DeepSeek’in mHC (Manifold-Constrained Hyper-Connections) LLM’leri ölçeklerken çoğu ekibin karşılaştığı bir sorunu ele alıyor: GPU eklemeye devam edebilirsiniz, ancak bir noktadan sonra eğitim kararsız hâle gelir ve verim artışı durur.
Temel fikir şu:
- Ölçekte gerçek sınırlar çoğunlukla bellek bant genişliği, GPU’lar arası iletişim ve gecikme ek yüküdür.
- Hyper-Connections (HC), bilgi akışının artık yollar üzerinden daha zengin kalıntı (residual) yollarla ilerlemesine izin vererek, katman başına FLOPs’u çok fazla artırmadan model kapasitesini yükseltmeye çalışır. Ancak bu ek karışım, artık ağlarını baştan itibaren dengeli kılan “kimlik kısayolu” ilkesini bozabilir ve eğitimin patlamasına neden olabilir.
- mHC bunu, bu kalıntı yolların nasıl karıştığını kısıtlayarak düzeltir. Kalıntı karışımı, iyi huylu bir ağırlıklı ortalama (Sinkhorn–Knopp ile uygulanan çift stokastik matris) gibi davranmaya zorlanır; bu da sinyal ve gradyanların patlamasını veya sönümlenmesini engeller.
Hyper-Connections bağlantıyı ve kapasiteyi artırır; ancak Manifold Kısıtlı Hiper-Bağlantılar (mHC), bellek bant genişliği ve iletişim gibi gerçek darboğazları göz ardı etmeden bu yükseltmeyi istikrarlı ve ölçeklenebilir hâle getirir.
Bu derste ele alınan ilkeler hakkında daha fazla bilgi edinmek istiyorsanız, PyTorch ile Transformer Modelleri ve PyTorch ile Derin Öğrenme kurslarına göz atmanızı öneririm.
mHC nedir? Artık Bağlantılardan Hiper-Bağlantılara
Bu bölümde, düz artık bağlantıların ötesine geçme ihtiyacını, HC’nin bunu nasıl çözmeye çalıştığını ve mHC’nin fikri LLM ölçeğinde işe yarar kılan düzeltme olmasının nedenini açacağım.
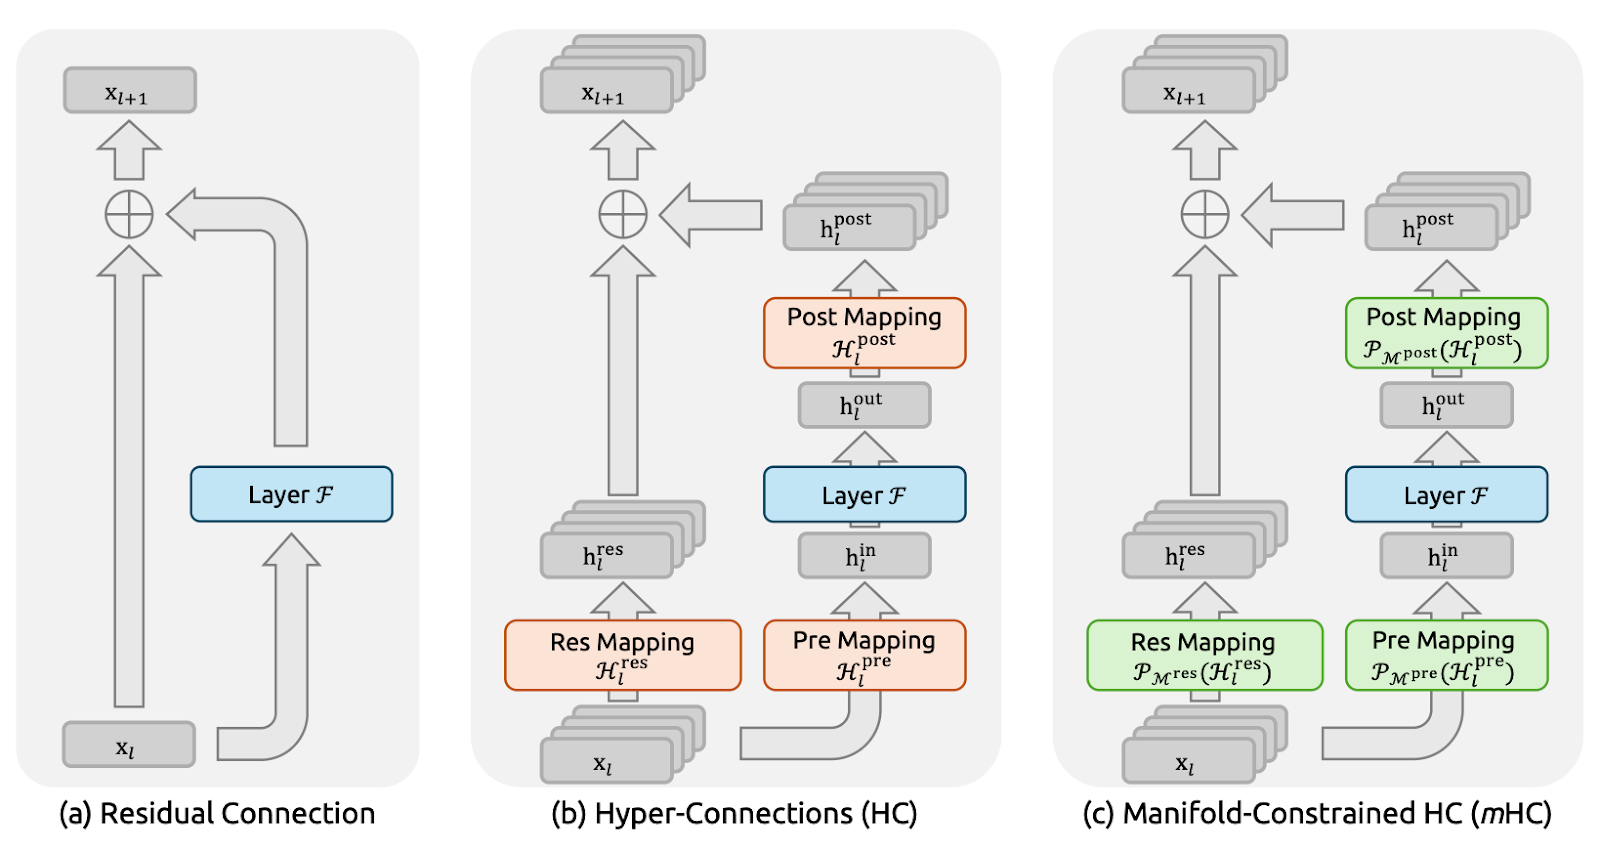
Şekil 1: Artık Bağlantı Paradigmalarının Gösterimleri (mHC makalesi)
Artık bağlantılar (Şekil a), her bir katmana bir kimlik kısayolu sağlar ve sinyal ile gradyanların çok derin ağlar boyunca temiz bir şekilde akmasına imkân tanır.
DeepSeek, mHC makalesi için başlangıç noktası olarak bu kimlik eşleme ilkesini açıkça kullandı. Dezavantajı şu ki düz bir artık yol aynı zamanda fazla kısıtlayıcıdır; artık akış içinde fazla bilgi alışverişine izin vermez.
Hyper-Connections (HC) (Şekil b) ise doğal bir sonraki adımdı: tek bir artık akış yerine, n paralel akışa genişler ve akışların karışıp bilgi paylaşabilmesi için öğrenilebilir ön/son/artık eşlemeler ekler. Bu, katman başına FLOPs’u mutlaka patlatmadan ifade gücünü artırır.
Ancak büyük ölçekte HC iki büyük sorunla karşılaşır. İlk olarak, akışlar her katmanda serbestçe karıştığından, bu küçük karışımlar derinleştikçe birikir. Çok sayıda katmandan sonra ağ, temiz bir “atlama bağlantısı” gibi davranmayı bırakabilir ve sinyaller veya gradyanlar patlayabilir ya da sönümlenebilir; bu da eğitimi kararsız kılar. İkinci olarak, ek hesaplamalar basit olsa bile donanım maliyeti hızla artar.
Manifold Kısıtlı Hiper-Bağlantılar (mHC) (Şekil c) HC’nin ek bağlantılılığını korur, ancak bir ResNet gibi güvenle eğitilebilir hâle getirir.
Ana fikir; artık akışların herhangi bir şekilde karışmasına izin vermek yerine, mHC’nin karışımın sıkı kurallara uymasını zorlamasıdır. Makalede bu, karışım matrisini Sinkhorn–Knopp adı verilen bir işlemle iyi huylu bir “ağırlıklı ortalama”ya dönüştürerek yapılır. Sonuç olarak, çok sayıda katmandan sonra bile karışım istikrarlı kalır ve sinyaller ile gradyanlar ne patlar ne de yok olur.
Kısacası, tek bir atlama yolu yerine daha zengin bir bilgi akışı istediğimiz için artık bağlantılardan mHC’ye geçtik.
mHC’nin Temel Kavramları
Yüksek düzeyde bakıldığında mHC, Hyper-Connection’ın çok akışlı karışımını korur; ancak yüzlerce katman üst üste konduğunda bile karışımın istikrarlı, ResNet tarzı bir atlama yolu gibi davranmasını sağlamak için katı korkuluklar koyar.
Yazarlar, kalıntı karışım matrisi Hlres’i derinlik boyunca iyi huylu kalacak şekilde kısıtlar; aynı zamanda akışların bilgi alışverişine izin verir.
Somut olarak, mHC Hlres’i çift stokastik olmaya zorlar; yani tüm girdiler negatif değildir ve her satır ile her sütun toplamı 1’dir. Bu, artık akışın kontrollü bir ağırlıklı ortalama gibi davranmasını sağlar.
Bu yaklaşım; eşlemenin genişlemeyen (spektral normu 1 ile sınırlı) olduğunu, katmanlar boyunca çarpıldığında istikrarını koruduğunu (çarpım altında kapanış) ve Birkhoff politopu üzerinden ortalama/permütasyon harmanlaması şeklinde sezgisel bir karışım yorumuna sahip olduğunu vurgular. Ayrıca sinyal iptalini önlemek için ön/son eşlemeleri negatif olmayan olacak şekilde kısıtlar.
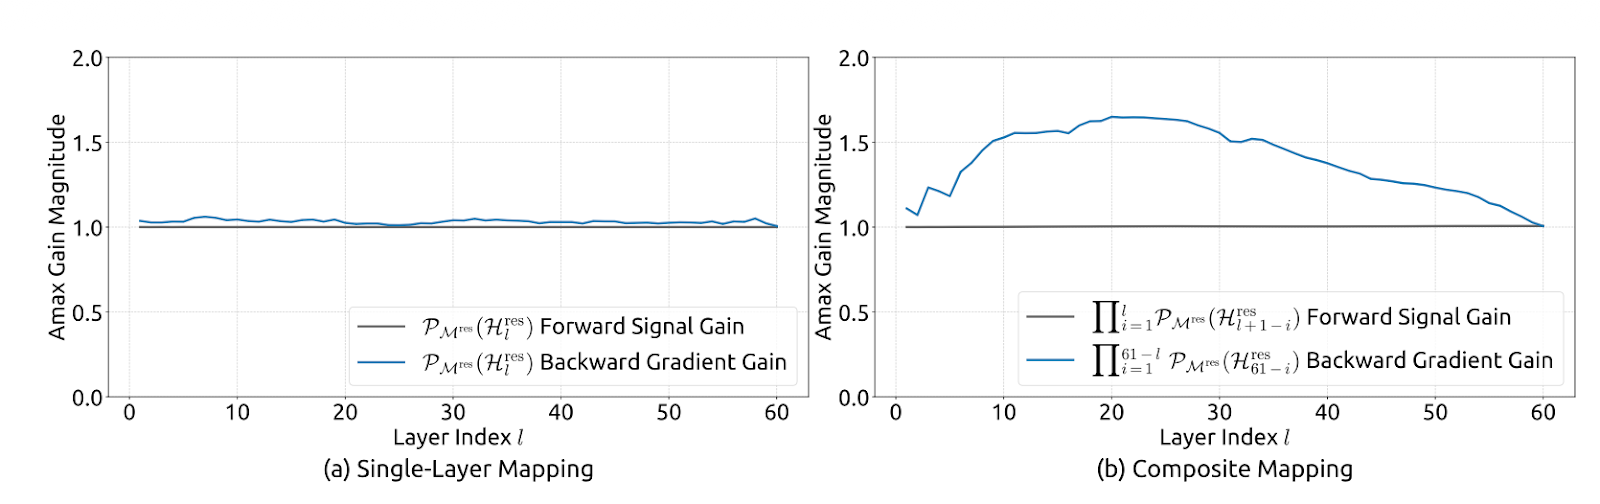
Şekil 2: Manifold Kısıtlı Hiper-Bağlantıların Yayılım İstikrarı (mHC makalesi)
Uygulama açısından makale pratik kalır: mevcut katmanın çok akışlı durumundan (tam bağlamı korumak için xl yassılaştırılır) kısıtsız ham eşlemeler Hlpre, Hlpost ve Hlres hesaplanır; ardından bunlar kısıtlı biçimlerine yansıtılır. Hlpre ve Hlpost sigmoid tabanlı bir kısıtla elde edilirken, Hlres Sinkhorn–Knopp kullanılarak yansıtılır: girişler pozitif yapmak için üstel alınır, sonra toplamlar 1 olana dek satır/sütun normalleştirmeleri dönüşümlü uygulanır.
Yazarlar ayrıca mHC’yi (n=4 ile) ölçekte yalnızca ~%6,7 eğitim süresi ek yüküyle uyguladıklarını bildiriyor; bu da esas olarak bellek trafiğini agresif biçimde azaltarak sağlanmış. Verimlilik için RMSNorm’un parçalarını yeniden sıralamışlar, çekirdek füzyonu kullanmışlar (Sinkhorn yinelemelerini özel geri yayılım ile tek bir çekirdeğin içinde uygulamak dâhil), okuma/yazmaları azaltmak için Hlpost ve Hlres uygulamasını artık birleşimiyle birleştirmişler, büyük ara aktivasyonları depolamaktan kaçınmak için seçici yeniden hesaplamadan yararlanmışlar ve boru hattı aşaması gecikmesini gizlemek üzere genişletilmiş bir DualPipe çizelgesinde iletişimi örtüşmüşler.
mHC’yi Optimize Etmek: Sistem Teknikleri
Yalnızca istikrar yeterli değildir. Eğer mHC çok fazla bellek trafiği veya GPU’dan GPU’ya iletişim eklerse, verimlilikten kaybederiz. Bu yüzden yazarlar, mHC yöntemini bellek duvarıyla dost kalacak şekilde tasarlanmış bir dizi altyapı optimizasyonuyla eşleştirdi.
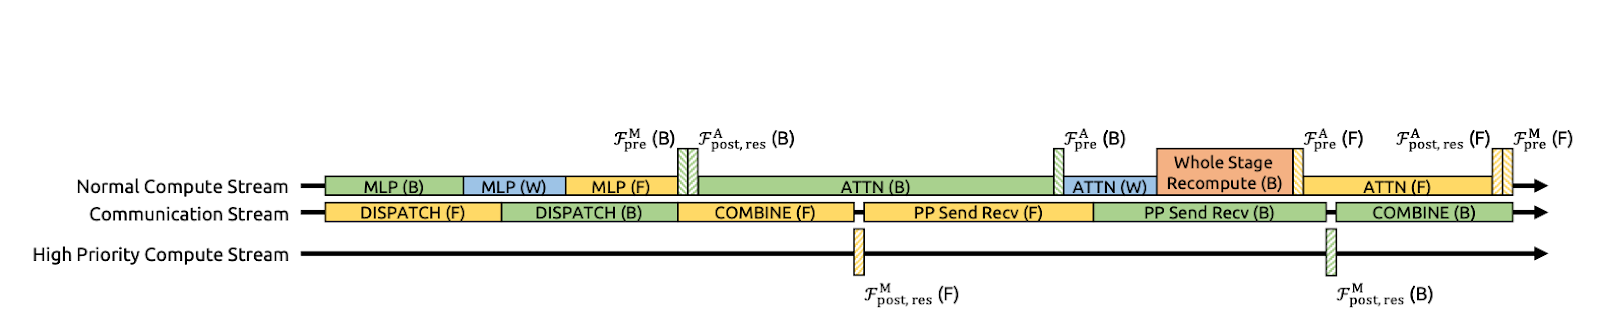
Şekil 3: mHC için İletişim-Hesaplama Örtüşmesi (mHC makalesi)
Bellek okuma/yazmalarını azaltmak için çekirdek füzyonu
Yazarlar, birden fazla adımı tek bir GPU çekirdeğinde birleştirerek mHC’yi hızlandırıyor. Hlpost, Hlres uygulayıp ardından artık akışla ayrı geçişler olarak birleştirmek (GPU’nun ara tensörleri belleğe yazmasını ve geri okumasını zorlar) yerine, bu işlemler tek bir geçişte yapılıyor.
Bu, bellek trafiğini önemli ölçüde azaltır. Çekirdek artık yaklaşık (n+1)C değer okur (önceden (3n+1)C) ve yaklaşık nC değer yazar (önceden 3nC). Burada C, gizli boyuttur (akış başına özellik sayısı) ve n, artık akışların sayısıdır; dolayısıyla nC genişletilmiş artık durumun boyutudur. Daha az okuma/yazma, bellekten veri taşımanın azalması demektir.
Makale ayrıca çoğu çekirdeğin, bellek bant genişliğini daha iyi kullanmak için TileLang ile uygulanmasını öneriyor.
Aktivasyon belleğini kontrol etmek için yeniden hesaplama
Çok akışlı mHC, geri yayılım için normalde saklamanız gereken ara aktivasyon miktarını artırır; bu da GPU belleğini şişirip daha küçük yığınlara veya daha agresif kontrol noktalamaya zorlayabilir.
Bunu önlemek için makale basit bir numara öneriyor: ileri geçişten sonra mHC ara çıktıları saklanmaz. Bunun yerine, geri yayılım sırasında hafif mHC çekirdekleri yeniden hesaplanır; pahalı Transformer katmanı F’nin yeniden hesaplanması atlanır.
Bu, bellek baskısını azaltır ve daha yüksek etkili verimi korumaya yardımcı olur. Pratik bir kısıt, bu yeniden hesaplama bloklarının boru hattı aşaması sınırlarıyla hizalanması gerektiğidir; aksi takdirde boru hattı çizelgelemesi karmaşıklaşır.
DualPipe örtüşmesiyle iletişim farkında çizelgeleme
Ölçekte boru hattı paralelliği yaygındır; ancak mHC’nin n akışlı tasarımı, aşama sınırlarını geçmesi gereken veri miktarını artırır ve bu da belirgin iletişim duraklamaları ekleyebilir.
DeepSeek bunu, iletişim ile hesaplamanın boru hattı sınırlarında örtüşmesini sağlayacak şekilde DualPipe’ı genişleterek optimize eder. Bu, gönderim/alım işlemleri tamamlanana kadar boşta beklemek yerine, aktarım sürerken GPU’ların faydalı iş yapması anlamına gelir. Ayrıca bazı çekirdekler yüksek öncelikli bir hesaplama akışında çalıştırılır; böylece hesaplama, iletişim ilerlemesini engellemez. Sonuç olarak mHC’den kaynaklanan ek iletişim maliyeti kısmen gizlenir ve uçtan uca eğitim verimliliği artar.
Sıcak Noktalar
mHC’yi uygulamasak bile, DeepSeek’in çerçevesi sistemin gerçekte nerede zaman kaybettiğini belirlemek için iyi bir yoldur.
- Uzun-bağlam iş yükleri: Uzun istemler, bellekte çok fazla veriyi hareket ettirmesi gerektiği için ön doldurmayı (prefill) pahalı hâle getirir. Çözümleme (decode) sırasında KV önbelleği büyümeye devam eder; bu da token başına bellek okumalarını artırır. Birlikte, bunlar bellek bant genişliği sınırlarını zorlar ve sıklıkla parçalanma veya verimsiz yığınlamaya neden olur.
- MoE yönlendirme ve uzman paralelliği: Mixture of Experts (MoE) ile maliyet yalnızca hesaplama değildir. Uzmanlara token göndermek ve çıktıları toplamak için gereken yönlendirme, token değişimi ve GPU çapraz iletişimdir. DeepSeek’in DualPipe örtüşmesi, boru hattı iletişimini hesaplamanın arkasına saklamaya odaklanır; bu da ölçekte MoE’nin ihtiyaç duyduğu şeydir.
- Çok kiracılı ve küçük yığın trafiği: Gerçek dağıtımlarda istekler düzenli, büyük yığınlar hâlinde gelmez. Daha küçük, tutarsız yığınlar, karışık dizi uzunlukları ve daha zayıf önbellek yeniden kullanımı elde ederiz. Bu, yığınlama verimliliğini düşürür ve kuyruk gecikmesini artırır; böylece bellek bant genişliği ve çizelgeleme darboğaz hâline gelir.
KV Önbelleği ve Bellek Trafiği
mHC esas olarak bir eğitim fikri olsa da, makalenin temel dersi doğrudan çıkarım için geçerlidir. Makale yalnızca FLOPs için değil, bellek trafiği, iletişim ve gecikme için de optimize etmeye odaklanır. En büyük kanıt, yaklaşık KV önbelleği tahmininin şöyle olduğu uzun-bağlam çözümlemedir:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batch
FP16/BF16 için bytes_per_elem değeri 2’dir. Örneğin tipik bir şekille (L=32, H=4096, batch=1) 8K token yaklaşık 4 GB KV iken, 128K token yaklaşık 64 GB’dır; bu nedenle hesaplama makul kalsa bile bellek yine de patlayabilir ve bant genişliği sınırlı hâle gelirsiniz.
Bu nedenle pratik çıkarım optimizasyonları; KV önbelleği nicelemesi, sayfalı KV ve tahliye, verimli dikkat çekirdekleri (FlashAttention ailesi), sürekli yığınlama ve şekil kovalaması (bucketing) ile iletişim farkında paralellik gibi tekniklerle bellek hareketini azaltmaya odaklanır.
Amaç, performans kazanımlarını sürdürürken bellek okuma/yazmalarında ve senkronizasyonda gizli bir vergi ödememektir.
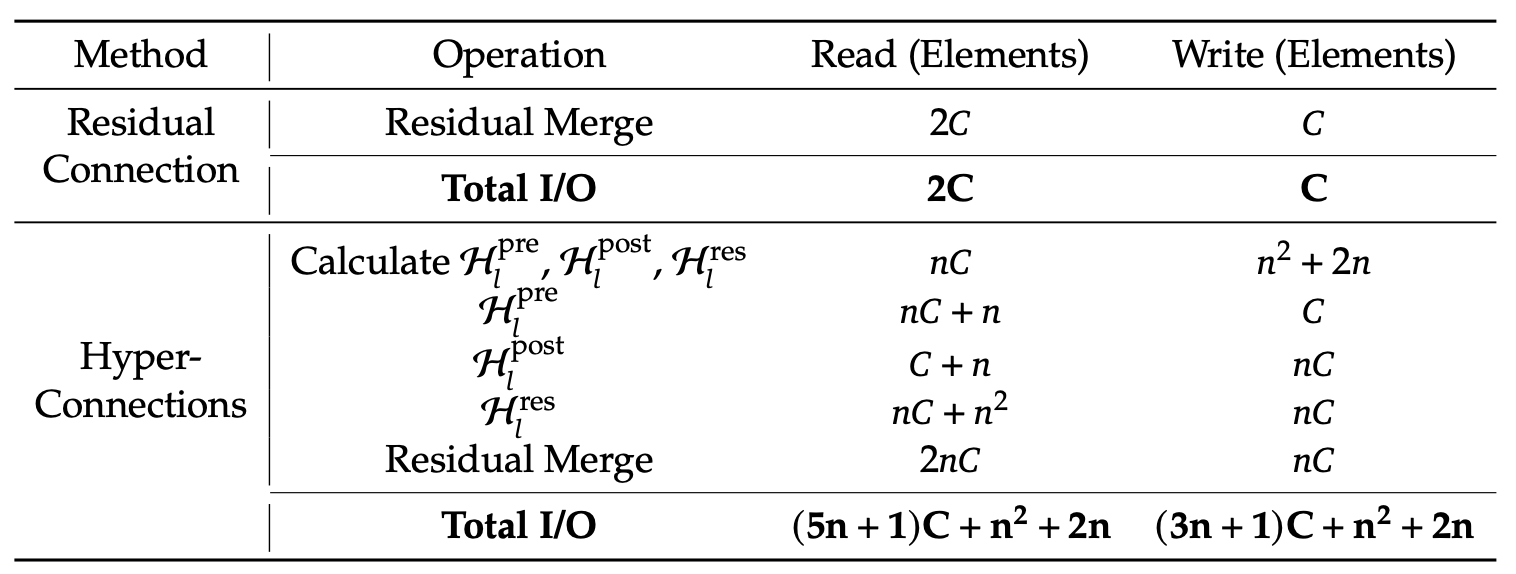
Tablo 1: Token Başına Bellek Erişim Maliyeti Karşılaştırması (mHC makalesi)
DeepSeek, mHC’nin 27B modeller için çoğu ölçüt üzerinde temeli (baseline) tutarlı biçimde geride bıraktığını ve HC’yi aştığını bildiriyor; HC’ye kıyasla BBH’de +%2,1 ve DROP’ta +%2,3 dâhil. Bu da mHC’nin ölçekte daha iyi sonuçlara dönüştüğünü gösteriyor.
Sonuç
Bu makaleden çıkarılacak ana ders; LLM’leri ölçeklendirmenin yalnızca bir FLOPs sorunu olmadığı, aynı ölçüde bir istikrar ve sistemler sorunu olduğudur. Hyper-Connections (HC), artık akışı genişleterek ve birden fazla akışın karışmasına izin vererek model kapasitesini artırır; ancak büyük derinliklerde bu karışım, kimlik yolundan önemli ölçüde sapabilen bileşik bir eşlemeye dönüşerek sinyal/gradyan patlamasına veya sönümlenmesine ve eğitimde çöküşlere yol açabilir.
mHC, artık karışım matrisini Sinkhorn–Knopp ile zorlanan çift stokastik (negatif olmayan, satır/sütun toplamları 1) olacak şekilde kısıtlayarak bu karışım üzerine korkuluklar koyar; böylece artık yol, kontrollü bir ağırlıklı ortalama gibi davranır ve çok sayıda katman yığıldığında bile istikrarlı kalır.
DeepSeek ayrıca çalışma zamanı verimliliğini yöntemin bir parçası olarak ele alır. Yüksek bant genişlikli bellek okuma/yazmalarını azaltmak için çekirdek füzyonunu ve aktivasyon belleğini en aza indirmek için seçici yeniden hesaplamayı kullanmışlardır.
Ayrıca, iletişimin hesaplamayla örtüşmesi için DualPipe’ı genişleterek, boru hattı duraklamalarının kazanımları silmemesini sağlarlar. Sonuç; yalnızca daha istikrarlı bir eğitim değil, aynı zamanda ölçekte daha iyi aşağı akış performansıdır.
LLM uygulama geliştirme hakkında daha fazla bilgi edinmek istiyorsanız, LangChain ile LLM Uygulamaları Geliştirme kursuna göz atmanızı öneririm.








DeepSeek’in mHC (Manifold-Constrained Hyper-Connections) LLM’leri ölçeklerken çoğu ekibin karşılaştığı bir sorunu ele alıyor: GPU eklemeye devam edebilirsiniz, ancak bir noktadan sonra eğitim kararsız hâle gelir ve verim artışı durur.
Temel fikir şu:
Hyper-Connections bağlantıyı ve kapasiteyi artırır; ancak Manifold Kısıtlı Hiper-Bağlantılar (mHC), bellek bant genişliği ve iletişim gibi gerçek darboğazları göz ardı etmeden bu yükseltmeyi istikrarlı ve ölçeklenebilir hâle getirir.
Bu derste ele alınan ilkeler hakkında daha fazla bilgi edinmek istiyorsanız, PyTorch ile Transformer Modelleri ve PyTorch ile Derin Öğrenme kurslarına göz atmanızı öneririm.
mHC nedir? Artık Bağlantılardan Hiper-Bağlantılara
Bu bölümde, düz artık bağlantıların ötesine geçme ihtiyacını, HC’nin bunu nasıl çözmeye çalıştığını ve mHC’nin fikri LLM ölçeğinde işe yarar kılan düzeltme olmasının nedenini açacağım.
Şekil 1: Artık Bağlantı Paradigmalarının Gösterimleri (mHC makalesi)
Artık bağlantılar (Şekil a), her bir katmana bir kimlik kısayolu sağlar ve sinyal ile gradyanların çok derin ağlar boyunca temiz bir şekilde akmasına imkân tanır.
DeepSeek, mHC makalesi için başlangıç noktası olarak bu kimlik eşleme ilkesini açıkça kullandı. Dezavantajı şu ki düz bir artık yol aynı zamanda fazla kısıtlayıcıdır; artık akış içinde fazla bilgi alışverişine izin vermez.
Hyper-Connections (HC) (Şekil b) ise doğal bir sonraki adımdı: tek bir artık akış yerine, n paralel akışa genişler ve akışların karışıp bilgi paylaşabilmesi için öğrenilebilir ön/son/artık eşlemeler ekler. Bu, katman başına FLOPs’u mutlaka patlatmadan ifade gücünü artırır.
Ancak büyük ölçekte HC iki büyük sorunla karşılaşır. İlk olarak, akışlar her katmanda serbestçe karıştığından, bu küçük karışımlar derinleştikçe birikir. Çok sayıda katmandan sonra ağ, temiz bir “atlama bağlantısı” gibi davranmayı bırakabilir ve sinyaller veya gradyanlar patlayabilir ya da sönümlenebilir; bu da eğitimi kararsız kılar. İkinci olarak, ek hesaplamalar basit olsa bile donanım maliyeti hızla artar.
Manifold Kısıtlı Hiper-Bağlantılar (mHC) (Şekil c) HC’nin ek bağlantılılığını korur, ancak bir ResNet gibi güvenle eğitilebilir hâle getirir.
Ana fikir; artık akışların herhangi bir şekilde karışmasına izin vermek yerine, mHC’nin karışımın sıkı kurallara uymasını zorlamasıdır. Makalede bu, karışım matrisini Sinkhorn–Knopp adı verilen bir işlemle iyi huylu bir “ağırlıklı ortalama”ya dönüştürerek yapılır. Sonuç olarak, çok sayıda katmandan sonra bile karışım istikrarlı kalır ve sinyaller ile gradyanlar ne patlar ne de yok olur.
Kısacası, tek bir atlama yolu yerine daha zengin bir bilgi akışı istediğimiz için artık bağlantılardan mHC’ye geçtik.
mHC’nin Temel Kavramları
Yüksek düzeyde bakıldığında mHC, Hyper-Connection’ın çok akışlı karışımını korur; ancak yüzlerce katman üst üste konduğunda bile karışımın istikrarlı, ResNet tarzı bir atlama yolu gibi davranmasını sağlamak için katı korkuluklar koyar.
Yazarlar, kalıntı karışım matrisi
Hlres’i derinlik boyunca iyi huylu kalacak şekilde kısıtlar; aynı zamanda akışların bilgi alışverişine izin verir.Somut olarak, mHC
Hlres’i çift stokastik olmaya zorlar; yani tüm girdiler negatif değildir ve her satır ile her sütun toplamı 1’dir. Bu, artık akışın kontrollü bir ağırlıklı ortalama gibi davranmasını sağlar.Bu yaklaşım; eşlemenin genişlemeyen (spektral normu 1 ile sınırlı) olduğunu, katmanlar boyunca çarpıldığında istikrarını koruduğunu (çarpım altında kapanış) ve Birkhoff politopu üzerinden ortalama/permütasyon harmanlaması şeklinde sezgisel bir karışım yorumuna sahip olduğunu vurgular. Ayrıca sinyal iptalini önlemek için ön/son eşlemeleri negatif olmayan olacak şekilde kısıtlar.
Şekil 2: Manifold Kısıtlı Hiper-Bağlantıların Yayılım İstikrarı (mHC makalesi)
Uygulama açısından makale pratik kalır: mevcut katmanın çok akışlı durumundan (tam bağlamı korumak için
xlyassılaştırılır) kısıtsız ham eşlemelerHlpre,HlpostveHlreshesaplanır; ardından bunlar kısıtlı biçimlerine yansıtılır.HlpreveHlpostsigmoid tabanlı bir kısıtla elde edilirken, HlresSinkhorn–Knopp kullanılarak yansıtılır: girişler pozitif yapmak için üstel alınır, sonra toplamlar 1 olana dek satır/sütun normalleştirmeleri dönüşümlü uygulanır.Yazarlar ayrıca mHC’yi (n=4 ile) ölçekte yalnızca ~%6,7 eğitim süresi ek yüküyle uyguladıklarını bildiriyor; bu da esas olarak bellek trafiğini agresif biçimde azaltarak sağlanmış. Verimlilik için RMSNorm’un parçalarını yeniden sıralamışlar, çekirdek füzyonu kullanmışlar (Sinkhorn yinelemelerini özel geri yayılım ile tek bir çekirdeğin içinde uygulamak dâhil), okuma/yazmaları azaltmak için
HlpostveHlresuygulamasını artık birleşimiyle birleştirmişler, büyük ara aktivasyonları depolamaktan kaçınmak için seçici yeniden hesaplamadan yararlanmışlar ve boru hattı aşaması gecikmesini gizlemek üzere genişletilmiş bir DualPipe çizelgesinde iletişimi örtüşmüşler.mHC’yi Optimize Etmek: Sistem Teknikleri
Yalnızca istikrar yeterli değildir. Eğer mHC çok fazla bellek trafiği veya GPU’dan GPU’ya iletişim eklerse, verimlilikten kaybederiz. Bu yüzden yazarlar, mHC yöntemini bellek duvarıyla dost kalacak şekilde tasarlanmış bir dizi altyapı optimizasyonuyla eşleştirdi.
Şekil 3: mHC için İletişim-Hesaplama Örtüşmesi (mHC makalesi)
Bellek okuma/yazmalarını azaltmak için çekirdek füzyonu
Yazarlar, birden fazla adımı tek bir GPU çekirdeğinde birleştirerek mHC’yi hızlandırıyor.
Hlpost,Hlresuygulayıp ardından artık akışla ayrı geçişler olarak birleştirmek (GPU’nun ara tensörleri belleğe yazmasını ve geri okumasını zorlar) yerine, bu işlemler tek bir geçişte yapılıyor.Bu, bellek trafiğini önemli ölçüde azaltır. Çekirdek artık yaklaşık
(n+1)Cdeğer okur (önceden(3n+1)C) ve yaklaşıknCdeğer yazar (önceden3nC). BuradaC, gizli boyuttur (akış başına özellik sayısı) ven, artık akışların sayısıdır; dolayısıylanCgenişletilmiş artık durumun boyutudur. Daha az okuma/yazma, bellekten veri taşımanın azalması demektir.Makale ayrıca çoğu çekirdeğin, bellek bant genişliğini daha iyi kullanmak için TileLang ile uygulanmasını öneriyor.
Aktivasyon belleğini kontrol etmek için yeniden hesaplama
Çok akışlı mHC, geri yayılım için normalde saklamanız gereken ara aktivasyon miktarını artırır; bu da GPU belleğini şişirip daha küçük yığınlara veya daha agresif kontrol noktalamaya zorlayabilir.
Bunu önlemek için makale basit bir numara öneriyor: ileri geçişten sonra mHC ara çıktıları saklanmaz. Bunun yerine, geri yayılım sırasında hafif mHC çekirdekleri yeniden hesaplanır; pahalı Transformer katmanı F’nin yeniden hesaplanması atlanır.
Bu, bellek baskısını azaltır ve daha yüksek etkili verimi korumaya yardımcı olur. Pratik bir kısıt, bu yeniden hesaplama bloklarının boru hattı aşaması sınırlarıyla hizalanması gerektiğidir; aksi takdirde boru hattı çizelgelemesi karmaşıklaşır.
DualPipe örtüşmesiyle iletişim farkında çizelgeleme
Ölçekte boru hattı paralelliği yaygındır; ancak mHC’nin n akışlı tasarımı, aşama sınırlarını geçmesi gereken veri miktarını artırır ve bu da belirgin iletişim duraklamaları ekleyebilir.
DeepSeek bunu, iletişim ile hesaplamanın boru hattı sınırlarında örtüşmesini sağlayacak şekilde DualPipe’ı genişleterek optimize eder. Bu, gönderim/alım işlemleri tamamlanana kadar boşta beklemek yerine, aktarım sürerken GPU’ların faydalı iş yapması anlamına gelir. Ayrıca bazı çekirdekler yüksek öncelikli bir hesaplama akışında çalıştırılır; böylece hesaplama, iletişim ilerlemesini engellemez. Sonuç olarak mHC’den kaynaklanan ek iletişim maliyeti kısmen gizlenir ve uçtan uca eğitim verimliliği artar.
Sıcak Noktalar
mHC’yi uygulamasak bile, DeepSeek’in çerçevesi sistemin gerçekte nerede zaman kaybettiğini belirlemek için iyi bir yoldur.
KV Önbelleği ve Bellek Trafiği
mHC esas olarak bir eğitim fikri olsa da, makalenin temel dersi doğrudan çıkarım için geçerlidir. Makale yalnızca FLOPs için değil, bellek trafiği, iletişim ve gecikme için de optimize etmeye odaklanır. En büyük kanıt, yaklaşık KV önbelleği tahmininin şöyle olduğu uzun-bağlam çözümlemedir:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batchFP16/BF16 için
bytes_per_elemdeğeri 2’dir. Örneğin tipik bir şekille (L=32, H=4096, batch=1) 8K token yaklaşık 4 GB KV iken, 128K token yaklaşık 64 GB’dır; bu nedenle hesaplama makul kalsa bile bellek yine de patlayabilir ve bant genişliği sınırlı hâle gelirsiniz.Bu nedenle pratik çıkarım optimizasyonları; KV önbelleği nicelemesi, sayfalı KV ve tahliye, verimli dikkat çekirdekleri (FlashAttention ailesi), sürekli yığınlama ve şekil kovalaması (bucketing) ile iletişim farkında paralellik gibi tekniklerle bellek hareketini azaltmaya odaklanır.
Amaç, performans kazanımlarını sürdürürken bellek okuma/yazmalarında ve senkronizasyonda gizli bir vergi ödememektir.
Tablo 1: Token Başına Bellek Erişim Maliyeti Karşılaştırması (mHC makalesi)
DeepSeek, mHC’nin 27B modeller için çoğu ölçüt üzerinde temeli (baseline) tutarlı biçimde geride bıraktığını ve HC’yi aştığını bildiriyor; HC’ye kıyasla BBH’de +%2,1 ve DROP’ta +%2,3 dâhil. Bu da mHC’nin ölçekte daha iyi sonuçlara dönüştüğünü gösteriyor.
Sonuç
Bu makaleden çıkarılacak ana ders; LLM’leri ölçeklendirmenin yalnızca bir FLOPs sorunu olmadığı, aynı ölçüde bir istikrar ve sistemler sorunu olduğudur. Hyper-Connections (HC), artık akışı genişleterek ve birden fazla akışın karışmasına izin vererek model kapasitesini artırır; ancak büyük derinliklerde bu karışım, kimlik yolundan önemli ölçüde sapabilen bileşik bir eşlemeye dönüşerek sinyal/gradyan patlamasına veya sönümlenmesine ve eğitimde çöküşlere yol açabilir.
mHC, artık karışım matrisini Sinkhorn–Knopp ile zorlanan çift stokastik (negatif olmayan, satır/sütun toplamları 1) olacak şekilde kısıtlayarak bu karışım üzerine korkuluklar koyar; böylece artık yol, kontrollü bir ağırlıklı ortalama gibi davranır ve çok sayıda katman yığıldığında bile istikrarlı kalır.
DeepSeek ayrıca çalışma zamanı verimliliğini yöntemin bir parçası olarak ele alır. Yüksek bant genişlikli bellek okuma/yazmalarını azaltmak için çekirdek füzyonunu ve aktivasyon belleğini en aza indirmek için seçici yeniden hesaplamayı kullanmışlardır.
Ayrıca, iletişimin hesaplamayla örtüşmesi için DualPipe’ı genişleterek, boru hattı duraklamalarının kazanımları silmemesini sağlarlar. Sonuç; yalnızca daha istikrarlı bir eğitim değil, aynı zamanda ölçekte daha iyi aşağı akış performansıdır.
LLM uygulama geliştirme hakkında daha fazla bilgi edinmek istiyorsanız, LangChain ile LLM Uygulamaları Geliştirme kursuna göz atmanızı öneririm.