DeepSeek’s mHC (Manifold-Constrained Hyper-Connections) pakt een probleem aan waar de meeste teams tegenaan lopen bij het opschalen van LLM’s: je kunt blijven GPUs toevoegen, maar op een gegeven moment wordt trainen instabiel en verbetert de throughput niet meer.
Hier is het kernidee:
- Op schaal zijn de echte grenzen vaak geheugenbandbreedte, GPU-naar-GPU-communicatie en latentiekosten.
- Hyper-Connections (HC) proberen de modelcapaciteit te vergroten door informatie via rijkere residuele paden te laten stromen zonder de FLOPs per laag te veel op te voeren. Maar die extra vermenging kan de “identity shortcut” doorbreken die residuele netwerken oorspronkelijk stabiel maakte, waardoor de training kan ontsporen.
- mHC lost dit op door te beperken hoe die residuele paden mengen. De residuele menging wordt gedwongen zich te gedragen als een welgemiddeld gewogen gemiddelde (een dubbel-stochastische matrix, afgedwongen met Sinkhorn–Knopp), wat voorkomt dat signalen en gradiënten exploderen of uitsterven.
Hyper-Connections verbeteren de connectiviteit en capaciteit, maar Manifold-Constrained Hyper-Connections (mHC’s) maken die upgrade stabiel en schaalbaar, zonder de echte knelpunten zoals geheugenbandbreedte en communicatie te negeren.
Als je meer wilt leren over enkele principes uit deze tutorial, raad ik aan om de Transformer Models with PyTorch-cursus en de Deep Learning with PyTorch-cursus te bekijken.
Wat is mHC? Van residuele verbindingen naar Hyper-Connections
In deze sectie leg ik uit waarom we verder moeten gaan dan simpele residuele verbindingen, hoe HC dat probeerde op te lossen en waarom mHC de fix is die het idee op LLM-schaal laat werken.
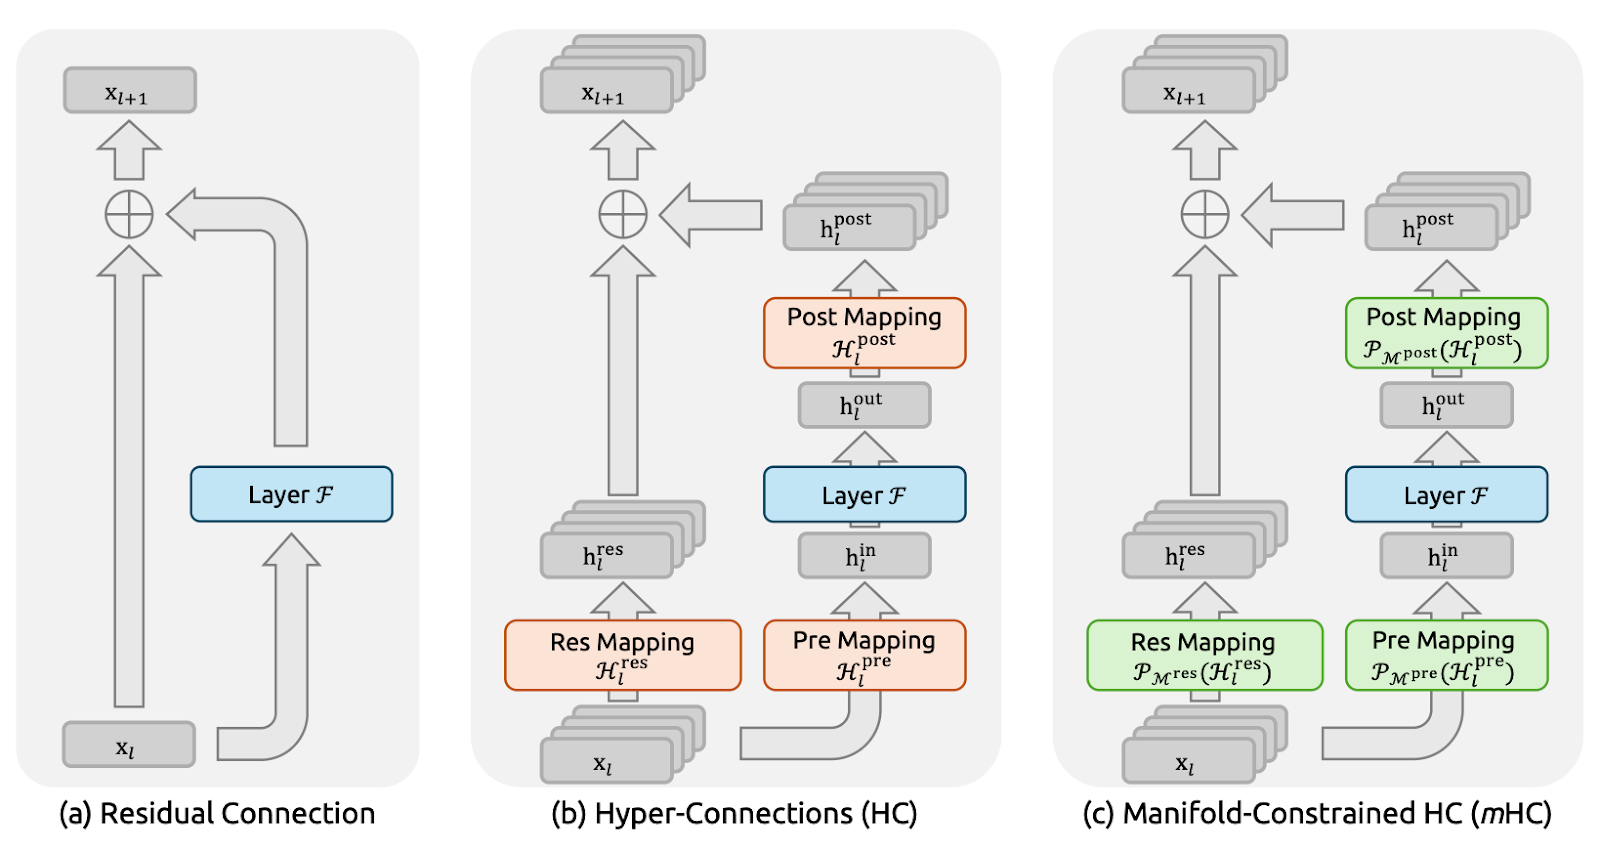
Figuur 1: Illustraties van paradigmas voor residuele verbindingen (mHC-paper)
Residuele verbindingen (Figuur a) geven elke laag een identity-shortcut, waardoor signalen en gradiënten netjes door zeer diepe netwerken kunnen stromen.
DeepSeek gebruikte dit principe van identity-mapping expliciet als vertrekpunt voor het mHC-paper. Het nadeel is dat een simpele residuele route ook te beperkend is, waardoor weinig informatie-uitwisseling plaatsvindt binnen de residuele stroom.
Hyper-Connections (HC) (Figuur b) waren de logische volgende stap: in plaats van één residuele stroom wordt dit uitgebreid naar n parallelle stromen met leerbare pre-/post-/residuele mappings, zodat stromen kunnen mengen en informatie delen. Dit vergroot de expressiviteit zonder per se de FLOPs per laag te laten exploderen.
Maar op grote schaal loopt HC tegen twee grote problemen aan. Ten eerste, omdat de stromen vrij kunnen mengen in elke laag, stapelen die kleine vermengingen zich op naarmate je dieper gaat. Over veel lagen heen kan het netwerk ophouden zich te gedragen als een nette “skip-connection”, en kunnen signalen of gradiënten exploderen of wegvallen, wat de training instabiel maakt. Ten tweede, zelfs als de extra berekeningen simpel zijn, stijgen de hardwarekosten snel.
Manifold-Constrained Hyper-Connections (mHC) (Figuur c) behouden de extra connectiviteit van HC, maar maken het net zo veilig trainbaar als een ResNet.
Het hoofdpunt is dat mHC de vermenging tussen residuele stromen niet willekeurig laat verlopen, maar die volgens strikte regels afdwingt. In het paper gebeurt dit door de mengmatrix om te zetten in een welgemanierd “gewogen gemiddelde” met behulp van de Sinkhorn–Knopp-procedure. Het resultaat is dat de menging stabiel blijft, zelfs na veel lagen, en signalen en gradiënten niet exploderen of verdwijnen.
Kortom: we zijn van residuele verbindingen naar mHC gegaan omdat we rijkere informatiestromen wilden in plaats van één enkele skip-route.
Belangrijke mHC-concepten
Op hoofdlijnen behoudt mHC het multi-stream mengen van Hyper-Connections, maar zet het harde vangrails op de menging zodat die zich gedraagt als een stabiel, ResNet-achtig skip-pad, zelfs wanneer we honderden lagen stapelen.
De auteurs beperken de residuele mengmatrix Hlres zodat die zich netjes gedraagt over de diepte, terwijl stromen toch informatie kunnen uitwisselen.
Concreet dwingt mHC af dat Hlres dubbel-stochastisch is: alle elementen zijn niet-negatief en elke rij en kolom somt tot 1. Daardoor gedraagt de residuele stroom zich als een gecontroleerd gewogen gemiddelde.
Dit onderstreept dat de mapping niet-expansief is (spectrale norm begrensd door 1), stabiel blijft bij vermenigvuldiging over lagen (gesloten onder multiplicatie), en een intuïtieve interpretatie heeft als middelen/permutatiemenging via de Birkhoff-polytoop. Ook worden de pre-/post-mappings beperkt tot niet-negatief om signaalannulering te vermijden.
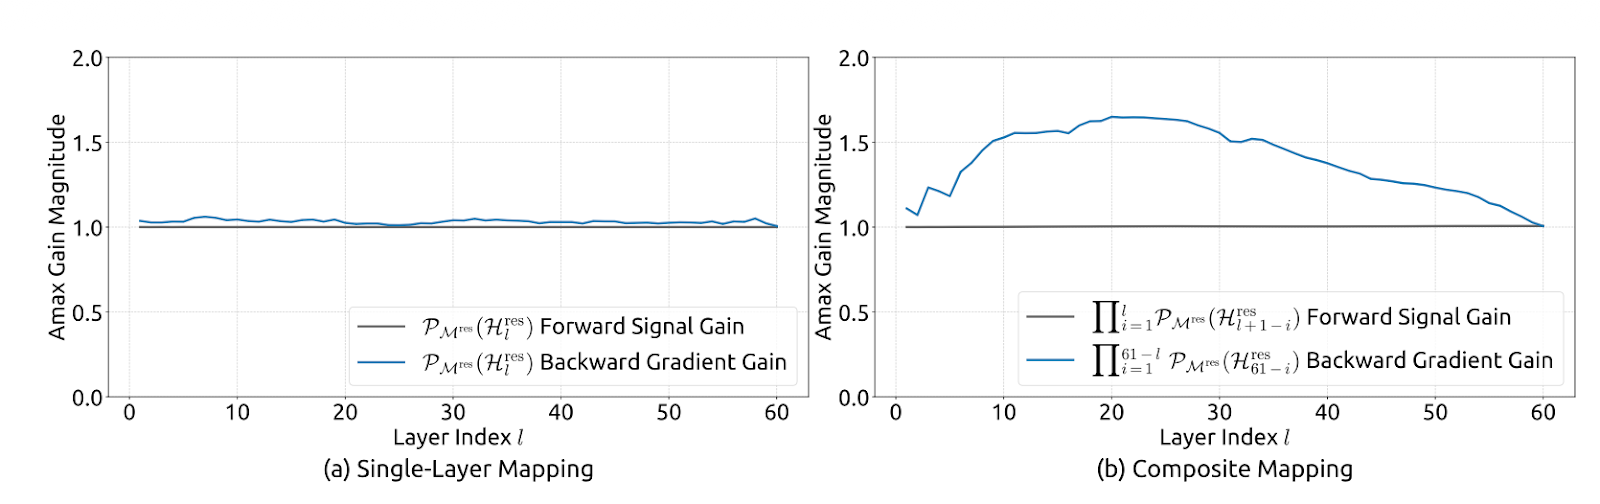
Figuur 2: Propagatiestabiliteit van Manifold-Constrained Hyper-Connections (mHC-paper)
Qua implementatie houdt het paper het praktisch door onbegrensde ruwe mappings Hlpre, Hlpost en Hlres te berekenen vanuit de multistreamstatus van de huidige laag (ze flatten xl om volledige context te behouden) en ze daarna te projecteren naar de begrensde vormen. Hlpre en Hlpost worden verkregen met een sigmoid-gebaseerde begrenzing, terwijl Hlres wordt geprojecteerd met Sinkhorn–Knopp: exponentiëren om entries positief te maken en vervolgens afwisselend rijen/kolommen normaliseren totdat de sommen 1 zijn.
De auteurs melden ook dat ze mHC (met n=4) op schaal implementeerden met slechts ~6,7% overhead in trainingstijd, vooral door het geheugenverkeer agressief te verlagen. Ze hebben delen van RMSNorm herschikt voor efficiëntie, kernel-fusie gebruikt (inclusief het implementeren van Sinkhorn-iteraties in één kernel met een custom backward), het toepassen van Hlpost en Hlres gecombineerd met residuele merge om reads/writes te verminderen, selectieve recomputatie gebruikt om het opslaan van grote tussenactivaties te vermijden, en communicatie overlapt in een uitgebreide DualPipe-planning om pipeline-latentie te verbergen.
mHC optimaliseren: systeemtechnieken
Alleen stabiliteit is niet genoeg. Als mHC te veel geheugenverkeer of GPU-naar-GPU-communicatie toevoegt, verliezen we op throughput. Daarom koppelden de auteurs de mHC-methode aan een set infrastructuuroptimalisaties die vriendelijk blijven voor de memory wall.
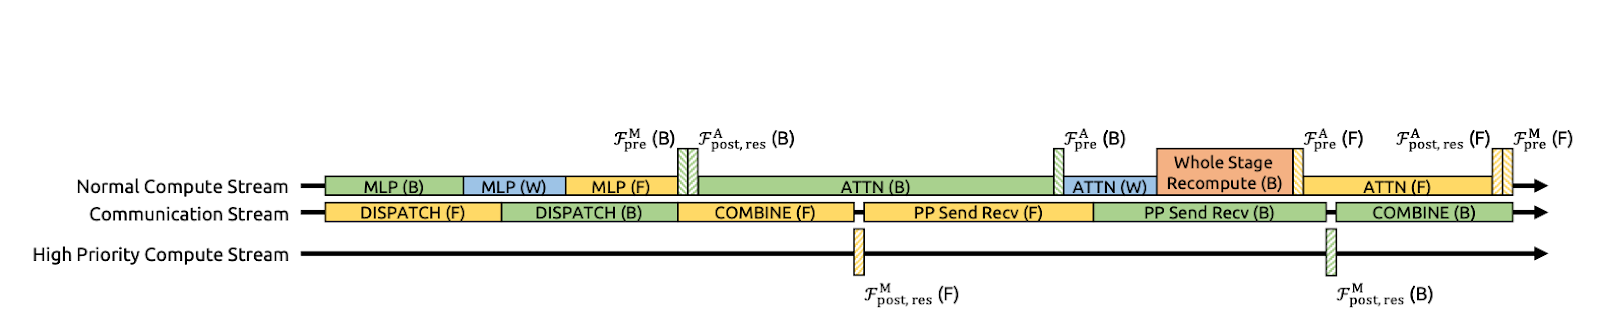
Figuur 3: Communicatie–computatie-overlap voor mHC (mHC-paper)
Kernel-fusie om memory reads/writes te beperken
De auteurs versnellen mHC door meerdere stappen te fuseren tot één GPU-kernel. In plaats van Hlpost, Hlres toe te passen en vervolgens als aparte passes weer samen te voegen in de residuele stroom (waardoor de GPU tussentijdse tensors naar het geheugen moet schrijven en teruglezen), doen ze deze bewerkingen in één pass.
Dit vermindert het geheugenverkeer aanzienlijk. De kernel leest nu ongeveer (n+1)C waarden in plaats van (3n+1)C en schrijft ongeveer nC waarden in plaats van 3nC. Hier is C de hidden size (features per stroom) en n het aantal residuele stromen, dus nC is de grootte van de verbrede residuele status. Minder reads/writes betekent minder databeweging naar en uit het geheugen.
Het paper stelt ook voor om de meeste kernels te implementeren met TileLang om de geheugenbandbreedte beter te benutten.
Recomputatie om activatiegeheugen te beheersen
Multi-stream mHC vergroot het aantal tussenliggende activaties dat je normaal zou moeten opslaan voor backprop, wat GPU-geheugen kan laten ontploffen en kleinere batches of agressiever checkpointen kan afdwingen.
Om dat te vermijden, stelt het paper een simpele truc voor: sla de mHC-intermediates na de forward pass niet op. Herbereken in plaats daarvan de lichte mHC-kernels tijdens de backward pass, terwijl je recomputatie van de dure Transformer-laag F overslaat.
Dit verlaagt de geheugenbelasting en helpt een hogere effectieve throughput te behouden. Een praktische randvoorwaarde is dat deze recomputatieblokken moeten aansluiten op pipeline-stadiumgrenzen; anders wordt pipelinescheduling rommelig.
Communicatiebewuste scheduling met DualPipe-overlap
Op schaal is pipeline-parallelisme gebruikelijk, maar het n-stream ontwerp van mHC vergroot de hoeveelheid data die over stadiumgrenzen heen moet, wat merkbare communicatiestops kan toevoegen.
DeepSeek optimaliseert dit door DualPipe uit te breiden zodat communicatie en compute overlappen aan pipelinegrenzen. Dit betekent dat de GPU’s nuttig werk doen terwijl overdrachten plaatsvinden, in plaats van werkloos te wachten tot send/receive klaar zijn. Ze draaien ook sommige kernels op een high-priority compute-stream, zodat compute de voortgang van communicatie niet blokkeert. Het resultaat is dat de extra communicatiekosten van mHC deels verborgen worden, wat de end-to-end trainingsefficiëntie verbetert
Hotspots
Zelfs als we mHC niet implementeren, is DeepSeek’s benadering een goede manier om te zien waar het systeem echt tijd verliest.
- Long-context-workloads: Lange prompts maken prefill duur omdat attention veel data door het geheugen moet verplaatsen. Tijdens decode groeit de KV-cache door, wat memory reads per token verhoogt. Samen drukken deze op de geheugenbandbreedte en veroorzaken ze vaak fragmentatie of inefficiënte batching.
- MoE-routing en expert-parallelisme: Bij Mixture of Experts (MoE) draait de kost niet alleen om compute. Het gaat om routing, tokenuitwisseling en cross-GPU-communicatie om tokens naar experts te sturen en outputs te verzamelen. DeepSeek’s DualPipe-overlap richt zich op het verbergen van pipelinecommunicatie achter compute, wat MoE op schaal nodig heeft.
- Multi-tenant en small-batch-verkeer: In echte deployments komen verzoeken niet in keurige grote batches binnen. We krijgen kleinere, inconsistente batches, gemengde sequentielengtes en zwakkere cache-hergebruik. Dat schaadt batchingefficiëntie en vergroot tail-latency, waardoor geheugenbandbreedte en scheduling de bottleneck worden.
KV-cache en geheugenverkeer
Hoewel mHC vooral een trainingsidee is, geldt de kernles uit het paper direct voor inference. Het paper richt zich niet alleen op het optimaliseren van FLOPs, maar ook op geheugenverkeer, communicatie en latentie. Het grootste bewijs is long-context decoding, waar de ruwe KV-cache-schatting is:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batch
Voor FP16/BF16 is de waarde van bytes_per_elem 2. Bijvoorbeeld, met een typische vorm (L=32, H=4096, batch=1) is 8K tokens ~4 GB KV, terwijl 128K tokens ~64 GB is. Dus zelfs als compute redelijk blijft, kan het geheugen nog steeds exploderen en raak je gebonden aan bandbreedte.
Daarom richten praktische inference-optimalisaties zich op het verminderen van databeweging met technieken zoals KV-cache-kwantisatie, gepagineerde KV en eviction, efficiënte attention-kernels (FlashAttention-familie), continue batching en shape-bucketing, en communicatiebewuste parallelisatie.
Het doel is de prestatiewinst te behouden zonder een verborgen belasting te betalen in memory reads/writes en synchronisatie.
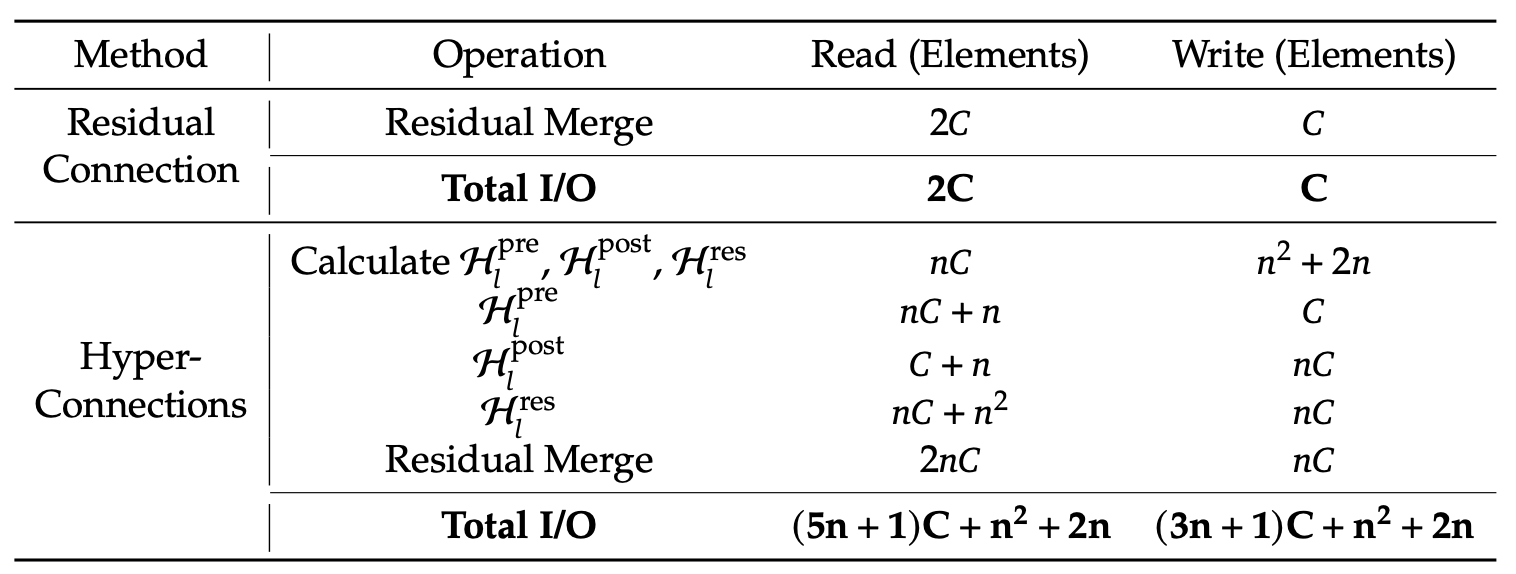
Tabel 1: Vergelijking van geheugentoegangskosten per token (mHC-paper)
DeepSeek meldt dat mHC consequent beter presteert dan de baseline en HC op de meeste benchmarks voor 27B-modellen overtreft, waaronder +2,1% op BBH en +2,3% op DROP vergeleken met HC. Dit laat zien dat mHC zich vertaalt in betere resultaten op schaal.
Conclusie
De belangrijkste les uit dit paper is dat LLM’s opschalen niet alleen een FLOPs-probleem is; het is net zo goed een stabiliteits- en systeemprobleem. Hyper-Connections (HC) vergroten de modelcapaciteit door de residuele stroom uit te breiden en meerdere stromen te laten mengen, maar op grote dieptes stapelt die menging zich op tot een samengestelde mapping die sterk kan afwijken van een identity-pad, wat leidt tot explosie of verdwijning van signaal/gradiënt en trainingsinstortingen.
mHC repareert dit door vangrails te plaatsen op die menging: de residuele mengmatrix wordt beperkt tot dubbel-stochastisch (niet-negatief, rijen/kolommen sommeren tot 1), afgedwongen via Sinkhorn–Knopp, zodat het residuele pad zich gedraagt als een gecontroleerd gewogen gemiddelde en stabiel blijft, zelfs als je veel lagen stapelt.
DeepSeek ziet runtime-efficiëntie ook als onderdeel van de methode. Ze gebruikten kernel-fusie om reads/writes naar high-bandwidth memory te verminderen en selectieve recomputatie om het activatiegeheugen te minimaliseren.
Daarnaast hebben ze DualPipe uitgebreid om communicatie te overlappen met compute, zodat pipeline-stops de winst niet tenietdoen. Het resultaat is niet alleen stabielere training, maar ook betere downstream-prestaties op schaal.
Als je meer wilt leren over LLM-applicatieontwikkeling, raad ik aan om de Developing LLM Applications with LangChain-cursus te bekijken.


DeepSeek’s mHC (Manifold-Constrained Hyper-Connections) pakt een probleem aan waar de meeste teams tegenaan lopen bij het opschalen van LLM’s: je kunt blijven GPUs toevoegen, maar op een gegeven moment wordt trainen instabiel en verbetert de throughput niet meer.
Hier is het kernidee:
Hyper-Connections verbeteren de connectiviteit en capaciteit, maar Manifold-Constrained Hyper-Connections (mHC’s) maken die upgrade stabiel en schaalbaar, zonder de echte knelpunten zoals geheugenbandbreedte en communicatie te negeren.
Als je meer wilt leren over enkele principes uit deze tutorial, raad ik aan om de Transformer Models with PyTorch-cursus en de Deep Learning with PyTorch-cursus te bekijken.
Wat is mHC? Van residuele verbindingen naar Hyper-Connections
In deze sectie leg ik uit waarom we verder moeten gaan dan simpele residuele verbindingen, hoe HC dat probeerde op te lossen en waarom mHC de fix is die het idee op LLM-schaal laat werken.
Figuur 1: Illustraties van paradigmas voor residuele verbindingen (mHC-paper)
Residuele verbindingen (Figuur a) geven elke laag een identity-shortcut, waardoor signalen en gradiënten netjes door zeer diepe netwerken kunnen stromen.
DeepSeek gebruikte dit principe van identity-mapping expliciet als vertrekpunt voor het mHC-paper. Het nadeel is dat een simpele residuele route ook te beperkend is, waardoor weinig informatie-uitwisseling plaatsvindt binnen de residuele stroom.
Hyper-Connections (HC) (Figuur b) waren de logische volgende stap: in plaats van één residuele stroom wordt dit uitgebreid naar n parallelle stromen met leerbare pre-/post-/residuele mappings, zodat stromen kunnen mengen en informatie delen. Dit vergroot de expressiviteit zonder per se de FLOPs per laag te laten exploderen.
Maar op grote schaal loopt HC tegen twee grote problemen aan. Ten eerste, omdat de stromen vrij kunnen mengen in elke laag, stapelen die kleine vermengingen zich op naarmate je dieper gaat. Over veel lagen heen kan het netwerk ophouden zich te gedragen als een nette “skip-connection”, en kunnen signalen of gradiënten exploderen of wegvallen, wat de training instabiel maakt. Ten tweede, zelfs als de extra berekeningen simpel zijn, stijgen de hardwarekosten snel.
Manifold-Constrained Hyper-Connections (mHC) (Figuur c) behouden de extra connectiviteit van HC, maar maken het net zo veilig trainbaar als een ResNet.
Het hoofdpunt is dat mHC de vermenging tussen residuele stromen niet willekeurig laat verlopen, maar die volgens strikte regels afdwingt. In het paper gebeurt dit door de mengmatrix om te zetten in een welgemanierd “gewogen gemiddelde” met behulp van de Sinkhorn–Knopp-procedure. Het resultaat is dat de menging stabiel blijft, zelfs na veel lagen, en signalen en gradiënten niet exploderen of verdwijnen.
Kortom: we zijn van residuele verbindingen naar mHC gegaan omdat we rijkere informatiestromen wilden in plaats van één enkele skip-route.
Belangrijke mHC-concepten
Op hoofdlijnen behoudt mHC het multi-stream mengen van Hyper-Connections, maar zet het harde vangrails op de menging zodat die zich gedraagt als een stabiel, ResNet-achtig skip-pad, zelfs wanneer we honderden lagen stapelen.
De auteurs beperken de residuele mengmatrix
Hlreszodat die zich netjes gedraagt over de diepte, terwijl stromen toch informatie kunnen uitwisselen.Concreet dwingt mHC af dat
Hlresdubbel-stochastisch is: alle elementen zijn niet-negatief en elke rij en kolom somt tot 1. Daardoor gedraagt de residuele stroom zich als een gecontroleerd gewogen gemiddelde.Dit onderstreept dat de mapping niet-expansief is (spectrale norm begrensd door 1), stabiel blijft bij vermenigvuldiging over lagen (gesloten onder multiplicatie), en een intuïtieve interpretatie heeft als middelen/permutatiemenging via de Birkhoff-polytoop. Ook worden de pre-/post-mappings beperkt tot niet-negatief om signaalannulering te vermijden.
Figuur 2: Propagatiestabiliteit van Manifold-Constrained Hyper-Connections (mHC-paper)
Qua implementatie houdt het paper het praktisch door onbegrensde ruwe mappings
Hlpre,HlpostenHlreste berekenen vanuit de multistreamstatus van de huidige laag (ze flattenxlom volledige context te behouden) en ze daarna te projecteren naar de begrensde vormen.HlpreenHlpostworden verkregen met een sigmoid-gebaseerde begrenzing, terwijlHlreswordt geprojecteerd met Sinkhorn–Knopp: exponentiëren om entries positief te maken en vervolgens afwisselend rijen/kolommen normaliseren totdat de sommen 1 zijn.De auteurs melden ook dat ze mHC (met n=4) op schaal implementeerden met slechts ~6,7% overhead in trainingstijd, vooral door het geheugenverkeer agressief te verlagen. Ze hebben delen van RMSNorm herschikt voor efficiëntie, kernel-fusie gebruikt (inclusief het implementeren van Sinkhorn-iteraties in één kernel met een custom backward), het toepassen van
HlpostenHlresgecombineerd met residuele merge om reads/writes te verminderen, selectieve recomputatie gebruikt om het opslaan van grote tussenactivaties te vermijden, en communicatie overlapt in een uitgebreide DualPipe-planning om pipeline-latentie te verbergen.mHC optimaliseren: systeemtechnieken
Alleen stabiliteit is niet genoeg. Als mHC te veel geheugenverkeer of GPU-naar-GPU-communicatie toevoegt, verliezen we op throughput. Daarom koppelden de auteurs de mHC-methode aan een set infrastructuuroptimalisaties die vriendelijk blijven voor de memory wall.
Figuur 3: Communicatie–computatie-overlap voor mHC (mHC-paper)
Kernel-fusie om memory reads/writes te beperken
De auteurs versnellen mHC door meerdere stappen te fuseren tot één GPU-kernel. In plaats van
Hlpost,Hlrestoe te passen en vervolgens als aparte passes weer samen te voegen in de residuele stroom (waardoor de GPU tussentijdse tensors naar het geheugen moet schrijven en teruglezen), doen ze deze bewerkingen in één pass.Dit vermindert het geheugenverkeer aanzienlijk. De kernel leest nu ongeveer
(n+1)Cwaarden in plaats van(3n+1)Cen schrijft ongeveernCwaarden in plaats van3nC. Hier isCde hidden size (features per stroom) ennhet aantal residuele stromen, dusnCis de grootte van de verbrede residuele status. Minder reads/writes betekent minder databeweging naar en uit het geheugen.Het paper stelt ook voor om de meeste kernels te implementeren met TileLang om de geheugenbandbreedte beter te benutten.
Recomputatie om activatiegeheugen te beheersen
Multi-stream mHC vergroot het aantal tussenliggende activaties dat je normaal zou moeten opslaan voor backprop, wat GPU-geheugen kan laten ontploffen en kleinere batches of agressiever checkpointen kan afdwingen.
Om dat te vermijden, stelt het paper een simpele truc voor: sla de mHC-intermediates na de forward pass niet op. Herbereken in plaats daarvan de lichte mHC-kernels tijdens de backward pass, terwijl je recomputatie van de dure Transformer-laag F overslaat.
Dit verlaagt de geheugenbelasting en helpt een hogere effectieve throughput te behouden. Een praktische randvoorwaarde is dat deze recomputatieblokken moeten aansluiten op pipeline-stadiumgrenzen; anders wordt pipelinescheduling rommelig.
Communicatiebewuste scheduling met DualPipe-overlap
Op schaal is pipeline-parallelisme gebruikelijk, maar het n-stream ontwerp van mHC vergroot de hoeveelheid data die over stadiumgrenzen heen moet, wat merkbare communicatiestops kan toevoegen.
DeepSeek optimaliseert dit door DualPipe uit te breiden zodat communicatie en compute overlappen aan pipelinegrenzen. Dit betekent dat de GPU’s nuttig werk doen terwijl overdrachten plaatsvinden, in plaats van werkloos te wachten tot send/receive klaar zijn. Ze draaien ook sommige kernels op een high-priority compute-stream, zodat compute de voortgang van communicatie niet blokkeert. Het resultaat is dat de extra communicatiekosten van mHC deels verborgen worden, wat de end-to-end trainingsefficiëntie verbetert
Hotspots
Zelfs als we mHC niet implementeren, is DeepSeek’s benadering een goede manier om te zien waar het systeem echt tijd verliest.
KV-cache en geheugenverkeer
Hoewel mHC vooral een trainingsidee is, geldt de kernles uit het paper direct voor inference. Het paper richt zich niet alleen op het optimaliseren van FLOPs, maar ook op geheugenverkeer, communicatie en latentie. Het grootste bewijs is long-context decoding, waar de ruwe KV-cache-schatting is:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batchVoor FP16/BF16 is de waarde van
bytes_per_elem2. Bijvoorbeeld, met een typische vorm (L=32, H=4096, batch=1) is 8K tokens ~4 GB KV, terwijl 128K tokens ~64 GB is. Dus zelfs als compute redelijk blijft, kan het geheugen nog steeds exploderen en raak je gebonden aan bandbreedte.Daarom richten praktische inference-optimalisaties zich op het verminderen van databeweging met technieken zoals KV-cache-kwantisatie, gepagineerde KV en eviction, efficiënte attention-kernels (FlashAttention-familie), continue batching en shape-bucketing, en communicatiebewuste parallelisatie.
Het doel is de prestatiewinst te behouden zonder een verborgen belasting te betalen in memory reads/writes en synchronisatie.
Tabel 1: Vergelijking van geheugentoegangskosten per token (mHC-paper)
DeepSeek meldt dat mHC consequent beter presteert dan de baseline en HC op de meeste benchmarks voor 27B-modellen overtreft, waaronder +2,1% op BBH en +2,3% op DROP vergeleken met HC. Dit laat zien dat mHC zich vertaalt in betere resultaten op schaal.
Conclusie
De belangrijkste les uit dit paper is dat LLM’s opschalen niet alleen een FLOPs-probleem is; het is net zo goed een stabiliteits- en systeemprobleem. Hyper-Connections (HC) vergroten de modelcapaciteit door de residuele stroom uit te breiden en meerdere stromen te laten mengen, maar op grote dieptes stapelt die menging zich op tot een samengestelde mapping die sterk kan afwijken van een identity-pad, wat leidt tot explosie of verdwijning van signaal/gradiënt en trainingsinstortingen.
mHC repareert dit door vangrails te plaatsen op die menging: de residuele mengmatrix wordt beperkt tot dubbel-stochastisch (niet-negatief, rijen/kolommen sommeren tot 1), afgedwongen via Sinkhorn–Knopp, zodat het residuele pad zich gedraagt als een gecontroleerd gewogen gemiddelde en stabiel blijft, zelfs als je veel lagen stapelt.
DeepSeek ziet runtime-efficiëntie ook als onderdeel van de methode. Ze gebruikten kernel-fusie om reads/writes naar high-bandwidth memory te verminderen en selectieve recomputatie om het activatiegeheugen te minimaliseren.
Daarnaast hebben ze DualPipe uitgebreid om communicatie te overlappen met compute, zodat pipeline-stops de winst niet tenietdoen. Het resultaat is niet alleen stabielere training, maar ook betere downstream-prestaties op schaal.
Als je meer wilt leren over LLM-applicatieontwikkeling, raad ik aan om de Developing LLM Applications with LangChain-cursus te bekijken.