DeepSeek 的 mHC(Manifold-Constrained Hyper-Connections,流形约束超连接)针对的是大多数团队在扩展大模型时都会遇到的问题:您可以不断增加 GPU,但在某个点上,训练会变得不稳定,吞吐量也不再提升。
核心思想如下:
- 在大规模下,真正的限制往往是内存带宽、GPU 之间的通信,以及延迟开销。
- 超连接(HC)试图通过让信息经由更丰富的残差路径流动来提升模型容量,同时不过度增加每层的 FLOPs。但这种额外的混合会破坏最初让残差网络稳定的“恒等捷径”,从而导致训练发散。
- mHC 通过约束这些残差路径的混合方式来修复上述问题。它强制残差混合表现得像一个良性的加权平均(一个双随机矩阵,使用 Sinkhorn–Knopp 强制实现),从而防止信号和梯度爆炸或消失。
超连接提升了连通性和容量,而流形约束超连接(mHC)则让这种升级在不忽视内存带宽和通信等真实瓶颈的前提下,实现稳定且可扩展的训练。
如果您想进一步了解本教程涵盖的一些原理,建议 查看 Transformer Models with PyTorch 课程以及 Deep Learning with PyTorch 课程。
什么是 mHC?从残差连接到超连接
本节将拆解为何需要超越普通残差连接、HC 如何尝试解决这一问题,以及为何 mHC 是让这一思路在大模型尺度上可行的修复方案。
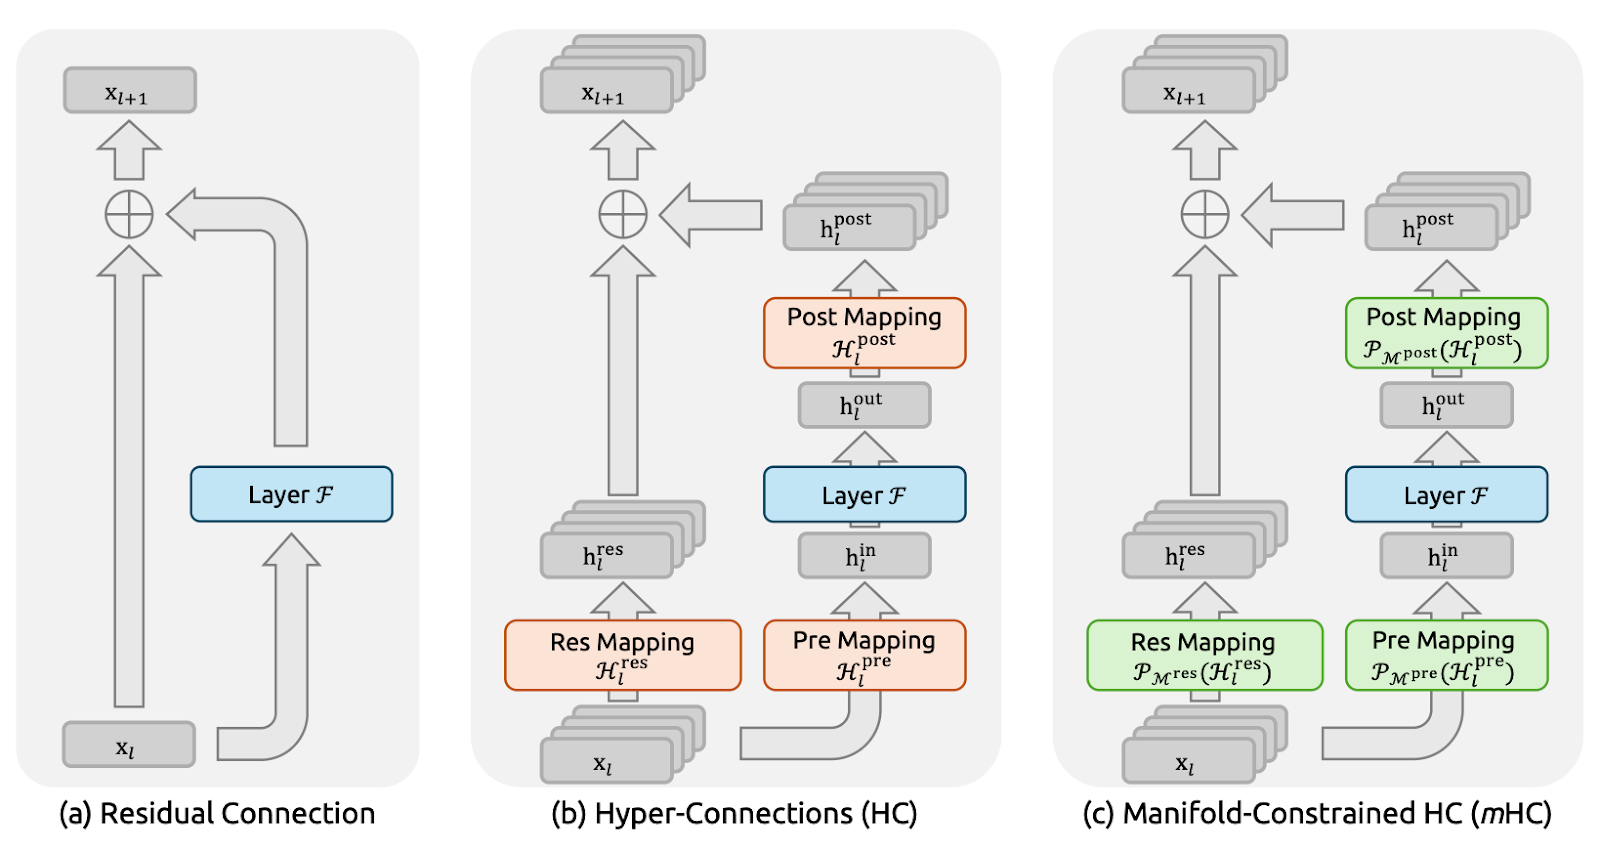
图 1:残差连接范式示意图(mHC 论文)
残差连接(图 a)为每一层提供了恒等捷径,使信号与梯度能够在非常深的网络中顺畅传播。
DeepSeek 在 mHC 论文中明确以这一恒等映射原则为出发点。其不足在于,单一的残差路径过于受限,难以在残差流内部进行充分的信息交换。
超连接(HC,图 b)是自然而然的下一步:它不再只有一条残差流,而是扩展为 n 条并行流,并增加可学习的前/后/残差映射,使各流可以混合并共享信息。这样可以在不必然激增每层 FLOPs 的情况下提升表达能力。
但在大规模下,HC 会遇到两个主要问题。首先,由于各流在每一层都可以自由混合,这些小的混合会随着深度累积。经过多层后,网络可能不再像干净的“跳连”,信号或梯度会爆炸或衰减,训练变得不稳定。其次,即使新增的计算很简单,硬件成本也会迅速上升。
流形约束超连接(mHC,图 c)保留了 HC 的额外连通性,但让其像ResNet 一样易于训练。
其主要思想是,不再允许残差流以任意方式混合,而是强制其遵循严格规则。论文通过将混合矩阵变为一个良性的“加权平均”,并使用名为 Sinkhorn–Knopp 的过程来实现。结果是,即使经过许多层,混合依旧保持稳定,信号和梯度不会爆炸或消失。
简言之,我们从残差连接走向 mHC,是为了获得比单一路径更丰富的信息流动。
mHC 关键概念
从高层看,mHC 保留了超连接的多流混合,但在混合上设置了硬性护栏,使其即便在堆叠数百层时,也能像 ResNet 风格的跳连一样稳定。
作者对残差混合矩阵 Hlres 施加约束,使其在深度方向保持良性,同时仍允许各流交换信息。
具体而言,mHC 强制 Hlres 为双随机矩阵,即所有元素非负,且每行与每列之和为 1。这使残差流表现为一种可控的加权平均。
这强调了映射的非扩张性(谱范数不超过 1)、在层间相乘时保持稳定(在乘法下封闭),并可通过 Birkhoff 多胞体给予直观的“作为平均/置换混合”的解释。同时还对前/后映射施加非负约束以避免信号相互抵消。
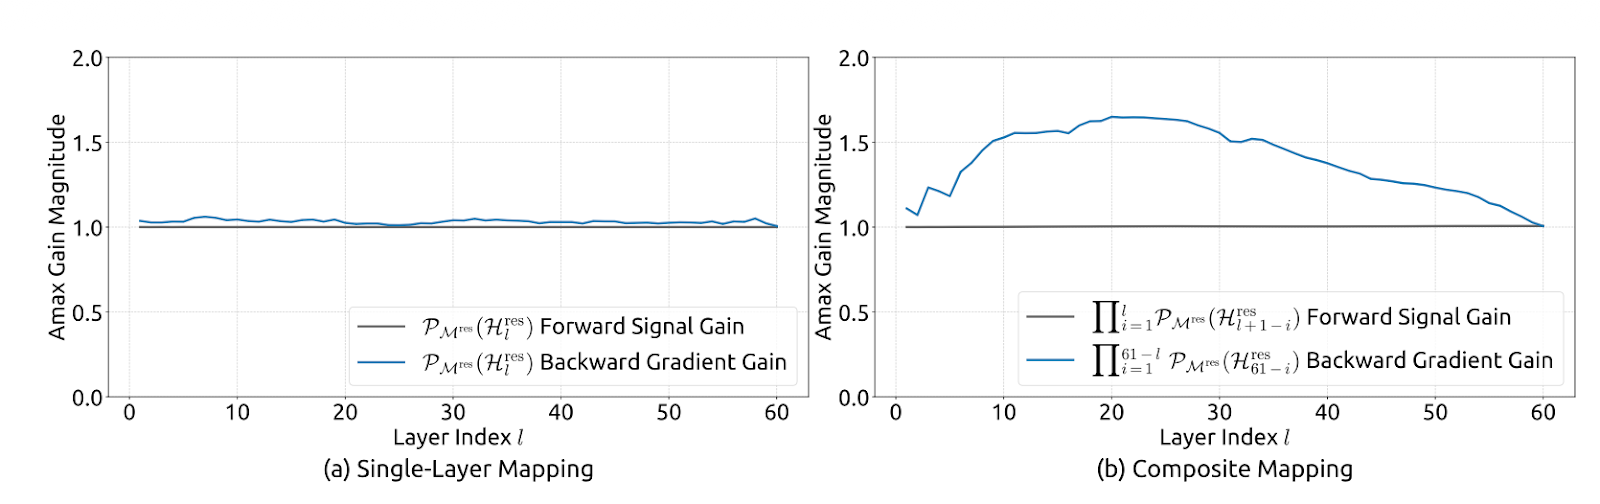
图 2:流形约束超连接的传播稳定性(mHC 论文)
在实现上,论文保持了实用性:先从当前层的多流状态计算无约束的原始映射 Hlpre、 Hlpost 和 Hlres(将 xl 展平以保留完整上下文),再将它们投影到受约束的形式。Hlpre 和 Hlpost 通过基于 sigmoid 的约束获得,而 Hlres 则使用 Sinkhorn–Knopp:先指数化使条目为正,再交替进行行/列归一化直到和为 1。
作者还报告在大规模下以 n=4 实现 mHC 时,训练时开销仅约 ~6.7%,主要得益于大幅减少内存流量。他们对 RMSNorm 的部分进行了重排以提升效率,使用内核融合(包括将 Sinkhorn 迭代实现在单一内核中并自定义反向传播),将 Hlpost 与 Hlres 的应用与残差合并进行融合以减少读写,采用选择性重计算以避免存储大型中间激活,并在扩展的 DualPipe 调度中重叠通信以隐藏流水线阶段延迟。
优化 mHC:系统层技巧
仅有稳定性还不够。如果 mHC 带来过多的内存流量或 GPU 间通信,我们的吞吐量会下降。因此,作者将 mHC 方法与一系列面向“内存墙”友好的基础设施优化配套使用。
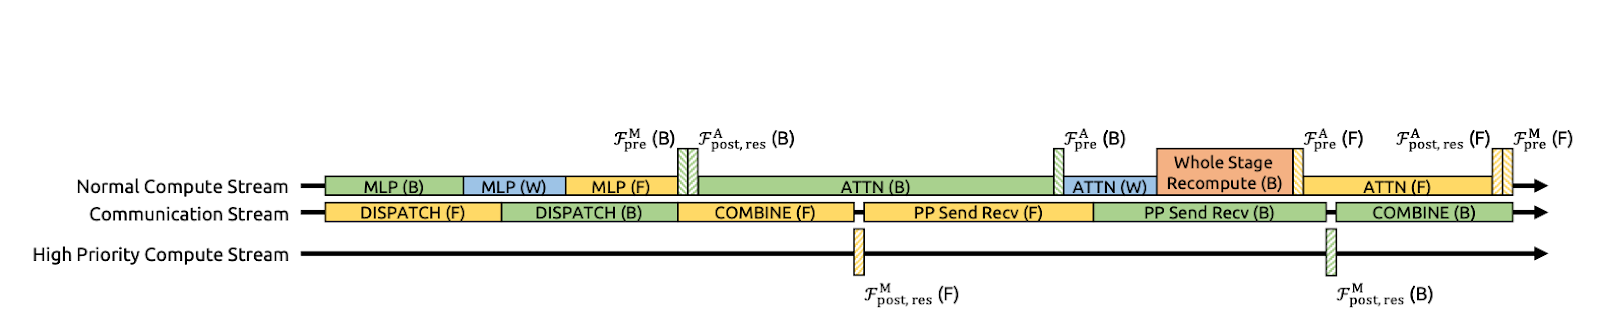
图 3:mHC 的通信-计算重叠(mHC 论文)
通过内核融合减少内存读/写
作者通过将多个步骤融合到一个 GPU 内核来加速 mHC。与其将 Hlpost、Hlres 的应用以及残差回并各自单独执行(这会迫使 GPU 将中间张量写回内存再读出),不如在单次执行中完成这些操作。
这样能显著削减内存流量。该内核现在大约读取 (n+1)C 个值而非 (3n+1)C,写入约 nC 个值而非 3nC。其中,C 为隐藏维度(每条流的特征数),n 为残差流数量,因此 nC 是加宽后的残差状态大小。更少的读写意味着更少的数据在内存与计算单元之间搬运。
论文还建议使用 TileLang 来实现大多数内核,以更好地利用内存带宽。
通过重计算控制激活内存
多流 mHC 会增加通常为反向传播而需存储的中间激活量,可能导致 GPU 内存爆炸,并被迫采用更小的批量或更激进的检查点策略。
为避免这一点,论文提出了一个简单技巧:在前向传播后不存储 mHC 的中间结果。相反,在反向传播时对轻量级的 mHC 内核进行重计算,同时跳过对昂贵的 Transformer 层 F 的重算。
这能降低内存压力,并有助于维持更高的有效吞吐量。一个实际约束是,这些重计算块应与流水线阶段边界对齐,否则会使流水线调度变得复杂。
带有 DualPipe 重叠的通信感知调度
在大规模训练中,流水线并行很常见,但 mHC 的 n 流设计会增加跨阶段边界需要传输的数据量,从而带来明显的通信停顿。
DeepSeek 通过扩展 DualPipe,使通信与计算在流水线边界处发生重叠进行优化。也就是说,GPU 在传输期间仍能执行有用计算,而不是空等收发完成。他们还在高优先级计算流上运行部分内核,以避免计算阻塞通信进度。结果是部分隐藏了 mHC 带来的额外通信成本,提升了端到端训练效率。
热点
即使我们不实现 mHC,DeepSeek 的框架也有助于定位系统实际耗时之处。
- 长上下文工作负载:长提示会让预填充阶段开销高昂,因为注意力需要在内存中搬运大量数据。解码阶段,KV 缓存不断增长,导致每个 token 的内存读取增加。两者叠加将推高内存带宽上限,并常引发碎片化或低效批处理。
- MoE 路由与专家并行:在专家混合(MoE)中,成本不止在计算本身。还包括路由、token 交换,以及为将 token 发送至专家并汇总输出而需要的跨 GPU 通信。DeepSeek 的 DualPipe 重叠旨在将流水线通信隐藏在计算之后,这在大规模 MoE 中尤为需要。
- 多租户与小批量流量:在真实部署中,请求并不会以整齐的大批量到达。我们会遇到更小且不一致的批量、序列长度参差不齐、缓存复用较弱。这会损害批处理效率并抬高尾部延迟,使内存带宽与调度成为瓶颈。
KV 缓存与内存流量
尽管 mHC 主要是训练上的理念,但论文的核心经验也直接适用于推理。论文关注的不仅是 FLOPs,还包括内存流量、通信与延迟。最直观的例证是长上下文解码,其中 KV 缓存的粗略估计为:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batch
对于 FP16/BF16,bytes_per_elem 为 2。以常见形状(L=32,H=4096,batch=1)为例,8K tokens 约为 ~4 GB 的 KV,而 128K tokens 约为 ~64 GB,因此即使计算仍然可接受,内存也可能爆炸,进而受制于带宽。
这就是为什么实用的推理优化会聚焦于减少内存搬运,例如 KV 缓存量化、分页 KV 与淘汰、优efficient 的注意力内核(FlashAttention 系列)、连续批处理与形状分桶、以及通信感知并行。
目标是在不为内存读写与同步支付隐性成本的情况下保留性能收益。
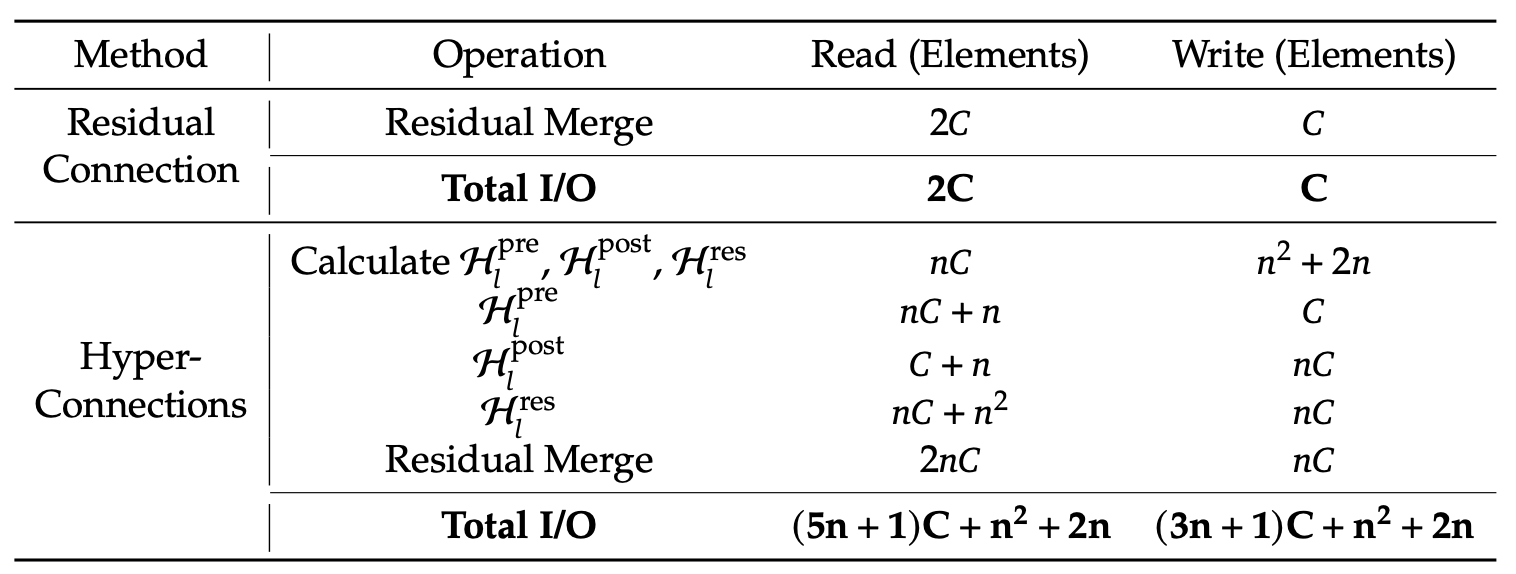
表 1:每个 token 的内存访问成本对比(mHC 论文)
DeepSeek 报告称,在 27B 模型的大多数基准上,mHC 一贯优于基线并超过 HC,例如在 BBH 上提升 +2.1%,在 DROP 上提升 +2.3%(相较于 HC)。这表明 mHC 在大规模下确实带来更好的效果。
总结
这篇论文的要点是:扩展大模型不仅是 FLOPs 问题,同样也是稳定性与系统问题。超连接(HC)通过扩展残差流、允许多流混合来增强模型容量,但在很深的网络中,这种混合会复合成偏离恒等路径的映射,导致信号/梯度爆炸或消失,进而训练崩溃。
mHC 通过对残差混合矩阵施加双随机(非负、行列和为 1)的约束,并借助 Sinkhorn–Knopp 加以实现,为混合设置护栏,使残差路径表现为可控的加权平均,即便堆叠大量层也保持稳定。
DeepSeek 还将运行时效率视为方法的一部分。他们通过内核融合减少高带宽内存读写,并通过选择性重计算来最小化激活内存。
此外,他们扩展了 DualPipe,使通信与计算重叠,避免流水线停顿抹去增益。结果不仅是训练更稳定,也带来了大规模下更好的下游表现。
如果您想进一步学习 LLM 应用开发,建议查看 Developing LLM Applications with LangChain 课程。


DeepSeek 的 mHC(Manifold-Constrained Hyper-Connections,流形约束超连接)针对的是大多数团队在扩展大模型时都会遇到的问题:您可以不断增加 GPU,但在某个点上,训练会变得不稳定,吞吐量也不再提升。
核心思想如下:
超连接提升了连通性和容量,而流形约束超连接(mHC)则让这种升级在不忽视内存带宽和通信等真实瓶颈的前提下,实现稳定且可扩展的训练。
如果您想进一步了解本教程涵盖的一些原理,建议 查看 Transformer Models with PyTorch 课程以及 Deep Learning with PyTorch 课程。
什么是 mHC?从残差连接到超连接
本节将拆解为何需要超越普通残差连接、HC 如何尝试解决这一问题,以及为何 mHC 是让这一思路在大模型尺度上可行的修复方案。
图 1:残差连接范式示意图(mHC 论文)
残差连接(图 a)为每一层提供了恒等捷径,使信号与梯度能够在非常深的网络中顺畅传播。
DeepSeek 在 mHC 论文中明确以这一恒等映射原则为出发点。其不足在于,单一的残差路径过于受限,难以在残差流内部进行充分的信息交换。
超连接(HC,图 b)是自然而然的下一步:它不再只有一条残差流,而是扩展为 n 条并行流,并增加可学习的前/后/残差映射,使各流可以混合并共享信息。这样可以在不必然激增每层 FLOPs 的情况下提升表达能力。
但在大规模下,HC 会遇到两个主要问题。首先,由于各流在每一层都可以自由混合,这些小的混合会随着深度累积。经过多层后,网络可能不再像干净的“跳连”,信号或梯度会爆炸或衰减,训练变得不稳定。其次,即使新增的计算很简单,硬件成本也会迅速上升。
流形约束超连接(mHC,图 c)保留了 HC 的额外连通性,但让其像ResNet 一样易于训练。
其主要思想是,不再允许残差流以任意方式混合,而是强制其遵循严格规则。论文通过将混合矩阵变为一个良性的“加权平均”,并使用名为 Sinkhorn–Knopp 的过程来实现。结果是,即使经过许多层,混合依旧保持稳定,信号和梯度不会爆炸或消失。
简言之,我们从残差连接走向 mHC,是为了获得比单一路径更丰富的信息流动。
mHC 关键概念
从高层看,mHC 保留了超连接的多流混合,但在混合上设置了硬性护栏,使其即便在堆叠数百层时,也能像 ResNet 风格的跳连一样稳定。
作者对残差混合矩阵
Hlres施加约束,使其在深度方向保持良性,同时仍允许各流交换信息。具体而言,mHC 强制
Hlres为双随机矩阵,即所有元素非负,且每行与每列之和为 1。这使残差流表现为一种可控的加权平均。这强调了映射的非扩张性(谱范数不超过 1)、在层间相乘时保持稳定(在乘法下封闭),并可通过 Birkhoff 多胞体给予直观的“作为平均/置换混合”的解释。同时还对前/后映射施加非负约束以避免信号相互抵消。
图 2:流形约束超连接的传播稳定性(mHC 论文)
在实现上,论文保持了实用性:先从当前层的多流状态计算无约束的原始映射
Hlpre、Hlpost和Hlres(将xl展平以保留完整上下文),再将它们投影到受约束的形式。Hlpre和Hlpost通过基于 sigmoid 的约束获得,而Hlres则使用 Sinkhorn–Knopp:先指数化使条目为正,再交替进行行/列归一化直到和为 1。作者还报告在大规模下以 n=4 实现 mHC 时,训练时开销仅约 ~6.7%,主要得益于大幅减少内存流量。他们对 RMSNorm 的部分进行了重排以提升效率,使用内核融合(包括将 Sinkhorn 迭代实现在单一内核中并自定义反向传播),将
Hlpost与Hlres的应用与残差合并进行融合以减少读写,采用选择性重计算以避免存储大型中间激活,并在扩展的 DualPipe 调度中重叠通信以隐藏流水线阶段延迟。优化 mHC:系统层技巧
仅有稳定性还不够。如果 mHC 带来过多的内存流量或 GPU 间通信,我们的吞吐量会下降。因此,作者将 mHC 方法与一系列面向“内存墙”友好的基础设施优化配套使用。
图 3:mHC 的通信-计算重叠(mHC 论文)
通过内核融合减少内存读/写
作者通过将多个步骤融合到一个 GPU 内核来加速 mHC。与其将
Hlpost、Hlres的应用以及残差回并各自单独执行(这会迫使 GPU 将中间张量写回内存再读出),不如在单次执行中完成这些操作。这样能显著削减内存流量。该内核现在大约读取
(n+1)C个值而非(3n+1)C,写入约nC个值而非3nC。其中,C为隐藏维度(每条流的特征数),n为残差流数量,因此nC是加宽后的残差状态大小。更少的读写意味着更少的数据在内存与计算单元之间搬运。论文还建议使用 TileLang 来实现大多数内核,以更好地利用内存带宽。
通过重计算控制激活内存
多流 mHC 会增加通常为反向传播而需存储的中间激活量,可能导致 GPU 内存爆炸,并被迫采用更小的批量或更激进的检查点策略。
为避免这一点,论文提出了一个简单技巧:在前向传播后不存储 mHC 的中间结果。相反,在反向传播时对轻量级的 mHC 内核进行重计算,同时跳过对昂贵的 Transformer 层 F 的重算。
这能降低内存压力,并有助于维持更高的有效吞吐量。一个实际约束是,这些重计算块应与流水线阶段边界对齐,否则会使流水线调度变得复杂。
带有 DualPipe 重叠的通信感知调度
在大规模训练中,流水线并行很常见,但 mHC 的 n 流设计会增加跨阶段边界需要传输的数据量,从而带来明显的通信停顿。
DeepSeek 通过扩展 DualPipe,使通信与计算在流水线边界处发生重叠进行优化。也就是说,GPU 在传输期间仍能执行有用计算,而不是空等收发完成。他们还在高优先级计算流上运行部分内核,以避免计算阻塞通信进度。结果是部分隐藏了 mHC 带来的额外通信成本,提升了端到端训练效率。
热点
即使我们不实现 mHC,DeepSeek 的框架也有助于定位系统实际耗时之处。
KV 缓存与内存流量
尽管 mHC 主要是训练上的理念,但论文的核心经验也直接适用于推理。论文关注的不仅是 FLOPs,还包括内存流量、通信与延迟。最直观的例证是长上下文解码,其中 KV 缓存的粗略估计为:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batch对于 FP16/BF16,
bytes_per_elem为 2。以常见形状(L=32,H=4096,batch=1)为例,8K tokens 约为 ~4 GB 的 KV,而 128K tokens 约为 ~64 GB,因此即使计算仍然可接受,内存也可能爆炸,进而受制于带宽。这就是为什么实用的推理优化会聚焦于减少内存搬运,例如 KV 缓存量化、分页 KV 与淘汰、优efficient 的注意力内核(FlashAttention 系列)、连续批处理与形状分桶、以及通信感知并行。
目标是在不为内存读写与同步支付隐性成本的情况下保留性能收益。
表 1:每个 token 的内存访问成本对比(mHC 论文)
DeepSeek 报告称,在 27B 模型的大多数基准上,mHC 一贯优于基线并超过 HC,例如在 BBH 上提升 +2.1%,在 DROP 上提升 +2.3%(相较于 HC)。这表明 mHC 在大规模下确实带来更好的效果。
总结
这篇论文的要点是:扩展大模型不仅是 FLOPs 问题,同样也是稳定性与系统问题。超连接(HC)通过扩展残差流、允许多流混合来增强模型容量,但在很深的网络中,这种混合会复合成偏离恒等路径的映射,导致信号/梯度爆炸或消失,进而训练崩溃。
mHC 通过对残差混合矩阵施加双随机(非负、行列和为 1)的约束,并借助 Sinkhorn–Knopp 加以实现,为混合设置护栏,使残差路径表现为可控的加权平均,即便堆叠大量层也保持稳定。
DeepSeek 还将运行时效率视为方法的一部分。他们通过内核融合减少高带宽内存读写,并通过选择性重计算来最小化激活内存。
此外,他们扩展了 DualPipe,使通信与计算重叠,避免流水线停顿抹去增益。结果不仅是训练更稳定,也带来了大规模下更好的下游表现。
如果您想进一步学习 LLM 应用开发,建议查看 Developing LLM Applications with LangChain 课程。