mHC (Manifold-Constrained Hyper-Connections) của DeepSeek giải quyết một vấn đề mà hầu hết các đội ngũ gặp phải khi mở rộng LLM: bạn có thể tiếp tục thêm GPU, nhưng đến một thời điểm, quá trình huấn luyện trở nên bất ổn và thông lượng ngừng cải thiện.
Ý tưởng cốt lõi như sau:
- Ở quy mô lớn, các giới hạn thực tế thường là băng thông bộ nhớ, truyền thông giữa GPU và độ trễ.
- Hyper-Connections (HC) cố gắng cải thiện năng lực mô hình bằng cách cho phép thông tin chảy qua các đường tắt dư phong phú hơn mà không tăng FLOPs mỗi lớp quá nhiều. Nhưng sự pha trộn bổ sung đó có thể làm hỏng “đường tắt đồng nhất” vốn giúp mạng dư ổn định ngay từ đầu, khiến huấn luyện sụp đổ.
- mHC khắc phục điều này bằng cách ràng buộc cách các nhánh dư trộn lẫn. Việc trộn dư bị buộc phải hành xử như một trung bình có trọng số chuẩn mực (ma trận lưỡng suy rộng, được áp đặt bằng Sinkhorn–Knopp), giúp tín hiệu và gradient không bùng nổ hay tiêu biến.
Hyper-Connections cải thiện khả năng kết nối và năng lực, còn Manifold-Constrained Hyper-Connections (mHC) biến nâng cấp đó thành ổn định và có thể mở rộng, đồng thời không bỏ qua các nút thắt cổ chai thực như băng thông bộ nhớ và truyền thông.
Nếu bạn muốn tìm hiểu thêm về một số nguyên lý được đề cập trong hướng dẫn này, tôi khuyến nghị xem khóa học Transformer Models with PyTorch và khóa học Deep Learning with PyTorch.
mHC là gì? Từ kết nối dư đến Hyper-Connections
Trong phần này, tôi sẽ phân tích nhu cầu vượt ra khỏi các kết nối dư thuần túy, cách HC cố gắng giải quyết điều đó và vì sao mHC là cách sửa giúp ý tưởng hoạt động ở quy mô LLM.
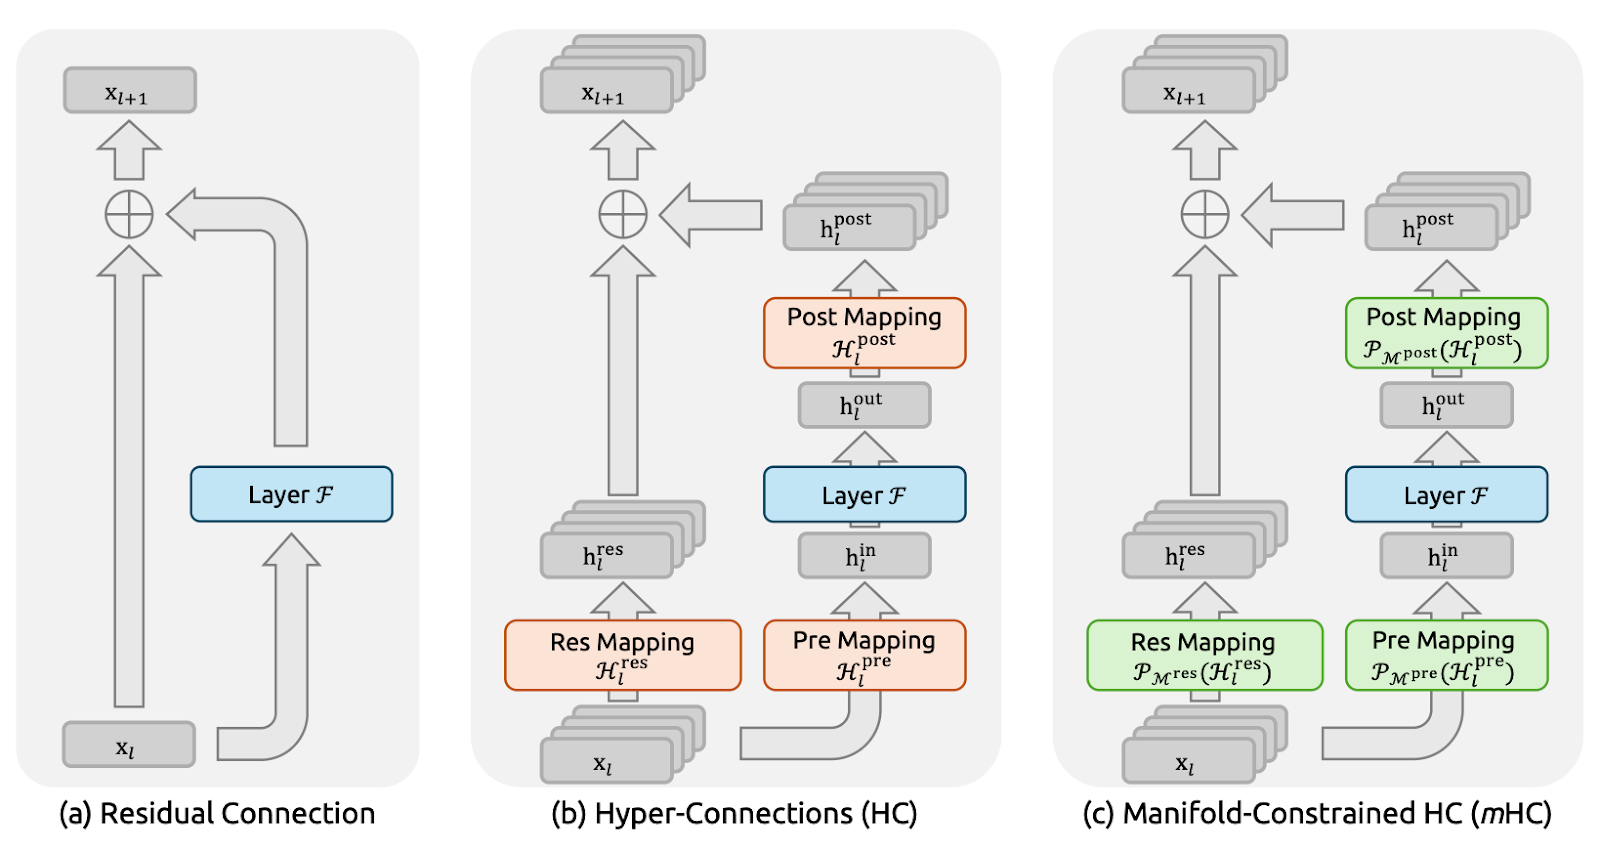
Hình 1: Minh họa các mô hình kết nối dư (bài báo mHC)
Kết nối dư (Hình a) cung cấp cho mỗi lớp một đường tắt đồng nhất, cho phép tín hiệu và gradient chảy mượt qua các mạng rất sâu.
DeepSeek đã sử dụng rõ ràng nguyên lý ánh xạ đồng nhất này làm điểm xuất phát cho bài báo mHC. Điểm hạn chế là một đường dư thuần túy cũng quá gò bó, nên không cho phép trao đổi nhiều thông tin trong dòng dư.
Hyper-Connections (HC) (Hình b) là bước tiếp theo tự nhiên: thay vì một dòng dư, mở rộng thành n dòng song song và thêm các ánh xạ học được trước/sau/dư để các dòng có thể trộn và chia sẻ thông tin. Điều này tăng tính biểu đạt mà không nhất thiết làm bùng nổ FLOPs mỗi lớp.
Nhưng ở quy mô lớn, HC gặp hai vấn đề lớn. Thứ nhất, vì các dòng trộn tự do ở mọi lớp, những pha trộn nhỏ tích tụ dần khi đi sâu hơn. Qua nhiều lớp, mạng có thể không còn hành xử như một “skip connection” gọn gàng, và tín hiệu hoặc gradient có thể bùng nổ hoặc tiêu biến, làm huấn luyện bất ổn. Thứ hai, ngay cả khi phép tính bổ sung đơn giản, chi phí phần cứng cũng tăng nhanh.
Manifold-Constrained Hyper-Connections (mHC) (Hình c) giữ lại khả năng kết nối bổ sung của HC nhưng khiến việc huấn luyện an toàn như một ResNet.
Ý chính là thay vì cho phép các dòng dư trộn theo bất kỳ cách nào, mHC buộc việc trộn phải tuân thủ các quy tắc nghiêm ngặt. Trong bài báo, điều này được thực hiện bằng cách biến ma trận trộn thành một “trung bình có trọng số” chuẩn mực, sử dụng thủ tục gọi là Sinkhorn–Knopp. Kết quả là ngay cả sau nhiều lớp, việc trộn vẫn ổn định, và tín hiệu cũng như gradient không bùng nổ hay biến mất.
Tóm lại, chúng ta chuyển từ kết nối dư sang mHC vì muốn luồng thông tin phong phú hơn thay vì chỉ một đường tắt duy nhất.
Các khái niệm chính của mHC
Ở mức khái quát, mHC giữ cơ chế trộn đa dòng của Hyper-Connections, nhưng đặt những “lan can” cứng lên việc trộn để nó hành xử như một đường tắt kiểu ResNet ổn định, ngay cả khi xếp chồng hàng trăm lớp.
Các tác giả ràng buộc ma trận trộn dư Hlres để nó luôn chuẩn mực theo chiều sâu, đồng thời vẫn cho phép các dòng trao đổi thông tin.
Cụ thể, mHC buộc Hlres phải là lưỡng suy rộng, tức mọi phần tử không âm, và mỗi hàng cũng như mỗi cột có tổng bằng 1. Nhờ vậy dòng dư hành xử như một trung bình có trọng số được kiểm soát.
Điểm này làm nổi bật rằng ánh xạ là không giãn (chuẩn phổ bị chặn bởi 1), vẫn ổn định khi nhân qua nhiều lớp (đóng dưới phép nhân), và có cách hiểu trực quan về trộn như phép trung bình/pha trộn hoán vị thông qua đa diện Birkhoff. Nó cũng ràng buộc các ánh xạ trước/sau phải không âm để tránh triệt tiêu tín hiệu.
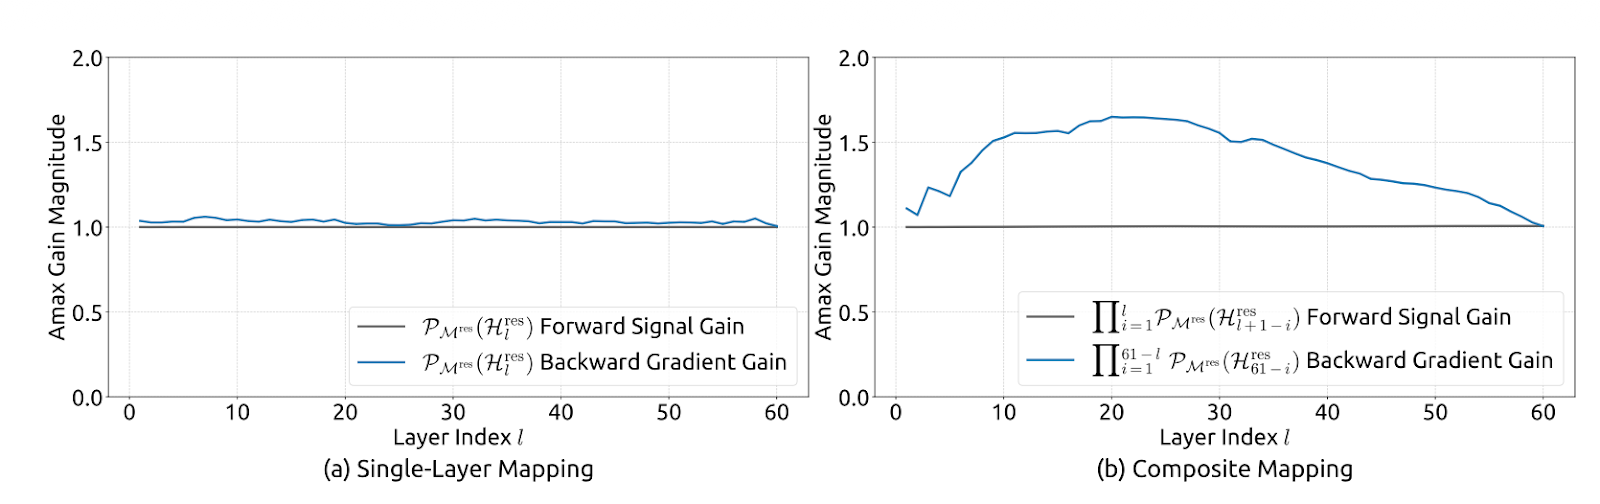
Hình 2: Ổn định lan truyền của Manifold-Constrained Hyper-Connections (bài báo mHC)
Về triển khai, bài báo giữ tính thực tiễn bằng cách tính các ánh xạ thô chưa ràng buộc Hlpre, Hlpost và Hlres từ trạng thái đa dòng của lớp hiện tại (họ làm phẳng xl để giữ toàn bộ ngữ cảnh), rồi chiếu chúng vào dạng bị ràng buộc. Hlpre và Hlpost được áp ràng buộc dựa trên sigmoid, còn Hlres được chiếu bằng Sinkhorn–Knopp: lũy thừa để làm phần tử dương, rồi luân phiên chuẩn hóa hàng/cột cho đến khi tổng bằng 1.
Các tác giả cũng báo cáo triển khai mHC (với n=4) ở quy mô lớn chỉ với chi phí huấn luyện tăng ~6,7%, chủ yếu nhờ cắt giảm mạnh lưu lượng bộ nhớ. Họ sắp xếp lại các phần của RMSNorm để hiệu quả hơn, dùng hợp nhất kernel (bao gồm hiện thực vòng lặp Sinkhorn trong một kernel duy nhất với đạo hàm ngược tùy chỉnh), hợp nhất việc áp dụng Hlpost và Hlres với bước gộp dư để giảm đọc/ghi, dùng tính toán lại có chọn lọc để tránh lưu các kích hoạt trung gian lớn, và chồng lấp truyền thông trong lịch DualPipe mở rộng để che giấu độ trễ giữa các giai đoạn pipeline.
Tối ưu mHC: Kỹ thuật hệ thống
Chỉ ổn định thôi là chưa đủ. Nếu mHC thêm quá nhiều lưu lượng bộ nhớ hoặc truyền thông giữa GPU, chúng ta sẽ mất thông lượng. Vì vậy, các tác giả kết hợp phương pháp mHC với một tập tối ưu hạ tầng được thiết kế để thân thiện với “bức tường bộ nhớ”.
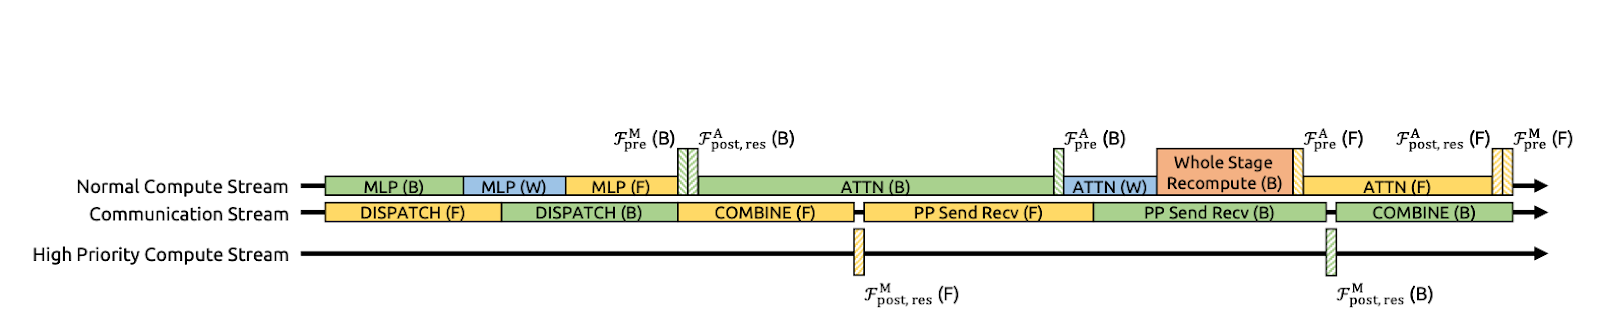
Hình 3: Chồng lấp truyền thông–tính toán cho mHC (bài báo mHC)
Hợp nhất kernel để giảm đọc/ghi bộ nhớ
Các tác giả tăng tốc mHC bằng cách hợp nhất nhiều bước vào một kernel GPU. Thay vì áp dụng Hlpost, Hlres, rồi gộp lại vào dòng dư qua các lượt riêng (khiến GPU phải ghi tensor trung gian ra bộ nhớ rồi đọc lại), họ thực hiện các thao tác này trong một lượt duy nhất.
Cách này cắt giảm đáng kể lưu lượng bộ nhớ. Kernel giờ đọc khoảng (n+1)C giá trị thay vì (3n+1)C và ghi khoảng nC giá trị thay vì 3nC. Ở đây, C là kích thước ẩn (số đặc trưng mỗi dòng) và n là số dòng dư, nên nC là kích thước trạng thái dư mở rộng. Ít đọc/ghi hơn nghĩa là ít dữ liệu phải di chuyển tới/về bộ nhớ hơn.
Bài báo cũng gợi ý hiện thực phần lớn kernel bằng TileLang để tận dụng băng thông bộ nhớ tốt hơn.
Tính toán lại để kiểm soát bộ nhớ kích hoạt
mHC đa dòng làm tăng lượng kích hoạt trung gian bạn thường phải lưu cho lan truyền ngược, có thể làm nổ bộ nhớ GPU và buộc phải giảm batch hoặc checkpoint mạnh tay hơn.
Để tránh điều đó, bài báo đề xuất một mẹo đơn giản: không lưu các trung gian của mHC sau lượt tiến. Thay vào đó, tính toán lại các kernel mHC nhẹ trong lượt lùi, đồng thời bỏ qua việc tính lại khối Transformer F tốn kém.
Điều này giảm áp lực bộ nhớ và giúp duy trì thông lượng hiệu dụng cao hơn. Một ràng buộc thực tế là các khối tính lại này nên trùng với ranh giới giai đoạn pipeline; nếu không, việc lập lịch pipeline sẽ trở nên rối rắm.
Lập lịch nhận thức truyền thông với chồng lấp DualPipe
Ở quy mô lớn, song song đường ống là phổ biến, nhưng thiết kế n dòng của mHC làm tăng lượng dữ liệu phải vượt qua ranh giới giai đoạn, có thể thêm các khoảng dừng truyền thông đáng kể.
DeepSeek tối ưu bằng cách mở rộng DualPipe để truyền thông và tính toán chồng lấp tại ranh giới pipeline. Điều này nghĩa là GPU làm việc hữu ích trong khi truyền tải diễn ra, thay vì ngồi chờ gửi/nhận hoàn tất. Họ cũng chạy một số kernel trên luồng tính toán ưu tiên cao để tính toán không chặn tiến trình truyền thông. Kết quả là chi phí truyền thông tăng thêm từ mHC được che giấu phần nào, cải thiện hiệu quả huấn luyện tổng thể
Điểm nóng
Ngay cả khi chúng ta không triển khai mHC, cách đặt vấn đề của DeepSeek là một phương pháp tốt để xác định nơi hệ thống thực sự mất thời gian.
- Tác vụ ngữ cảnh dài: Prompt dài khiến giai đoạn prefill đắt đỏ vì attention phải di chuyển nhiều dữ liệu qua bộ nhớ. Trong giai đoạn decode, KV cache phình to dần, làm tăng lượt đọc bộ nhớ mỗi token. Cả hai cùng đẩy tới giới hạn băng thông bộ nhớ và thường gây phân mảnh hoặc batching kém hiệu quả.
- Định tuyến MoE và song song chuyên gia: Với Mixture of Experts (MoE), chi phí không chỉ là tính toán. Đó còn là định tuyến, trao đổi token và truyền thông liên GPU để gửi token tới chuyên gia và gom kết quả. Chồng lấp DualPipe của DeepSeek tập trung che giấu truyền thông pipeline phía sau tính toán, điều mà MoE rất cần ở quy mô lớn.
- Lưu lượng đa thuê và batch nhỏ: Trong triển khai thực tế, yêu cầu không đến theo các batch lớn gọn gàng. Ta có các batch nhỏ hơn, không đồng nhất, độ dài chuỗi pha trộn, và khả năng tận dụng cache yếu hơn. Điều đó làm giảm hiệu quả batching và tăng độ trễ đuôi, khiến băng thông bộ nhớ và lập lịch trở thành nút thắt cổ chai.
KV Cache và lưu lượng bộ nhớ
Dù mHC chủ yếu là ý tưởng cho huấn luyện, bài học cốt lõi của bài báo áp dụng trực tiếp cho suy luận. Bài báo tập trung tối ưu không chỉ FLOPs, mà còn lưu lượng bộ nhớ, truyền thông và độ trễ. Bằng chứng lớn nhất là giải mã ngữ cảnh dài, với ước lượng KV cache xấp xỉ:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batch
Với FP16/BF16, giá trị bytes_per_elem là 2. Ví dụ, với kích thước điển hình (L=32, H=4096, batch=1), 8K token vào khoảng ~4 GB KV, trong khi 128K token là ~64 GB, nên ngay cả khi chi phí tính toán vẫn hợp lý, bộ nhớ vẫn có thể bùng nổ và bạn sẽ bị giới hạn bởi băng thông.
Đó là lý do các tối ưu suy luận thực tế tập trung vào giảm chuyển động bộ nhớ bằng các kỹ thuật như lượng tử hóa KV cache, KV theo trang và loại bỏ, kernel attention hiệu quả (họ FlashAttention), batching liên tục và gom nhóm theo hình dạng, và song song nhận thức truyền thông.
Mục tiêu là giữ nguyên lợi ích hiệu năng mà không phải trả “thuế ẩn” trong đọc/ghi bộ nhớ và đồng bộ hóa.
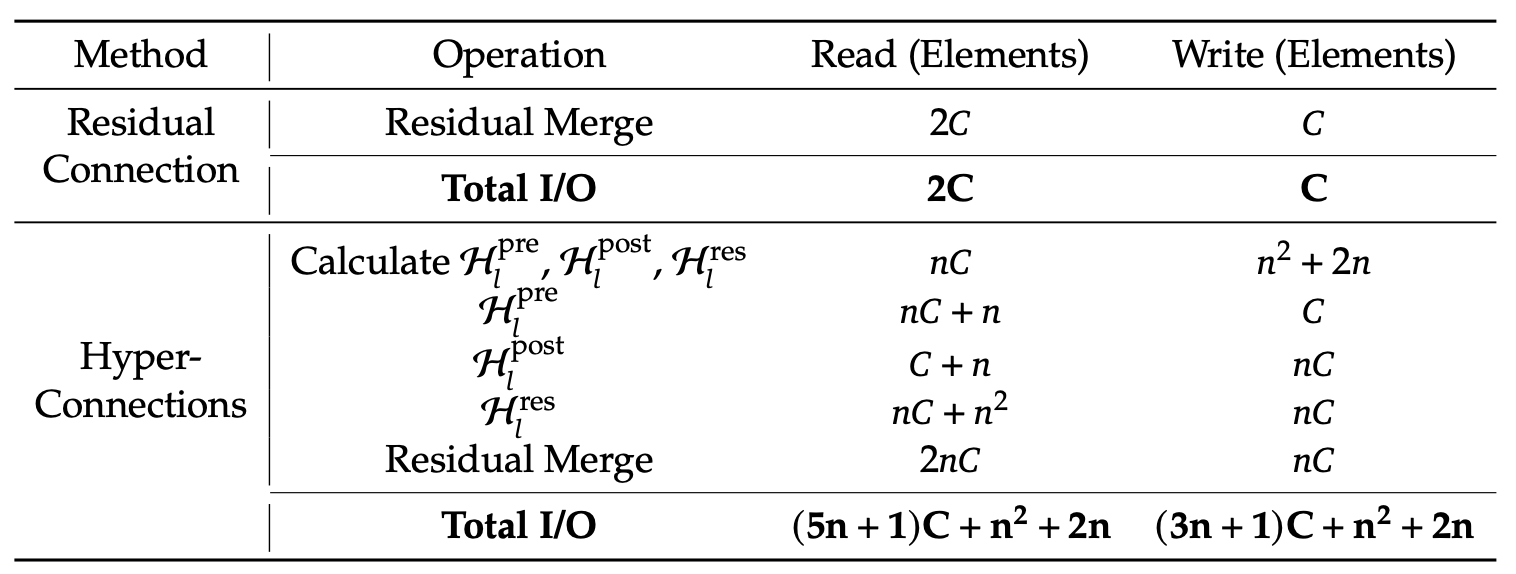
Bảng 1: So sánh chi phí truy cập bộ nhớ trên mỗi token (bài báo mHC)
DeepSeek báo cáo mHC liên tục vượt trội so với đường cơ sở và vượt HC trên hầu hết các benchmark cho mô hình 27B, bao gồm +2,1% trên BBH và +2,3% trên DROP so với HC. Điều này cho thấy mHC chuyển hóa thành kết quả tốt hơn ở quy mô lớn.
Kết luận
Điểm mấu chốt từ bài báo là mở rộng LLM không chỉ là vấn đề FLOPs; đó đồng thời là vấn đề ổn định và hệ thống. Hyper-Connections (HC) tăng năng lực mô hình bằng cách mở rộng dòng dư và cho phép nhiều dòng trộn lẫn, nhưng ở độ sâu lớn, sự pha trộn này tích tụ thành một ánh xạ tổng hợp có thể lệch đáng kể khỏi đường đồng nhất, dẫn đến bùng nổ hoặc tiêu biến tín hiệu/gradient, và huấn luyện sụp đổ.
mHC khắc phục bằng cách đặt “lan can” lên việc trộn đó, ràng buộc ma trận trộn dư phải là lưỡng suy rộng (không âm, hàng/cột có tổng bằng 1), được áp đặt qua Sinkhorn–Knopp, để đường dư hành xử như một trung bình có trọng số được kiểm soát và vẫn ổn định ngay cả khi xếp chồng nhiều lớp.
DeepSeek cũng coi hiệu quả thời gian chạy là một phần của phương pháp. Họ dùng hợp nhất kernel để giảm đọc/ghi bộ nhớ băng thông cao và tính toán lại có chọn lọc để tối thiểu hóa bộ nhớ kích hoạt.
Ngoài ra, họ mở rộng DualPipe để chồng lấp truyền thông với tính toán, đảm bảo các điểm nghẽn pipeline không xóa mất lợi ích đạt được. Kết quả không chỉ là huấn luyện ổn định hơn mà còn hiệu năng downstream tốt hơn ở quy mô lớn.
Nếu bạn muốn tìm hiểu thêm về phát triển ứng dụng LLM, tôi khuyến nghị xem khóa học Developing LLM Applications with LangChain.


mHC (Manifold-Constrained Hyper-Connections) của DeepSeek giải quyết một vấn đề mà hầu hết các đội ngũ gặp phải khi mở rộng LLM: bạn có thể tiếp tục thêm GPU, nhưng đến một thời điểm, quá trình huấn luyện trở nên bất ổn và thông lượng ngừng cải thiện.
Ý tưởng cốt lõi như sau:
Hyper-Connections cải thiện khả năng kết nối và năng lực, còn Manifold-Constrained Hyper-Connections (mHC) biến nâng cấp đó thành ổn định và có thể mở rộng, đồng thời không bỏ qua các nút thắt cổ chai thực như băng thông bộ nhớ và truyền thông.
Nếu bạn muốn tìm hiểu thêm về một số nguyên lý được đề cập trong hướng dẫn này, tôi khuyến nghị xem khóa học Transformer Models with PyTorch và khóa học Deep Learning with PyTorch.
mHC là gì? Từ kết nối dư đến Hyper-Connections
Trong phần này, tôi sẽ phân tích nhu cầu vượt ra khỏi các kết nối dư thuần túy, cách HC cố gắng giải quyết điều đó và vì sao mHC là cách sửa giúp ý tưởng hoạt động ở quy mô LLM.
Hình 1: Minh họa các mô hình kết nối dư (bài báo mHC)
Kết nối dư (Hình a) cung cấp cho mỗi lớp một đường tắt đồng nhất, cho phép tín hiệu và gradient chảy mượt qua các mạng rất sâu.
DeepSeek đã sử dụng rõ ràng nguyên lý ánh xạ đồng nhất này làm điểm xuất phát cho bài báo mHC. Điểm hạn chế là một đường dư thuần túy cũng quá gò bó, nên không cho phép trao đổi nhiều thông tin trong dòng dư.
Hyper-Connections (HC) (Hình b) là bước tiếp theo tự nhiên: thay vì một dòng dư, mở rộng thành n dòng song song và thêm các ánh xạ học được trước/sau/dư để các dòng có thể trộn và chia sẻ thông tin. Điều này tăng tính biểu đạt mà không nhất thiết làm bùng nổ FLOPs mỗi lớp.
Nhưng ở quy mô lớn, HC gặp hai vấn đề lớn. Thứ nhất, vì các dòng trộn tự do ở mọi lớp, những pha trộn nhỏ tích tụ dần khi đi sâu hơn. Qua nhiều lớp, mạng có thể không còn hành xử như một “skip connection” gọn gàng, và tín hiệu hoặc gradient có thể bùng nổ hoặc tiêu biến, làm huấn luyện bất ổn. Thứ hai, ngay cả khi phép tính bổ sung đơn giản, chi phí phần cứng cũng tăng nhanh.
Manifold-Constrained Hyper-Connections (mHC) (Hình c) giữ lại khả năng kết nối bổ sung của HC nhưng khiến việc huấn luyện an toàn như một ResNet.
Ý chính là thay vì cho phép các dòng dư trộn theo bất kỳ cách nào, mHC buộc việc trộn phải tuân thủ các quy tắc nghiêm ngặt. Trong bài báo, điều này được thực hiện bằng cách biến ma trận trộn thành một “trung bình có trọng số” chuẩn mực, sử dụng thủ tục gọi là Sinkhorn–Knopp. Kết quả là ngay cả sau nhiều lớp, việc trộn vẫn ổn định, và tín hiệu cũng như gradient không bùng nổ hay biến mất.
Tóm lại, chúng ta chuyển từ kết nối dư sang mHC vì muốn luồng thông tin phong phú hơn thay vì chỉ một đường tắt duy nhất.
Các khái niệm chính của mHC
Ở mức khái quát, mHC giữ cơ chế trộn đa dòng của Hyper-Connections, nhưng đặt những “lan can” cứng lên việc trộn để nó hành xử như một đường tắt kiểu ResNet ổn định, ngay cả khi xếp chồng hàng trăm lớp.
Các tác giả ràng buộc ma trận trộn dư
Hlresđể nó luôn chuẩn mực theo chiều sâu, đồng thời vẫn cho phép các dòng trao đổi thông tin.Cụ thể, mHC buộc
Hlresphải là lưỡng suy rộng, tức mọi phần tử không âm, và mỗi hàng cũng như mỗi cột có tổng bằng 1. Nhờ vậy dòng dư hành xử như một trung bình có trọng số được kiểm soát.Điểm này làm nổi bật rằng ánh xạ là không giãn (chuẩn phổ bị chặn bởi 1), vẫn ổn định khi nhân qua nhiều lớp (đóng dưới phép nhân), và có cách hiểu trực quan về trộn như phép trung bình/pha trộn hoán vị thông qua đa diện Birkhoff. Nó cũng ràng buộc các ánh xạ trước/sau phải không âm để tránh triệt tiêu tín hiệu.
Hình 2: Ổn định lan truyền của Manifold-Constrained Hyper-Connections (bài báo mHC)
Về triển khai, bài báo giữ tính thực tiễn bằng cách tính các ánh xạ thô chưa ràng buộc
Hlpre,HlpostvàHlrestừ trạng thái đa dòng của lớp hiện tại (họ làm phẳngxlđể giữ toàn bộ ngữ cảnh), rồi chiếu chúng vào dạng bị ràng buộc.HlprevàHlpostđược áp ràng buộc dựa trên sigmoid, còn Hlresđược chiếu bằng Sinkhorn–Knopp: lũy thừa để làm phần tử dương, rồi luân phiên chuẩn hóa hàng/cột cho đến khi tổng bằng 1.Các tác giả cũng báo cáo triển khai mHC (với n=4) ở quy mô lớn chỉ với chi phí huấn luyện tăng ~6,7%, chủ yếu nhờ cắt giảm mạnh lưu lượng bộ nhớ. Họ sắp xếp lại các phần của RMSNorm để hiệu quả hơn, dùng hợp nhất kernel (bao gồm hiện thực vòng lặp Sinkhorn trong một kernel duy nhất với đạo hàm ngược tùy chỉnh), hợp nhất việc áp dụng
HlpostvàHlresvới bước gộp dư để giảm đọc/ghi, dùng tính toán lại có chọn lọc để tránh lưu các kích hoạt trung gian lớn, và chồng lấp truyền thông trong lịch DualPipe mở rộng để che giấu độ trễ giữa các giai đoạn pipeline.Tối ưu mHC: Kỹ thuật hệ thống
Chỉ ổn định thôi là chưa đủ. Nếu mHC thêm quá nhiều lưu lượng bộ nhớ hoặc truyền thông giữa GPU, chúng ta sẽ mất thông lượng. Vì vậy, các tác giả kết hợp phương pháp mHC với một tập tối ưu hạ tầng được thiết kế để thân thiện với “bức tường bộ nhớ”.
Hình 3: Chồng lấp truyền thông–tính toán cho mHC (bài báo mHC)
Hợp nhất kernel để giảm đọc/ghi bộ nhớ
Các tác giả tăng tốc mHC bằng cách hợp nhất nhiều bước vào một kernel GPU. Thay vì áp dụng
Hlpost,Hlres, rồi gộp lại vào dòng dư qua các lượt riêng (khiến GPU phải ghi tensor trung gian ra bộ nhớ rồi đọc lại), họ thực hiện các thao tác này trong một lượt duy nhất.Cách này cắt giảm đáng kể lưu lượng bộ nhớ. Kernel giờ đọc khoảng
(n+1)Cgiá trị thay vì(3n+1)Cvà ghi khoảngnCgiá trị thay vì3nC. Ở đây,Clà kích thước ẩn (số đặc trưng mỗi dòng) vànlà số dòng dư, nênnClà kích thước trạng thái dư mở rộng. Ít đọc/ghi hơn nghĩa là ít dữ liệu phải di chuyển tới/về bộ nhớ hơn.Bài báo cũng gợi ý hiện thực phần lớn kernel bằng TileLang để tận dụng băng thông bộ nhớ tốt hơn.
Tính toán lại để kiểm soát bộ nhớ kích hoạt
mHC đa dòng làm tăng lượng kích hoạt trung gian bạn thường phải lưu cho lan truyền ngược, có thể làm nổ bộ nhớ GPU và buộc phải giảm batch hoặc checkpoint mạnh tay hơn.
Để tránh điều đó, bài báo đề xuất một mẹo đơn giản: không lưu các trung gian của mHC sau lượt tiến. Thay vào đó, tính toán lại các kernel mHC nhẹ trong lượt lùi, đồng thời bỏ qua việc tính lại khối Transformer F tốn kém.
Điều này giảm áp lực bộ nhớ và giúp duy trì thông lượng hiệu dụng cao hơn. Một ràng buộc thực tế là các khối tính lại này nên trùng với ranh giới giai đoạn pipeline; nếu không, việc lập lịch pipeline sẽ trở nên rối rắm.
Lập lịch nhận thức truyền thông với chồng lấp DualPipe
Ở quy mô lớn, song song đường ống là phổ biến, nhưng thiết kế n dòng của mHC làm tăng lượng dữ liệu phải vượt qua ranh giới giai đoạn, có thể thêm các khoảng dừng truyền thông đáng kể.
DeepSeek tối ưu bằng cách mở rộng DualPipe để truyền thông và tính toán chồng lấp tại ranh giới pipeline. Điều này nghĩa là GPU làm việc hữu ích trong khi truyền tải diễn ra, thay vì ngồi chờ gửi/nhận hoàn tất. Họ cũng chạy một số kernel trên luồng tính toán ưu tiên cao để tính toán không chặn tiến trình truyền thông. Kết quả là chi phí truyền thông tăng thêm từ mHC được che giấu phần nào, cải thiện hiệu quả huấn luyện tổng thể
Điểm nóng
Ngay cả khi chúng ta không triển khai mHC, cách đặt vấn đề của DeepSeek là một phương pháp tốt để xác định nơi hệ thống thực sự mất thời gian.
KV Cache và lưu lượng bộ nhớ
Dù mHC chủ yếu là ý tưởng cho huấn luyện, bài học cốt lõi của bài báo áp dụng trực tiếp cho suy luận. Bài báo tập trung tối ưu không chỉ FLOPs, mà còn lưu lượng bộ nhớ, truyền thông và độ trễ. Bằng chứng lớn nhất là giải mã ngữ cảnh dài, với ước lượng KV cache xấp xỉ:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batchVới FP16/BF16, giá trị
bytes_per_elemlà 2. Ví dụ, với kích thước điển hình (L=32, H=4096, batch=1), 8K token vào khoảng ~4 GB KV, trong khi 128K token là ~64 GB, nên ngay cả khi chi phí tính toán vẫn hợp lý, bộ nhớ vẫn có thể bùng nổ và bạn sẽ bị giới hạn bởi băng thông.Đó là lý do các tối ưu suy luận thực tế tập trung vào giảm chuyển động bộ nhớ bằng các kỹ thuật như lượng tử hóa KV cache, KV theo trang và loại bỏ, kernel attention hiệu quả (họ FlashAttention), batching liên tục và gom nhóm theo hình dạng, và song song nhận thức truyền thông.
Mục tiêu là giữ nguyên lợi ích hiệu năng mà không phải trả “thuế ẩn” trong đọc/ghi bộ nhớ và đồng bộ hóa.
Bảng 1: So sánh chi phí truy cập bộ nhớ trên mỗi token (bài báo mHC)
DeepSeek báo cáo mHC liên tục vượt trội so với đường cơ sở và vượt HC trên hầu hết các benchmark cho mô hình 27B, bao gồm +2,1% trên BBH và +2,3% trên DROP so với HC. Điều này cho thấy mHC chuyển hóa thành kết quả tốt hơn ở quy mô lớn.
Kết luận
Điểm mấu chốt từ bài báo là mở rộng LLM không chỉ là vấn đề FLOPs; đó đồng thời là vấn đề ổn định và hệ thống. Hyper-Connections (HC) tăng năng lực mô hình bằng cách mở rộng dòng dư và cho phép nhiều dòng trộn lẫn, nhưng ở độ sâu lớn, sự pha trộn này tích tụ thành một ánh xạ tổng hợp có thể lệch đáng kể khỏi đường đồng nhất, dẫn đến bùng nổ hoặc tiêu biến tín hiệu/gradient, và huấn luyện sụp đổ.
mHC khắc phục bằng cách đặt “lan can” lên việc trộn đó, ràng buộc ma trận trộn dư phải là lưỡng suy rộng (không âm, hàng/cột có tổng bằng 1), được áp đặt qua Sinkhorn–Knopp, để đường dư hành xử như một trung bình có trọng số được kiểm soát và vẫn ổn định ngay cả khi xếp chồng nhiều lớp.
DeepSeek cũng coi hiệu quả thời gian chạy là một phần của phương pháp. Họ dùng hợp nhất kernel để giảm đọc/ghi bộ nhớ băng thông cao và tính toán lại có chọn lọc để tối thiểu hóa bộ nhớ kích hoạt.
Ngoài ra, họ mở rộng DualPipe để chồng lấp truyền thông với tính toán, đảm bảo các điểm nghẽn pipeline không xóa mất lợi ích đạt được. Kết quả không chỉ là huấn luyện ổn định hơn mà còn hiệu năng downstream tốt hơn ở quy mô lớn.
Nếu bạn muốn tìm hiểu thêm về phát triển ứng dụng LLM, tôi khuyến nghị xem khóa học Developing LLM Applications with LangChain.