

Kursus
Bekerja dengan OpenAI API
3 jam
184.8K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleOpenAI baru-baru ini merilis GPT-4.1, keluarga model baru yang dibuat khusus untuk tugas pengodean. Saya sama bingungnya dengan yang lain soal lompatan penamaan dari GPT-4.5 ke GPT-4.1, tetapi untungnya, tolok ukurnya tidak ikut mundur—bahkan sebaliknya.
Peluncuran dimulai pada 14 April dengan akses khusus API. Lalu, pada 14 Mei, OpenAI mulai menghadirkan GPT-4.1 ke aplikasi ChatGPT. Pengguna paket gratis tidak akan bisa memilih GPT-4.1 secara manual, tetapi kini mereka mendapat manfaat dari GPT-4.1 Mini sebagai fallback bawaan yang baru, menggantikan GPT-4o Mini.
GPT-4.1 hadir dalam tiga ukuran: GPT-4.1, GPT-4.1 Mini, dan GPT-4.1 Nano. Ketiganya mendukung hingga 1 juta token konteks dan menghadirkan peningkatan berarti dalam pengodean, kepatuhan instruksi, dan pemahaman konteks panjang. Model-model ini juga lebih murah dan lebih cepat dibanding rilis sebelumnya.
Dalam artikel ini, saya akan memandu Anda mengenai kemampuan setiap model, bagaimana perbandingannya dengan GPT-4o dan GPT-4.5, serta posisinya pada tolok ukur dan penggunaan nyata.
Kami terus memperbarui pembaca tentang kabar terbaru AI melalui The Median, buletin gratis setiap Jumat yang merangkum cerita-cerita kunci dalam sepekan. Berlangganan dan tetap tajam hanya dalam beberapa menit per minggu:
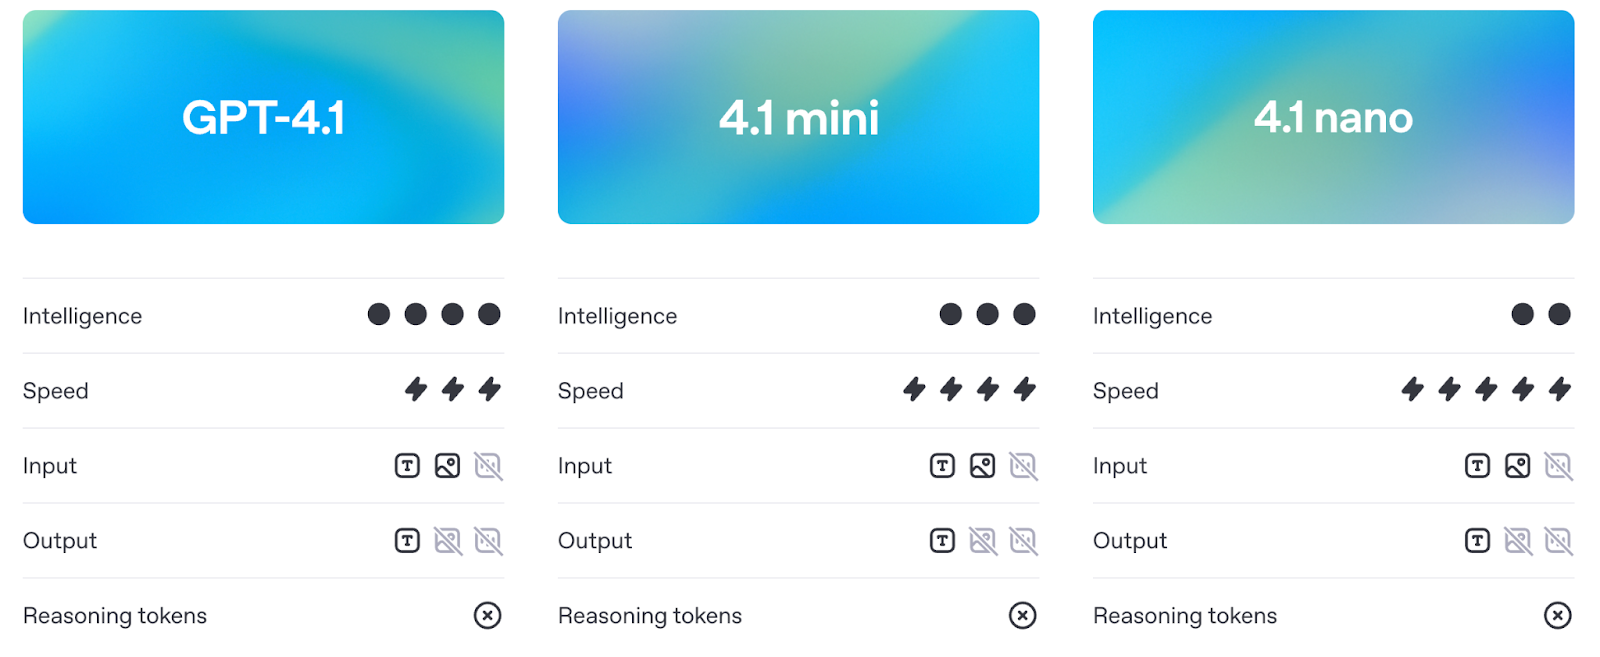
Rangkaian model GPT-4.1 terdiri dari tiga model: GPT-4.1, GPT-4.1 Mini, dan GPT-4.1 Nano. Model-model ini ditujukan untuk pengembang yang membutuhkan kinerja lebih baik, konteks lebih panjang, dan kepatuhan instruksi yang lebih dapat diprediksi. Masing-masing mendukung hingga 1 juta token konteks, lompatan besar dari batas 128K pada versi sebelumnya seperti GPT-4o.
Sumber: OpenAI
Terlepas dari arsitektur yang sama, setiap versi disetel untuk kasus penggunaan yang berbeda. Mari kita telusuri masing-masing lebih lanjut.
Ini adalah model andalan. Jika Anda menginginkan kinerja terbaik secara keseluruhan untuk pengodean, kepatuhan instruksi, dan tugas berkonteks panjang, inilah pilihannya. Model ini dibuat untuk menangani alur kerja pengodean yang kompleks atau memproses dokumen besar dalam satu prompt.
Dalam tolok ukur, model ini mengungguli GPT-4o dalam rekayasa perangkat lunak dunia nyata (SWE-bench), kepatuhan instruksi (MultiChallenge), dan penalaran konteks panjang (MRCR, Graphwalks). Model ini juga jauh lebih baik dalam mematuhi struktur dan pemformatan—pikirkan respons XML, instruksi berurutan, dan batasan negatif seperti “jangan jawab kecuali…”.
Anda juga dapat melakukan fine-tune GPT-4.1 sejak hari peluncuran, yang membukanya untuk lebih banyak kasus penggunaan produksi di mana kontrol atas nada, format, atau pengetahuan domain penting.
GPT-4.1 Mini adalah opsi kelas menengah, menawarkan kemampuan hampir setara dengan model penuh tetapi dengan latensi dan biaya lebih rendah. Model ini menyamai atau mengalahkan GPT-4o di banyak tolok ukur, termasuk kepatuhan instruksi dan penalaran berbasis gambar.
Kemungkinan besar ini akan menjadi pilihan default untuk banyak kasus penggunaan: cukup cepat untuk alat interaktif, cukup cerdas untuk mengikuti instruksi detail, dan jauh lebih murah daripada model penuh.
Seperti versi penuh, model ini mendukung konteks 1 juta token dan sudah tersedia untuk fine-tuning.
Nano adalah yang terkecil, tercepat, dan termurah di antara ketiganya. Model ini dibuat untuk tugas seperti autocomplete, klasifikasi, dan mengekstraksi informasi dari dokumen besar. Meski ringan, model ini tetap mendukung jendela konteks penuh 1 juta token.
Ini juga merupakan model OpenAI yang paling kecil, tercepat, dan termurah sejauh ini, hanya sekitar 10 sen per sejuta token. Anda tidak mendapatkan kemampuan penalaran dan perencanaan penuh seperti model yang lebih besar, tetapi untuk tugas tertentu, itu memang bukan tujuannya.
Sebelum membahas tolok ukur (yang akan kita ulas detail di bagian berikutnya), perlu dipahami bagaimana GPT-4.1 berbeda dalam praktik dibanding GPT-4o dan GPT-4.5.
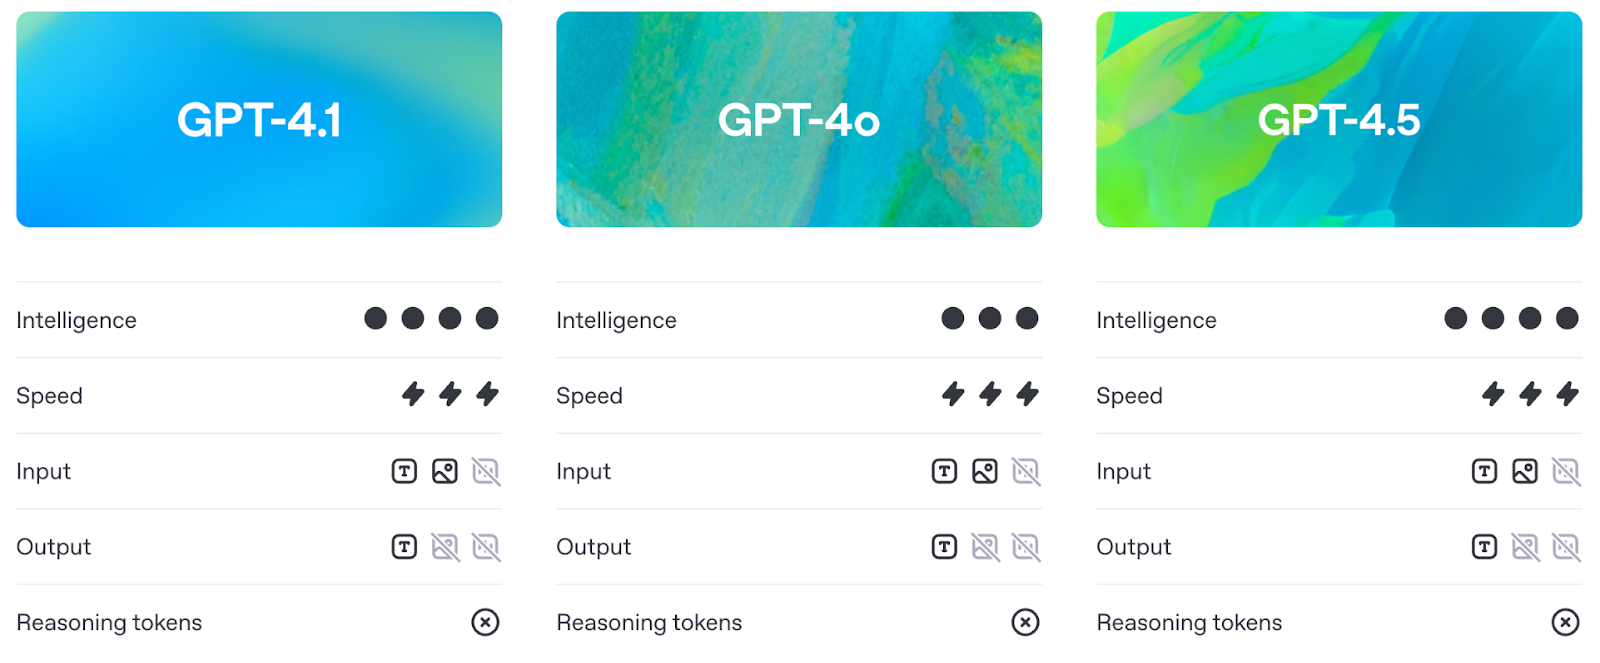
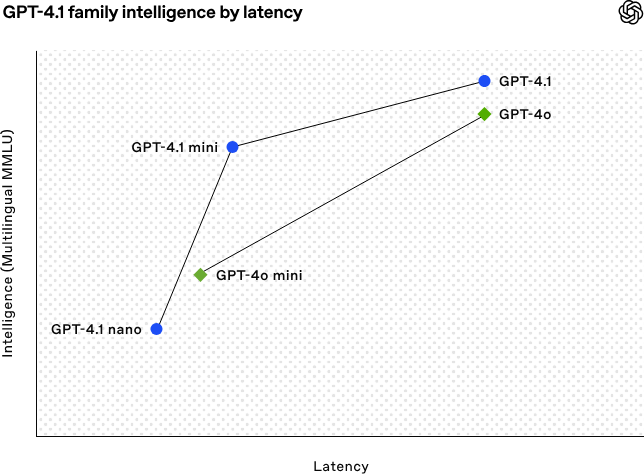
GPT-4.1 meningkatkan kemampuan GPT-4o sambil mempertahankan latensi pada rentang yang kurang lebih sama. Dalam praktiknya, ini berarti pengembang kini mendapatkan kinerja lebih baik tanpa mengorbankan daya tanggap.
Sumber: OpenAI
Mari kita uraikan grafik di atas:
Sementara itu, GPT-4.5 sejak awal diposisikan sebagai pratinjau riset. Meski memiliki penalaran dan kualitas penulisan yang kuat, model ini datang dengan beban lebih besar. GPT-4.1 menghadirkan hasil serupa atau lebih baik pada tolok ukur kunci namun lebih murah dan lebih responsif—cukup sehingga OpenAI berencana menghentikan 4.5 sepenuhnya pada pertengahan Juli untuk membebaskan lebih banyak GPU.
Ketiga model GPT-4.1—standar, Mini, dan Nano—mendukung hingga 1 juta token konteks. Itu lebih dari 8x dibanding yang ditawarkan GPT-4o.
Kapasitas konteks panjang ini memungkinkan kasus penggunaan praktis seperti memproses seluruh log, mengindeks repositori kode, menangani alur kerja hukum multi-dokumen, atau menganalisis transkrip panjang—semuanya tanpa perlu melakukan chunking atau merangkum sebelumnya.
GPT-4.1 juga menandai perubahan dalam keandalan model dalam mengikuti instruksi. Model ini menangani prompt kompleks yang melibatkan langkah berurutan, batasan pemformatan, dan kondisi negatif (seperti menolak menjawab jika formatnya salah).
Dalam praktiknya, ini berarti dua hal: lebih sedikit waktu untuk menyusun prompt, dan lebih sedikit waktu untuk membersihkan keluaran setelahnya.
GPT-4.1 menunjukkan kemajuan di empat area inti: pengodean, kepatuhan instruksi, pemahaman konteks panjang, dan tugas multimodal.
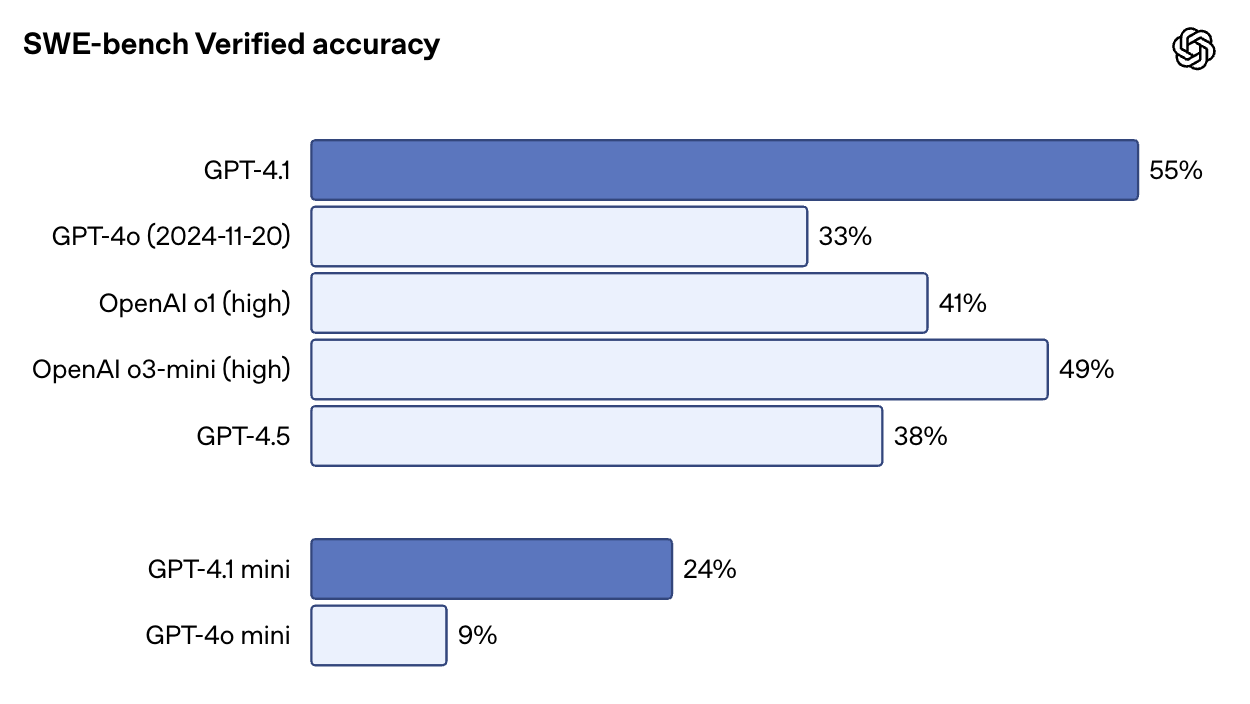
Pada SWE-bench Verified—tolok ukur yang menjatuhkan model ke dalam basis kode nyata dan memintanya menyelesaikan isu secara end-to-end—GPT-4.1 meraih skor 54,6%. Naik dari 33,2% untuk GPT-4o dan 38% untuk GPT-4.5. Yang juga sangat mengesankan, GPT-4.1 mencetak skor lebih tinggi daripada o1 dan o3-mini.
Sumber: OpenAI
Model ini juga lebih dari dua kali lipat kinerja GPT-4o pada tolok ukur polyglot diff milik Aider, mencapai akurasi 52,9% pada diff kode lintas berbagai bahasa dan format. GPT-4.5 mencetak 44,9% pada tugas yang sama. GPT-4.1 juga lebih presisi: dalam evaluasi internal, suntingan kode berlebih turun dari 9% (GPT-4o) menjadi hanya 2%.
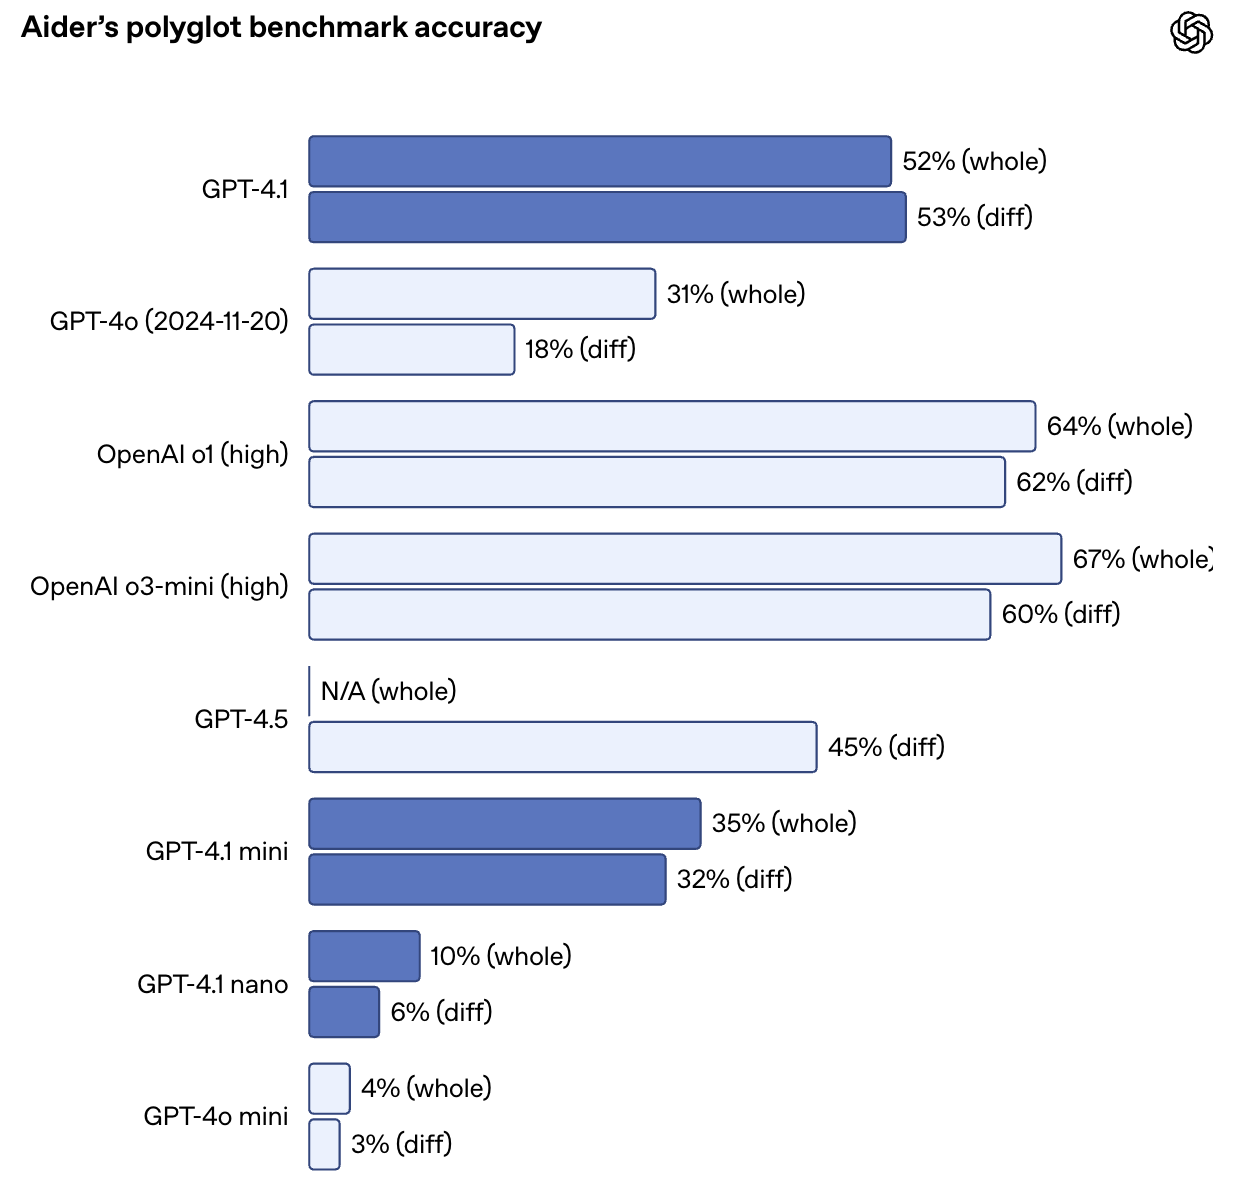
Sumber: OpenAI
Di luar skor tolok ukur, demo pengodean frontend yang ditunjukkan OpenAI menjadi contoh visual yang baik atas keunggulan kinerja GPT-4.1. Tim OpenAI meminta kedua model membuat aplikasi kartu flash yang sama, dan penilai manusia lebih memilih keluaran GPT-4.1 sebanyak 80% dari waktu penilaian.
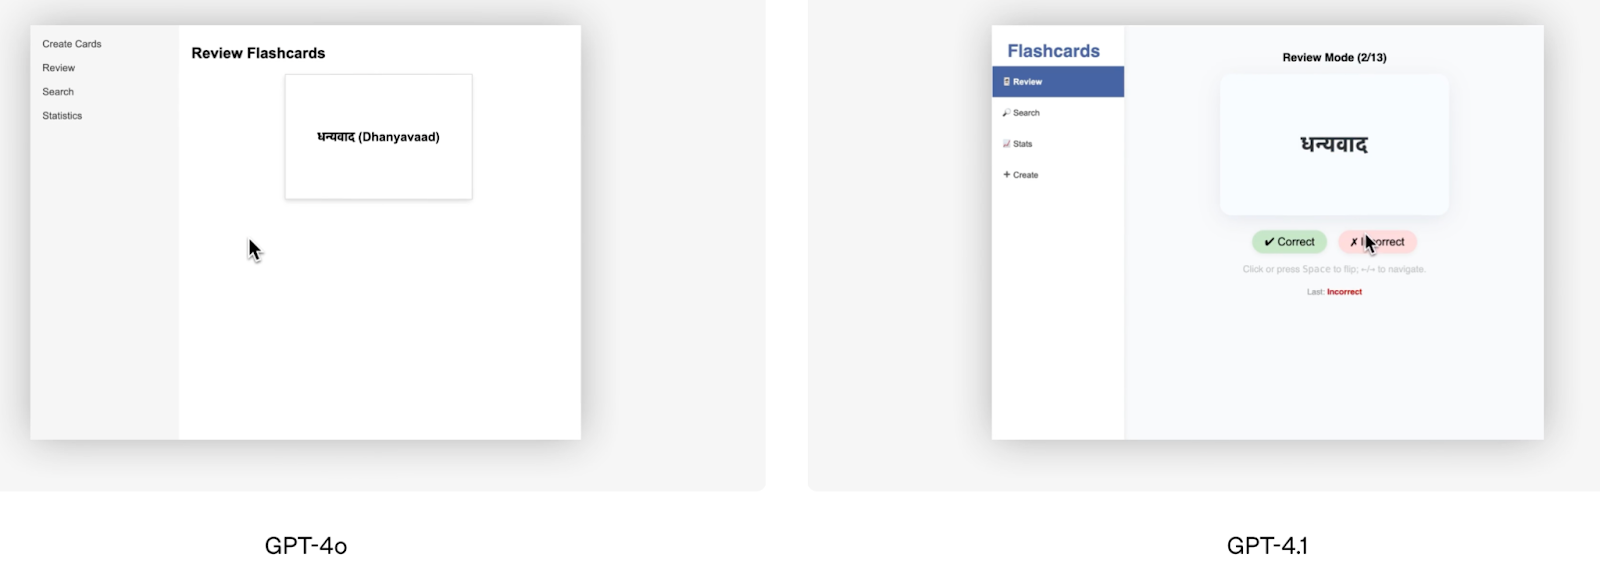
Sumber: OpenAI
Windsurf, salah satu penguji alfa, melaporkan peningkatan 60% pada tolok ukur pengodean internal mereka. Perusahaan lain, Qodo, menguji GPT-4.1 pada pull request GitHub nyata dan menemukan model ini menghasilkan saran yang lebih baik 55% dari waktu, dengan lebih sedikit suntingan yang tidak relevan atau terlalu bertele-tele.
GPT-4.1 lebih literal—dan lebih andal—dalam mengikuti instruksi, terutama untuk tugas yang melibatkan banyak langkah, aturan pemformatan, atau kondisi. Pada evaluasi internal OpenAI terkait kepatuhan instruksi (subset sulit), GPT-4.1 mencetak 49,1%, dibanding hanya 29,2% untuk GPT-4o. GPT-4.5 sedikit unggul di sini dengan 54%, tetapi kesenjangan antara 4.1 dan 4o cukup signifikan.
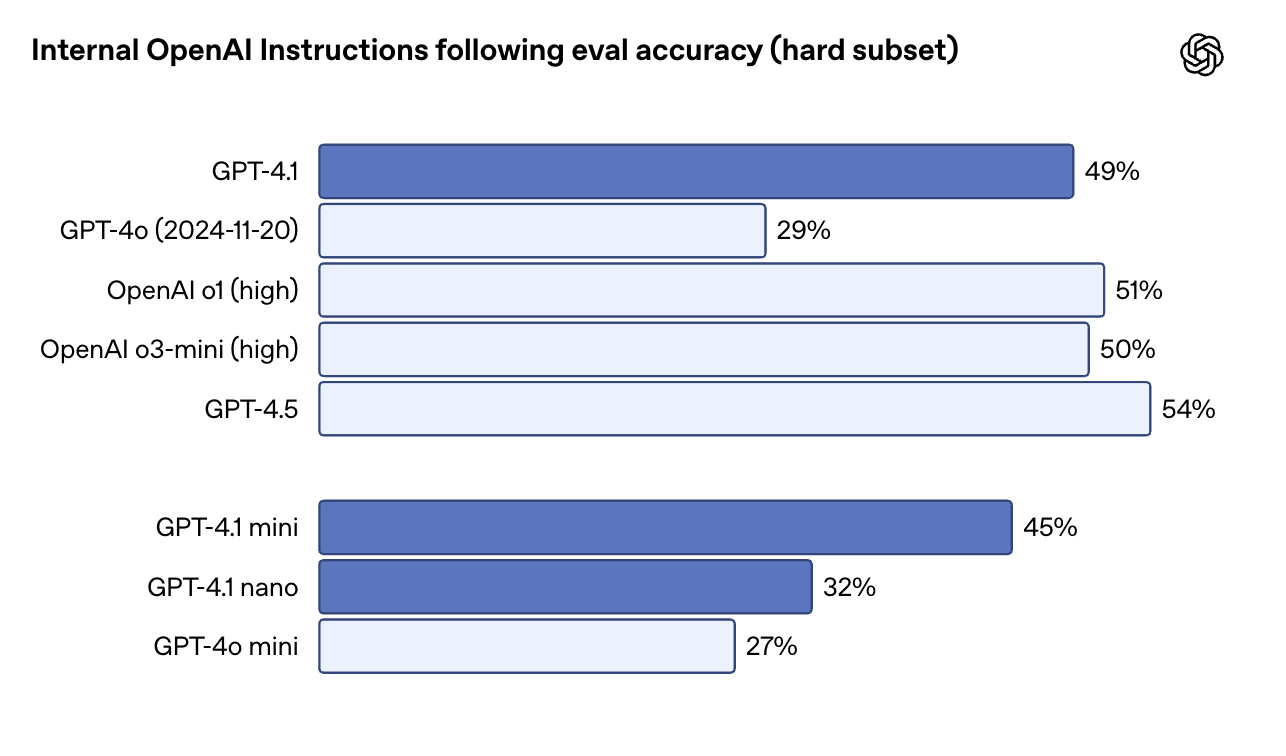
Sumber: OpenAI
Pada MultiChallenge, yang menguji apakah model dapat mengikuti instruksi multi-giliran dan mengingat batasan yang diperkenalkan lebih awal dalam percakapan, GPT-4.1 mencetak 38,3%—naik dari 27,8% untuk GPT-4o. Dan pada IFEval, yang menguji kepatuhan terhadap persyaratan keluaran yang ditentukan dengan jelas, GPT-4.1 mencapai 87,4%, peningkatan solid dibanding 81% milik GPT-4o.
Dalam praktiknya, ini berarti GPT-4.1 lebih baik dalam berpegang pada langkah berurutan, menolak masukan yang tidak valid, dan merespons dalam format yang Anda minta—terutama pada keluaran terstruktur seperti XML, YAML, atau markdown. Hal ini juga memudahkan pembuatan alur kerja agen yang andal tanpa banyak percobaan ulang prompt.
Ketiga model GPT-4.1—standar, Mini, dan Nano—mendukung hingga 1 juta token konteks. Ini merupakan peningkatan 8x dibanding GPT-4o, yang batasnya 128K. Sama pentingnya: tidak ada biaya tambahan untuk menggunakan jendela konteks tersebut. Harganya sama seperti prompt lainnya.
Namun, apakah modelnya benar-benar dapat memanfaatkan semua konteks itu? Dalam evaluasi needle-in-a-haystack milik OpenAI, GPT-4.1 secara andal menemukan konten yang disisipkan di titik mana pun—awal, tengah, atau akhir—di dalam input 1 juta token penuh.
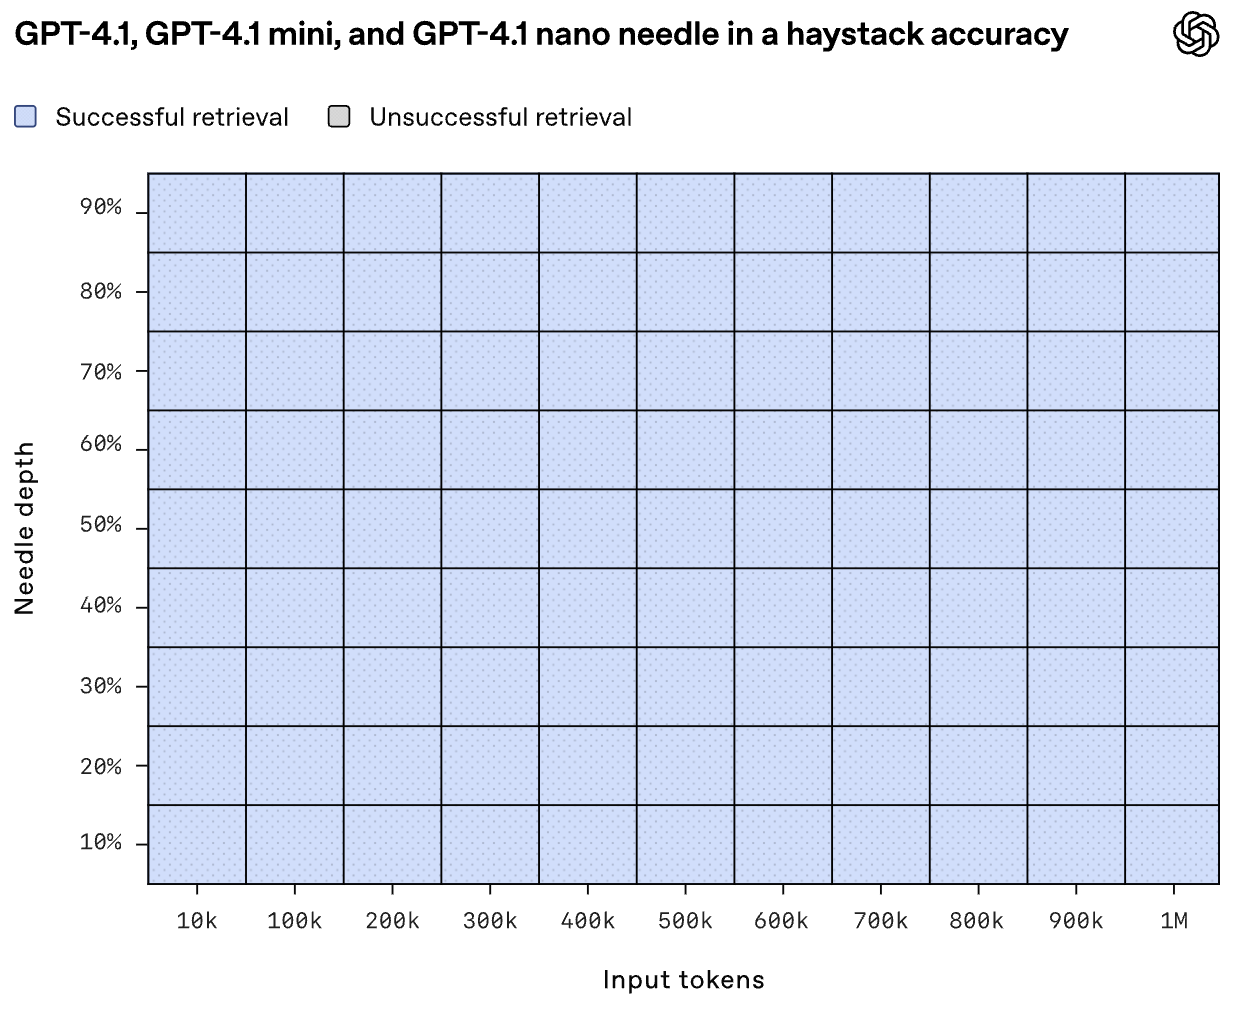
Sumber: OpenAI
Graphwalks, tolok ukur yang menguji penalaran multi-hop dalam konteks panjang, menempatkan GPT-4.1 pada 61,7%—lompatan solid dari 41,7% milik GPT-4o, meski masih di bawah GPT-4.5 pada 72,3%.
Peningkatan ini juga tampak pada uji nyata. Thomson Reuters melihat peningkatan 17% dalam analisis hukum multi-dokumen menggunakan GPT-4.1, sementara Carlyle melaporkan peningkatan 50% dalam mengekstraksi data granular dari laporan keuangan yang padat.
Pada tugas multimodal, GPT-4.1 juga mengalami kemajuan. Model ini mencetak 72,0% pada tolok ukur Video-MME, yang melibatkan menjawab pertanyaan tentang video berdurasi 30–60 menit tanpa subtitle—naik dari 65,3% dengan GPT-4o.
Pada tolok ukur kaya gambar seperti MMMU, model ini mencapai 74,8% vs. 68,7% untuk GPT-4o. Pada MathVista, yang mencakup bagan, grafik, dan visual matematika, GPT-4.1 mencapai 72,2%.
Yang mengejutkan: GPT-4.1 Mini tampil hampir setara dengan versi penuh pada beberapa tolok ukur ini. Pada MathVista, misalnya, model ini sedikit mengungguli GPT-4.1 dengan 73,1%. Ini menjadikannya pilihan menarik untuk kasus penggunaan yang menggabungkan kecepatan dengan prompt yang kaya visual.
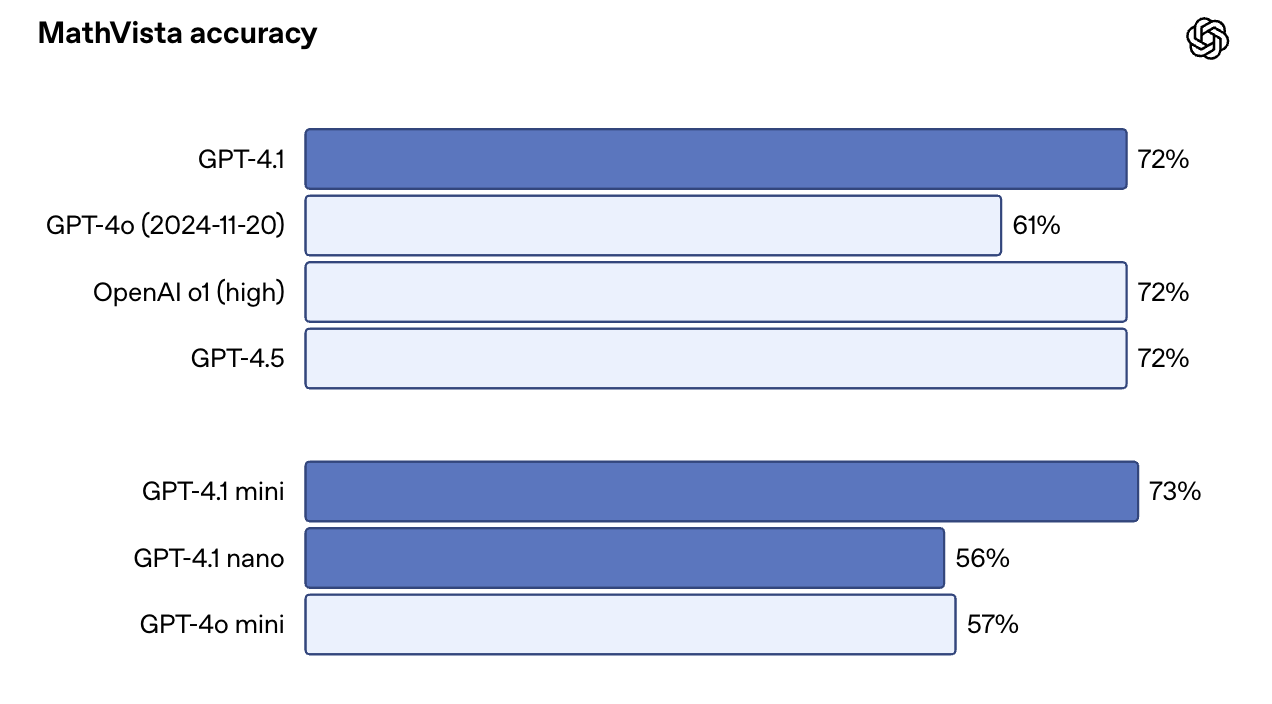
Sumber: OpenAI
Anda kini dapat mengakses GPT-4.1 dan GPT-4.1 Mini langsung di aplikasi ChatGPT, bukan hanya melalui API. Pelanggan Plus, Pro, dan Team dapat memilih GPT-4.1 secara manual dari menu model, sementara pengguna gratis otomatis menggunakan GPT-4.1 Mini—menggantikan GPT-4o Mini sebagai default di belakang layar. Paket Enterprise dan Education diperkirakan akan mendapatkan akses dalam beberapa pekan mendatang.
Bagi pengembang, OpenAI API dan Playground terus mendukung ketiga varian—GPT-4.1, GPT-4.1 Mini, dan GPT-4.1 Nano. Ini tetap menjadi cara terbaik untuk menguji prompt, mengeksplorasi perilaku konteks panjang, dan membandingkan model sebelum mengintegrasikannya ke produksi.
Jika Anda bekerja dengan dokumen panjang—seperti log, PDF, catatan hukum, atau artikel akademik—Anda dapat mengirim hingga 1 juta token dalam satu panggilan, tanpa parameter khusus. Tidak ada kenaikan harga untuk konteks panjang: biaya token flat, terlepas dari ukuran input.
Anda dapat melakukan fine-tune pada ketiga varian GPT-4.1. Ini membuka peluang untuk instruksi khusus, kosakata spesifik domain, atau keluaran dengan nada tertentu. Perlu dicatat bahwa fine-tuning memiliki penetapan harga yang sedikit lebih besar:
|
Model |
Input |
Cached Input |
Output |
Pelatihan |
|
GPT-4.1 |
$3.00 / 1M token |
$0.75 / 1M token |
$12.00 / 1M token |
$25.00 / 1M token |
|
GPT-4.1 Mini |
$0.80 / 1M token |
$0.20 / 1M token |
$3.20 / 1M token |
$5.00 / 1M token |
|
GPT-4.1 Nano |
$0.20 / 1M token |
$0.05 / 1M token |
$0.80 / 1M token |
$1.50 / 1M token |
Jika Anda sebelumnya telah melakukan fine-tune pada model GPT-3.5 atau GPT-4, prosesnya sebagian besar tetap sama—tinggal pilih basis yang lebih baru. Jika Anda ingin belajar lebih lanjut, saya merekomendasikan tutorial ini tentang fine-tuning GPT-4o mini.
Salah satu pembaruan yang disambut baik pada GPT-4.1 adalah bukan hanya lebih cerdas—tetapi juga lebih murah. OpenAI mengatakan tujuannya adalah membuat model-model ini lebih dapat digunakan di lebih banyak alur kerja dunia nyata, dan hal itu terlihat pada struktur penetapan harganya.
Berikut adalah harga ketiga model untuk inferensi:
|
Model |
Input |
Cached Input |
Output |
Biaya Rata-rata Campuran* |
|
GPT-4.1 |
$2.00 / 1M token |
$0.50 / 1M token |
$8.00 / 1M token |
$1.84 |
|
GPT-4.1 Mini |
$0.40 / 1M token |
$0.10 / 1M token |
$1.60 / 1M token |
$0.42 |
|
GPT-4.1 Nano |
$0.10 / 1M token |
$0.025 / 1M token |
$0.40 / 1M token |
$0.12 |
*Angka “campuran” didasarkan pada asumsi OpenAI mengenai rasio input/output yang tipikal.
GPT-4.1 hadir dengan generasi kode yang lebih andal, kepatuhan instruksi yang lebih baik, pemrosesan konteks panjang yang sesungguhnya, dan iterasi yang lebih cepat.
Penamaannya mungkin membingungkan, tetapi model-modelnya jelas lebih mumpuni daripada pendahulunya. Model ini juga lebih terjangkau—dan lebih mudah digunakan—terutama di lingkungan produksi di mana latensi, biaya, dan prediktabilitas sangat penting.
Jika Anda saat ini menggunakan GPT-4o, ada baiknya menguji GPT-4.1.
Belajar AI dengan kursus-kursus ini!
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



