

Cursus
Werken met de OpenAI API
3 uur
184.5K
Oefen en volg je voortgang.
Ga Verder Met GoogleOpenAI heeft onlangs GPT-4.1 uitgebracht, een nieuwe familie van modellen die specifiek is gebouwd voor codeerwerk. Ik ben net zo in de war als iedereen over de sprong in naamgeving van GPT-4.5 naar GPT-4.1, maar gelukkig gaan de benchmarks niet ook achteruit—integendeel.
De uitrol begon op 14 april met alleen API-toegang. Vervolgens begon OpenAI op 14 mei GPT-4.1 naar de ChatGPT-app te brengen. Gratis gebruikers kunnen GPT-4.1 niet handmatig kiezen, maar profiteren nu van GPT-4.1 Mini als nieuwe standaard fallback, ter vervanging van GPT-4o Mini.
GPT-4.1 is er in drie maten: GPT-4.1, GPT-4.1 Mini en GPT-4.1 Nano. Alle drie ondersteunen tot 1 miljoen tokens aan context en brengen opvallende verbeteringen in coderen, instructieopvolging en begrip van lange context. Ze zijn ook goedkoper en sneller dan eerdere releases.
In dit artikel laat ik je zien wat elk model kan, hoe het zich verhoudt tot GPT-4o en GPT-4.5, en waar het staat in benchmarks en praktijkgebruik.
We houden onze lezers op de hoogte van het laatste AI-nieuws via The Median, onze gratis vrijdagnieuwsbrief die de belangrijkste verhalen van de week samenvat. Abonneer je en blijf scherp in slechts een paar minuten per week:
De GPT-4.1-modelsuite bestaat uit drie modellen: GPT-4.1, GPT-4.1 Mini en GPT-4.1 Nano. Ze zijn gericht op ontwikkelaars die betere prestaties, langere context en voorspelbaardere instructieopvolging nodig hebben. Elk model ondersteunt tot 1 miljoen tokens aan context, een grote sprong vanaf de limiet van 128K in eerdere versies zoals GPT-4o.
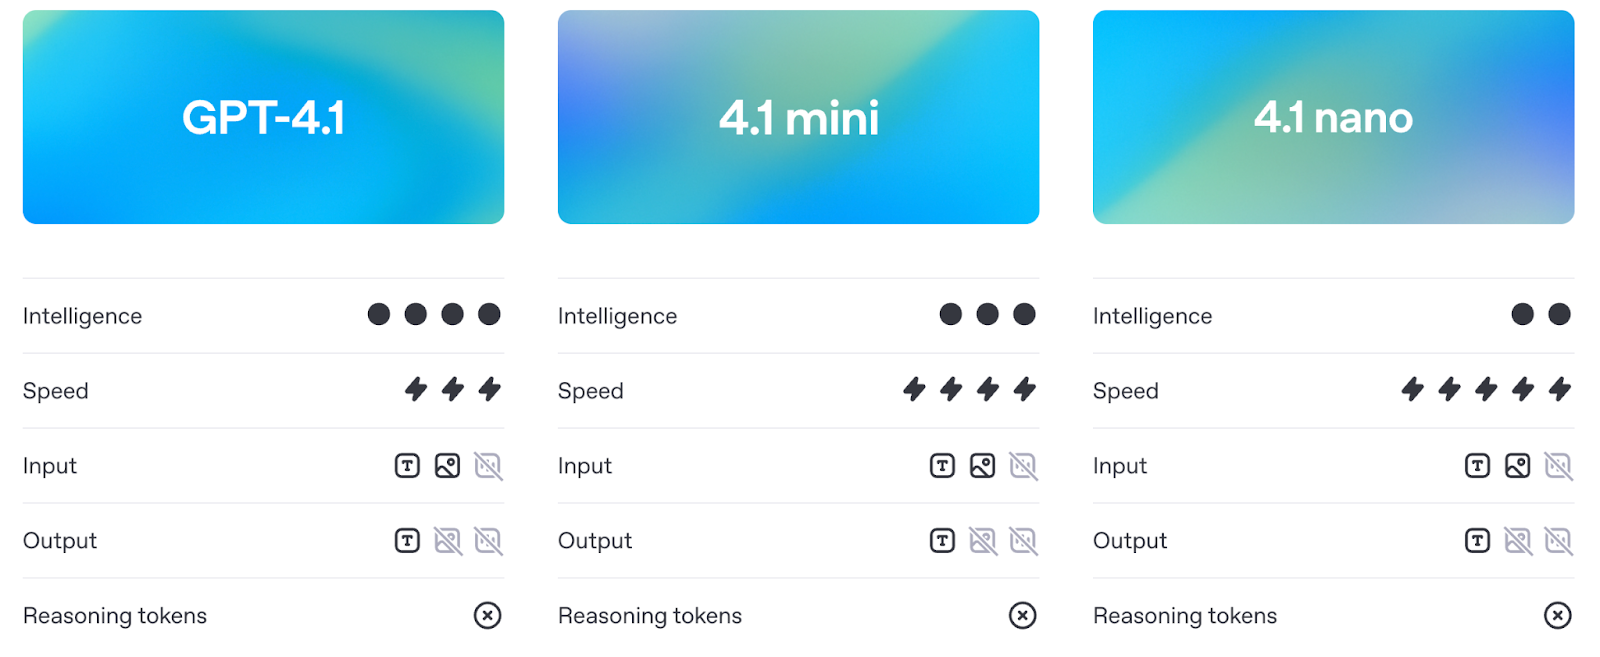
Bron: OpenAI
Ondanks de gedeelde architectuur is elke versie afgestemd op andere use-cases. Laten we ze stuk voor stuk bekijken.
Dit is het vlaggenschipmodel. Als je de beste algehele prestaties wilt voor coderen, instructieopvolging en taken met lange context, is dit de juiste keuze. Het is gebouwd om complexe codeerworkflows aan te kunnen of grote documenten in één prompt te verwerken.
In benchmarks presteert het beter dan GPT-4o op realistische software-engineering (SWE-bench), instructieopvolging (MultiChallenge) en redeneren met lange context (MRCR, Graphwalks). Het is ook merkbaar beter in het respecteren van structuur en opmaak—denk aan XML-antwoorden, geordende instructies en negatieve voorwaarden zoals “antwoord niet tenzij…”.
Je kunt GPT-4.1 ook fine-tunen vanaf de lanceringsdag, wat het inzetbaar maakt voor meer productie-use-cases waarbij controle over toon, formaat of domeinkennis telt.
GPT-4.1 Mini is de middenklasse-optie, met bijna dezelfde capaciteiten als het volledige model maar met lagere latency en kosten. Het evenaart of overtreft GPT-4o in veel benchmarks, waaronder instructieopvolging en beeldgebaseerd redeneren.
Het zal waarschijnlijk de standaardkeuze worden voor veel toepassingen: snel genoeg voor interactieve tools, slim genoeg om gedetailleerde instructies te volgen en aanzienlijk goedkoper dan het volledige model.
Net als de volledige versie ondersteunt het 1 miljoen tokens aan context en is het al beschikbaar voor fine-tuning.
Nano is de kleinste, snelste en goedkoopste van het stel. Het is gebouwd voor taken zoals automatisch aanvullen, classificatie en informatie-extractie uit grote documenten. Ondanks het lichte karakter ondersteunt het nog steeds het volledige contextvenster van 1 miljoen tokens.
Het is ook het kleinste, snelste en goedkoopste model van OpenAI tot nu toe, met ongeveer 10 cent per miljoen tokens. Je krijgt niet het volledige redeneer- en planningsvermogen van de grotere modellen, maar voor bepaalde taken is dat ook niet nodig.
Voordat we de benchmarks induiken (die we in de volgende sectie uitgebreid behandelen), is het de moeite waard om te begrijpen hoe GPT-4.1 zich in de praktijk onderscheidt van GPT-4o en GPT-4.5.
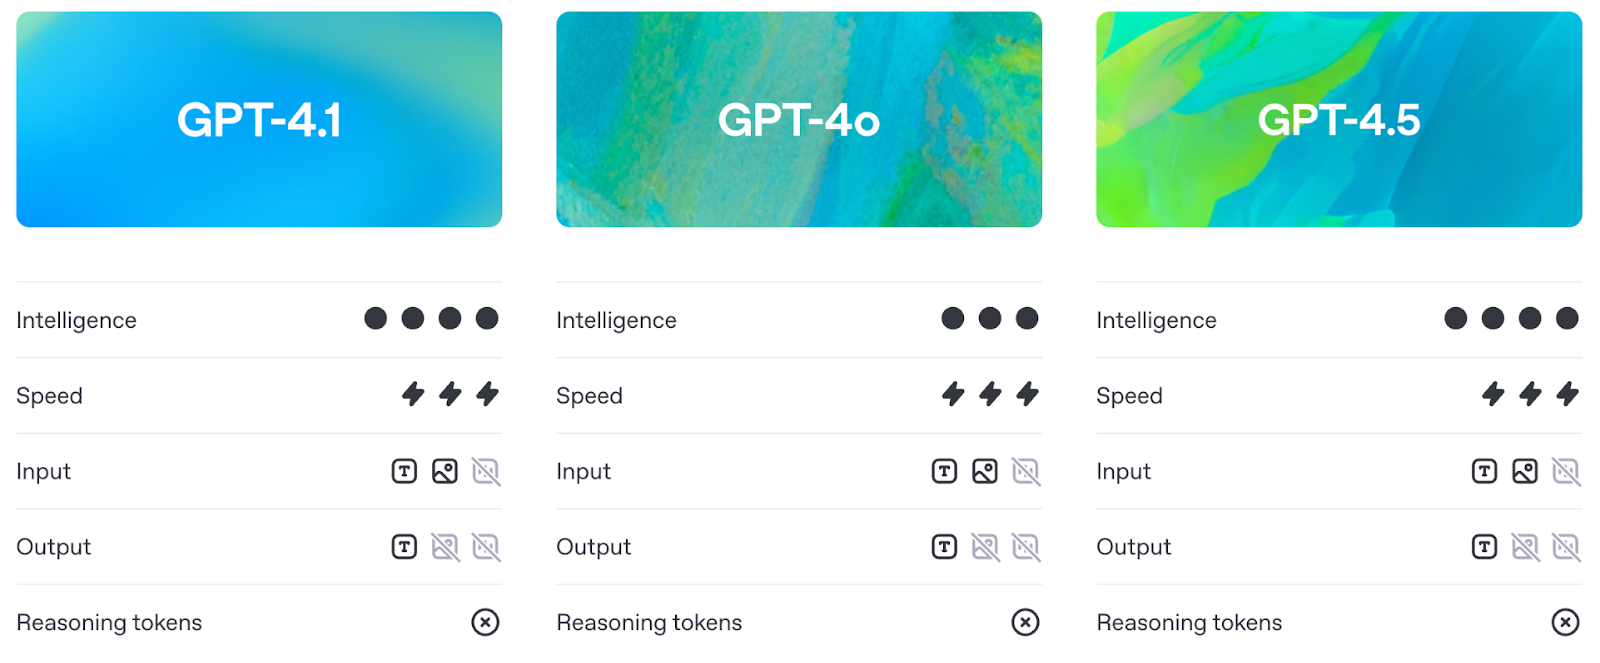
GPT-4.1 bouwt voort op de capaciteiten van GPT-4o terwijl de latency ongeveer gelijk blijft. In de praktijk betekent dit dat ontwikkelaars nu betere prestaties krijgen zonder in te leveren op reactietijd.
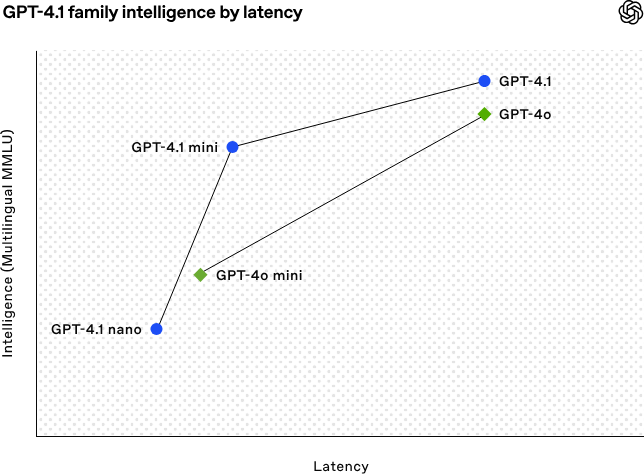
Bron: OpenAI
Laten we de bovenstaande grafiek ontleden:
GPT-4.5 daarentegen was altijd gepositioneerd als een research preview. Hoewel het sterk scoorde op redeneren en schrijfstijl, kwam het met meer overhead. GPT-4.1 levert vergelijkbare of betere resultaten op belangrijke benchmarks, maar is goedkoper en responsiever—voldoende reden voor OpenAI om 4.5 halverwege juli volledig uit te faseren om meer GPU’s vrij te maken.
Alle drie de GPT-4.1-modellen—standaard, Mini en Nano—ondersteunen tot 1 miljoen tokens aan context. Dat is meer dan 8x wat GPT-4o bood.
Deze lange-contextcapaciteit maakt praktische use-cases mogelijk zoals het verwerken van volledige logs, het indexeren van coderepository’s, het afhandelen van juridische workflows met meerdere documenten of het analyseren van lange transcripties—zonder vooraf te hoeven chunken of samenvatten.
GPT-4.1 markeert ook een verschuiving in hoe betrouwbaar de modellen instructies volgen. Het gaat goed om met complexe prompts met geordende stappen, opmaakbeperkingen en negatieve voorwaarden (zoals weigeren te antwoorden als de opmaak niet klopt).
In de praktijk betekent dit twee dingen: minder tijd aan promptcrafting en minder tijd aan het opschonen van de output achteraf.
GPT-4.1 laat vooruitgang zien op vier kerngebieden: coderen, instructieopvolging, begrip van lange context en multimodale taken.
Op SWE-bench Verified—een benchmark die het model in een echte codebase zet en vraagt om issues end-to-end op te lossen—scoort GPT-4.1 54,6%. Dat is een stijging ten opzichte van 33,2% voor GPT-4o en 38% voor GPT-4.5. Het is ook opvallend dat GPT-4.1 hoger scoort dan o1 en o3-mini.
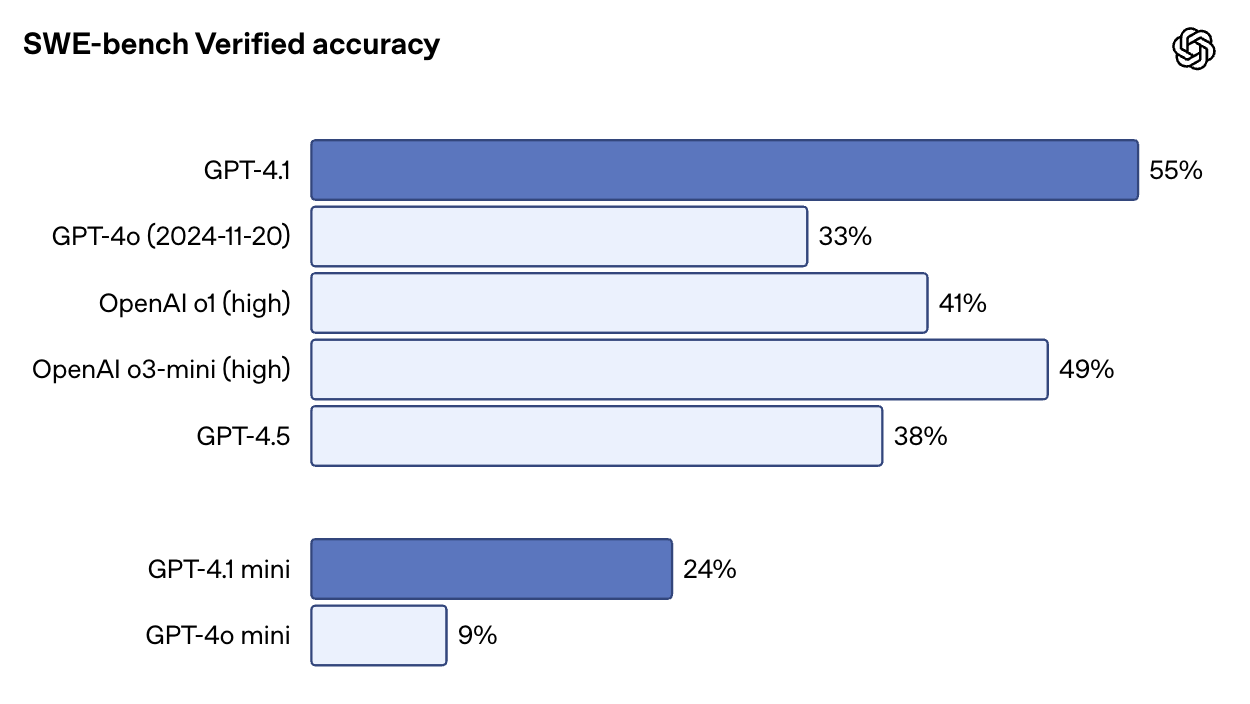
Bron: OpenAI
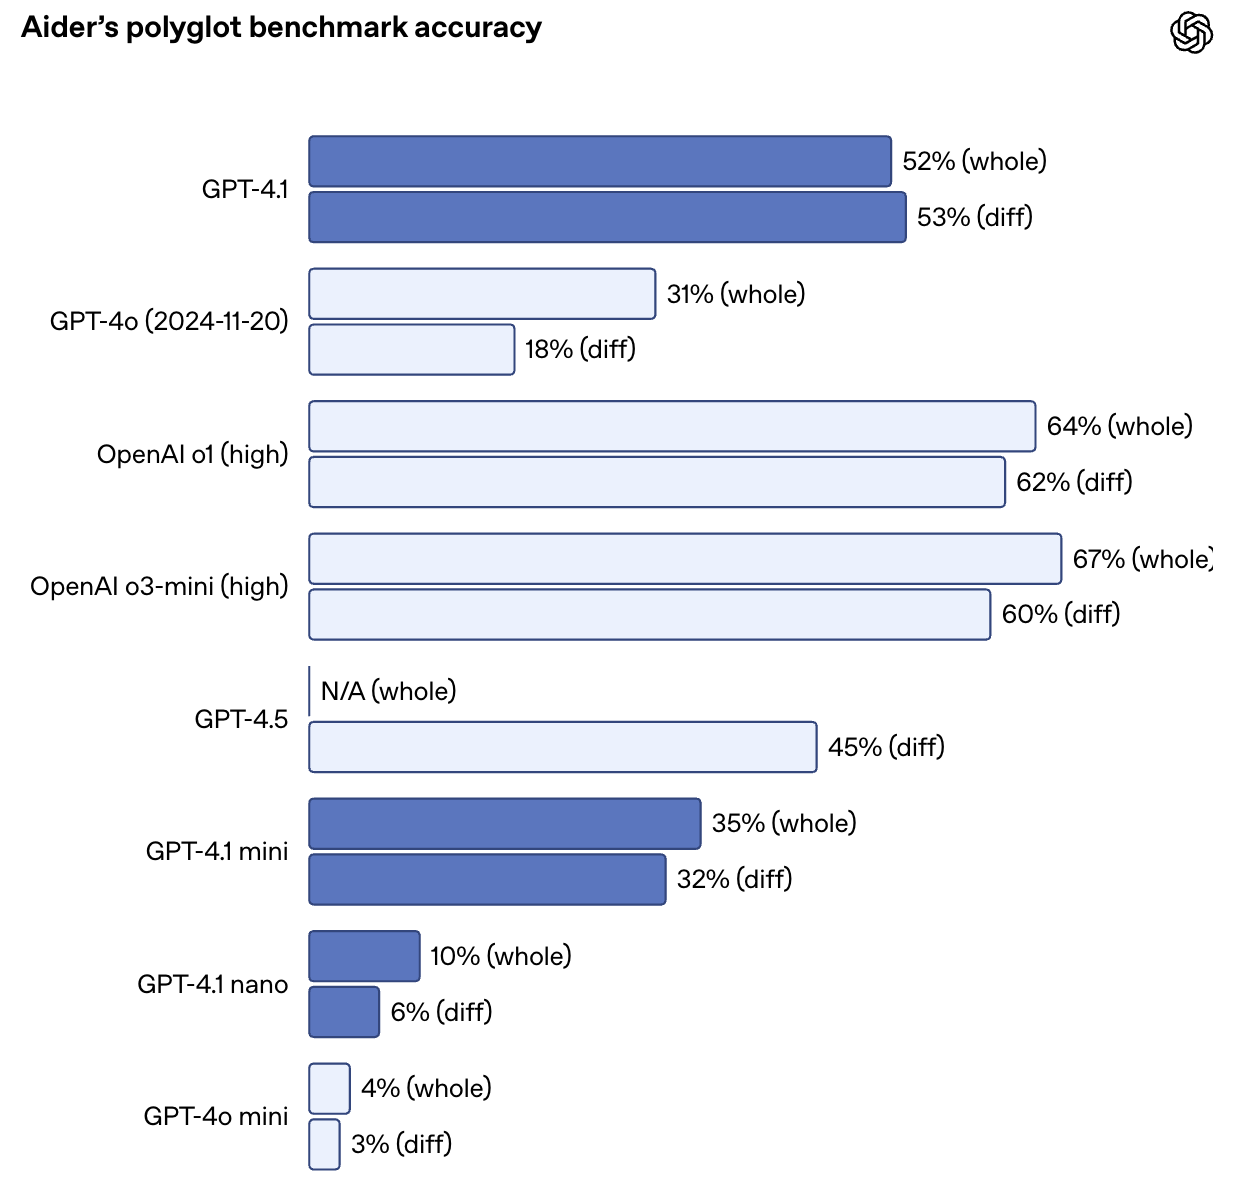
Het verdubbelt ook ruimschoots de prestaties van GPT-4o op Aider’s polyglot diff-benchmark, met 52,9% nauwkeurigheid op codediffs in meerdere talen en formaten. GPT-4.5 scoorde 44,9% op dezelfde taak. GPT-4.1 is ook preciezer: in interne evaluaties daalden overbodige codewijzigingen van 9% (GPT-4o) naar slechts 2%.
Bron: OpenAI
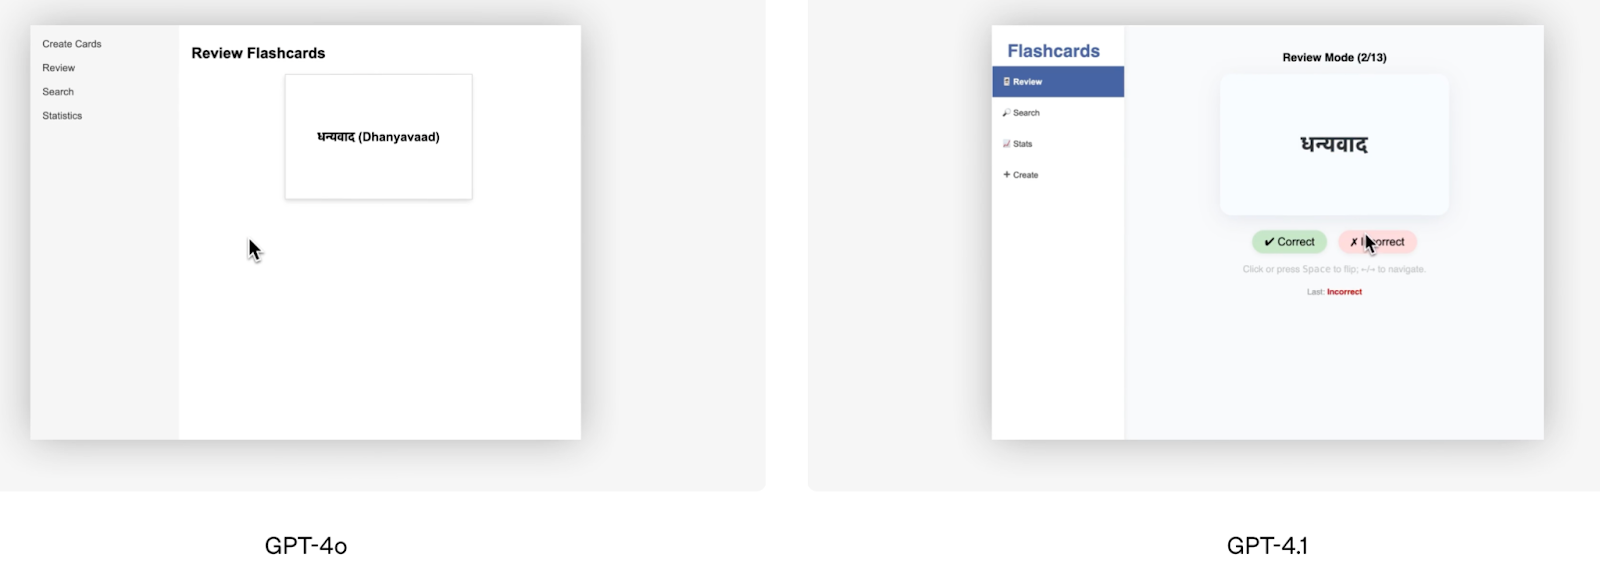
Buiten benchmarkcijfers om is de frontend-codingdemo van OpenAI een goed visueel voorbeeld van de superieure prestaties van GPT-4.1. Het team van OpenAI vroeg beide modellen om dezelfde flashcard-app te bouwen, en menselijke beoordelaars gaven in 80% van de gevallen de voorkeur aan de output van GPT-4.1.
Bron: OpenAI
Windsurf, een van de alfa-testers, rapporteerde een verbetering van 60% op hun eigen interne codeerbenchmark. Een ander bedrijf, Qodo, testte GPT-4.1 op echte GitHub-pull requests en concludeerde dat het 55% van de tijd betere suggesties gaf, met minder irrelevante of overdreven lange wijzigingen.
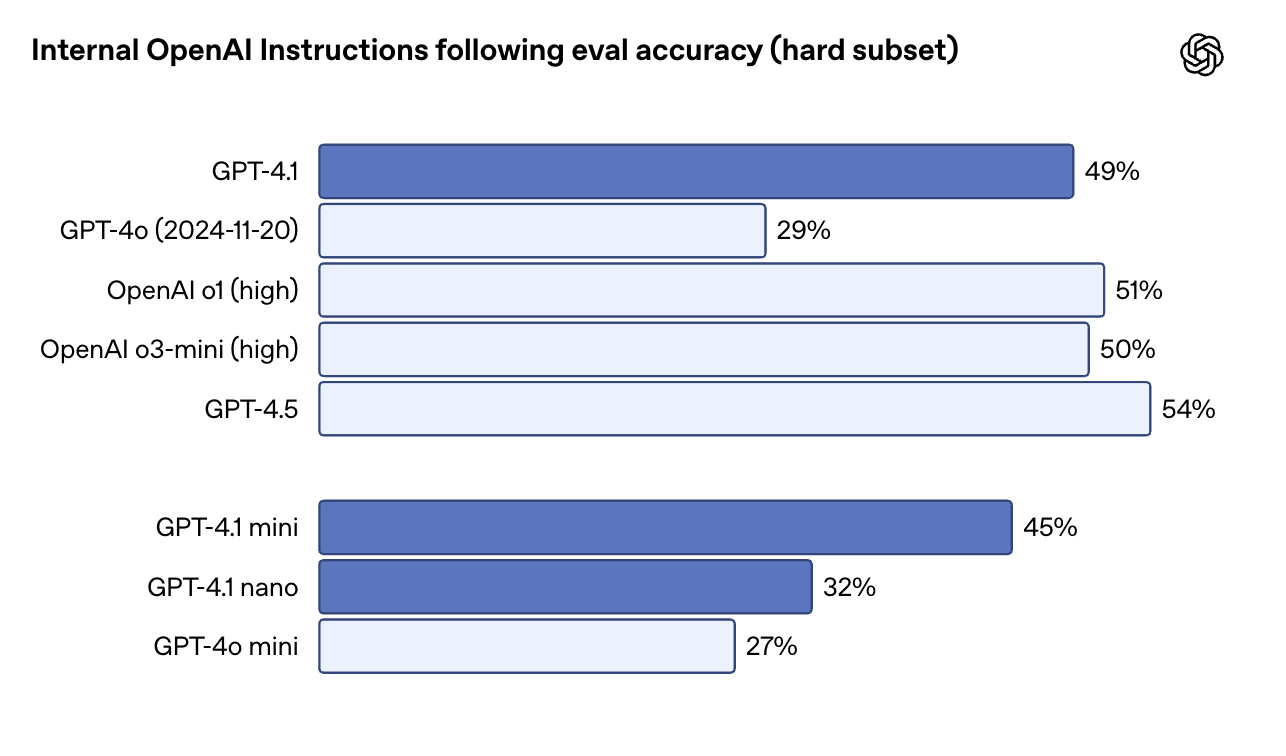
GPT-4.1 is letterlijker—en betrouwbaarder—bij het volgen van instructies, vooral voor taken met meerdere stappen, opmaakregels of voorwaarden. Op OpenAI’s interne evaluatie voor instructieopvolging (moeilijke subset) scoorde GPT-4.1 49,1%, tegenover slechts 29,2% voor GPT-4o. GPT-4.5 ligt hier iets voor met 54%, maar het verschil tussen 4.1 en 4o is aanzienlijk.
Bron: OpenAI
Op MultiChallenge, dat test of een model meerstapsinstructies kan volgen en beperkingen kan onthouden die eerder in het gesprek zijn geïntroduceerd, scoort GPT-4.1 38,3%—tegenover 27,8% voor GPT-4o. En op IFEval, dat naleving van duidelijk gespecificeerde outputvereisten test, haalt GPT-4.1 87,4%, een solide verbetering ten opzichte van GPT-4o’s 81%.
In de praktijk betekent dit dat GPT-4.1 beter vasthoudt aan geordende stappen, onjuist geformatteerde input afwijst en reageert in het formaat dat je vroeg—vooral bij gestructureerde outputs zoals XML, YAML of markdown. Dat maakt het ook eenvoudiger om betrouwbare agent-workflows te bouwen zonder veel prompt-retries.
Alle drie de GPT-4.1-modellen—standaard, Mini en Nano—ondersteunen tot 1 miljoen tokens aan context. Dat is een 8x toename ten opzichte van GPT-4o, dat maximaal 128K had. Minstens zo belangrijk: er zijn geen extra kosten voor het gebruik van dat contextvenster. Het wordt geprijsd zoals elke andere prompt.
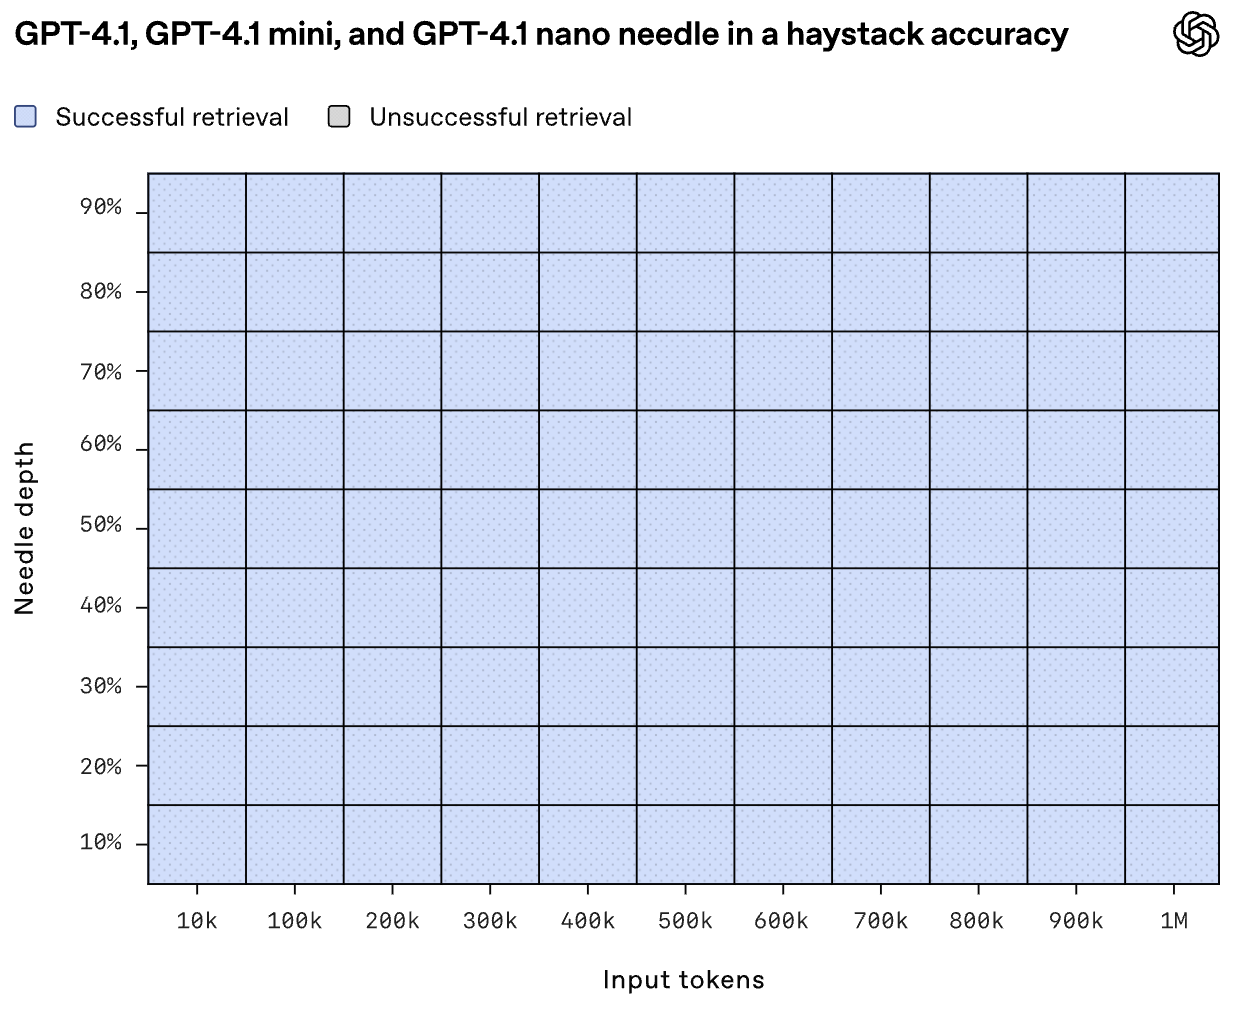
Maar kunnen de modellen al die context ook daadwerkelijk benutten? In OpenAI’s needle-in-a-haystack-evaluatie vond GPT-4.1 betrouwbaar ingevoegde content op elk punt—begin, midden of eind—binnen de volledige input van 1M tokens.
Bron: OpenAI
Graphwalks, een benchmark die multi-hop redeneren in lange contexten test, plaatst GPT-4.1 op 61,7%—een solide sprong vanaf GPT-4o’s 41,7%, al nog onder GPT-4.5 met 72,3%.
Deze verbeteringen zie je ook terug in praktijktests. Thomson Reuters zag een boost van 17% in juridische analyse met meerdere documenten met GPT-4.1, terwijl Carlyle een verbetering van 50% rapporteerde bij het extraheren van gedetailleerde data uit dense financiële rapporten.
Op multimodale taken boekt GPT-4.1 ook vooruitgang. Het scoorde 72,0% op de Video-MME-benchmark, waarbij vragen moeten worden beantwoord over video’s van 30–60 minuten zonder ondertiteling—tegenover 65,3% met GPT-4o.
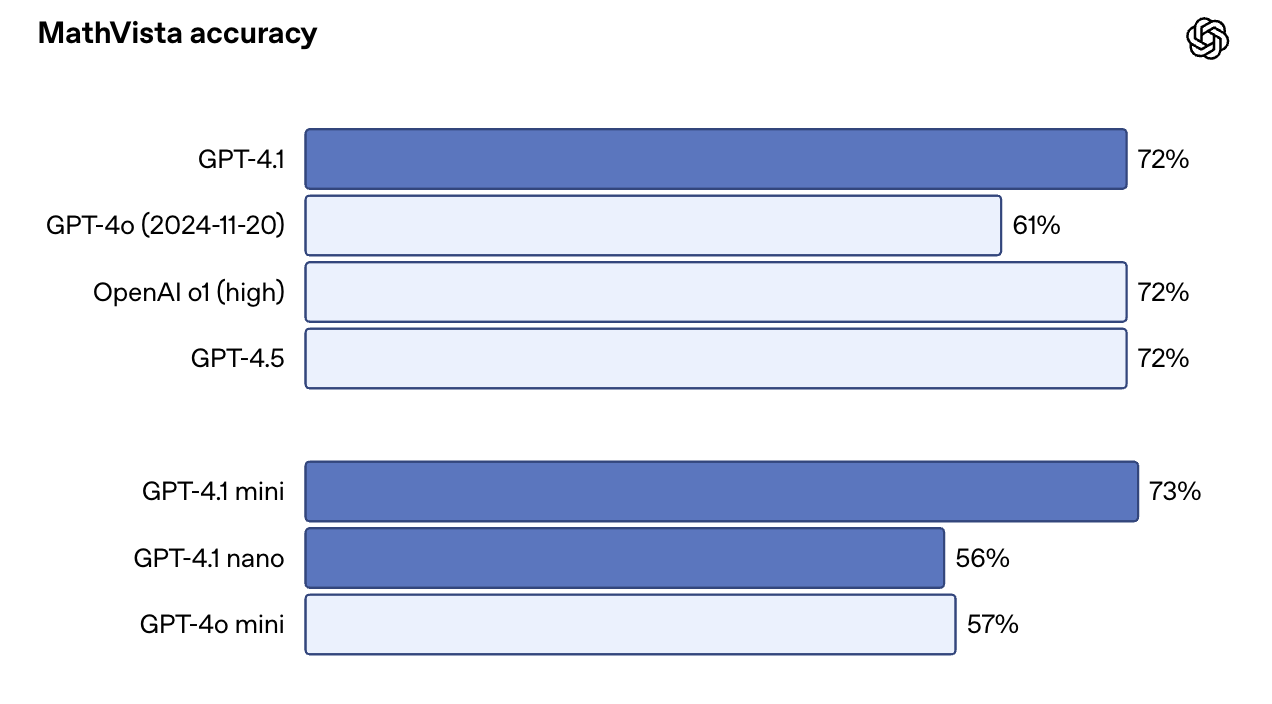
Op beeldzware benchmarks zoals MMMU haalde het 74,8% versus 68,7% voor GPT-4o. Op MathVista, met grafieken, diagrammen en wiskundige visuals, scoorde GPT-4.1 72,2%.
Een verrassing: GPT-4.1 Mini presteert op sommige van deze benchmarks bijna net zo goed als de volledige versie. Op MathVista, bijvoorbeeld, scoorde het zelfs net iets hoger dan GPT-4.1 met 73,1%. Dat maakt het een aantrekkelijke keuze voor use-cases die snelheid combineren met beeldintensieve prompts.
Bron: OpenAI
Je hebt nu rechtstreeks toegang tot GPT-4.1 en GPT-4.1 Mini in de ChatGPT-app, niet alleen via de API. Plus-, Pro- en Team-abonnees kunnen GPT-4.1 handmatig selecteren in het modelmenu, terwijl gratis gebruikers automatisch terugvallen op GPT-4.1 Mini—achter de schermen de vervanger van GPT-4o Mini. Enterprise- en Education-plannen krijgen naar verwachting binnen enkele weken toegang.
Voor ontwikkelaars blijven de OpenAI API en de Playground alle drie de varianten ondersteunen—GPT-4.1, GPT-4.1 Mini en GPT-4.1 Nano. Dit blijft de beste manier om prompts te testen, gedrag met lange context te verkennen en modellen te vergelijken voordat je ze in productie integreert.
Werk je met lange documenten—denk aan logs, pdf’s, juridische dossiers of wetenschappelijke artikelen—dan kun je tot 1 miljoen tokens in één call versturen, zonder speciale parameter. Er is ook geen prijsstijging voor lange context: de tokenkosten zijn vlak, ongeacht de invoergrootte.
Je kunt alle drie de GPT-4.1-varianten fine-tunen. Dat opent de deur voor aangepaste instructies, domeinspecifieke woordenschat of toon-specifieke outputs. Let op dat fine-tunen een iets hogere pricing:
|
Model |
Input |
Gecachte input |
Output |
Training |
|
GPT-4.1 |
$3.00 / 1M tokens |
$0.75 / 1M tokens |
$12.00 / 1M tokens |
$25.00 / 1M tokens |
|
GPT-4.1 Mini |
$0.80 / 1M tokens |
$0.20 / 1M tokens |
$3.20 / 1M tokens |
$5.00 / 1M tokens |
|
GPT-4.1 Nano |
$0.20 / 1M tokens |
$0.05 / 1M tokens |
$0.80 / 1M tokens |
$1.50 / 1M tokens |
Als je eerder GPT-3.5- of GPT-4-modellen hebt gefinetuned, blijft het proces grotendeels hetzelfde—kies gewoon de nieuwere basis. Wil je meer leren, dan raad ik deze tutorial aan over fine-tunen van GPT-4o mini.
Een van de prettigste updates met GPT-4.1 is dat het niet alleen slimmer is—het is ook goedkoper. OpenAI zegt dat het doel is om deze modellen bruikbaarder te maken in meer realistische workflows, en dat zie je terug in de prijsstructuur.
Zo zijn de drie modellen geprijsd voor inference:
|
Model |
Input |
Gecachte input |
Output |
Gemiddelde ‘blended’ kosten* |
|
GPT-4.1 |
$2.00 / 1M tokens |
$0.50 / 1M tokens |
$8.00 / 1M tokens |
$1.84 |
|
GPT-4.1 Mini |
$0.40 / 1M tokens |
$0.10 / 1M tokens |
$1.60 / 1M tokens |
$0.42 |
|
GPT-4.1 Nano |
$0.10 / 1M tokens |
$0.025 / 1M tokens |
$0.40 / 1M tokens |
$0.12 |
*Het “blended”-getal is gebaseerd op OpenAI’s aanname van typische input/output-verhoudingen.
GPT-4.1 biedt betrouwbaardere codegeneratie, betere instructieopvolging, echte langetermijncontextverwerking en snellere iteratie.
De naamgeving mag dan verwarrend zijn, de modellen zelf zijn duidelijk capabeler dan hun voorgangers. Ze zijn ook betaalbaarder—en bruikbaarder—vooral in productieomgevingen waar latency, kosten en voorspelbaarheid tellen.
Werk je vandaag met GPT-4o, dan is het de moeite waard om GPT-4.1 te testen.
Leer AI met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

