OpenAI ने हाल ही में GPT-4.1 जारी किया है, कोडिंग कार्यों के लिए खास तौर पर बनाए गए मॉडलों का नया परिवार। मैं भी सभी की तरह GPT-4.5 से GPT-4.1 पर नाम में हुई छलांग को लेकर उलझन में हूँ, लेकिन शुक्र है कि बेंचमार्क्स पीछे नहीं गए—बल्कि उल्टा।
रोलआउट 14 अप्रैल को केवल API एक्सेस से शुरू हुआ। फिर, 14 मई को OpenAI ने GPT-4.1 को ChatGPT ऐप में लाना शुरू किया। फ्री-टियर उपयोगकर्ता GPT-4.1 को मैन्युअल रूप से नहीं चुन पाएंगे, लेकिन अब उन्हें GPT-4o Mini की जगह नए डिफ़ॉल्ट फॉलबैक के रूप में GPT-4.1 Mini का लाभ मिलता है।
GPT-4.1 तीन आकारों में आता है: GPT-4.1, GPT-4.1 Mini, और GPT-4.1 Nano। तीनों ही 1 मिलियन टोकन तक का संदर्भ संभालते हैं और कोडिंग, निर्देश पालन, तथा लंबी संदर्भ सामग्री समझने में उल्लेखनीय सुधार लाते हैं। ये पिछले रिलीज़ की तुलना में सस्ते और तेज़ भी हैं।
इस लेख में, मैं बताऊँगा कि प्रत्येक मॉडल क्या कर सकता है, यह GPT-4o और GPT-4.5 से कैसे तुलना करता है, और बेंचमार्क तथा वास्तविक उपयोग में यह कहाँ ठहरता है।
हम अपने पाठकों को AI की ताज़ा जानकारियों से अपडेट रखते हैं The Median के ज़रिए—हमारा मुफ्त शुक्रवार न्यूज़लेटर जो हफ्ते की प्रमुख कहानियाँ सरल भाषा में समझाता है। कुछ ही मिनटों में तेज बने रहने के लिए सदस्यता लें:
GPT-4.1 क्या है?
GPT-4.1 मॉडल सूट में तीन मॉडल शामिल हैं: GPT-4.1, GPT-4.1 Mini, और GPT-4.1 Nano। ये उन डेवलपर्स के लिए बनाए गए हैं जिन्हें बेहतर प्रदर्शन, लंबा संदर्भ, और अधिक पूर्वानुमेय निर्देश पालन चाहिए। हर मॉडल 1 मिलियन टोकन तक का संदर्भ सपोर्ट करता है—जो GPT-4o जैसे पिछले संस्करणों की 128K सीमा से बड़ा उछाल है।
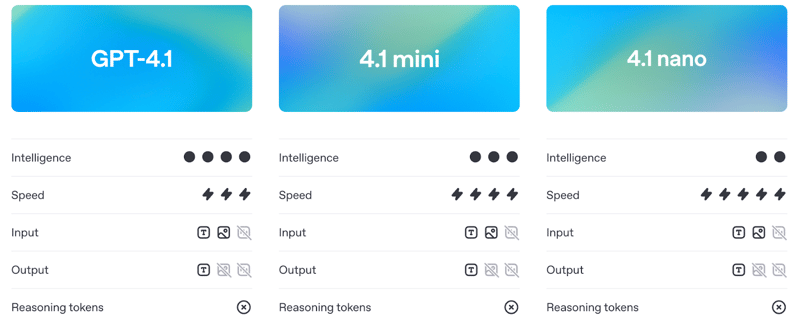
स्रोत: OpenAI
साझा आर्किटेक्चर के बावजूद, हर संस्करण अलग-अलग उपयोग मामलों के लिए ट्यून किया गया है। आइए प्रत्येक को विस्तार से देखते हैं।
GPT-4.1
यह फ्लैगशिप मॉडल है। यदि आप कोडिंग, निर्देश पालन, और लंबी-संदर्भ वाली जिम्मेदारियों में सर्वोत्तम समग्र प्रदर्शन चाहते हैं, तो यही चुनें। यह जटिल कोडिंग वर्कफ़्लो को संभालने या एक ही प्रॉम्प्ट में बड़े दस्तावेज़ प्रोसेस करने के लिए बना है।
बेंचमार्क्स में, यह वास्तविक दुनिया की सॉफ्टवेयर इंजीनियरिंग (SWE-bench), निर्देश पालन (MultiChallenge), और लंबी-संदर्भ तर्क (MRCR, Graphwalks) में GPT-4o से बेहतर है। यह संरचना और फ़ॉर्मैटिंग का सम्मान करने में भी स्पष्ट रूप से बेहतर है—जैसे XML प्रतिक्रियाएँ, क्रमबद्ध निर्देश, और ऐसी नकारात्मक शर्तें जैसे “जब तक ... न हो, जवाब न दें।”
आप लॉन्च के दिन से ही GPT-4.1 को फाइन-ट्यून भी कर सकते हैं, जो टोन, फ़ॉर्मैट, या डोमेन नॉलेज पर नियंत्रण महत्वपूर्ण होने वाले प्रोडक्शन उपयोग मामलों के लिए इसे और उपयोगी बनाता है।
GPT-4.1 Mini
GPT-4.1 Mini मिड-टियर विकल्प है, जो लगभग पूर्ण मॉडल जैसी क्षमताएँ कम विलंबता और लागत के साथ देता है। यह कई बेंचमार्क्स पर, जिनमें निर्देश पालन और इमेज-आधारित तर्क शामिल हैं, GPT-4o की बराबरी करता है या उसे पछाड़ता है।
यह कई उपयोग मामलों के लिए डिफ़ॉल्ट पसंद बन सकता है: इंटरैक्टिव टूल्स के लिए पर्याप्त तेज़, विस्तृत निर्देशों का पालन करने के लिए पर्याप्त स्मार्ट, और पूर्ण मॉडल से काफी सस्ता।
पूर्ण संस्करण की तरह, यह भी 1 मिलियन टोकन का संदर्भ सपोर्ट करता है और फाइन-ट्यूनिंग के लिए पहले से उपलब्ध है।
GPT-4.1 Nano
Nano सबसे छोटा, सबसे तेज़, और सबसे सस्ता है। यह ऑटोकम्प्लीट, वर्गीकरण, और बड़े दस्तावेज़ों से जानकारी निकालने जैसे कार्यों के लिए बनाया गया है। हल्का होने के बावजूद, यह 1 मिलियन-टोकन का पूरा संदर्भ विंडो सपोर्ट करता है।
यह OpenAI का अब तक का सबसे छोटा, सबसे तेज़, और सबसे सस्ता मॉडल भी है—लगभग 10 सेंट प्रति 1 मिलियन टोकन। आपको बड़े मॉडलों जैसी पूरी तर्क और योजना क्षमता नहीं मिलेगी, लेकिन कुछ कार्यों के लिए यही बात मायने नहीं रखती।
GPT-4.1 बनाम GPT-4o और GPT-4.5
बेंचमार्क्स में जाने से पहले (जिसे हम अगले सेक्शन में विस्तार से कवर करेंगे), यह समझना उपयोगी है कि व्यवहार में GPT-4.1, GPT-4o और GPT-4.5 से कैसे अलग है।
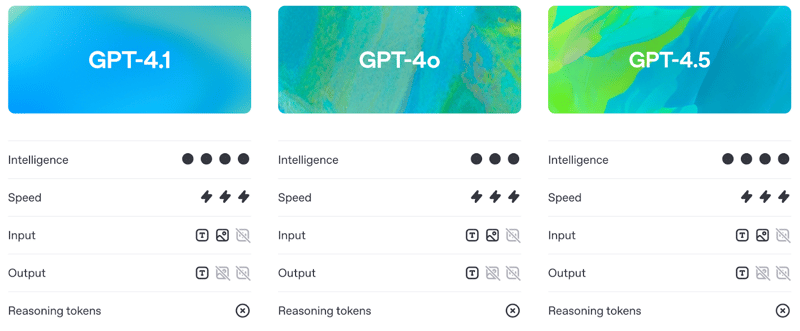
GPT-4o से अधिक स्मार्ट, GPT-4.5 से अधिक व्यावहारिक
GPT-4.1, GPT-4o की क्षमताओं में सुधार करता है जबकि विलंबता को लगभग उसी दायरे में रखता है। व्यवहार में, इसका मतलब है कि डेवलपर्स अब प्रतिक्रियाशीलता की कीमत चुकाए बिना बेहतर प्रदर्शन पाते हैं।
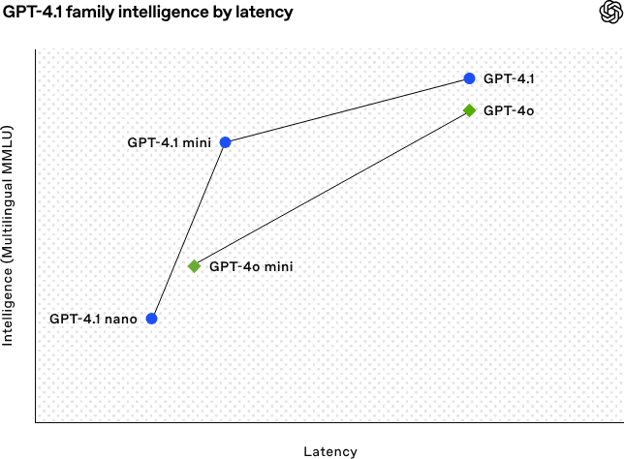
स्रोत: OpenAI
ऊपर दिए ग्राफ़ को तोड़कर समझें:
- विलंबता के मामले में GPT-4.1 और GPT-4o लगभग एक ही स्थान पर आते हैं, लेकिन बुद्धिमत्ता में GPT-4.1 आगे निकलता है। यानी आपको समान गति पर अधिक स्मार्ट (और सस्ता) मॉडल मिलता है।
- GPT-4.1 Mini भी GPT-4o Mini से अधिक सक्षम है, लेकिन इस बढ़त के साथ एक छोटा सा समझौता है: विलंबता में थोड़ी वृद्धि।
- गति में GPT-4.1 Nano स्पष्ट विजेता है—ग्राफ़ में सबसे बाएँ। MMLU पर यह उतना मज़बूत नहीं है, लेकिन यह अपेक्षित है—इसे हल्के कार्यों के लिए बनाया गया है जहाँ कच्चे तर्क से ज्यादा गति मायने रखती है।
दूसरी ओर, GPT-4.5 हमेशा एक रिसर्च प्रीव्यू के रूप में पोजिशन किया गया था। इसमें तर्क और लेखन गुणवत्ता मजबूत थी, लेकिन ओवरहेड भी अधिक था। GPT-4.1 प्रमुख बेंचमार्क्स पर समान या बेहतर नतीजे देता है, जबकि यह सस्ता और अधिक प्रतिक्रियाशील है—इतना कि OpenAI मध्य जुलाई तक 4.5 को पूरी तरह रिटायर करने की योजना बना रहा है ताकि अधिक GPUs खाली किए जा सकें।
1 मिलियन टोकन का संदर्भ
तीनों GPT-4.1 मॉडल—स्टैंडर्ड, Mini, और Nano—1 मिलियन टोकन तक का संदर्भ सपोर्ट करते हैं। यह GPT-4o की पेशकश से 8 गुना से भी अधिक है।
यह लंबा संदर्भ क्षमता व्यावहारिक उपयोग मामलों को सक्षम करती है, जैसे पूरे लॉग्स प्रोसेस करना, कोड रिपॉजिटरी इंडेक्स करना, बहु-दस्तावेज़ी कानूनी वर्कफ़्लो संभालना, या लंबे ट्रांसक्रिप्ट्स का विश्लेषण—वह भी बिना पहले से चंकिंग या सार-संक्षेप किए।
बेहतर निर्देश पालन
GPT-4.1 इस बात में भी बदलाव लाता है कि मॉडल कितनी विश्वसनीयता से निर्देशों का पालन करते हैं। यह क्रमबद्ध चरणों, फ़ॉर्मैटिंग बाधाओं, और नकारात्मक शर्तों (जैसे यदि फ़ॉर्मैटिंग गलत है तो उत्तर देने से इनकार) वाले जटिल प्रॉम्प्ट्स को संभालता है।
व्यवहार में, इसका मतलब दो बातें हैं: प्रॉम्प्ट तैयार करने में कम समय, और बाद में आउटपुट साफ़ करने में भी कम समय।
GPT-4.1 बेंचमार्क्स
GPT-4.1 चार कोर क्षेत्रों में प्रगति दिखाता है: कोडिंग, निर्देश पालन, लंबी-संदर्भ समझ, और मल्टीमॉडल कार्य।
कोडिंग प्रदर्शन
SWE-bench Verified पर—एक बेंचमार्क जो मॉडल को वास्तविक कोडबेस में डालता है और उससे एंड-टू-एंड इश्यू पूरे करने को कहता है—GPT-4.1 ने 54.6% स्कोर किया। यह GPT-4o के 33.2% और GPT-4.5 के 38% से ऊपर है। यह भी काफ़ी प्रभावशाली है कि GPT-4.1 ने o1 और o3-mini से भी अधिक स्कोर किया।
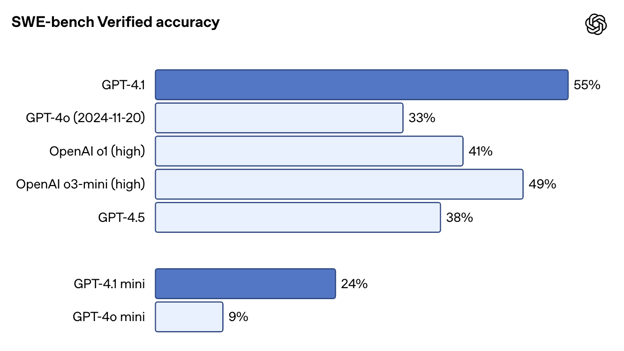
स्रोत: OpenAI
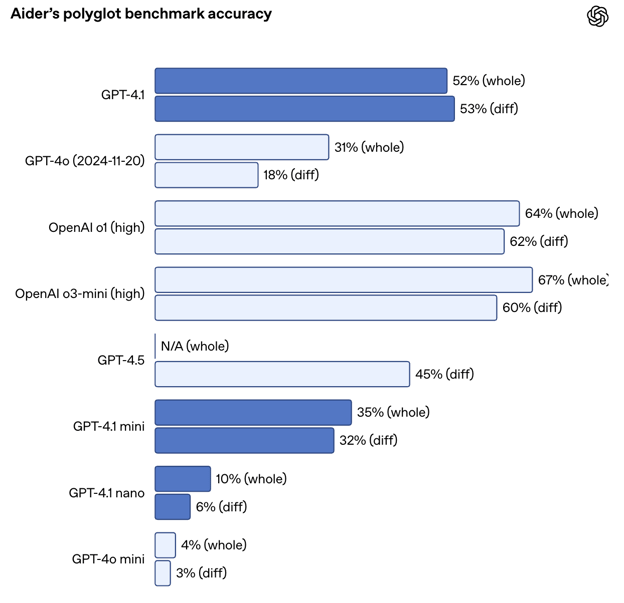
यह Aider के पॉलीग्लॉट डिफ़ बेंचमार्क पर GPT-4o के प्रदर्शन को दोगुने से अधिक कर देता है, और कई भाषाओं व फ़ॉर्मैट्स में कोड डिफ़्स पर 52.9% सटीकता तक पहुँचता है। इसी कार्य पर GPT-4.5 ने 44.9% स्कोर किया। GPT-4.1 अधिक सटीक भी है: इंटरनल इवैल्स में, अनावश्यक कोड एडिट्स 9% (GPT-4o) से घटकर मात्र 2% रह गए।
स्रोत: OpenAI
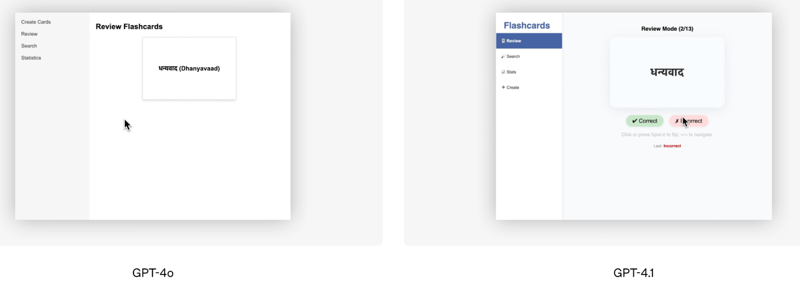
बेंचमार्क स्कोर से इतर, OpenAI द्वारा दिखाया गया फ्रंटएंड कोडिंग डेमो GPT-4.1 के श्रेष्ठ प्रदर्शन का अच्छा दृश्य उदाहरण है। OpenAI की टीम ने दोनों मॉडलों से एक ही फ़्लैशकार्ड ऐप बनवाया, और मानव रेटर्स ने 80% मामलों में GPT-4.1 के आउटपुट को प्राथमिकता दी।
स्रोत: OpenAI
अल्फा टेस्टर्स में से एक, Windsurf, ने अपने इंटरनल कोडिंग बेंचमार्क पर 60% सुधार की रिपोर्ट की। एक अन्य कंपनी, Qodo, ने GPT-4.1 का परीक्षण वास्तविक GitHub पुल रिक्वेस्ट्स पर किया और पाया कि इसने 55% मामलों में बेहतर सुझाव दिए, और अप्रासंगिक या अत्यधिक शब्दाडंबर वाले एडिट्स कम किए।
निर्देश पालन
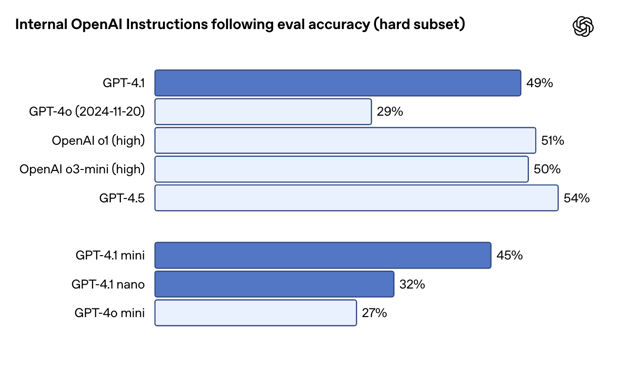
निर्देशों का पालन करने में—खासकर बहु-चरणीय कार्यों, फ़ॉर्मैटिंग नियमों, या शर्तों वाले कामों में—GPT-4.1 अधिक शाब्दिक और अधिक विश्वसनीय है। OpenAI के इंटरनल निर्देश पालन इवैल (हार्ड सबसेट) में GPT-4.1 ने 49.1% स्कोर किया, जबकि GPT-4o केवल 29.2% पर रहा। यहाँ GPT-4.5 थोड़ा आगे है 54% पर, लेकिन 4.1 और 4o के बीच का अंतर महत्वपूर्ण है।
स्रोत: OpenAI
MultiChallenge पर, जो जाँचता है कि कोई मॉडल बहु-टर्न निर्देशों का पालन कर सकता है और बातचीत में पहले पेश की गई बाधाओं को याद रख सकता है या नहीं, GPT-4.1 ने 38.3% स्कोर किया—जो GPT-4o के 27.8% से ऊपर है। और IFEval पर, जो स्पष्ट रूप से निर्दिष्ट आउटपुट आवश्यकताओं के अनुपालन की जाँच करता है, GPT-4.1 87.4% तक पहुँचा—GPT-4o के 81% पर ठोस सुधार।
व्यवहार में, इसका मतलब है कि GPT-4.1 क्रमबद्ध चरणों का पालन करने, बिगड़े हुए इनपुट को अस्वीकार करने, और आपके द्वारा माँगे गए फ़ॉर्मैट में प्रतिक्रिया देने में बेहतर है—खासकर XML, YAML, या मार्कडाउन जैसे संरचित आउटपुट्स में। इससे बिना ढेर सारे प्रॉम्प्ट रिट्राई के विश्वसनीय एजेंट वर्कफ़्लोज़ बनाना भी आसान हो जाता है।
लंबी-संदर्भ तर्क
तीनों GPT-4.1 मॉडल—स्टैंडर्ड, Mini, और Nano—1 मिलियन टोकन तक का संदर्भ सपोर्ट करते हैं। यह GPT-4o के 128K की सीमा पर 8 गुना वृद्धि है। उतना ही अहम: इस संदर्भ विंडो के उपयोग पर कोई अतिरिक्त लागत नहीं है। इसकी कीमत किसी भी अन्य प्रॉम्प्ट की तरह ही है।
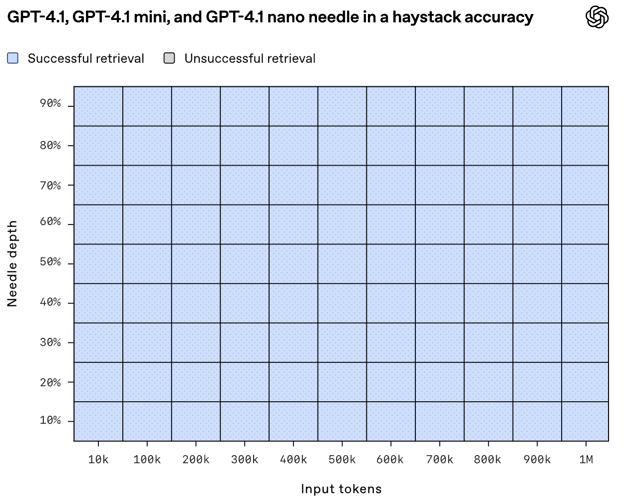
लेकिन क्या मॉडल वास्तव में उस पूरे संदर्भ का उपयोग कर सकते हैं? OpenAI के नीडल-इन-ए-हेयस्टैक इवैल में, GPT-4.1 ने 1M-टोकन के पूरे इनपुट में—शुरुआत, बीच, या अंत—कहीं भी डाले गए कंटेंट को भरोसेमंद रूप से ढूँढ लिया।
स्रोत: OpenAI
Graphwalks—जो लंबी संदर्भों में मल्टी-हॉप तर्क का परीक्षण करता है—GPT-4.1 को 61.7% पर रखता है—GPT-4o के 41.7% से ठोस छलांग, हालांकि GPT-4.5 के 72.3% से अभी नीचे।
ये सुधार वास्तविक दुनिया के परीक्षणों में भी दिखते हैं। Thomson Reuters ने 17% बढ़त देखी बहु-दस्तावेज़ी कानूनी विश्लेषण में GPT-4.1 के साथ, जबकि Carlyle ने घने वित्तीय रिपोर्ट्स से सूक्ष्म डेटा निकालने में 50% सुधार दर्ज किया।
मल्टीमॉडल और विज़न कार्य
मल्टीमॉडल कार्यों में भी GPT-4.1 प्रगति करता है। इसने Video-MME बेंचमार्क पर 72.0% स्कोर किया, जिसमें 30–60 मिनट के बिना सबटाइटल वाले वीडियो पर प्रश्नों के उत्तर देने होते हैं—GPT-4o के 65.3% से ऊपर।
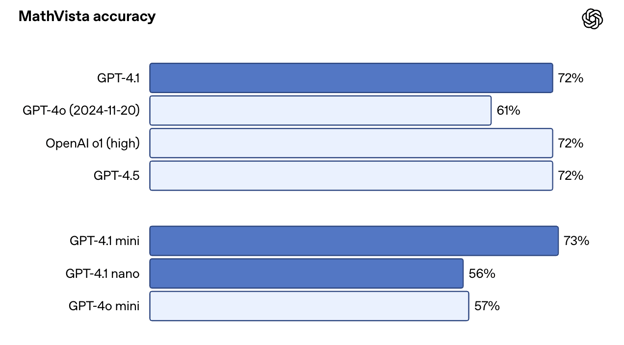
MMMU जैसे इमेज-प्रधान बेंचमार्क्स पर, यह 74.8% तक पहुँचा बनाम GPT-4o के 68.7%। MathVista पर—जिसमें चार्ट, ग्राफ़, और गणितीय विज़ुअल्स शामिल हैं—GPT-4.1 ने 72.2% हासिल किया।
एक चौंकाने वाली बात: GPT-4.1 Mini इन बेंचमार्क्स में से कुछ पर लगभग पूर्ण संस्करण जितना ही अच्छा प्रदर्शन करता है। उदाहरण के लिए, MathVista पर इसने 73.1% के साथ GPT-4.1 को थोड़ा पीछे छोड़ा। यह उन उपयोग मामलों के लिए आकर्षक विकल्प बनाता है जो गति को विज़न-प्रधान प्रॉम्प्ट्स के साथ जोड़ते हैं।
स्रोत: OpenAI
GPT-4.1 का एक्सेस कैसे पाएँ
अब आप GPT-4.1 और GPT-4.1 Mini तक सीधे ChatGPT ऐप में पहुँच सकते हैं, सिर्फ API के ज़रिए ही नहीं। Plus, Pro, और Team सब्सक्राइबर्स मॉडल मेन्यू से GPT-4.1 को मैन्युअल रूप से चुन सकते हैं, जबकि फ्री उपयोगकर्ता स्वतः GPT-4.1 Mini पर फॉलबैक करते हैं—पर्दे के पीछे GPT-4o Mini की जगह यह नया डिफ़ॉल्ट बन गया है। Enterprise और Education प्लान्स को आने वाले हफ्तों में एक्सेस मिलने की उम्मीद है।
डेवलपर्स के लिए, OpenAI API और Playground तीनों वेरिएंट्स—GPT-4.1, GPT-4.1 Mini, और GPT-4.1 Nano—को सपोर्ट करते हैं। इंटीग्रेशन से पहले प्रॉम्प्ट्स टेस्ट करने, लंबी-संदर्भ व्यवहार एक्सप्लोर करने, और मॉडलों की तुलना करने का यह अब भी सबसे अच्छा तरीका है।
यदि आप लंबे दस्तावेज़ों—जैसे लॉग्स, PDFs, कानूनी रिकॉर्ड्स, या अकादमिक आलेख—पर काम कर रहे हैं, तो आप एक ही कॉल में 1 मिलियन टोकन तक भेज सकते हैं, किसी विशेष पैरामीटर की आवश्यकता नहीं। लंबी संदर्भ के लिए कोई अतिरिक्त कीमत भी नहीं: टोकन लागतें इनपुट आकार की परवाह किए बिना फ्लैट हैं।
GPT-4.1 को फाइन-ट्यून करना
आप GPT-4.1 के तीनों वेरिएंट्स को फाइन-ट्यून कर सकते हैं। इससे कस्टम निर्देश, डोमेन-विशिष्ट शब्दावली, या टोन-विशिष्ट आउटपुट्स के लिए रास्ता खुलता है। ध्यान दें कि फाइन-ट्यूनिंग की pricing थोड़ी अधिक है:
|
मॉडल
|
इनपुट
|
कैश्ड इनपुट
|
आउटपुट
|
ट्रेनिंग
|
|
GPT-4.1
|
$3.00 / 1M tokens
|
$0.75 / 1M tokens
|
$12.00 / 1M tokens
|
$25.00 / 1M tokens
|
|
GPT-4.1 Mini
|
$0.80 / 1M tokens
|
$0.20 / 1M tokens
|
$3.20 / 1M tokens
|
$5.00 / 1M tokens
|
|
GPT-4.1 Nano
|
$0.20 / 1M tokens
|
$0.05 / 1M tokens
|
$0.80 / 1M tokens
|
$1.50 / 1M tokens
|
अगर आपने पहले GPT-3.5 या GPT-4 मॉडलों को फाइन-ट्यून किया है, तो प्रक्रिया लगभग वही है—बस नया बेस चुनें। यदि आप और सीखना चाहते हैं, तो मैं यह ट्यूटोरियल सुझाऊँगा: GPT-4o mini को फाइन-ट्यून करना।
GPT-4.1 की कीमत
GPT-4.1 के साथ एक स्वागतयोग्य अपडेट यह भी है कि यह केवल ज़्यादा स्मार्ट नहीं—बल्कि सस्ता भी है। OpenAI का कहना है कि लक्ष्य इन मॉडलों को अधिक वास्तविक वर्कफ़्लो में अधिक उपयोगी बनाना था, और यह प्राइसिंग संरचना में झलकता है।
इन्फरence के लिए तीनों मॉडलों की कीमत इस प्रकार है:
|
मॉडल
|
इनपुट
|
कैश्ड इनपुट
|
आउटपुट
|
ब्लेंडेड औसत लागत*
|
|
GPT-4.1
|
$2.00 / 1M tokens
|
$0.50 / 1M tokens
|
$8.00 / 1M tokens
|
$1.84
|
|
GPT-4.1 Mini
|
$0.40 / 1M tokens
|
$0.10 / 1M tokens
|
$1.60 / 1M tokens
|
$0.42
|
|
GPT-4.1 Nano
|
$0.10 / 1M tokens
|
$0.025 / 1M tokens
|
$0.40 / 1M tokens
|
$0.12
|
*यह “ब्लेंडेड” संख्या OpenAI के सामान्य इनपुट/आउटपुट अनुपात के अनुमान पर आधारित है।
निष्कर्ष
GPT-4.1 अधिक विश्वसनीय कोड जेनरेशन, बेहतर निर्देश पालन, सच्चा लंबा-संदर्भ प्रोसेसिंग, और तेज़ इटरेशन के साथ आता है।
नामकरण भले उलझन भरा हो, पर मॉडल खुद पिछले संस्करणों से स्पष्ट रूप से अधिक सक्षम हैं। ये अधिक किफायती—और अधिक उपयोगी—भी हैं, खासकर उन प्रोडक्शन वातावरणों में जहाँ विलंबता, लागत, और पूर्वानुमेयता मायने रखती है।
यदि आप आज GPT-4o के साथ काम कर रहे हैं, तो GPT-4.1 को ज़रूर परखें।


OpenAI ने हाल ही में GPT-4.1 जारी किया है, कोडिंग कार्यों के लिए खास तौर पर बनाए गए मॉडलों का नया परिवार। मैं भी सभी की तरह GPT-4.5 से GPT-4.1 पर नाम में हुई छलांग को लेकर उलझन में हूँ, लेकिन शुक्र है कि बेंचमार्क्स पीछे नहीं गए—बल्कि उल्टा।
रोलआउट 14 अप्रैल को केवल API एक्सेस से शुरू हुआ। फिर, 14 मई को OpenAI ने GPT-4.1 को ChatGPT ऐप में लाना शुरू किया। फ्री-टियर उपयोगकर्ता GPT-4.1 को मैन्युअल रूप से नहीं चुन पाएंगे, लेकिन अब उन्हें GPT-4o Mini की जगह नए डिफ़ॉल्ट फॉलबैक के रूप में GPT-4.1 Mini का लाभ मिलता है।
GPT-4.1 तीन आकारों में आता है: GPT-4.1, GPT-4.1 Mini, और GPT-4.1 Nano। तीनों ही 1 मिलियन टोकन तक का संदर्भ संभालते हैं और कोडिंग, निर्देश पालन, तथा लंबी संदर्भ सामग्री समझने में उल्लेखनीय सुधार लाते हैं। ये पिछले रिलीज़ की तुलना में सस्ते और तेज़ भी हैं।
इस लेख में, मैं बताऊँगा कि प्रत्येक मॉडल क्या कर सकता है, यह GPT-4o और GPT-4.5 से कैसे तुलना करता है, और बेंचमार्क तथा वास्तविक उपयोग में यह कहाँ ठहरता है।
हम अपने पाठकों को AI की ताज़ा जानकारियों से अपडेट रखते हैं The Median के ज़रिए—हमारा मुफ्त शुक्रवार न्यूज़लेटर जो हफ्ते की प्रमुख कहानियाँ सरल भाषा में समझाता है। कुछ ही मिनटों में तेज बने रहने के लिए सदस्यता लें:
GPT-4.1 क्या है?
GPT-4.1 मॉडल सूट में तीन मॉडल शामिल हैं: GPT-4.1, GPT-4.1 Mini, और GPT-4.1 Nano। ये उन डेवलपर्स के लिए बनाए गए हैं जिन्हें बेहतर प्रदर्शन, लंबा संदर्भ, और अधिक पूर्वानुमेय निर्देश पालन चाहिए। हर मॉडल 1 मिलियन टोकन तक का संदर्भ सपोर्ट करता है—जो GPT-4o जैसे पिछले संस्करणों की 128K सीमा से बड़ा उछाल है।
स्रोत: OpenAI
साझा आर्किटेक्चर के बावजूद, हर संस्करण अलग-अलग उपयोग मामलों के लिए ट्यून किया गया है। आइए प्रत्येक को विस्तार से देखते हैं।
GPT-4.1
यह फ्लैगशिप मॉडल है। यदि आप कोडिंग, निर्देश पालन, और लंबी-संदर्भ वाली जिम्मेदारियों में सर्वोत्तम समग्र प्रदर्शन चाहते हैं, तो यही चुनें। यह जटिल कोडिंग वर्कफ़्लो को संभालने या एक ही प्रॉम्प्ट में बड़े दस्तावेज़ प्रोसेस करने के लिए बना है।
बेंचमार्क्स में, यह वास्तविक दुनिया की सॉफ्टवेयर इंजीनियरिंग (SWE-bench), निर्देश पालन (MultiChallenge), और लंबी-संदर्भ तर्क (MRCR, Graphwalks) में GPT-4o से बेहतर है। यह संरचना और फ़ॉर्मैटिंग का सम्मान करने में भी स्पष्ट रूप से बेहतर है—जैसे XML प्रतिक्रियाएँ, क्रमबद्ध निर्देश, और ऐसी नकारात्मक शर्तें जैसे “जब तक ... न हो, जवाब न दें।”
आप लॉन्च के दिन से ही GPT-4.1 को फाइन-ट्यून भी कर सकते हैं, जो टोन, फ़ॉर्मैट, या डोमेन नॉलेज पर नियंत्रण महत्वपूर्ण होने वाले प्रोडक्शन उपयोग मामलों के लिए इसे और उपयोगी बनाता है।
GPT-4.1 Mini
GPT-4.1 Mini मिड-टियर विकल्प है, जो लगभग पूर्ण मॉडल जैसी क्षमताएँ कम विलंबता और लागत के साथ देता है। यह कई बेंचमार्क्स पर, जिनमें निर्देश पालन और इमेज-आधारित तर्क शामिल हैं, GPT-4o की बराबरी करता है या उसे पछाड़ता है।
यह कई उपयोग मामलों के लिए डिफ़ॉल्ट पसंद बन सकता है: इंटरैक्टिव टूल्स के लिए पर्याप्त तेज़, विस्तृत निर्देशों का पालन करने के लिए पर्याप्त स्मार्ट, और पूर्ण मॉडल से काफी सस्ता।
पूर्ण संस्करण की तरह, यह भी 1 मिलियन टोकन का संदर्भ सपोर्ट करता है और फाइन-ट्यूनिंग के लिए पहले से उपलब्ध है।
GPT-4.1 Nano
Nano सबसे छोटा, सबसे तेज़, और सबसे सस्ता है। यह ऑटोकम्प्लीट, वर्गीकरण, और बड़े दस्तावेज़ों से जानकारी निकालने जैसे कार्यों के लिए बनाया गया है। हल्का होने के बावजूद, यह 1 मिलियन-टोकन का पूरा संदर्भ विंडो सपोर्ट करता है।
यह OpenAI का अब तक का सबसे छोटा, सबसे तेज़, और सबसे सस्ता मॉडल भी है—लगभग 10 सेंट प्रति 1 मिलियन टोकन। आपको बड़े मॉडलों जैसी पूरी तर्क और योजना क्षमता नहीं मिलेगी, लेकिन कुछ कार्यों के लिए यही बात मायने नहीं रखती।
GPT-4.1 बनाम GPT-4o और GPT-4.5
बेंचमार्क्स में जाने से पहले (जिसे हम अगले सेक्शन में विस्तार से कवर करेंगे), यह समझना उपयोगी है कि व्यवहार में GPT-4.1, GPT-4o और GPT-4.5 से कैसे अलग है।
GPT-4o से अधिक स्मार्ट, GPT-4.5 से अधिक व्यावहारिक
GPT-4.1, GPT-4o की क्षमताओं में सुधार करता है जबकि विलंबता को लगभग उसी दायरे में रखता है। व्यवहार में, इसका मतलब है कि डेवलपर्स अब प्रतिक्रियाशीलता की कीमत चुकाए बिना बेहतर प्रदर्शन पाते हैं।
स्रोत: OpenAI
ऊपर दिए ग्राफ़ को तोड़कर समझें:
दूसरी ओर, GPT-4.5 हमेशा एक रिसर्च प्रीव्यू के रूप में पोजिशन किया गया था। इसमें तर्क और लेखन गुणवत्ता मजबूत थी, लेकिन ओवरहेड भी अधिक था। GPT-4.1 प्रमुख बेंचमार्क्स पर समान या बेहतर नतीजे देता है, जबकि यह सस्ता और अधिक प्रतिक्रियाशील है—इतना कि OpenAI मध्य जुलाई तक 4.5 को पूरी तरह रिटायर करने की योजना बना रहा है ताकि अधिक GPUs खाली किए जा सकें।
1 मिलियन टोकन का संदर्भ
तीनों GPT-4.1 मॉडल—स्टैंडर्ड, Mini, और Nano—1 मिलियन टोकन तक का संदर्भ सपोर्ट करते हैं। यह GPT-4o की पेशकश से 8 गुना से भी अधिक है।
यह लंबा संदर्भ क्षमता व्यावहारिक उपयोग मामलों को सक्षम करती है, जैसे पूरे लॉग्स प्रोसेस करना, कोड रिपॉजिटरी इंडेक्स करना, बहु-दस्तावेज़ी कानूनी वर्कफ़्लो संभालना, या लंबे ट्रांसक्रिप्ट्स का विश्लेषण—वह भी बिना पहले से चंकिंग या सार-संक्षेप किए।
बेहतर निर्देश पालन
GPT-4.1 इस बात में भी बदलाव लाता है कि मॉडल कितनी विश्वसनीयता से निर्देशों का पालन करते हैं। यह क्रमबद्ध चरणों, फ़ॉर्मैटिंग बाधाओं, और नकारात्मक शर्तों (जैसे यदि फ़ॉर्मैटिंग गलत है तो उत्तर देने से इनकार) वाले जटिल प्रॉम्प्ट्स को संभालता है।
व्यवहार में, इसका मतलब दो बातें हैं: प्रॉम्प्ट तैयार करने में कम समय, और बाद में आउटपुट साफ़ करने में भी कम समय।
GPT-4.1 बेंचमार्क्स
GPT-4.1 चार कोर क्षेत्रों में प्रगति दिखाता है: कोडिंग, निर्देश पालन, लंबी-संदर्भ समझ, और मल्टीमॉडल कार्य।
कोडिंग प्रदर्शन
SWE-bench Verified पर—एक बेंचमार्क जो मॉडल को वास्तविक कोडबेस में डालता है और उससे एंड-टू-एंड इश्यू पूरे करने को कहता है—GPT-4.1 ने 54.6% स्कोर किया। यह GPT-4o के 33.2% और GPT-4.5 के 38% से ऊपर है। यह भी काफ़ी प्रभावशाली है कि GPT-4.1 ने o1 और o3-mini से भी अधिक स्कोर किया।
स्रोत: OpenAI
यह Aider के पॉलीग्लॉट डिफ़ बेंचमार्क पर GPT-4o के प्रदर्शन को दोगुने से अधिक कर देता है, और कई भाषाओं व फ़ॉर्मैट्स में कोड डिफ़्स पर 52.9% सटीकता तक पहुँचता है। इसी कार्य पर GPT-4.5 ने 44.9% स्कोर किया। GPT-4.1 अधिक सटीक भी है: इंटरनल इवैल्स में, अनावश्यक कोड एडिट्स 9% (GPT-4o) से घटकर मात्र 2% रह गए।
स्रोत: OpenAI
बेंचमार्क स्कोर से इतर, OpenAI द्वारा दिखाया गया फ्रंटएंड कोडिंग डेमो GPT-4.1 के श्रेष्ठ प्रदर्शन का अच्छा दृश्य उदाहरण है। OpenAI की टीम ने दोनों मॉडलों से एक ही फ़्लैशकार्ड ऐप बनवाया, और मानव रेटर्स ने 80% मामलों में GPT-4.1 के आउटपुट को प्राथमिकता दी।
स्रोत: OpenAI
अल्फा टेस्टर्स में से एक, Windsurf, ने अपने इंटरनल कोडिंग बेंचमार्क पर 60% सुधार की रिपोर्ट की। एक अन्य कंपनी, Qodo, ने GPT-4.1 का परीक्षण वास्तविक GitHub पुल रिक्वेस्ट्स पर किया और पाया कि इसने 55% मामलों में बेहतर सुझाव दिए, और अप्रासंगिक या अत्यधिक शब्दाडंबर वाले एडिट्स कम किए।
निर्देश पालन
निर्देशों का पालन करने में—खासकर बहु-चरणीय कार्यों, फ़ॉर्मैटिंग नियमों, या शर्तों वाले कामों में—GPT-4.1 अधिक शाब्दिक और अधिक विश्वसनीय है। OpenAI के इंटरनल निर्देश पालन इवैल (हार्ड सबसेट) में GPT-4.1 ने 49.1% स्कोर किया, जबकि GPT-4o केवल 29.2% पर रहा। यहाँ GPT-4.5 थोड़ा आगे है 54% पर, लेकिन 4.1 और 4o के बीच का अंतर महत्वपूर्ण है।
स्रोत: OpenAI
MultiChallenge पर, जो जाँचता है कि कोई मॉडल बहु-टर्न निर्देशों का पालन कर सकता है और बातचीत में पहले पेश की गई बाधाओं को याद रख सकता है या नहीं, GPT-4.1 ने 38.3% स्कोर किया—जो GPT-4o के 27.8% से ऊपर है। और IFEval पर, जो स्पष्ट रूप से निर्दिष्ट आउटपुट आवश्यकताओं के अनुपालन की जाँच करता है, GPT-4.1 87.4% तक पहुँचा—GPT-4o के 81% पर ठोस सुधार।
व्यवहार में, इसका मतलब है कि GPT-4.1 क्रमबद्ध चरणों का पालन करने, बिगड़े हुए इनपुट को अस्वीकार करने, और आपके द्वारा माँगे गए फ़ॉर्मैट में प्रतिक्रिया देने में बेहतर है—खासकर XML, YAML, या मार्कडाउन जैसे संरचित आउटपुट्स में। इससे बिना ढेर सारे प्रॉम्प्ट रिट्राई के विश्वसनीय एजेंट वर्कफ़्लोज़ बनाना भी आसान हो जाता है।
लंबी-संदर्भ तर्क
तीनों GPT-4.1 मॉडल—स्टैंडर्ड, Mini, और Nano—1 मिलियन टोकन तक का संदर्भ सपोर्ट करते हैं। यह GPT-4o के 128K की सीमा पर 8 गुना वृद्धि है। उतना ही अहम: इस संदर्भ विंडो के उपयोग पर कोई अतिरिक्त लागत नहीं है। इसकी कीमत किसी भी अन्य प्रॉम्प्ट की तरह ही है।
लेकिन क्या मॉडल वास्तव में उस पूरे संदर्भ का उपयोग कर सकते हैं? OpenAI के नीडल-इन-ए-हेयस्टैक इवैल में, GPT-4.1 ने 1M-टोकन के पूरे इनपुट में—शुरुआत, बीच, या अंत—कहीं भी डाले गए कंटेंट को भरोसेमंद रूप से ढूँढ लिया।
स्रोत: OpenAI
Graphwalks—जो लंबी संदर्भों में मल्टी-हॉप तर्क का परीक्षण करता है—GPT-4.1 को 61.7% पर रखता है—GPT-4o के 41.7% से ठोस छलांग, हालांकि GPT-4.5 के 72.3% से अभी नीचे।
ये सुधार वास्तविक दुनिया के परीक्षणों में भी दिखते हैं। Thomson Reuters ने 17% बढ़त देखी बहु-दस्तावेज़ी कानूनी विश्लेषण में GPT-4.1 के साथ, जबकि Carlyle ने घने वित्तीय रिपोर्ट्स से सूक्ष्म डेटा निकालने में 50% सुधार दर्ज किया।
मल्टीमॉडल और विज़न कार्य
मल्टीमॉडल कार्यों में भी GPT-4.1 प्रगति करता है। इसने Video-MME बेंचमार्क पर 72.0% स्कोर किया, जिसमें 30–60 मिनट के बिना सबटाइटल वाले वीडियो पर प्रश्नों के उत्तर देने होते हैं—GPT-4o के 65.3% से ऊपर।
MMMU जैसे इमेज-प्रधान बेंचमार्क्स पर, यह 74.8% तक पहुँचा बनाम GPT-4o के 68.7%। MathVista पर—जिसमें चार्ट, ग्राफ़, और गणितीय विज़ुअल्स शामिल हैं—GPT-4.1 ने 72.2% हासिल किया।
एक चौंकाने वाली बात: GPT-4.1 Mini इन बेंचमार्क्स में से कुछ पर लगभग पूर्ण संस्करण जितना ही अच्छा प्रदर्शन करता है। उदाहरण के लिए, MathVista पर इसने 73.1% के साथ GPT-4.1 को थोड़ा पीछे छोड़ा। यह उन उपयोग मामलों के लिए आकर्षक विकल्प बनाता है जो गति को विज़न-प्रधान प्रॉम्प्ट्स के साथ जोड़ते हैं।
स्रोत: OpenAI
GPT-4.1 का एक्सेस कैसे पाएँ
अब आप GPT-4.1 और GPT-4.1 Mini तक सीधे ChatGPT ऐप में पहुँच सकते हैं, सिर्फ API के ज़रिए ही नहीं। Plus, Pro, और Team सब्सक्राइबर्स मॉडल मेन्यू से GPT-4.1 को मैन्युअल रूप से चुन सकते हैं, जबकि फ्री उपयोगकर्ता स्वतः GPT-4.1 Mini पर फॉलबैक करते हैं—पर्दे के पीछे GPT-4o Mini की जगह यह नया डिफ़ॉल्ट बन गया है। Enterprise और Education प्लान्स को आने वाले हफ्तों में एक्सेस मिलने की उम्मीद है।
डेवलपर्स के लिए, OpenAI API और Playground तीनों वेरिएंट्स—GPT-4.1, GPT-4.1 Mini, और GPT-4.1 Nano—को सपोर्ट करते हैं। इंटीग्रेशन से पहले प्रॉम्प्ट्स टेस्ट करने, लंबी-संदर्भ व्यवहार एक्सप्लोर करने, और मॉडलों की तुलना करने का यह अब भी सबसे अच्छा तरीका है।
यदि आप लंबे दस्तावेज़ों—जैसे लॉग्स, PDFs, कानूनी रिकॉर्ड्स, या अकादमिक आलेख—पर काम कर रहे हैं, तो आप एक ही कॉल में 1 मिलियन टोकन तक भेज सकते हैं, किसी विशेष पैरामीटर की आवश्यकता नहीं। लंबी संदर्भ के लिए कोई अतिरिक्त कीमत भी नहीं: टोकन लागतें इनपुट आकार की परवाह किए बिना फ्लैट हैं।
GPT-4.1 को फाइन-ट्यून करना
आप GPT-4.1 के तीनों वेरिएंट्स को फाइन-ट्यून कर सकते हैं। इससे कस्टम निर्देश, डोमेन-विशिष्ट शब्दावली, या टोन-विशिष्ट आउटपुट्स के लिए रास्ता खुलता है। ध्यान दें कि फाइन-ट्यूनिंग की pricing थोड़ी अधिक है:
मॉडल
इनपुट
कैश्ड इनपुट
आउटपुट
ट्रेनिंग
GPT-4.1
$3.00 / 1M tokens
$0.75 / 1M tokens
$12.00 / 1M tokens
$25.00 / 1M tokens
GPT-4.1 Mini
$0.80 / 1M tokens
$0.20 / 1M tokens
$3.20 / 1M tokens
$5.00 / 1M tokens
GPT-4.1 Nano
$0.20 / 1M tokens
$0.05 / 1M tokens
$0.80 / 1M tokens
$1.50 / 1M tokens
अगर आपने पहले GPT-3.5 या GPT-4 मॉडलों को फाइन-ट्यून किया है, तो प्रक्रिया लगभग वही है—बस नया बेस चुनें। यदि आप और सीखना चाहते हैं, तो मैं यह ट्यूटोरियल सुझाऊँगा: GPT-4o mini को फाइन-ट्यून करना।
GPT-4.1 की कीमत
GPT-4.1 के साथ एक स्वागतयोग्य अपडेट यह भी है कि यह केवल ज़्यादा स्मार्ट नहीं—बल्कि सस्ता भी है। OpenAI का कहना है कि लक्ष्य इन मॉडलों को अधिक वास्तविक वर्कफ़्लो में अधिक उपयोगी बनाना था, और यह प्राइसिंग संरचना में झलकता है।
इन्फरence के लिए तीनों मॉडलों की कीमत इस प्रकार है:
मॉडल
इनपुट
कैश्ड इनपुट
आउटपुट
ब्लेंडेड औसत लागत*
GPT-4.1
$2.00 / 1M tokens
$0.50 / 1M tokens
$8.00 / 1M tokens
$1.84
GPT-4.1 Mini
$0.40 / 1M tokens
$0.10 / 1M tokens
$1.60 / 1M tokens
$0.42
GPT-4.1 Nano
$0.10 / 1M tokens
$0.025 / 1M tokens
$0.40 / 1M tokens
$0.12
*यह “ब्लेंडेड” संख्या OpenAI के सामान्य इनपुट/आउटपुट अनुपात के अनुमान पर आधारित है।
निष्कर्ष
GPT-4.1 अधिक विश्वसनीय कोड जेनरेशन, बेहतर निर्देश पालन, सच्चा लंबा-संदर्भ प्रोसेसिंग, और तेज़ इटरेशन के साथ आता है।
नामकरण भले उलझन भरा हो, पर मॉडल खुद पिछले संस्करणों से स्पष्ट रूप से अधिक सक्षम हैं। ये अधिक किफायती—और अधिक उपयोगी—भी हैं, खासकर उन प्रोडक्शन वातावरणों में जहाँ विलंबता, लागत, और पूर्वानुमेयता मायने रखती है।
यदि आप आज GPT-4o के साथ काम कर रहे हैं, तो GPT-4.1 को ज़रूर परखें।