OpenAI 近日发布了 GPT-4.1,这是一组专为编码任务打造的新模型。我和大家一样对从 GPT-4.5 跳回到 GPT-4.1 的命名感到困惑,但所幸基准测试并没有倒退——恰恰相反。
此次发布从 4 月 14 日开始,仅通过 API 提供访问。随后在 5 月 14 日,OpenAI 开始将 GPT-4.1 引入 ChatGPT 应用。免费层用户无法手动选择 GPT-4.1,但现在已能受益于将 GPT-4.1 Mini 作为新的默认回退模型,取代了 GPT-4o Mini。
GPT-4.1 提供三种尺寸:GPT-4.1、GPT-4.1 Mini 和 GPT-4.1 Nano。三者均支持最高 100 万 tokens 的上下文,并在编码、指令遵循和长上下文理解方面带来显著提升。同时,它们比以往版本更便宜、更快速。
本文将为您介绍各模型能做什么、与 GPT-4o 和 GPT-4.5 的对比,以及在基准测试和实际应用中的表现。
我们通过每周五发布的免费通讯 The Median,为读者带来最新 AI 动态,拆解本周要闻。订阅即可每周几分钟高效掌握:
什么是 GPT-4.1?
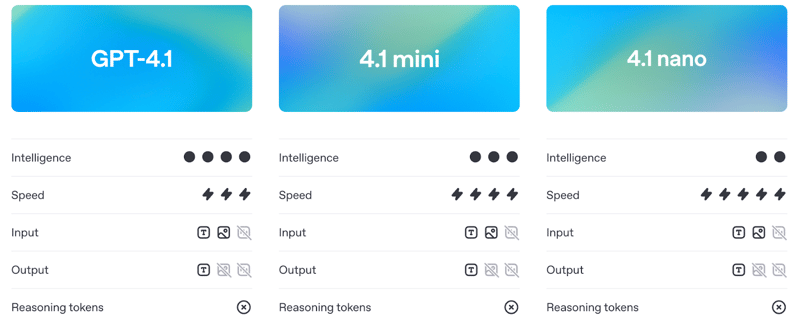
GPT-4.1 模型套件包含三个模型:GPT-4.1、GPT-4.1 Mini 和 GPT-4.1 Nano。它们面向需要更强性能、更长上下文以及更可预测指令遵循的开发者。每个模型均支持最高 100 万 tokens 的上下文,相比此前如 GPT-4o 的 128K 限制是一次巨大飞跃。
来源: OpenAI
虽然共享同一架构,但每个版本都针对不同场景进行了优化。我们来分别看看。
GPT-4.1
这是旗舰模型。如果您希望在编码、指令遵循和长上下文任务上获得最佳综合表现,它是不二之选。它可处理复杂的编码工作流,或在单次提示中处理大型文档。
在基准测试中,它在真实世界软件工程(SWE-bench)、指令遵循(MultiChallenge)以及长上下文推理(MRCR、Graphwalks)方面优于 GPT-4o。它在遵循结构与格式方面也有明显提升——例如 XML 响应、有序指令,以及诸如“除非……否则不要回答”这类否定约束。
您还可以在发布当天就微调 GPT-4.1,这让它在需要控制语气、格式或领域知识的生产用例中更具可用性。
GPT-4.1 Mini
GPT-4.1 Mini 属于中端选项,能力几乎与完整版相当,但延迟和成本更低。在许多基准上它与 GPT-4o 持平或更强,包括指令遵循和基于图像的推理。
它很可能成为众多场景的默认之选:足够快以支撑交互式工具,足够聪明以遵循详细指令,而且远比完整版更经济。
与完整版一样,它支持 100 万 tokens 的上下文,并已可进行微调。
GPT-4.1 Nano
Nano 是三者中最小、最快、最便宜的模型。它用于自动补全、分类,以及从大型文档中抽取信息等任务。尽管轻量,它仍支持完整的 100 万 token 上下文窗口。
它也是 OpenAI 有史以来最小、最快、最便宜的模型,每百万 tokens 约 10 美分。您无法获得与更大模型相同的推理与规划能力,但对某些任务而言,这并非关键。
GPT-4.1 与 GPT-4o、GPT-4.5 的对比
在进入基准测试(下一节将详细介绍)之前,先看看 GPT-4.1 在实际应用中与 GPT-4o 和 GPT-4.5 的差异。
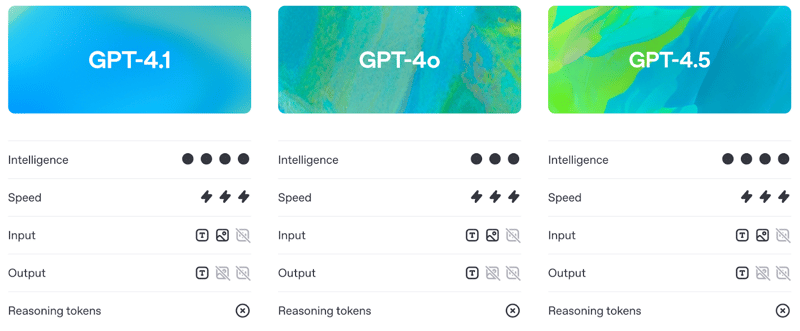
比 GPT-4o 更聪明,比 GPT-4.5 更实用
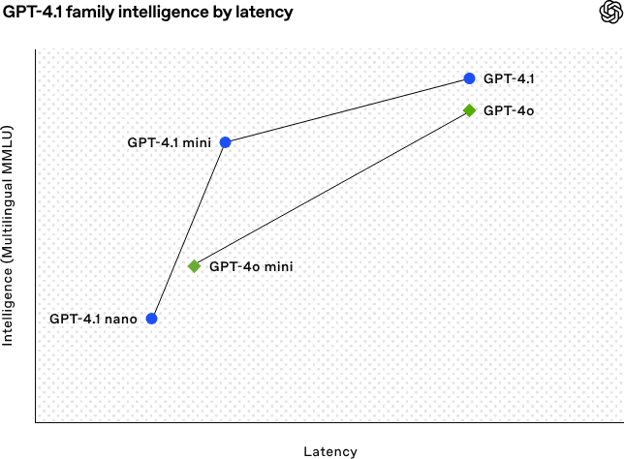
GPT-4.1 在保持大致相同延迟的同时提升了 GPT-4o 的能力。实际效果是,开发者现在能在不牺牲响应速度的情况下获得更好的性能。
来源: OpenAI
我们来拆解一下上图:
- GPT-4.1 和 GPT-4o 在延迟方面大致相当,但 GPT-4.1 在智能度上更胜一筹。因此,您在相近速度下获得了更聪明(且更便宜)的模型。
- GPT-4.1 Mini 也比 GPT-4o Mini 更强,但这种提升带来了一点取舍:延迟略有增加。
- GPT-4.1 Nano 在速度上明显胜出,位于图表最左侧。它在 MMLU 上不如其他型号,但这是意料之中——它面向速度优先的轻量级任务,而非纯粹推理能力。
另一方面,GPT-4.5 一直被定位为研究预览。它在推理和写作质量上表现强劲,但开销更大。GPT-4.1 在关键基准上达到相当或更好的结果,同时价格更低、响应更快——足以让 OpenAI 计划在 7 月中旬完全退役 4.5,以释放更多 GPU。
100 万 token 的上下文
三款 GPT-4.1 模型——标准版、Mini 和 Nano——均支持最高 100 万 token 的上下文。这是 GPT-4o 的 8 倍以上。
这种长上下文能力让许多实际用例变得可行,例如处理完整日志、索引代码仓库、处理多文档法律流程,或分析长篇转录——无需事先分块或摘要。
更好的指令遵循
GPT-4.1 在模型可靠遵循指令方面实现了转变。它能够处理包含有序步骤、格式约束和否定条件(如若格式错误则拒答)的复杂提示。
实际意义在于两点:更少时间用来设计提示,更少时间在事后清理输出。
GPT-4.1 基准测试
GPT-4.1 在四个核心方向上都有进展:编码、指令遵循、长上下文理解和多模态任务。
编码表现
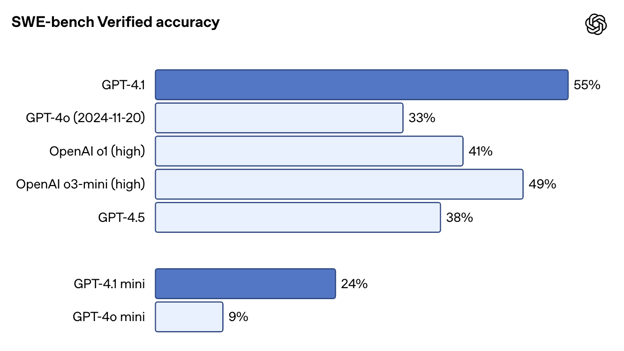
在 SWE-bench Verified——将模型置入真实代码库并要求端到端完成 issue 的基准——上,GPT-4.1 得分为 54.6%。这比 GPT-4o 的 33.2% 和 GPT-4.5 的 38% 有明显提升。同样令人印象深刻的是,GPT-4.1 的得分高于 o1 和 o3-mini。
来源: OpenAI
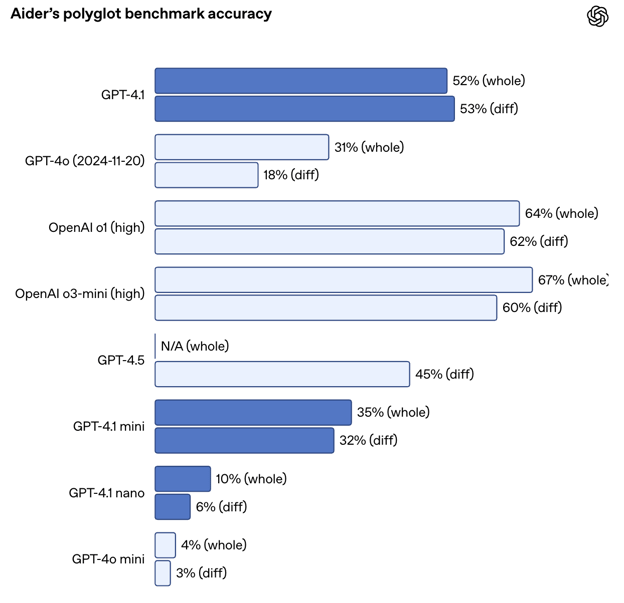
在 Aider 的 polyglot diff 基准上,它也将 GPT-4o 的表现提升了一倍多,在多种语言和格式的代码 diff 上达到 52.9% 的准确率。GPT-4.5 在同一任务上的得分为 44.9%。GPT-4.1 也更精确:在内部评测中,多余的代码修改从 GPT-4o 的 9% 降至仅 2%。
来源: OpenAI
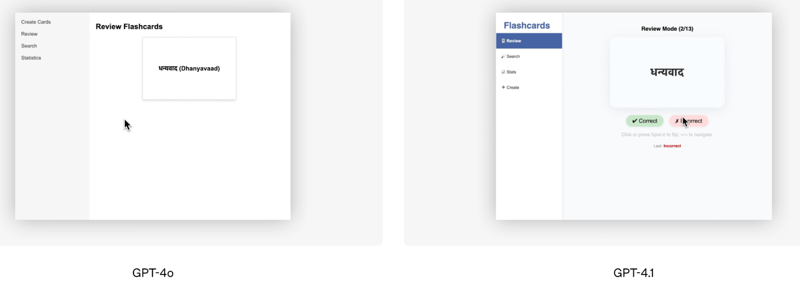
在基准之外,OpenAI 提供的前端编码演示直观展示了 GPT-4.1 的优势。OpenAI 团队让两个模型构建同一款抽认卡应用,人工评估者有 80% 的时间更偏好 GPT-4.1 的输出。
来源: OpenAI
作为内测方之一的 Windsurf 报告称,其内部编码基准提升了 60%。另一家公司 Qodo 测试了 GPT-4.1 在真实 GitHub PR 上的表现,发现其在 55% 的情况下提出了更好的建议,且无关或冗长修改更少。
指令遵循
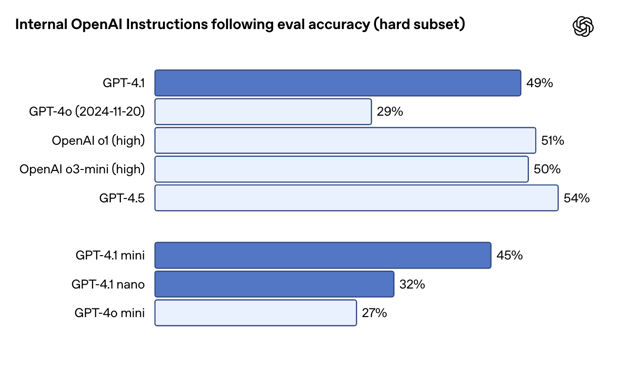
在遵循指令方面,GPT-4.1 更加字面、更加可靠,尤其适用于包含多步骤、格式规则或条件约束的任务。在 OpenAI 的内部指令遵循评测(困难子集)中,GPT-4.1 得分 49.1%,而 GPT-4o 仅为 29.2%。GPT-4.5 在此略占优势,为 54%,但 4.1 与 4o 的差距相当明显。
来源: OpenAI
在 MultiChallenge 上(测试模型是否能遵循多轮指令并记住对话早先引入的约束),GPT-4.1 得分 38.3%,高于 GPT-4o 的 27.8%。在 IFEval(测试对明确输出要求的遵循)上,GPT-4.1 达到 87.4%,较 GPT-4o 的 81% 有稳健提升。
在实际中,这意味着 GPT-4.1 更善于遵循有序步骤、拒绝格式不正确的输入,并按您要求的格式作答——尤其是在 XML、YAML 或 Markdown 等结构化输出中。这也让您更容易构建可靠的代理工作流,而无需大量提示重试。
长上下文推理
三款 GPT-4.1 模型——标准版、Mini 与 Nano——都支持最高 100 万 token 的上下文。相较最高 128K 的 GPT-4o,提升了 8 倍。更重要的是:使用该上下文窗口无需额外费用,定价与其他提示一致。
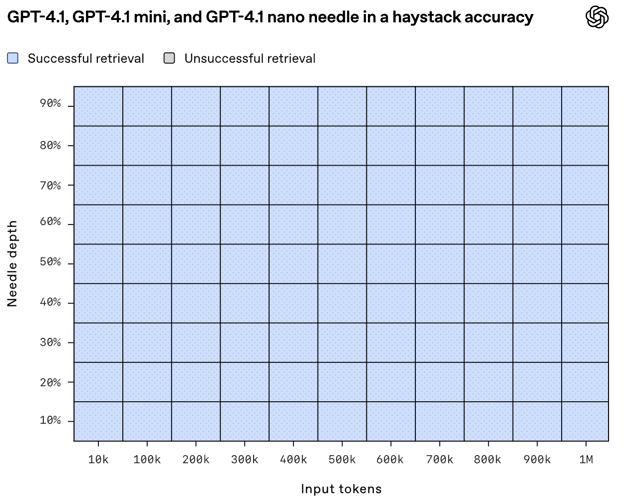
但模型真的能用好这些上下文吗?在 OpenAI 的大海捞针评测中,GPT-4.1 能稳定找到插入在 100 万 token 输入任意位置——开头、中间或结尾——的内容。
来源: OpenAI
Graphwalks(测试长上下文中的多跳推理)将 GPT-4.1 评为 61.7%——较 GPT-4o 的 41.7% 有明显跃升,但仍低于 GPT-4.5 的 72.3%。
这些改进也体现在真实测试中。 汤森路透的测试显示,使用 GPT-4.1 进行多文档法律分析,效果提升 17%;凯雷集团报告称,在从密集的财报中抽取细粒度数据方面,提升了 50%。
多模态与视觉任务
在多模态任务上,GPT-4.1 也有所进步。在 Video-MME 基准(针对 30–60 分钟、无字幕视频的问答)上,得分 72.0%,高于 GPT-4o 的 65.3%。
在以图像为主的基准如 MMMU 上,达到 74.8%,而 GPT-4o 为 68.7%。在包含图表、曲线图和数学可视化的 MathVista 上,GPT-4.1 达到 72.2%。
一个意外之处是:GPT-4.1 Mini 在部分基准上几乎与完整版持平。例如在 MathVista 上,它以 73.1% 略高于 GPT-4.1。这使其在需要速度与重视觉提示相结合的场景中颇具吸引力。
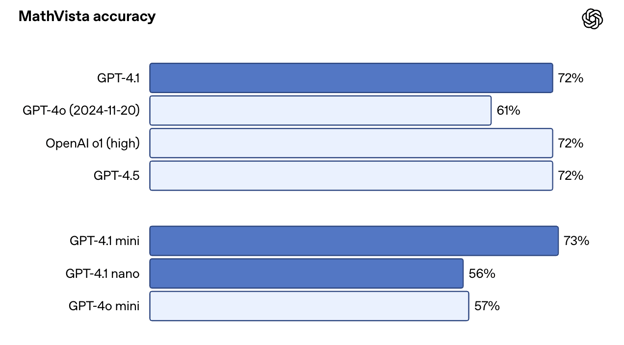
来源: OpenAI
如何使用 GPT-4.1
您现在可以在 ChatGPT 应用中直接使用 GPT-4.1 和 GPT-4.1 Mini,不再仅限 API。Plus、Pro 和 Team 订阅者可在模型菜单中手动选择 GPT-4.1;免费用户将自动回退到 GPT-4.1 Mini——在幕后取代了默认的 GPT-4o Mini。Enterprise 与 Education 方案预计将在未来数周内获得访问权限。
对于开发者,OpenAI API 和 Playground 继续支持三个变体——GPT-4.1、GPT-4.1 Mini 和 GPT-4.1 Nano。这仍是测试提示、探索长上下文行为、以及在集成到生产前比较模型的最佳方式。
如果您在处理长文档——如日志、PDF、法律记录或学术论文——可在一次调用中发送最多 100 万 tokens,无需特殊参数。长上下文也不加价:无论输入大小,token 成本均为统一费率。
微调 GPT-4.1
您可以微调三种 GPT-4.1 变体。这为自定义指令、领域专属词汇或特定语气的输出打开了大门。请注意,微调的 pricing 稍高:
|
Model
|
Input
|
Cached Input
|
Output
|
Training
|
|
GPT-4.1
|
$3.00 / 1M tokens
|
$0.75 / 1M tokens
|
$12.00 / 1M tokens
|
$25.00 / 1M tokens
|
|
GPT-4.1 Mini
|
$0.80 / 1M tokens
|
$0.20 / 1M tokens
|
$3.20 / 1M tokens
|
$5.00 / 1M tokens
|
|
GPT-4.1 Nano
|
$0.20 / 1M tokens
|
$0.05 / 1M tokens
|
$0.80 / 1M tokens
|
$1.50 / 1M tokens
|
If you’ve previously fine-tuned GPT-3.5 or GPT-4 models, the process remains mostly the same—just pick the newer base. If you want to learn more, I recommend this tutorial on fine-tuning GPT-4o mini.
GPT-4.1 定价
GPT-4.1 的另一个亮点是它不仅更聪明——也更便宜。OpenAI 表示目标是让这些模型更适用于更多真实工作流程,这一点也体现在定价结构中。
以下是三款模型用于 inference 的定价:
|
Model
|
Input
|
Cached Input
|
Output
|
Blended Avg. Cost*
|
|
GPT-4.1
|
$2.00 / 1M tokens
|
$0.50 / 1M tokens
|
$8.00 / 1M tokens
|
$1.84
|
|
GPT-4.1 Mini
|
$0.40 / 1M tokens
|
$0.10 / 1M tokens
|
$1.60 / 1M tokens
|
$0.42
|
|
GPT-4.1 Nano
|
$0.10 / 1M tokens
|
$0.025 / 1M tokens
|
$0.40 / 1M tokens
|
$0.12
|
*“综合”数值基于 OpenAI 对典型输入/输出比例的假设。
结语
GPT-4.1 带来了更可靠的代码生成、更好的指令遵循、真正的长上下文处理,以及更快的迭代。
命名也许令人困惑,但模型本身显然比过往更强。同时它也更实惠、更易用——尤其是在对延迟、成本和可预测性要求较高的生产环境中。
如果您目前在使用 GPT-4o,值得测试一下 GPT-4.1。


OpenAI 近日发布了 GPT-4.1,这是一组专为编码任务打造的新模型。我和大家一样对从 GPT-4.5 跳回到 GPT-4.1 的命名感到困惑,但所幸基准测试并没有倒退——恰恰相反。
此次发布从 4 月 14 日开始,仅通过 API 提供访问。随后在 5 月 14 日,OpenAI 开始将 GPT-4.1 引入 ChatGPT 应用。免费层用户无法手动选择 GPT-4.1,但现在已能受益于将 GPT-4.1 Mini 作为新的默认回退模型,取代了 GPT-4o Mini。
GPT-4.1 提供三种尺寸:GPT-4.1、GPT-4.1 Mini 和 GPT-4.1 Nano。三者均支持最高 100 万 tokens 的上下文,并在编码、指令遵循和长上下文理解方面带来显著提升。同时,它们比以往版本更便宜、更快速。
本文将为您介绍各模型能做什么、与 GPT-4o 和 GPT-4.5 的对比,以及在基准测试和实际应用中的表现。
我们通过每周五发布的免费通讯 The Median,为读者带来最新 AI 动态,拆解本周要闻。订阅即可每周几分钟高效掌握:
什么是 GPT-4.1?
GPT-4.1 模型套件包含三个模型:GPT-4.1、GPT-4.1 Mini 和 GPT-4.1 Nano。它们面向需要更强性能、更长上下文以及更可预测指令遵循的开发者。每个模型均支持最高 100 万 tokens 的上下文,相比此前如 GPT-4o 的 128K 限制是一次巨大飞跃。
来源: OpenAI
虽然共享同一架构,但每个版本都针对不同场景进行了优化。我们来分别看看。
GPT-4.1
这是旗舰模型。如果您希望在编码、指令遵循和长上下文任务上获得最佳综合表现,它是不二之选。它可处理复杂的编码工作流,或在单次提示中处理大型文档。
在基准测试中,它在真实世界软件工程(SWE-bench)、指令遵循(MultiChallenge)以及长上下文推理(MRCR、Graphwalks)方面优于 GPT-4o。它在遵循结构与格式方面也有明显提升——例如 XML 响应、有序指令,以及诸如“除非……否则不要回答”这类否定约束。
您还可以在发布当天就微调 GPT-4.1,这让它在需要控制语气、格式或领域知识的生产用例中更具可用性。
GPT-4.1 Mini
GPT-4.1 Mini 属于中端选项,能力几乎与完整版相当,但延迟和成本更低。在许多基准上它与 GPT-4o 持平或更强,包括指令遵循和基于图像的推理。
它很可能成为众多场景的默认之选:足够快以支撑交互式工具,足够聪明以遵循详细指令,而且远比完整版更经济。
与完整版一样,它支持 100 万 tokens 的上下文,并已可进行微调。
GPT-4.1 Nano
Nano 是三者中最小、最快、最便宜的模型。它用于自动补全、分类,以及从大型文档中抽取信息等任务。尽管轻量,它仍支持完整的 100 万 token 上下文窗口。
它也是 OpenAI 有史以来最小、最快、最便宜的模型,每百万 tokens 约 10 美分。您无法获得与更大模型相同的推理与规划能力,但对某些任务而言,这并非关键。
GPT-4.1 与 GPT-4o、GPT-4.5 的对比
在进入基准测试(下一节将详细介绍)之前,先看看 GPT-4.1 在实际应用中与 GPT-4o 和 GPT-4.5 的差异。
比 GPT-4o 更聪明,比 GPT-4.5 更实用
GPT-4.1 在保持大致相同延迟的同时提升了 GPT-4o 的能力。实际效果是,开发者现在能在不牺牲响应速度的情况下获得更好的性能。
来源: OpenAI
我们来拆解一下上图:
另一方面,GPT-4.5 一直被定位为研究预览。它在推理和写作质量上表现强劲,但开销更大。GPT-4.1 在关键基准上达到相当或更好的结果,同时价格更低、响应更快——足以让 OpenAI 计划在 7 月中旬完全退役 4.5,以释放更多 GPU。
100 万 token 的上下文
三款 GPT-4.1 模型——标准版、Mini 和 Nano——均支持最高 100 万 token 的上下文。这是 GPT-4o 的 8 倍以上。
这种长上下文能力让许多实际用例变得可行,例如处理完整日志、索引代码仓库、处理多文档法律流程,或分析长篇转录——无需事先分块或摘要。
更好的指令遵循
GPT-4.1 在模型可靠遵循指令方面实现了转变。它能够处理包含有序步骤、格式约束和否定条件(如若格式错误则拒答)的复杂提示。
实际意义在于两点:更少时间用来设计提示,更少时间在事后清理输出。
GPT-4.1 基准测试
GPT-4.1 在四个核心方向上都有进展:编码、指令遵循、长上下文理解和多模态任务。
编码表现
在 SWE-bench Verified——将模型置入真实代码库并要求端到端完成 issue 的基准——上,GPT-4.1 得分为 54.6%。这比 GPT-4o 的 33.2% 和 GPT-4.5 的 38% 有明显提升。同样令人印象深刻的是,GPT-4.1 的得分高于 o1 和 o3-mini。
来源: OpenAI
在 Aider 的 polyglot diff 基准上,它也将 GPT-4o 的表现提升了一倍多,在多种语言和格式的代码 diff 上达到 52.9% 的准确率。GPT-4.5 在同一任务上的得分为 44.9%。GPT-4.1 也更精确:在内部评测中,多余的代码修改从 GPT-4o 的 9% 降至仅 2%。
来源: OpenAI
在基准之外,OpenAI 提供的前端编码演示直观展示了 GPT-4.1 的优势。OpenAI 团队让两个模型构建同一款抽认卡应用,人工评估者有 80% 的时间更偏好 GPT-4.1 的输出。
来源: OpenAI
作为内测方之一的 Windsurf 报告称,其内部编码基准提升了 60%。另一家公司 Qodo 测试了 GPT-4.1 在真实 GitHub PR 上的表现,发现其在 55% 的情况下提出了更好的建议,且无关或冗长修改更少。
指令遵循
在遵循指令方面,GPT-4.1 更加字面、更加可靠,尤其适用于包含多步骤、格式规则或条件约束的任务。在 OpenAI 的内部指令遵循评测(困难子集)中,GPT-4.1 得分 49.1%,而 GPT-4o 仅为 29.2%。GPT-4.5 在此略占优势,为 54%,但 4.1 与 4o 的差距相当明显。
来源: OpenAI
在 MultiChallenge 上(测试模型是否能遵循多轮指令并记住对话早先引入的约束),GPT-4.1 得分 38.3%,高于 GPT-4o 的 27.8%。在 IFEval(测试对明确输出要求的遵循)上,GPT-4.1 达到 87.4%,较 GPT-4o 的 81% 有稳健提升。
在实际中,这意味着 GPT-4.1 更善于遵循有序步骤、拒绝格式不正确的输入,并按您要求的格式作答——尤其是在 XML、YAML 或 Markdown 等结构化输出中。这也让您更容易构建可靠的代理工作流,而无需大量提示重试。
长上下文推理
三款 GPT-4.1 模型——标准版、Mini 与 Nano——都支持最高 100 万 token 的上下文。相较最高 128K 的 GPT-4o,提升了 8 倍。更重要的是:使用该上下文窗口无需额外费用,定价与其他提示一致。
但模型真的能用好这些上下文吗?在 OpenAI 的大海捞针评测中,GPT-4.1 能稳定找到插入在 100 万 token 输入任意位置——开头、中间或结尾——的内容。
来源: OpenAI
Graphwalks(测试长上下文中的多跳推理)将 GPT-4.1 评为 61.7%——较 GPT-4o 的 41.7% 有明显跃升,但仍低于 GPT-4.5 的 72.3%。
这些改进也体现在真实测试中。 汤森路透的测试显示,使用 GPT-4.1 进行多文档法律分析,效果提升 17%;凯雷集团报告称,在从密集的财报中抽取细粒度数据方面,提升了 50%。
多模态与视觉任务
在多模态任务上,GPT-4.1 也有所进步。在 Video-MME 基准(针对 30–60 分钟、无字幕视频的问答)上,得分 72.0%,高于 GPT-4o 的 65.3%。
在以图像为主的基准如 MMMU 上,达到 74.8%,而 GPT-4o 为 68.7%。在包含图表、曲线图和数学可视化的 MathVista 上,GPT-4.1 达到 72.2%。
一个意外之处是:GPT-4.1 Mini 在部分基准上几乎与完整版持平。例如在 MathVista 上,它以 73.1% 略高于 GPT-4.1。这使其在需要速度与重视觉提示相结合的场景中颇具吸引力。
来源: OpenAI
如何使用 GPT-4.1
您现在可以在 ChatGPT 应用中直接使用 GPT-4.1 和 GPT-4.1 Mini,不再仅限 API。Plus、Pro 和 Team 订阅者可在模型菜单中手动选择 GPT-4.1;免费用户将自动回退到 GPT-4.1 Mini——在幕后取代了默认的 GPT-4o Mini。Enterprise 与 Education 方案预计将在未来数周内获得访问权限。
对于开发者,OpenAI API 和 Playground 继续支持三个变体——GPT-4.1、GPT-4.1 Mini 和 GPT-4.1 Nano。这仍是测试提示、探索长上下文行为、以及在集成到生产前比较模型的最佳方式。
如果您在处理长文档——如日志、PDF、法律记录或学术论文——可在一次调用中发送最多 100 万 tokens,无需特殊参数。长上下文也不加价:无论输入大小,token 成本均为统一费率。
微调 GPT-4.1
您可以微调三种 GPT-4.1 变体。这为自定义指令、领域专属词汇或特定语气的输出打开了大门。请注意,微调的 pricing 稍高:
Model
Input
Cached Input
Output
Training
GPT-4.1
$3.00 / 1M tokens
$0.75 / 1M tokens
$12.00 / 1M tokens
$25.00 / 1M tokens
GPT-4.1 Mini
$0.80 / 1M tokens
$0.20 / 1M tokens
$3.20 / 1M tokens
$5.00 / 1M tokens
GPT-4.1 Nano
$0.20 / 1M tokens
$0.05 / 1M tokens
$0.80 / 1M tokens
$1.50 / 1M tokens
If you’ve previously fine-tuned GPT-3.5 or GPT-4 models, the process remains mostly the same—just pick the newer base. If you want to learn more, I recommend this tutorial on fine-tuning GPT-4o mini.
GPT-4.1 定价
GPT-4.1 的另一个亮点是它不仅更聪明——也更便宜。OpenAI 表示目标是让这些模型更适用于更多真实工作流程,这一点也体现在定价结构中。
以下是三款模型用于 inference 的定价:
Model
Input
Cached Input
Output
Blended Avg. Cost*
GPT-4.1
$2.00 / 1M tokens
$0.50 / 1M tokens
$8.00 / 1M tokens
$1.84
GPT-4.1 Mini
$0.40 / 1M tokens
$0.10 / 1M tokens
$1.60 / 1M tokens
$0.42
GPT-4.1 Nano
$0.10 / 1M tokens
$0.025 / 1M tokens
$0.40 / 1M tokens
$0.12
*“综合”数值基于 OpenAI 对典型输入/输出比例的假设。
结语
GPT-4.1 带来了更可靠的代码生成、更好的指令遵循、真正的长上下文处理,以及更快的迭代。
命名也许令人困惑,但模型本身显然比过往更强。同时它也更实惠、更易用——尤其是在对延迟、成本和可预测性要求较高的生产环境中。
如果您目前在使用 GPT-4o,值得测试一下 GPT-4.1。