

Corso
Lavorare con l'API di OpenAI
3 ore
184.5K
Pratica and corso your progress.
Continua Con GoogleOpenAI ha rilasciato di recente GPT-4.1, una nuova famiglia di modelli progettata specificamente per i compiti di coding. Sono confuso quanto te per il salto di naming da GPT-4.5 a GPT-4.1, ma per fortuna i benchmark non fanno lo stesso passo indietro—anzi.
Il rollout è iniziato il 14 aprile con accesso solo via API. Poi, il 14 maggio, OpenAI ha iniziato a portare GPT-4.1 nell’app di ChatGPT. Gli utenti del piano gratuito non potranno selezionare GPT-4.1 manualmente, ma ora beneficiano di GPT-4.1 Mini come nuovo fallback predefinito, che sostituisce GPT-4o Mini.
GPT-4.1 è disponibile in tre dimensioni: GPT-4.1, GPT-4.1 Mini e GPT-4.1 Nano. Tutti e tre supportano fino a 1 milione di token di contesto e introducono miglioramenti significativi in coding, aderenza alle istruzioni e comprensione di contesti lunghi. Sono anche più economici e veloci rispetto alle versioni precedenti.
In questo articolo, ti guiderò attraverso ciò che può fare ciascun modello, come si confronta con GPT-4o e GPT-4.5, e come si posiziona nei benchmark e nell’uso reale.
Teniamo i nostri lettori aggiornati sulle ultime novità dell’AI inviando The Median, la nostra newsletter gratuita del venerdì che spiega le storie chiave della settimana. Iscriviti e resta sul pezzo in pochi minuti a settimana:
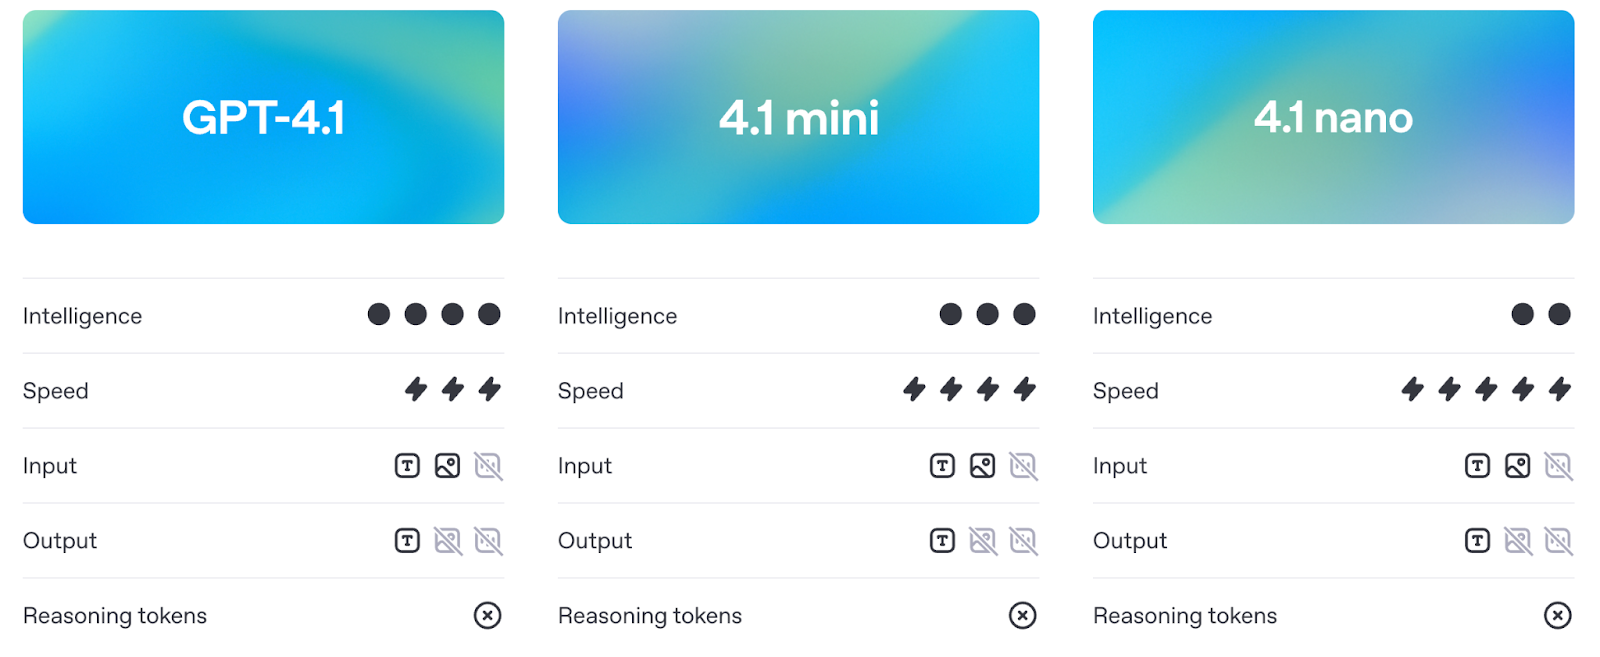
La suite di modelli GPT-4.1 comprende tre modelli: GPT-4.1, GPT-4.1 Mini e GPT-4.1 Nano. Sono pensati per gli sviluppatori che necessitano di prestazioni migliori, contesti più lunghi e una maggiore prevedibilità nel seguire le istruzioni. Ogni modello supporta fino a 1 milione di token di contesto, un grande salto rispetto al limite di 128K delle versioni precedenti come GPT-4o.
Fonte: OpenAI
Nonostante l’architettura condivisa, ogni versione è messa a punto per casi d’uso diversi. Vediamole nel dettaglio.
Questo è il modello di punta. Se vuoi le migliori prestazioni complessive tra coding, aderenza alle istruzioni e attività con contesto lungo, è quello giusto. È progettato per gestire workflow di sviluppo complessi o processare documenti di grandi dimensioni in un unico prompt.
Nei benchmark, supera GPT-4o nell’ingegneria del software reale (SWE-bench), nell’aderenza alle istruzioni (MultiChallenge) e nel ragionamento su contesti lunghi (MRCR, Graphwalks). È anche sensibilmente migliore nel rispettare struttura e formattazione—pensa a risposte in XML, istruzioni ordinate e vincoli negativi come «non rispondere a meno che…».
Puoi anche fare fine-tuning di GPT-4.1 fin dal giorno del lancio, il che lo apre a più casi d’uso in produzione in cui contano controllo del tono, del formato o della conoscenza di dominio.
GPT-4.1 Mini è l’opzione di fascia media, che offre quasi le stesse capacità del modello completo ma con latenza e costi inferiori. Eguaglia o supera GPT-4o in molti benchmark, inclusi aderenza alle istruzioni e ragionamento basato su immagini.
È destinato a diventare la scelta predefinita per molti casi d’uso: abbastanza veloce per strumenti interattivi, abbastanza intelligente da seguire istruzioni dettagliate e significativamente più economico del modello completo.
Come la versione completa, supporta 1 milione di token di contesto ed è già disponibile per il fine-tuning.
Nano è il più piccolo, veloce ed economico del gruppo. È pensato per compiti come autocompletamento, classificazione ed estrazione di informazioni da documenti di grandi dimensioni. Pur essendo leggero, supporta comunque la finestra di contesto completa da 1 milione di token.
È anche il modello OpenAI più piccolo, veloce ed economico di sempre, a circa 10 centesimi per milione di token. Non ottieni le piene capacità di ragionamento e pianificazione dei modelli più grandi, ma per certi compiti non è quello il punto.
Prima di entrare nei benchmark (che tratteremo nel dettaglio nella prossima sezione), vale la pena capire come GPT-4.1 differisca, nella pratica, da GPT-4o e GPT-4.5.
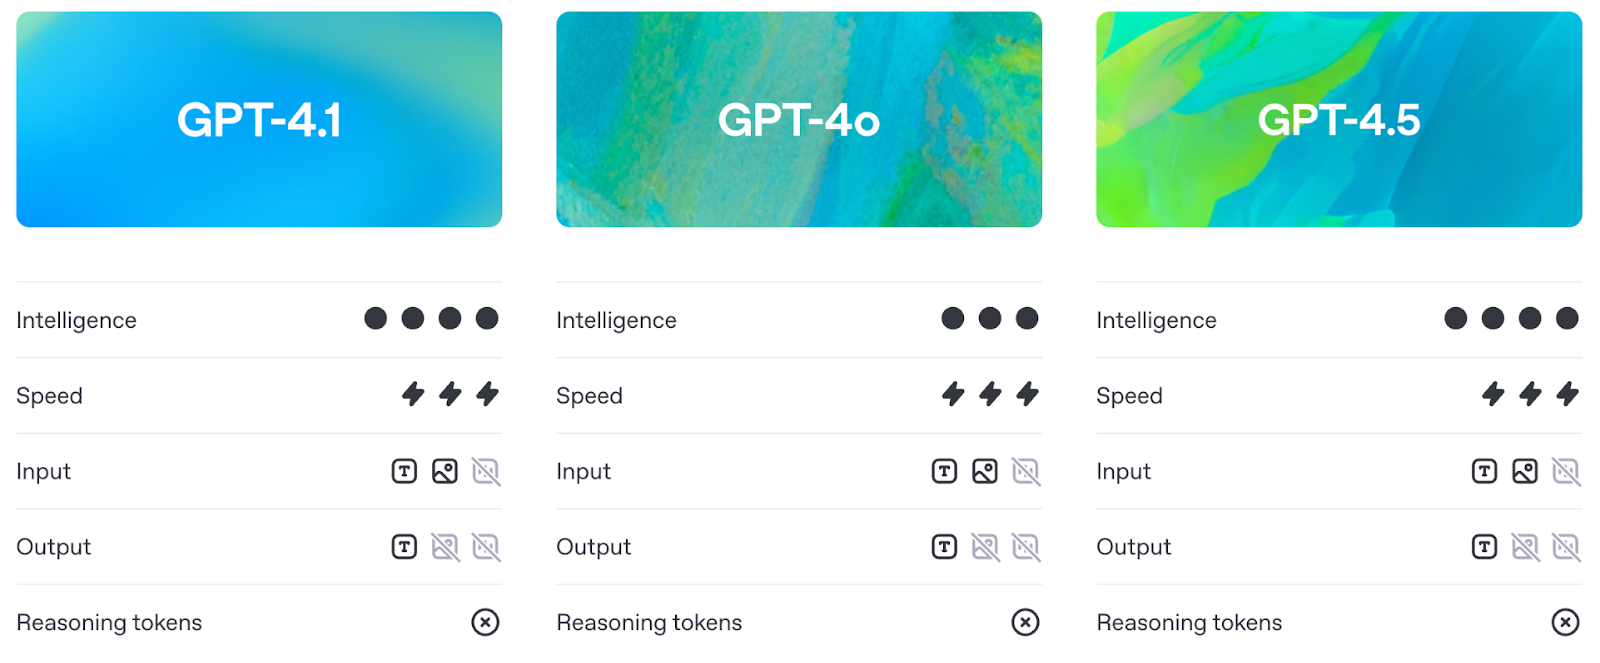
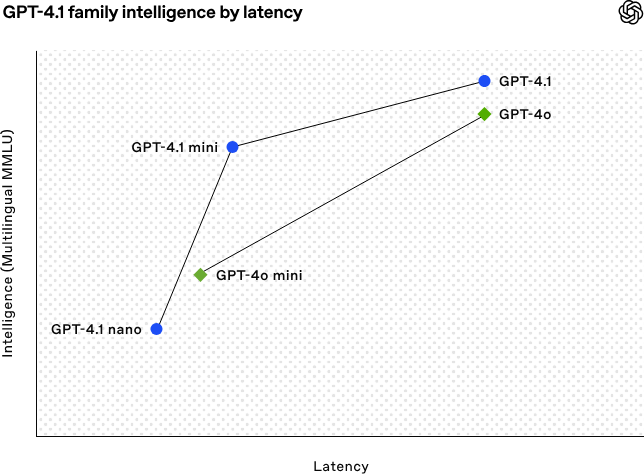
GPT-4.1 migliora le capacità di GPT-4o mantenendo la latenza più o meno sullo stesso livello. In pratica, significa che gli sviluppatori ora ottengono prestazioni migliori senza pagare in reattività.
Fonte: OpenAI
Scomponiamo il grafico sopra:
GPT-4.5, invece, è sempre stato presentato come una preview di ricerca. Pur avendo un forte ragionamento e qualità di scrittura, comportava più overhead. GPT-4.1 offre risultati simili o migliori nei benchmark chiave ma è più economico e reattivo—tanto che OpenAI prevede di ritirare completamente il 4.5 entro metà luglio per liberare più GPU.
Tutti e tre i modelli GPT-4.1—standard, Mini e Nano—supportano fino a 1 milione di token di contesto. È oltre 8 volte quanto offriva GPT-4o.
Questa capacità di contesto lungo abilita casi d’uso pratici come processare interi log, indicizzare repository di codice, gestire workflow legali multi-documento o analizzare trascrizioni lunghe—il tutto senza dover spezzare o riassumere in anticipo.
GPT-4.1 segna anche un cambiamento nell’affidabilità con cui i modelli seguono le istruzioni. Gestisce prompt complessi che coinvolgono passi ordinati, vincoli di formattazione e condizioni negative (come rifiutare di rispondere se la formattazione è sbagliata).
In pratica, questo significa due cose: meno tempo speso a elaborare i prompt e meno tempo a ripulire l’output dopo.
GPT-4.1 mostra progressi in quattro aree chiave: coding, aderenza alle istruzioni, comprensione di contesti lunghi e compiti multimodali.
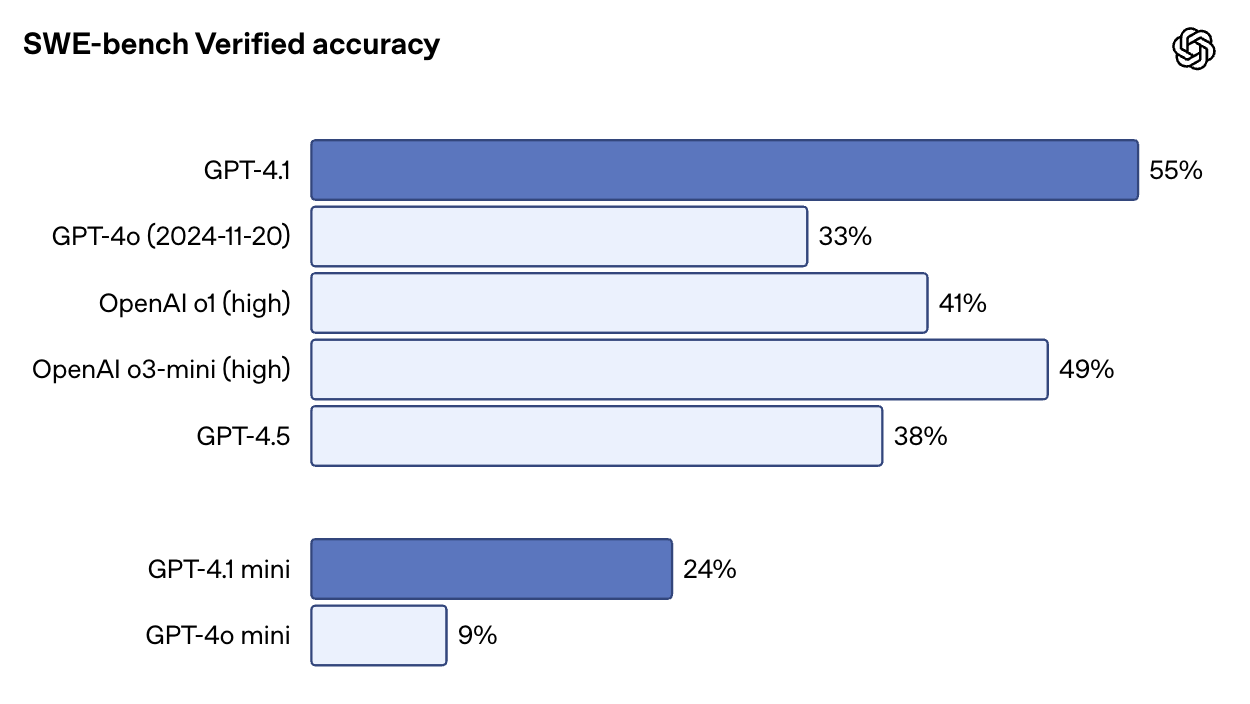
Su SWE-bench Verified—un benchmark che inserisce il modello in un vero codebase e gli chiede di completare issue end-to-end—GPT-4.1 ottiene il 54,6%. È un salto rispetto al 33,2% di GPT-4o e al 38% di GPT-4.5. È anche notevole che GPT-4.1 ottenga un punteggio superiore a o1 e o3-mini.
Fonte: OpenAI
Supera anche di oltre il doppio le prestazioni di GPT-4o sul benchmark polyglot diff di Aider, raggiungendo il 52,9% di accuratezza sui diff di codice in più linguaggi e formati. GPT-4.5 ha ottenuto il 44,9% nello stesso compito. GPT-4.1 è anche più preciso: nelle valutazioni interne, le modifiche di codice superflue sono scese dal 9% (GPT-4o) al 2%.
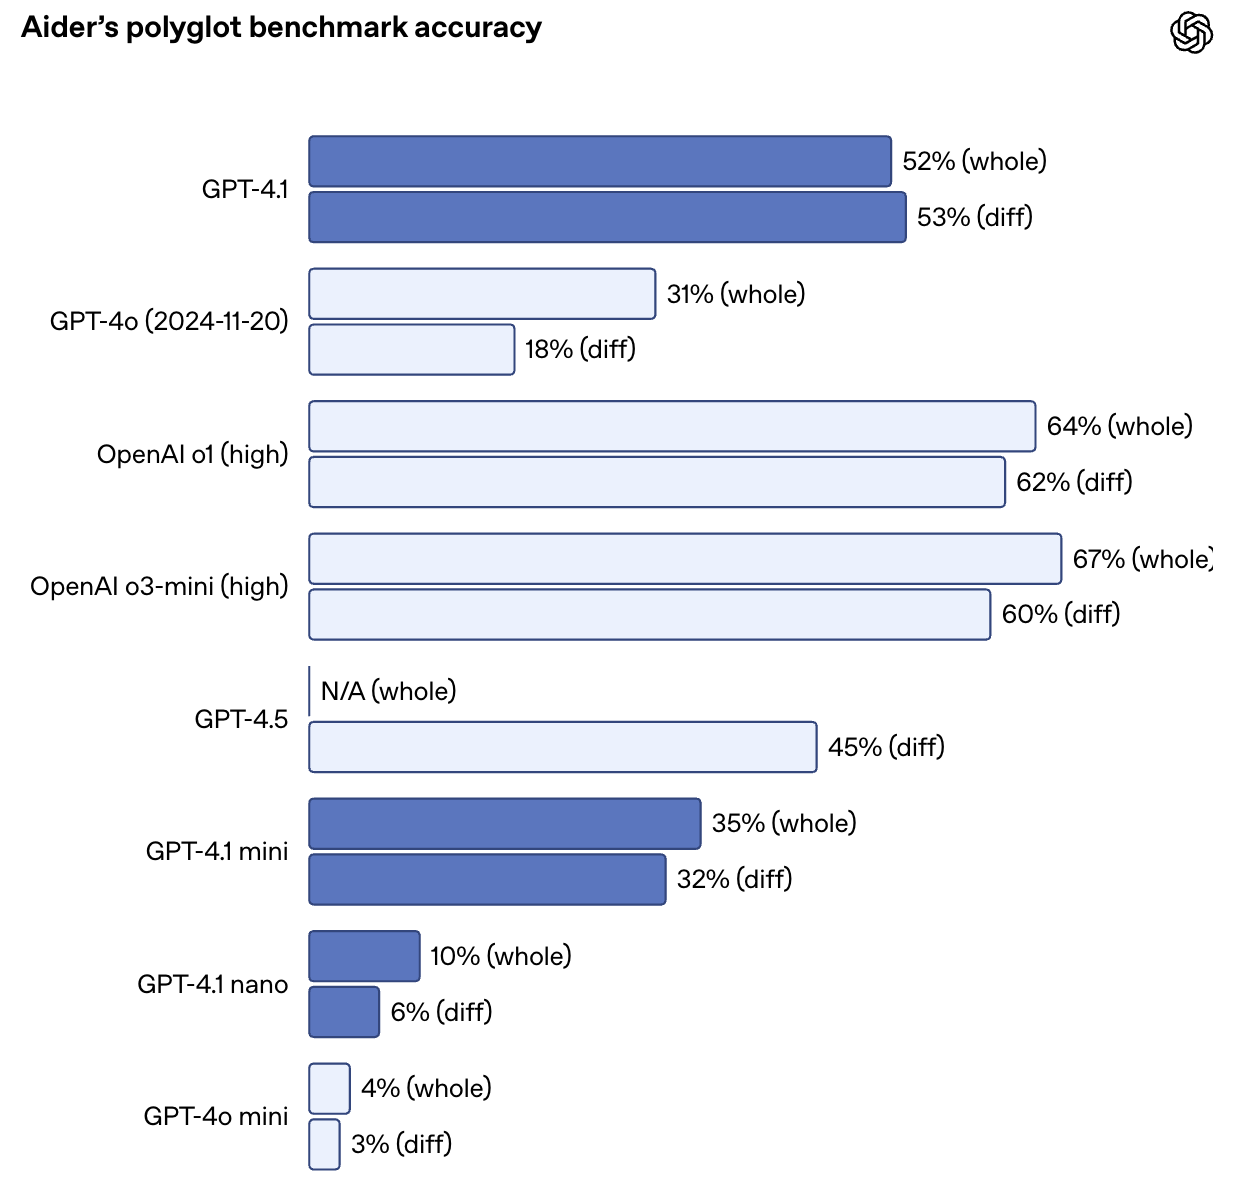
Fonte: OpenAI
Al di là dei punteggi di benchmark, la demo di frontend coding presentata da OpenAI è un buon esempio visivo delle prestazioni superiori di GPT-4.1. Il team ha chiesto a entrambi i modelli di costruire la stessa app di flashcard, e i valutatori umani hanno preferito l’output di GPT-4.1 nell’80% dei casi.
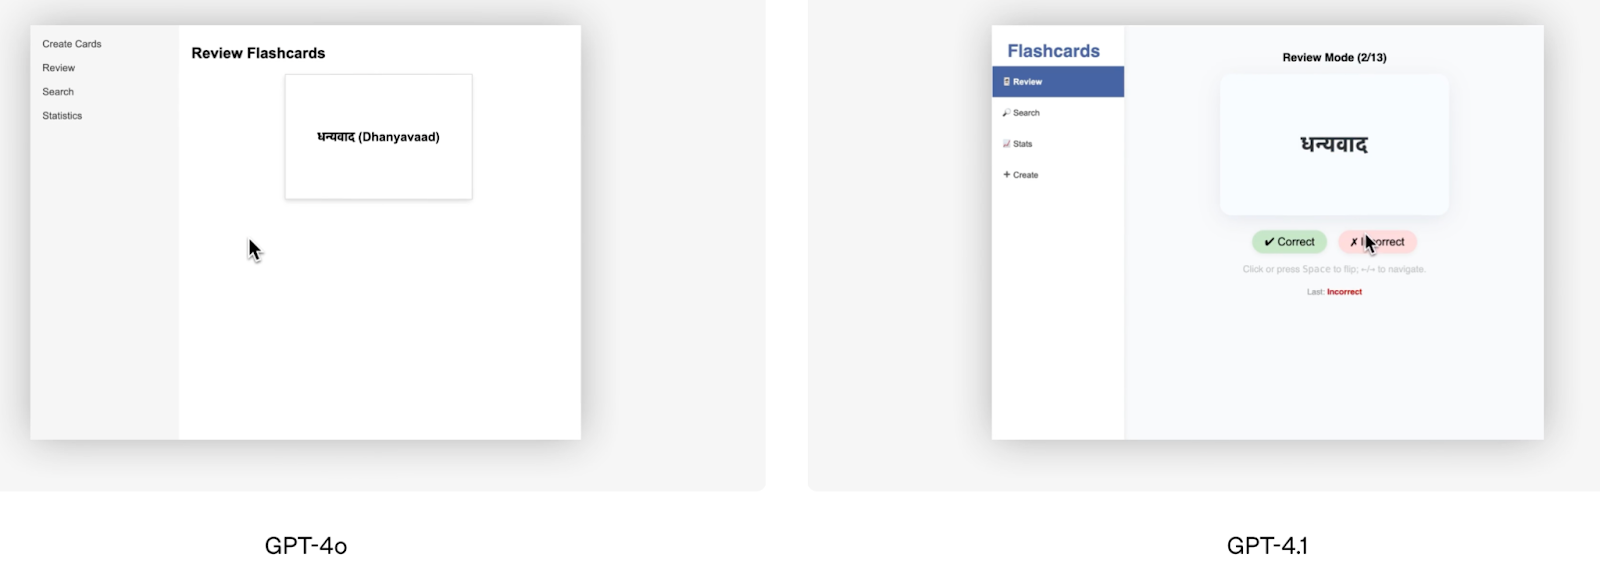
Fonte: OpenAI
Windsurf, uno degli alpha tester, ha riportato un miglioramento del 60% sul proprio benchmark interno di coding. Un’altra azienda, Qodo, ha testato GPT-4.1 su vere pull request di GitHub e ha riscontrato che produceva suggerimenti migliori nel 55% dei casi, con meno modifiche irrilevanti o eccessivamente verbose.
GPT-4.1 è più letterale—e più affidabile—nel seguire le istruzioni, soprattutto per compiti che coinvolgono più passaggi, regole di formattazione o condizioni. Nel test interno di OpenAI sull’aderenza alle istruzioni (sottoinsieme difficile), GPT-4.1 ha ottenuto il 49,1%, rispetto al 29,2% di GPT-4o. Qui GPT-4.5 è leggermente avanti con il 54%, ma il divario tra 4.1 e 4o è significativo.
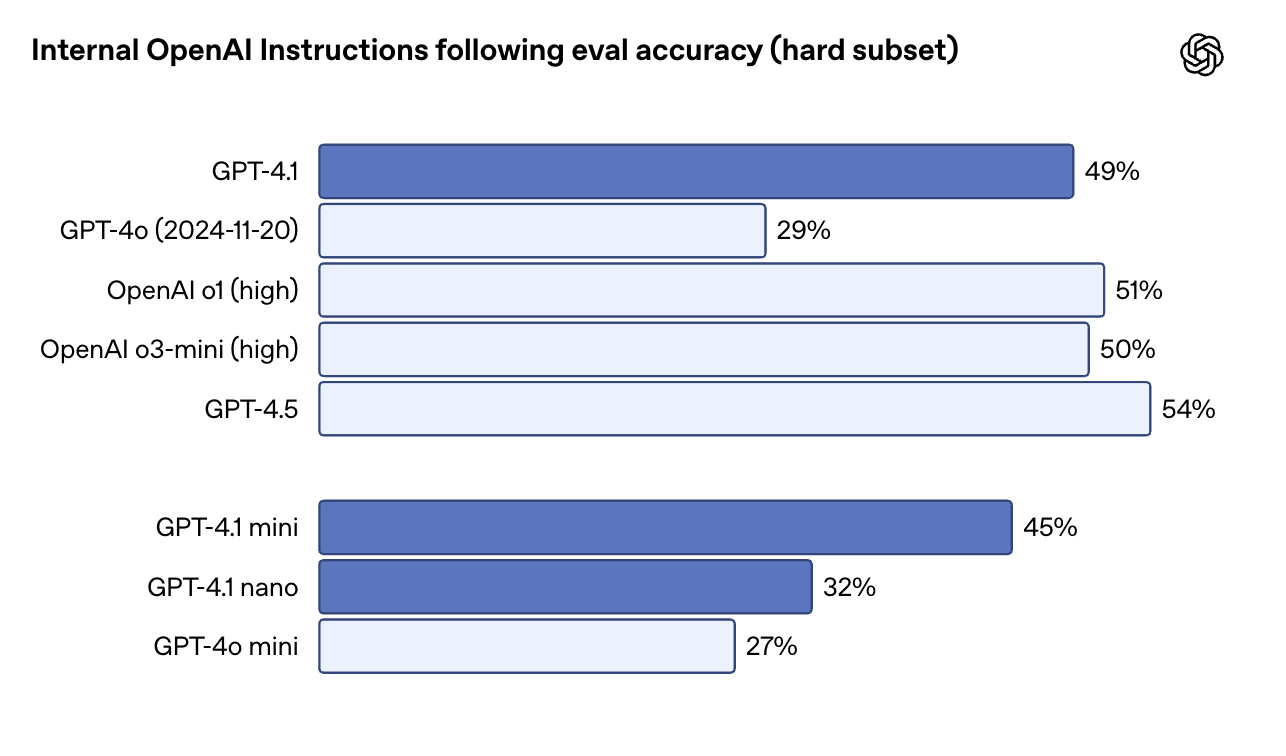
Fonte: OpenAI
Su MultiChallenge, che verifica se un modello sa seguire istruzioni multi-turn e ricordare vincoli introdotti in precedenza nella conversazione, GPT-4.1 ottiene il 38,3%—rispetto al 27,8% di GPT-4o. E su IFEval, che testa la conformità a requisiti di output chiaramente specificati, GPT-4.1 raggiunge l’87,4%, un miglioramento solido rispetto all’81% di GPT-4o.
In pratica, questo significa che GPT-4.1 è migliore nel rispettare passi ordinati, rifiutare input malformati e rispondere nel formato richiesto—soprattutto in output strutturati come XML, YAML o markdown. Rende anche più semplice costruire workflow di agent affidabili senza molti tentativi di prompt.
Tutti e tre i modelli GPT-4.1—standard, Mini e Nano—supportano fino a 1 milione di token di contesto. È un aumento di 8 volte rispetto a GPT-4o, che si fermava a 128K. Altrettanto importante: non c’è un costo extra per usare quella finestra di contesto. È tariffata come qualsiasi altro prompt.
Ma i modelli riescono davvero a sfruttare tutto quel contesto? Nel test di OpenAI «ago nel pagliaio», GPT-4.1 ha trovato in modo affidabile contenuti inseriti in qualsiasi punto—inizio, mezzo o fine—all’interno dell’intero input da 1M di token.
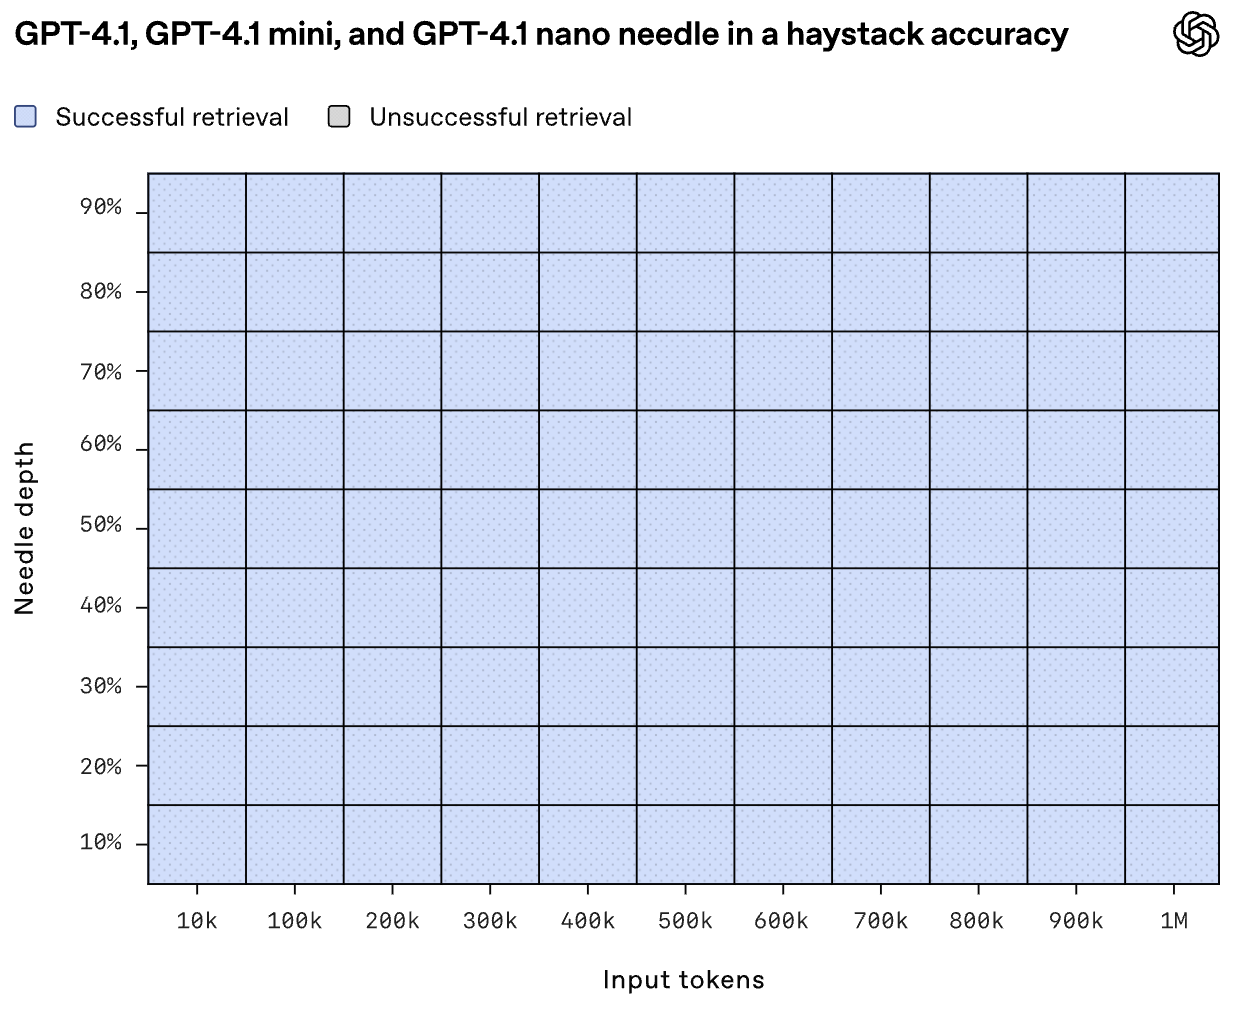
Fonte: OpenAI
Graphwalks, un benchmark che testa il ragionamento multi-hop in contesti lunghi, colloca GPT-4.1 al 61,7%—un salto consistente rispetto al 41,7% di GPT-4o, anche se ancora sotto GPT-4.5 al 72,3%.
Questi miglioramenti emergono anche nei test reali. Thomson Reuters ha visto un incremento del 17% nell’analisi legale multi-documento usando GPT-4.1, mentre Carlyle ha riportato un miglioramento del 50% nell’estrazione di dati granulari da densi report finanziari.
Sui compiti multimodali, GPT-4.1 fa ulteriori progressi. Ha ottenuto il 72,0% nel benchmark Video-MME, che prevede di rispondere a domande su video da 30–60 minuti senza sottotitoli—rispetto al 65,3% di GPT-4o.
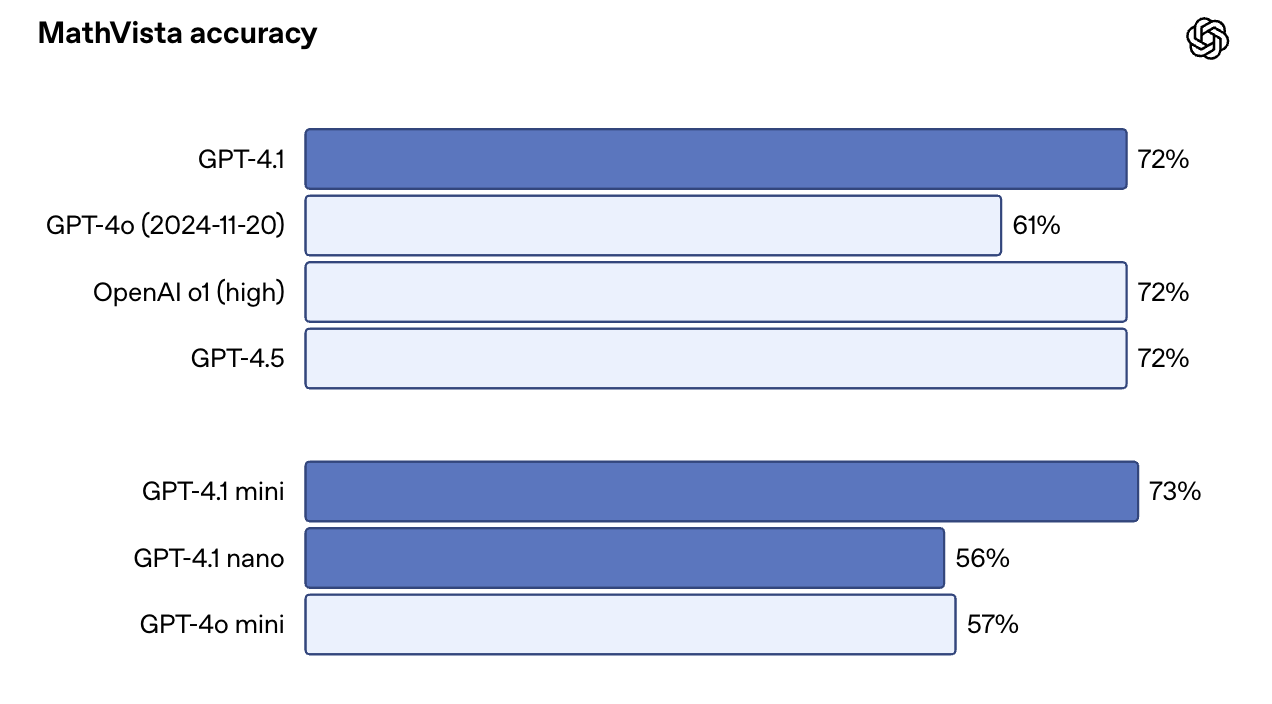
Su benchmark ricchi di immagini come MMMU, ha raggiunto il 74,8% contro il 68,7% di GPT-4o. Su MathVista, che include grafici, diagrammi e visual matematici, GPT-4.1 ha toccato il 72,2%.
Una sorpresa: GPT-4.1 Mini si comporta quasi come la versione completa su alcuni di questi benchmark. Su MathVista, ad esempio, ha leggermente superato GPT-4.1 con il 73,1%. Questo lo rende una scelta interessante per casi d’uso che combinano velocità e prompt ricchi di elementi visivi.
Fonte: OpenAI
Ora puoi accedere a GPT-4.1 e GPT-4.1 Mini direttamente nell’app ChatGPT, non solo tramite API. Gli abbonati Plus, Pro e Team possono selezionare manualmente GPT-4.1 dal menu dei modelli, mentre gli utenti free passano automaticamente a GPT-4.1 Mini—sostituendo GPT-4o Mini come predefinito dietro le quinte. I piani Enterprise ed Education dovrebbero ricevere l’accesso nelle prossime settimane.
Per gli sviluppatori, l’API di OpenAI e il Playground continuano a supportare tutte e tre le varianti—GPT-4.1, GPT-4.1 Mini e GPT-4.1 Nano. Resta il modo migliore per testare i prompt, esplorare il comportamento su contesti lunghi e confrontare i modelli prima di integrarli in produzione.
Se lavori con documenti lunghi—ad esempio log, PDF, archivi legali o articoli accademici—puoi inviare fino a 1 milione di token in una singola chiamata, senza bisogno di parametri speciali. Non c’è neanche un sovrapprezzo per il contesto lungo: i costi dei token sono fissi, a prescindere dalla dimensione dell’input.
Puoi effettuare il fine-tuning di tutte e tre le varianti di GPT-4.1. Questo apre la strada a istruzioni personalizzate, vocabolario specifico di dominio o output con un tono mirato. Nota che il fine-tuning ha un prezzo leggermente superiore:
|
Modello |
Input |
Input in cache |
Output |
Training |
|
GPT-4.1 |
$3.00 / 1M token |
$0.75 / 1M token |
$12.00 / 1M token |
$25.00 / 1M token |
|
GPT-4.1 Mini |
$0.80 / 1M token |
$0.20 / 1M token |
$3.20 / 1M token |
$5.00 / 1M token |
|
GPT-4.1 Nano |
$0.20 / 1M token |
$0.05 / 1M token |
$0.80 / 1M token |
$1.50 / 1M token |
Se hai già effettuato il fine-tuning di modelli GPT-3.5 o GPT-4, il processo resta quasi identico—basta scegliere la base più recente. Se vuoi saperne di più, ti consiglio questo tutorial sul fine-tuning di GPT-4o mini.
Una delle novità più gradite con GPT-4.1 è che non è solo più intelligente—è anche più economico. OpenAI afferma che l’obiettivo era rendere questi modelli più utilizzabili in sempre più workflow reali, e si vede da come sono strutturati i prezzi.
Ecco come sono prezzati i tre modelli per l’inferenza:
|
Modello |
Input |
Input in cache |
Output |
Costo medio "blended"* |
|
GPT-4.1 |
$2.00 / 1M token |
$0.50 / 1M token |
$8.00 / 1M token |
$1.84 |
|
GPT-4.1 Mini |
$0.40 / 1M token |
$0.10 / 1M token |
$1.60 / 1M token |
$0.42 |
|
GPT-4.1 Nano |
$0.10 / 1M token |
$0.025 / 1M token |
$0.40 / 1M token |
$0.12 |
*Il numero «blended» si basa sull’ipotesi di OpenAI sui tipici rapporti input/output.
GPT-4.1 offre generazione di codice più affidabile, migliore aderenza alle istruzioni, vero processamento di contesti lunghi e iterazioni più rapide.
Il naming può essere fuorviante, ma i modelli sono chiaramente più capaci di quelli precedenti. Sono anche più accessibili—e più usabili—soprattutto in ambienti di produzione dove latenza, costo e prevedibilità contano.
Se oggi lavori con GPT-4o, vale la pena testare GPT-4.1.
Impara l’AI con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



