Memahami aliran data dan memanfaatkan potensinya menjadi sangat krusial bagi organisasi modern. Kafka adalah platform terdepan untuk memasukkan, menyimpan, dan memproses stream data waktu nyata dalam lanskap aplikasi modern.
Dalam artikel ini, kami akan menguraikan beberapa pertanyaan wawancara Kafka dan membahas peran krusial alat ini dalam pemrosesan data. Kami akan membahas berbagai tingkat pertanyaan wawancara, dari dasar hingga lanjutan, serta memberikan kiat agar Anda dapat mempersiapkan diri secara efektif. Jika Anda baru mengenal Kafka, pastikan untuk melihat kursus Introduction to Apache Kafka kami.
Pertanyaan Wawancara Kafka Dasar
Pertanyaan-pertanyaan ini akan menguji pemahaman dasar Anda tentang Kafka sebagai alat untuk rekayasa data.
1. Apa itu Apache Kafka?
Apache Kafka adalah platform event-streaming terdistribusi yang kuat dan bersumber terbuka. Awalnya dikembangkan oleh LinkedIn sebagai antrian pesan, Kafka berevolusi menjadi alat untuk menangani stream data di berbagai skenario.
Arsitektur sistem terdistribusi Kafka memungkinkan skalabilitas horizontal, sehingga konsumen dapat mengambil pesan sesuai kecepatan mereka sendiri dan memudahkan penambahan node Kafka (server) ke dalam kluster.
Kafka dirancang untuk memproses data dalam jumlah besar dengan cepat dan latensi rendah. Meskipun ditulis dalam Scala dan Java, Kafka mendukung berbagai bahasa pemrograman.
Apache Kafka bertindak sebagai pengumpul log terdistribusi, di mana pesan log disimpan sebagai pasangan key-value dalam berkas log append-only untuk penyimpanan dan pengambilan jangka panjang yang andal. Berbeda dengan antrian pesan tradisional seperti RabbitMQ, yang menghapus pesan setelah dikonsumsi, Kafka mempertahankan pesan selama periode yang dapat dikonfigurasi, sehingga ideal untuk kasus penggunaan yang memerlukan pemutaran ulang data atau event sourcing.
Sementara RabbitMQ berfokus pada pengiriman pesan waktu nyata tanpa penyimpanan jangka panjang, kebijakan retensi Kafka mendukung aplikasi yang lebih kompleks dan berorientasi data.
Kasus penggunaan umum Kafka mencakup pelacakan aplikasi, agregasi log, dan pengiriman pesan, meskipun Kafka tidak memiliki fitur basis data tradisional seperti kueri dan pengindeksan. Kekuatan Kafka terletak pada penanganan stream data waktu nyata, menjadikannya tak tergantikan untuk sistem terdistribusi dan analitik real-time.
2. Apa saja fitur Kafka?
Apache Kafka adalah platform streaming terdistribusi sumber terbuka yang banyak digunakan untuk membangun pipeline data waktu nyata dan aplikasi streaming. Kafka menawarkan fitur-fitur berikut:
1. Throughput tinggi
Kafka mampu menangani volume data yang masif. Kafka dirancang untuk membaca dan menulis ratusan gigabita dari klien sumber secara efisien.
2. Arsitektur terdistribusi
Apache Kafka memiliki arsitektur berpusat pada kluster dan secara inheren mendukung partisi lintas server Kafka. Desain ini juga memungkinkan konsumsi terdistribusi di seluruh kluster mesin konsumen, sambil tetap menjaga urutan pesan dalam setiap partisi. Selain itu, kluster Kafka dapat diskalakan secara elastis dan transparan tanpa memerlukan downtime.
3. Mendukung berbagai klien
Apache Kafka mendukung integrasi klien dari berbagai platform, seperti .NET, JAVA, PHP, dan Python.
4. Pesan waktu nyata
Kafka menghasilkan pesan waktu nyata yang harus terlihat oleh konsumen; ini penting untuk sistem pemrosesan event yang kompleks.
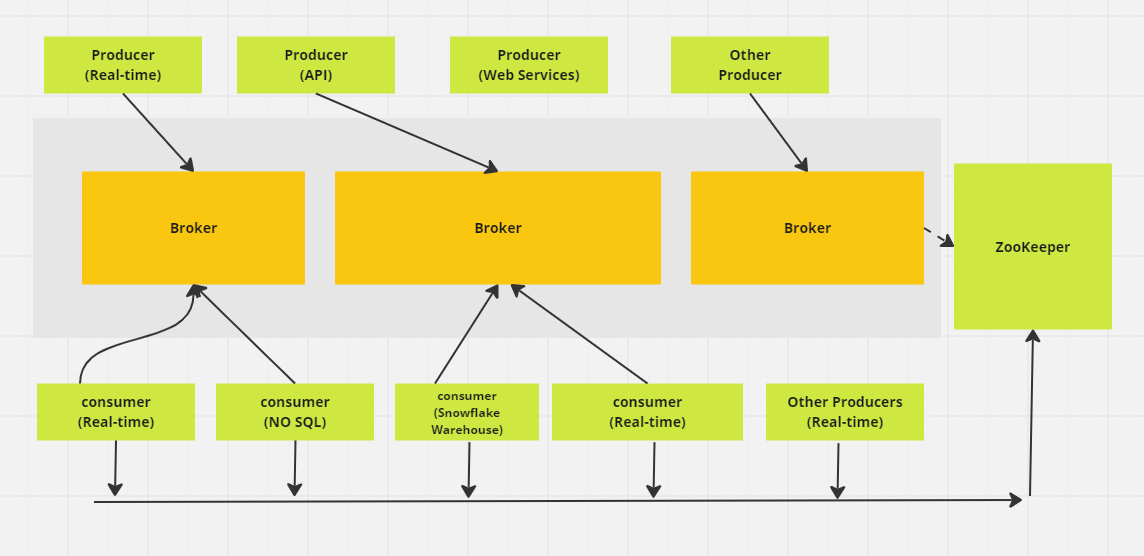
Sistem terdistribusi pengiriman pesan Apache Kafka. (Gambar oleh Penulis)
3. Bagaimana Partisi bekerja di Kafka?
Di Kafka, topik berfungsi sebagai ruang penyimpanan tempat semua pesan dari produser disimpan. Biasanya, data yang saling terkait disimpan di topik terpisah. Misalnya, topik bernama "transactions" akan menyimpan detail pembelian pengguna di situs e-niaga, sementara topik bernama "customers" akan menyimpan informasi pelanggan.
Topik dibagi menjadi partisi. Secara default, sebuah topik memiliki satu partisi, tetapi Anda dapat mengonfigurasinya agar memiliki lebih banyak. Pesan didistribusikan ke seluruh partisi ini, dengan setiap partisi memiliki offset sendiri dan disimpan di server yang berbeda dalam kluster Kafka.
Sebagai contoh, jika sebuah topik memiliki tiga partisi di tiga broker, dan produser mengirim 15 pesan, pesan-pesan tersebut didistribusikan secara berurutan:
- Rekaman 1 masuk ke Partisi 0
- Rekaman 2 masuk ke Partisi 1
- Rekaman 3 masuk ke Partisi 2
Kemudian siklus berulang, dengan Rekaman 4 kembali ke Partisi 0, dan seterusnya.
4. Mengapa Anda memilih Kafka dibandingkan layanan pengiriman pesan lainnya?
Memilih Kafka dibandingkan layanan pengiriman pesan lain sering kali bergantung pada keunggulan uniknya, terutama untuk kasus penggunaan yang memerlukan throughput tinggi dan pemrosesan data waktu nyata. Berikut alasan Kafka menonjol:
- Throughput dan skalabilitas tinggi: Kafka dapat menangani volume data besar secara efisien. Arsitekturnya mendukung penskalaan horizontal, memungkinkan Anda menambah broker dan partisi untuk mengelola beban data yang meningkat tanpa mengorbankan kinerja.
- Pemrosesan waktu nyata: Kafka sangat baik untuk streaming data waktu nyata, sehingga ideal untuk kasus penggunaan seperti pelacakan aktivitas dan pemantauan operasional. Misalnya, LinkedIn membuat Kafka untuk menangani pipeline pelacakan aktivitasnya, memungkinkan publikasi umpan waktu nyata dari interaksi pengguna seperti klik dan suka.
- Pemutaran ulang pesan: Kafka memungkinkan konsumen memutar ulang pesan, yang bermanfaat jika konsumen mengalami kesalahan atau kelebihan beban. Ini memastikan tidak ada data yang hilang—konsumen dapat memulihkan dan memutar ulang pesan yang terlewat untuk menjaga integritas data.
- Daya tahan dan toleransi kesalahan: Alat ini mereplikasi data di beberapa broker, memastikan keandalan meskipun sebagian broker gagal. Desain yang toleran terhadap kesalahan ini menjaga data tetap dapat diakses, memberikan keamanan untuk operasi kritis.
5. Jelaskan semua API yang disediakan oleh Apache Kafka.
API (Application Programming Interface) memungkinkan komunikasi antara berbagai layanan, mikroservis, dan sistem. Kafka menyediakan serangkaian API yang dirancang untuk membangun platform event streaming dan berinteraksi dengan sistem pengirim pesannya.
API inti Kafka adalah:
- Producer API: Digunakan untuk mengirim data waktu nyata ke topik Kafka. Produser menentukan ke partisi mana dalam sebuah topik setiap pesan akan dikirim, dengan callback yang menangani keberhasilan atau kegagalan operasi pengiriman.
- Consumer API: Memungkinkan pembacaan data waktu nyata dari topik Kafka. Konsumen dapat menjadi bagian dari consumer group untuk penyeimbangan beban dan pemrosesan paralel, berlangganan topik, dan terus melakukan polling Kafka untuk pesan baru.
- Streams API: Mendukung pembuatan aplikasi waktu nyata yang mentransformasi, mengagregasi, dan menganalisis data di dalam Kafka. Menyediakan DSL (Domain Specific Language) tingkat tinggi untuk mendefinisikan logika pemrosesan stream yang kompleks.
- Kafka Connect API: Digunakan untuk membuat dan menjalankan konektor yang dapat digunakan kembali untuk mengimpor dan mengekspor data antara Kafka dan sistem eksternal.
- Admin API: Menyediakan alat untuk mengelola dan mengonfigurasi topik, broker, dan sumber daya Kafka lainnya guna memastikan operasi yang lancar dan skalabilitas.
API-API ini memungkinkan produksi, konsumsi, pemrosesan, dan pengelolaan data yang mulus di dalam Kafka.
Pertanyaan Wawancara Kafka Menengah
Pertanyaan-pertanyaan ini ditujukan bagi praktisi yang lebih berpengalaman yang sudah memahami dengan baik penggunaan Kafka.
6. Apa implikasi meningkatkan jumlah partisi dalam sebuah topik Kafka?
Meningkatkan jumlah partisi dalam topik Kafka dapat meningkatkan konkurensi dan throughput dengan memungkinkan lebih banyak konsumen membaca secara paralel. Namun, hal ini juga menimbulkan tantangan tertentu:
- Peningkatan overhead kluster: Lebih banyak partisi mengonsumsi sumber daya kluster tambahan, meningkatkan lalu lintas jaringan untuk replikasi dan kebutuhan penyimpanan.
- Potensi ketidakseimbangan data: Saat partisi bertambah, data mungkin tidak terdistribusi merata, sehingga sebagian partisi bisa kelebihan beban sementara yang lain kurang dimanfaatkan.
- Manajemen consumer group yang lebih kompleks: Dengan lebih banyak partisi, pengelolaan penugasan consumer group dan pelacakan offset menjadi lebih rumit.
- Waktu rebalancing lebih lama: Saat konsumen bergabung atau keluar, penyeimbangan ulang partisi di seluruh grup dapat memakan waktu lebih lama, memengaruhi respons sistem secara keseluruhan.
7. Jelaskan empat komponen arsitektur Kafka
Kafka adalah arsitektur terdistribusi yang terdiri dari beberapa komponen kunci:
Broker node
Arsitektur terdistribusi Kafka terdiri dari beberapa komponen kunci, salah satunya adalah broker node. Broker menangani beban berat operasi input/output dan mengelola penyimpanan pesan yang tahan lama. Broker menerima data dari produser, menyimpannya, dan menyediakannya bagi konsumen. Setiap broker merupakan bagian dari kluster Kafka dan memiliki ID unik untuk membantu koordinasi.
Dalam versi Kafka yang lebih lama, kluster dikelola menggunakan Zookeeper, yang memastikan koordinasi yang tepat antar broker dan melacak metadata seperti lokasi partisi (meski Kafka bergerak menuju mode internal KRaft untuk ini). Broker Kafka sangat dapat diskalakan dan mampu menangani volume permintaan baca dan tulis yang besar untuk pesan di seluruh sistem terdistribusi.
Node ZooKeeper
ZooKeeper berperan penting di Kafka dengan mengelola pendaftaran broker dan memilih controller Kafka, yang menangani operasi administratif untuk kluster. ZooKeeper beroperasi sebagai kluster tersendiri, disebut ensemble, di mana beberapa proses bekerja sama untuk memastikan hanya satu broker pada satu waktu yang ditetapkan sebagai controller.
Jika controller saat ini gagal, ZooKeeper dengan cepat memilih broker baru untuk mengambil alih. Meskipun ZooKeeper merupakan bagian penting dari arsitektur Kafka, Kafka sedang bertransisi ke mode KRaft baru yang menghilangkan kebutuhan akan ZooKeeper. ZooKeeper adalah proyek open-source independen dan bukan komponen asli Kafka.
Produser
Produser Kafka adalah aplikasi klien yang berfungsi sebagai sumber data untuk Kafka, menerbitkan rekaman ke satu atau lebih topik Kafka melalui koneksi TCP persisten ke broker.
Beberapa produser dapat mengirim rekaman ke topik yang sama secara bersamaan. Topik Kafka bersifat append-only, artinya produser dapat menulis data baru, tetapi baik produser maupun konsumen tidak dapat mengubah atau menghapus rekaman yang ada, sehingga memastikan imutabilitas data.
Konsumen
Konsumen Kafka adalah aplikasi klien yang berlangganan satu atau lebih topik Kafka untuk mengonsumsi stream rekaman. Konsumen biasanya bekerja dalam consumer group, di mana beban pembacaan dan pemrosesan rekaman didistribusikan ke beberapa konsumen.
Setiap konsumen melacak progresnya melalui stream dengan mempertahankan offset, memastikan tidak ada data yang diproses dua kali dan rekaman yang belum diproses tidak hilang. Konsumen Kafka bertindak sebagai langkah akhir dalam pipeline data, di mana rekaman diproses atau diteruskan ke sistem hilir.
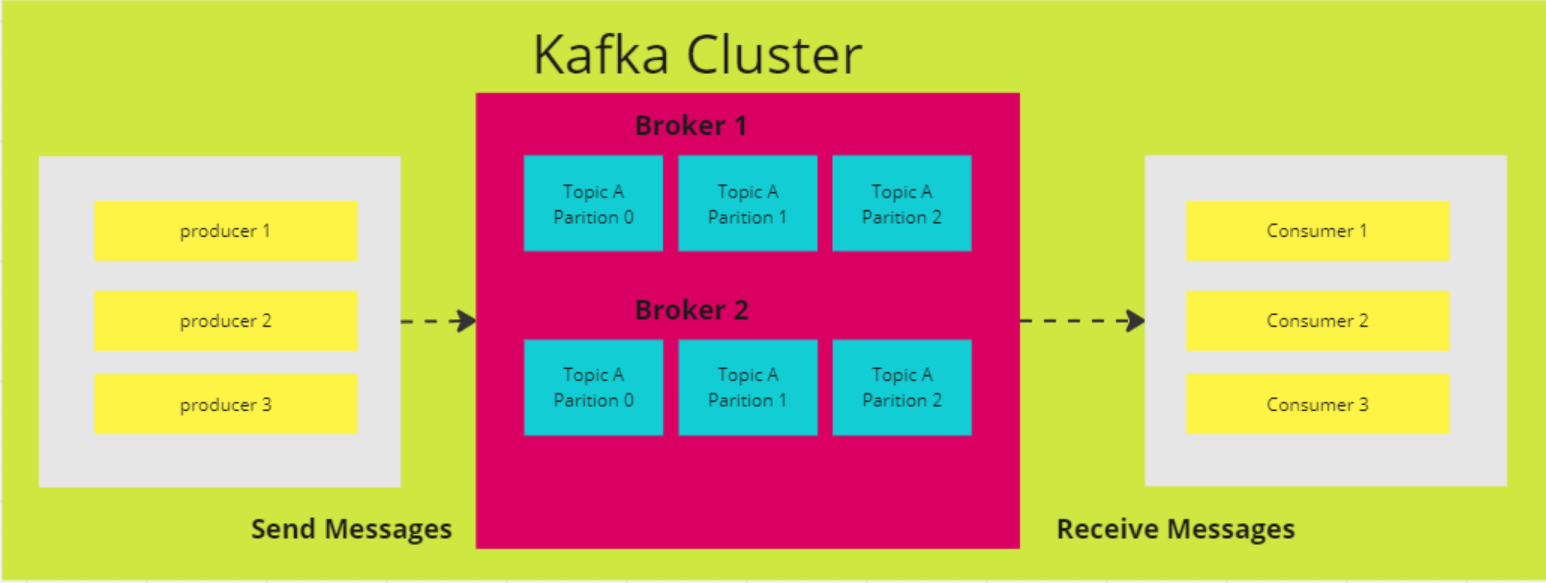
Diagram arsitektur Apache Kafka (Gambar oleh Penulis)
8. Apa tujuan utama log compaction di Kafka? Bagaimana dampaknya terhadap kinerja konsumen Kafka?
Tujuan utama log compaction di Kafka adalah mempertahankan nilai paling mutakhir untuk setiap key unik dalam log sebuah topik, memastikan status terbaru data tetap terjaga dan mengurangi penggunaan penyimpanan. Ini memungkinkan konsumen mengakses nilai saat ini lebih efisien tanpa harus memproses duplikasi lama.
Berbeda dengan kebijakan retensi tradisional Kafka, yang menghapus pesan setelah jangka waktu tertentu, log compaction hanya menghapus rekaman lama untuk setiap key, dengan mempertahankan nilai terbaru untuk key tersebut. Fitur ini membantu memastikan konsumen selalu memiliki akses ke status saat ini sekaligus menjaga log tetap ringkas untuk efisiensi penyimpanan yang lebih baik dan pencarian yang lebih cepat.
9. Apa perbedaan antara Partisi dan Replika dalam kluster Kafka?
Partisi dan replika adalah komponen kunci arsitektur Kafka, yang memastikan kinerja dan toleransi kesalahan. Partisi meningkatkan throughput dengan memungkinkan sebuah topik dipecah menjadi beberapa bagian, sehingga konsumen dapat membaca dari partisi berbeda secara paralel, yang meningkatkan skalabilitas dan efisiensi Kafka.
Replika, di sisi lain, memberikan redundansi dengan membuat salinan partisi di beberapa broker. Ini memastikan toleransi kesalahan karena, jika broker pemimpin gagal (broker yang mengelola operasi baca dan tulis untuk sebuah partisi), salah satu replika pengikut dapat dipromosikan untuk mengambil alih sebagai pemimpin baru.
Kafka mempertahankan beberapa replika untuk setiap partisi guna memastikan ketersediaan tinggi dan daya tahan data, meminimalkan risiko kehilangan data saat terjadi kegagalan, meskipun daya tahan penuh bergantung pada pengaturan replikasi.
10. Apa itu skema di Kafka, dan mengapa penting untuk sistem terdistribusi?
Di Kafka, skema mendefinisikan struktur dan format data, seperti field CustomerID (integer), CustomerName (string), dan Designation (string).
Dalam sistem terdistribusi seperti Kafka, produser dan konsumen harus sepakat tentang format data untuk menghindari kesalahan saat bertukar data. Kafka Schema Registry mengelola dan menegakkan skema ini, memastikan produser dan konsumen menggunakan versi yang kompatibel.
Schema Registry menyimpan skema (umumnya dalam format seperti Avro, Protobuf, atau JSON Schema) dan mendukung evolusi skema, memungkinkan format data berubah tanpa merusak konsumen yang ada. Ini memastikan pertukaran data yang lancar dan keandalan sistem seiring berkembangnya skema.
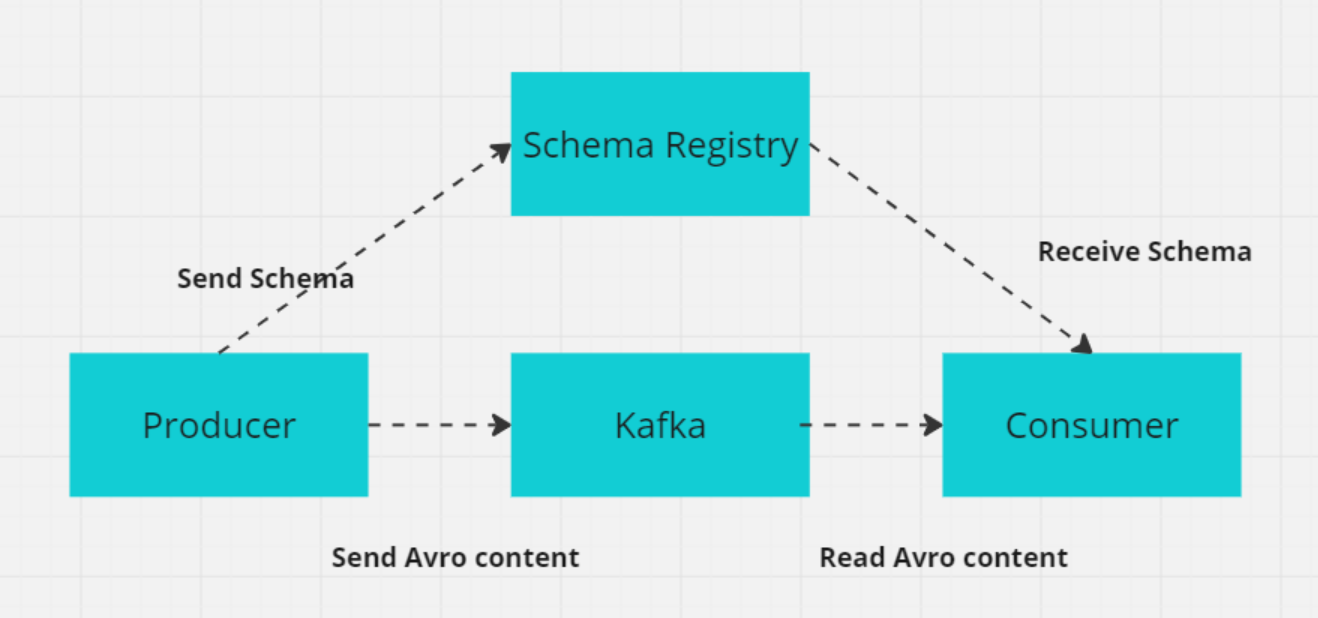
Cara kerja Schema Registry dengan produser/konsumen (Gambar oleh Penulis)
Pertanyaan Wawancara Kafka Lanjutan
Untuk pengguna Kafka yang lebih mahir, pertanyaan wawancara yang Anda hadapi kemungkinan akan lebih bersifat teknis.
11. Bagaimana Kafka memastikan pencegahan kehilangan pesan?
Kafka menerapkan beberapa mekanisme untuk mencegah kehilangan pesan dan memastikan pengiriman pesan yang andal:
- Commit offset manual: Konsumen dapat menonaktifkan commit offset otomatis dan melakukan commit offset secara manual setelah berhasil memproses pesan untuk menghindari kehilangan pesan yang belum diproses jika terjadi crash pada konsumen.
- Pengakuan produser (
acks=all): Mengaturacks=allpada produser memastikan bahwa pesan diakui oleh semua replika yang sinkron sebelum dianggap berhasil ditulis, mengurangi risiko kehilangan pesan jika terjadi kegagalan broker. - Replikasi (
min.insync.replicasdanreplication.factor): Kafka mereplikasi data setiap partisi ke beberapa broker. Faktor replikasi lebih dari 1 memastikan toleransi kesalahan, memungkinkan data tetap tersedia bahkan jika satu broker gagal. Pengaturanmin.insync.replicasmemastikan sejumlah minimum replika mengakui sebuah pesan sebelum ditulis, sehingga meningkatkan daya tahan data. Misalnya, dengan faktor replikasi 3, jika satu broker mati, data tetap tersedia di dua broker lainnya. - Retry produser: Mengonfigurasi retry ke nilai tinggi memastikan produser akan mencoba kembali mengirim pesan jika terjadi kegagalan sementara. Dikombinasikan dengan konfigurasi yang cermat, seperti
max.in.flight.requests.per.connection=1, hal ini mengurangi kemungkinan perubahan urutan pesan dan memastikan pesan akhirnya terkirim tanpa hilang.
12. Bagaimana perbedaan Kafka dengan RabbitMq?
Kafka dan RabbitMQ adalah dua sistem pengiriman pesan populer dan berbeda dalam hal arsitektur dan penggunaannya. Berikut perbandingan di area kunci:
1. Penggunaan dan desain
Kafka dirancang untuk menangani stream data skala besar dan pipeline waktu nyata, dioptimalkan untuk throughput tinggi dan latensi rendah. Arsitektur berbasis log memastikan daya tahan dan memungkinkan data diproses ulang, sehingga ideal untuk kasus penggunaan seperti event sourcing dan pemrosesan stream.
RabbitMQ adalah message broker serbaguna yang mendukung routing kompleks dan biasanya digunakan untuk pengiriman pesan antar mikroservis atau pendistribusian tugas di antara pekerja. RabbitMQ unggul di lingkungan yang memerlukan pengiriman pesan yang andal, fleksibilitas routing, dan interaksi antar layanan.
2. Arsitektur
Kafka mengategorikan pesan ke dalam topik, yang dibagi menjadi partisi. Setiap partisi dapat diproses oleh beberapa konsumen, memungkinkan pemrosesan paralel dan penskalaan. Data disimpan di disk dengan periode retensi yang dapat dikonfigurasi, memastikan daya tahan dan memungkinkan pemrosesan ulang pesan saat diperlukan.
RabbitMQ mengirim pesan ke antrian, tempat pesan dikonsumsi oleh satu atau lebih konsumen. RabbitMQ memastikan pengiriman yang andal melalui pengakuan pesan, retry, dan dead-letter exchange untuk menangani pesan yang gagal. Arsitektur ini berfokus pada integritas pesan dan fleksibilitas routing.
3. Kinerja dan skalabilitas
Kafka dibangun untuk skalabilitas horizontal dengan menambah broker dan partisi, memungkinkannya menangani jutaan pesan per detik. Arsitekturnya mendukung pemrosesan paralel dan throughput tinggi, sehingga ideal untuk streaming data skala besar.
RabbitMQ dapat diskalakan, meskipun tidak seefisien Kafka saat menangani volume data yang sangat besar. RabbitMQ cocok untuk skenario throughput sedang hingga tinggi, tetapi tidak dioptimalkan untuk throughput ekstrem yang dapat ditangani Kafka dalam aplikasi streaming berskala besar.
Ringkasan: Kafka dan RabbitMQ sama-sama alat yang kuat untuk pengiriman pesan, tetapi unggul pada kasus penggunaan yang berbeda. Kafka ideal untuk streaming data waktu nyata ber-throughput tinggi dan aplikasi event sourcing yang memerlukan pemrosesan paralel skala besar.
RabbitMQ sangat cocok untuk pengiriman pesan yang andal, distribusi tugas dalam arsitektur mikroservis, dan routing pesan yang kompleks. RabbitMQ unggul pada skenario yang memerlukan keterikatan longgar antar layanan, pemrosesan asinkron, dan keandalan.
13. Bagaimana Kafka membantu pengembangan aplikasi berbasis mikroservis?
Apache Kafka adalah alat yang berharga untuk membangun arsitektur mikroservis karena kemampuannya dalam menangani data waktu nyata, komunikasi berbasis event, dan pengiriman pesan yang andal. Berikut cara Kafka mendukung pengembangan mikroservis:
1. Arsitektur berbasis event
- Pemutusan keterikatan layanan: Kafka memungkinkan layanan berkomunikasi melalui event alih-alih panggilan langsung, mengurangi ketergantungan di antara mereka. Pemutusan keterikatan ini memungkinkan layanan memproduksi dan mengonsumsi event secara mandiri, menyederhanakan evolusi dan pemeliharaan layanan.
- Pemrosesan asinkron: Layanan dapat memublikasikan event dan melanjutkan pemrosesan tanpa menunggu respons layanan lain, meningkatkan responsivitas dan efisiensi sistem.
2. Skalabilitas
- Skalabilitas horizontal: Kafka dapat menangani volume data besar dengan mendistribusikan beban ke beberapa broker dan partisi. Setiap partisi dapat diproses oleh instance konsumen yang berbeda, memungkinkan sistem diskalakan secara horizontal.
- Konsumsi paralel: Beberapa konsumen dapat membaca dari partisi berbeda secara bersamaan, meningkatkan throughput dan kinerja.
3. Keandalan dan toleransi kesalahan
- Replikasi data: Kafka mereplikasi data di beberapa broker, memastikan ketersediaan tinggi dan toleransi kesalahan. Jika satu broker gagal, broker lain dapat mengambil alih dengan data yang direplikasi. Kafka menyimpan data di disk dengan periode retensi yang dapat dikonfigurasi, memastikan event tidak hilang dan dapat diproses ulang jika diperlukan.
4. Integrasi data
- Hub data pusat: Kafka bertindak sebagai hub pusat aliran data dalam arsitektur mikroservis, memfasilitasi integrasi antara berbagai sumber dan tujuan data. Ini menyederhanakan pemeliharaan konsistensi data di seluruh layanan.
- Kafka Connect: Kafka Connect menyediakan konektor untuk mengintegrasikan Kafka dengan banyak database, key-value store, indeks pencarian, dan sistem lainnya, menyederhanakan perpindahan data antara mikroservis dan sistem eksternal.
14. Apa itu Kafka Zookeeper, dan bagaimana cara kerjanya?
Apache ZooKeeper adalah layanan sumber terbuka yang membantu mengoordinasikan dan mengelola data konfigurasi, sinkronisasi, dan layanan grup dalam sistem terdistribusi. Pada versi Kafka yang lebih lama, ZooKeeper berperan penting dalam mengelola metadata, pemilihan pemimpin, dan koordinasi broker.
Namun, Kafka telah bertransisi ke mode KRaft sejak versi 2.8, yang menghilangkan kebutuhan akan ZooKeeper. ZooKeeper kini dianggap usang dan akan dihapus pada rilis 4.0, yang diperkirakan pada 2024.
ZooKeeper menyimpan data dalam struktur hierarkis node yang disebut "znode," di mana setiap znode dapat menyimpan metadata dan memiliki znode anak, mirip dengan sistem berkas. Struktur ini krusial untuk mempertahankan metadata terkait broker, topik, dan partisi Kafka. Mekanisme berbasis kuorum milik ZooKeeper memastikan konsistensi: mayoritas node (kuorum) harus menyetujui setiap perubahan, menjadikan ZooKeeper sangat andal dan toleran terhadap kesalahan.
Dalam versi Kafka yang lebih lama, ZooKeeper digunakan untuk beberapa fungsi kritis:
- Pemilihan pemimpin: ZooKeeper memilih node controller, yang mengelola penetapan pemimpin partisi dan tugas lintas kluster lainnya.
- Manajemen metadata broker: Menjaga registri terpusat broker aktif dan statusnya.
- Penetapan ulang partisi: ZooKeeper membantu mengelola rebalancing partisi di seluruh broker selama kegagalan atau ekspansi kluster.
Protokol ZAB (ZooKeeper Atomic Broadcast) milik ZooKeeper menjamin konsistensi di seluruh node, bahkan saat terjadi partisi jaringan, memastikan Kafka tetap toleran terhadap kesalahan. Konsistensi dan keandalan ini menjadikan ZooKeeper krusial untuk mengelola sifat terdistribusi Kafka, meskipun arsitektur Kafka di masa depan akan semakin sedikit bergantung pada ZooKeeper seiring KRaft menjadi mode default.
15. Bagaimana Anda dapat mengurangi penggunaan disk di Kafka?
Kafka menyediakan beberapa cara untuk secara efektif mengurangi penggunaan disk. Berikut strategi kunci:
1. Sesuaikan pengaturan retensi log
Ubah kebijakan retensi log untuk mengurangi lamanya pesan disimpan di disk. Ini dapat dilakukan dengan menyesuaikan retention.ms (retensi berbasis waktu) atau retention.bytes (retensi berbasis ukuran) untuk membatasi berapa lama atau berapa banyak data yang disimpan Kafka sebelum menghapus pesan lama.
2. Terapkan log compaction
Gunakan log compaction untuk mempertahankan hanya pesan terbaru untuk setiap key unik, menghapus data usang atau redundan. Ini sangat berguna untuk skenario di mana hanya status terbaru yang relevan, mengurangi penggunaan ruang disk tanpa kehilangan informasi penting.
3. Konfigurasikan kebijakan pembersihan
Tetapkan kebijakan pembersihan yang efektif berdasarkan kasus penggunaan Anda. Anda dapat mengonfigurasi kebijakan retensi berbasis waktu (retention.ms) dan berbasis ukuran (retention.bytes) untuk secara otomatis menghapus pesan lama dan mengelola jejak disk Kafka.
4. Kompres pesan
Aktifkan kompresi pesan di sisi produser menggunakan format seperti GZIP, Snappy, atau LZ4. Kompresi mengurangi ukuran pesan, sehingga konsumsi ruang disk lebih rendah. Namun, pertimbangkan trade-off antara pengurangan penggunaan disk dan peningkatan beban CPU akibat kompresi dan dekompresi.
5. Sesuaikan ukuran segmen log
Konfigurasikan ukuran segmen log Kafka (segment.bytes) untuk mengontrol seberapa sering segmen log digulirkan. Ukuran segmen yang lebih kecil memungkinkan pengguliran log lebih sering, yang dapat membantu efisiensi penggunaan disk dengan memungkinkan penghapusan data lama lebih cepat.
6. Hapus topik atau partisi yang tidak perlu
Secara berkala tinjau dan hapus topik serta partisi yang tidak digunakan atau tidak diperlukan. Ini dapat membebaskan ruang disk dan membantu menjaga penggunaan disk Kafka tetap terkendali.
Pertanyaan Wawancara Kafka untuk Data Engineer
Jika Anda mengikuti wawancara untuk posisi data engineer, Anda mungkin ingin mempersiapkan pertanyaan wawancara Kafka berikut.
16. Apa perbedaan antara leader replica dan follower replica di Kafka?
Leader replica
Leader replica menangani semua permintaan baca dan tulis dari klien. Ia mengelola status partisi dan menjadi titik interaksi utama bagi produser dan konsumen. Jika pemimpin gagal, perannya dialihkan ke salah satu follower replica untuk mempertahankan ketersediaan.
Follower replica
Follower replica mereplikasi data dari pemimpin tetapi tidak menangani permintaan klien secara langsung. Perannya adalah memastikan toleransi kesalahan dengan menjaga salinan data partisi yang selalu terbaru. Mulai Kafka 2.4, dalam kondisi tertentu, follower replica juga dapat menangani permintaan baca untuk membantu mendistribusikan beban dan meningkatkan throughput baca. Jika pemimpin gagal, seorang pengikut dipilih sebagai pemimpin baru untuk menjaga konsistensi dan ketersediaan data.
17. Mengapa kita menggunakan kluster di Kafka, dan apa manfaatnya?
Kluster Kafka terdiri dari beberapa broker yang mendistribusikan data ke beberapa instance, sehingga memungkinkan skalabilitas tanpa downtime. Kluster ini dirancang untuk meminimalkan keterlambatan, dan jika kluster utama gagal, kluster Kafka lain dapat mengambil alih untuk menjaga kelangsungan layanan.
Arsitektur kluster Kafka mencakup Topik, Broker, Produser, dan Konsumen. Kluster ini mengelola stream data secara efisien, menjadikannya ideal untuk aplikasi big data dan pengembangan aplikasi berbasis data.
18. Bagaimana Kafka memastikan pengurutan pesan?
Kafka memastikan pengurutan pesan dengan dua cara utama:
- Menggunakan key pesan: Saat sebuah pesan diberi key, semua pesan dengan key yang sama akan dikirim ke partisi yang sama. Ini memastikan pesan dengan key yang sama diproses sesuai urutan diterima, karena Kafka menjaga urutan dalam setiap partisi.
- Pemrosesan konsumen single-threaded: Untuk mempertahankan urutan, konsumen harus memproses pesan dari sebuah partisi dalam satu thread. Jika menggunakan beberapa thread, atur antrean dalam memori terpisah untuk setiap partisi agar pesan diproses dalam urutan yang benar selama penanganan konkuren.
19. Apa yang dimaksud dengan ISR dan AR di Kafka? Apa arti perluasan ISR?
ISR (in-sync replicas)
ISR mengacu pada replika yang sepenuhnya tersinkronisasi dengan leader replica. Replika ini memiliki data terbaru dan dianggap andal untuk operasi baca dan tulis.
AR (assigned replicas)
AR mencakup semua replika yang ditetapkan ke sebuah partisi, baik yang sinkron maupun yang tidak sinkron. Ini merepresentasikan keseluruhan set replika untuk sebuah partisi.
Perluasan ISR
Perluasan ISR terjadi ketika replika baru berhasil mengejar ketertinggalan dengan pemimpin dan ditambahkan ke daftar ISR. Ini meningkatkan jumlah replika yang terbaru, sehingga memperbaiki toleransi kesalahan dan keandalan.
20. Apa skenario penggunaan zero-copy di Kafka?
Kafka menggunakan zero-copy untuk mentransfer volume data besar secara efisien antara produser dan konsumen. Kafka memanfaatkan metode FileChannel.transferTo untuk memindahkan data langsung dari sistem berkas ke soket jaringan tanpa penyalinan tambahan, meningkatkan kinerja dan throughput.
Teknik ini memanfaatkan berkas yang dipetakan ke memori (mmap) untuk membaca berkas indeks, memungkinkan buffer data dibagikan antara user space dan kernel space, sehingga semakin mengurangi kebutuhan penyalinan data tambahan. Hal ini membuat Kafka sangat cocok untuk menangani stream data waktu nyata berskala besar secara efisien.
Mempersiapkan Wawancara Kafka Anda
Saat Anda mempersiapkan wawancara data engineering yang berfokus pada Kafka, penting untuk memiliki landasan teknis yang kuat dan pemahaman jelas tentang bagaimana Kafka terintegrasi ke dalam sistem modern. Kafka menjadi inti banyak platform data waktu nyata, sehingga pewawancara akan mengharapkan Anda memahami dasar-dasarnya sekaligus cara kerja Kafka dalam lingkungan yang dapat diskalakan dan toleran terhadap kesalahan.
Area kunci untuk difokuskan
Seperti yang kita lihat pada pertanyaan wawancara Kafka yang telah dibahas, ada beberapa area kunci yang perlu Anda dalami:
- Arsitektur: Yakinlah membahas arsitektur Kafka, termasuk broker, partisi, serta interaksi antara produser dan konsumen. Anda juga harus menjelaskan jaminan pengiriman pesan Kafka—seperti "at-least-once" atau "exactly-once"—dan bagaimana Kafka memastikan pengurutan pesan melalui fitur seperti In-Sync Replicas (ISR).
- Integrasi: Pahami bagaimana Kafka terintegrasi dengan sistem lain menggunakan alat seperti Kafka Connect, yang menghubungkan database, key-value store, dan sistem lainnya. Pewawancara mungkin menanyakan peran Kafka dalam menjaga konsistensi data di mikroservis atau sistem terdistribusi.
- Pemantauan dan pemecahan masalah: Keakraban dengan alat pemantauan seperti Kafka Manager dan Prometheus itu penting. Anda perlu menunjukkan kemampuan untuk mengelola dan mengoptimalkan kluster Kafka secara efektif.
- Pemecahan masalah: Bersiaplah merancang solusi pengiriman pesan yang menyelesaikan tantangan dunia nyata, seperti menangani aliran data besar atau memastikan keandalan pesan. Pewawancara mungkin memberikan skenario hipotetis di mana Anda perlu melakukan troubleshooting atau mengoptimalkan kinerja Kafka.
- Komunikasi: Kafka itu kompleks, jadi Anda harus mampu menjelaskan dengan jelas keputusan desain atau langkah pemecahan masalah Anda, baik kepada tim teknis maupun pemangku kepentingan bisnis. Keterampilan komunikasi yang kuat akan membedakan Anda.
- Pengalaman langsung: Soroti pengalaman praktis apa pun, seperti menyiapkan kluster Kafka, mengelola retensi data, atau mengintegrasikan Kafka dengan alat lain. Pengetahuan praktis sangat dihargai.
- Pembelajaran berkelanjutan: Tetap mengikuti fitur terbaru Kafka dan praktik terbaiknya. Membaca dokumentasi atau berkontribusi pada proyek open-source menunjukkan komitmen Anda terhadap pembelajaran berkelanjutan.
Kiat wawancara
Berikut beberapa kiat utama agar Anda sukses dalam wawancara:
- Riset tentang perusahaan, industri, dan latar belakang pewawancara Anda.
- Siapkan diri untuk berbagai tahapan wawancara (teknis, HR, telepon, dan tatap muka) dengan pendekatan yang disesuaikan.
- Secara rutin tinjau sumber daya teknis seperti:
Dengan mempertajam keterampilan ini dan mempersiapkan diri secara efektif, Anda akan siap menghadapi wawancara terkait Kafka. Ingat, pewawancara mencari tidak hanya keahlian teknis tetapi juga komunikasi yang jelas dan kemampuan memecahkan masalah dunia nyata. Tunjukkan antusiasme Anda terhadap rekayasa data sepanjang proses wawancara.