Hiểu cách dữ liệu luân chuyển và khai thác tiềm năng của nó đã trở nên vô cùng quan trọng đối với các tổ chức hiện đại. Kafka là nền tảng hàng đầu để tiếp nhận, lưu trữ và xử lý các luồng dữ liệu thời gian thực trong bức tranh ứng dụng ngày nay.
Trong bài viết này, chúng tôi sẽ nêu ra một số câu hỏi phỏng vấn về Kafka và khám phá vai trò then chốt của công cụ này trong xử lý dữ liệu. Chúng tôi sẽ đi qua các cấp độ câu hỏi, từ cơ bản đến nâng cao, và đưa ra mẹo giúp bạn chuẩn bị hiệu quả. Nếu bạn mới làm quen với Kafka, hãy xem khóa học Giới thiệu về Apache Kafka của chúng tôi.
Câu hỏi phỏng vấn Kafka cơ bản
Những câu hỏi này sẽ kiểm tra mức hiểu biết cơ bản của bạn về Kafka với tư cách là một công cụ dành cho kỹ thuật dữ liệu.
1. Apache Kafka là gì?
Apache Kafka là nền tảng phát sự kiện phân tán mạnh mẽ, mã nguồn mở. Ban đầu được LinkedIn phát triển như một hàng đợi tin nhắn, Kafka đã phát triển thành công cụ xử lý các luồng dữ liệu trong nhiều kịch bản khác nhau.
Kiến trúc hệ thống phân tán của Kafka cho phép mở rộng theo chiều ngang, giúp người tiêu thụ lấy tin nhắn theo nhịp độ riêng và dễ dàng thêm nút Kafka (máy chủ) vào cụm.
Kafka được thiết kế để xử lý lượng dữ liệu lớn nhanh với độ trễ thấp. Mặc dù được viết bằng Scala và Java, Kafka hỗ trợ nhiều ngôn ngữ lập trình khác.
Apache Kafka hoạt động như một bộ thu thập nhật ký phân tán, nơi các thông điệp nhật ký được lưu dưới dạng cặp khóa-giá trị trong tệp nhật ký chỉ-ghi để lưu trữ và truy xuất bền vững, dài hạn. Khác với các hàng đợi tin nhắn truyền thống như RabbitMQ vốn xóa tin nhắn sau khi được tiêu thụ, Kafka giữ lại tin nhắn trong một khoảng thời gian có thể cấu hình, giúp lý tưởng cho các trường hợp cần phát lại dữ liệu hoặc event sourcing.
Trong khi RabbitMQ tập trung vào phân phối tin nhắn theo thời gian thực mà không lưu trữ dài hạn, chính sách giữ lại của Kafka hỗ trợ các ứng dụng phức tạp, định hướng dữ liệu hơn.
Các trường hợp sử dụng phổ biến của Kafka gồm theo dõi ứng dụng, tổng hợp nhật ký và nhắn tin, dù nó thiếu các tính năng cơ sở dữ liệu truyền thống như truy vấn và lập chỉ mục. Thế mạnh của Kafka nằm ở xử lý các luồng dữ liệu thời gian thực, khiến nó không thể thiếu cho hệ thống phân tán và phân tích thời gian thực.
2. Một số tính năng của Kafka là gì?
Apache Kafka là nền tảng phát trực tuyến phân tán mã nguồn mở được sử dụng rộng rãi để xây dựng pipeline dữ liệu thời gian thực và ứng dụng phát trực tuyến. Nó cung cấp các tính năng sau:
1. Thông lượng cao
Kafka có khả năng xử lý khối lượng dữ liệu khổng lồ. Nó được thiết kế để đọc và ghi hàng trăm gigabyte từ các client nguồn một cách hiệu quả.
2. Kiến trúc phân tán
Apache Kafka có kiến trúc hướng cụm và mặc định hỗ trợ phân vùng trên các máy chủ Kafka. Thiết kế này cũng cho phép tiêu thụ phân tán trên một cụm máy tiêu thụ, đồng thời vẫn giữ thứ tự tin nhắn trong mỗi phân vùng. Ngoài ra, cụm Kafka có thể mở rộng linh hoạt và minh bạch mà không cần downtime.
3. Hỗ trợ nhiều client
Apache Kafka hỗ trợ tích hợp client từ nhiều nền tảng như .NET, JAVA, PHP và Python.
4. Thông điệp thời gian thực
Kafka tạo ra các thông điệp thời gian thực mà người tiêu thụ có thể thấy ngay; điều này quan trọng đối với các hệ thống xử lý sự kiện phức tạp.
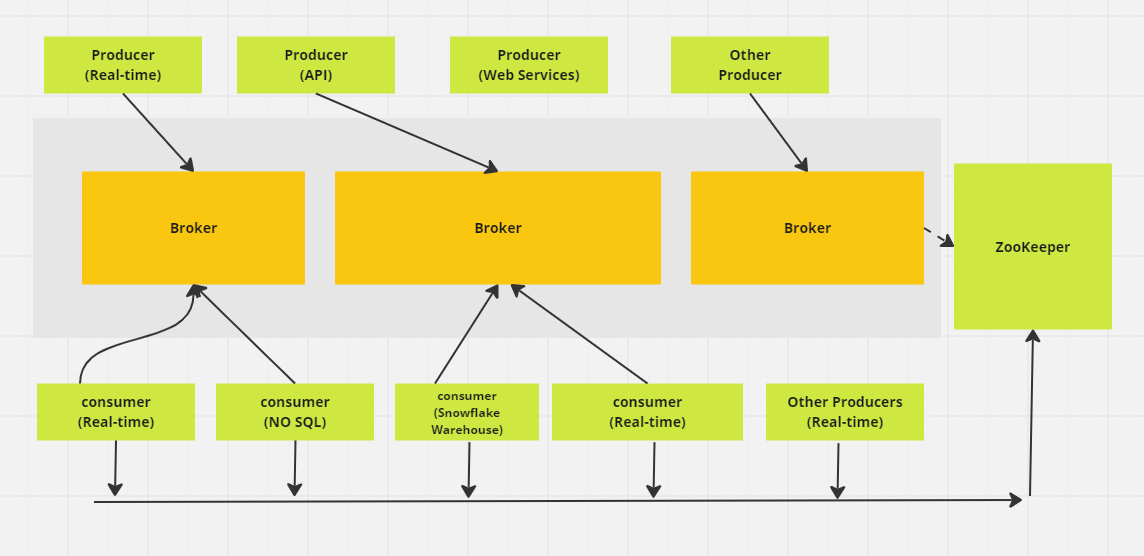
Hệ thống nhắn tin phân tán Apache Kafka. (Hình do Tác giả cung cấp)
3. Phân vùng (Partition) hoạt động như thế nào trong Kafka?
Trong Kafka, chủ đề (topic) đóng vai trò là không gian lưu trữ nơi tất cả thông điệp từ các producer được giữ lại. Thông thường, dữ liệu liên quan được lưu ở các topic riêng. Ví dụ, một topic tên "transactions" sẽ lưu chi tiết các giao dịch mua của người dùng trên trang thương mại điện tử, trong khi topic "customers" lưu thông tin khách hàng.
Các topic được chia thành các phân vùng. Mặc định, một topic có một phân vùng, nhưng bạn có thể cấu hình để có nhiều hơn. Thông điệp được phân phối qua các phân vùng này, mỗi phân vùng có offset riêng và được lưu trên máy chủ khác nhau trong cụm Kafka.
Chẳng hạn, nếu một topic có ba phân vùng trên ba broker, và một producer gửi 15 thông điệp, chúng sẽ được phân phối tuần tự:
- Bản ghi 1 vào Phân vùng 0
- Bản ghi 2 vào Phân vùng 1
- Bản ghi 3 vào Phân vùng 2
Sau đó chu kỳ lặp lại, Bản ghi 4 quay lại Phân vùng 0, và cứ thế tiếp tục.
4. Vì sao bạn chọn Kafka thay vì các dịch vụ nhắn tin khác?
Việc chọn Kafka thay vì các dịch vụ nhắn tin khác thường phụ thuộc vào những điểm mạnh khác biệt của nó, đặc biệt với các trường hợp cần thông lượng cao và xử lý dữ liệu thời gian thực. Lý do Kafka nổi bật:
- Thông lượng cao và khả năng mở rộng: Kafka có thể xử lý khối lượng dữ liệu lớn một cách hiệu quả. Kiến trúc của nó hỗ trợ mở rộng theo chiều ngang, cho phép bạn thêm nhiều broker và phân vùng để xử lý tải dữ liệu tăng mà không giảm hiệu năng.
- Xử lý thời gian thực: Kafka xuất sắc trong phát trực tuyến dữ liệu thời gian thực, lý tưởng cho các trường hợp như theo dõi hoạt động và giám sát vận hành. Ví dụ, LinkedIn tạo Kafka để xử lý pipeline theo dõi hoạt động, cho phép xuất bản nguồn cấp dữ liệu thời gian thực về tương tác của người dùng như nhấp chuột và lượt thích.
- Phát lại tin nhắn: Kafka cho phép người tiêu thụ phát lại tin nhắn, hữu ích khi consumer gặp lỗi hoặc bị quá tải. Điều này đảm bảo không mất dữ liệu—consumer có thể phục hồi và phát lại các tin nhắn bỏ lỡ để duy trì tính toàn vẹn dữ liệu.
- Độ bền và chịu lỗi: Công cụ sao chép dữ liệu trên nhiều broker, đảm bảo độ tin cậy ngay cả khi một số broker gặp sự cố. Thiết kế chịu lỗi này giữ dữ liệu luôn sẵn sàng, tạo sự an tâm cho các hoạt động quan trọng.
5. Hãy giải thích tất cả các API do Apache Kafka cung cấp.
API (Giao diện Lập trình Ứng dụng) cho phép giao tiếp giữa các dịch vụ, vi dịch vụ và hệ thống khác nhau. Kafka cung cấp một bộ API được thiết kế để xây dựng nền tảng phát sự kiện và tương tác với hệ thống nhắn tin của nó.
Các API cốt lõi của Kafka gồm:
- Producer API: Dùng để gửi dữ liệu thời gian thực vào các topic của Kafka. Producer quyết định phân vùng trong topic mà mỗi thông điệp sẽ đến, với callback xử lý thành công hay thất bại của thao tác gửi.
- Consumer API: Cho phép đọc dữ liệu thời gian thực từ các topic của Kafka. Consumer có thể là một phần của nhóm consumer để cân bằng tải và xử lý song song, đăng ký topic và liên tục thăm dò Kafka để lấy tin nhắn mới.
- Streams API: Hỗ trợ xây dựng ứng dụng thời gian thực để biến đổi, tổng hợp và phân tích dữ liệu trong Kafka. Nó cung cấp DSL (Domain Specific Language) cấp cao để định nghĩa logic xử lý luồng phức tạp.
- Kafka Connect API: Dùng để tạo và chạy các connector tái sử dụng nhằm nhập và xuất dữ liệu giữa Kafka và hệ thống bên ngoài.
- Admin API: Cung cấp công cụ quản lý và cấu hình topic, broker và tài nguyên khác của Kafka để đảm bảo vận hành trơn tru và mở rộng.
Các API này cho phép sản xuất, tiêu thụ, xử lý và quản lý dữ liệu liền mạch trong Kafka.
Câu hỏi phỏng vấn Kafka trung cấp
Những câu hỏi này hướng đến những người đã có kinh nghiệm và nắm vững các cách sử dụng của Kafka.
6. Tăng số lượng phân vùng trong một topic Kafka có ý nghĩa gì?
Tăng số lượng phân vùng trong một topic Kafka có thể cải thiện khả năng đồng thời và thông lượng bằng cách cho phép nhiều consumer đọc song song. Tuy nhiên, điều này cũng mang lại một số thách thức:
- Tăng chi phí vận hành cụm: Nhiều phân vùng tiêu tốn thêm tài nguyên cụm, dẫn đến lưu lượng mạng cao hơn cho việc sao chép và yêu cầu lưu trữ tăng.
- Nguy cơ mất cân bằng dữ liệu: Khi số phân vùng tăng, dữ liệu có thể không được phân phối đều, khiến một số phân vùng quá tải còn số khác kém sử dụng.
- Quản lý nhóm consumer phức tạp hơn: Với nhiều phân vùng hơn, quản lý phân công cho nhóm consumer và theo dõi offset trở nên phức tạp hơn.
- Thời gian cân bằng lại lâu hơn: Khi consumer tham gia hoặc rời đi, việc cân bằng lại phân vùng trong nhóm có thể mất nhiều thời gian hơn, ảnh hưởng đến khả năng phản hồi tổng thể.
7. Giải thích bốn thành phần của kiến trúc Kafka
Kafka là một kiến trúc phân tán gồm một số thành phần chủ chốt:
Nút broker
Kiến trúc phân tán của Kafka bao gồm một số thành phần chính, trong đó có nút broker. Broker đảm nhận phần lớn thao tác vào/ra và quản lý lưu trữ bền vững của tin nhắn. Chúng nhận dữ liệu từ producer, lưu trữ và cung cấp cho consumer. Mỗi broker là một phần của cụm Kafka và có ID duy nhất để phối hợp.
Trong các phiên bản Kafka cũ, cụm được quản lý bằng Zookeeper, bảo đảm phối hợp đúng giữa các broker và theo dõi metadata như vị trí phân vùng (dù Kafka đang chuyển sang chế độ nội bộ KRaft cho mục đích này). Broker Kafka có khả năng mở rộng cao và xử lý được lượng lớn yêu cầu đọc và ghi tin nhắn trên hệ thống phân tán.
Nút ZooKeeper
ZooKeeper đóng vai trò quan trọng trong Kafka bằng cách quản lý đăng ký broker và bầu chọn controller của Kafka, thành phần xử lý các tác vụ quản trị cho cụm. ZooKeeper tự chạy như một cụm gọi là ensemble, nơi nhiều tiến trình phối hợp để đảm bảo chỉ một broker tại một thời điểm được chỉ định làm controller.
Nếu controller hiện tại gặp sự cố, ZooKeeper nhanh chóng bầu một broker mới tiếp quản. Dù ZooKeeper từng là phần thiết yếu của kiến trúc Kafka, Kafka đang chuyển sang chế độ KRaft mới loại bỏ nhu cầu dùng ZooKeeper. ZooKeeper là một dự án mã nguồn mở độc lập và không phải thành phần gốc của Kafka.
Producer
Producer Kafka là một ứng dụng client hoạt động như nguồn dữ liệu cho Kafka, xuất bản bản ghi vào một hoặc nhiều topic Kafka qua kết nối TCP bền vững tới các broker.
Nhiều producer có thể đồng thời gửi bản ghi đến cùng một topic. Các topic Kafka là chỉ-ghi, nghĩa là producer có thể ghi dữ liệu mới, nhưng cả producer lẫn consumer không thể sửa hay xóa bản ghi hiện có, đảm bảo tính bất biến dữ liệu.
Consumer
Consumer Kafka là ứng dụng client đăng ký một hoặc nhiều topic để tiêu thụ luồng bản ghi. Consumer thường làm việc theo nhóm, trong đó tải đọc và xử lý bản ghi được phân phối qua nhiều consumer.
Mỗi consumer theo dõi tiến độ của mình qua luồng bằng cách duy trì offset, đảm bảo không xử lý trùng lặp dữ liệu và không mất các bản ghi chưa xử lý. Consumer Kafka là bước cuối của pipeline dữ liệu, nơi bản ghi được xử lý hoặc chuyển tiếp đến hệ thống hạ nguồn.
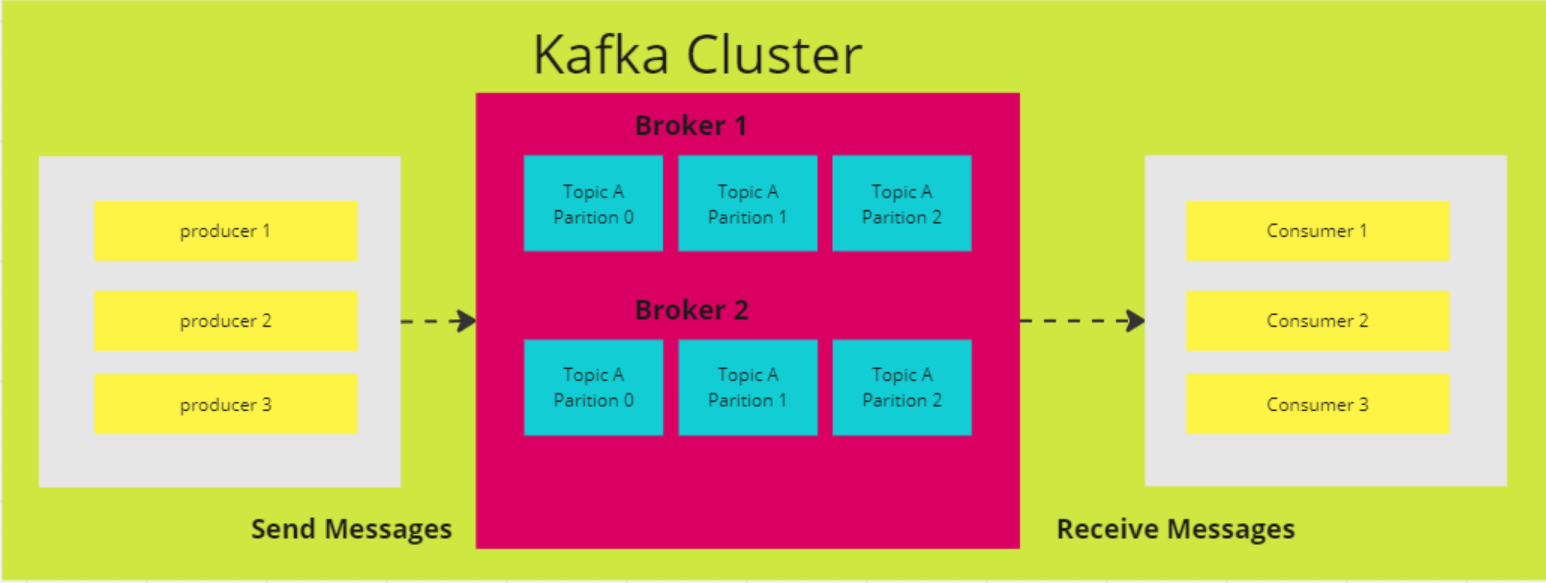
Sơ đồ kiến trúc Apache Kafka (Hình do Tác giả cung cấp)
8. Mục đích chính của log compaction trong Kafka là gì? Log compaction ảnh hưởng thế nào đến hiệu năng của consumer Kafka?
Mục tiêu chính của log compaction trong Kafka là giữ lại giá trị mới nhất cho mỗi khóa duy nhất trong log của topic, đảm bảo trạng thái cập nhật nhất của dữ liệu được bảo tồn và giảm sử dụng lưu trữ. Nhờ vậy consumer có thể truy cập giá trị hiện tại hiệu quả hơn mà không phải xử lý các bản trùng lặp cũ.
Khác với chính sách giữ lại truyền thống của Kafka vốn xóa tin nhắn sau một khoảng thời gian, log compaction chỉ xóa các bản ghi cũ theo từng khóa, giữ lại giá trị mới nhất của khóa đó. Tính năng này giúp consumer luôn có trạng thái hiện tại, đồng thời duy trì log gọn nhẹ hơn để tiết kiệm lưu trữ và tra cứu nhanh hơn.
9. Sự khác nhau giữa Phân vùng (Partition) và Bản sao (Replica) trong cụm Kafka là gì?
Phân vùng và bản sao là các thành phần chính trong kiến trúc Kafka, đảm bảo cả hiệu năng lẫn khả năng chịu lỗi. Phân vùng tăng thông lượng bằng cách cho phép một topic được chia thành nhiều phần, cho phép consumer đọc từ các phân vùng khác nhau song song, từ đó cải thiện khả năng mở rộng và hiệu quả của Kafka.
Bản sao mang lại tính dư thừa bằng việc tạo các bản sao của phân vùng trên nhiều broker. Điều này đảm bảo chịu lỗi vì khi broker lãnh đạo (quản lý thao tác đọc/ghi cho một phân vùng) gặp sự cố, một trong các bản sao theo sau có thể được thăng làm lãnh đạo mới.
Kafka duy trì nhiều bản sao cho mỗi phân vùng để đảm bảo tính sẵn sàng cao và độ bền dữ liệu, giảm thiểu rủi ro mất dữ liệu khi xảy ra sự cố, dù độ bền toàn phần còn phụ thuộc vào cấu hình sao chép.
10. Schema trong Kafka là gì và vì sao quan trọng đối với hệ thống phân tán?
Trong Kafka, schema định nghĩa cấu trúc và định dạng dữ liệu, chẳng hạn các trường như CustomerID (số nguyên), CustomerName (chuỗi), và Designation (chuỗi).
Trong các hệ thống phân tán như Kafka, producer và consumer phải thống nhất về định dạng dữ liệu để tránh lỗi khi trao đổi dữ liệu. Kafka Schema Registry quản lý và cưỡng chế các schema này, đảm bảo cả producer và consumer sử dụng các phiên bản tương thích.
Schema Registry lưu trữ schema (thường ở các định dạng như Avro, Protobuf, hoặc JSON Schema) và hỗ trợ tiến hóa schema, cho phép thay đổi định dạng dữ liệu mà không làm hỏng consumer hiện hữu. Điều này đảm bảo trao đổi dữ liệu trơn tru và độ tin cậy hệ thống khi schema phát triển.
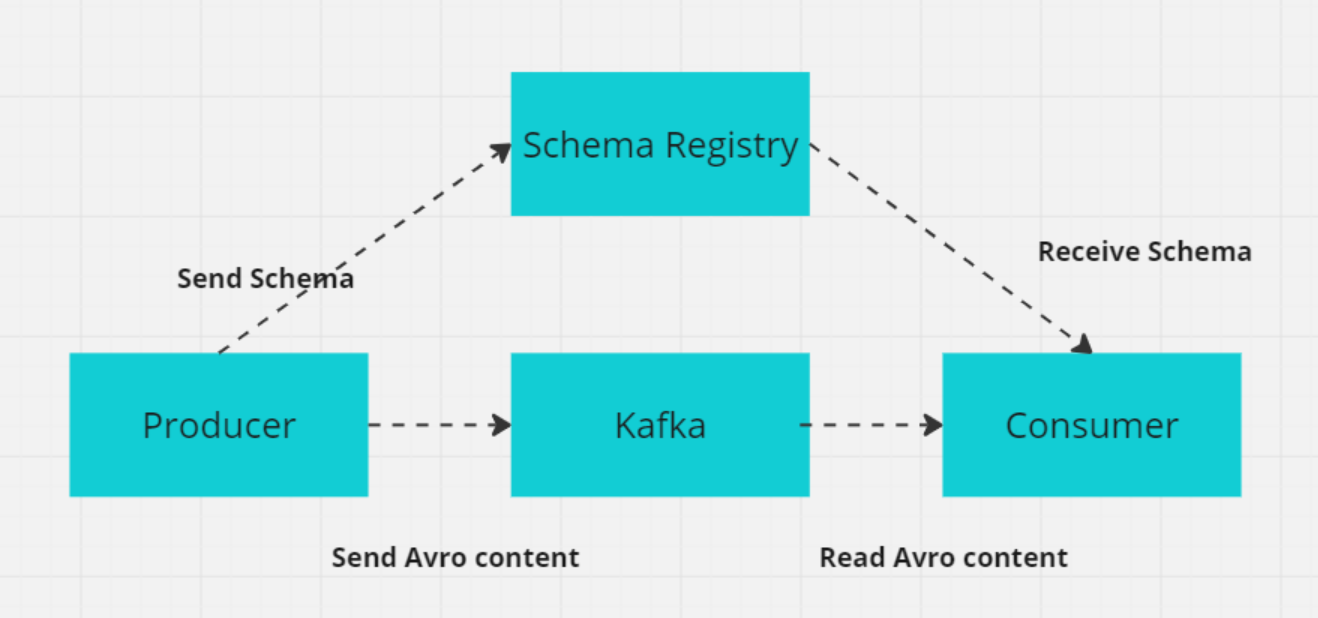
Schema Registry hoạt động với producer/consumer như thế nào (Hình do Tác giả cung cấp)
Câu hỏi phỏng vấn Kafka nâng cao
Với những người dùng Kafka nâng cao hơn, các câu hỏi phỏng vấn bạn gặp có thể thiên về kỹ thuật nhiều hơn.
11. Kafka đảm bảo tránh mất tin nhắn như thế nào?
Kafka sử dụng nhiều cơ chế để ngăn mất tin nhắn và đảm bảo phân phối đáng tin cậy:
- Commit offset thủ công: Consumer có thể tắt commit offset tự động và chủ động commit offset sau khi xử lý thành công tin nhắn để tránh mất các tin chưa xử lý khi consumer gặp sự cố.
- Xác nhận của producer (
acks=all): Thiết lậpacks=allở producer đảm bảo tin nhắn được tất cả replica đồng bộ xác nhận trước khi coi là ghi thành công, giảm rủi ro mất tin khi broker hỏng. - Sao chép (
min.insync.replicasvàreplication.factor): Kafka sao chép dữ liệu của mỗi phân vùng trên nhiều broker. Hệ số sao chép lớn hơn 1 đảm bảo chịu lỗi, giúp dữ liệu vẫn sẵn có ngay cả khi một broker hỏng. Thiết lậpmin.insync.replicasđảm bảo tối thiểu số replica phải xác nhận một tin trước khi ghi, tăng độ bền dữ liệu. Ví dụ, với hệ số sao chép là 3, nếu một broker ngừng hoạt động, dữ liệu vẫn có trên hai broker còn lại. - Retry ở producer: Cấu hình số lần retry cao đảm bảo producer sẽ gửi lại tin khi xảy ra lỗi thoáng qua. Kết hợp với cấu hình cẩn trọng như
max.in.flight.requests.per.connection=1, điều này giảm nguy cơ đảo thứ tự tin và đảm bảo tin nhắn cuối cùng sẽ được gửi mà không bị mất.
12. Kafka khác RabbitMq như thế nào?
Kafka và RabbitMQ là hai hệ thống nhắn tin phổ biến và khác nhau về kiến trúc lẫn cách sử dụng. Dưới đây là so sánh ở các khía cạnh chính:
1. Mục đích sử dụng và thiết kế
Kafka được thiết kế để xử lý các luồng dữ liệu quy mô lớn và pipeline thời gian thực, tối ưu cho thông lượng cao và độ trễ thấp. Kiến trúc dựa trên log đảm bảo độ bền và cho phép xử lý lại dữ liệu, lý tưởng cho các trường hợp như event sourcing và xử lý luồng.
RabbitMQ là bộ môi giới tin nhắn đa dụng hỗ trợ định tuyến phức tạp và thường dùng để nhắn tin giữa các vi dịch vụ hoặc phân phối tác vụ giữa các worker. Nó vượt trội trong bối cảnh cần phân phối tin nhắn đáng tin cậy, linh hoạt định tuyến và tương tác giữa các dịch vụ.
2. Kiến trúc
Kafka phân loại tin nhắn vào các topic, được chia thành phân vùng. Mỗi phân vùng có thể được xử lý bởi nhiều consumer, cho phép xử lý song song và mở rộng. Dữ liệu được lưu trên đĩa với thời gian lưu trữ có thể cấu hình, đảm bảo độ bền và cho phép xử lý lại khi cần.
RabbitMQ gửi tin nhắn vào các hàng đợi (queue), nơi chúng được tiêu thụ bởi một hoặc nhiều consumer. Nó đảm bảo phân phối đáng tin cậy qua cơ chế xác nhận, retry và dead-letter exchange để xử lý tin nhắn lỗi. Kiến trúc này tập trung vào tính toàn vẹn và linh hoạt định tuyến tin nhắn.
3. Hiệu năng và khả năng mở rộng
Kafka được xây dựng để mở rộng theo chiều ngang bằng cách thêm broker và phân vùng, cho phép xử lý hàng triệu tin nhắn mỗi giây. Kiến trúc của nó hỗ trợ xử lý song song và thông lượng cao, rất phù hợp cho phát trực tuyến dữ liệu quy mô lớn.
RabbitMQ có thể mở rộng, nhưng không hiệu quả bằng Kafka khi xử lý khối lượng dữ liệu rất lớn. Nó phù hợp cho các kịch bản thông lượng từ trung bình đến cao, nhưng không tối ưu cho thông lượng cực lớn như Kafka trong các ứng dụng phát trực tuyến quy mô lớn.
Tóm tắt: Cả Kafka và RabbitMQ đều là công cụ nhắn tin mạnh, nhưng tỏa sáng ở các trường hợp sử dụng khác nhau. Kafka lý tưởng cho phát trực tuyến dữ liệu thời gian thực, thông lượng cao và ứng dụng event sourcing nơi cần xử lý song song ở quy mô lớn.
RabbitMQ phù hợp với phân phối tin nhắn đáng tin cậy, phân phối tác vụ trong kiến trúc vi dịch vụ và định tuyến tin nhắn phức tạp. Nó vượt trội trong các tình huống cần tách rời giữa các dịch vụ, xử lý bất đồng bộ và độ tin cậy.
13. Kafka hỗ trợ phát triển ứng dụng dựa trên vi dịch vụ như thế nào?
Apache Kafka là công cụ giá trị cho kiến trúc vi dịch vụ nhờ khả năng xử lý dữ liệu thời gian thực, giao tiếp hướng sự kiện và nhắn tin đáng tin cậy. Cách Kafka hỗ trợ phát triển vi dịch vụ:
1. Kiến trúc hướng sự kiện
- Tách rời dịch vụ: Kafka cho phép các dịch vụ giao tiếp qua sự kiện thay vì gọi trực tiếp, giảm phụ thuộc giữa chúng. Nhờ tách rời, dịch vụ có thể phát và tiêu thụ sự kiện độc lập, đơn giản hóa việc tiến hóa và bảo trì.
- Xử lý bất đồng bộ: Dịch vụ có thể xuất bản sự kiện và tiếp tục xử lý mà không chờ dịch vụ khác phản hồi, cải thiện khả năng đáp ứng và hiệu quả.
2. Khả năng mở rộng
- Mở rộng theo chiều ngang: Kafka xử lý khối lượng dữ liệu lớn bằng cách phân phối tải qua nhiều broker và phân vùng. Mỗi phân vùng có thể được xử lý bởi instance consumer khác nhau, cho phép hệ thống mở rộng theo chiều ngang.
- Tiêu thụ song song: Nhiều consumer có thể đọc từ các phân vùng khác nhau đồng thời, tăng thông lượng và hiệu năng.
3. Độ tin cậy và chịu lỗi
- Sao chép dữ liệu: Kafka sao chép dữ liệu qua nhiều broker, đảm bảo tính sẵn sàng cao và chịu lỗi. Nếu một broker hỏng, broker khác có thể tiếp quản với dữ liệu đã sao chép. Kafka lưu dữ liệu trên đĩa với thời gian lưu trữ có thể cấu hình, đảm bảo sự kiện không bị mất và có thể xử lý lại khi cần.
4. Tích hợp dữ liệu
- Trung tâm dữ liệu: Kafka đóng vai trò trung tâm luồng dữ liệu trong kiến trúc vi dịch vụ, tạo điều kiện tích hợp giữa nhiều nguồn và đích dữ liệu. Điều này đơn giản hóa việc duy trì tính nhất quán dữ liệu giữa các dịch vụ.
- Kafka Connect: Kafka Connect cung cấp các connector để tích hợp Kafka với nhiều cơ sở dữ liệu, kho khóa-giá trị, chỉ mục tìm kiếm và hệ thống khác, giúp luân chuyển dữ liệu giữa vi dịch vụ và hệ thống bên ngoài thuận tiện.
14. Kafka Zookeeper là gì và hoạt động ra sao?
Apache ZooKeeper là dịch vụ mã nguồn mở giúp điều phối và quản lý dữ liệu cấu hình, đồng bộ hóa và dịch vụ nhóm trong hệ thống phân tán. Ở các phiên bản Kafka cũ, ZooKeeper đóng vai trò then chốt trong quản lý metadata, bầu chọn lãnh đạo và điều phối broker.
Tuy nhiên, kể từ phiên bản 2.8, Kafka đang chuyển sang chế độ KRaft loại bỏ nhu cầu dùng ZooKeeper. ZooKeeper hiện được coi là lỗi thời và sẽ bị loại bỏ trong bản phát hành 4.0 dự kiến năm 2024.
ZooKeeper lưu dữ liệu theo cấu trúc phân cấp của các nút gọi là "znode", mỗi znode có thể lưu metadata và có znode con, tương tự hệ thống tệp. Cấu trúc này rất quan trọng để duy trì metadata liên quan đến broker, topic và phân vùng của Kafka. Cơ chế đa số (quorum) của ZooKeeper đảm bảo tính nhất quán: phần lớn nút phải đồng ý cho mọi thay đổi, giúp ZooKeeper rất đáng tin cậy và chịu lỗi tốt.
Trong các phiên bản Kafka cũ, ZooKeeper được dùng cho nhiều chức năng quan trọng:
- Bầu chọn lãnh đạo: ZooKeeper bầu một nút controller, quản lý việc gán lãnh đạo phân vùng và các tác vụ ở cấp cụm.
- Quản lý metadata broker: Duy trì sổ đăng ký tập trung về các broker đang hoạt động và trạng thái của chúng.
- Phân công lại phân vùng: Hỗ trợ quản lý cân bằng lại phân vùng giữa các broker khi có sự cố hoặc mở rộng cụm.
Giao thức ZAB (ZooKeeper Atomic Broadcast) của ZooKeeper đảm bảo nhất quán giữa các nút ngay cả khi mạng bị phân mảnh, giúp Kafka chịu lỗi tốt. Tính nhất quán và độ tin cậy này khiến ZooKeeper quan trọng cho việc quản lý bản chất phân tán của Kafka, dù trong tương lai kiến trúc Kafka sẽ ít phụ thuộc vào ZooKeeper khi KRaft trở thành chế độ mặc định.
15. Làm thế nào để giảm sử dụng đĩa trong Kafka?
Kafka cung cấp nhiều cách để giảm hiệu quả dung lượng đĩa. Dưới đây là các chiến lược chính:
1. Điều chỉnh cài đặt giữ log
Sửa chính sách giữ log để giảm thời gian tin nhắn được lưu trên đĩa. Có thể thực hiện bằng cách điều chỉnh retention.ms (giữ theo thời gian) hoặc retention.bytes (giữ theo kích thước) nhằm giới hạn thời gian hoặc lượng dữ liệu Kafka lưu trước khi xóa tin cũ.
2. Triển khai log compaction
Dùng log compaction để chỉ giữ tin nhắn mới nhất cho mỗi khóa duy nhất, loại bỏ dữ liệu lỗi thời hoặc dư thừa. Điều này đặc biệt hữu ích khi chỉ trạng thái mới nhất là quan trọng, giúp giảm dung lượng đĩa mà không mất thông tin cần thiết.
3. Cấu hình chính sách dọn dẹp
Thiết lập chính sách dọn dẹp phù hợp với trường hợp sử dụng. Bạn có thể cấu hình cả giữ theo thời gian (retention.ms) và theo kích thước (retention.bytes) để tự động xóa tin cũ và quản lý dấu chân đĩa của Kafka.
4. Nén tin nhắn
Bật nén tin nhắn ở phía producer bằng các định dạng như GZIP, Snappy hoặc LZ4. Nén giảm kích thước tin nhắn, dẫn đến tiêu thụ đĩa thấp hơn. Tuy nhiên, cần cân nhắc đánh đổi giữa giảm dung lượng và tăng tải CPU do nén/giải nén.
5. Điều chỉnh kích thước phân đoạn log
Cấu hình kích thước phân đoạn log (segment.bytes) để kiểm soát tần suất cuộn phân đoạn. Phân đoạn nhỏ hơn cho phép cuộn log thường xuyên hơn, hỗ trợ sử dụng đĩa hiệu quả nhờ xóa nhanh dữ liệu cũ.
6. Xóa topic hoặc phân vùng không cần thiết
Định kỳ rà soát và xóa các topic, phân vùng không sử dụng. Điều này giải phóng dung lượng đĩa và giúp kiểm soát mức sử dụng đĩa của Kafka.
Câu hỏi phỏng vấn Kafka cho Kỹ sư Dữ liệu
Nếu bạn đang phỏng vấn cho vị trí kỹ sư dữ liệu, bạn có thể muốn chuẩn bị cho các câu hỏi Kafka sau.
16. Khác biệt giữa replica lãnh đạo (leader) và replica theo sau (follower) trong Kafka là gì?
Replica lãnh đạo
Leader replica xử lý tất cả yêu cầu đọc và ghi từ client. Nó quản lý trạng thái của phân vùng và là điểm tương tác chính cho producer và consumer. Nếu leader gặp sự cố, vai trò của nó sẽ được chuyển cho một follower để duy trì tính sẵn sàng.
Replica theo sau
Follower replica sao chép dữ liệu từ leader nhưng không trực tiếp xử lý yêu cầu của client. Vai trò của nó là đảm bảo chịu lỗi bằng cách giữ bản sao cập nhật của dữ liệu phân vùng. Từ Kafka 2.4, trong một số điều kiện, follower cũng có thể xử lý yêu cầu đọc để phân tán tải và cải thiện thông lượng đọc. Nếu leader gặp sự cố, một follower sẽ được bầu làm leader mới để duy trì tính nhất quán và sẵn sàng dữ liệu.
17. Vì sao chúng ta sử dụng cụm (cluster) trong Kafka và lợi ích của chúng là gì?
Một cụm Kafka gồm nhiều broker phân phối dữ liệu qua nhiều instance, cho phép mở rộng mà không cần downtime. Các cụm này được thiết kế để giảm thiểu độ trễ, và nếu cụm chính gặp sự cố, các cụm Kafka khác có thể tiếp quản để duy trì liên tục dịch vụ.
Kiến trúc cụm Kafka gồm Topic, Broker, Producer và Consumer. Nó quản lý hiệu quả các luồng dữ liệu, lý tưởng cho ứng dụng dữ liệu lớn và phát triển ứng dụng hướng dữ liệu.
18. Kafka đảm bảo thứ tự tin nhắn như thế nào?
Kafka đảm bảo thứ tự tin nhắn theo hai cách chính:
- Dùng khóa tin nhắn: Khi một tin có khóa, tất cả tin có cùng khóa được gửi đến cùng một phân vùng. Điều này đảm bảo tin có cùng khóa được xử lý theo thứ tự nhận, vì Kafka giữ thứ tự trong mỗi phân vùng.
- Consumer xử lý đơn luồng: Để duy trì thứ tự, consumer nên xử lý tin từ một phân vùng bằng một luồng đơn. Nếu dùng nhiều luồng, hãy thiết lập hàng đợi trong bộ nhớ riêng cho từng phân vùng để đảm bảo tin được xử lý đúng thứ tự khi xử lý đồng thời.
19. ISR và AR trong Kafka đại diện cho gì? ISR mở rộng nghĩa là gì?
ISR (in-sync replicas)
ISR là các replica đồng bộ hoàn toàn với leader. Những replica này có dữ liệu mới nhất và được coi là đáng tin cậy cho cả hoạt động đọc và ghi.
AR (assigned replicas)
AR bao gồm tất cả replica được gán cho một phân vùng, cả đồng bộ và không đồng bộ. Nó đại diện cho toàn bộ tập replica của phân vùng.
Mở rộng ISR
Mở rộng ISR xảy ra khi replica mới bắt kịp leader và được thêm vào danh sách ISR. Điều này tăng số replica cập nhật, cải thiện chịu lỗi và độ tin cậy.
20. Kịch bản sử dụng zero-copy trong Kafka là gì?
Kafka dùng zero-copy để truyền hiệu quả lượng dữ liệu lớn giữa producer và consumer. Nó tận dụng phương thức FileChannel.transferTo để chuyển dữ liệu trực tiếp từ hệ thống tệp đến socket mạng mà không cần sao chép bổ sung, cải thiện hiệu năng và thông lượng.
Kỹ thuật này sử dụng tệp ánh xạ bộ nhớ (mmap) để đọc các tệp chỉ mục, cho phép bộ đệm dữ liệu được chia sẻ giữa không gian người dùng và kernel, càng giảm nhu cầu sao chép dữ liệu. Điều này giúp Kafka phù hợp để xử lý hiệu quả các luồng dữ liệu thời gian thực quy mô lớn.
Chuẩn bị cho buổi phỏng vấn Kafka của bạn
Khi chuẩn bị cho một buổi phỏng vấn kỹ thuật dữ liệu tập trung vào Kafka, điều quan trọng là có nền tảng kỹ thuật vững và hiểu rõ Kafka tích hợp vào các hệ thống hiện đại như thế nào. Kafka là trung tâm của nhiều nền tảng dữ liệu thời gian thực, vì vậy nhà tuyển dụng sẽ kỳ vọng bạn nắm được cả kiến thức cơ bản lẫn cách Kafka vận hành trong môi trường có thể mở rộng và chịu lỗi.
Các mảng trọng tâm
Như chúng ta đã thấy qua các câu hỏi phỏng vấn Kafka ở trên, có một số mảng chính bạn cần ôn luyện:
- Kiến trúc: Tự tin khi thảo luận kiến trúc Kafka, gồm broker, phân vùng và tương tác giữa producer với consumer. Bạn cũng nên giải thích các đảm bảo phân phối tin của Kafka—như "ít nhất một lần" hoặc "chính xác một lần"—và cách Kafka đảm bảo thứ tự tin qua các tính năng như In-Sync Replicas (ISR).
- Tích hợp: Hiểu Kafka tích hợp với hệ thống khác qua công cụ như Kafka Connect, vốn kết nối cơ sở dữ liệu, kho khóa-giá trị và hệ thống khác. Nhà tuyển dụng có thể hỏi vai trò của Kafka trong việc duy trì tính nhất quán dữ liệu trong vi dịch vụ hoặc hệ thống phân tán.
- Giám sát và xử lý sự cố: Quen thuộc với công cụ giám sát như Kafka Manager và Prometheus là quan trọng. Bạn cần thể hiện khả năng quản trị và tối ưu cụm Kafka hiệu quả.
- Giải quyết vấn đề: Sẵn sàng thiết kế giải pháp nhắn tin để giải quyết thách thức thực tế, như xử lý luồng dữ liệu lớn hoặc đảm bảo độ tin cậy tin nhắn. Nhà tuyển dụng có thể đưa ra tình huống giả định để bạn xử lý sự cố hoặc tối ưu hiệu năng Kafka.
- Giao tiếp: Kafka phức tạp, vì vậy bạn phải có khả năng giải thích rõ ràng quyết định thiết kế hoặc bước xử lý sự cố, dù với đội ngũ kỹ thuật hay bên liên quan kinh doanh. Kỹ năng giao tiếp tốt sẽ là lợi thế.
- Kinh nghiệm thực hành: Nêu bật bất kỳ kinh nghiệm thực tiễn nào, như thiết lập cụm Kafka, quản lý giữ dữ liệu, hoặc tích hợp Kafka với công cụ khác. Kiến thức thực tế rất được đánh giá cao.
- Học hỏi liên tục: Cập nhật các tính năng mới và thực tiễn tốt nhất của Kafka. Đọc tài liệu hoặc đóng góp cho dự án mã nguồn mở thể hiện cam kết học tập lâu dài.
Mẹo phỏng vấn
Dưới đây là một số mẹo hàng đầu để bạn đạt kết quả tốt trong buổi phỏng vấn:
- Tìm hiểu về công ty, ngành và lý lịch người phỏng vấn.
- Chuẩn bị cho các vòng phỏng vấn khác nhau (kỹ thuật, nhân sự, qua điện thoại và trực tiếp) với cách tiếp cận phù hợp.
- Thường xuyên xem lại tài nguyên kỹ thuật như:
Bằng cách trau dồi những kỹ năng này và chuẩn bị hiệu quả, bạn sẽ sẵn sàng cho các buổi phỏng vấn liên quan đến Kafka. Hãy nhớ, nhà tuyển dụng tìm kiếm không chỉ chuyên môn kỹ thuật mà còn khả năng giao tiếp rõ ràng và kỹ năng giải quyết vấn đề thực tế. Thể hiện niềm đam mê kỹ thuật dữ liệu của bạn trong suốt quá trình phỏng vấn.