Verinin nasıl aktığını anlamak ve potansiyelinden yararlanmak, modern kurumlar için son derece kritik hale geldi. Kafka, modern uygulama dünyasında gerçek zamanlı veri akışlarını alma, depolama ve işleme konusunda lider bir platformdur.
Bu yazıda, bazı Kafka mülakat sorularını ana hatlarıyla ele alacak ve aracın veri işleme konusundaki kritik rolünü inceleyeceğiz. Temelden ileri seviyeye kadar farklı zorluk derecelerinde sorulara değinecek ve etkili şekilde hazırlanmanıza yardımcı olacak ipuçları sunacağız. Kafka’ya yeniyseniz, Apache Kafka’ya Giriş kursumuza mutlaka göz atın.
Temel Kafka Mülakat Soruları
Bu sorular, Kafka’yı bir veri mühendisliği aracı olarak temel düzeyde anladığınızı ölçer.
1. Apache Kafka nedir?
Apache Kafka, güçlü, açık kaynaklı, dağıtık bir olay akış platformudur. Başlangıçta LinkedIn tarafından bir mesaj kuyruğu olarak geliştirilen Kafka, çeşitli senaryolarda veri akışlarını yönetmek için kullanılan bir araca evrilmiştir.
Kafka’nın dağıtık sistem mimarisi yatay ölçeklenebilirlik sağlar; bu sayede tüketiciler mesajları kendi hızlarında alabilir ve kümeye Kafka düğümleri (sunucular) kolayca eklenebilir.
Kafka, büyük miktarda veriyi düşük gecikme ile hızlıca işlemek üzere tasarlanmıştır. Scala ve Java ile yazılmış olsa da geniş bir programlama dili yelpazesini destekler.
Apache Kafka, dağıtık bir günlük toplayıcı gibi davranır; günlük mesajları, yalnızca ekleme yapılan bir günlük dosyasında anahtar-değer çiftleri olarak dayanıklı, uzun süreli depolama ve erişim için saklanır. Tüketildikten sonra mesajları silen RabbitMQ gibi geleneksel mesaj kuyruklarının aksine, Kafka mesajları yapılandırılabilir bir süre boyunca tutar; bu da veri tekrar oynatma veya olay kaynaklı mimari gibi kullanım senaryoları için idealdir.
RabbitMQ, mesajları uzun vadeli saklamadan gerçek zamanlı iletime odaklanırken; Kafka’nın saklama politikası daha karmaşık, veri odaklı uygulamaları destekler.
Kafka’nın yaygın kullanım alanları arasında uygulama izleme, günlük toplama ve mesajlaşma bulunur; ancak sorgulama ve indeksleme gibi geleneksel veritabanı özelliklerine sahip değildir. Gücü, gerçek zamanlı veri akışlarını yönetmesinde yatar ve bu da onu dağıtık sistemler ve gerçek zamanlı analitik için vazgeçilmez kılar.
2. Kafka’nın bazı özellikleri nelerdir?
Apache Kafka, gerçek zamanlı veri hatları ve akış uygulamaları kurmak için yaygın olarak kullanılan, açık kaynaklı, dağıtık bir akış platformudur. Şu özellikleri sunar:
1. Yüksek aktarım hızı
Kafka, çok büyük veri hacimlerini işleyebilir. Kaynak istemcilerden yüzlerce gigabaytı verimli şekilde okuyup yazacak biçimde tasarlanmıştır.
2. Dağıtık mimari
Apache Kafka, küme merkezli bir mimariye sahiptir ve Kafka sunucuları arasında mesaj bölümlemeyi doğal olarak destekler. Bu tasarım, bir tüketici makine kümesi genelinde dağıtık tüketimi mümkün kılar; her bölüm içinde mesaj sırasını korur. Ayrıca bir Kafka kümesi kesinti gerektirmeden esnek ve şeffaf şekilde ölçeklenebilir.
3. Çeşitli istemcileri destekleme
Apache Kafka, .NET, JAVA, PHP ve Python gibi farklı platformlardaki istemcilerin entegrasyonunu destekler.
4. Gerçek zamanlı mesajlar
Kafka, tüketiciler tarafından görülebilir olması gereken gerçek zamanlı mesajlar üretir; bu, karmaşık olay işleme sistemleri için önemlidir.
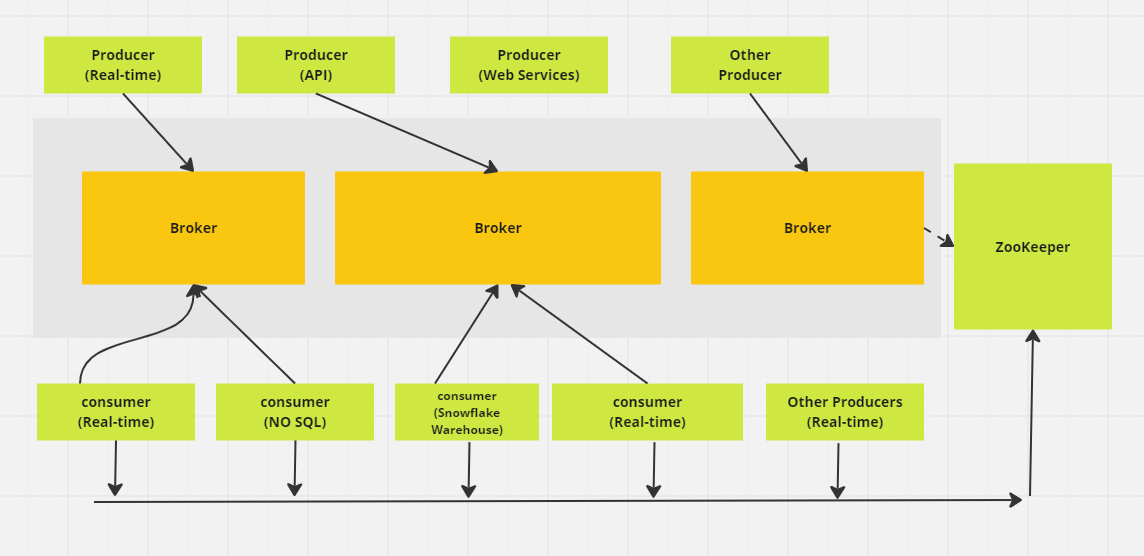
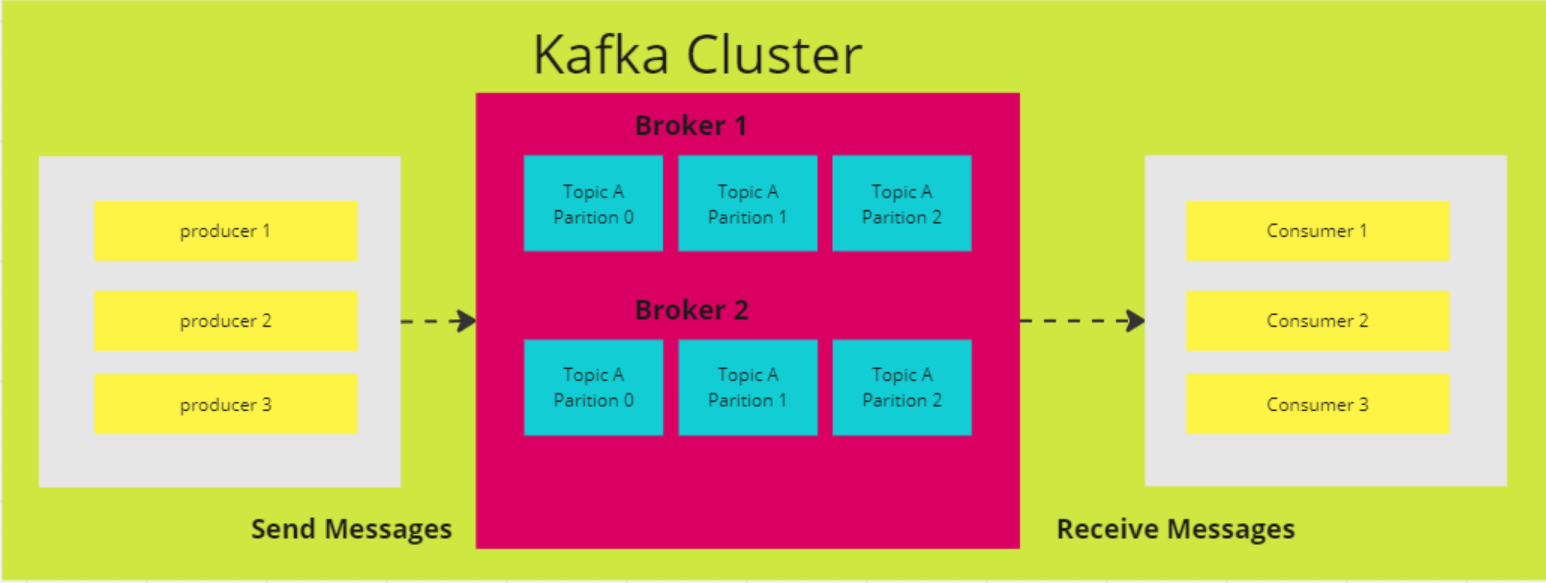
Apache Kafka Mesajlaşma Dağıtık sistemi. (Görsel: Yazar)
3. Kafka’da Bölümler (Partition) nasıl çalışır?
Kafka’da bir konu (topic), üreticilerden gelen tüm mesajların tutulduğu bir depolama alanıdır. Genellikle ilişkili veriler ayrı konularda saklanır. Örneğin, "transactions" adlı bir konu e-ticaret sitesindeki kullanıcı alışverişlerinin ayrıntılarını, "customers" adlı bir konu ise müşteri bilgilerini tutar.
Konular bölümlere ayrılır. Varsayılan olarak bir konunun bir bölümü vardır, ancak daha fazlası için yapılandırabilirsiniz. Mesajlar bu bölümlere dağıtılır; her bölümün kendi ofseti vardır ve Kafka kümesinde farklı bir sunucuda saklanır.
Örneğin, bir konu üç aracıyı (broker) kapsayan üç bölüme sahipse ve bir üretici 15 mesaj gönderirse, mesajlar sırayla dağıtılır:
- Kayıt 1, Bölüm 0’a gider
- Kayıt 2, Bölüm 1’e gider
- Kayıt 3, Bölüm 2’ye gider
Daha sonra döngü tekrarlanır; Kayıt 4 yeniden Bölüm 0’a gider ve bu şekilde devam eder.
4. Neden diğer mesajlaşma servisleri yerine Kafka’yı seçersiniz?
Kafka’yı diğer mesajlaşma servislerine tercih etmek çoğu zaman benzersiz güçlü yanlarına dayanır; özellikle yüksek aktarım hızı ve gerçek zamanlı veri işleme gerektiren kullanım durumlarında. Kafka’yı öne çıkaranlar şunlardır:
- Yüksek aktarım hızı ve ölçeklenebilirlik: Kafka, büyük veri hacimlerini verimli şekilde işleyebilir. Mimarisi yatay ölçeklemeyi destekler; performanstan ödün vermeden artan veri yüklerini yönetmek için daha fazla aracı ve bölüm ekleyebilirsiniz.
- Gerçek zamanlı işleme: Gerçek zamanlı veri akışı için mükemmeldir; etkinlik izleme ve operasyonel izleme gibi kullanım durumları için idealdir. Örneğin LinkedIn, tıklamalar ve beğeniler gibi kullanıcı etkileşimlerinin gerçek zamanlı akışlarını yayımlayan etkinlik izleme hattını yönetmek için Kafka’yı oluşturmuştur.
- Mesajları tekrar oynatma: Kafka, tüketicilerin mesajları tekrar oynatmasına izin verir; bu, bir tüketici hatayla karşılaşır veya aşırı yüklenirse faydalıdır. Böylece veri kaybı olmaz—tüketiciler toparlanıp kaçırdıkları mesajları tekrar işleyerek veri bütünlüğünü korur.
- Dayanıklılık ve hata toleransı: Araç, verileri birden fazla aracı arasında çoğaltır; bazı arızalar olsa bile güvenilirlik sağlar. Bu hata toleranslı tasarım, verileri erişilebilir tutar ve kritik operasyonlara güvence sağlar.
5. Apache Kafka’nın sunduğu tüm API’leri açıklayın.
API (Uygulama Programlama Arayüzü), farklı servisler, mikro servisler ve sistemler arasında iletişimi sağlar. Kafka, olay akış platformları kurmak ve mesajlaşma sistemiyle etkileşim kurmak için tasarlanmış bir API seti sunar.
Temel Kafka API’leri şunlardır:
- Producer API: Gerçek zamanlı veriyi Kafka konularına göndermek için kullanılır. Üreticiler, her mesajın bir konunun hangi bölümüne gideceğini belirler; geri çağrılar gönderme işlemlerinin başarı veya başarısızlığını ele alır.
- Consumer API: Kafka konularından gerçek zamanlı veri okumayı sağlar. Tüketiciler, yük dengeleme ve paralel işleme için bir tüketici grubunun parçası olabilir; konulara abone olur ve yeni mesajlar için Kafka’yı sürekli yoklar.
- Streams API: Kafka içinde veriyi dönüştüren, birleştiren ve analiz eden gerçek zamanlı uygulamalar geliştirmeyi destekler. Karmaşık akış işleme mantığını tanımlamak için üst düzey bir DSL (Etki Alanına Özgü Dil) sunar.
- Kafka Connect API: Kafka ile harici sistemler arasında veri alma ve verme için yeniden kullanılabilir bağlayıcılar oluşturup çalıştırmakta kullanılır.
- Admin API: Kafka konularını, aracıları ve diğer kaynakları yönetmek ve yapılandırmak için araçlar sağlar; sorunsuz işletim ve ölçeklenebilirliği güvence altına alır.
Bu API’ler, Kafka içinde kesintisiz veri üretimi, tüketimi, işlenmesi ve yönetimini mümkün kılar.
Orta Seviye Kafka Mülakat Soruları
Bu sorular, Kafka’nın kullanım alanlarına hâkim, daha deneyimli uygulayıcılara yöneliktir.
6. Bir Kafka konusundaki bölüm sayısını artırmanın sonuçları nelerdir?
Bir Kafka konusundaki bölüm (partition) sayısını artırmak, daha fazla tüketicinin paralel okumasına olanak tanıyarak eşzamanlılığı ve aktarım hızını artırabilir. Ancak bazı zorlukları da beraberinde getirir:
- Artan küme yükü: Daha fazla bölüm, ek küme kaynakları tüketir; çoğaltma için daha yüksek ağ trafiğine ve artan depolama gereksinimlerine yol açar.
- Olası veri dengesizliği: Bölüm sayısı arttıkça veriler eşit dağılmayabilir; bazı bölümler aşırı yüklenirken diğerleri atıl kalabilir.
- Daha karmaşık tüketici grubu yönetimi: Daha fazla bölümle, tüketici grubu atamalarını yönetmek ve ofsetleri izlemek daha karmaşık hale gelir.
- Daha uzun yeniden dengeleme süreleri: Tüketiciler katıldığında veya ayrıldığında, bölümlerin grup genelinde yeniden dengelenmesi daha uzun sürebilir ve genel sistem tepkiselliğini etkileyebilir.
7. Kafka mimarisinin dört bileşenini açıklayın
Kafka, birkaç temel bileşenden oluşan dağıtık bir mimaridir:
Aracı düğümleri
Kafka’nın dağıtık mimarisi, aracı düğümü de dâhil olmak üzere birkaç temel bileşenden oluşur. Aracılar, girdi/çıktı işlemlerinin ağır işini yürütür ve mesajların kalıcı depolanmasını yönetir. Üreticilerden verileri alır, depolar ve tüketicilere sunarlar. Her aracı, bir Kafka kümesinin parçasıdır ve koordinasyona yardımcı olan benzersiz bir kimliğe sahiptir.
Kafka’nın eski sürümlerinde küme, aracıların uygun koordinasyonunu sağlayan ve bölüm konumları gibi metaverileri izleyen Zookeeper ile yönetilir (Kafka bu iş için dahili KRaft moduna geçiş yapmaktadır). Kafka aracıları son derece ölçeklenebilirdir ve dağıtık sistemler genelinde mesajlar için yüksek hacimli okuma ve yazma isteklerini karşılayabilir.
ZooKeeper düğümleri
ZooKeeper, aracı kaydını yöneterek ve küme için yönetimsel işlemleri yürüten Kafka denetleyicisini seçerek Kafka’da kritik bir rol oynar. ZooKeeper, kendi içinde bir küme olarak (ensemble) çalışır; birden çok süreç, aynı anda yalnızca bir aracının denetleyici olarak atanmasını sağlamak için birlikte çalışır.
Geçerli denetleyici arızalanırsa ZooKeeper hızla yeni bir aracıyı görevlendirir. ZooKeeper, Kafka mimarisinin önemli bir parçası olmuş olsa da, Kafka, ZooKeeper gereksinimini ortadan kaldıran yeni KRaft moduna geçmektedir. ZooKeeper, bağımsız bir açık kaynak projedir ve yerleşik bir Kafka bileşeni değildir.
Üreticiler
Bir Kafka üreticisi, kalıcı TCP bağlantıları üzerinden aracılarına bir veya daha fazla Kafka konusuna kayıt yayımlayan, Kafka için veri kaynağı görevi gören bir istemci uygulamasıdır.
Birden fazla üretici aynı konuya eşzamanlı olarak kayıt gönderebilir. Kafka konuları yalnızca eklemeye açıktır; bu da üreticilerin yeni veri yazabileceği, ancak ne üreticilerin ne de tüketicilerin mevcut kayıtları değiştirebileceği veya silebileceği anlamına gelir; böylece veri değişmezliği sağlanır.
Tüketiciler
Bir Kafka tüketicisi, bir veya daha fazla Kafka konusuna abone olarak kayıt akışlarını tüketen bir istemci uygulamasıdır. Tüketiciler genellikle tüketici grupları hâlinde çalışır; okuma ve işleme yükü birden çok tüketici arasında dağıtılır.
Her tüketici, ofsetleri tutarak akıştaki ilerlemesini izler; böylece hiçbir verinin iki kez işlenmemesi ve işlenmemiş kayıtların kaybolmaması sağlanır. Kafka tüketicileri, kayıtların işlendiği veya aşağı akış sistemlerine iletildiği veri hattının son adımıdır.
Apache Kafka mimari diyagramı (Görsel: Yazar)
8. Kafka’da günlük sıkıştırmanın (log compaction) ana amacı nedir? Günlük sıkıştırma, Kafka tüketicilerinin performansını nasıl etkiler?
Kafka’da günlük sıkıştırmanın temel amacı, bir konunun günlüğünde her benzersiz anahtar için en güncel değeri koruyarak verinin en son durumunun muhafaza edilmesini sağlamak ve depolama kullanımını azaltmaktır. Böylece tüketiciler, eski yinelenen kayıtları işlemeye gerek kalmadan mevcut değere daha verimli şekilde erişebilir.
Kafka’nın belirli bir süre sonra mesajları silen geleneksel saklama politikasının aksine, günlük sıkıştırma her anahtar için yalnızca eski kayıtları siler ve o anahtarın en son değerini tutar. Bu özellik, tüketicilerin mevcut duruma her zaman erişebilmesini sağlarken, depolama verimliliğini artıran ve daha hızlı arama imkânı sağlayan sıkıştırılmış bir günlük sunar.
9. Bir Kafka kümesinde Bölümler (Partitions) ile Kopyalar (Replicas) arasındaki fark nedir?
Bölümler ve kopyalar, Kafka’nın mimarisinin performans ve hata toleransını sağlayan temel bileşenleridir. Bölümler, bir konunun birden çok parçaya ayrılmasına imkân tanıyarak aktarım hızını artırır; tüketicilerin farklı bölümlerden paralel okumasına olanak tanır ve Kafka’nın ölçeklenebilirliğini ve verimliliğini artırır.
Kopyalar ise, bölümlerin birden çok aracı üzerinde çoğaltılmasıyla yedeklilik sağlar. Bir lider aracı (bir bölüm için okuma ve yazma işlemlerini yöneten aracı) arızalanırsa takipçi kopyalardan biri yeni lider olarak görevi devralabilir.
Kafka, her bölümün birden çok kopyasını tutarak yüksek erişilebilirlik ve veri dayanıklılığı sağlar; arızalar sırasında veri kaybı riskini en aza indirir; ancak tam dayanıklılık, çoğaltma ayarlarına bağlıdır.
10. Kafka’da şema nedir ve dağıtık sistemler için neden önemlidir?
Kafka’da bir şema, CustomerID (tamsayı), CustomerName (dize) ve Designation (dize) gibi alanlar dâhil olmak üzere verinin yapısını ve biçimini tanımlar.
Kafka gibi dağıtık sistemlerde, üreticiler ve tüketiciler veri alışverişinde hata yaşamamak için veri formatı konusunda mutabık olmalıdır. Kafka Şema Sicili (Schema Registry), bu şemaları yönetir ve uygular; hem üreticilerin hem tüketicilerin uyumlu sürümler kullanmasını güvence altına alır.
Şema Sicili, şemaları (genellikle Avro, Protobuf veya JSON Schema biçimlerinde) depolar ve şema evrimini destekler; böylece veri formatları mevcut tüketicileri bozmadan değişebilir. Bu da şemalar evrimleşirken sorunsuz veri alışverişi ve sistem güvenilirliği sağlar.
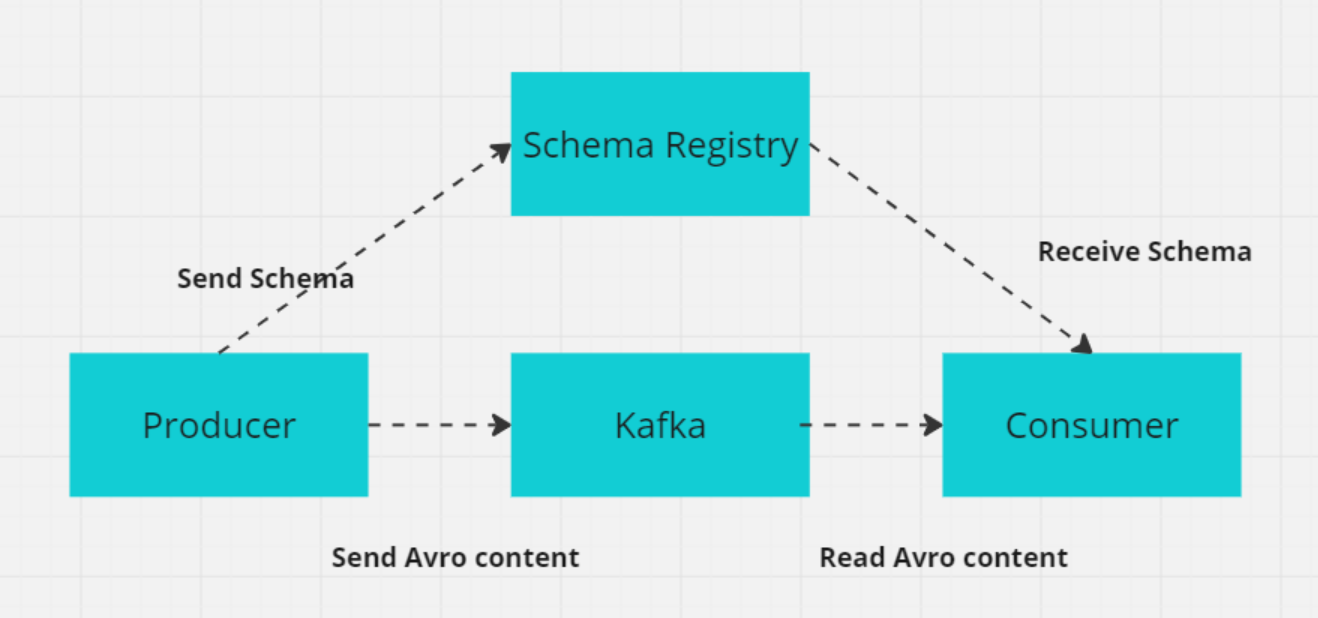
Şema sicili üretici/tüketici ile nasıl çalışır (Görsel: Yazar)
İleri Seviye Kafka Mülakat Soruları
Daha ileri düzey Kafka kullanıcıları için mülakat soruları genellikle daha teknik olacaktır.
11. Kafka mesaj kaybını nasıl önler?
Kafka, mesaj kaybını önlemek ve güvenilir mesaj teslimi sağlamak için birkaç mekanizma kullanır:
- Manuel ofset onayı: Tüketiciler, otomatik ofset onaylarını devre dışı bırakıp mesajları başarıyla işledikten sonra ofsetleri manuel olarak onaylayabilir; böylece bir tüketici çökmesi durumunda işlenmemiş mesajların kaybı önlenir.
- Üretici onayları (
acks=all): Üreticideacks=allayarı, mesajların başarıyla yazılmış sayılmadan önce eşzamanlı (in-sync) tüm kopyalar tarafından onaylanmasını sağlar; bu da bir aracı arızası durumunda mesaj kaybı riskini azaltır. - Çoğaltma (
min.insync.replicasvereplication.factor): Kafka, her bölümün verisini birden çok aracıya çoğaltır. 1’den büyük bir çoğaltma faktörü hata toleransı sağlar; bir aracı arızalansa bile verinin erişilebilir kalmasına imkân tanır.min.insync.replicasayarı, bir mesaj yazılmadan önce en az kaç kopyanın onu onaylaması gerektiğini belirleyerek veri dayanıklılığını artırır. Örneğin, çoğaltma faktörü 3 ise bir aracı devre dışı kalsa da veri diğer iki aracıda kullanılabilir. - Üretici yeniden denemeleri: Yeniden deneme sayısını yüksek bir değere ayarlamak, geçici bir hata oluştuğunda üreticilerin mesaj göndermeyi tekrar denemesini sağlar.
max.in.flight.requests.per.connection=1gibi dikkatli yapılandırmalarla birlikte kullanıldığında, mesajların yeniden sıralanma olasılığını azaltır ve mesajların kaybolmadan eninde sonunda teslim edilmesini güvenceye alır.
12. Kafka, RabbitMq’den nasıl farklıdır?
Kafka ve RabbitMQ, mimari ve kullanım açısından farklılaşan iki popüler mesajlaşma sistemidir. Temel alanlarda karşılaştırmaları şöyledir:
1. Kullanım ve tasarım
Kafka, büyük ölçekli veri akışlarını ve gerçek zamanlı hatları yönetmek üzere tasarlanmıştır; yüksek aktarım hızı ve düşük gecikme için optimize edilmiştir. Günlük (log) tabanlı mimarisi dayanıklılık sağlar ve verinin yeniden işlenmesine olanak tanır; bu da olay kaynaklı mimari ve akış işlemede idealdir.
RabbitMQ, karmaşık yönlendirmeyi destekleyen genel amaçlı bir mesaj aracısıdır; genellikle mikro servisler arasında mesajlaşma veya görevlerin çalışanlar arasında dağıtımı için kullanılır. Güvenilir mesaj teslimi, yönlendirme esnekliği ve servisler arası etkileşimin kritik olduğu ortamlarda öne çıkar.
2. Mimari
Kafka, mesajları konulara ayırır; konular bölümlere bölünür. Her bölüm birden çok tüketici tarafından işlenebilir; bu da paralel işlemeyi ve ölçeklemeyi mümkün kılar. Veriler, yapılandırılabilir bir saklama süresiyle diskte tutulur; dayanıklılık sağlar ve gerektiğinde mesajların yeniden işlenmesine izin verir.
RabbitMQ, mesajları kuyruklara gönderir; mesajlar bir veya daha fazla tüketici tarafından tüketilir. Mesaj onayları, yeniden denemeler ve başarısız mesajları işlemek için dead-letter değişimleriyle güvenilir teslimat sağlar. Bu mimari, mesaj bütünlüğüne ve yönlendirmede esnekliğe odaklanır.
3. Performans ve ölçeklenebilirlik
Kafka, daha fazla aracı ve bölüm ekleyerek yatay ölçeklenme için inşa edilmiştir; saniyede milyonlarca mesajı işleyebilir. Mimarisi, paralel işlemeyi ve yüksek aktarım hızını destekler; büyük ölçekli veri akışı için idealdir.
RabbitMQ da ölçeklenebilir; ancak çok büyük veri hacimleri söz konusu olduğunda Kafka kadar verimli değildir. Orta-yüksek aktarım senaryoları için uygundur; fakat büyük ölçekli akış uygulamalarında Kafka’nın ulaştığı uç değerler için optimize edilmemiştir.
Özet: Kafka ve RabbitMQ, mesajlaşma için güçlü araçlardır; ancak farklı kullanım durumlarında öne çıkarlar. Kafka, büyük ölçekli, paralel işlemenin gerektiği yüksek aktarım hızlı, gerçek zamanlı veri akışı ve olay kaynaklı uygulamalar için idealdir.
RabbitMQ ise güvenilir mesaj teslimi, mikro servis mimarilerinde görev dağıtımı ve karmaşık mesaj yönlendirme için uygundur. Servisler arası gevşek bağ, eşzamansız işleme ve güvenilirliğin gerektiği senaryolarda başarılıdır.
13. Kafka, mikro servis tabanlı uygulamaların geliştirilmesine nasıl yardımcı olur?
Apache Kafka, gerçek zamanlı veri işleme, olay güdümlü iletişim ve güvenilir mesajlaşma yetenekleri sayesinde mikro servis mimarileri kurmada değerli bir araçtır. Kafka’nın mikro servis geliştirmeyi destekleme yolları şunlardır:
1. Olay güdümlü mimari
- Servis ayrışması: Kafka, servislerin doğrudan çağrılar yerine olaylar üzerinden iletişim kurmasına izin vererek aralarındaki bağımlılıkları azaltır. Bu ayrışma, servislerin olay üretip tüketmesini bağımsız kılar; servislerin evrimini ve bakımını kolaylaştırır.
- Eşzamansız işleme: Servisler, olay yayımlayıp diğer servislerin yanıtını beklemeden işlemeye devam edebilir; bu da sistemin tepkiselliğini ve verimliliğini artırır.
2. Ölçeklenebilirlik
- Yatay ölçeklenebilirlik: Kafka, yükü birden fazla aracı ve bölüm arasında dağıtarak büyük veri hacimlerini yönetebilir. Her bölüm, farklı tüketici örnekleri tarafından işlenebilir; sistemin yatayda ölçeklenmesine olanak tanır.
- Paralel tüketim: Birden fazla tüketici, farklı bölümlerden eşzamanlı okuyabilir; aktarım hızını ve performansı artırır.
3. Güvenilirlik ve hata toleransı
- Veri çoğaltma: Kafka, verileri birden fazla aracıya çoğaltır; yüksek erişilebilirlik ve hata toleransı sağlar. Bir aracı arızalanırsa diğeri, çoğaltılmış verilerle devralabilir. Kafka, verileri yapılandırılabilir saklama süreleriyle diskte tutar; böylece olaylar kaybolmaz ve gerektiğinde yeniden işlenebilir.
4. Veri entegrasyonu
- Merkezi veri merkezi: Kafka, mikro servis mimarisi içinde veri akışı için merkezi bir merkez görevi görür; çeşitli veri kaynakları ve hedefleri arasında entegrasyonu kolaylaştırır. Bu, servisler arasında veri tutarlılığını sürdürmeyi basitleştirir.
- Kafka Connect: Kafka Connect, Kafka’yı çok sayıda veritabanı, anahtar-değer deposu, arama indeksi ve diğer sistemlerle entegre etmek için bağlayıcılar sunar; mikro servisler ile harici sistemler arasında veri taşınmasını sadeleştirir.
14. Kafka Zookeeper nedir ve nasıl çalışır?
Apache ZooKeeper, dağıtık sistemlerde yapılandırma verilerini yönetmeye, eşzamanlamaya ve grup servislerine yardımcı olan açık kaynaklı bir servistir. Kafka’nın eski sürümlerinde ZooKeeper, metaveri yönetimi, lider seçimi ve aracı koordinasyonunda kritik rol oynamıştır.
Bununla birlikte Kafka, 2.8 sürümünden beri ZooKeeper ihtiyacını ortadan kaldıran KRaft moduna geçiş yapmaktadır. ZooKeeper artık eskimiş kabul edilmekte ve 2024’te beklenen 4.0 sürümünde kaldırılacaktır.
ZooKeeper, "znode" adı verilen düğümlerin hiyerarşik yapısında veri depolar; her znode, metaveri tutabilir ve bir dosya sistemine benzer şekilde alt znode’lara sahip olabilir. Bu yapı, Kafka aracıları, konular ve bölümlerle ilgili metaverilerin korunması için önemlidir. ZooKeeper’ın çoğunluk (quorum) temelli mekanizması tutarlılık sağlar: Herhangi bir değişiklik için düğümlerin çoğunluğunun anlaşması gerekir; bu da ZooKeeper’ı son derece güvenilir ve hata toleranslı kılar.
Kafka’nın eski sürümlerinde ZooKeeper, birkaç kritik işlev için kullanılır:
- Lider seçimi: ZooKeeper, bölüm lideri atamalarını ve küme genelindeki diğer görevleri yöneten bir denetleyici düğüm seçer.
- Aracı metaveri yönetimi: Etkin aracıların ve durumlarının merkezi bir kaydını tutar.
- Bölüm yeniden atama: Arızalar veya küme genişletmeleri sırasında bölümlerin aracılar arasında yeniden dengelenmesini yönetmeye yardımcı olur.
ZooKeeper’ın ZAB (ZooKeeper Atomic Broadcast) protokolü, ağ bölünmeleri karşısında bile düğümler arasında tutarlılığı garanti eder; böylece Kafka hata toleransını korur. Bu tutarlılık ve güvenilirlik, Kafka’nın dağıtık doğasını yönetmede ZooKeeper’ı kritik kılmıştır; ancak KRaft varsayılan hâle geldikçe Kafka’nın gelecekteki mimarisi ZooKeeper’a daha az dayanacaktır.
15. Kafka’da disk kullanımını nasıl azaltabilirsiniz?
Kafka, disk kullanımını etkili biçimde azaltmanın çeşitli yollarını sunar. Başlıca stratejiler şunlardır:
1. Günlük saklama ayarlarını düzenleyin
Mesajların diskte ne kadar süre tutulacağını azaltmak için günlük saklama politikasını değiştirin. Bunu, Kafka’nın daha eski mesajları silmeden önce ne kadar süre veya ne kadar veri saklayacağını sınırlamak amacıyla retention.ms (zamana dayalı saklama) veya retention.bytes (boyuta dayalı saklama) ayarlarını düzenleyerek yapabilirsiniz.
2. Günlük sıkıştırmayı uygulayın
Her benzersiz anahtar için yalnızca en son mesajı tutmak ve eski veya yinelenen verileri kaldırmak için günlük sıkıştırmayı kullanın. Bu, yalnızca en güncel durumun önemli olduğu senaryolarda özellikle faydalıdır; önemli bilgileri kaybetmeden disk alanı kullanımını azaltır.
3. Temizlik politikalarını yapılandırın
Kullanım durumunuza göre etkili temizlik politikaları belirleyin. Eski mesajları otomatik olarak silmek ve Kafka’nın disk ayak izini yönetmek için hem zamana dayalı (retention.ms) hem boyuta dayalı (retention.bytes) saklama politikalarını yapılandırabilirsiniz.
4. Mesajları sıkıştırın
Üretici tarafında GZIP, Snappy veya LZ4 gibi biçimlerle mesaj sıkıştırmayı etkinleştirin. Sıkıştırma mesaj boyutunu küçültür; böylece disk alanı tüketimi azalır. Ancak sıkıştırma/açma işlemlerinin getirdiği CPU yükü ile disk kullanımındaki azalma arasındaki ödünleşimi dikkate almak önemlidir.
5. Günlük parça (segment) boyutunu ayarlayın
Kafka’nın günlük parça boyutunu (segment.bytes) yapılandırarak günlük parçalarının ne sıklıkla döndürüleceğini kontrol edin. Daha küçük parça boyutları, daha sık günlük döndürmeye olanak tanır; böylece daha eski verilerin daha hızlı silinmesini sağlayarak disk kullanımının daha verimli olmasına yardımcı olabilir.
6. Gereksiz konuları veya bölümleri silin
Kullanılmayan veya gereksiz konu ve bölümleri periyodik olarak gözden geçirip silin. Bu, disk alanını boşaltır ve Kafka’nın disk kullanımını kontrol altında tutmaya yardımcı olur.
Veri Mühendisleri için Kafka Mülakat Soruları
Bir veri mühendisi pozisyonu için mülakata giriyorsanız, aşağıdaki Kafka mülakat sorularına hazırlanmak isteyebilirsiniz.
16. Kafka’da lider kopya (leader replica) ile takipçi kopya (follower replica) arasındaki farklar nelerdir?
Lider kopya
Lider kopya, tüm istemci okuma ve yazma isteklerini karşılar. Bölümün durumunu yönetir ve üreticiler ile tüketiciler için birincil etkileşim noktasıdır. Lider arızalanırsa, erişilebilirliği sürdürmek için rolü takipçi kopyalardan birine devredilir.
Takipçi kopya
Takipçi kopya, veriyi liderden çoğaltır ancak istemci isteklerini doğrudan karşılamaz. Rolü, bölüm verisinin güncel bir kopyasını tutarak hata toleransı sağlamaktır. Kafka 2.4’ten itibaren belirli koşullar altında takipçi kopyalar, yükü dağıtmak ve okuma aktarım hızını artırmak için okuma isteklerini de karşılayabilir. Lider arızalanırsa bir takipçi, veri tutarlılığı ve erişilebilirliği korumak üzere yeni lider olarak seçilir.
17. Kafka’da neden kümeler kullanıyoruz ve faydaları nelerdir?
Bir Kafka kümesi, veriyi birden fazla örnek arasında dağıtan birden çok aracıdan oluşur; bu da kesinti olmadan ölçeklenebilirlik sağlar. Bu kümeler gecikmeleri en aza indirecek şekilde tasarlanmıştır ve birincil küme arızalanırsa hizmet sürekliliğini korumak için diğer Kafka kümeleri devralabilir.
Kafka kümesinin mimarisi; Konular, Aracılar, Üreticiler ve Tüketicileri içerir. Veri akışlarını verimli şekilde yönetir; bu da onu büyük veri uygulamaları ve veri odaklı uygulamaların geliştirilmesi için ideal kılar.
18. Kafka mesaj sıralamasını nasıl sağlar?
Kafka, mesaj sıralamasını iki ana yolla sağlar:
- Mesaj anahtarlarını kullanma: Bir mesaja anahtar atandığında, aynı anahtara sahip tüm mesajlar aynı bölüme gönderilir. Kafka, her bölüm içinde sıralamayı koruduğundan, aynı anahtara sahip mesajların alındıkları sırayla işlenmesi garanti edilir.
- Tek iş parçacıklı tüketici işleme: Sıralamayı korumak için tüketici, bir bölümden gelen mesajları tek bir iş parçacığında işlemelidir. Birden çok iş parçacığı kullanılıyorsa, eşzamanlı işleme sırasında mesajların doğru sırayla işlendiğinden emin olmak için her bölüm için ayrı bellek içi kuyruklar kurun.
19. Kafka’da ISR ve AR neyi temsil eder? ISR genişlemesi ne anlama gelir?
ISR (eşzamanlı kopyalar)
ISR, lider kopyayla tamamen senkronize olan kopyaları ifade eder. Bu kopyalar en güncel veriye sahiptir ve okuma-yazma işlemleri için güvenilirdir.
AR (atanmış kopyalar)
AR, bir bölüme atanmış tüm kopyaları, hem eşzamanlı hem eşzamanlı olmayan kopyaları içerir. Bir bölüm için kopyaların tam kümesini temsil eder.
ISR genişlemesi
ISR genişlemesi, yeni kopyalar lideri yakaladığında ve ISR listesine eklendiğinde gerçekleşir. Bu durum, güncel kopya sayısını artırır; hata toleransı ve güvenilirliği iyileştirir.
20. Kafka’da sıfır kopya (zero-copy) kullanım senaryosu nedir?
Kafka, üreticiler ve tüketiciler arasında büyük veri hacimlerini verimli şekilde aktarmak için sıfır kopya kullanır. Veriyi dosya sisteminden ağ soketlerine fazladan kopyalama yapmadan doğrudan taşımak için FileChannel.transferTo yönteminden yararlanır; bu da performansı ve aktarım hızını iyileştirir.
Bu teknik, indeks dosyalarını okumak için bellek eşlemeli dosyaları (mmap) kullanır; böylece veri arabelleklerinin kullanıcı alanı ve çekirdek alanı arasında paylaşılmasına olanak tanır ve ek veri kopyalama ihtiyacını daha da azaltır. Bu da Kafka’yı büyük ölçekli gerçek zamanlı veri akışlarını verimli şekilde yönetmeye son derece uygun kılar.
Kafka Mülakatına Hazırlık
Kafka odaklı bir veri mühendisliği mülakatına hazırlanırken, güçlü bir teknik temelinizin ve Kafka’nın modern sistemlere nasıl entegre olduğunu net şekilde anlamanızın olması kritik önem taşır. Kafka, birçok gerçek zamanlı veri platformunun merkezindedir; bu nedenle mülakatçıların hem temelleri hem de Kafka’nın ölçeklenebilir, hata toleranslı ortamlarda nasıl çalıştığını bilmenizi beklemesi olasıdır.
Odaklanılması gereken başlıca alanlar
Burada ele aldığımız Kafka mülakat soruları boyunca gördüğümüz gibi, tazelemeniz gereken birkaç temel alan vardır:
- Mimari: Kafka’nın aracıları, bölümleri ve üretici-tüketici etkileşimi dâhil mimarisini anlatmada kendinize güvenin. Ayrıca Kafka’nın "en az bir kez" veya "tam olarak bir kez" gibi mesaj teslimi garantilerini ve Eşzamanlı Kopyalar (ISR) gibi özelliklerle mesaj sıralamasını nasıl sağladığını da açıklayabilmelisiniz.
- Entegrasyon: Kafka’nın, veritabanları, anahtar-değer depoları ve diğer sistemlerle bağlantı kuran Kafka Connect gibi araçlarla diğer sistemlere nasıl entegre olduğunu anlayın. Mülakatçılar, Kafka’nın mikro servisler veya dağıtık sistemlerde veri tutarlılığını sağlamadaki rolü hakkında sorular yöneltebilir.
- İzleme ve sorun giderme: Kafka Manager ve Prometheus gibi izleme araçlarına aşina olmak önemlidir. Kafka kümelerini etkin biçimde yönetme ve optimize etme yeteneğinizi göstermeniz beklenir.
- Problem çözme: Büyük veri akışlarını yönetmek veya mesaj güvenilirliğini sağlamak gibi gerçek dünya zorluklarını çözen mesajlaşma çözümleri tasarlamaya hazır olun. Mülakatçılar, Kafka performansını sorun gidermek veya optimize etmek zorunda kalacağınız varsayımsal senaryolar da verebilir.
- İletişim: Kafka karmaşıktır; bu nedenle tasarım kararlarınızı veya sorun giderme adımlarınızı teknik ekiplere ya da iş paydaşlarına açık şekilde anlatabilmelisiniz. Güçlü iletişim becerileri sizi öne çıkaracaktır.
- Uygulamalı deneyim: Kafka kümeleri kurma, veri saklamayı yönetme veya Kafka’yı diğer araçlarla entegre etme gibi pratik deneyimleri vurgulayın. Pratik bilgi yüksek değer görür.
- Sürekli öğrenme: Kafka’nın en yeni özellikleri ve en iyi uygulamalarıyla güncel kalın. Dokümantasyon okumak veya açık kaynak projelere katkıda bulunmak, sürekli öğrenmeye olan bağlılığınızı gösterir.
Mülakat ipuçları
Mülakatta başarılı olmanızı sağlayacak bazı önemli ipuçları şunlardır:
- Şirketi, sektörü ve mülakatçınızın geçmişini araştırın.
- Farklı mülakat turları (teknik, İK, telefon ve yüz yüze) için uyarlanmış bir yaklaşımla hazırlanın.
- Şu teknik kaynakları düzenli olarak gözden geçirin:
Bu becerileri geliştirip etkili şekilde hazırlık yaparak, Kafka ile ilgili mülakatlara iyi donanımlı olarak gireceksiniz. Unutmayın, mülakatçılar yalnızca teknik uzmanlık değil, aynı zamanda net iletişim ve gerçek dünya problem çözme becerileri de arar. Mülakat süreci boyunca veri mühendisliğine olan tutkunuzu gösterin.