Begrijpen hoe data stroomt en het potentieel ervan benutten is absoluut cruciaal geworden voor moderne organisaties. Kafka is het toonaangevende platform voor het inladen, opslaan en verwerken van realtime datastreams in het moderne applicatielandschap.
In deze post zetten we enkele Kafka-sollicitatievragen op een rij en verkennen we de cruciale rol van de tool in dataverwerking. We bekijken verschillende niveaus van vragen, van basis tot gevorderd, en geven tips om je effectief voor te bereiden. Ben je nieuw met Kafka? Bekijk dan zeker onze Introduction to Apache Kafka course.
Basisvragen over Kafka
Deze vragen testen je basiskennis van Kafka als tool voor data-engineering.
1. Wat is Apache Kafka?
Apache Kafka is een krachtige, open-source gedistribueerde event-streamingplatform. Oorspronkelijk ontwikkeld door LinkedIn als een messaging queue, is het uitgegroeid tot een tool voor het verwerken van datastreams in uiteenlopende scenario’s.
Door Kafka’s gedistribueerde systeemarchitectuur is horizontale schaalbaarheid mogelijk, zodat consumers berichten in hun eigen tempo kunnen ophalen en het eenvoudig is om Kafka-nodes (servers) aan de cluster toe te voegen.
Kafka is ontworpen om grote hoeveelheden data snel te verwerken met een lage latency. Hoewel het is geschreven in Scala en Java, ondersteunt het een breed scala aan programmeertalen.
Apache Kafka fungeert als een gedistribueerde logcollector, waarbij logberichten als key-valueparen worden opgeslagen in een append-only logbestand voor duurzame, langdurige opslag en opvraging. In tegenstelling tot traditionele message queues zoals RabbitMQ, die berichten verwijderen nadat ze zijn geconsumeerd, bewaart Kafka berichten gedurende een configureerbare periode, wat het ideaal maakt voor use-cases die datareplay of event sourcing vereisen.
Waar RabbitMQ zich richt op realtime berichtaflevering zonder berichten langdurig op te slaan, ondersteunt Kafka’s retentiebeleid complexere, datagedreven applicaties.
Veelvoorkomende use-cases voor Kafka zijn applicatietracking, logaggregatie en messaging, al mist het traditionele databasefuncties zoals query’s en indexing. De kracht ligt in het verwerken van realtime datastreams, waardoor het onmisbaar is voor gedistribueerde systemen en realtime analytics.
2. Wat zijn enkele kenmerken van Kafka?
Apache Kafka is een open-source gedistribueerd streamingplatform dat veel wordt gebruikt voor het bouwen van realtime datapijplijnen en streamingapplicaties. Het biedt de volgende kenmerken:
1. Hoge doorvoer
Kafka kan enorme hoeveelheden data verwerken. Het is ontworpen om honderden gigabytes efficiënt te lezen en te schrijven vanaf bronclients.
2. Gedistribueerde architectuur
Apache Kafka heeft een clustergerichte architectuur en ondersteunt inherent message-partitioning over Kafka-servers. Dit ontwerp maakt ook gedistribueerde consumptie over een cluster van consumermachines mogelijk, terwijl de volgorde van berichten binnen elke partitie behouden blijft. Daarnaast kan een Kafka-cluster elastisch en transparant schalen, zonder downtime.
3. Ondersteuning voor diverse clients
Apache Kafka ondersteunt de integratie van clients van verschillende platforms, zoals .NET, JAVA, PHP en Python.
4. Realtime berichten
Kafka produceert realtime berichten die zichtbaar moeten zijn voor consumers; dit is belangrijk voor systemen voor complexe eventverwerking.
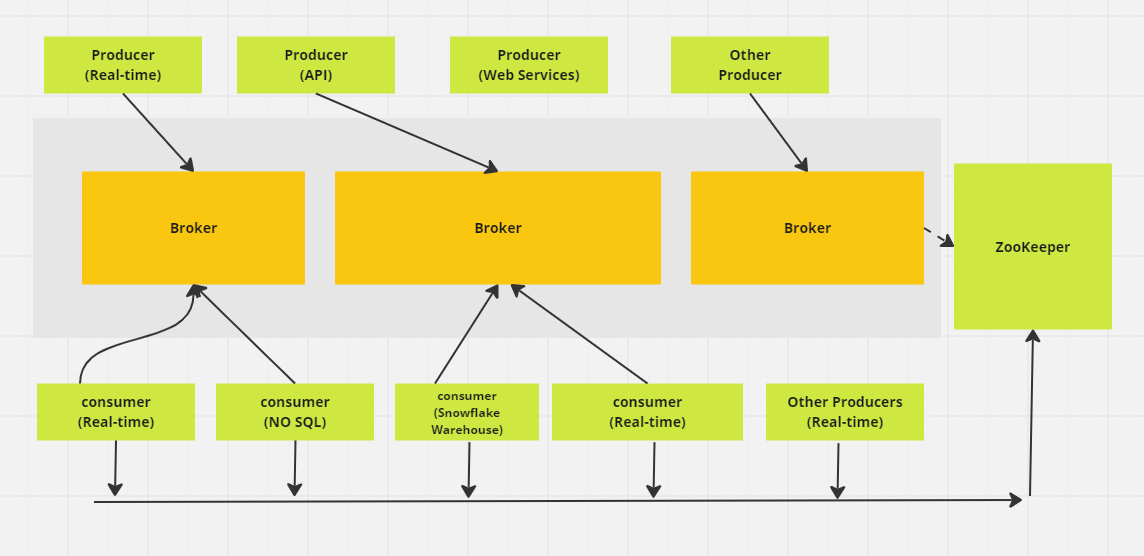
Apache Kafka Messaging gedistribueerd systeem. (Afbeelding door auteur)
3. Hoe werken partitities in Kafka?
In Kafka fungeert een topic als opslagruimte waar alle berichten van producers worden bewaard. Gewoonlijk worden gerelateerde data in afzonderlijke topics opgeslagen. Zo zou een topic met de naam "transactions" details van aankopen door gebruikers op een e-commerce site opslaan, terwijl een topic "customers" klantinformatie bevat.
Topics worden opgedeeld in partitities. Standaard heeft een topic één partitie, maar je kunt het zo configureren dat het er meer heeft. Berichten worden over deze partitities verdeeld, waarbij elke partitie zijn eigen offset heeft en op een andere server in het Kafka-cluster is opgeslagen.
Als een topic bijvoorbeeld drie partitities over drie brokers heeft, en een producer 15 berichten verstuurt, worden de berichten sequentieel verdeeld:
- Record 1 gaat naar Partitie 0
- Record 2 gaat naar Partitie 1
- Record 3 gaat naar Partitie 2
Daarna herhaalt de cyclus zich, waarbij Record 4 teruggaat naar Partitie 0, enzovoort.
4. Waarom zou je voor Kafka kiezen boven andere messagingservices?
De keuze voor Kafka boven andere messagingservices komt vaak neer op zijn unieke sterke punten, vooral voor use-cases die hoge doorvoer en realtime dataverwerking nodig hebben. Dit is waarom Kafka eruit springt:
- Hoge doorvoer en schaalbaarheid: Kafka kan grote hoeveelheden data efficiënt verwerken. De architectuur ondersteunt horizontaal schalen, zodat je meer brokers en partitities kunt toevoegen om toenemende datalasten aan te kunnen zonder in te leveren op performance.
- Realtime verwerking: Het is uitstekend voor realtime datastreaming en dus perfect voor use-cases zoals activiteitstracking en operationele monitoring. LinkedIn creëerde Kafka bijvoorbeeld om zijn activiteitstrackingpijplijn te verwerken, waarmee realtime feeds van gebruikersinteracties zoals klikken en likes kunnen worden gepubliceerd.
- Message replay: Kafka laat consumers berichten opnieuw afspelen, wat handig is als een consumer een fout tegenkomt of overbelast raakt. Zo gaat er geen data verloren—consumers kunnen herstellen en gemiste berichten opnieuw afspelen om dataintegriteit te behouden.
- Duurzaamheid en fouttolerantie: De tool repliceert data over meerdere brokers, wat betrouwbaarheid garandeert zelfs als sommige brokers uitvallen. Dit fouttolerante ontwerp houdt data toegankelijk en biedt zekerheid voor kritieke operaties.
5. Leg alle API’s uit die door Apache Kafka worden geleverd.
Een API (Application Programming Interface) maakt communicatie mogelijk tussen verschillende services, microservices en systemen. Kafka biedt een set API’s die zijn ontworpen om event-streamingplatformen te bouwen en te communiceren met het berichtensysteem.
De kern-API’s van Kafka zijn:
- Producer API: Wordt gebruikt om realtime data naar Kafka-topics te sturen. Producers bepalen naar welke partitie binnen een topic elk bericht moet gaan, met callbacks die het slagen of falen van verzendoperaties afhandelen.
- Consumer API: Maakt het mogelijk om realtime data uit Kafka-topics te lezen. Consumers kunnen deel uitmaken van een consumergroep voor load balancing en parallelle verwerking, abonneren op topics en continu Kafka pollen voor nieuwe berichten.
- Streams API: Ondersteunt het bouwen van realtime applicaties die data binnen Kafka transformeren, aggregeren en analyseren. Biedt een high-level DSL (Domain Specific Language) om complexe streamverwerkingslogica te definiëren.
- Kafka Connect API: Wordt gebruikt om herbruikbare connectors te maken en uit te voeren voor het importeren en exporteren van data tussen Kafka en externe systemen.
- Admin API: Biedt tools voor het beheren en configureren van Kafka-topics, brokers en andere resources om soepele werking en schaalbaarheid te garanderen.
Deze API’s maken naadloze dataproduktie, -consumptie, -verwerking en -beheer binnen Kafka mogelijk.
Tussenniveau Kafka-sollicitatievragen
Deze vragen zijn gericht op meer ervaren beoefenaars die al een stevige grip hebben op Kafka’s toepassingen.
6. Wat zijn de gevolgen van het verhogen van het aantal partitities in een Kafka-topic?
Het verhogen van het aantal partitities in een Kafka-topic kan de gelijktijdigheid en doorvoer verbeteren door meer consumers in parallel te laten lezen. Het brengt echter ook bepaalde uitdagingen met zich mee:
- Meer cluster-overhead: Meer partitities verbruiken extra clusterresources, wat leidt tot meer netwerkverkeer voor replicatie en hogere opslagvereisten.
- Potentiële datadonbalans: Naarmate het aantal partitities toeneemt, wordt data mogelijk niet gelijkmatig verdeeld, waardoor sommige partitities overbelast raken terwijl andere onderbenut blijven.
- Complexer beheer van consumergroepen: Met meer partitities wordt het beheren van toewijzingen en het bijhouden van offsets ingewikkelder.
- Langere rebalancing-tijden: Wanneer consumers joinen of leaven, kan het herverdelen van partitities over de groep langer duren, wat de algehele responsiviteit beïnvloedt.
7. Leg de vier componenten van de Kafka-architectuur uit
Kafka is een gedistribueerde architectuur die uit verschillende kerncomponenten bestaat:
Brokernodes
Kafka’s gedistribueerde architectuur omvat verschillende kernelementen, waarvan één de brokernode is. Brokers doen het zware werk van in-/uitvoerbewerkingen en beheren de duurzame opslag van berichten. Ze ontvangen data van producers, slaan deze op en stellen deze beschikbaar aan consumers. Elke broker maakt deel uit van een Kafka-cluster en heeft een unieke ID voor coördinatie.
In oudere versies van Kafka wordt de cluster beheerd met Zookeeper, dat zorgt voor correcte coördinatie tussen brokers en metadata bijhoudt zoals partitie-locaties (al beweegt Kafka naar een interne KRaft-modus hiervoor). Kafka-brokers zijn zeer schaalbaar en in staat om grote volumes lees- en schrijfbewerkingen voor berichten over gedistribueerde systemen te verwerken.
ZooKeeper-nodes
ZooKeeper speelt een cruciale rol in Kafka door brokerregistratie te beheren en de Kafka-controller te kiezen, die de beheeroperaties voor de cluster afhandelt. ZooKeeper draait zelf als een cluster, een ensemble, waarin meerdere processen samenwerken om te verzekeren dat maar één broker tegelijk als controller is aangewezen.
Als de huidige controller uitvalt, kiest ZooKeeper snel een nieuwe broker om het over te nemen. Hoewel ZooKeeper een essentieel onderdeel van Kafka’s architectuur is geweest, stapt Kafka over op een nieuwe KRaft-modus die ZooKeeper overbodig maakt. ZooKeeper is een onafhankelijk open-sourceproject en geen native Kafka-component.
Producers
Een Kafka-producer is een clientapplicatie die als databron voor Kafka dient en records publiceert naar een of meer Kafka-topics via persistente TCP-verbindingen met brokers.
Meerdere producers kunnen gelijktijdig records naar hetzelfde topic sturen. Kafka-topics zijn append-only, wat betekent dat producers nieuwe data kunnen schrijven, maar noch producers noch consumers bestaande records kunnen wijzigen of verwijderen. Dit garandeert data-imputabiliteit.
Consumers
Een Kafka-consumer is een clientapplicatie die zich abonneert op een of meer Kafka-topics om streams van records te consumeren. Consumers werken doorgaans in consumergroepen, waar de last van het lezen en verwerken van records over meerdere consumers wordt verdeeld.
Elke consumer volgt zijn voortgang door offsets bij te houden, zodat geen data dubbel wordt verwerkt en onbewerkte records niet verloren gaan. Kafka-consumers vormen de laatste stap in de datapijplijn, waar records worden verwerkt of doorgestuurd naar downstreamsystemen.
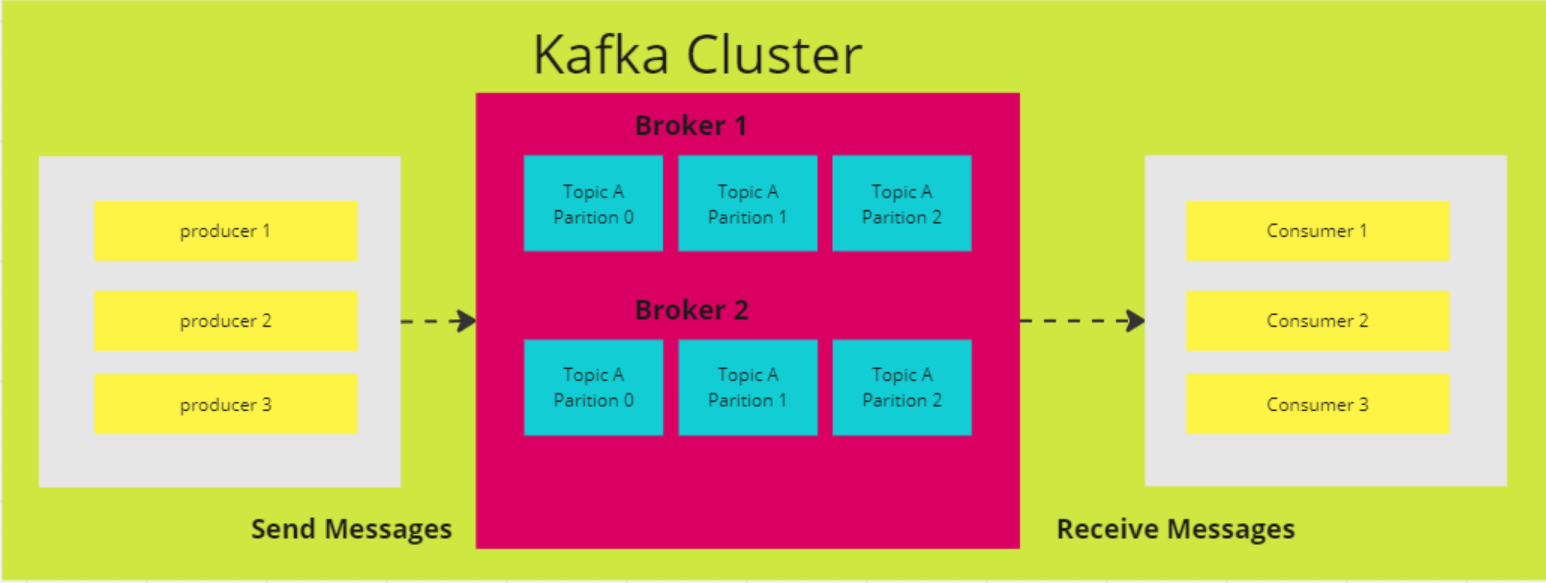
Architectuurschema van Apache Kafka (Afbeelding door auteur)
8. Wat is het primaire doel van logcompactie in Kafka? Hoe beïnvloedt logcompactie de performance van Kafka-consumers?
Het belangrijkste doel van logcompactie in Kafka is om de meest recente waarde voor elke unieke key in de log van een topic te behouden, zodat de laatste status van de data bewaard blijft en het opslaggebruik afneemt. Dit stelt consumers in staat om de actuele waarde efficiënter te benaderen zonder oudere duplicaten te hoeven verwerken.
In tegenstelling tot Kafka’s traditionele retentiebeleid, dat berichten na een bepaalde tijd verwijdert, verwijdert logcompactie oudere records per key en behoudt het de meest recente waarde voor die key. Deze feature zorgt ervoor dat consumers altijd toegang hebben tot de actuele status, terwijl een compacte log wordt behouden voor betere opslagefficiëntie en snellere lookups.
9. Wat is het verschil tussen partitities en replica’s in een Kafka-cluster?
Partitities en replica’s zijn sleutelonderdelen van Kafka’s architectuur en zorgen voor zowel performance als fouttolerantie. Partitities verhogen de doorvoer door een topic op te splitsen in meerdere delen, waardoor consumers in parallel uit verschillende partitities kunnen lezen, wat de schaalbaarheid en efficiëntie van Kafka verbetert.
Replica’s bieden daarentegen redundantie door kopieën van partitities over meerdere brokers te maken. Dit garandeert fouttolerantie omdat, in het geval van een uitval van de leader-broker (de broker die lees- en schrijfbewerkingen voor een partitie beheert), een van de follower-replica’s kan worden gepromoveerd tot nieuwe leader.
Kafka onderhoudt meerdere replica’s van elke partitie om hoge beschikbaarheid en dataduurzaamheid te waarborgen, waarbij het risico op dataverlies tijdens storingen wordt geminimaliseerd, hoewel volledige duurzaamheid afhangt van replicatie-instellingen.
10. Wat is een schema in Kafka en waarom is het belangrijk voor gedistribueerde systemen?
In Kafka definieert een schema de structuur en het formaat van data, zoals velden als CustomerID (integer), CustomerName (string) en Designation (string).
In gedistribueerde systemen zoals Kafka moeten producers en consumers het eens zijn over het dataformaat om fouten bij de gegevensuitwisseling te voorkomen. De Kafka Schema Registry beheert en handhaaft deze schema’s, zodat zowel producers als consumers compatibele versies gebruiken.
De Schema Registry slaat schema’s op (vaak in formaten als Avro, Protobuf of JSON Schema) en ondersteunt schema-evolutie, waardoor dataformaten kunnen veranderen zonder bestaande consumers te breken. Dit zorgt voor soepele gegevensuitwisseling en systeem betrouwbaarheid naarmate schema’s evolueren.
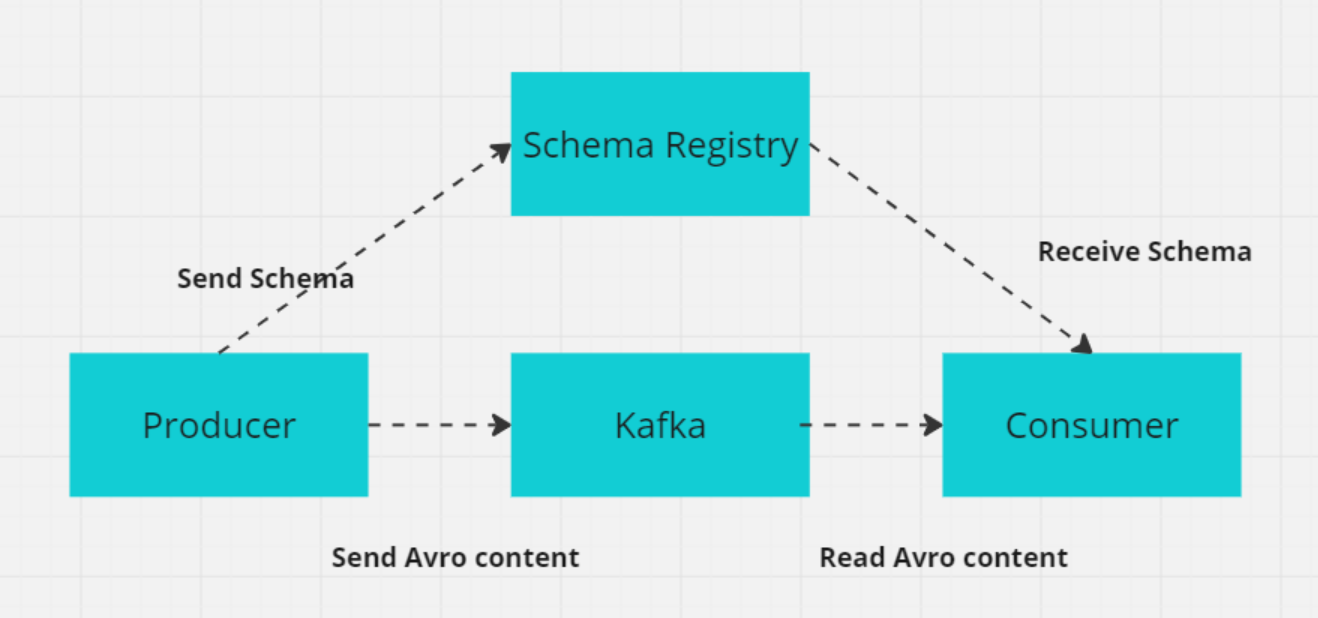
Hoe Schema Registry werkt met producer/consumer (Afbeelding door auteur)
Gevorderde Kafka-sollicitatievragen
Voor meer gevorderde Kafka-gebruikers zullen de vragen die je krijgt waarschijnlijk technischer van aard zijn.
11. Hoe zorgt Kafka voor het voorkomen van berichtverlies?
Kafka gebruikt verschillende mechanismen om berichtverlies te voorkomen en betrouwbare aflevering te garanderen:
- Handmatige offset-commit: Consumers kunnen automatische offset-commits uitschakelen en offsets handmatig committen na succesvolle verwerking van berichten, om te voorkomen dat onbewerkte berichten verloren gaan bij een consumercrash.
- Producer-acknowledgments (
acks=all): Dooracks=allop de producer in te stellen, worden berichten door alle in-sync replica’s bevestigd voordat ze als succesvol geschreven gelden, wat het risico op verlies bij brokeruitval verkleint. - Replicatie (
min.insync.replicasenreplication.factor): Kafka repliceert de data van elke partitie over meerdere brokers. Een replicatiefactor groter dan 1 biedt fouttolerantie, zodat data beschikbaar blijft als een broker uitvalt. De instellingmin.insync.replicaszorgt ervoor dat een minimumaantal replica’s een bericht bevestigt voordat het wordt geschreven, wat de dataduurzaamheid verbetert. Bijvoorbeeld: met een replicatiefactor van 3 blijft de data beschikbaar op de andere twee brokers als er één uitvalt. - Producer-retries: Het configureren van een hoog aantal retries zorgt ervoor dat producers berichten opnieuw verzenden als er een tijdelijke fout optreedt. In combinatie met zorgvuldige configuratie, zoals
max.in.flight.requests.per.connection=1, verkleint dit de kans op herschikking en zorgt het ervoor dat berichten uiteindelijk worden afgeleverd zonder verloren te gaan.
12. Hoe verschilt Kafka van RabbitMq?
Kafka en RabbitMQ zijn twee populaire berichtensystemen en verschillen qua architectuur en gebruik. Zo vergelijken ze op kerngebieden:
1. Gebruik en ontwerp
Kafka is ontworpen om grootschalige datastreams en realtime pijplijnen te verwerken, geoptimaliseerd voor hoge doorvoer en lage latency. De loggebaseerde architectuur zorgt voor duurzaamheid en maakt herverwerking van data mogelijk, wat het ideaal maakt voor use-cases zoals event sourcing en streamverwerking.
RabbitMQ is een general-purpose message broker die complexe routing ondersteunt en doorgaans wordt gebruikt voor messaging tussen microservices of het verdelen van taken onder workers. Het blinkt uit in omgevingen waar betrouwbare berichtaflevering, routeringsflexibiliteit en interactie tussen services essentieel zijn.
2. Architectuur
Kafka categoriseert berichten in topics, die zijn opgesplitst in partitities. Elke partitie kan door meerdere consumers worden verwerkt, wat parallelle verwerking en schaalbaarheid mogelijk maakt. Data wordt op schijf opgeslagen met een configureerbare retentieperiode, wat duurzaamheid garandeert en herverwerking van berichten mogelijk maakt wanneer nodig.
RabbitMQ stuurt berichten naar queues, waar ze door één of meer consumers worden geconsumeerd. Het garandeert betrouwbare aflevering via berichtbevestigingen, retries en dead-letter exchanges voor het afhandelen van mislukte berichten. Deze architectuur focust op berichtintegriteit en flexibiliteit in routing.
3. Performance en schaalbaarheid
Kafka is gebouwd voor horizontale schaalbaarheid door meer brokers en partitities toe te voegen, waardoor het miljoenen berichten per seconde aankan. De architectuur ondersteunt parallelle verwerking en hoge doorvoer, wat het ideaal maakt voor grootschalige datastreaming.
RabbitMQ kan schalen, maar niet zo efficiënt als Kafka bij zeer grote datavolumes. Het is geschikt voor scenario’s met matige tot hoge doorvoer, maar is niet geoptimaliseerd voor de extreme doorvoer die Kafka in grootschalige streamingapplicaties aankan.
Samenvatting: Zowel Kafka als RabbitMQ zijn krachtige tools voor messaging, maar ze excelleren in verschillende use-cases. Kafka is ideaal voor high-throughput, realtime datastreaming en event-sourcingapplicaties waar grootschalige, parallelle verwerking nodig is.
RabbitMQ is zeer geschikt voor betrouwbare berichtaflevering, taakverdeling in microservice-architecturen en complexe berichtenroutering. Het blinkt uit in scenario’s die losse koppeling tussen services, asynchrone verwerking en betrouwbaarheid vereisen.
13. Hoe helpt Kafka bij het ontwikkelen van microservice-gebaseerde applicaties?
Apache Kafka is een waardevol hulpmiddel voor het bouwen van microservice-architecturen dankzij zijn mogelijkheden voor realtime data-afhandeling, eventgedreven communicatie en betrouwbare messaging. Zo ondersteunt Kafka de ontwikkeling van microservices:
1. Eventgedreven architectuur
- Serviceontkoppeling: Met Kafka communiceren services via events in plaats van directe calls, waardoor afhankelijkheden afnemen. Deze ontkoppeling stelt services in staat om onafhankelijk events te produceren en consumeren, wat evolutie en onderhoud vereenvoudigt.
- Asynchrone verwerking: Services kunnen events publiceren en doorgaan zonder te wachten op reacties van andere services, wat de responsiviteit en efficiëntie verbetert.
2. Schaalbaarheid
- Horizontale schaalbaarheid: Kafka kan grote datavolumes aan door de belasting over meerdere brokers en partitities te distribueren. Elke partitie kan door verschillende consumerinstanties worden verwerkt, zodat het systeem horizontaal kan schalen.
- Parallelle consumptie: Meerdere consumers kunnen gelijktijdig uit verschillende partitities lezen, wat doorvoer en performance verhoogt.
3. Betrouwbaarheid en fouttolerantie
- Datareplicatie: Kafka repliceert data over meerdere brokers, wat hoge beschikbaarheid en fouttolerantie garandeert. Als één broker uitvalt, kan een andere het overnemen met de gerepliceerde data. Kafka slaat data op schijf op met configureerbare retentieperiodes, zodat events niet verloren gaan en indien nodig opnieuw kunnen worden verwerkt.
4. Dataintegratie
- Centrale datahub: Kafka fungeert als centrale hub voor datastromen binnen een microservice-architectuur en faciliteert integratie tussen uiteenlopende databronnen en -sinks. Dit vereenvoudigt het handhaven van dataconsistentie tussen services.
- Kafka Connect: Kafka Connect biedt connectors voor integratie met tal van databases, key-valuestores, zoekindexen en andere systemen, waardoor databeweging tussen microservices en externe systemen wordt gestroomlijnd.
14. Wat is Kafka Zookeeper en hoe werkt het?
Apache ZooKeeper is een open-sourceservice die helpt bij coördinatie en beheer van configuratiedata, synchronisatie en groepsservices in gedistribueerde systemen. In oudere versies van Kafka speelde ZooKeeper een cruciale rol bij het beheren van metadata, leadelectie en brokercoördinatie.
Kafka stapt echter sinds versie 2.8 over op KRaft-modus, die de noodzaak voor ZooKeeper wegneemt. ZooKeeper wordt nu als verouderd beschouwd en zal worden verwijderd in release 4.0, die in 2024 wordt verwacht.
ZooKeeper slaat data op in een hiërarchische structuur van nodes genaamd "znodes", waarbij elke znode metadata kan opslaan en child-znodes kan hebben, vergelijkbaar met een bestandssysteem. Deze structuur is cruciaal voor het bijhouden van metadata van Kafka-brokers, topics en partitities. ZooKeeper’s quorummechanisme garandeert consistentie: een meerderheid van nodes (quorum) moet akkoord gaan met elke wijziging, waardoor ZooKeeper zeer betrouwbaar en fouttolerant is.
In oudere Kafka-versies wordt ZooKeeper gebruikt voor verschillende kritieke functies:
- Leadelectie: ZooKeeper kiest een controllernode die partitie-leadertoewijzingen en andere clustertaken beheert.
- Broker-metadatabeheer: Het onderhoudt een gecentraliseerd register van actieve brokers en hun status.
- Partitieherverdeling: ZooKeeper helpt bij het herverdelen van partitities over brokers tijdens storingen of clusteruitbreidingen.
ZooKeeper’s ZAB-protocol (ZooKeeper Atomic Broadcast) garandeert consistentie over nodes, zelfs bij netwerkpartities, zodat Kafka fouttolerant blijft. Deze consistentie en betrouwbaarheid maakten ZooKeeper cruciaal voor het beheer van Kafka’s gedistribueerde aard, al zal Kafka in de toekomst minder op ZooKeeper steunen nu KRaft de standaardmodus wordt.
15. Hoe kun je het schijfgebruik in Kafka verminderen?
Kafka biedt verschillende manieren om het schijfgebruik effectief te verminderen. Dit zijn belangrijke strategieën:
1. Pas logretentie-instellingen aan
Wijzig het logretentiebeleid om te verminderen hoelang berichten op schijf bewaard blijven. Dit kan door retention.ms (tijdgebaseerde retentie) of retention.bytes (grootttegebaseerde retentie) aan te passen, om te beperken hoelang of hoeveel data Kafka opslaat voordat oudere berichten worden verwijderd.
2. Implementeer logcompactie
Gebruik logcompactie om alleen het meest recente bericht voor elke unieke key te bewaren en verouderde of redundante data te verwijderen. Dit is vooral nuttig in scenario’s waar alleen de laatste status relevant is, waardoor schijfruimte wordt bespaard zonder belangrijke informatie te verliezen.
3. Configureer opschoonbeleiden
Stel effectieve opschoonbeleiden in op basis van je use-case. Je kunt zowel tijdgebaseerde (retention.ms) als grootttegebaseerde (retention.bytes) retentie instellen om oudere berichten automatisch te verwijderen en Kafka’s schijfvoetafdruk te beheren.
4. Comprimeer berichten
Schakel berichtcompressie in aan de producerzijde met formaten zoals GZIP, Snappy of LZ4. Compressie verkleint berichten, wat leidt tot minder schijfruimtegebruik. Houd echter rekening met de trade-off tussen minder schijfgebruik en hogere CPU-belasting door compressie en decompressie.
5. Pas de logsegmentgrootte aan
Configureer Kafka’s logsegmentgrootte (segment.bytes) om te bepalen hoe vaak logsegmenten worden gerold. Kleinere segmentgroottes zorgen voor vaker rollen, wat kan helpen om schijfruimte efficiënter te gebruiken door oudere data sneller te kunnen verwijderen.
6. Verwijder onnodige topics of partitities
Evalueer en verwijder periodiek ongebruikte of onnodige topics en partitities. Dit kan schijfruimte vrijmaken en helpen om Kafka’s schijfgebruik onder controle te houden.
Kafka-sollicitatievragen voor data-engineers
Als je solliciteert naar een functie als data-engineer, wil je je misschien voorbereiden op de volgende Kafka-sollicitatievragen.
16. Wat zijn de verschillen tussen leader-replica en follower-replica in Kafka?
Leader-replica
De leader-replica handelt alle clientlees- en schrijfbewerkingen af. Deze beheert de status van de partitie en is het primaire aanspreekpunt voor producers en consumers. Als de leader uitvalt, wordt de rol overgedragen aan een van de follower-replica’s om beschikbaarheid te behouden.
Follower-replica
De follower-replica repliceert data van de leader maar handelt geen clientverzoeken direct af. De rol is om fouttolerantie te waarborgen door een up-to-date kopie van de partitie-data te houden. Vanaf Kafka 2.4 kunnen follower-replica’s onder bepaalde voorwaarden ook leesverzoeken afhandelen om de load te verdelen en de leessnelheid te verbeteren. Als de leader faalt, wordt een follower gekozen als nieuwe leader om consistentie en beschikbaarheid te behouden.
17. Waarom gebruiken we clusters in Kafka, en wat zijn de voordelen?
Een Kafka-cluster bestaat uit meerdere brokers die data over verschillende instanties verdelen, waardoor je zonder downtime kunt schalen. Deze clusters zijn ontworpen om vertragingen te minimaliseren, en als de primaire cluster faalt, kunnen andere Kafka-clusters het overnemen om de dienstverlening te continueren.
De architectuur van een Kafka-cluster omvat Topics, Brokers, Producers en Consumers. Het beheert datastreams efficiënt en is daardoor ideaal voor big data-toepassingen en de ontwikkeling van datagedreven applicaties.
18. Hoe zorgt Kafka voor de volgorde van berichten?
Kafka waarborgt de berichtvolgorde op twee hoofdmaneiren:
- Met message keys: Als een bericht een key krijgt, gaan alle berichten met dezelfde key naar dezelfde partitie. Dit zorgt ervoor dat berichten met dezelfde key in de volgorde worden verwerkt waarin ze zijn ontvangen, aangezien Kafka de volgorde binnen een partitie bewaart.
- Single-threaded consumerverwerking: Om de volgorde te behouden, moet de consumer berichten uit een partitie in één thread verwerken. Als meerdere threads worden gebruikt, richt dan afzonderlijke in-memory queues in voor elke partitie om ervoor te zorgen dat berichten in de juiste volgorde worden verwerkt bij gelijktijdige afhandeling.
19. Waar staan ISR en AR voor in Kafka? Wat betekent ISR-uitbreiding?
ISR (in-sync replicas)
ISR verwijst naar de replica’s die volledig zijn gesynchroniseerd met de leader-replica. Deze replica’s hebben de meest recente data en worden als betrouwbaar beschouwd voor zowel lees- als schrijfbewerkingen.
AR (assigned replicas)
AR omvat alle aan een partitie toegewezen replica’s, zowel in-sync als out-of-sync replica’s. Het vertegenwoordigt de volledige set replica’s voor een partitie.
ISR-uitbreiding
ISR-uitbreiding vindt plaats wanneer nieuwe replica’s de leader inhalen en aan de ISR-lijst worden toegevoegd. Dit vergroot het aantal up-to-date replica’s en verbetert de fouttolerantie en betrouwbaarheid.
20. Wat is een zero-copy-gebruikssituatie in Kafka?
Kafka gebruikt zero-copy om grote hoeveelheden data efficiënt tussen producers en consumers over te dragen. Het maakt gebruik van de methode FileChannel.transferTo om data rechtstreeks van het bestandssysteem naar netwerksockets te verplaatsen zonder extra kopieën, wat performance en doorvoer verbetert.
Deze techniek gebruikt memory-mapped files (mmap) voor het lezen van indexbestanden, zodat databuffers tussen user space en kernel space kunnen worden gedeeld, wat de noodzaak voor extra datakopieën verder vermindert. Dit maakt Kafka zeer geschikt voor het efficiënt verwerken van grootschalige realtime datastreams.
Voorbereiden op je Kafka-sollicitatie
Terwijl je je voorbereidt op een data-engineeringgesprek met focus op Kafka, is het cruciaal om zowel een sterke technische basis te hebben als een helder begrip van hoe Kafka in moderne systemen integreert. Kafka staat centraal in veel realtime dataplatformen, dus interviewers verwachten dat je zowel de basis kent als weet hoe Kafka werkt in schaalbare, fouttolerante omgevingen.
Belangrijke aandachtsgebieden
Zoals we hebben gezien in de Kafka-sollicitatievragen die we hier hebben behandeld, zijn er verschillende kerngebieden waarop je moet bijspijkeren:
- Architectuur: Wees zeker van je zaak bij het bespreken van Kafka’s architectuur, inclusief brokers, partitities en de interactie tussen producers en consumers. Je moet ook Kafka’s leveringsgaranties kunnen uitleggen—zoals "at-least-once" of "exactly-once" aflevering—en hoe Kafka berichtvolgorde waarborgt via features zoals In-Sync Replicas (ISR).
- Integratie: Begrijp hoe Kafka met andere systemen integreert via tools als Kafka Connect, dat databases, key-valuestores en andere systemen verbindt. Interviewers kunnen vragen naar Kafka’s rol bij het handhaven van dataconsistentie in microservices of gedistribueerde systemen.
- Monitoring en troubleshooting: Vertrouwdheid met monitoringtools zoals Kafka Manager en Prometheus is belangrijk. Je moet kunnen aantonen dat je Kafka-clusters effectief kunt beheren en optimaliseren.
- Probleemoplossing: Wees voorbereid om messagingoplossingen te ontwerpen die realistische uitdagingen oplossen, zoals het afhandelen van grote datastromen of het waarborgen van berichtbetrouwbaarheid. Interviewers kunnen hypothetische scenario’s geven waarin je Kafka-prestaties moet troubleshooten of optimaliseren.
- Communicatie: Kafka is complex, dus je moet je ontwerpkeuzes of troubleshooting-stappen helder kunnen uitleggen, zowel aan technische teams als aan zakelijke stakeholders. Sterke communicatieve vaardigheden maken het verschil.
- Hands-on ervaring: Benadruk praktische ervaring, zoals het opzetten van Kafka-clusters, het beheren van retentie of het integreren van Kafka met andere tools. Praktische kennis is zeer waardevol.
- Continu leren: Blijf op de hoogte van de nieuwste features en best practices van Kafka. Documentatie lezen of bijdragen aan open-sourceprojecten toont je inzet voor doorlopend leren.
Sollicitatietips
Hier zijn een paar toptips om te zorgen dat je het gesprek met vlag en wimpel afrondt:
- Onderzoek het bedrijf, de sector en de achtergrond van je interviewer.
- Bereid je voor op verschillende rondes (technisch, HR, telefonisch en in persoon) met een gerichte aanpak.
- Beoordeel regelmatig technische bronnen zoals:
Door deze vaardigheden te verfijnen en je goed voor te bereiden, ben je uitstekend toegerust voor Kafka-gerelateerde sollicitaties. Onthoud dat interviewers niet alleen zoeken naar technische expertise, maar ook naar heldere communicatie en probleemoplossend vermogen in de praktijk. Laat je passie voor data-engineering tijdens het hele proces zien.