डेटा के प्रवाह को समझना और उसकी क्षमता का उपयोग करना आधुनिक संगठनों के लिए अत्यंत महत्वपूर्ण हो गया है। आधुनिक एप्लिकेशन परिदृश्य में रियल-टाइम डेटा स्ट्रीम को इनजेस्ट करने, संग्रहीत करने और प्रोसेस करने के लिए Kafka अग्रणी प्लेटफ़ॉर्म है।
इस पोस्ट में, हम कुछ Kafka इंटरव्यू प्रश्नों की रूपरेखा प्रस्तुत करेंगे और डेटा प्रोसेसिंग में इस टूल की महत्वपूर्ण भूमिका पर चर्चा करेंगे। हम बुनियादी से लेकर उन्नत तक विभिन्न स्तरों के इंटरव्यू प्रश्नों का अन्वेषण करेंगे और प्रभावी तैयारी के सुझाव देंगे। यदि आप Kafka में नए हैं, तो हमारा Introduction to Apache Kafka कोर्स अवश्य देखें।
बेसिक Kafka इंटरव्यू प्रश्न
ये प्रश्न Kafka को डेटा इंजीनियरिंग टूल के रूप में आपकी बुनियादी समझ को परखेंगे।
1. Apache Kafka क्या है?
Apache Kafka एक शक्तिशाली, ओपन-सोर्स, डिस्ट्रीब्यूटेड इवेंट-स्ट्रीमिंग प्लेटफ़ॉर्म है। मूल रूप से LinkedIn द्वारा मैसेजिंग क्यू के रूप में विकसित, यह विभिन्न परिदृश्यों में डेटा स्ट्रीम को संभालने वाले टूल के रूप में विकसित हो चुका है।
Kafka की डिस्ट्रीब्यूटेड सिस्टम आर्किटेक्चर क्षैतिज स्केलेबिलिटी की अनुमति देती है, जिससे कंज़्यूमर अपने अनुसार गति से संदेश प्राप्त कर सकते हैं और क्लस्टर में Kafka नोड्स (सर्वर) जोड़ना आसान हो जाता है।
Kafka कम विलंबता के साथ बड़े पैमाने पर डेटा को तेज़ी से प्रोसेस करने के लिए डिज़ाइन किया गया है। यद्यपि यह Scala और Java में लिखा गया है, यह विभिन्न प्रोग्रामिंग भाषाओं का समर्थन करता है।
Apache Kafka एक डिस्ट्रीब्यूटेड लॉग कलेक्टर की तरह कार्य करता है, जहाँ लॉग संदेशों को की-वैल्यू पेयर्स के रूप में केवल-एपेंड लॉग फ़ाइल में टिकाऊ, दीर्घकालिक स्टोरेज और पुनर्प्राप्ति के लिए संग्रहीत किया जाता है। पारंपरिक मैसेज क्यू जैसे RabbitMQ, जो संदेशों को कंज़्यूम होने के बाद हटा देते हैं, के विपरीत Kafka संदेशों को एक कॉन्फ़िगरेबल अवधि तक बनाए रखता है, जिससे यह डेटा रिप्ले या इवेंट सोर्सिंग जैसी आवश्यकताओं के लिए आदर्श बनता है।
जहाँ RabbitMQ बिना लंबे समय तक स्टोरेज के रियल-टाइम संदेश डिलीवरी पर केंद्रित है, वहीं Kafka की रिटेंशन पॉलिसी अधिक जटिल, डेटा-चालित एप्लिकेशन का समर्थन करती है।
Kafka के सामान्य उपयोग मामलों में एप्लिकेशन ट्रैकिंग, लॉग एग्रीगेशन, और मैसेजिंग शामिल हैं, हालांकि इसमें क्वेरीिंग और इंडेक्सिंग जैसी पारंपरिक डेटाबेस विशेषताएँ नहीं हैं। इसकी ताकत रियल-टाइम डेटा स्ट्रीम को संभालने में है, जो इसे डिस्ट्रीब्यूटेड सिस्टम और रियल-टाइम एनालिटिक्स के लिए अपरिहार्य बनाती है।
2. Kafka की कुछ विशेषताएँ क्या हैं?
Apache Kafka एक ओपन-सोर्स डिस्ट्रीब्यूटेड स्ट्रीमिंग प्लेटफ़ॉर्म है, जिसका व्यापक रूप से रियल-टाइम डेटा पाइपलाइनों और स्ट्रीमिंग एप्लिकेशन बनाने में उपयोग होता है। यह निम्नलिखित विशेषताएँ प्रदान करता है:
1. उच्च थ्रूपुट
Kafka विशाल मात्रा में डेटा संभालने में सक्षम है। इसे स्रोत क्लाइंट्स से सैकड़ों गीगाबाइट को कुशलतापूर्वक पढ़ने और लिखने के लिए डिज़ाइन किया गया है।
2. डिस्ट्रीब्यूटेड आर्किटेक्चर
Apache Kafka में क्लस्टर-केंद्रित आर्किटेक्चर है और यह स्वाभाविक रूप से Kafka सर्वरों में संदेशों के पार्टिशनिंग का समर्थन करता है। यह डिज़ाइन कंज़्यूमर मशीनों के क्लस्टर में डिस्ट्रीब्यूटेड कंज़म्पशन को भी सक्षम करता है, जबकि प्रत्येक पार्टिशन के भीतर संदेशों के क्रम को संरक्षित रखता है। इसके अलावा, Kafka क्लस्टर बिना किसी डाउनटाइम के लोचदार और पारदर्शी रूप से स्केल कर सकता है।
3. विभिन्न क्लाइंट्स का समर्थन
Apache Kafka विभिन्न प्लेटफ़ॉर्म जैसे .NET, JAVA, PHP, और Python से क्लाइंट्स के इंटीग्रेशन का समर्थन करता है।
4. रियल-टाइम संदेश
Kafka रियल-टाइम संदेश उत्पन्न करता है जो कंज़्यूमर्स को दिखने चाहिए; यह जटिल इवेंट प्रोसेसिंग सिस्टम के लिए महत्वपूर्ण है।
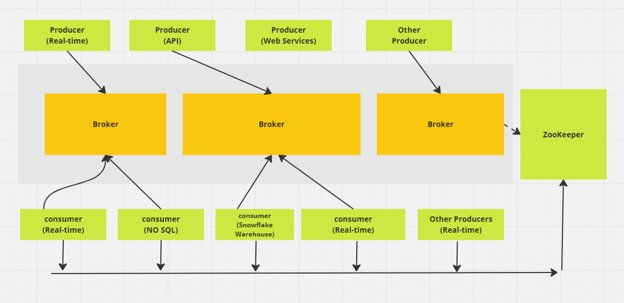
Apache Kafka मैसेजिंग डिस्ट्रीब्यूटेड सिस्टम। (चित्र: लेखक)
3. Kafka में पार्टिशन कैसे काम करते हैं?
Kafka में, एक टॉपिक वह स्टोरेज स्पेस है जहाँ प्रोड्यूसर्स के सभी संदेश रखे जाते हैं। सामान्यतः, संबंधित डेटा अलग-अलग टॉपिक्स में संग्रहीत किया जाता है। उदाहरण के लिए, "transactions" नामक टॉपिक ई-कॉमर्स साइट पर उपयोगकर्ता की खरीदारी के विवरण संग्रहीत करेगा, जबकि "customers" नामक टॉपिक में ग्राहक संबंधी जानकारी होगी।
टॉपिक्स को पार्टिशन में विभाजित किया जाता है। डिफ़ॉल्ट रूप से, एक टॉपिक में एक पार्टिशन होता है, लेकिन आप इसे अधिक के लिए कॉन्फ़िगर कर सकते हैं। संदेश इन पार्टिशनों में वितरित होते हैं, प्रत्येक पार्टिशन का अपना ऑफ़सेट होता है और यह Kafka क्लस्टर के अलग-अलग सर्वरों पर संग्रहीत होता है।
उदाहरण के लिए, यदि किसी टॉपिक में तीन ब्रोकर्स पर तीन पार्टिशन हैं, और एक प्रोड्यूसर 15 संदेश भेजता है, तो संदेश क्रम में वितरित होंगे:
- रिकॉर्ड 1 पार्टिशन 0 में जाएगा
- रिकॉर्ड 2 पार्टिशन 1 में जाएगा
- रिकॉर्ड 3 पार्टिशन 2 में जाएगा
फिर चक्र दोहराया जाता है, रिकॉर्ड 4 वापस पार्टिशन 0 में जाएगा, और इसी तरह आगे।
4. आप अन्य मैसेजिंग सेवाओं की तुलना में Kafka क्यों चुनेंगे?
अन्य मैसेजिंग सेवाओं की तुलना में Kafka चुनना अक्सर इसकी विशिष्ट ताकतों पर निर्भर करता है, खासकर उन उपयोग मामलों के लिए जहाँ उच्च थ्रूपुट और रियल-टाइम डेटा प्रोसेसिंग की आवश्यकता होती है। यहाँ बताया गया है कि Kafka क्यों अलग है:
- उच्च थ्रूपुट और स्केलेबिलिटी: Kafka बड़े पैमाने पर डेटा को कुशलता से संभाल सकता है। इसकी आर्किटेक्चर क्षैतिज स्केलिंग का समर्थन करती है, जिससे आप अधिक ब्रोकर्स और पार्टिशन जोड़कर बढ़ते डेटा लोड को बिना परफॉर्मेंस खोए संभाल सकते हैं।
- रियल-टाइम प्रोसेसिंग: यह रियल-टाइम डेटा स्ट्रीमिंग के लिए उत्कृष्ट है, जो एक्टिविटी ट्रैकिंग और ऑपरेशनल मॉनिटरिंग जैसे उपयोग मामलों के लिए उपयुक्त बनाता है। उदाहरण के लिए, LinkedIn ने अपनी एक्टिविटी ट्रैकिंग पाइपलाइन को संभालने के लिए Kafka बनाया, जिससे क्लिक और लाइक्स जैसी उपयोगकर्ता इंटरैक्शन की रियल-टाइम फ़ीड प्रकाशित करना संभव हुआ।
- मैसेज रिप्ले: Kafka कंज़्यूमर्स को संदेशों को फिर से चलाने की अनुमति देता है, जो तब उपयोगी होता है जब कोई कंज़्यूमर त्रुटि का सामना करता है या ओवरलोड हो जाता है। इससे सुनिश्चित होता है कि कोई डेटा न खोए—कंज़्यूमर्स छूटे हुए संदेशों को फिर से पढ़कर डेटा अखंडता बनाए रख सकते हैं।
- दृढ़ता और फ़ॉल्ट टॉलरेंस: यह टूल डेटा को कई ब्रोकर्स में प्रतिलिपि (रिप्लिकेट) करता है, जिससे कुछ ब्रोकर्स के फेल होने पर भी विश्वसनीयता बनी रहती है। यह फ़ॉल्ट-टॉलरेंट डिज़ाइन डेटा को सुलभ रखता है और महत्वपूर्ण कार्यों के लिए सुरक्षा प्रदान करता है।
5. Apache Kafka द्वारा प्रदान किए गए सभी APIs समझाएँ।
API (एप्लिकेशन प्रोग्रामिंग इंटरफ़ेस) विभिन्न सेवाओं, माइक्रोसर्विसेज़ और सिस्टम्स के बीच संचार को सक्षम करता है। Kafka इवेंट स्ट्रीमिंग प्लेटफ़ॉर्म बनाने और उसके मैसेजिंग सिस्टम के साथ इंटरेक्ट करने के लिए APIs का एक सेट प्रदान करता है।
कोर Kafka APIs हैं:
- Producer API: Kafka टॉपिक्स को रियल-टाइम डेटा भेजने के लिए उपयोग होता है। प्रोड्यूसर यह तय करते हैं कि किसी टॉपिक के भीतर प्रत्येक संदेश किस पार्टिशन में जाएगा, और कॉलबैक्स भेजने की सफलता या असफलता को हैंडल करते हैं।
- Consumer API: Kafka टॉपिक्स से रियल-टाइम डेटा पढ़ने की अनुमति देता है। कंज़्यूमर्स लोड बैलेंसिंग और पैरेलल प्रोसेसिंग के लिए कंज़्यूमर ग्रुप का हिस्सा हो सकते हैं, टॉपिक्स को सब्सक्राइब करते हैं और नए संदेशों के लिए लगातार Kafka को पोल करते हैं।
- Streams API: Kafka के भीतर डेटा को ट्रांसफ़ॉर्म, एग्रीगेट और विश्लेषित करने वाले रियल-टाइम एप्लिकेशन बनाने में सहायता करता है। यह जटिल स्ट्रीम प्रोसेसिंग लॉजिक को परिभाषित करने के लिए हाई-लेवल DSL (डोमेन स्पेसिफिक लैंग्वेज) प्रदान करता है।
- Kafka Connect API: Kafka और बाहरी सिस्टम्स के बीच डेटा आयात-निर्यात के लिए पुन: प्रयोज्य कनेक्टर्स बनाने और चलाने में उपयोग होता है।
- Admin API: Kafka टॉपिक्स, ब्रोकर्स और अन्य संसाधनों को प्रबंधित और कॉन्फ़िगर करने के लिए टूल प्रदान करता है ताकि सुचारू संचालन और स्केलेबिलिटी सुनिश्चित हो।
ये APIs Kafka के भीतर डेटा के उत्पादन, उपभोग, प्रोसेसिंग और प्रबंधन को सहज बनाते हैं।
इंटरमीडिएट Kafka इंटरव्यू प्रश्न
ये प्रश्न उन अनुभवी प्रैक्टिशनर्स के लिए हैं जिन्हें Kafka के उपयोग की ठोस समझ है।
6. Kafka टॉपिक में पार्टिशन की संख्या बढ़ाने के क्या निहितार्थ हैं?
Kafka टॉपिक में पार्टिशन की संख्या बढ़ाने से अधिक कंज़्यूमर्स को समानांतर में पढ़ने की अनुमति देकर कंकरेन्सी और थ्रूपुट में सुधार हो सकता है। हालाँकि, इससे कुछ चुनौतियाँ भी आती हैं:
- क्लस्टर ओवरहेड में वृद्धि: अधिक पार्टिशन अतिरिक्त क्लस्टर संसाधन उपभोग करते हैं, प्रतिकृति के लिए अधिक नेटवर्क ट्रैफ़िक और स्टोरेज आवश्यकताओं में वृद्धि होती है।
- डेटा असंतुलन की संभावना: पार्टिशन बढ़ने पर डेटा समान रूप से वितरित नहीं हो सकता, जिससे कुछ पार्टिशन ओवरलोड और अन्य अंडरयूटिलाइज़्ड हो सकते हैं।
- कंज़्यूमर ग्रुप प्रबंधन अधिक जटिल: अधिक पार्टिशन होने पर कंज़्यूमर ग्रुप असाइनमेंट और ऑफ़सेट ट्रैकिंग का प्रबंधन अधिक पेचीदा हो जाता है।
- रीबैलेंसिंग समय लंबा होना: जब कंज़्यूमर्स जुड़ते या छोड़ते हैं, तो ग्रुप में पार्टिशन का रीबैलेंसिंग अधिक समय ले सकता है, जिससे समग्र सिस्टम की प्रतिक्रियाशीलता प्रभावित होती है।
7. Kafka आर्किटेक्चर के चार घटकों की व्याख्या करें
Kafka कई प्रमुख घटकों से मिलकर बना एक डिस्ट्रीब्यूटेड आर्किटेक्चर है:
ब्रोकर्स नोड्स
Kafka की डिस्ट्रीब्यूटेड आर्किटेक्चर कई प्रमुख घटकों से मिलकर बनती है, जिनमें से एक है ब्रोकर नोड। ब्रोकर्स I/O ऑपरेशनों का मुख्य कार्य संभालते हैं और संदेशों के टिकाऊ स्टोरेज का प्रबंधन करते हैं। वे प्रोड्यूसर्स से डेटा प्राप्त करते हैं, उसे स्टोर करते हैं और कंज़्यूमर्स के लिए उपलब्ध कराते हैं। प्रत्येक ब्रोकर Kafka क्लस्टर का हिस्सा होता है और समन्वय में मदद के लिए एक यूनिक ID रखता है।
Kafka के पुराने संस्करणों में, क्लस्टर का प्रबंधन Zookeeper द्वारा किया जाता है, जो ब्रोकर्स के बीच उचित समन्वय सुनिश्चित करता है और पार्टिशन लोकेशन जैसी मेटाडेटा को ट्रैक करता है (हालाँकि Kafka इसके लिए आंतरिक KRaft मोड की ओर बढ़ रहा है)। Kafka ब्रोकर्स अत्यधिक स्केलेबल हैं और डिस्ट्रीब्यूटेड सिस्टम्स में संदेशों के बड़े पैमाने पर रीड और राइट अनुरोधों को संभालने में सक्षम हैं।
ZooKeeper नोड्स
ZooKeeper Kafka में एक महत्वपूर्ण भूमिका निभाता है, ब्रोकर रजिस्ट्रेशन का प्रबंधन करता है और Kafka कंट्रोलर का चुनाव करता है, जो क्लस्टर के प्रशासनिक संचालन संभालता है। ZooKeeper स्वयं एक क्लस्टर के रूप में कार्य करता है, जिसे एंसेंबल कहा जाता है, जहाँ कई प्रोसेस यह सुनिश्चित करने के लिए साथ काम करते हैं कि एक समय में केवल एक ब्रोकर कंट्रोलर के रूप में असाइन हो।
यदि वर्तमान कंट्रोलर फेल हो जाता है, तो ZooKeeper शीघ्र ही किसी नए ब्रोकर का चुनाव कर देता है। यद्यपि ZooKeeper Kafka आर्किटेक्चर का एक आवश्यक हिस्सा रहा है, Kafka एक नए KRaft मोड में परिवर्तन कर रहा है जो ZooKeeper की आवश्यकता को समाप्त करता है। ZooKeeper एक स्वतंत्र ओपन-सोर्स प्रोजेक्ट है और मूल Kafka घटक नहीं है।
प्रोड्यूसर्स
Kafka प्रोड्यूसर एक क्लाइंट एप्लिकेशन है जो Kafka के लिए डेटा स्रोत के रूप में कार्य करता है, और ब्रोकर्स से स्थायी TCP कनेक्शनों के माध्यम से एक या अधिक Kafka टॉपिक्स पर रिकॉर्ड प्रकाशित करता है।
कई प्रोड्यूसर्स एक साथ उसी टॉपिक पर रिकॉर्ड भेज सकते हैं। Kafka टॉपिक्स केवल-एपेंड होते हैं, यानी प्रोड्यूसर्स नया डेटा लिख सकते हैं, लेकिन न तो प्रोड्यूसर्स और न ही कंज़्यूमर्स मौजूदा रिकॉर्ड को संशोधित या हटाते हैं, जिससे डेटा की अपरिवर्तनीयता सुनिश्चित होती है।
कंज़्यूमर्स
Kafka कंज़्यूमर एक क्लाइंट एप्लिकेशन है जो एक या अधिक Kafka टॉपिक्स को सब्सक्राइब करके रिकॉर्ड्स की स्ट्रीम को कंज़्यूम करता है। कंज़्यूमर्स आमतौर पर कंज़्यूमर ग्रुप्स में काम करते हैं, जहाँ रेकॉर्ड्स को पढ़ने और प्रोसेस करने का लोड कई कंज़्यूमर्स में बाँट दिया जाता है।
प्रत्येक कंज़्यूमर ऑफ़सेट बनाए रखकर स्ट्रीम में अपनी प्रगति को ट्रैक करता है, यह सुनिश्चित करते हुए कि कोई डेटा दो बार प्रोसेस न हो और अप्रोसेस्ड रिकॉर्ड न छूटें। Kafka कंज़्यूमर्स डेटा पाइपलाइन के अंतिम चरण के रूप में कार्य करते हैं, जहाँ रिकॉर्ड्स को प्रोसेस किया जाता है या डाउनस्ट्रीम सिस्टम्स को अग्रेषित किया जाता है।
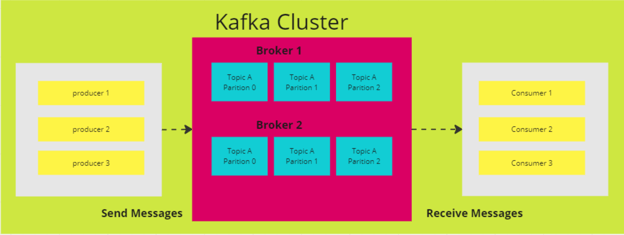
Apache Kafka का आर्किटेक्चर डायग्राम (चित्र: लेखक)
8. Kafka में लॉग कम्पैक्शन का प्राथमिक उद्देश्य क्या है? लॉग कम्पैक्शन Kafka कंज़्यूमर्स के प्रदर्शन को कैसे प्रभावित करता है?
Kafka में लॉग कम्पैक्शन का मुख्य उद्देश्य किसी टॉपिक के लॉग में प्रत्येक यूनिक कुंजी के लिए सबसे ताज़ा वैल्यू को बनाए रखना है, जिससे डेटा की नवीनतम अवस्था सुरक्षित रहे और स्टोरेज उपयोग कम हो। इससे कंज़्यूमर्स पुराने डुप्लिकेट प्रोसेस किए बिना वर्तमान वैल्यू को अधिक कुशलता से एक्सेस कर सकते हैं।
Kafka की पारंपरिक रिटेंशन पॉलिसी, जो एक निश्चित अवधि के बाद संदेशों को हटा देती है, के विपरीत, लॉग कम्पैक्शन प्रत्येक कुंजी के लिए सिर्फ पुराने रिकॉर्ड हटाता है और उस कुंजी की नवीनतम वैल्यू को बनाए रखता है। यह सुविधा कंज़्यूमर्स को हमेशा वर्तमान स्टेट तक पहुँच प्रदान करते हुए स्टोरेज दक्षता और तेज़ लुकअप के लिए कॉम्पैक्ट लॉग बनाए रखने में मदद करती है।
9. Kafka क्लस्टर में पार्टिशन और रेप्लिकाज़ में क्या अंतर है?
पार्टिशन और रेप्लिकाज़ Kafka की आर्किटेक्चर के प्रमुख घटक हैं, जो प्रदर्शन और फ़ॉल्ट टॉलरेंस दोनों सुनिश्चित करते हैं। पार्टिशन किसी टॉपिक को कई भागों में विभाजित कर थ्रूपुट बढ़ाते हैं, जिससे कंज़्यूमर्स अलग-अलग पार्टिशन से समानांतर में पढ़ सकते हैं, और Kafka की स्केलेबिलिटी व दक्षता में सुधार होता है।
रेप्लिकाज़ दूसरी ओर, कई ब्रोकर्स पर पार्टिशन की प्रतियाँ बनाकर रिडंडेंसी प्रदान करते हैं। यह फ़ॉल्ट टॉलरेंस सुनिश्चित करता है क्योंकि यदि लीडर ब्रोकर (जो किसी पार्टिशन के लिए रीड/राइट ऑपरेशन संभालता है) फेल हो जाए, तो फॉलोवर रेप्लिकाज़ में से एक को नए लीडर के रूप में प्रोमोट किया जा सकता है।
Kafka प्रत्येक पार्टिशन की कई प्रतियाँ बनाए रखता है ताकि उच्च उपलब्धता और डेटा की दृढ़ता सुनिश्चित हो, जिससे विफलताओं के दौरान डेटा हानि का जोखिम कम से कम हो, हालांकि पूर्ण दृढ़ता रेप्लिकेशन सेटिंग्स पर निर्भर करती है।
10. Kafka में स्कीमा क्या है, और यह डिस्ट्रीब्यूटेड सिस्टम्स के लिए क्यों महत्वपूर्ण है?
Kafka में, स्कीमा डेटा की संरचना और फ़ॉर्मेट को परिभाषित करता है, जैसे CustomerID (integer), CustomerName (string), और Designation (string) जैसे फ़ील्ड्स।
Kafka जैसे डिस्ट्रीब्यूटेड सिस्टम्स में, डेटा का आदान-प्रदान करते समय त्रुटियों से बचने के लिए प्रोड्यूसर्स और कंज़्यूमर्स को डेटा फ़ॉर्मेट पर सहमत होना चाहिए। Kafka Schema Registry इन स्कीमाज़ को मैनेज और लागू करता है, यह सुनिश्चित करते हुए कि प्रोड्यूसर्स और कंज़्यूमर्स संगत संस्करणों का उपयोग करें।
Schema Registry स्कीमाज़ को स्टोर करता है (आम तौर पर Avro, Protobuf, या JSON Schema फ़ॉर्मेट में) और स्कीमा एवोल्यूशन का समर्थन करता है, जिससे डेटा फ़ॉर्मेट बदले जा सकते हैं बिना मौजूदा कंज़्यूमर्स को तोड़े। इससे स्कीमाज़ के विकसित होने पर भी सुचारू डेटा एक्सचेंज और सिस्टम विश्वसनीयता सुनिश्चित होती है।
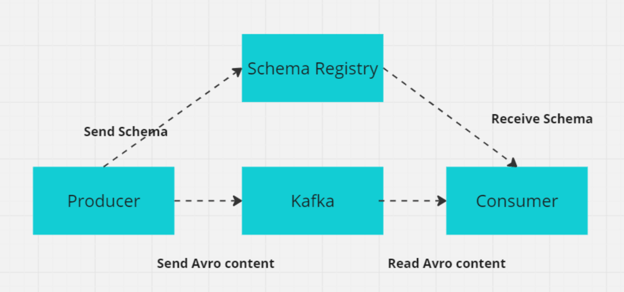
प्रोड्यूसर/कंज़्यूमर के साथ स्कीमा रजिस्ट्रि कैसे काम करती है (चित्र: लेखक)
एडवांस्ड Kafka इंटरव्यू प्रश्न
अधिक उन्नत Kafka उपयोगकर्ताओं के लिए, इंटरव्यू प्रश्न अधिक तकनीकी प्रकृति के होने की संभावना है।
11. Kafka संदेश हानि की रोकथाम कैसे सुनिश्चित करता है?
Kafka संदेश हानि को रोकने और विश्वसनीय संदेश डिलीवरी सुनिश्चित करने के लिए कई तंत्र अपनाता है:
- मैनुअल ऑफ़सेट कमिट: कंज़्यूमर्स ऑटोमैटिक ऑफ़सेट कमिट को डिसेबल कर सकते हैं और संदेशों को सफलतापूर्वक प्रोसेस करने के बाद मैन्युअली ऑफ़सेट कमिट कर सकते हैं, ताकि कंज़्यूमर क्रैश होने पर अप्रोसेस्ड संदेश न खोएँ।
- प्रोड्यूसर अcknowledgeमेंट (
acks=all): प्रोड्यूसर पर acks=all सेट करने से संदेश तब तक सफलतापूर्वक लिखे नहीं माने जाते जब तक सभी इन-सिंक रेप्लिकाज़ उन्हें स्वीकार न कर लें, जिससे ब्रोकर फेल्योर की स्थिति में संदेश हानि का जोखिम कम होता है।
- रिप्लिकेशन (
min.insync.replicas और replication.factor): Kafka प्रत्येक पार्टिशन के डेटा को कई ब्रोकर्स में रिप्लिकेट करता है। 1 से अधिक रिप्लिकेशन फ़ैक्टर फ़ॉल्ट टॉलरेंस सुनिश्चित करता है, जिससे ब्रोकर फेल होने पर भी डेटा उपलब्ध रहता है। min.insync.replicas सेटिंग यह सुनिश्चित करती है कि कोई संदेश लिखे जाने से पहले कम से कम निर्दिष्ट संख्या में रेप्लिकाज़ उसे स्वीकार करें, जिससे डेटा की दृढ़ता बेहतर होती है। उदाहरण के लिए, 3 के रिप्लिकेशन फ़ैक्टर के साथ, यदि एक ब्रोकर डाउन हो जाए, तो बाकी दो ब्रोकर्स पर डेटा उपलब्ध रहता है।
- प्रोड्यूसर रिट्राइज़: रिट्राइज़ को अधिक मान पर कॉन्फ़िगर करने से यह सुनिश्चित होता है कि अस्थायी विफलता होने पर प्रोड्यूसर्स संदेश भेजने का पुनः प्रयास करेंगे। सावधानीपूर्वक कॉन्फ़िगरेशन, जैसे
max.in.flight.requests.per.connection=1, के साथ मिलाकर यह संदेश रीऑर्डरिंग की संभावना कम करता है और सुनिश्चित करता है कि संदेश अंततः बिना खोए डिलीवर हो जाएँ।
12. Kafka RabbitMQ से कैसे भिन्न है?
Kafka और RabbitMQ दो लोकप्रिय मैसेजिंग सिस्टम हैं और आर्किटेक्चर तथा उपयोग के लिहाज़ से अलग हैं। प्रमुख क्षेत्रों में उनकी तुलना इस प्रकार है:
1. उपयोग और डिज़ाइन
Kafka बड़े पैमाने पर डेटा स्ट्रीम और रियल-टाइम पाइपलाइनों को संभालने के लिए डिज़ाइन किया गया है, उच्च थ्रूपुट और कम विलंबता के लिए अनुकूलित। इसका लॉग-आधारित आर्किटेक्चर दृढ़ता सुनिश्चित करता है और डेटा को पुनः प्रोसेस करने की अनुमति देता है, जिससे यह इवेंट सोर्सिंग और स्ट्रीम प्रोसेसिंग जैसे उपयोग मामलों के लिए आदर्श बनता है।
RabbitMQ एक जनरल-पर्पज़ मैसेज ब्रोकर है जो जटिल रूटिंग का समर्थन करता है और आम तौर पर माइक्रोसर्विसेज़ के बीच मैसेजिंग या वर्कर्स के बीच टास्क वितरित करने के लिए उपयोग किया जाता है। यह ऐसे वातावरणों में उत्कृष्ट है जहाँ विश्वसनीय संदेश डिलीवरी, रूटिंग में लचीलापन और सेवाओं के बीच इंटरेक्शन आवश्यक होता है।
2. आर्किटेक्चर
Kafka संदेशों को टॉपिक्स में वर्गीकृत करता है, जिन्हें पार्टिशन में विभाजित किया जाता है। प्रत्येक पार्टिशन को कई कंज़्यूमर्स प्रोसेस कर सकते हैं, जिससे पैरेलल प्रोसेसिंग और स्केलिंग संभव होती है। डेटा डिस्क पर कॉन्फ़िगरेबल रिटेंशन अवधि के साथ संग्रहीत होता है, जिससे दृढ़ता सुनिश्चित होती है और आवश्यकता पड़ने पर संदेशों को पुनः प्रोसेस किया जा सकता है।
RabbitMQ संदेशों को क्यूज़ में भेजता है, जहाँ उन्हें एक या अधिक कंज़्यूमर्स द्वारा कंज़्यूम किया जाता है। यह संदेश अcknowledgeमेंट, रिट्राइज़ और फेल संदेशों को संभालने के लिए डेड-लेटर एक्सचेंज के माध्यम से विश्वसनीय डिलीवरी सुनिश्चित करता है। यह आर्किटेक्चर संदेश अखंडता और रूटिंग की लचीलापन पर केंद्रित है।
3. प्रदर्शन और स्केलेबिलिटी
Kafka ब्रोकर्स और पार्टिशन जोड़कर क्षैतिज स्केलेबिलिटी के लिए बनाया गया है, जिससे यह प्रति सेकंड लाखों संदेशों को संभाल सकता है। इसकी आर्किटेक्चर पैरेलल प्रोसेसिंग और उच्च थ्रूपुट का समर्थन करती है, जो इसे बड़े पैमाने पर डेटा स्ट्रीमिंग के लिए उपयुक्त बनाती है।
RabbitMQ स्केल हो सकता है, हालांकि बहुत बड़े डेटा वॉल्यूम के मामले में Kafka जितना कुशल नहीं। यह मध्यम से उच्च थ्रूपुट परिदृश्यों के लिए उपयुक्त है, लेकिन बड़े पैमाने की स्ट्रीमिंग एप्लिकेशन में Kafka जितने अत्यधिक थ्रूपुट के लिए अनुकूलित नहीं है।
सार: Kafka और RabbitMQ दोनों मैसेजिंग के लिए शक्तिशाली टूल हैं, लेकिन वे अलग-अलग उपयोग मामलों में उत्कृष्टता दिखाते हैं। Kafka उच्च थ्रूपुट, रियल-टाइम डेटा स्ट्रीमिंग और इवेंट सोर्सिंग एप्लिकेशन के लिए आदर्श है जहाँ बड़े पैमाने पर पैरेलल प्रोसेसिंग की आवश्यकता होती है।
RabbitMQ विश्वसनीय संदेश डिलीवरी, माइक्रोसर्विस आर्किटेक्चर में टास्क डिस्ट्रीब्यूशन और जटिल मैसेज रूटिंग के लिए उपयुक्त है। यह उन परिदृश्यों में उत्कृष्ट है जहाँ सेवाओं के बीच लूज़ कप्लिंग, असिंक्रोनस प्रोसेसिंग और विश्वसनीयता आवश्यक होती है।
13. माइक्रोसर्विस-आधारित एप्लिकेशन विकसित करने में Kafka कैसे मदद करता है?
Apache Kafka रियल-टाइम डेटा हैंडलिंग, इवेंट-ड्रिवन कम्युनिकेशन, और विश्वसनीय मैसेजिंग की क्षमताओं के कारण माइक्रोसर्विस आर्किटेक्चर बनाने के लिए एक मूल्यवान टूल है। Kafka माइक्रोसर्विस विकास को इस प्रकार समर्थन देता है:
1. इवेंट-ड्रिवन आर्किटेक्चर
- सेवा डिकप्लिंग: Kafka सेवाओं को डायरेक्ट कॉल्स के बजाय इवेंट्स के माध्यम से संचार करने देता है, जिससे उनके बीच निर्भरताएँ कम होती हैं। यह डिकप्लिंग सेवाओं को स्वतंत्र रूप से इवेंट्स प्रोड्यूस और कंज़्यूम करने में सक्षम बनाती है, जिससे विकास और मेंटेनेंस सरल होता है।
- असिंक्रोनस प्रोसेसिंग: सेवाएँ इवेंट प्रकाशित कर सकती हैं और अन्य सेवाओं की प्रतिक्रिया की प्रतीक्षा किए बिना आगे बढ़ सकती हैं, जिससे सिस्टम की प्रतिक्रियाशीलता और दक्षता बढ़ती है।
2. स्केलेबिलिटी
- क्षैतिज स्केलेबिलिटी: Kafka ब्रोकर्स और पार्टिशन में लोड वितरित करके बड़ी डेटा मात्रा संभाल सकता है। प्रत्येक पार्टिशन को अलग-अलग कंज़्यूमर इंस्टेंसेज़ प्रोसेस कर सकती हैं, जिससे सिस्टम क्षैतिज रूप से स्केल होता है।
- पैरेलल कंज़म्पशन: कई कंज़्यूमर्स अलग-अलग पार्टिशन से एक साथ पढ़ सकते हैं, जिससे थ्रूपुट और परफॉर्मेंस बढ़ता है।
3. विश्वसनीयता और फ़ॉल्ट टॉलरेंस
- डेटा रिप्लिकेशन: Kafka डेटा को कई ब्रोकर्स में रिप्लिकेट करता है, जिससे उच्च उपलब्धता और फ़ॉल्ट टॉलरेंस सुनिश्चित होता है। यदि एक ब्रोकर फेल हो जाए, तो दूसरा रिप्लिकेटेड डेटा के साथ कार्य संभाल सकता है। Kafka डेटा को डिस्क पर कॉन्फ़िगरेबल रिटेंशन के साथ स्टोर करता है, जिससे इवेंट्स न खोएँ और आवश्यकता पड़ने पर पुनः प्रोसेस किए जा सकें।
4. डेटा इंटीग्रेशन
- केंद्रीय डेटा हब: Kafka माइक्रोसर्विस आर्किटेक्चर के भीतर डेटा प्रवाह के लिए एक केंद्रीय हब की तरह काम करता है, विभिन्न डेटा स्रोतों और सिंक के बीच इंटीग्रेशन को सुगम बनाता है। इससे सेवाओं में डेटा स्थिरता बनाए रखना सरल हो जाता है।
- Kafka Connect: Kafka Connect कई डेटाबेस, की-वैल्यू स्टोर्स, सर्च इंडेक्स और अन्य सिस्टम्स के साथ Kafka को इंटीग्रेट करने के लिए कनेक्टर्स प्रदान करता है, जिससे माइक्रोसर्विसेज़ और बाहरी सिस्टम्स के बीच डेटा मूवमेंट आसान होता है।
14. Kafka Zookeeper क्या है, और यह कैसे काम करता है?
Apache ZooKeeper एक ओपन-सोर्स सेवा है जो डिस्ट्रीब्यूटेड सिस्टम्स में कॉन्फ़िगरेशन डेटा, सिंक्रोनाइज़ेशन और ग्रुप सेवाओं के समन्वय और प्रबंधन में मदद करती है। Kafka के पुराने संस्करणों में, ZooKeeper मेटाडेटा प्रबंधन, लीडर इलेक्शन और ब्रोकर समन्वय में महत्वपूर्ण भूमिका निभाता था।
हालाँकि, Kafka संस्करण 2.8 से KRaft मोड में संक्रमण कर रहा है, जो ZooKeeper की आवश्यकता को समाप्त करता है। ZooKeeper अब अप्रासंगिक माना जाता है और 4.0 रिलीज़ (अपेक्षित 2024) में हटा दिया जाएगा।
ZooKeeper डेटा को "znode" नामक नोड्स की पदानुक्रमित संरचना में संग्रहीत करता है, जहाँ प्रत्येक znode मेटाडेटा स्टोर कर सकता है और फाइल सिस्टम के समान चाइल्ड znodes रख सकता है। यह संरचना Kafka ब्रोकर्स, टॉपिक्स और पार्टिशन से संबंधित मेटाडेटा बनाए रखने के लिए महत्वपूर्ण है। ZooKeeper का क्वरम-आधारित मैकेनिज़्म स्थिरता सुनिश्चित करता है: किसी भी बदलाव पर अधिकांश नोड्स (क्वरम) की सहमति आवश्यक होती है, जो ZooKeeper को अत्यधिक विश्वसनीय और फ़ॉल्ट-टॉलरेंट बनाती है।
Kafka के पुराने संस्करणों में, ZooKeeper कई महत्वपूर्ण कार्यों के लिए उपयोग होता है:
- लीडर इलेक्शन: ZooKeeper एक कंट्रोलर नोड का चुनाव करता है, जो पार्टिशन लीडर असाइनमेंट और अन्य क्लस्टर-व्यापी कार्यों का प्रबंधन करता है।
- ब्रोकर मेटाडेटा प्रबंधन: यह सक्रिय ब्रोकर्स और उनकी स्थिति की केंद्रीकृत रजिस्ट्री बनाए रखता है।
- पार्टिशन रीअसाइनमेंट: विफलताओं या क्लस्टर विस्तार के दौरान ब्रोकर्स के बीच पार्टिशन के रीबैलेंसिंग का प्रबंधन करने में ZooKeeper मदद करता है।
ZooKeeper का ZAB प्रोटोकॉल (ZooKeeper Atomic Broadcast) नेटवर्क पार्टिशन जैसी परिस्थितियों में भी नोड्स के बीच स्थिरता की गारंटी देता है, जिससे Kafka फ़ॉल्ट-टॉलरेंट बना रहता है। यह स्थिरता और विश्वसनीयता Kafka की डिस्ट्रीब्यूटेड प्रकृति के प्रबंधन के लिए ZooKeeper को महत्वपूर्ण बनाती है, हालांकि KRaft के डिफ़ॉल्ट मोड बनने के साथ भविष्य में Kafka की आर्किटेक्चर ZooKeeper पर कम निर्भर होगी।
15. आप Kafka में डिस्क उपयोग कैसे कम कर सकते हैं?
Kafka डिस्क उपयोग को प्रभावी ढंग से कम करने के कई तरीके प्रदान करता है। यहाँ प्रमुख रणनीतियाँ हैं:
1. लॉग रिटेंशन सेटिंग्स समायोजित करें
डिस्क पर संदेशों को बनाए रखने का समय कम करने के लिए लॉग रिटेंशन पॉलिसी संशोधित करें। यह retention.ms (समय-आधारित रिटेंशन) या retention.bytes (आकार-आधारित रिटेंशन) को समायोजित करके किया जा सकता है ताकि Kafka पुराने संदेशों को हटाने से पहले कितने समय तक या कितना डेटा स्टोर करेगा, उसे सीमित किया जा सके।
2. लॉग कम्पैक्शन लागू करें
प्रत्येक यूनिक कुंजी के लिए केवल सबसे हालिया संदेश बनाए रखने के लिए लॉग कम्पैक्शन का उपयोग करें, जिससे पुराना या अनावश्यक डेटा हट जाए। यह विशेष रूप से उन परिदृश्यों में उपयोगी है जहाँ केवल नवीनतम स्टेट मायने रखती है, और महत्वपूर्ण जानकारी खोए बिना डिस्क स्पेस उपयोग घटता है।
3. क्लीनअप पॉलिसीज़ कॉन्फ़िगर करें
अपने उपयोग मामले के आधार पर प्रभावी क्लीनअप पॉलिसीज़ सेट करें। आप समय-आधारित (retention.ms) और आकार-आधारित (retention.bytes) दोनों रिटेंशन पॉलिसीज़ कॉन्फ़िगर कर सकते हैं ताकि पुराने संदेश स्वतः हटते रहें और Kafka का डिस्क फ़ुटप्रिंट नियंत्रित रहे।
4. संदेशों को कंप्रेस करें
प्रोड्यूसर साइड पर GZIP, Snappy, या LZ4 जैसे फ़ॉर्मैट का उपयोग करके संदेश कंप्रेशन सक्षम करें। कंप्रेशन से संदेश आकार घटता है, जिससे डिस्क स्पेस की खपत कम होती है। हालाँकि, कंप्रेशन और डीकंप्रेशन के कारण CPU ओवरहेड बढ़ने-घटने के संतुलन पर विचार करना महत्वपूर्ण है।
5. लॉग सेगमेंट आकार समायोजित करें
Kafka के लॉग सेगमेंट आकार (segment.bytes) को कॉन्फ़िगर करें ताकि लॉग सेगमेंट कितनी बार रोल हों, इसे नियंत्रित किया जा सके। छोटे सेगमेंट आकार अधिक बार लॉग रोलिंग की अनुमति देते हैं, जो पुराने डेटा के त्वरित डिलीशन को सक्षम कर अधिक कुशल डिस्क उपयोग में मदद कर सकते हैं।
6. अनावश्यक टॉपिक्स या पार्टिशन हटाएँ
समय-समय पर अप्रयुक्त या अनावश्यक टॉपिक्स और पार्टिशनों की समीक्षा करें और उन्हें हटा दें। इससे डिस्क स्पेस खाली होता है और Kafka का डिस्क उपयोग नियंत्रण में रहता है।
डेटा इंजीनियर्स के लिए Kafka इंटरव्यू प्रश्न
यदि आप डेटा इंजीनियर पद के लिए इंटरव्यू दे रहे हैं, तो आप निम्नलिखित Kafka इंटरव्यू प्रश्नों के लिए तैयारी करना चाहेंगे।
16. Kafka में लीडर रेप्लिका और फॉलोवर रेप्लिका में क्या अंतर है?
लीडर रेप्लिका
लीडर रेप्लिका सभी क्लाइंट रीड और राइट अनुरोधों को संभालती है। यह पार्टिशन की स्टेट मैनेज करती है और प्रोड्यूसर्स तथा कंज़्यूमर्स के लिए प्राथमिक इंटरेक्शन पॉइंट होती है। यदि लीडर फेल हो जाए, तो उपलब्धता बनाए रखने के लिए उसका रोल किसी फॉलोवर रेप्लिका को ट्रांसफ़र कर दिया जाता है।
फॉलोवर रेप्लिका
फॉलोवर रेप्लिका लीडर से डेटा रिप्लिकेट करती है लेकिन सीधे क्लाइंट अनुरोध हैंडल नहीं करती। इसका कार्य पार्टिशन के डेटा की अप-टू-डेट कॉपी रखकर फ़ॉल्ट टॉलरेंस सुनिश्चित करना है। Kafka 2.4 से, कुछ शर्तों के तहत फॉलोवर रेप्लिकाज़ रीड अनुरोध भी संभाल सकती हैं ताकि लोड वितरित हो और रीड थ्रूपुट में सुधार हो। लीडर फेल होने पर, डेटा संगति और उपलब्धता बनाए रखने के लिए किसी फॉलोवर को नया लीडर चुना जाता है।
17. हम Kafka में क्लस्टर्स का उपयोग क्यों करते हैं, और उनके क्या लाभ हैं?
Kafka क्लस्टर कई ब्रोकर्स से मिलकर बना होता है जो डेटा को कई इंस्टेंस में वितरित करते हैं, जिससे बिना डाउनटाइम के स्केलेबिलिटी संभव होती है। ये क्लस्टर्स विलंब को न्यूनतम करने के लिए डिज़ाइन किए गए हैं, और यदि प्राथमिक क्लस्टर फेल हो जाए तो अन्य Kafka क्लस्टर्स सेवा निरंतरता बनाए रखने के लिए कार्य संभाल सकते हैं।
Kafka क्लस्टर की आर्किटेक्चर में टॉपिक्स, ब्रोकर्स, प्रोड्यूसर्स और कंज़्यूमर्स शामिल हैं। यह डेटा स्ट्रीम्स का कुशलतापूर्वक प्रबंधन करता है, जिससे यह बिग डेटा एप्लिकेशन और डेटा-ड्रिवन एप्लिकेशन विकास के लिए आदर्श बनता है।
18. Kafka संदेशों का क्रम कैसे सुनिश्चित करता है?
Kafka दो प्रमुख तरीकों से संदेशों का क्रम सुनिश्चित करता है:
- मैसेज कीज़ का उपयोग: जब किसी संदेश को एक कुंजी दी जाती है, तो उसी कुंजी वाले सभी संदेश एक ही पार्टिशन में भेजे जाते हैं। इससे सुनिश्चित होता है कि समान कुंजी वाले संदेश उसी क्रम में प्रोसेस हों जिसमें वे प्राप्त हुए हैं, क्योंकि Kafka प्रत्येक पार्टिशन के भीतर क्रम को संरक्षित रखता है।
- सिंगल-थ्रेडेड कंज़्यूमर प्रोसेसिंग: क्रम बनाए रखने के लिए कंज़्यूमर को किसी पार्टिशन से संदेशों को एक ही थ्रेड में प्रोसेस करना चाहिए। यदि कई थ्रेड्स का उपयोग किया जाता है, तो समांतर हैंडलिंग के दौरान सही क्रम में प्रोसेसिंग सुनिश्चित करने के लिए प्रत्येक पार्टिशन के लिए अलग इन-मेमोरी क्यू स्थापित करें।
19. Kafka में ISR और AR क्या दर्शाते हैं? ISR विस्तार का क्या अर्थ है?
ISR (इन-सिंक रेप्लिकाज़)
ISR वे रेप्लिकाज़ हैं जो लीडर रेप्लिका के साथ पूरी तरह से सिंक्रोनाइज़्ड हैं। इन रेप्लिकाज़ के पास नवीनतम डेटा होता है और इन्हें रीड व राइट ऑपरेशनों के लिए विश्वसनीय माना जाता है।
AR (असाइंड रेप्लिकाज़)
AR में किसी पार्टिशन को असाइन की गई सभी रेप्लिकाज़ शामिल होती हैं, चाहे वे इन-सिंक हों या आउट-ऑफ-सिंक। यह किसी पार्टिशन के लिए रेप्लिकाज़ के पूरे सेट का प्रतिनिधित्व करता है।
ISR विस्तार
ISR विस्तार तब होता है जब नई रेप्लिकाज़ लीडर के साथ कैच-अप कर लेती हैं और ISR सूची में जोड़ दी जाती हैं। इससे अप-टू-डेट रेप्लिकाज़ की संख्या बढ़ती है, जिससे फ़ॉल्ट टॉलरेंस और विश्वसनीयता में सुधार होता है।
20. Kafka में ज़ीरो-कॉपी का उपयोग परिदृश्य क्या है?
Kafka प्रोड्यूसर्स और कंज़्यूमर्स के बीच बड़े पैमाने पर डेटा को कुशलतापूर्वक ट्रांसफ़र करने के लिए ज़ीरो-कॉपी का उपयोग करता है। यह FileChannel.transferTo मेथड का लाभ उठाता है ताकि डेटा को फाइल सिस्टम से नेटवर्क सॉकेट्स तक सीधे स्थानांतरित किया जा सके, अतिरिक्त कॉपीिंग के बिना, जिससे परफॉर्मेंस और थ्रूपुट में सुधार होता है।
यह तकनीक इंडेक्स फाइलों को पढ़ने के लिए मेमोरी-मैप्ड फाइल्स (mmap) का उपयोग करती है, जिससे डेटा बफ़र्स को यूज़र स्पेस और कर्नेल स्पेस के बीच साझा किया जा सके, और अतिरिक्त डेटा कॉपी की आवश्यकता और कम हो। इससे Kafka बड़े पैमाने की रियल-टाइम डेटा स्ट्रीम्स को कुशलतापूर्वक संभालने के लिए उपयुक्त बनता है।
अपने Kafka इंटरव्यू की तैयारी
Kafka-केंद्रित डेटा इंजीनियरिंग इंटरव्यू की तैयारी करते समय, मज़बूत तकनीकी नींव और यह स्पष्ट समझ दोनों होना महत्वपूर्ण है कि Kafka आधुनिक सिस्टम्स में कैसे एकीकृत होता है। Kafka कई रियल-टाइम डेटा प्लेटफ़ॉर्म्स के केंद्र में है, इसलिए इंटरव्यूअर्स आपसे बुनियादी बातों के साथ-साथ यह भी अपेक्षा करेंगे कि आप स्केलेबल, फ़ॉल्ट-टॉलरेंट परिवेशों में Kafka के काम करने के तरीके को जानते हों।
ध्यान केंद्रित करने के प्रमुख क्षेत्र
जैसा कि हमने यहाँ कवर किए गए Kafka इंटरव्यू प्रश्नों में देखा, कई प्रमुख क्षेत्र हैं जिन पर आपको तैयारी करनी होगी:
- आर्किटेक्चर: Kafka की आर्किटेक्चर, जिसमें ब्रोकर्स, पार्टिशन और प्रोड्यूसर्स व कंज़्यूमर्स के बीच इंटरेक्शन शामिल हैं, पर आत्मविश्वास से चर्चा करें। आपको Kafka की संदेश डिलीवरी गारंटी—जैसे "at-least-once" या "exactly-once" डिलीवरी—और In-Sync Replicas (ISR) जैसी विशेषताओं के माध्यम से Kafka संदेश क्रम कैसे सुनिश्चित करता है, यह भी समझाना चाहिए।
- इंटीग्रेशन: समझें कि Kafka अन्य सिस्टम्स के साथ Kafka Connect जैसे टूल्स का उपयोग करके कैसे इंटीग्रेट होता है, जो डेटाबेस, की-वैल्यू स्टोर्स, और अन्य सिस्टम्स को जोड़ता है। इंटरव्यूअर्स माइक्रोसर्विसेज़ या डिस्ट्रीब्यूटेड सिस्टम्स में डेटा स्थिरता बनाए रखने में Kafka की भूमिका के बारे में पूछ सकते हैं।
- मॉनिटरिंग और ट्रबलशूटिंग: Kafka Manager और Prometheus जैसे मॉनिटरिंग टूल्स से परिचित रहें। आपको Kafka क्लस्टर्स को प्रभावी ढंग से प्रबंधित और ऑप्टिमाइज़ करने की अपनी क्षमता दिखानी होगी।
- समस्या-समाधान: ऐसे मैसेजिंग सॉल्यूशंस डिज़ाइन करने के लिए तैयार रहें जो वास्तविक दुनिया की चुनौतियों को हल करें, जैसे बड़े डेटा फ्लो को संभालना या संदेश विश्वसनीयता सुनिश्चित करना। इंटरव्यूअर्स आपको हाइपोथेटिकल परिदृश्य दे सकते हैं जहाँ आपको Kafka परफॉर्मेंस को ट्रबलशूट या ऑप्टिमाइज़ करना होगा।
- कम्युनिकेशन: Kafka जटिल है, इसलिए आपको अपने डिज़ाइन निर्णयों या ट्रबलशूटिंग चरणों को स्पष्ट रूप से समझाने में सक्षम होना चाहिए—चाहे वह तकनीकी टीम हो या बिज़नेस स्टेकहोल्डर्स। मज़बूत संचार कौशल आपको अलग पहचान दिलाएगा।
- हैंड्स-ऑन अनुभव: किसी भी व्यावहारिक अनुभव पर प्रकाश डालें, जैसे Kafka क्लस्टर्स सेट करना, डेटा रिटेंशन मैनेज करना, या Kafka को अन्य टूल्स के साथ इंटीग्रेट करना। व्यावहारिक ज्ञान को अत्यधिक महत्व दिया जाता है।
- निरंतर सीखना: Kafka की नवीनतम विशेषताओं और सर्वोत्तम प्रथाओं से अपडेटेड रहें। डॉक्युमेंटेशन पढ़ना या ओपन-सोर्स प्रोजेक्ट्स में योगदान करना आपके सतत सीखने के प्रति समर्पण को दर्शाता है।
इंटरव्यू टिप्स
यहाँ इंटरव्यू में उत्कृष्ट प्रदर्शन सुनिश्चित करने के लिए कुछ शीर्ष सुझाव हैं:
- कंपनी, उद्योग और अपने इंटरव्यूअर की पृष्ठभूमि पर रिसर्च करें।
- विभिन्न इंटरव्यू राउंड्स (टेक्निकल, HR, फ़ोन और इन-पर्सन) के लिए अनुकूलित दृष्टिकोण के साथ तैयारी करें।
- नियमित रूप से इन तकनीकी संसाधनों की समीक्षा करें:
इन कौशलों को निखारकर और प्रभावी तैयारी करके, आप Kafka-संबंधित इंटरव्यूज़ के लिए अच्छी तरह से सुसज्जित होंगे। याद रखें, इंटरव्यूअर्स केवल तकनीकी विशेषज्ञता ही नहीं, बल्कि स्पष्ट संचार और वास्तविक दुनिया की समस्या-समाधान क्षमता भी देखते हैं। इंटरव्यू प्रक्रिया के दौरान डेटा इंजीनियरिंग के प्रति अपना जुनून दिखाएँ।


डेटा के प्रवाह को समझना और उसकी क्षमता का उपयोग करना आधुनिक संगठनों के लिए अत्यंत महत्वपूर्ण हो गया है। आधुनिक एप्लिकेशन परिदृश्य में रियल-टाइम डेटा स्ट्रीम को इनजेस्ट करने, संग्रहीत करने और प्रोसेस करने के लिए Kafka अग्रणी प्लेटफ़ॉर्म है।
इस पोस्ट में, हम कुछ Kafka इंटरव्यू प्रश्नों की रूपरेखा प्रस्तुत करेंगे और डेटा प्रोसेसिंग में इस टूल की महत्वपूर्ण भूमिका पर चर्चा करेंगे। हम बुनियादी से लेकर उन्नत तक विभिन्न स्तरों के इंटरव्यू प्रश्नों का अन्वेषण करेंगे और प्रभावी तैयारी के सुझाव देंगे। यदि आप Kafka में नए हैं, तो हमारा Introduction to Apache Kafka कोर्स अवश्य देखें।
बेसिक Kafka इंटरव्यू प्रश्न
ये प्रश्न Kafka को डेटा इंजीनियरिंग टूल के रूप में आपकी बुनियादी समझ को परखेंगे।
1. Apache Kafka क्या है?
Apache Kafka एक शक्तिशाली, ओपन-सोर्स, डिस्ट्रीब्यूटेड इवेंट-स्ट्रीमिंग प्लेटफ़ॉर्म है। मूल रूप से LinkedIn द्वारा मैसेजिंग क्यू के रूप में विकसित, यह विभिन्न परिदृश्यों में डेटा स्ट्रीम को संभालने वाले टूल के रूप में विकसित हो चुका है।
Kafka की डिस्ट्रीब्यूटेड सिस्टम आर्किटेक्चर क्षैतिज स्केलेबिलिटी की अनुमति देती है, जिससे कंज़्यूमर अपने अनुसार गति से संदेश प्राप्त कर सकते हैं और क्लस्टर में Kafka नोड्स (सर्वर) जोड़ना आसान हो जाता है।
Kafka कम विलंबता के साथ बड़े पैमाने पर डेटा को तेज़ी से प्रोसेस करने के लिए डिज़ाइन किया गया है। यद्यपि यह Scala और Java में लिखा गया है, यह विभिन्न प्रोग्रामिंग भाषाओं का समर्थन करता है।
Apache Kafka एक डिस्ट्रीब्यूटेड लॉग कलेक्टर की तरह कार्य करता है, जहाँ लॉग संदेशों को की-वैल्यू पेयर्स के रूप में केवल-एपेंड लॉग फ़ाइल में टिकाऊ, दीर्घकालिक स्टोरेज और पुनर्प्राप्ति के लिए संग्रहीत किया जाता है। पारंपरिक मैसेज क्यू जैसे RabbitMQ, जो संदेशों को कंज़्यूम होने के बाद हटा देते हैं, के विपरीत Kafka संदेशों को एक कॉन्फ़िगरेबल अवधि तक बनाए रखता है, जिससे यह डेटा रिप्ले या इवेंट सोर्सिंग जैसी आवश्यकताओं के लिए आदर्श बनता है।
जहाँ RabbitMQ बिना लंबे समय तक स्टोरेज के रियल-टाइम संदेश डिलीवरी पर केंद्रित है, वहीं Kafka की रिटेंशन पॉलिसी अधिक जटिल, डेटा-चालित एप्लिकेशन का समर्थन करती है।
Kafka के सामान्य उपयोग मामलों में एप्लिकेशन ट्रैकिंग, लॉग एग्रीगेशन, और मैसेजिंग शामिल हैं, हालांकि इसमें क्वेरीिंग और इंडेक्सिंग जैसी पारंपरिक डेटाबेस विशेषताएँ नहीं हैं। इसकी ताकत रियल-टाइम डेटा स्ट्रीम को संभालने में है, जो इसे डिस्ट्रीब्यूटेड सिस्टम और रियल-टाइम एनालिटिक्स के लिए अपरिहार्य बनाती है।
2. Kafka की कुछ विशेषताएँ क्या हैं?
Apache Kafka एक ओपन-सोर्स डिस्ट्रीब्यूटेड स्ट्रीमिंग प्लेटफ़ॉर्म है, जिसका व्यापक रूप से रियल-टाइम डेटा पाइपलाइनों और स्ट्रीमिंग एप्लिकेशन बनाने में उपयोग होता है। यह निम्नलिखित विशेषताएँ प्रदान करता है:
1. उच्च थ्रूपुट
Kafka विशाल मात्रा में डेटा संभालने में सक्षम है। इसे स्रोत क्लाइंट्स से सैकड़ों गीगाबाइट को कुशलतापूर्वक पढ़ने और लिखने के लिए डिज़ाइन किया गया है।
2. डिस्ट्रीब्यूटेड आर्किटेक्चर
Apache Kafka में क्लस्टर-केंद्रित आर्किटेक्चर है और यह स्वाभाविक रूप से Kafka सर्वरों में संदेशों के पार्टिशनिंग का समर्थन करता है। यह डिज़ाइन कंज़्यूमर मशीनों के क्लस्टर में डिस्ट्रीब्यूटेड कंज़म्पशन को भी सक्षम करता है, जबकि प्रत्येक पार्टिशन के भीतर संदेशों के क्रम को संरक्षित रखता है। इसके अलावा, Kafka क्लस्टर बिना किसी डाउनटाइम के लोचदार और पारदर्शी रूप से स्केल कर सकता है।
3. विभिन्न क्लाइंट्स का समर्थन
Apache Kafka विभिन्न प्लेटफ़ॉर्म जैसे .NET, JAVA, PHP, और Python से क्लाइंट्स के इंटीग्रेशन का समर्थन करता है।
4. रियल-टाइम संदेश
Kafka रियल-टाइम संदेश उत्पन्न करता है जो कंज़्यूमर्स को दिखने चाहिए; यह जटिल इवेंट प्रोसेसिंग सिस्टम के लिए महत्वपूर्ण है।
Apache Kafka मैसेजिंग डिस्ट्रीब्यूटेड सिस्टम। (चित्र: लेखक)
3. Kafka में पार्टिशन कैसे काम करते हैं?
Kafka में, एक टॉपिक वह स्टोरेज स्पेस है जहाँ प्रोड्यूसर्स के सभी संदेश रखे जाते हैं। सामान्यतः, संबंधित डेटा अलग-अलग टॉपिक्स में संग्रहीत किया जाता है। उदाहरण के लिए, "transactions" नामक टॉपिक ई-कॉमर्स साइट पर उपयोगकर्ता की खरीदारी के विवरण संग्रहीत करेगा, जबकि "customers" नामक टॉपिक में ग्राहक संबंधी जानकारी होगी।
टॉपिक्स को पार्टिशन में विभाजित किया जाता है। डिफ़ॉल्ट रूप से, एक टॉपिक में एक पार्टिशन होता है, लेकिन आप इसे अधिक के लिए कॉन्फ़िगर कर सकते हैं। संदेश इन पार्टिशनों में वितरित होते हैं, प्रत्येक पार्टिशन का अपना ऑफ़सेट होता है और यह Kafka क्लस्टर के अलग-अलग सर्वरों पर संग्रहीत होता है।
उदाहरण के लिए, यदि किसी टॉपिक में तीन ब्रोकर्स पर तीन पार्टिशन हैं, और एक प्रोड्यूसर 15 संदेश भेजता है, तो संदेश क्रम में वितरित होंगे:
फिर चक्र दोहराया जाता है, रिकॉर्ड 4 वापस पार्टिशन 0 में जाएगा, और इसी तरह आगे।
4. आप अन्य मैसेजिंग सेवाओं की तुलना में Kafka क्यों चुनेंगे?
अन्य मैसेजिंग सेवाओं की तुलना में Kafka चुनना अक्सर इसकी विशिष्ट ताकतों पर निर्भर करता है, खासकर उन उपयोग मामलों के लिए जहाँ उच्च थ्रूपुट और रियल-टाइम डेटा प्रोसेसिंग की आवश्यकता होती है। यहाँ बताया गया है कि Kafka क्यों अलग है:
5. Apache Kafka द्वारा प्रदान किए गए सभी APIs समझाएँ।
API (एप्लिकेशन प्रोग्रामिंग इंटरफ़ेस) विभिन्न सेवाओं, माइक्रोसर्विसेज़ और सिस्टम्स के बीच संचार को सक्षम करता है। Kafka इवेंट स्ट्रीमिंग प्लेटफ़ॉर्म बनाने और उसके मैसेजिंग सिस्टम के साथ इंटरेक्ट करने के लिए APIs का एक सेट प्रदान करता है।
कोर Kafka APIs हैं:
ये APIs Kafka के भीतर डेटा के उत्पादन, उपभोग, प्रोसेसिंग और प्रबंधन को सहज बनाते हैं।
इंटरमीडिएट Kafka इंटरव्यू प्रश्न
ये प्रश्न उन अनुभवी प्रैक्टिशनर्स के लिए हैं जिन्हें Kafka के उपयोग की ठोस समझ है।
6. Kafka टॉपिक में पार्टिशन की संख्या बढ़ाने के क्या निहितार्थ हैं?
Kafka टॉपिक में पार्टिशन की संख्या बढ़ाने से अधिक कंज़्यूमर्स को समानांतर में पढ़ने की अनुमति देकर कंकरेन्सी और थ्रूपुट में सुधार हो सकता है। हालाँकि, इससे कुछ चुनौतियाँ भी आती हैं:
7. Kafka आर्किटेक्चर के चार घटकों की व्याख्या करें
Kafka कई प्रमुख घटकों से मिलकर बना एक डिस्ट्रीब्यूटेड आर्किटेक्चर है:
ब्रोकर्स नोड्स
Kafka की डिस्ट्रीब्यूटेड आर्किटेक्चर कई प्रमुख घटकों से मिलकर बनती है, जिनमें से एक है ब्रोकर नोड। ब्रोकर्स I/O ऑपरेशनों का मुख्य कार्य संभालते हैं और संदेशों के टिकाऊ स्टोरेज का प्रबंधन करते हैं। वे प्रोड्यूसर्स से डेटा प्राप्त करते हैं, उसे स्टोर करते हैं और कंज़्यूमर्स के लिए उपलब्ध कराते हैं। प्रत्येक ब्रोकर Kafka क्लस्टर का हिस्सा होता है और समन्वय में मदद के लिए एक यूनिक ID रखता है।
Kafka के पुराने संस्करणों में, क्लस्टर का प्रबंधन Zookeeper द्वारा किया जाता है, जो ब्रोकर्स के बीच उचित समन्वय सुनिश्चित करता है और पार्टिशन लोकेशन जैसी मेटाडेटा को ट्रैक करता है (हालाँकि Kafka इसके लिए आंतरिक KRaft मोड की ओर बढ़ रहा है)। Kafka ब्रोकर्स अत्यधिक स्केलेबल हैं और डिस्ट्रीब्यूटेड सिस्टम्स में संदेशों के बड़े पैमाने पर रीड और राइट अनुरोधों को संभालने में सक्षम हैं।
ZooKeeper नोड्स
ZooKeeper Kafka में एक महत्वपूर्ण भूमिका निभाता है, ब्रोकर रजिस्ट्रेशन का प्रबंधन करता है और Kafka कंट्रोलर का चुनाव करता है, जो क्लस्टर के प्रशासनिक संचालन संभालता है। ZooKeeper स्वयं एक क्लस्टर के रूप में कार्य करता है, जिसे एंसेंबल कहा जाता है, जहाँ कई प्रोसेस यह सुनिश्चित करने के लिए साथ काम करते हैं कि एक समय में केवल एक ब्रोकर कंट्रोलर के रूप में असाइन हो।
यदि वर्तमान कंट्रोलर फेल हो जाता है, तो ZooKeeper शीघ्र ही किसी नए ब्रोकर का चुनाव कर देता है। यद्यपि ZooKeeper Kafka आर्किटेक्चर का एक आवश्यक हिस्सा रहा है, Kafka एक नए KRaft मोड में परिवर्तन कर रहा है जो ZooKeeper की आवश्यकता को समाप्त करता है। ZooKeeper एक स्वतंत्र ओपन-सोर्स प्रोजेक्ट है और मूल Kafka घटक नहीं है।
प्रोड्यूसर्स
Kafka प्रोड्यूसर एक क्लाइंट एप्लिकेशन है जो Kafka के लिए डेटा स्रोत के रूप में कार्य करता है, और ब्रोकर्स से स्थायी TCP कनेक्शनों के माध्यम से एक या अधिक Kafka टॉपिक्स पर रिकॉर्ड प्रकाशित करता है।
कई प्रोड्यूसर्स एक साथ उसी टॉपिक पर रिकॉर्ड भेज सकते हैं। Kafka टॉपिक्स केवल-एपेंड होते हैं, यानी प्रोड्यूसर्स नया डेटा लिख सकते हैं, लेकिन न तो प्रोड्यूसर्स और न ही कंज़्यूमर्स मौजूदा रिकॉर्ड को संशोधित या हटाते हैं, जिससे डेटा की अपरिवर्तनीयता सुनिश्चित होती है।
कंज़्यूमर्स
Kafka कंज़्यूमर एक क्लाइंट एप्लिकेशन है जो एक या अधिक Kafka टॉपिक्स को सब्सक्राइब करके रिकॉर्ड्स की स्ट्रीम को कंज़्यूम करता है। कंज़्यूमर्स आमतौर पर कंज़्यूमर ग्रुप्स में काम करते हैं, जहाँ रेकॉर्ड्स को पढ़ने और प्रोसेस करने का लोड कई कंज़्यूमर्स में बाँट दिया जाता है।
प्रत्येक कंज़्यूमर ऑफ़सेट बनाए रखकर स्ट्रीम में अपनी प्रगति को ट्रैक करता है, यह सुनिश्चित करते हुए कि कोई डेटा दो बार प्रोसेस न हो और अप्रोसेस्ड रिकॉर्ड न छूटें। Kafka कंज़्यूमर्स डेटा पाइपलाइन के अंतिम चरण के रूप में कार्य करते हैं, जहाँ रिकॉर्ड्स को प्रोसेस किया जाता है या डाउनस्ट्रीम सिस्टम्स को अग्रेषित किया जाता है।
Apache Kafka का आर्किटेक्चर डायग्राम (चित्र: लेखक)
8. Kafka में लॉग कम्पैक्शन का प्राथमिक उद्देश्य क्या है? लॉग कम्पैक्शन Kafka कंज़्यूमर्स के प्रदर्शन को कैसे प्रभावित करता है?
Kafka में लॉग कम्पैक्शन का मुख्य उद्देश्य किसी टॉपिक के लॉग में प्रत्येक यूनिक कुंजी के लिए सबसे ताज़ा वैल्यू को बनाए रखना है, जिससे डेटा की नवीनतम अवस्था सुरक्षित रहे और स्टोरेज उपयोग कम हो। इससे कंज़्यूमर्स पुराने डुप्लिकेट प्रोसेस किए बिना वर्तमान वैल्यू को अधिक कुशलता से एक्सेस कर सकते हैं।
Kafka की पारंपरिक रिटेंशन पॉलिसी, जो एक निश्चित अवधि के बाद संदेशों को हटा देती है, के विपरीत, लॉग कम्पैक्शन प्रत्येक कुंजी के लिए सिर्फ पुराने रिकॉर्ड हटाता है और उस कुंजी की नवीनतम वैल्यू को बनाए रखता है। यह सुविधा कंज़्यूमर्स को हमेशा वर्तमान स्टेट तक पहुँच प्रदान करते हुए स्टोरेज दक्षता और तेज़ लुकअप के लिए कॉम्पैक्ट लॉग बनाए रखने में मदद करती है।
9. Kafka क्लस्टर में पार्टिशन और रेप्लिकाज़ में क्या अंतर है?
पार्टिशन और रेप्लिकाज़ Kafka की आर्किटेक्चर के प्रमुख घटक हैं, जो प्रदर्शन और फ़ॉल्ट टॉलरेंस दोनों सुनिश्चित करते हैं। पार्टिशन किसी टॉपिक को कई भागों में विभाजित कर थ्रूपुट बढ़ाते हैं, जिससे कंज़्यूमर्स अलग-अलग पार्टिशन से समानांतर में पढ़ सकते हैं, और Kafka की स्केलेबिलिटी व दक्षता में सुधार होता है।
रेप्लिकाज़ दूसरी ओर, कई ब्रोकर्स पर पार्टिशन की प्रतियाँ बनाकर रिडंडेंसी प्रदान करते हैं। यह फ़ॉल्ट टॉलरेंस सुनिश्चित करता है क्योंकि यदि लीडर ब्रोकर (जो किसी पार्टिशन के लिए रीड/राइट ऑपरेशन संभालता है) फेल हो जाए, तो फॉलोवर रेप्लिकाज़ में से एक को नए लीडर के रूप में प्रोमोट किया जा सकता है।
Kafka प्रत्येक पार्टिशन की कई प्रतियाँ बनाए रखता है ताकि उच्च उपलब्धता और डेटा की दृढ़ता सुनिश्चित हो, जिससे विफलताओं के दौरान डेटा हानि का जोखिम कम से कम हो, हालांकि पूर्ण दृढ़ता रेप्लिकेशन सेटिंग्स पर निर्भर करती है।
10. Kafka में स्कीमा क्या है, और यह डिस्ट्रीब्यूटेड सिस्टम्स के लिए क्यों महत्वपूर्ण है?
Kafka में, स्कीमा डेटा की संरचना और फ़ॉर्मेट को परिभाषित करता है, जैसे CustomerID (integer), CustomerName (string), और Designation (string) जैसे फ़ील्ड्स।
Kafka जैसे डिस्ट्रीब्यूटेड सिस्टम्स में, डेटा का आदान-प्रदान करते समय त्रुटियों से बचने के लिए प्रोड्यूसर्स और कंज़्यूमर्स को डेटा फ़ॉर्मेट पर सहमत होना चाहिए। Kafka Schema Registry इन स्कीमाज़ को मैनेज और लागू करता है, यह सुनिश्चित करते हुए कि प्रोड्यूसर्स और कंज़्यूमर्स संगत संस्करणों का उपयोग करें।
Schema Registry स्कीमाज़ को स्टोर करता है (आम तौर पर Avro, Protobuf, या JSON Schema फ़ॉर्मेट में) और स्कीमा एवोल्यूशन का समर्थन करता है, जिससे डेटा फ़ॉर्मेट बदले जा सकते हैं बिना मौजूदा कंज़्यूमर्स को तोड़े। इससे स्कीमाज़ के विकसित होने पर भी सुचारू डेटा एक्सचेंज और सिस्टम विश्वसनीयता सुनिश्चित होती है।
प्रोड्यूसर/कंज़्यूमर के साथ स्कीमा रजिस्ट्रि कैसे काम करती है (चित्र: लेखक)
एडवांस्ड Kafka इंटरव्यू प्रश्न
अधिक उन्नत Kafka उपयोगकर्ताओं के लिए, इंटरव्यू प्रश्न अधिक तकनीकी प्रकृति के होने की संभावना है।
11. Kafka संदेश हानि की रोकथाम कैसे सुनिश्चित करता है?
Kafka संदेश हानि को रोकने और विश्वसनीय संदेश डिलीवरी सुनिश्चित करने के लिए कई तंत्र अपनाता है:
acks=all): प्रोड्यूसर परacks=allसेट करने से संदेश तब तक सफलतापूर्वक लिखे नहीं माने जाते जब तक सभी इन-सिंक रेप्लिकाज़ उन्हें स्वीकार न कर लें, जिससे ब्रोकर फेल्योर की स्थिति में संदेश हानि का जोखिम कम होता है।min.insync.replicasऔरreplication.factor): Kafka प्रत्येक पार्टिशन के डेटा को कई ब्रोकर्स में रिप्लिकेट करता है। 1 से अधिक रिप्लिकेशन फ़ैक्टर फ़ॉल्ट टॉलरेंस सुनिश्चित करता है, जिससे ब्रोकर फेल होने पर भी डेटा उपलब्ध रहता है।min.insync.replicasसेटिंग यह सुनिश्चित करती है कि कोई संदेश लिखे जाने से पहले कम से कम निर्दिष्ट संख्या में रेप्लिकाज़ उसे स्वीकार करें, जिससे डेटा की दृढ़ता बेहतर होती है। उदाहरण के लिए, 3 के रिप्लिकेशन फ़ैक्टर के साथ, यदि एक ब्रोकर डाउन हो जाए, तो बाकी दो ब्रोकर्स पर डेटा उपलब्ध रहता है।max.in.flight.requests.per.connection=1, के साथ मिलाकर यह संदेश रीऑर्डरिंग की संभावना कम करता है और सुनिश्चित करता है कि संदेश अंततः बिना खोए डिलीवर हो जाएँ।12. Kafka RabbitMQ से कैसे भिन्न है?
Kafka और RabbitMQ दो लोकप्रिय मैसेजिंग सिस्टम हैं और आर्किटेक्चर तथा उपयोग के लिहाज़ से अलग हैं। प्रमुख क्षेत्रों में उनकी तुलना इस प्रकार है:
1. उपयोग और डिज़ाइन
Kafka बड़े पैमाने पर डेटा स्ट्रीम और रियल-टाइम पाइपलाइनों को संभालने के लिए डिज़ाइन किया गया है, उच्च थ्रूपुट और कम विलंबता के लिए अनुकूलित। इसका लॉग-आधारित आर्किटेक्चर दृढ़ता सुनिश्चित करता है और डेटा को पुनः प्रोसेस करने की अनुमति देता है, जिससे यह इवेंट सोर्सिंग और स्ट्रीम प्रोसेसिंग जैसे उपयोग मामलों के लिए आदर्श बनता है।
RabbitMQ एक जनरल-पर्पज़ मैसेज ब्रोकर है जो जटिल रूटिंग का समर्थन करता है और आम तौर पर माइक्रोसर्विसेज़ के बीच मैसेजिंग या वर्कर्स के बीच टास्क वितरित करने के लिए उपयोग किया जाता है। यह ऐसे वातावरणों में उत्कृष्ट है जहाँ विश्वसनीय संदेश डिलीवरी, रूटिंग में लचीलापन और सेवाओं के बीच इंटरेक्शन आवश्यक होता है।
2. आर्किटेक्चर
Kafka संदेशों को टॉपिक्स में वर्गीकृत करता है, जिन्हें पार्टिशन में विभाजित किया जाता है। प्रत्येक पार्टिशन को कई कंज़्यूमर्स प्रोसेस कर सकते हैं, जिससे पैरेलल प्रोसेसिंग और स्केलिंग संभव होती है। डेटा डिस्क पर कॉन्फ़िगरेबल रिटेंशन अवधि के साथ संग्रहीत होता है, जिससे दृढ़ता सुनिश्चित होती है और आवश्यकता पड़ने पर संदेशों को पुनः प्रोसेस किया जा सकता है।
RabbitMQ संदेशों को क्यूज़ में भेजता है, जहाँ उन्हें एक या अधिक कंज़्यूमर्स द्वारा कंज़्यूम किया जाता है। यह संदेश अcknowledgeमेंट, रिट्राइज़ और फेल संदेशों को संभालने के लिए डेड-लेटर एक्सचेंज के माध्यम से विश्वसनीय डिलीवरी सुनिश्चित करता है। यह आर्किटेक्चर संदेश अखंडता और रूटिंग की लचीलापन पर केंद्रित है।
3. प्रदर्शन और स्केलेबिलिटी
Kafka ब्रोकर्स और पार्टिशन जोड़कर क्षैतिज स्केलेबिलिटी के लिए बनाया गया है, जिससे यह प्रति सेकंड लाखों संदेशों को संभाल सकता है। इसकी आर्किटेक्चर पैरेलल प्रोसेसिंग और उच्च थ्रूपुट का समर्थन करती है, जो इसे बड़े पैमाने पर डेटा स्ट्रीमिंग के लिए उपयुक्त बनाती है।
RabbitMQ स्केल हो सकता है, हालांकि बहुत बड़े डेटा वॉल्यूम के मामले में Kafka जितना कुशल नहीं। यह मध्यम से उच्च थ्रूपुट परिदृश्यों के लिए उपयुक्त है, लेकिन बड़े पैमाने की स्ट्रीमिंग एप्लिकेशन में Kafka जितने अत्यधिक थ्रूपुट के लिए अनुकूलित नहीं है।
सार: Kafka और RabbitMQ दोनों मैसेजिंग के लिए शक्तिशाली टूल हैं, लेकिन वे अलग-अलग उपयोग मामलों में उत्कृष्टता दिखाते हैं। Kafka उच्च थ्रूपुट, रियल-टाइम डेटा स्ट्रीमिंग और इवेंट सोर्सिंग एप्लिकेशन के लिए आदर्श है जहाँ बड़े पैमाने पर पैरेलल प्रोसेसिंग की आवश्यकता होती है।
RabbitMQ विश्वसनीय संदेश डिलीवरी, माइक्रोसर्विस आर्किटेक्चर में टास्क डिस्ट्रीब्यूशन और जटिल मैसेज रूटिंग के लिए उपयुक्त है। यह उन परिदृश्यों में उत्कृष्ट है जहाँ सेवाओं के बीच लूज़ कप्लिंग, असिंक्रोनस प्रोसेसिंग और विश्वसनीयता आवश्यक होती है।
13. माइक्रोसर्विस-आधारित एप्लिकेशन विकसित करने में Kafka कैसे मदद करता है?
Apache Kafka रियल-टाइम डेटा हैंडलिंग, इवेंट-ड्रिवन कम्युनिकेशन, और विश्वसनीय मैसेजिंग की क्षमताओं के कारण माइक्रोसर्विस आर्किटेक्चर बनाने के लिए एक मूल्यवान टूल है। Kafka माइक्रोसर्विस विकास को इस प्रकार समर्थन देता है:
1. इवेंट-ड्रिवन आर्किटेक्चर
2. स्केलेबिलिटी
3. विश्वसनीयता और फ़ॉल्ट टॉलरेंस
4. डेटा इंटीग्रेशन
14. Kafka Zookeeper क्या है, और यह कैसे काम करता है?
Apache ZooKeeper एक ओपन-सोर्स सेवा है जो डिस्ट्रीब्यूटेड सिस्टम्स में कॉन्फ़िगरेशन डेटा, सिंक्रोनाइज़ेशन और ग्रुप सेवाओं के समन्वय और प्रबंधन में मदद करती है। Kafka के पुराने संस्करणों में, ZooKeeper मेटाडेटा प्रबंधन, लीडर इलेक्शन और ब्रोकर समन्वय में महत्वपूर्ण भूमिका निभाता था।
हालाँकि, Kafka संस्करण 2.8 से KRaft मोड में संक्रमण कर रहा है, जो ZooKeeper की आवश्यकता को समाप्त करता है। ZooKeeper अब अप्रासंगिक माना जाता है और 4.0 रिलीज़ (अपेक्षित 2024) में हटा दिया जाएगा।
ZooKeeper डेटा को "znode" नामक नोड्स की पदानुक्रमित संरचना में संग्रहीत करता है, जहाँ प्रत्येक znode मेटाडेटा स्टोर कर सकता है और फाइल सिस्टम के समान चाइल्ड znodes रख सकता है। यह संरचना Kafka ब्रोकर्स, टॉपिक्स और पार्टिशन से संबंधित मेटाडेटा बनाए रखने के लिए महत्वपूर्ण है। ZooKeeper का क्वरम-आधारित मैकेनिज़्म स्थिरता सुनिश्चित करता है: किसी भी बदलाव पर अधिकांश नोड्स (क्वरम) की सहमति आवश्यक होती है, जो ZooKeeper को अत्यधिक विश्वसनीय और फ़ॉल्ट-टॉलरेंट बनाती है।
Kafka के पुराने संस्करणों में, ZooKeeper कई महत्वपूर्ण कार्यों के लिए उपयोग होता है:
ZooKeeper का ZAB प्रोटोकॉल (ZooKeeper Atomic Broadcast) नेटवर्क पार्टिशन जैसी परिस्थितियों में भी नोड्स के बीच स्थिरता की गारंटी देता है, जिससे Kafka फ़ॉल्ट-टॉलरेंट बना रहता है। यह स्थिरता और विश्वसनीयता Kafka की डिस्ट्रीब्यूटेड प्रकृति के प्रबंधन के लिए ZooKeeper को महत्वपूर्ण बनाती है, हालांकि KRaft के डिफ़ॉल्ट मोड बनने के साथ भविष्य में Kafka की आर्किटेक्चर ZooKeeper पर कम निर्भर होगी।
15. आप Kafka में डिस्क उपयोग कैसे कम कर सकते हैं?
Kafka डिस्क उपयोग को प्रभावी ढंग से कम करने के कई तरीके प्रदान करता है। यहाँ प्रमुख रणनीतियाँ हैं:
1. लॉग रिटेंशन सेटिंग्स समायोजित करें
डिस्क पर संदेशों को बनाए रखने का समय कम करने के लिए लॉग रिटेंशन पॉलिसी संशोधित करें। यह
retention.ms(समय-आधारित रिटेंशन) याretention.bytes(आकार-आधारित रिटेंशन) को समायोजित करके किया जा सकता है ताकि Kafka पुराने संदेशों को हटाने से पहले कितने समय तक या कितना डेटा स्टोर करेगा, उसे सीमित किया जा सके।2. लॉग कम्पैक्शन लागू करें
प्रत्येक यूनिक कुंजी के लिए केवल सबसे हालिया संदेश बनाए रखने के लिए लॉग कम्पैक्शन का उपयोग करें, जिससे पुराना या अनावश्यक डेटा हट जाए। यह विशेष रूप से उन परिदृश्यों में उपयोगी है जहाँ केवल नवीनतम स्टेट मायने रखती है, और महत्वपूर्ण जानकारी खोए बिना डिस्क स्पेस उपयोग घटता है।
3. क्लीनअप पॉलिसीज़ कॉन्फ़िगर करें
अपने उपयोग मामले के आधार पर प्रभावी क्लीनअप पॉलिसीज़ सेट करें। आप समय-आधारित (
retention.ms) और आकार-आधारित (retention.bytes) दोनों रिटेंशन पॉलिसीज़ कॉन्फ़िगर कर सकते हैं ताकि पुराने संदेश स्वतः हटते रहें और Kafka का डिस्क फ़ुटप्रिंट नियंत्रित रहे।4. संदेशों को कंप्रेस करें
प्रोड्यूसर साइड पर GZIP, Snappy, या LZ4 जैसे फ़ॉर्मैट का उपयोग करके संदेश कंप्रेशन सक्षम करें। कंप्रेशन से संदेश आकार घटता है, जिससे डिस्क स्पेस की खपत कम होती है। हालाँकि, कंप्रेशन और डीकंप्रेशन के कारण CPU ओवरहेड बढ़ने-घटने के संतुलन पर विचार करना महत्वपूर्ण है।
5. लॉग सेगमेंट आकार समायोजित करें
Kafka के लॉग सेगमेंट आकार (
segment.bytes) को कॉन्फ़िगर करें ताकि लॉग सेगमेंट कितनी बार रोल हों, इसे नियंत्रित किया जा सके। छोटे सेगमेंट आकार अधिक बार लॉग रोलिंग की अनुमति देते हैं, जो पुराने डेटा के त्वरित डिलीशन को सक्षम कर अधिक कुशल डिस्क उपयोग में मदद कर सकते हैं।6. अनावश्यक टॉपिक्स या पार्टिशन हटाएँ
समय-समय पर अप्रयुक्त या अनावश्यक टॉपिक्स और पार्टिशनों की समीक्षा करें और उन्हें हटा दें। इससे डिस्क स्पेस खाली होता है और Kafka का डिस्क उपयोग नियंत्रण में रहता है।
डेटा इंजीनियर्स के लिए Kafka इंटरव्यू प्रश्न
यदि आप डेटा इंजीनियर पद के लिए इंटरव्यू दे रहे हैं, तो आप निम्नलिखित Kafka इंटरव्यू प्रश्नों के लिए तैयारी करना चाहेंगे।
16. Kafka में लीडर रेप्लिका और फॉलोवर रेप्लिका में क्या अंतर है?
लीडर रेप्लिका
लीडर रेप्लिका सभी क्लाइंट रीड और राइट अनुरोधों को संभालती है। यह पार्टिशन की स्टेट मैनेज करती है और प्रोड्यूसर्स तथा कंज़्यूमर्स के लिए प्राथमिक इंटरेक्शन पॉइंट होती है। यदि लीडर फेल हो जाए, तो उपलब्धता बनाए रखने के लिए उसका रोल किसी फॉलोवर रेप्लिका को ट्रांसफ़र कर दिया जाता है।
फॉलोवर रेप्लिका
फॉलोवर रेप्लिका लीडर से डेटा रिप्लिकेट करती है लेकिन सीधे क्लाइंट अनुरोध हैंडल नहीं करती। इसका कार्य पार्टिशन के डेटा की अप-टू-डेट कॉपी रखकर फ़ॉल्ट टॉलरेंस सुनिश्चित करना है। Kafka 2.4 से, कुछ शर्तों के तहत फॉलोवर रेप्लिकाज़ रीड अनुरोध भी संभाल सकती हैं ताकि लोड वितरित हो और रीड थ्रूपुट में सुधार हो। लीडर फेल होने पर, डेटा संगति और उपलब्धता बनाए रखने के लिए किसी फॉलोवर को नया लीडर चुना जाता है।
17. हम Kafka में क्लस्टर्स का उपयोग क्यों करते हैं, और उनके क्या लाभ हैं?
Kafka क्लस्टर कई ब्रोकर्स से मिलकर बना होता है जो डेटा को कई इंस्टेंस में वितरित करते हैं, जिससे बिना डाउनटाइम के स्केलेबिलिटी संभव होती है। ये क्लस्टर्स विलंब को न्यूनतम करने के लिए डिज़ाइन किए गए हैं, और यदि प्राथमिक क्लस्टर फेल हो जाए तो अन्य Kafka क्लस्टर्स सेवा निरंतरता बनाए रखने के लिए कार्य संभाल सकते हैं।
Kafka क्लस्टर की आर्किटेक्चर में टॉपिक्स, ब्रोकर्स, प्रोड्यूसर्स और कंज़्यूमर्स शामिल हैं। यह डेटा स्ट्रीम्स का कुशलतापूर्वक प्रबंधन करता है, जिससे यह बिग डेटा एप्लिकेशन और डेटा-ड्रिवन एप्लिकेशन विकास के लिए आदर्श बनता है।
18. Kafka संदेशों का क्रम कैसे सुनिश्चित करता है?
Kafka दो प्रमुख तरीकों से संदेशों का क्रम सुनिश्चित करता है:
19. Kafka में ISR और AR क्या दर्शाते हैं? ISR विस्तार का क्या अर्थ है?
ISR (इन-सिंक रेप्लिकाज़)
ISR वे रेप्लिकाज़ हैं जो लीडर रेप्लिका के साथ पूरी तरह से सिंक्रोनाइज़्ड हैं। इन रेप्लिकाज़ के पास नवीनतम डेटा होता है और इन्हें रीड व राइट ऑपरेशनों के लिए विश्वसनीय माना जाता है।
AR (असाइंड रेप्लिकाज़)
AR में किसी पार्टिशन को असाइन की गई सभी रेप्लिकाज़ शामिल होती हैं, चाहे वे इन-सिंक हों या आउट-ऑफ-सिंक। यह किसी पार्टिशन के लिए रेप्लिकाज़ के पूरे सेट का प्रतिनिधित्व करता है।
ISR विस्तार
ISR विस्तार तब होता है जब नई रेप्लिकाज़ लीडर के साथ कैच-अप कर लेती हैं और ISR सूची में जोड़ दी जाती हैं। इससे अप-टू-डेट रेप्लिकाज़ की संख्या बढ़ती है, जिससे फ़ॉल्ट टॉलरेंस और विश्वसनीयता में सुधार होता है।
20. Kafka में ज़ीरो-कॉपी का उपयोग परिदृश्य क्या है?
Kafka प्रोड्यूसर्स और कंज़्यूमर्स के बीच बड़े पैमाने पर डेटा को कुशलतापूर्वक ट्रांसफ़र करने के लिए ज़ीरो-कॉपी का उपयोग करता है। यह
FileChannel.transferToमेथड का लाभ उठाता है ताकि डेटा को फाइल सिस्टम से नेटवर्क सॉकेट्स तक सीधे स्थानांतरित किया जा सके, अतिरिक्त कॉपीिंग के बिना, जिससे परफॉर्मेंस और थ्रूपुट में सुधार होता है।यह तकनीक इंडेक्स फाइलों को पढ़ने के लिए मेमोरी-मैप्ड फाइल्स (mmap) का उपयोग करती है, जिससे डेटा बफ़र्स को यूज़र स्पेस और कर्नेल स्पेस के बीच साझा किया जा सके, और अतिरिक्त डेटा कॉपी की आवश्यकता और कम हो। इससे Kafka बड़े पैमाने की रियल-टाइम डेटा स्ट्रीम्स को कुशलतापूर्वक संभालने के लिए उपयुक्त बनता है।
अपने Kafka इंटरव्यू की तैयारी
Kafka-केंद्रित डेटा इंजीनियरिंग इंटरव्यू की तैयारी करते समय, मज़बूत तकनीकी नींव और यह स्पष्ट समझ दोनों होना महत्वपूर्ण है कि Kafka आधुनिक सिस्टम्स में कैसे एकीकृत होता है। Kafka कई रियल-टाइम डेटा प्लेटफ़ॉर्म्स के केंद्र में है, इसलिए इंटरव्यूअर्स आपसे बुनियादी बातों के साथ-साथ यह भी अपेक्षा करेंगे कि आप स्केलेबल, फ़ॉल्ट-टॉलरेंट परिवेशों में Kafka के काम करने के तरीके को जानते हों।
ध्यान केंद्रित करने के प्रमुख क्षेत्र
जैसा कि हमने यहाँ कवर किए गए Kafka इंटरव्यू प्रश्नों में देखा, कई प्रमुख क्षेत्र हैं जिन पर आपको तैयारी करनी होगी:
इंटरव्यू टिप्स
यहाँ इंटरव्यू में उत्कृष्ट प्रदर्शन सुनिश्चित करने के लिए कुछ शीर्ष सुझाव हैं:
इन कौशलों को निखारकर और प्रभावी तैयारी करके, आप Kafka-संबंधित इंटरव्यूज़ के लिए अच्छी तरह से सुसज्जित होंगे। याद रखें, इंटरव्यूअर्स केवल तकनीकी विशेषज्ञता ही नहीं, बल्कि स्पष्ट संचार और वास्तविक दुनिया की समस्या-समाधान क्षमता भी देखते हैं। इंटरव्यू प्रक्रिया के दौरान डेटा इंजीनियरिंग के प्रति अपना जुनून दिखाएँ।