Capire come scorre il dato e saperne sfruttare il potenziale è diventato assolutamente cruciale per le organizzazioni moderne. Kafka è la piattaforma leader per l’ingestione, l’archiviazione e l’elaborazione di flussi di dati in tempo reale nel panorama applicativo odierno.
In questo post presenteremo alcune domande da colloquio su Kafka ed esploreremo il ruolo fondamentale dello strumento nell’elaborazione dei dati. Vedremo domande di livello diverso, da base ad avanzato, e forniremo suggerimenti per aiutarti a prepararti al meglio. Se sei alle prime armi con Kafka, dai un’occhiata al nostro corso Introduction to Apache Kafka.
Domande di base su Kafka
Queste domande verificano la tua comprensione di base di Kafka come strumento per il data engineering.
1. Che cos’è Apache Kafka?
Apache Kafka è una potente piattaforma open-source per l’event streaming distribuito. Inizialmente sviluppata da LinkedIn come coda di messaggi, si è evoluta in uno strumento per la gestione di flussi di dati in vari scenari.
L’architettura distribuita di Kafka consente scalabilità orizzontale, permettendo ai consumer di recuperare i messaggi al proprio ritmo e rendendo semplice aggiungere nodi Kafka (server) al cluster.
Kafka è progettato per elaborare grandi quantità di dati rapidamente e con bassa latenza. Sebbene sia scritto in Scala e Java, supporta un’ampia gamma di linguaggi di programmazione.
Apache Kafka agisce come un collettore di log distribuito, in cui i messaggi di log sono archiviati come coppie chiave-valore in un file di log append-only per uno storage durevole, a lungo termine, e per il recupero. A differenza delle code di messaggi tradizionali come RabbitMQ, che eliminano i messaggi dopo il consumo, Kafka conserva i messaggi per un periodo configurabile, risultando ideale per casi d’uso che richiedono il replay dei dati o l’event sourcing.
Mentre RabbitMQ punta alla consegna dei messaggi in tempo reale senza conservarli a lungo termine, la policy di retention di Kafka supporta applicazioni più complesse e data-driven.
I casi d’uso comuni di Kafka includono il tracciamento delle applicazioni, l’aggregazione dei log e la messaggistica, sebbene manchi di funzionalità tipiche dei database come query e indicizzazione. Il suo punto di forza è la gestione di flussi di dati in tempo reale, che lo rende indispensabile per sistemi distribuiti e analisi real-time.
2. Quali sono alcune funzionalità di Kafka?
Apache Kafka è una piattaforma di streaming distribuita open-source ampiamente usata per costruire pipeline di dati in tempo reale e applicazioni di streaming. Offre le seguenti funzionalità:
1. Alto throughput
Kafka è in grado di gestire volumi di dati enormi. È progettato per leggere e scrivere in modo efficiente centinaia di gigabyte dai client sorgente.
2. Architettura distribuita
Apache Kafka ha un’architettura incentrata sul cluster e supporta intrinsecamente la partizionamento dei messaggi tra i server Kafka. Questo design abilita anche il consumo distribuito su un cluster di macchine consumer, preservando al contempo l’ordine dei messaggi all’interno di ogni partizione. Inoltre, un cluster Kafka può scalare in modo elastico e trasparente, senza richiedere downtime.
3. Supporto per vari client
Apache Kafka supporta l’integrazione di client da diverse piattaforme, come .NET, JAVA, PHP e Python.
4. Messaggi in tempo reale
Kafka produce messaggi in tempo reale che devono essere visibili ai consumer; questo è importante per sistemi di complex event processing.
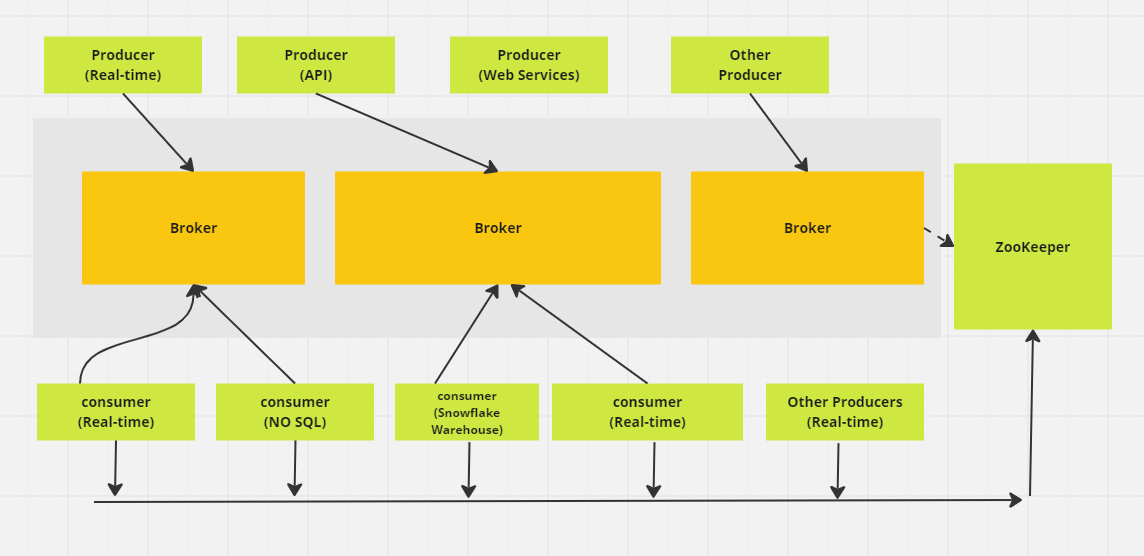
Apache Kafka Messaging Distributed system. (Immagine dell’autore)
3. Come funzionano le partizioni in Kafka?
In Kafka, un topic è uno spazio di archiviazione in cui vengono conservati tutti i messaggi dei producer. In genere, i dati correlati sono conservati in topic separati. Per esempio, un topic chiamato "transactions" conterrà i dettagli degli acquisti degli utenti su un sito di e-commerce, mentre un topic chiamato "customers" conterrà le informazioni sui clienti.
I topic sono suddivisi in partizioni. Per impostazione predefinita, un topic ha una partizione, ma puoi configurarlo per averne di più. I messaggi sono distribuiti tra queste partizioni, ognuna con il proprio offset ed archiviata su un server diverso nel cluster Kafka.
Ad esempio, se un topic ha tre partizioni su tre broker e un producer invia 15 messaggi, i messaggi sono distribuiti in sequenza:
- Il record 1 va alla Partizione 0
- Il record 2 va alla Partizione 1
- Il record 3 va alla Partizione 2
Poi il ciclo si ripete, con il record 4 che torna alla Partizione 0, e così via.
4. Perché sceglieresti Kafka rispetto ad altri servizi di messaggistica?
La scelta di Kafka rispetto ad altri servizi di messaggistica spesso dipende dai suoi punti di forza unici, soprattutto per i casi d’uso che necessitano di alto throughput ed elaborazione dei dati in tempo reale. Ecco perché Kafka si distingue:
- Alto throughput e scalabilità: Kafka può gestire grandi volumi di dati in modo efficiente. La sua architettura supporta la scalabilità orizzontale, permettendoti di aggiungere broker e partizioni per gestire carichi crescenti senza sacrificare le prestazioni.
- Elaborazione in tempo reale: È eccellente per lo streaming di dati in tempo reale, perfetto per casi come il tracciamento delle attività e il monitoraggio operativo. Per esempio, LinkedIn ha creato Kafka per gestire la propria pipeline di activity tracking, consentendo la pubblicazione di feed in tempo reale delle interazioni degli utenti come clic e like.
- Replay dei messaggi: Kafka consente ai consumer di riprodurre i messaggi, utile se un consumer incontra un errore o è sovraccaricato. Questo assicura che nessun dato vada perso: i consumer possono recuperare e rigiocare i messaggi persi per mantenere l’integrità dei dati.
- Durabilità e tolleranza ai guasti: Lo strumento replica i dati su più broker, garantendo affidabilità anche se alcuni broker falliscono. Questo design fault-tolerant mantiene accessibili i dati, offrendo sicurezza per le operazioni critiche.
5. Spiega tutte le API fornite da Apache Kafka.
Un’API (Application Programming Interface) abilita la comunicazione tra servizi, microservizi e sistemi diversi. Kafka fornisce un set di API progettate per costruire piattaforme di event streaming e interagire con il suo sistema di messaggistica.
Le API core di Kafka sono:
- Producer API: Usata per inviare dati in tempo reale ai topic Kafka. I producer determinano a quale partizione di un topic debba andare ciascun messaggio, con callback che gestiscono l’esito positivo o negativo delle operazioni di invio.
- Consumer API: Consente di leggere dati in tempo reale dai topic Kafka. I consumer possono far parte di un consumer group per il load balancing e l’elaborazione in parallelo, iscrivendosi ai topic e interrogando continuamente Kafka per nuovi messaggi.
- Streams API: Supporta la creazione di applicazioni real-time che trasformano, aggregano e analizzano i dati all’interno di Kafka. Offre una DSL (Domain Specific Language) di alto livello per definire logiche complesse di stream processing.
- Kafka Connect API: Usata per creare ed eseguire connettori riutilizzabili per importare ed esportare dati tra Kafka e sistemi esterni.
- Admin API: Fornisce strumenti per gestire e configurare topic, broker e altre risorse di Kafka per garantire operatività fluida e scalabilità.
Queste API consentono produzione, consumo, elaborazione e gestione dei dati in Kafka in modo fluido.
Domande intermedie su Kafka
Queste domande sono rivolte a professionisti più esperti che hanno già una solida comprensione degli utilizzi di Kafka.
6. Quali sono le implicazioni dell’aumento del numero di partizioni in un topic Kafka?
Aumentare il numero di partizioni in un topic Kafka può migliorare la concorrenza e il throughput permettendo a più consumer di leggere in parallelo. Tuttavia, introduce anche alcune sfide:
- Maggiore overhead del cluster: Più partizioni consumano risorse aggiuntive del cluster, causando maggior traffico di rete per la replica e maggiori esigenze di storage.
- Potenziale squilibrio dei dati: All’aumentare delle partizioni, i dati potrebbero non essere distribuiti in modo uniforme, con alcune partizioni sovraccariche e altre sottoutilizzate.
- Gestione più complessa dei consumer group: Con più partizioni, la gestione delle assegnazioni dei consumer group e il tracciamento degli offset diventano più complicati.
- Tempi di ribilanciamento più lunghi: Quando i consumer si uniscono o lasciano il gruppo, il ribilanciamento delle partizioni può richiedere più tempo, influenzando la reattività complessiva del sistema.
7. Spiega i quattro componenti dell’architettura Kafka
Kafka è un’architettura distribuita composta da diversi componenti chiave:
Broker node
L’architettura distribuita di Kafka comprende diversi componenti chiave, tra cui il broker node. I broker gestiscono il carico principale delle operazioni di input/output e l’archiviazione durevole dei messaggi. Ricevono i dati dai producer, li archiviano e li rendono disponibili ai consumer. Ogni broker fa parte di un cluster Kafka e ha un ID univoco per facilitare il coordinamento.
Nelle versioni più vecchie di Kafka, il cluster è gestito tramite Zookeeper, che garantisce il corretto coordinamento tra broker e tiene traccia dei metadati come la collocazione delle partizioni (anche se Kafka si sta spostando verso una modalità interna KRaft per questo). I broker Kafka sono altamente scalabili e capaci di gestire grandi volumi di richieste di lettura e scrittura di messaggi nei sistemi distribuiti.
Nodi ZooKeeper
ZooKeeper svolge un ruolo cruciale in Kafka gestendo la registrazione dei broker ed eleggendo il controller di Kafka, che si occupa delle operazioni amministrative del cluster. ZooKeeper opera esso stesso come un cluster, chiamato ensemble, in cui più processi collaborano per garantire che un solo broker alla volta sia assegnato come controller.
Se il controller attuale fallisce, ZooKeeper elegge rapidamente un nuovo broker che ne prende il posto. Sebbene ZooKeeper sia stato una parte essenziale dell’architettura di Kafka, Kafka sta passando a una nuova modalità KRaft che elimina la necessità di ZooKeeper. ZooKeeper è un progetto open-source indipendente e non un componente nativo di Kafka.
Producer
Un producer Kafka è un’applicazione client che funge da sorgente dati per Kafka, pubblicando record su uno o più topic Kafka tramite connessioni TCP persistenti ai broker.
Più producer possono inviare contemporaneamente record allo stesso topic. I topic Kafka sono append-only, il che significa che i producer possono scrivere nuovi dati, ma né i producer né i consumer possono modificare o eliminare i record esistenti, garantendo l’immutabilità dei dati.
Consumer
Un consumer Kafka è un’applicazione client che si iscrive a uno o più topic Kafka per consumare flussi di record. I consumer operano tipicamente in consumer group, in cui il carico di lettura ed elaborazione è distribuito tra più consumer.
Ogni consumer tiene traccia dei propri progressi nel flusso mantenendo gli offset, assicurando che nessun dato venga elaborato due volte e che i record non elaborati non vadano persi. I consumer Kafka rappresentano l’ultimo passaggio della pipeline dei dati, dove i record sono elaborati o inoltrati a sistemi a valle.
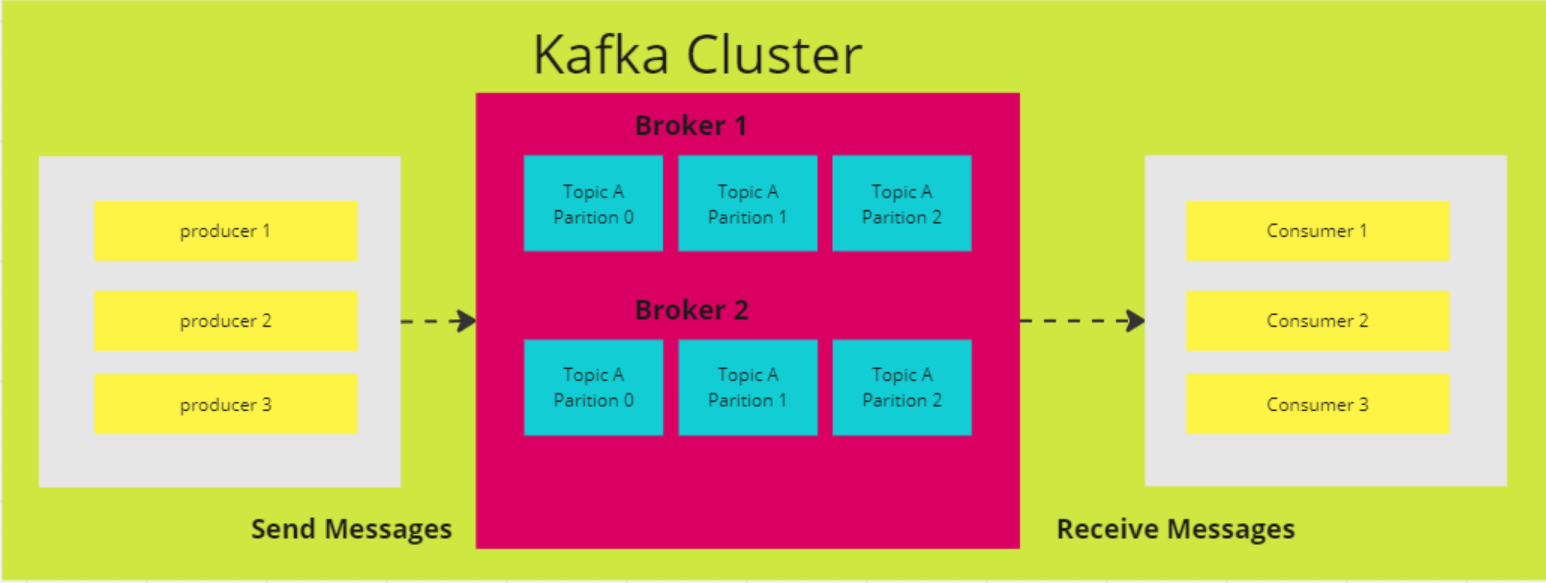
Diagramma dell’architettura di Apache Kafka (Immagine dell’autore)
8. Qual è lo scopo principale della log compaction in Kafka? In che modo influisce sulle prestazioni dei consumer?
L’obiettivo principale della log compaction in Kafka è conservare il valore più recente per ogni chiave univoca nel log di un topic, garantendo la preservazione dello stato più aggiornato dei dati e riducendo l’uso di storage. Ciò consente ai consumer di accedere in modo più efficiente al valore corrente senza dover elaborare duplicati più vecchi.
A differenza della retention tradizionale di Kafka, che elimina i messaggi dopo un certo periodo di tempo, la log compaction elimina i record più vecchi per ciascuna chiave, mantenendo l’ultimo valore per quella chiave. Questa funzione assicura che i consumer abbiano sempre accesso allo stato corrente, mantenendo al contempo un log compatto per una migliore efficienza di storage e ricerche più rapide.
9. Qual è la differenza tra partizioni e repliche in un cluster Kafka?
Partizioni e repliche sono componenti chiave dell’architettura di Kafka, che garantiscono prestazioni e tolleranza ai guasti. Le partizioni aumentano il throughput consentendo di suddividere un topic in più parti, permettendo ai consumer di leggere da partizioni diverse in parallelo, migliorando la scalabilità e l’efficienza di Kafka.
Le repliche, invece, forniscono ridondanza creando copie delle partizioni su più broker. Questo assicura tolleranza ai guasti perché, in caso di failure del broker leader (il broker che gestisce letture e scritture per una partizione), una delle repliche follower può essere promossa a nuovo leader.
Kafka mantiene più repliche per ogni partizione per garantire alta disponibilità e durabilità dei dati, riducendo al minimo il rischio di perdita di dati durante i guasti, anche se la durabilità completa dipende dalle impostazioni di replica.
10. Che cos’è uno schema in Kafka e perché è importante per i sistemi distribuiti?
In Kafka, uno schema definisce la struttura e il formato dei dati, ad esempio campi come CustomerID (intero), CustomerName (stringa) e Designation (stringa).
Nei sistemi distribuiti come Kafka, producer e consumer devono concordare sul formato dei dati per evitare errori nello scambio. Il Kafka Schema Registry gestisce e applica questi schemi, assicurando che producer e consumer usino versioni compatibili.
Lo Schema Registry archivia schemi (comunemente in formati come Avro, Protobuf o JSON Schema) e supporta l’evoluzione degli schemi, permettendo modifiche al formato dei dati senza interrompere i consumer esistenti. Questo garantisce uno scambio dati fluido e l’affidabilità del sistema man mano che gli schemi evolvono.
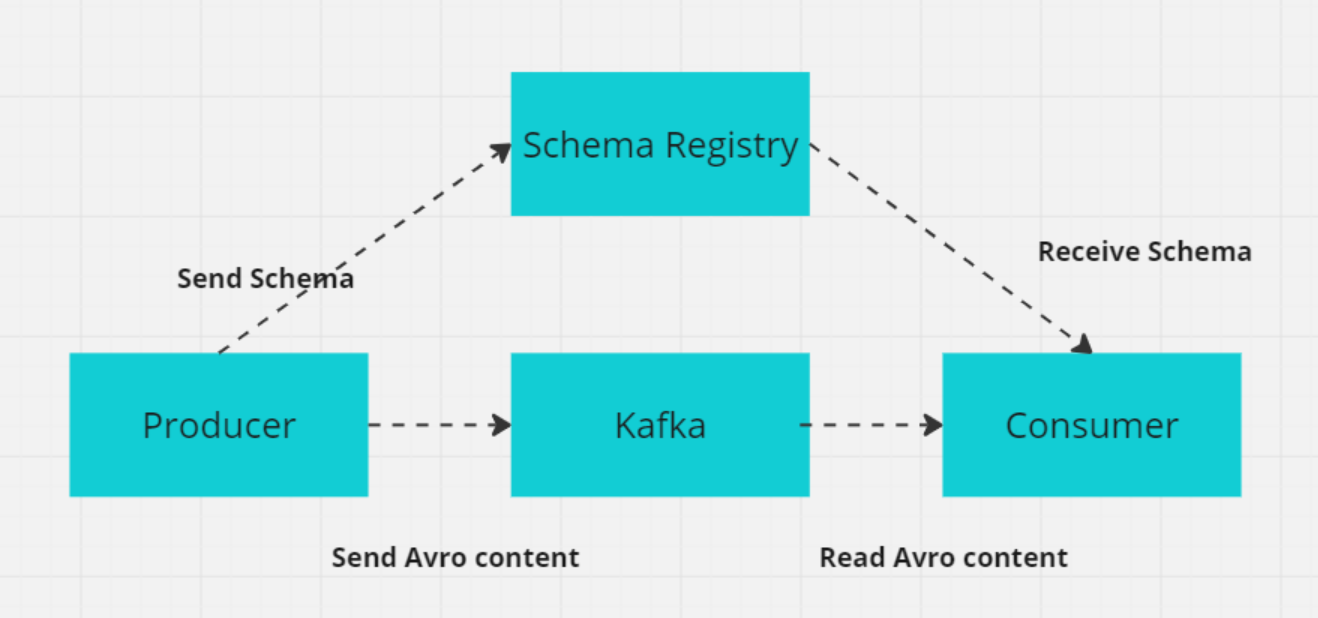
Come funziona lo Schema Registry con producer/consumer (Immagine dell’autore)
Domande avanzate su Kafka
Per utenti Kafka più avanzati, le domande di colloquio saranno probabilmente più tecniche.
11. Come fa Kafka a prevenire la perdita di messaggi?
Kafka adotta diversi meccanismi per prevenire la perdita di messaggi e garantire una consegna affidabile:
- Commit manuale degli offset: I consumer possono disabilitare i commit automatici degli offset e fare commit manuale dopo aver elaborato con successo i messaggi per evitare di perdere messaggi non elaborati in caso di crash del consumer.
- Acknowledgment del producer (
acks=all): Impostandoacks=allsul producer si assicura che i messaggi siano riconosciuti da tutte le repliche in-sync prima di considerarli scritti con successo, riducendo il rischio di perdita in caso di failure di un broker. - Replica (
min.insync.replicasereplication.factor): Kafka replica i dati di ciascuna partizione su più broker. Un replication factor maggiore di 1 assicura tolleranza ai guasti, permettendo ai dati di rimanere disponibili anche se un broker fallisce. L’impostazionemin.insync.replicasgarantisce che un numero minimo di repliche riconosca un messaggio prima che sia scritto, assicurando maggiore durabilità. Ad esempio, con un replication factor di 3, se un broker si ferma, i dati restano disponibili sugli altri due. - Retry del producer: Configurare un numero elevato di retry assicura che i producer ritentino l’invio dei messaggi in caso di failure transitorie. Combinato con una configurazione attenta, come
max.in.flight.requests.per.connection=1, ciò riduce la possibilità di riordinamento dei messaggi e garantisce che vengano infine consegnati senza perdite.
12. In cosa Kafka è diverso da RabbitMq?
Kafka e RabbitMQ sono due sistemi di messaggistica molto diffusi e differiscono per architettura e utilizzo. Ecco come si confrontano in aree chiave:
1. Utilizzo e design
Kafka è progettato per gestire flussi di dati su larga scala e pipeline real-time, ottimizzato per alto throughput e bassa latenza. La sua architettura basata su log garantisce durabilità e consente di rielaborare i dati, rendendolo ideale per casi come event sourcing e stream processing.
RabbitMQ è un message broker general-purpose che supporta routing complesso ed è tipicamente usato per la messaggistica tra microservizi o per distribuire task tra worker. Eccelle in ambienti in cui sono essenziali consegna affidabile, flessibilità nel routing e interazione tra servizi.
2. Architettura
Kafka categorizza i messaggi in topic, che sono divisi in partizioni. Ogni partizione può essere elaborata da più consumer, abilitando l’elaborazione parallela e la scalabilità. I dati sono archiviati su disco con un periodo di retention configurabile, garantendo durabilità e permettendo il rielaboro dei messaggi quando necessario.
RabbitMQ invia i messaggi a code, dove sono consumati da uno o più consumer. Garantisce consegna affidabile tramite acknowledgment dei messaggi, retry ed exchange di dead-letter per la gestione dei messaggi falliti. Questa architettura è focalizzata sull’integrità dei messaggi e sulla flessibilità nel routing.
3. Prestazioni e scalabilità
Kafka è costruito per scalare orizzontalmente aggiungendo broker e partizioni, consentendogli di gestire milioni di messaggi al secondo. La sua architettura supporta elaborazione parallela e alto throughput, rendendolo ideale per lo streaming di dati su larga scala.
RabbitMQ può scalare, sebbene non in modo efficiente quanto Kafka con volumi di dati molto grandi. È adatto a scenari da throughput moderato ad elevato, ma non è ottimizzato per gli estremi che Kafka può gestire nelle applicazioni di streaming su larga scala.
In sintesi: Sia Kafka che RabbitMQ sono strumenti potenti per la messaggistica, ma eccellono in casi d’uso diversi. Kafka è ideale per streaming di dati ad alto throughput in tempo reale e applicazioni di event sourcing dove serve elaborazione parallela su larga scala.
RabbitMQ è adatto alla consegna affidabile dei messaggi, alla distribuzione di task nelle architetture a microservizi e al routing complesso. Eccelle in scenari che richiedono disaccoppiamento tra servizi, elaborazione asincrona e affidabilità.
13. In che modo Kafka aiuta a sviluppare applicazioni basate su microservizi?
Apache Kafka è uno strumento prezioso per costruire architetture a microservizi grazie alle sue capacità nella gestione di dati in tempo reale, nella comunicazione event-driven e nella messaggistica affidabile. Ecco come supporta lo sviluppo di microservizi:
1. Architettura event-driven
- Disaccoppiamento dei servizi: Kafka consente ai servizi di comunicare tramite eventi invece che con chiamate dirette, riducendo le dipendenze tra loro. Questo disaccoppiamento permette ai servizi di produrre e consumare eventi in modo indipendente, semplificando evoluzione e manutenzione.
- Elaborazione asincrona: I servizi possono pubblicare eventi e proseguire l’elaborazione senza attendere la risposta di altri servizi, migliorando reattività ed efficienza.
2. Scalabilità
- Scalabilità orizzontale: Kafka può gestire grandi volumi di dati distribuendo il carico su più broker e partizioni. Ogni partizione può essere elaborata da diverse istanze di consumer, consentendo al sistema di scalare orizzontalmente.
- Consumo parallelo: Più consumer possono leggere da partizioni diverse simultaneamente, aumentando throughput e prestazioni.
3. Affidabilità e tolleranza ai guasti
- Replica dei dati: Kafka replica i dati su più broker, assicurando alta disponibilità e tolleranza ai guasti. Se un broker fallisce, un altro può subentrare con i dati replicati. Kafka archivia i dati su disco con periodi di retention configurabili, assicurando che gli eventi non vadano persi e possano essere rielaborati se necessario.
4. Integrazione dei dati
- Hub dati centrale: Kafka funge da hub centrale per il flusso di dati in un’architettura a microservizi, facilitando l’integrazione tra varie sorgenti e destinazioni. Questo semplifica il mantenimento della coerenza dei dati tra i servizi.
- Kafka Connect: Kafka Connect fornisce connettori per integrare Kafka con numerosi database, key-value store, motori di ricerca e altri sistemi, semplificando il movimento dei dati tra microservizi e sistemi esterni.
14. Che cos’è Kafka Zookeeper e come funziona?
Apache ZooKeeper è un servizio open-source che aiuta a coordinare e gestire dati di configurazione, sincronizzazione e servizi di gruppo nei sistemi distribuiti. Nelle versioni più vecchie di Kafka, ZooKeeper svolgeva un ruolo critico nella gestione dei metadati, nell’elezione del leader e nel coordinamento dei broker.
Tuttavia, dalla versione 2.8 Kafka sta passando alla modalità KRaft, che elimina la necessità di ZooKeeper. ZooKeeper è ormai considerato obsoleto e verrà rimosso nella release 4.0, prevista nel 2024.
ZooKeeper archivia i dati in una struttura gerarchica di nodi chiamati "znode", dove ogni znode può memorizzare metadati e avere znode figli, in modo simile a un file system. Questa struttura è cruciale per mantenere i metadati relativi a broker, topic e partizioni di Kafka. Il meccanismo basato su quorum di ZooKeeper assicura coerenza: la maggioranza dei nodi (quorum) deve concordare su qualsiasi modifica, rendendo ZooKeeper altamente affidabile e tollerante ai guasti.
Nelle versioni più vecchie di Kafka, ZooKeeper è usato per diverse funzioni critiche:
- Elezione del leader: ZooKeeper elegge un nodo controller, che gestisce l’assegnazione dei leader di partizione e altre attività a livello di cluster.
- Gestione dei metadati dei broker: Mantiene un registro centralizzato dei broker attivi e del loro stato.
- Riassegnazione delle partizioni: ZooKeeper aiuta a gestire il ribilanciamento delle partizioni tra i broker durante i guasti o le espansioni del cluster.
Il protocollo ZAB (ZooKeeper Atomic Broadcast) di ZooKeeper garantisce coerenza tra i nodi, anche in presenza di partizioni di rete, assicurando che Kafka rimanga tollerante ai guasti. Questa coerenza e affidabilità rendono ZooKeeper fondamentale per gestire la natura distribuita di Kafka, sebbene il futuro dell’architettura di Kafka farà sempre meno affidamento su ZooKeeper man mano che KRaft diventa la modalità predefinita.
15. Come puoi ridurre l’uso del disco in Kafka?
Kafka offre vari modi per ridurre efficacemente l’uso del disco. Ecco le strategie chiave:
1. Regola le impostazioni di retention dei log
Modifica la policy di retention per ridurre il tempo di conservazione dei messaggi su disco. Si può intervenire su retention.ms (retention basata sul tempo) o retention.bytes (retention basata sulla dimensione) per limitare per quanto tempo o quanti dati Kafka conserva prima di eliminare i messaggi più vecchi.
2. Implementa la log compaction
Usa la log compaction per conservare solo il messaggio più recente per ogni chiave univoca, rimuovendo i dati obsoleti o ridondanti. È particolarmente utile quando è rilevante solo lo stato più recente, riducendo lo spazio su disco senza perdere informazioni importanti.
3. Configura le policy di cleanup
Imposta policy di cleanup efficaci in base al tuo caso d’uso. Puoi configurare sia retention basata sul tempo (retention.ms) sia sulla dimensione (retention.bytes) per eliminare automaticamente i messaggi più vecchi e gestire l’ingombro su disco di Kafka.
4. Comprimi i messaggi
Abilita la compressione dei messaggi lato producer usando formati come GZIP, Snappy o LZ4. La compressione riduce la dimensione dei messaggi, con conseguente minor utilizzo del disco. Tuttavia, è importante considerare il trade-off tra minore uso del disco e maggior carico CPU dovuto a compressione e decompressione.
5. Regola la dimensione dei segmenti di log
Configura la dimensione dei segmenti di log di Kafka (segment.bytes) per controllare la frequenza di rotazione dei segmenti. Segmenti più piccoli consentono rotazioni più frequenti, aiutando a usare il disco in modo più efficiente grazie all’eliminazione più rapida dei dati più vecchi.
6. Elimina topic o partizioni non necessari
Revisiona periodicamente ed elimina topic e partizioni inutilizzati o non necessari. Questo può liberare spazio su disco e aiutare a mantenere sotto controllo l’utilizzo del disco di Kafka.
Domande su Kafka per Data Engineer
Se stai sostenendo un colloquio per una posizione da data engineer, potresti voler prepararti alle seguenti domande su Kafka.
16. Quali sono le differenze tra leader replica e follower replica in Kafka?
Leader replica
La leader replica gestisce tutte le richieste di lettura e scrittura dei client. Gestisce lo stato della partizione ed è il punto primario di interazione per producer e consumer. Se il leader fallisce, il suo ruolo viene trasferito a una delle repliche follower per mantenere la disponibilità.
Follower replica
La follower replica replica i dati dal leader ma non gestisce direttamente le richieste dei client. Il suo ruolo è garantire tolleranza ai guasti mantenendo una copia aggiornata dei dati della partizione. A partire da Kafka 2.4, in determinate condizioni, le repliche follower possono anche gestire richieste di lettura per distribuire il carico e migliorare il throughput di lettura. Se il leader fallisce, una follower viene eletta come nuovo leader per mantenere consistenza e disponibilità dei dati.
17. Perché usiamo i cluster in Kafka e quali sono i loro benefici?
Un cluster Kafka è composto da più broker che distribuiscono i dati su diverse istanze, consentendo la scalabilità senza downtime. Questi cluster sono progettati per ridurre al minimo le latenze e, nel caso in cui il cluster primario fallisca, altri cluster Kafka possono subentrare per mantenere la continuità del servizio.
L’architettura di un cluster Kafka include Topic, Broker, Producer e Consumer. Gestisce in modo efficiente i flussi di dati, rendendolo ideale per applicazioni di big data e lo sviluppo di applicazioni data-driven.
18. Come assicura Kafka l’ordinamento dei messaggi?
Kafka assicura l’ordinamento dei messaggi in due modi principali:
- Uso delle chiavi dei messaggi: Quando a un messaggio è assegnata una chiave, tutti i messaggi con la stessa chiave vengono inviati alla stessa partizione. Questo garantisce che i messaggi con la stessa chiave siano elaborati nell’ordine di arrivo, poiché Kafka preserva l’ordine all’interno di ogni partizione.
- Elaborazione single-threaded del consumer: Per mantenere l’ordine, il consumer dovrebbe elaborare i messaggi di una partizione in un singolo thread. Se si usano più thread, configura code in memoria separate per ogni partizione per assicurare l’ordine corretto durante la gestione concorrente.
19. Cosa rappresentano ISR e AR in Kafka? Cosa significa espansione dell’ISR?
ISR (in-sync replicas)
ISR si riferisce alle repliche completamente sincronizzate con la replica leader. Queste repliche hanno i dati più recenti e sono considerate affidabili sia per le letture che per le scritture.
AR (assigned replicas)
AR include tutte le repliche assegnate a una partizione, sia in-sync sia out-of-sync. Rappresenta l’insieme completo delle repliche per una partizione.
Espansione dell’ISR
L’espansione dell’ISR si verifica quando nuove repliche si allineano al leader e vengono aggiunte alla lista ISR. Questo aumenta il numero di repliche aggiornate, migliorando tolleranza ai guasti e affidabilità.
20. Qual è uno scenario di utilizzo dello zero-copy in Kafka?
Kafka utilizza lo zero-copy per trasferire in modo efficiente grandi volumi di dati tra producer e consumer. Sfrutta il metodo FileChannel.transferTo per spostare i dati direttamente dal file system ai socket di rete senza copie aggiuntive, migliorando prestazioni e throughput.
Questa tecnica utilizza file mappati in memoria (mmap) per leggere i file di indice, consentendo ai buffer di dati di essere condivisi tra user space e kernel space, riducendo ulteriormente la necessità di copie extra. Ciò rende Kafka particolarmente adatto alla gestione efficiente di flussi di dati real-time su larga scala.
Prepararsi al colloquio su Kafka
Mentre ti prepari a un colloquio di data engineering focalizzato su Kafka, è fondamentale avere sia solide basi tecniche sia una chiara comprensione di come Kafka si integra nei sistemi moderni. Kafka è centrale in molte piattaforme di dati real-time, quindi i recruiter si aspetteranno che tu conosca sia le basi sia il funzionamento di Kafka in ambienti scalabili e tolleranti ai guasti.
Aree chiave su cui concentrarti
Come abbiamo visto nelle domande su Kafka trattate qui, ci sono diverse aree chiave su cui dovrai ripassare:
- Architettura: Sii pronto a parlare dell’architettura di Kafka, inclusi broker, partizioni e l’interazione tra producer e consumer. Dovresti anche spiegare le garanzie di consegna dei messaggi di Kafka, come "at-least-once" o "exactly-once", e come Kafka assicura l’ordinamento tramite feature come le In-Sync Replicas (ISR).
- Integrazione: Comprendi come Kafka si integra con altri sistemi usando strumenti come Kafka Connect, che collega database, key-value store e altri sistemi. In sede di colloquio potrebbero chiederti del ruolo di Kafka nel mantenere la coerenza dei dati in microservizi o sistemi distribuiti.
- Monitoraggio e troubleshooting: È importante conoscere strumenti di monitoraggio come Kafka Manager e Prometheus. Dovrai dimostrare di saper gestire e ottimizzare efficacemente i cluster Kafka.
- Problem solving: Preparati a progettare soluzioni di messaggistica per problemi reali, come la gestione di grandi flussi di dati o l’assicurare l’affidabilità dei messaggi. Potrebbero proporti scenari ipotetici in cui dovrai effettuare troubleshooting o ottimizzare le prestazioni di Kafka.
- Comunicazione: Kafka è complesso, quindi devi essere in grado di spiegare chiaramente le tue decisioni di design o i passaggi di troubleshooting, sia ai team tecnici sia agli stakeholder business. Forti capacità comunicative faranno la differenza.
- Esperienza pratica: Metti in evidenza le esperienze pratiche, come l’impostazione di cluster Kafka, la gestione della retention dei dati o l’integrazione di Kafka con altri strumenti. La conoscenza pratica è molto apprezzata.
- Apprendimento continuo: Rimani aggiornato sulle ultime funzionalità e best practice di Kafka. Leggere la documentazione o contribuire a progetti open-source dimostra il tuo impegno nell’apprendimento continuo.
Consigli per il colloquio
Ecco alcuni consigli per assicurarti di affrontare al meglio il colloquio:
- Informati su azienda, settore e background del tuo intervistatore.
- Preparati per diversi step del colloquio (tecnico, HR, telefonico e in presenza) con un approccio mirato.
- Rivedi regolarmente risorse tecniche come:
Affinando queste competenze e preparandoti in modo efficace, sarai ben attrezzato per i colloqui legati a Kafka. Ricorda, i recruiter cercano non solo competenza tecnica ma anche chiarezza comunicativa e capacità di risolvere problemi reali. Mostra la tua passione per il data engineering durante tutto il processo.