Pengguna dan pengikut, mahasiswa dan mata kuliah, pelanggan dan produk: dunia kita dipenuhi relasi many-to-many yang alami. Namun, relasi ini tidak selalu diterjemahkan dengan baik ke dalam desain basis data. Desain many-to-many yang buruk adalah salah satu sumber paling umum dari duplikasi data, analitik yang keliru, dan kesulitan pemeliharaan jangka panjang dalam sistem produksi.
Dalam artikel ini, saya akan membahas relasi many-to-many dari prinsip dasar hingga implementasi dunia nyata. Kita juga akan mengeksplor pola desain tingkat lanjut, normalisasi, pertimbangan kinerja, dan bagaimana relasi many-to-many diimplementasikan pada sistem relasional dan NoSQL.
Pada akhirnya, Anda seharusnya mampu merancang skema yang skalabel dan mudah dirawat yang memodelkan relasi kompleks dengan benar, menghindari anomali data, serta mendukung pelaporan dan alur kerja BI yang andal.
Bagi pembaca yang ingin memperkuat fundamental sepanjang jalan, saya merekomendasikan untuk mengikuti kursus Introduction to Relational Databases in SQL kami.
Apa Itu Relasi Many to Many
Relasi many-to-many (M:N) adalah relasi basis data dua arah di mana setiap record di Tabel A dapat berhubungan dengan banyak record di Tabel B, dan setiap record di Tabel B dapat berhubungan dengan banyak record di Tabel A. Tidak seperti tipe relasi yang lebih sederhana, kardinalitas ada di kedua sisi.
Relasi ini sangat lazim dalam sistem nyata:
- Pendidikan: Seorang mahasiswa dapat mengambil banyak mata kuliah, dan setiap mata kuliah dapat memiliki banyak mahasiswa.
- E-niaga: Sebuah produk dapat berada di beberapa kategori, dan setiap kategori dapat berisi banyak produk.
- Platform sosial: Pengguna dapat bergabung dengan banyak grup, dan grup dapat berisi banyak pengguna.
- Kesehatan: Seorang pasien dapat diresepkan beberapa obat, dan setiap obat dapat diresepkan untuk banyak pasien.
Relasi membawa makna dan sering kali datanya sendiri. Memahami perbedaan ini penting untuk desain skema dan kueri yang benar, terutama saat menggabungkan tabel untuk analitik.
Many-to-many vs one-to-many
Untuk memahami mengapa relasi many-to-many memerlukan penanganan khusus, akan membantu jika kita membandingkannya dengan kardinalitas yang lebih sederhana.
- One-to-one (1:1): Setiap record di Tabel A berhubungan tepat dengan satu record di Tabel B, dan sebaliknya (misalnya, seorang pengguna dan profil pengguna).
- One-to-many (1:N): Satu record di Tabel A dapat berhubungan dengan banyak record di Tabel B, tetapi setiap record di Tabel B hanya berhubungan dengan satu record di Tabel A (misalnya, pelanggan dan pesanan mereka).
|
Tipe Relasi
|
Deskripsi
|
Logika
|
Contoh
|
|
One-to-One (1:1)
|
Setiap record di Tabel A berhubungan tepat dengan satu record di Tabel B.
|
Pemasangan unik.
|
User ↔ User Profile
|
|
One-to-Many (1:N)
|
Satu record di Tabel A berhubungan dengan banyak record di Tabel B, tetapi record di Tabel B hanya memiliki satu induk.
|
Struktur Induk/Anak.
|
Customer → Multiple Orders
|
|
Many-to-Many (M:N)
|
Banyak record di Tabel A berhubungan dengan banyak record di Tabel B.
|
Jaringan dua arah.
|
Students ↔ Courses
|
Misalnya, dalam desain one-to-many, tabel orders biasanya berisi foreign key customer_id dengan setiap pesanan unik memiliki order_id. Setiap pesanan milik tepat satu pelanggan, tetapi seorang pelanggan dapat memiliki banyak kunci order_id.
Sekarang bandingkan dengan contoh mahasiswa–mata kuliah. Jika Anda mencoba menyimpan course_id langsung pada tabel students, setiap mahasiswa akan ditautkan ke beberapa nilai course_id. Sebaliknya, di dalam tabel course, setiap mata kuliah akan memiliki banyak referensi student_id. Alih-alih relasi satu arah yang rapi, kedua arah saling berbagi informasi.
Masalah umum adalah mencoba merepresentasikan relasi many-to-many secara langsung dengan menyimpan banyak nilai dalam satu kolom menggunakan array (misalnya, course_ids pada tabel students) atau kolom berulang seperti course_1, course_2, course_3.
Pendekatan ini melanggar First Normal Form (1NF), yang mensyaratkan setiap kolom berisi nilai yang atomik dan tak terpecah. Baca blog ini tentang normalisasi di SQL untuk penyegaran.
Melanggar 1NF menyebabkan anomali pembaruan klasik:
- Anomali penyisipan: Menambahkan relasi baru mengharuskan memodifikasi struktur baris yang sudah ada.
- Anomali pembaruan: Mengubah relasi memerlukan pembaruan banyak baris, banyak kolom, atau nilai tertanam, sehingga meningkatkan risiko inkonsistensi.
- Anomali penghapusan: Menghapus satu relasi dapat secara tidak sengaja menghapus informasi lain yang tidak terkait.
Di luar teori normalisasi, ada konsekuensi analitis serius yang dikenal sebagai masalah many-to-many. Saat tabel dengan relasi many-to-many tidak digabung dengan hati-hati, hal ini mudah menyebabkan pelipatan baris. Ini dapat menimbulkan masalah waktu komputasi dan kesalahan agregasi untuk analisis.
Sebagai contoh, menggabungkan courses dengan students berdasarkan student_id dapat menyebabkan setiap mata kuliah tergabung berkali-kali karena banyaknya entri mahasiswa. Kemudian upaya agregasi dapat menimbulkan perbedaan analitis seperti pendapatan atau jumlah mahasiswa.
Desain skema yang benar secara langsung memengaruhi akurasi pelaporan, perhitungan finansial, dan kepercayaan pada produk data. Selain itu, ini membantu menyederhanakan join untuk meminimalkan kesalahan manusia. Untuk detail lebih lanjut tentang jebakan join yang umum, lihat tutorial join SQL ini dan berlatihlah dengan 20 Pertanyaan Teratas tentang SQL Joins.
Tabel Perantara: Fondasi dan Struktur
Solusi standar untuk relasi many-to-many dalam sistem relasional adalah tabel perantara (juga disebut join table, bridge table, atau associative table). Alih-alih mencoba menyimpan relasi secara langsung, Anda memperkenalkan tabel perantara yang mereferensikan kedua tabel induk.
Secara konseptual, ini mengubah A ↔ B menjadi A ← JT→ B.
Kini, masing-masing memiliki relasi one-to-many dengan tabel perantara, sehingga memungkinkan skema analitis yang disederhanakan. Saya akan membahas bagaimana kita membangun tabel perantara ini dan bagaimana tabel tersebut digunakan.
Anatomi dan komponen
Sebuah tabel perantara dasar berisi:
- Satu foreign key yang mereferensikan primary key Tabel A
- Satu foreign key yang mereferensikan primary key Tabel B
Dalam banyak kasus, kedua foreign key ini bersama-sama membentuk primary key komposit. Ini menjamin bahwa relasi yang sama tidak dapat dimasukkan dua kali dan menegakkan keunikan di tingkat basis data.
Sebagai contoh, tabel enrollments dapat menggunakan penggabungan student_id dan course_id sebagai primary key. Basis data kini memiliki kunci referensi unik untuk relasi tersebut dan kita dapat mulai membangun use case bisnis.
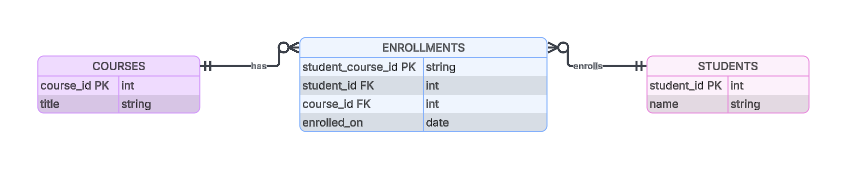
Contoh tampilan tabel perantara enrollments.
Menambahkan atribut ke tabel perantara
Ketika tabel perantara menyimpan atribut tambahan, tabel tersebut menjadi lebih mirip entitas asosiatif daripada sekadar artefak struktural. Ini memungkinkan tabel perantara memuat informasi kontekstual tentang relasi. Contoh umum termasuk:
-
Tanggal: enrollment_date, creation_date, dan informasi berbasis waktu serupa
-
Peran: misalnya admin vs anggota dalam sebuah grup
-
Metrix: penilaian relevansi dalam sistem rekomendasi
Ini membantu relasi membawa lebih banyak makna. Kompleksitas kueri sedikit meningkat, tetapi skema lebih akurat memodelkan realitas. Trade-off ini hampir selalu sepadan dalam sistem yang relasinya berkembang seiring waktu. Kita dapat menambahkan lebih banyak informasi dan menjadikan tabel perantara sebagai alat analitis yang berguna.
Menjaga integritas data
Tabel perantara sangat bergantung pada integritas referensial. Batasan foreign key memastikan setiap baris relasi mereferensikan record induk yang valid, mencegah data yatim.
Aturan penghapusan penting:
- CASCADE: Secara otomatis menghapus baris perantara saat induk dihapus.
- RESTRICT / NO ACTION: Mencegah penghapusan baris induk jika relasi masih ada.
Pilihan bergantung pada semantik bisnis. Di beberapa domain, pembersihan otomatis cocok; di lain pihak, relasi historis harus dipertahankan atau ditinjau secara eksplisit sebelum dihapus.
Normalisasi dan tabel perantara
Tabel perantara adalah penerapan langsung dari Third Normal Form (3NF). Tabel ini menghilangkan dependensi transitif dan menghapus penyimpanan redundan dari data relasi. Tujuannya adalah meningkatkan normalisasi dalam basis data.
Dalam banyak kasus, tabel perantara juga membantu memenuhi Boyce–Codd Normal Form (BCNF) karena primary key komposit sepenuhnya menentukan semua atribut non-kunci. Ini penting karena meminimalkan anomali pembaruan dan menjamin bahwa memodifikasi relasi membutuhkan perubahan tepat satu baris.
Untuk pemahaman yang lebih mendalam tentang pentingnya memastikan 3NF dalam basis data kita, lihat artikel tentang dependensi transitif ini.
Merancang dan Menerapkan Relasi Many to Many
Mari bahas bagaimana kita benar-benar membangun basis data untuk mendukung relasi many-to-many. Kita akan membahas praktik baik untuk memudahkan pekerjaan Anda.
Konvensi penamaan dan kejelasan skema
Penamaan tabel yang jelas mengurangi beban kognitif dan meningkatkan pemeliharaan. Konvensi umum biasanya mencakup TableA_TableB atau join_TableATableB, misalnya:
-
student_course
-
user_group
-
join_user_group
Nama kolom sebaiknya mencerminkan primary key tabel induk (misalnya, student_id, course_id) agar join menjadi jelas dan mudah dibaca. Konsistensi menjadi kritis saat skema bertumbuh dan tim berkembang.
Pola umum dan variasi
Ada beberapa cara untuk membangun tabel perantara mulai dari pelacakan relasi yang sangat sederhana hingga relasi polimorfik yang lebih kompleks.
Tabel perantara sederhana
Tabel perantara sederhana hanya berisi foreign key dan ideal untuk relasi statis atau berkonteks rendah. Tabel ini sangat mudah dirawat dengan overhead minimal karena biasanya hanya berfokus menampilkan bagaimana dua tabel saling berkaitan. Tabel perantara ini tidak memiliki data temporal atau kontekstual.
Relasi many-to-many yang mereferensikan diri sendiri
Relasi many-to-many yang mereferensikan diri sendiri terjadi ketika kedua foreign key mereferensikan tabel yang sama.
Misalnya, jika kita melacak aplikasi media sosial yang mencakup pelacakan pengguna, pengikut mereka, dan siapa yang mereka ikuti, kita mungkin memiliki relasi user_id ke follower_id di kedua arah. Batasan tambahan mungkin diperlukan untuk mencegah duplikasi yang tidak valid atau simetris.
Relasi many-to-many polimorfik
Relasi many-to-many polimorfik memungkinkan satu tabel perantara menghubungkan beberapa tipe entitas menggunakan penentu tipe. Ini memberikan fleksibilitas tetapi mengalihkan penegakan integritas ke logika aplikasi dan mempersulit kueri.
Sebagai contoh, tabel perantara bernama Tag untuk aplikasi media sosial dapat mengaitkan Posts, Comments, dan Users dengan kolom kontekstual tambahan untuk mengasosiasikan tag dengan entitas yang tepat.
Relasi temporal dan berbobot
Relasi temporal dan berbobot sama-sama menyimpan informasi tentang relasi dalam atribut tambahan.
Relasi many-to-many temporal menambahkan kolom yang memberikan informasi temporal, seperti active_from, active_to, atau created_on, untuk melacak validitas historis. Kunci enrolled_on dalam basis data mahasiswa–mata kuliah kita sebelumnya adalah salah satu contoh relasi temporal.
Ini sangat penting untuk jejak audit, relasi yang berubah perlahan, dan analisis titik waktu. Hal ini menambah sedikit kompleksitas di mana pengguna harus berhati-hati memfilter pada skala temporal yang tepat dan mempertimbangkan baris yang mungkin tidak aktif.
Relasi berbobot, di sisi lain, menyimpan metrik peringkat atau kekuatan. Engine rekomendasi, sistem penandaan, dan penilaian relevansi umumnya bergantung pada pola ini untuk melacak hal seperti tingkat keyakinan rekomendasi.
Relasi multi-arah
Walaupun sebagian besar sistem OLTP menghindari relasi yang melibatkan lebih dari dua entitas, sistem analitik sering menggunakannya. Tabel fakta dalam model dimensional secara efektif bertindak sebagai tabel perantara yang menghubungkan tabel pada tingkat granularitas yang berbeda. Desain ini kuat tetapi memerlukan disiplin saat melakukan kueri dan dokumentasi yang jelas.
Desain potensial adalah membuat tabel perantara Anda dengan foreign key ke semua entitas yang berpartisipasi.
Misalnya, jika kita melanjutkan contoh mahasiswa dan mata kuliah, tabel ketiga bisa berupa nomor ruang kelas. Sebuah tabel perantara dapat memuat foreign key untuk seorang mahasiswa pada kelas tertentu di ruangan tertentu. Mudah dilihat bahwa saat kita memperluas jumlah relasi, kueri dan skema menjadi semakin kompleks secara eksponensial.
Untuk pendalaman lebih lanjut dalam membangun basis data, pastikan mengikuti kursus kami tentang desain basis data.
Optimasi Kinerja dan Efisiensi Kueri
Dengan desain basis data yang rumit, kita harus melihat pertimbangan kinerja dan kueri. Semakin banyak komponen yang kita tambahkan, semakin besar kemungkinan kita menghadapi hambatan kinerja!
Pola kueri dan optimasi
Mari lihat beberapa cara kita mungkin melakukan kueri pada tabel perantara. Pola akses umum meliputi:
- Mengambil semua entitas terkait dari Tabel B untuk entitas tertentu di Tabel A
- Menghitung jumlah relasi
- Memfilter berdasarkan atribut relasi
Untuk mengoptimalkan kueri ini:
-
Indekskan foreign key pada tabel perantara
-
Gunakan GROUP BY atau DISTINCT untuk mencegah perhitungan berlebih
-
Pertimbangkan covering index untuk beban baca yang tinggi
-
Spesifiklah pada klausa WHERE untuk membatasi seberapa banyak data yang di-join.
Teknik-teknik ini mendasar untuk join dan agregasi yang efisien. Ingat juga, jika Anda mencoba menggunakan tabel perantara untuk menjembatani dua tabel, ada baiknya memikirkan bagaimana Anda dapat menggabungkan tiga tabel secara efisien.
Operasi massal dan konkurensi
Tabel perantara sering mengalami volume tulis yang tinggi. Penyisipan dan pembaruan secara batch mengurangi overhead transaksi.
Namun, kontensi tinggi pada foreign key populer dapat menciptakan hambatan penguncian. Pastikan memantau kinerja dan melakukan partisi tabel untuk memungkinkan paralelisasi.
Normalisasi vs denormalisasi
Mari luangkan waktu sejenak untuk melihat perbedaan kunci antara normalisasi dan denormalisasi sebagai pendekatan desain basis data:
- Desain ternormalisasi cocok untuk sistem yang banyak menulis dan sangat kritis terhadap konsistensi (misalnya, keuangan, ERP). Jika konsistensi ketat tanpa peluang duplikasi atau data berlebih diperlukan, fokuslah pada desain yang sepenuhnya ternormalisasi.
- Desain terdenormalisasi cocok untuk analitik yang banyak membaca di mana konsistensi pada akhirnya dapat diterima. Jika aksesibilitas data lebih penting, dan kita menerima data “mengendap” kemudian, maka kita dapat menggunakan desain terdenormalisasi, dengan catatan kita memberikan panduan praktik terbaik yang ketat.
Pertimbangkan benar pola akses, keahlian tim, dan batasan operasional.
Trade-off denormalisasi
Denormalisasi dapat meningkatkan kinerja pada sistem tulis-berat yang tidak sering berubah. Biayanya adalah kompleksitas yang bertambah, beban pemeliharaan meningkat, dan risiko data usang.
Pendapat saya: Denormalisasi sebaiknya hanya menjadi respons terukur terhadap hambatan baca-berat dan selalu dibangun dengan pemeriksaan konsistensi berkala.
Implementasi di Berbagai Sistem Basis Data
Sistem SQL dan NoSQL memiliki pendekatan yang sedikit berbeda untuk implementasi sistem many-to-many.
Arsitektur relasional dan NoSQL
Basis data relasional seperti PostgreSQL, MySQL, dan SQL Server mengimplementasikan relasi many-to-many secara eksplisit menggunakan tabel perantara dengan foreign key dan primary key komposit. Demikian pula, basis data relasional berbasis cloud seperti Snowflake mengikuti pola desain serupa.
Sistem NoSQL sering merepresentasikan relasi many-to-many dengan menyematkan array ID terkait atau menyimpan referensi yang dikelola oleh logika aplikasi. Ini karena prioritas performa baca dan skalabilitas horizontal pada basis data NoSQL. Pendekatan ini meningkatkan performa baca dan fleksibilitas skema tetapi mengorbankan normalisasi.
|
Fitur
|
Relasional (SQL)
|
NoSQL
|
|
Implementasi
|
Tabel Perantara: Menggunakan tabel ketiga dengan foreign key dan primary key komposit.
|
Embedding atau Referencing: Menggunakan array ID atau dokumen bertingkat.
|
|
Tujuan Utama
|
Normalisasi: Memastikan konsistensi data dan menghilangkan redundansi.
|
Performa: Memprioritaskan kecepatan baca dan skalabilitas horizontal.
|
|
Fleksibilitas
|
Skema Kaku: Memerlukan struktur yang telah ditentukan dan join untuk mengambil data.
|
Fleksibilitas Tinggi: Memungkinkan desain tanpa skema dan tipe data yang beragam.
|
|
Trade-off
|
Join Kompleks: Dapat menjadi lebih lambat saat dataset tumbuh signifikan.
|
Mengorbankan Normalisasi: Dapat menyebabkan duplikasi data atau data "usang".
|
|
Contoh
|
PostgreSQL, MySQL, SQL Server, Snowflake.
|
MongoDB, DynamoDB, Cassandra.
|
SQL vs NoSQL
Basis data relasional lebih disukai saat Anda memerlukan struktur skema yang terdefinisi dengan baik. Basis data ini lebih mudah dimanipulasi dan memungkinkan pengelolaan data yang lebih baik. Pertimbangkan untuk berfokus menggunakan basis data SQL relasional ketika:
- Relasi sering berubah
- Integritas sangat krusial bagi bisnis
- Kueri melibatkan join yang kompleks
Basis data NoSQL cocok untuk situasi di mana fleksibilitas dan kemampuan operasi massal menjadi prioritas. Misalnya, basis data NoSQL seperti MongoDB memungkinkan penggunaan operator seperti updateMany saat kita perlu memperbarui lintas banyak dokumen. Berikut beberapa prinsip panduan kapan Anda sebaiknya mempertimbangkan implementasi NoSQL:
- Kardinalitas dapat diprediksi
- Operasi baca jauh lebih banyak daripada tulis
- Fleksibilitas skema lebih penting daripada konsistensi ketat
Kesimpulan
Relasi many-to-many tak terhindarkan dalam model data yang realistis. Merancangnya dengan benar sangat penting untuk integritas data, skalabilitas, dan ketepatan analitis. Tabel perantara, ketika dinormalisasi dan diindeks dengan benar, menyediakan fondasi yang tangguh yang dapat diskalakan dari sistem transaksional hingga analitik tingkat perusahaan.
Setiap desain melibatkan trade-off: normalisasi versus performa, kesederhanaan versus fleksibilitas, dan abstraksi versus kontrol. Kuncinya adalah memprofil pola akses Anda, memilih pola yang selaras dengan beban kerja, serta memvalidasi desain melalui peninjauan skema dan pengujian kueri.
Bagi praktisi yang ingin memperdalam keterampilan desain basis data, saya sangat merekomendasikan untuk mendaftar pada jalur karier Associate Data Analyst in SQL kami.




Pengguna dan pengikut, mahasiswa dan mata kuliah, pelanggan dan produk: dunia kita dipenuhi relasi many-to-many yang alami. Namun, relasi ini tidak selalu diterjemahkan dengan baik ke dalam desain basis data. Desain many-to-many yang buruk adalah salah satu sumber paling umum dari duplikasi data, analitik yang keliru, dan kesulitan pemeliharaan jangka panjang dalam sistem produksi.
Dalam artikel ini, saya akan membahas relasi many-to-many dari prinsip dasar hingga implementasi dunia nyata. Kita juga akan mengeksplor pola desain tingkat lanjut, normalisasi, pertimbangan kinerja, dan bagaimana relasi many-to-many diimplementasikan pada sistem relasional dan NoSQL.
Pada akhirnya, Anda seharusnya mampu merancang skema yang skalabel dan mudah dirawat yang memodelkan relasi kompleks dengan benar, menghindari anomali data, serta mendukung pelaporan dan alur kerja BI yang andal.
Bagi pembaca yang ingin memperkuat fundamental sepanjang jalan, saya merekomendasikan untuk mengikuti kursus Introduction to Relational Databases in SQL kami.
Apa Itu Relasi Many to Many
Relasi many-to-many (M:N) adalah relasi basis data dua arah di mana setiap record di Tabel A dapat berhubungan dengan banyak record di Tabel B, dan setiap record di Tabel B dapat berhubungan dengan banyak record di Tabel A. Tidak seperti tipe relasi yang lebih sederhana, kardinalitas ada di kedua sisi.
Relasi ini sangat lazim dalam sistem nyata:
Relasi membawa makna dan sering kali datanya sendiri. Memahami perbedaan ini penting untuk desain skema dan kueri yang benar, terutama saat menggabungkan tabel untuk analitik.
Many-to-many vs one-to-many
Untuk memahami mengapa relasi many-to-many memerlukan penanganan khusus, akan membantu jika kita membandingkannya dengan kardinalitas yang lebih sederhana.
Tipe Relasi
Deskripsi
Logika
Contoh
One-to-One (1:1)
Setiap record di Tabel A berhubungan tepat dengan satu record di Tabel B.
Pemasangan unik.
User ↔ User Profile
One-to-Many (1:N)
Satu record di Tabel A berhubungan dengan banyak record di Tabel B, tetapi record di Tabel B hanya memiliki satu induk.
Struktur Induk/Anak.
Customer → Multiple Orders
Many-to-Many (M:N)
Banyak record di Tabel A berhubungan dengan banyak record di Tabel B.
Jaringan dua arah.
Students ↔ Courses
Misalnya, dalam desain one-to-many, tabel orders biasanya berisi foreign key
customer_iddengan setiap pesanan unik memilikiorder_id. Setiap pesanan milik tepat satu pelanggan, tetapi seorang pelanggan dapat memiliki banyak kunciorder_id.Sekarang bandingkan dengan contoh mahasiswa–mata kuliah. Jika Anda mencoba menyimpan
course_idlangsung pada tabel students, setiap mahasiswa akan ditautkan ke beberapa nilaicourse_id. Sebaliknya, di dalam tabel course, setiap mata kuliah akan memiliki banyak referensistudent_id. Alih-alih relasi satu arah yang rapi, kedua arah saling berbagi informasi.Pelanggaran First Normal Form dan Masalah Many-to-Many
Masalah umum adalah mencoba merepresentasikan relasi many-to-many secara langsung dengan menyimpan banyak nilai dalam satu kolom menggunakan array (misalnya,
course_idspada tabelstudents) atau kolom berulang seperticourse_1,course_2,course_3.Pendekatan ini melanggar First Normal Form (1NF), yang mensyaratkan setiap kolom berisi nilai yang atomik dan tak terpecah. Baca blog ini tentang normalisasi di SQL untuk penyegaran.
Melanggar 1NF menyebabkan anomali pembaruan klasik:
Di luar teori normalisasi, ada konsekuensi analitis serius yang dikenal sebagai masalah many-to-many. Saat tabel dengan relasi many-to-many tidak digabung dengan hati-hati, hal ini mudah menyebabkan pelipatan baris. Ini dapat menimbulkan masalah waktu komputasi dan kesalahan agregasi untuk analisis.
Sebagai contoh, menggabungkan
coursesdenganstudentsberdasarkanstudent_iddapat menyebabkan setiap mata kuliah tergabung berkali-kali karena banyaknya entri mahasiswa. Kemudian upaya agregasi dapat menimbulkan perbedaan analitis seperti pendapatan atau jumlah mahasiswa.Desain skema yang benar secara langsung memengaruhi akurasi pelaporan, perhitungan finansial, dan kepercayaan pada produk data. Selain itu, ini membantu menyederhanakan join untuk meminimalkan kesalahan manusia. Untuk detail lebih lanjut tentang jebakan join yang umum, lihat tutorial join SQL ini dan berlatihlah dengan 20 Pertanyaan Teratas tentang SQL Joins.
Tabel Perantara: Fondasi dan Struktur
Solusi standar untuk relasi many-to-many dalam sistem relasional adalah tabel perantara (juga disebut join table, bridge table, atau associative table). Alih-alih mencoba menyimpan relasi secara langsung, Anda memperkenalkan tabel perantara yang mereferensikan kedua tabel induk.
Secara konseptual, ini mengubah A ↔ B menjadi A ← JT→ B.
Kini, masing-masing memiliki relasi one-to-many dengan tabel perantara, sehingga memungkinkan skema analitis yang disederhanakan. Saya akan membahas bagaimana kita membangun tabel perantara ini dan bagaimana tabel tersebut digunakan.
Anatomi dan komponen
Sebuah tabel perantara dasar berisi:
Dalam banyak kasus, kedua foreign key ini bersama-sama membentuk primary key komposit. Ini menjamin bahwa relasi yang sama tidak dapat dimasukkan dua kali dan menegakkan keunikan di tingkat basis data.
Sebagai contoh, tabel
enrollmentsdapat menggunakan penggabunganstudent_iddancourse_idsebagai primary key. Basis data kini memiliki kunci referensi unik untuk relasi tersebut dan kita dapat mulai membangun use case bisnis.Contoh tampilan tabel perantara
enrollments.Menambahkan atribut ke tabel perantara
Ketika tabel perantara menyimpan atribut tambahan, tabel tersebut menjadi lebih mirip entitas asosiatif daripada sekadar artefak struktural. Ini memungkinkan tabel perantara memuat informasi kontekstual tentang relasi. Contoh umum termasuk:
Tanggal:
enrollment_date,creation_date, dan informasi berbasis waktu serupaPeran: misalnya admin vs anggota dalam sebuah grup
Metrix: penilaian relevansi dalam sistem rekomendasi
Ini membantu relasi membawa lebih banyak makna. Kompleksitas kueri sedikit meningkat, tetapi skema lebih akurat memodelkan realitas. Trade-off ini hampir selalu sepadan dalam sistem yang relasinya berkembang seiring waktu. Kita dapat menambahkan lebih banyak informasi dan menjadikan tabel perantara sebagai alat analitis yang berguna.
Menjaga integritas data
Tabel perantara sangat bergantung pada integritas referensial. Batasan foreign key memastikan setiap baris relasi mereferensikan record induk yang valid, mencegah data yatim.
Aturan penghapusan penting:
Pilihan bergantung pada semantik bisnis. Di beberapa domain, pembersihan otomatis cocok; di lain pihak, relasi historis harus dipertahankan atau ditinjau secara eksplisit sebelum dihapus.
Normalisasi dan tabel perantara
Tabel perantara adalah penerapan langsung dari Third Normal Form (3NF). Tabel ini menghilangkan dependensi transitif dan menghapus penyimpanan redundan dari data relasi. Tujuannya adalah meningkatkan normalisasi dalam basis data.
Dalam banyak kasus, tabel perantara juga membantu memenuhi Boyce–Codd Normal Form (BCNF) karena primary key komposit sepenuhnya menentukan semua atribut non-kunci. Ini penting karena meminimalkan anomali pembaruan dan menjamin bahwa memodifikasi relasi membutuhkan perubahan tepat satu baris.
Untuk pemahaman yang lebih mendalam tentang pentingnya memastikan 3NF dalam basis data kita, lihat artikel tentang dependensi transitif ini.
Merancang dan Menerapkan Relasi Many to Many
Mari bahas bagaimana kita benar-benar membangun basis data untuk mendukung relasi many-to-many. Kita akan membahas praktik baik untuk memudahkan pekerjaan Anda.
Konvensi penamaan dan kejelasan skema
Penamaan tabel yang jelas mengurangi beban kognitif dan meningkatkan pemeliharaan. Konvensi umum biasanya mencakup
TableA_TableBataujoin_TableATableB, misalnya:student_courseuser_groupjoin_user_groupNama kolom sebaiknya mencerminkan primary key tabel induk (misalnya,
student_id,course_id) agar join menjadi jelas dan mudah dibaca. Konsistensi menjadi kritis saat skema bertumbuh dan tim berkembang.Pola umum dan variasi
Ada beberapa cara untuk membangun tabel perantara mulai dari pelacakan relasi yang sangat sederhana hingga relasi polimorfik yang lebih kompleks.
Tabel perantara sederhana
Tabel perantara sederhana hanya berisi foreign key dan ideal untuk relasi statis atau berkonteks rendah. Tabel ini sangat mudah dirawat dengan overhead minimal karena biasanya hanya berfokus menampilkan bagaimana dua tabel saling berkaitan. Tabel perantara ini tidak memiliki data temporal atau kontekstual.
Relasi many-to-many yang mereferensikan diri sendiri
Relasi many-to-many yang mereferensikan diri sendiri terjadi ketika kedua foreign key mereferensikan tabel yang sama.
Misalnya, jika kita melacak aplikasi media sosial yang mencakup pelacakan pengguna, pengikut mereka, dan siapa yang mereka ikuti, kita mungkin memiliki relasi
user_idkefollower_iddi kedua arah. Batasan tambahan mungkin diperlukan untuk mencegah duplikasi yang tidak valid atau simetris.Relasi many-to-many polimorfik
Relasi many-to-many polimorfik memungkinkan satu tabel perantara menghubungkan beberapa tipe entitas menggunakan penentu tipe. Ini memberikan fleksibilitas tetapi mengalihkan penegakan integritas ke logika aplikasi dan mempersulit kueri.
Sebagai contoh, tabel perantara bernama
Taguntuk aplikasi media sosial dapat mengaitkanPosts,Comments, danUsersdengan kolom kontekstual tambahan untuk mengasosiasikan tag dengan entitas yang tepat.Relasi temporal dan berbobot
Relasi temporal dan berbobot sama-sama menyimpan informasi tentang relasi dalam atribut tambahan.
Relasi many-to-many temporal menambahkan kolom yang memberikan informasi temporal, seperti
active_from,active_to, ataucreated_on, untuk melacak validitas historis. Kuncienrolled_ondalam basis data mahasiswa–mata kuliah kita sebelumnya adalah salah satu contoh relasi temporal.Ini sangat penting untuk jejak audit, relasi yang berubah perlahan, dan analisis titik waktu. Hal ini menambah sedikit kompleksitas di mana pengguna harus berhati-hati memfilter pada skala temporal yang tepat dan mempertimbangkan baris yang mungkin tidak aktif.
Relasi berbobot, di sisi lain, menyimpan metrik peringkat atau kekuatan. Engine rekomendasi, sistem penandaan, dan penilaian relevansi umumnya bergantung pada pola ini untuk melacak hal seperti tingkat keyakinan rekomendasi.
Relasi multi-arah
Walaupun sebagian besar sistem OLTP menghindari relasi yang melibatkan lebih dari dua entitas, sistem analitik sering menggunakannya. Tabel fakta dalam model dimensional secara efektif bertindak sebagai tabel perantara yang menghubungkan tabel pada tingkat granularitas yang berbeda. Desain ini kuat tetapi memerlukan disiplin saat melakukan kueri dan dokumentasi yang jelas.
Desain potensial adalah membuat tabel perantara Anda dengan foreign key ke semua entitas yang berpartisipasi.
Misalnya, jika kita melanjutkan contoh mahasiswa dan mata kuliah, tabel ketiga bisa berupa nomor ruang kelas. Sebuah tabel perantara dapat memuat foreign key untuk seorang mahasiswa pada kelas tertentu di ruangan tertentu. Mudah dilihat bahwa saat kita memperluas jumlah relasi, kueri dan skema menjadi semakin kompleks secara eksponensial.
Untuk pendalaman lebih lanjut dalam membangun basis data, pastikan mengikuti kursus kami tentang desain basis data.
Optimasi Kinerja dan Efisiensi Kueri
Dengan desain basis data yang rumit, kita harus melihat pertimbangan kinerja dan kueri. Semakin banyak komponen yang kita tambahkan, semakin besar kemungkinan kita menghadapi hambatan kinerja!
Pola kueri dan optimasi
Mari lihat beberapa cara kita mungkin melakukan kueri pada tabel perantara. Pola akses umum meliputi:
Untuk mengoptimalkan kueri ini:
Indekskan foreign key pada tabel perantara
Gunakan
GROUP BYatauDISTINCTuntuk mencegah perhitungan berlebihPertimbangkan covering index untuk beban baca yang tinggi
Spesifiklah pada klausa
WHEREuntuk membatasi seberapa banyak data yang di-join.Teknik-teknik ini mendasar untuk join dan agregasi yang efisien. Ingat juga, jika Anda mencoba menggunakan tabel perantara untuk menjembatani dua tabel, ada baiknya memikirkan bagaimana Anda dapat menggabungkan tiga tabel secara efisien.
Operasi massal dan konkurensi
Tabel perantara sering mengalami volume tulis yang tinggi. Penyisipan dan pembaruan secara batch mengurangi overhead transaksi.
Namun, kontensi tinggi pada foreign key populer dapat menciptakan hambatan penguncian. Pastikan memantau kinerja dan melakukan partisi tabel untuk memungkinkan paralelisasi.
Normalisasi vs denormalisasi
Mari luangkan waktu sejenak untuk melihat perbedaan kunci antara normalisasi dan denormalisasi sebagai pendekatan desain basis data:
Pertimbangkan benar pola akses, keahlian tim, dan batasan operasional.
Trade-off denormalisasi
Denormalisasi dapat meningkatkan kinerja pada sistem tulis-berat yang tidak sering berubah. Biayanya adalah kompleksitas yang bertambah, beban pemeliharaan meningkat, dan risiko data usang.
Pendapat saya: Denormalisasi sebaiknya hanya menjadi respons terukur terhadap hambatan baca-berat dan selalu dibangun dengan pemeriksaan konsistensi berkala.
Implementasi di Berbagai Sistem Basis Data
Sistem SQL dan NoSQL memiliki pendekatan yang sedikit berbeda untuk implementasi sistem many-to-many.
Arsitektur relasional dan NoSQL
Basis data relasional seperti PostgreSQL, MySQL, dan SQL Server mengimplementasikan relasi many-to-many secara eksplisit menggunakan tabel perantara dengan foreign key dan primary key komposit. Demikian pula, basis data relasional berbasis cloud seperti Snowflake mengikuti pola desain serupa.
Sistem NoSQL sering merepresentasikan relasi many-to-many dengan menyematkan array ID terkait atau menyimpan referensi yang dikelola oleh logika aplikasi. Ini karena prioritas performa baca dan skalabilitas horizontal pada basis data NoSQL. Pendekatan ini meningkatkan performa baca dan fleksibilitas skema tetapi mengorbankan normalisasi.
Fitur
Relasional (SQL)
NoSQL
Implementasi
Tabel Perantara: Menggunakan tabel ketiga dengan foreign key dan primary key komposit.
Embedding atau Referencing: Menggunakan array ID atau dokumen bertingkat.
Tujuan Utama
Normalisasi: Memastikan konsistensi data dan menghilangkan redundansi.
Performa: Memprioritaskan kecepatan baca dan skalabilitas horizontal.
Fleksibilitas
Skema Kaku: Memerlukan struktur yang telah ditentukan dan join untuk mengambil data.
Fleksibilitas Tinggi: Memungkinkan desain tanpa skema dan tipe data yang beragam.
Trade-off
Join Kompleks: Dapat menjadi lebih lambat saat dataset tumbuh signifikan.
Mengorbankan Normalisasi: Dapat menyebabkan duplikasi data atau data "usang".
Contoh
PostgreSQL, MySQL, SQL Server, Snowflake.
MongoDB, DynamoDB, Cassandra.
SQL vs NoSQL
Basis data relasional lebih disukai saat Anda memerlukan struktur skema yang terdefinisi dengan baik. Basis data ini lebih mudah dimanipulasi dan memungkinkan pengelolaan data yang lebih baik. Pertimbangkan untuk berfokus menggunakan basis data SQL relasional ketika:
Basis data NoSQL cocok untuk situasi di mana fleksibilitas dan kemampuan operasi massal menjadi prioritas. Misalnya, basis data NoSQL seperti MongoDB memungkinkan penggunaan operator seperti
updateManysaat kita perlu memperbarui lintas banyak dokumen. Berikut beberapa prinsip panduan kapan Anda sebaiknya mempertimbangkan implementasi NoSQL:Kesimpulan
Relasi many-to-many tak terhindarkan dalam model data yang realistis. Merancangnya dengan benar sangat penting untuk integritas data, skalabilitas, dan ketepatan analitis. Tabel perantara, ketika dinormalisasi dan diindeks dengan benar, menyediakan fondasi yang tangguh yang dapat diskalakan dari sistem transaksional hingga analitik tingkat perusahaan.
Setiap desain melibatkan trade-off: normalisasi versus performa, kesederhanaan versus fleksibilitas, dan abstraksi versus kontrol. Kuncinya adalah memprofil pola akses Anda, memilih pola yang selaras dengan beban kerja, serta memvalidasi desain melalui peninjauan skema dan pengujian kueri.
Bagi praktisi yang ingin memperdalam keterampilan desain basis data, saya sangat merekomendasikan untuk mendaftar pada jalur karier Associate Data Analyst in SQL kami.