Kullanıcılar ve takipçiler, öğrenciler ve dersler, müşteriler ve ürünler: dünyamız doğal çoktan çoğa ilişkilerle dolu. Ancak bunlar her zaman veritabanı tasarımlarına iyi çevrilmez. Kötü tasarlanmış çoktan çoğa ilişkiler, üretim sistemlerinde en yaygın veri çoğaltma kaynaklarından, hatalı analitiklerden ve uzun vadeli bakım sıkıntılarından biridir.
Bu yazıda, çoktan çoğa ilişkileri ilk ilkelerden gerçek dünya uygulamasına kadar ele alacağım. Ayrıca gelişmiş tasarım kalıplarını, normalleştirmeyi, performans hususlarını ve çoktan çoğa ilişkilerin ilişkisel ve NoSQL sistemlerde nasıl uygulandığını inceleyeceğiz.
Sonunda, karmaşık ilişkileri doğru şekilde modelleyen, verimli ölçeklenen ve bakım kolaylığı sağlayan şemalar tasarlayabilecek, veri anomalilerinden kaçınabilecek ve güvenilir raporlama ile BI iş akışlarını destekleyebileceksiniz.
Yolda temelleri pekiştirmek isteyen okurlar için SQL ile İlişkisel Veritabanlarına Giriş kursunu öneririm.
Çoktan Çoğa İlişki Nedir
Çoktan çoğa ilişki (M:N), Tablo A’daki her kaydın Tablo B’deki birçok kayıtla, Tablo B’deki her kaydın da Tablo A’daki birçok kayıtla ilişkili olabildiği çift yönlü bir veritabanı ilişkisidir. Daha basit ilişki türlerinden farklı olarak, her iki tarafta da kardinalite vardır.
Bu ilişki gerçek sistemlerde yaygındır:
- Eğitim: Bir öğrenci birçok derse kayıt olabilir ve her dersin birçok öğrencisi olabilir.
- E-ticaret: Bir ürün birden fazla kategoriye ait olabilir ve her kategori birçok ürün içerebilir.
- Sosyal platformlar: Kullanıcılar birçok gruba katılabilir ve gruplar birçok kullanıcı barındırabilir.
- Sağlık: Bir hastaya birden fazla ilaç reçete edilebilir ve her ilaç birçok hastaya reçete edilebilir.
İlişki anlam taşır ve çoğu zaman kendi verisini de barındırır. Bu ayrımı anlamak, özellikle analitik için tabloları birleştirirken doğru şema tasarımı ve sorgulama açısından kritiktir.
Çoktan çoğa vs bire çok ilişki
Çoktan çoğa ilişkilerin neden özel işlem gerektirdiğini anlamak için, onları daha basit kardinalitelerle karşılaştırmak faydalıdır.
- Bire bir (1:1): Tablo A’daki her kayıt, Tablo B’deki tam olarak bir kayıtla ilişkilidir ve tersi de geçerlidir (ör. bir kullanıcı ve kullanıcı profili).
- Bire çok (1:N): Tablo A’daki bir kayıt, Tablo B’deki birçok kayıtla ilişkili olabilir, ancak Tablo B’deki her kayıt yalnızca Tablo A’daki bir kayıtla ilişkilidir (ör. bir müşteri ve siparişleri).
|
İlişki Türü
|
Açıklama
|
Mantık
|
Örnek
|
|
Bire Bir (1:1)
|
Tablo A’daki her kayıt, Tablo B’de tam olarak bir kayıtla ilişkilidir.
|
Benzersiz eşleşme.
|
Kullanıcı ↔ Kullanıcı Profili
|
|
Bire Çok (1:N)
|
Tablo A’daki bir kayıt Tablo B’de birçok kayıtla ilişkilidir, ancak Tablo B kayıtlarının yalnızca bir üst kaydı vardır.
|
Ebeveyn/Çocuk yapısı.
|
Müşteri → Birden Çok Sipariş
|
|
Çoktan Çoğa (M:N)
|
Tablo A’daki birden çok kayıt Tablo B’deki birden çok kayda bağlıdır.
|
Çift yönlü ağ.
|
Öğrenciler ↔ Dersler
|
Örneğin, bire çok tasarımda, siparişler tablosu genellikle her bir benzersiz siparişin bir order_id’si olacak şekilde bir customer_id yabancı anahtarı içerir. Her sipariş tam olarak bir müşteriye aittir, ancak bir müşterinin birden çok order_id anahtarı olabilir.
Şimdi bunu öğrenci–ders örneğiyle karşılaştırın. course_id bilgisini doğrudan öğrenciler tablosunda tutmaya çalışırsanız, her öğrenci birden çok course_id değeriyle ilişkilendirilecektir. Benzer şekilde, ders tablosunda her dersin birden çok student_id referansı olacaktır. Tertipli tek yönlü bir ilişki yerine, her iki yön de karşılıklı bilgi paylaşır.
Yaygın bir sorun, çoktan çoğa ilişkileri doğrudan temsil etmeye çalışırken tek bir sütunda birden çok değeri saklamaktır; örneğin bir students tablosunda course_ids dizisi kullanmak veya course_1, course_2, course_3 gibi tekrar eden sütunlar oluşturmak.
Bu yaklaşım, her sütunun atomik, bölünemez değerler içermesini zorunlu kılan Birinci Normal Formu’nu (1NF) ihlal eder. Tazeleme için şu SQL’de normalleştirme blogunu okuyun.
1NF’yi ihlal etmek, klasik güncelleme anomalilerine yol açar:
- Ekleme anomalileri: Yeni bir ilişki eklemek, mevcut bir satır yapısının değiştirilmesini gerektirir.
- Güncelleme anomalileri: Bir ilişkiyi değiştirmek, birden çok satırın, birden çok sütunun veya gömülü değerlerin güncellenmesini gerektirerek tutarsızlık riskini artırır.
- Silme anomalileri: Bir ilişkiyi kaldırmak, yanlışlıkla ilgisiz bilgilerin de silinmesine neden olabilir.
Normalleştirme teorisinin ötesinde, çoktan çoğa problemi olarak bilinen ciddi bir analitik sonuç vardır. Çoktan çoğa ilişkiye sahip tablolar dikkatli bir şekilde birleştirilmediğinde, satırların katlanmasına yol açabilir. Bu da hesaplama süresiyle ilgili sorunlara ve analiz için toplamlarda hatalara neden olabilir.
Örneğin, students tablosuna student_id temelinde courses tablosunu bağlamak, aynı kursun birden çok öğrenci kaydı nedeniyle birden fazla kez eşleşmesine yol açabilir. Ardından toplama girişimi, gelir veya öğrenci sayıları gibi analitik tutarsızlıklara neden olabilir.
Doğru şema tasarımı, raporlama doğruluğunu, finansal hesaplamaları ve veri ürünlerine duyulan güveni doğrudan etkiler. Ayrıca, birleştirmeleri basitleştirerek insan hatasını en aza indirmeye yardımcı olur. Yaygın JOIN tuzakları hakkında daha fazla bilgi için şu SQL join eğitimine göz atın ve şu En İyi 20 SQL Join Sorusu üzerinde pratik yapın.
Bağlantı Tabloları: Temel ve Yapı
İlişkisel sistemlerde çoktan çoğa ilişkilerin standart çözümü bağlantı tablosudur (join table, bridge table veya associative table olarak da adlandırılır). İlişkileri doğrudan saklamaya çalışmak yerine, her iki ana tabloya referans veren bir ara tablo eklersiniz.
Kavramsal olarak, bu durum A ↔ B’yi A ← JT→ B’ye dönüştürür.
Artık her birinin bağlantı tablosuyla bire çok ilişkisi vardır ve bu da daha sade bir analitik şema sağlar. Bu bağlantı tablolarını nasıl oluşturduğumuzu ve nasıl kullandığımızı anlatacağım.
Yapı ve bileşenler
Temel bir bağlantı tablosu şunları içerir:
- Tablo A’nın birincil anahtarına referans veren bir yabancı anahtar
- Tablo B’nin birincil anahtarına referans veren bir yabancı anahtar
Çoğu durumda, bu iki yabancı anahtar birlikte bir bileşik birincil anahtar oluşturur. Bu, aynı ilişkinin iki kez eklenmesini engeller ve benzersizliği veritabanı düzeyinde zorunlu kılar.
Örneğin bir enrollments tablosu, student_id ve course_id’nin birleştirilmesini birincil anahtar olarak kullanabilir. Veritabanının artık ilişki için benzersiz bir referans anahtarı vardır ve iş kullanım örneklerini oluşturmaya başlayabiliriz.
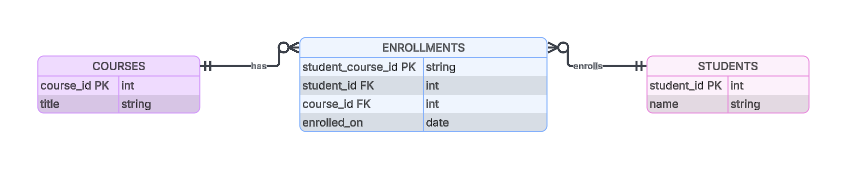
enrollments bağlantı tablosunun nasıl görünebileceğine dair bir örnek.
Bağlantı tablolarına öznitelik ekleme
Bir bağlantı tablosu ek öznitelikler sakladığında, salt yapısal bir unsurdan ziyade ilişkisel bir varlığa (associative entity) yaklaşır. Bu, bağlantı tablosunun ilişkinin bağlamsal bilgisini içermesine olanak tanır. Yaygın örnekler şunlardır:
-
Tarih: enrollment_date, creation_date ve benzeri zamana dayalı bilgiler
-
Rol: ör. bir grupta yönetici ve üye
-
Metrikler: öneri sistemlerinde alaka puanlaması
Bu, ilişkinin daha fazla anlam taşımasına yardımcı olur. Sorgu karmaşıklığı biraz artsa da şema gerçeği daha doğru yansıtır. Bu değiş tokuş, ilişkilerin zaman içinde evrildiği sistemlerde neredeyse her zaman değerdir. Daha fazla bilgi ekleyebilir ve bağlantı tablolarını kullanışlı bir analitik araca dönüştürebiliriz.
Veri bütünlüğünü koruma
Bağlantı tabloları büyük ölçüde başvuru bütünlüğüne dayanır. Yabancı anahtar kısıtları, her ilişki satırının geçerli üst kayıtları referanslamasını sağlar ve sahipsiz verileri önler.
Silme kuralları önemlidir:
- CASCADE: Bir üst kayıt silindiğinde bağlantı satırlarını otomatik olarak kaldırır.
- RESTRICT / NO ACTION: İlişkiler hâlâ mevcutsa üst kaydın silinmesini engeller.
Seçim, iş mantığına bağlıdır. Bazı alanlarda otomatik temizlik uygundur; diğerlerinde ise tarihsel ilişkilerin korunması veya silmeden önce açıkça gözden geçirilmesi gerekir.
Normalleştirme ve bağlantı tabloları
Bağlantı tabloları, Üçüncü Normal Form’un (3NF) doğrudan bir uygulamasıdır. Geçişli bağımlılıkları ortadan kaldırır ve ilişki verisinin yinelenen depolanmasını kaldırır. Tüm amacı, veritabanındaki normalleştirmeyi iyileştirmektir.
Çoğu durumda bağlantı tabloları, bileşik birincil anahtarın anahtar olmayan tüm öznitelikleri tam olarak belirlemesi sayesinde Boyce–Codd Normal Formu’nu (BCNF) sağlamaya da yardımcı olur. Bu önemlidir; çünkü güncelleme anomalilerini en aza indirir ve bir ilişkiyi değiştirmek için tam olarak bir satırın güncellenmesini garanti eder.
Veritabanlarımızda 3NF’yi sağlamanın önemini daha iyi anlamak için, şu geçişli bağımlılık makalesine göz atın.
Çoktan Çoğa İlişkilerin Tasarımı ve Uygulaması
Veritabanlarımızı çoktan çoğa ilişkileri destekleyecek şekilde nasıl gerçekten inşa edebileceğimizi tartışalım. Hayatınızı kolaylaştıracak iyi uygulamaları ele alacağız.
Adlandırma kuralları ve şema açıklığı
Açık tablo adlandırma, bilişsel yükü azaltır ve bakım kolaylığını artırır. Yaygın kurallar genellikle TableA_TableB veya join_TableATableB biçimindedir; örneğin:
-
student_course
-
user_group
-
join_user_group
Sütun adları, birleştirmeleri açık ve okunaklı kılmak için üst tablonun birincil anahtarlarını yansıtmalıdır (ör. student_id, course_id). Şemalar büyüdükçe ve ekipler genişledikçe tutarlılık kritik hâle gelir.
Yaygın kalıplar ve varyasyonlar
Bağlantı tablolarımızı çok basit ilişki takibinden daha karmaşık polimorfik ilişkilere kadar birkaç farklı şekilde kurabiliriz.
Basit bağlantı tabloları
Basit bağlantı tabloları yalnızca yabancı anahtarlar içerir ve statik veya bağlamı düşük ilişkiler için idealdir. Genellikle iki tablonun nasıl ilişkili olduğunu göstermeyle ilgilendikleri için, en az ek yükle bakımaları çok kolaydır. Bu bağlantı tablolarında zamansal veya bağlamsal veri bulunmaz.
Kendine referans veren çoktan çoğa ilişkiler
Kendine referans veren çoktan çoğa ilişkiler, her iki yabancı anahtarın da aynı tabloyu referanslamasıyla ortaya çıkar.
Örneğin, kullanıcıları, takipçilerini ve kimin kimi takip ettiğini izleyen bir sosyal medya uygulamasını takip ediyorsak, iki yönde de user_id ile follower_id arasında bir ilişki olabilir. Geçersiz veya simetrik yinelenenleri önlemek için ek kısıtlar gerekebilir.
Polimorfik çoktan çoğa ilişkiler
Polimorfik çoktan çoğa ilişkiler, bir tür ayrıştırıcı (type discriminator) kullanarak bir bağlantı tablosunun birden fazla varlık türünü bağlamasına olanak tanır. Bu esneklik sağlar ancak bütünlüğü uygulama mantığına kaydırır ve sorguları karmaşıklaştırır.
Örneğin, sosyal medya uygulamaları için Tag adlı bir bağlantı tablosu, etiketi doğru varlıkla ilişkilendirmek için ek bir bağlamsal sütunla Posts, Comments ve Users ile ilişki kurabilir.
Zamansal ve ağırlıklı ilişkiler
Zamansal ve ağırlıklı ilişkiler, ilişkinin bilgilerini ek özniteliklerde saklar.
Zamansal çoktan çoğa ilişkiler, tarihsel geçerliliği izlemek için active_from, active_to veya created_on gibi zamansal bilgi sağlayan sütunlar ekler. Daha önceki öğrenci–ders veritabanımızdaki enrolled_on anahtarı, zamansal ilişkilere bir örnektir.
Bunlar, denetim izleri, yavaş değişen ilişkiler ve belirli bir zamandaki analiz için gereklidir. Bu, kullanıcıların uygun zamansal ölçekte filtreleme yapmasına ve pasif olabilecek satırları dikkate almasına özen göstermesi gerektiği için biraz karmaşıklık ekler.
Ağırlıklı ilişkiler ise sıralama veya güç metriklerini saklar. Öneri motorları, etiketleme sistemleri ve alaka puanlaması, öneri güveni gibi unsurları izlemek için sıklıkla bu kalıba dayanır.
Çok yönlü ilişkiler
Çoğu OLTP sistemi iki varlıktan fazlasını içeren ilişkilerden kaçınsa da, analitik sistemler bunları sıklıkla kullanır. Boyutsal modellerdeki olgu (fact) tabloları, farklı ayrıntı seviyelerindeki tabloları bağlayan bağlantı tabloları gibi davranır. Bu tasarımlar güçlüdür ancak disiplinli sorgulama ve net dokümantasyon gerektirir.
Olası bir tasarım, bağlantı tablonuzu tüm katılımcı varlıklara yabancı anahtarlarla oluşturmaktır.
Örneğin, öğrenci ve ders örneğimizi genişletirsek, üçüncü bir tablo sınıf numaraları olabilir. Bir bağlantı tablosu, belirli bir sınıftaki belirli bir öğrenci için belirli bir odanın yabancı anahtarlarını içerebilir. İlişki sayısını artırdıkça sorgulamanın ve şemanın katlanarak daha karmaşık hâle geldiğini görmek kolaydır.
Veritabanı oluşturmaya daha derinlemesine dalmak için, mutlaka şu veritabanı tasarımı kursumuzu alın.
Karmaşık her veritabanı tasarımında, performans ve sorgu hususlarına bakmalıyız. Ne kadar çok parça eklersek, performans darboğazlarıyla karşılaşma olasılığımız o kadar artar!
Sorgu kalıpları ve optimizasyon
Önce bağlantı tablolarımızı nasıl sorgulayabileceğimize bakalım. Yaygın erişim kalıpları şunları içerir:
- Tablo A’daki belirli bir varlık için Tablo B’den tüm ilgili varlıkları getirme
- İlişkileri sayma
- İlişki özniteliklerine göre filtreleme
Bu sorguları optimize etmek için:
-
Bağlantı tablosundaki yabancı anahtarları indeksleyin
-
Aşırı sayımı önlemek için GROUP BY veya DISTINCT kullanın
-
Okuma ağırlıklı iş yükleri için kapsayıcı indeksleri düşünün
-
Birleştirilen veri miktarını sınırlamak için WHERE ifadelerinde spesifik olun.
Bu teknikler, verimli JOIN’ler ve toplamalar için temel niteliğindedir. Ayrıca, bağlantı tablosunu iki tablo arasında köprü olarak kullanmaya çalışıyorsanız, üç tabloyu verimli bir şekilde nasıl birleştirebileceğinizi düşünmek de iyidir.
Toplu işlemler ve eşzamanlılık
Bağlantı tablolarında sıklıkla yüksek yazma hacmi görülür. Toplu ekleme ve güncellemeler işlem yükünü azaltır.
Ancak popüler yabancı anahtarlarda yüksek çekişme, kilitlenme darboğazları yaratabilir. Performansı izleyin ve paralelleştirmeye olanak tanımak için tabloları bölümleyin.
Normalleştirme vs denormalizasyon
Veritabanı tasarımımıza yaklaşım olarak normalleştirme ve denormalizasyon arasındaki temel farka bir bakalım:
- Normalleştirilmiş tasarımlar, yazma ağırlıklı, tutarlılığı kritik sistemler için uygundur (ör. finans, ERP). Yinelenme veya gereksiz veri olasılığı olmadan sıkı tutarlılık gerekiyorsa, kesin biçimde normalleştirilmiş bir tasarıma odaklanın.
- Denormalize tasarımlar, sonradan tutarlılığın kabul edilebilir olduğu okuma ağırlıklı analitik için uygundur. Veri erişilebilirliğinin daha önemli olduğu, verinin daha sonra “oturmasına” razı olduğumuz durumlarda, en iyi uygulamalar için sıkı rehberlik sağlamak kaydıyla denormalize bir tasarım kullanılabilir.
Erişim kalıplarını, ekip uzmanlığını ve operasyonel kısıtları gerçekten düşünün.
Denormalizasyon değiş tokuşları
Denormalizasyon, sık değişmeyen yazma ağırlıklı sistemlerde performansı iyileştirebilir. Bedeli, artan karmaşıklık, daha yüksek bakım yükü ve bayat veri risktir.
Benim görüşüm: Denormalizasyon yalnızca okuma ağırlıklı darboğazlara ölçülü bir yanıt olmalı ve her zaman düzenli tutarlılık kontrolleriyle inşa edilmelidir.
Veritabanı Sistemlerinde Uygulama
SQL ve NoSQL sistemleri, çoktan çoğa sistemlerin uygulanmasına biraz farklı yaklaşımlar getirir.
İlişkisel ve NoSQL mimarileri
PostgreSQL, MySQL ve SQL Server gibi ilişkisel veritabanları, yabancı anahtarlar ve bileşik birincil anahtarlar içeren bağlantı tablolarını kullanarak çoktan çoğa ilişkileri açıkça uygular. Benzer şekilde, Snowflake gibi bulut tabanlı ilişkisel veritabanları da benzer bir tasarım kalıbını izler.
NoSQL sistemleri ise çoktan çoğa ilişkileri genellikle ilişkili kimliklerden oluşan dizileri gömerek veya uygulama mantığı tarafından yönetilen referanslar saklayarak temsil eder. Bu, NoSQL veritabanlarında okuma performansı ve yatay ölçeklenebilirliğin öncelikli olmasındandır. Bu yaklaşım okuma performansını ve şema esnekliğini artırır; ancak normalleştirmeden ödün verir.
|
Özellik
|
İlişkisel (SQL)
|
NoSQL
|
|
Uygulama
|
Bağlantı Tabloları: Yabancı anahtarlar ve bileşik birincil anahtarlar içeren üçüncü bir tablo kullanır.
|
Gömme veya Referanslama: Kimlik dizileri veya iç içe belgeler kullanır.
|
|
Birincil Hedef
|
Normalleştirme: Veri tutarlılığını sağlar ve fazlalığı ortadan kaldırır.
|
Performans: Okuma hızını ve yatay ölçeklenebilirliği önceliklendirir.
|
|
Esneklik
|
Katı Şema: Veriyi almak için önceden tanımlı yapılar ve JOIN’ler gerekir.
|
Yüksek Esneklik: Şemasız tasarımlara ve çeşitli veri türlerine izin verir.
|
|
Değiş Tokuş
|
Karmaşık JOIN’ler: Veri kümesi önemli ölçüde büyüdükçe yavaşlayabilir.
|
Normalleştirmeden Ödün: Veri çoğaltmaya veya “bayat” veriye yol açabilir.
|
|
Örnekler
|
PostgreSQL, MySQL, SQL Server, Snowflake.
|
MongoDB, DynamoDB, Cassandra.
|
SQL vs NoSQL
İyi tanımlanmış bir şema yapısına ihtiyaç duyduğunuzda ilişkisel veritabanlarını tercih edersiniz. Bu veritabanlarıyla çalışmak daha kolaydır ve daha iyi veri yönetimi sağlar. Aşağıdaki durumlarda ilişkisel bir SQL veritabanına odaklanmayı düşünün:
- İlişkiler sık sık değişiyorsa
- Bütünlük iş açısından kritikse
- Sorgular karmaşık JOIN’ler içeriyorsa
NoSQL veritabanları, esneklik ve toplu işlem yapılabilirliğin öncelikli olduğu durumlar için uygundur. Örneğin MongoDB gibi NoSQL veritabanları, çok sayıda belge üzerinde güncelleme yapmamız gerektiğinde updateMany gibi operatörlerin kullanılmasına olanak tanır. NoSQL uygulamasını düşünmeniz gereken durumlar için bazı kılavuz ilkeler şunlardır:
- Kardinalite öngörülebilir
- Okumalar yazmalardan katbekat fazlaysa
- Şema esnekliği, sıkı tutarlılığa baskın geliyorsa
Sonuç
Gerçekçi veri modellerinde çoktan çoğa ilişkiler kaçınılmazdır. Bunları doğru şekilde tasarlamak, veri bütünlüğü, ölçeklenebilirlik ve analitik doğruluk için kritiktir. Uygun şekilde normalleştirilen ve indekslenen bağlantı tabloları, işlem sistemlerinden kurumsal analitiğe kadar ölçeklenen sağlam bir temel sağlar.
Her tasarım, normalleştirme ile performans, sadelik ile esneklik ve soyutlama ile kontrol arasında değiş tokuşlar içerir. Önemli olan erişim kalıplarınızı profillemek, iş yükünüzle uyumlu kalıpları seçmek ve tasarımları şema incelemesi ile sorgu testleri üzerinden doğrulamaktır.
Veritabanı tasarımında becerilerini derinleştirmek isteyen uygulayıcılar için, SQL’de Associate Veri Analisti kariyer yoluna kaydolmanızı şiddetle tavsiye ederim.





Kullanıcılar ve takipçiler, öğrenciler ve dersler, müşteriler ve ürünler: dünyamız doğal çoktan çoğa ilişkilerle dolu. Ancak bunlar her zaman veritabanı tasarımlarına iyi çevrilmez. Kötü tasarlanmış çoktan çoğa ilişkiler, üretim sistemlerinde en yaygın veri çoğaltma kaynaklarından, hatalı analitiklerden ve uzun vadeli bakım sıkıntılarından biridir.
Bu yazıda, çoktan çoğa ilişkileri ilk ilkelerden gerçek dünya uygulamasına kadar ele alacağım. Ayrıca gelişmiş tasarım kalıplarını, normalleştirmeyi, performans hususlarını ve çoktan çoğa ilişkilerin ilişkisel ve NoSQL sistemlerde nasıl uygulandığını inceleyeceğiz.
Sonunda, karmaşık ilişkileri doğru şekilde modelleyen, verimli ölçeklenen ve bakım kolaylığı sağlayan şemalar tasarlayabilecek, veri anomalilerinden kaçınabilecek ve güvenilir raporlama ile BI iş akışlarını destekleyebileceksiniz.
Yolda temelleri pekiştirmek isteyen okurlar için SQL ile İlişkisel Veritabanlarına Giriş kursunu öneririm.
Çoktan Çoğa İlişki Nedir
Çoktan çoğa ilişki (M:N), Tablo A’daki her kaydın Tablo B’deki birçok kayıtla, Tablo B’deki her kaydın da Tablo A’daki birçok kayıtla ilişkili olabildiği çift yönlü bir veritabanı ilişkisidir. Daha basit ilişki türlerinden farklı olarak, her iki tarafta da kardinalite vardır.
Bu ilişki gerçek sistemlerde yaygındır:
İlişki anlam taşır ve çoğu zaman kendi verisini de barındırır. Bu ayrımı anlamak, özellikle analitik için tabloları birleştirirken doğru şema tasarımı ve sorgulama açısından kritiktir.
Çoktan çoğa vs bire çok ilişki
Çoktan çoğa ilişkilerin neden özel işlem gerektirdiğini anlamak için, onları daha basit kardinalitelerle karşılaştırmak faydalıdır.
İlişki Türü
Açıklama
Mantık
Örnek
Bire Bir (1:1)
Tablo A’daki her kayıt, Tablo B’de tam olarak bir kayıtla ilişkilidir.
Benzersiz eşleşme.
Kullanıcı ↔ Kullanıcı Profili
Bire Çok (1:N)
Tablo A’daki bir kayıt Tablo B’de birçok kayıtla ilişkilidir, ancak Tablo B kayıtlarının yalnızca bir üst kaydı vardır.
Ebeveyn/Çocuk yapısı.
Müşteri → Birden Çok Sipariş
Çoktan Çoğa (M:N)
Tablo A’daki birden çok kayıt Tablo B’deki birden çok kayda bağlıdır.
Çift yönlü ağ.
Öğrenciler ↔ Dersler
Örneğin, bire çok tasarımda, siparişler tablosu genellikle her bir benzersiz siparişin bir
order_id’si olacak şekilde bircustomer_idyabancı anahtarı içerir. Her sipariş tam olarak bir müşteriye aittir, ancak bir müşterinin birden çokorder_idanahtarı olabilir.Şimdi bunu öğrenci–ders örneğiyle karşılaştırın.
course_idbilgisini doğrudan öğrenciler tablosunda tutmaya çalışırsanız, her öğrenci birden çokcourse_iddeğeriyle ilişkilendirilecektir. Benzer şekilde, ders tablosunda her dersin birden çokstudent_idreferansı olacaktır. Tertipli tek yönlü bir ilişki yerine, her iki yön de karşılıklı bilgi paylaşır.Birinci Normal Form İhlali ve Çoktan Çoğa Problemi
Yaygın bir sorun, çoktan çoğa ilişkileri doğrudan temsil etmeye çalışırken tek bir sütunda birden çok değeri saklamaktır; örneğin bir
studentstablosundacourse_idsdizisi kullanmak veyacourse_1,course_2,course_3gibi tekrar eden sütunlar oluşturmak.Bu yaklaşım, her sütunun atomik, bölünemez değerler içermesini zorunlu kılan Birinci Normal Formu’nu (1NF) ihlal eder. Tazeleme için şu SQL’de normalleştirme blogunu okuyun.
1NF’yi ihlal etmek, klasik güncelleme anomalilerine yol açar:
Normalleştirme teorisinin ötesinde, çoktan çoğa problemi olarak bilinen ciddi bir analitik sonuç vardır. Çoktan çoğa ilişkiye sahip tablolar dikkatli bir şekilde birleştirilmediğinde, satırların katlanmasına yol açabilir. Bu da hesaplama süresiyle ilgili sorunlara ve analiz için toplamlarda hatalara neden olabilir.
Örneğin,
studentstablosunastudent_idtemelindecoursestablosunu bağlamak, aynı kursun birden çok öğrenci kaydı nedeniyle birden fazla kez eşleşmesine yol açabilir. Ardından toplama girişimi, gelir veya öğrenci sayıları gibi analitik tutarsızlıklara neden olabilir.Doğru şema tasarımı, raporlama doğruluğunu, finansal hesaplamaları ve veri ürünlerine duyulan güveni doğrudan etkiler. Ayrıca, birleştirmeleri basitleştirerek insan hatasını en aza indirmeye yardımcı olur. Yaygın JOIN tuzakları hakkında daha fazla bilgi için şu SQL join eğitimine göz atın ve şu En İyi 20 SQL Join Sorusu üzerinde pratik yapın.
Bağlantı Tabloları: Temel ve Yapı
İlişkisel sistemlerde çoktan çoğa ilişkilerin standart çözümü bağlantı tablosudur (join table, bridge table veya associative table olarak da adlandırılır). İlişkileri doğrudan saklamaya çalışmak yerine, her iki ana tabloya referans veren bir ara tablo eklersiniz.
Kavramsal olarak, bu durum A ↔ B’yi A ← JT→ B’ye dönüştürür.
Artık her birinin bağlantı tablosuyla bire çok ilişkisi vardır ve bu da daha sade bir analitik şema sağlar. Bu bağlantı tablolarını nasıl oluşturduğumuzu ve nasıl kullandığımızı anlatacağım.
Yapı ve bileşenler
Temel bir bağlantı tablosu şunları içerir:
Çoğu durumda, bu iki yabancı anahtar birlikte bir bileşik birincil anahtar oluşturur. Bu, aynı ilişkinin iki kez eklenmesini engeller ve benzersizliği veritabanı düzeyinde zorunlu kılar.
Örneğin bir
enrollmentstablosu,student_idvecourse_id’nin birleştirilmesini birincil anahtar olarak kullanabilir. Veritabanının artık ilişki için benzersiz bir referans anahtarı vardır ve iş kullanım örneklerini oluşturmaya başlayabiliriz.enrollmentsbağlantı tablosunun nasıl görünebileceğine dair bir örnek.Bağlantı tablolarına öznitelik ekleme
Bir bağlantı tablosu ek öznitelikler sakladığında, salt yapısal bir unsurdan ziyade ilişkisel bir varlığa (associative entity) yaklaşır. Bu, bağlantı tablosunun ilişkinin bağlamsal bilgisini içermesine olanak tanır. Yaygın örnekler şunlardır:
Tarih:
enrollment_date,creation_dateve benzeri zamana dayalı bilgilerRol: ör. bir grupta yönetici ve üye
Metrikler: öneri sistemlerinde alaka puanlaması
Bu, ilişkinin daha fazla anlam taşımasına yardımcı olur. Sorgu karmaşıklığı biraz artsa da şema gerçeği daha doğru yansıtır. Bu değiş tokuş, ilişkilerin zaman içinde evrildiği sistemlerde neredeyse her zaman değerdir. Daha fazla bilgi ekleyebilir ve bağlantı tablolarını kullanışlı bir analitik araca dönüştürebiliriz.
Veri bütünlüğünü koruma
Bağlantı tabloları büyük ölçüde başvuru bütünlüğüne dayanır. Yabancı anahtar kısıtları, her ilişki satırının geçerli üst kayıtları referanslamasını sağlar ve sahipsiz verileri önler.
Silme kuralları önemlidir:
Seçim, iş mantığına bağlıdır. Bazı alanlarda otomatik temizlik uygundur; diğerlerinde ise tarihsel ilişkilerin korunması veya silmeden önce açıkça gözden geçirilmesi gerekir.
Normalleştirme ve bağlantı tabloları
Bağlantı tabloları, Üçüncü Normal Form’un (3NF) doğrudan bir uygulamasıdır. Geçişli bağımlılıkları ortadan kaldırır ve ilişki verisinin yinelenen depolanmasını kaldırır. Tüm amacı, veritabanındaki normalleştirmeyi iyileştirmektir.
Çoğu durumda bağlantı tabloları, bileşik birincil anahtarın anahtar olmayan tüm öznitelikleri tam olarak belirlemesi sayesinde Boyce–Codd Normal Formu’nu (BCNF) sağlamaya da yardımcı olur. Bu önemlidir; çünkü güncelleme anomalilerini en aza indirir ve bir ilişkiyi değiştirmek için tam olarak bir satırın güncellenmesini garanti eder.
Veritabanlarımızda 3NF’yi sağlamanın önemini daha iyi anlamak için, şu geçişli bağımlılık makalesine göz atın.
Çoktan Çoğa İlişkilerin Tasarımı ve Uygulaması
Veritabanlarımızı çoktan çoğa ilişkileri destekleyecek şekilde nasıl gerçekten inşa edebileceğimizi tartışalım. Hayatınızı kolaylaştıracak iyi uygulamaları ele alacağız.
Adlandırma kuralları ve şema açıklığı
Açık tablo adlandırma, bilişsel yükü azaltır ve bakım kolaylığını artırır. Yaygın kurallar genellikle
TableA_TableBveyajoin_TableATableBbiçimindedir; örneğin:student_courseuser_groupjoin_user_groupSütun adları, birleştirmeleri açık ve okunaklı kılmak için üst tablonun birincil anahtarlarını yansıtmalıdır (ör.
student_id,course_id). Şemalar büyüdükçe ve ekipler genişledikçe tutarlılık kritik hâle gelir.Yaygın kalıplar ve varyasyonlar
Bağlantı tablolarımızı çok basit ilişki takibinden daha karmaşık polimorfik ilişkilere kadar birkaç farklı şekilde kurabiliriz.
Basit bağlantı tabloları
Basit bağlantı tabloları yalnızca yabancı anahtarlar içerir ve statik veya bağlamı düşük ilişkiler için idealdir. Genellikle iki tablonun nasıl ilişkili olduğunu göstermeyle ilgilendikleri için, en az ek yükle bakımaları çok kolaydır. Bu bağlantı tablolarında zamansal veya bağlamsal veri bulunmaz.
Kendine referans veren çoktan çoğa ilişkiler
Kendine referans veren çoktan çoğa ilişkiler, her iki yabancı anahtarın da aynı tabloyu referanslamasıyla ortaya çıkar.
Örneğin, kullanıcıları, takipçilerini ve kimin kimi takip ettiğini izleyen bir sosyal medya uygulamasını takip ediyorsak, iki yönde de
user_idilefollower_idarasında bir ilişki olabilir. Geçersiz veya simetrik yinelenenleri önlemek için ek kısıtlar gerekebilir.Polimorfik çoktan çoğa ilişkiler
Polimorfik çoktan çoğa ilişkiler, bir tür ayrıştırıcı (type discriminator) kullanarak bir bağlantı tablosunun birden fazla varlık türünü bağlamasına olanak tanır. Bu esneklik sağlar ancak bütünlüğü uygulama mantığına kaydırır ve sorguları karmaşıklaştırır.
Örneğin, sosyal medya uygulamaları için
Tagadlı bir bağlantı tablosu, etiketi doğru varlıkla ilişkilendirmek için ek bir bağlamsal sütunlaPosts,CommentsveUsersile ilişki kurabilir.Zamansal ve ağırlıklı ilişkiler
Zamansal ve ağırlıklı ilişkiler, ilişkinin bilgilerini ek özniteliklerde saklar.
Zamansal çoktan çoğa ilişkiler, tarihsel geçerliliği izlemek için
active_from,active_toveyacreated_ongibi zamansal bilgi sağlayan sütunlar ekler. Daha önceki öğrenci–ders veritabanımızdakienrolled_onanahtarı, zamansal ilişkilere bir örnektir.Bunlar, denetim izleri, yavaş değişen ilişkiler ve belirli bir zamandaki analiz için gereklidir. Bu, kullanıcıların uygun zamansal ölçekte filtreleme yapmasına ve pasif olabilecek satırları dikkate almasına özen göstermesi gerektiği için biraz karmaşıklık ekler.
Ağırlıklı ilişkiler ise sıralama veya güç metriklerini saklar. Öneri motorları, etiketleme sistemleri ve alaka puanlaması, öneri güveni gibi unsurları izlemek için sıklıkla bu kalıba dayanır.
Çok yönlü ilişkiler
Çoğu OLTP sistemi iki varlıktan fazlasını içeren ilişkilerden kaçınsa da, analitik sistemler bunları sıklıkla kullanır. Boyutsal modellerdeki olgu (fact) tabloları, farklı ayrıntı seviyelerindeki tabloları bağlayan bağlantı tabloları gibi davranır. Bu tasarımlar güçlüdür ancak disiplinli sorgulama ve net dokümantasyon gerektirir.
Olası bir tasarım, bağlantı tablonuzu tüm katılımcı varlıklara yabancı anahtarlarla oluşturmaktır.
Örneğin, öğrenci ve ders örneğimizi genişletirsek, üçüncü bir tablo sınıf numaraları olabilir. Bir bağlantı tablosu, belirli bir sınıftaki belirli bir öğrenci için belirli bir odanın yabancı anahtarlarını içerebilir. İlişki sayısını artırdıkça sorgulamanın ve şemanın katlanarak daha karmaşık hâle geldiğini görmek kolaydır.
Veritabanı oluşturmaya daha derinlemesine dalmak için, mutlaka şu veritabanı tasarımı kursumuzu alın.
Performans Optimizasyonu ve Sorgu Verimliliği
Karmaşık her veritabanı tasarımında, performans ve sorgu hususlarına bakmalıyız. Ne kadar çok parça eklersek, performans darboğazlarıyla karşılaşma olasılığımız o kadar artar!
Sorgu kalıpları ve optimizasyon
Önce bağlantı tablolarımızı nasıl sorgulayabileceğimize bakalım. Yaygın erişim kalıpları şunları içerir:
Bu sorguları optimize etmek için:
Bağlantı tablosundaki yabancı anahtarları indeksleyin
Aşırı sayımı önlemek için
GROUP BYveyaDISTINCTkullanınOkuma ağırlıklı iş yükleri için kapsayıcı indeksleri düşünün
Birleştirilen veri miktarını sınırlamak için
WHEREifadelerinde spesifik olun.Bu teknikler, verimli JOIN’ler ve toplamalar için temel niteliğindedir. Ayrıca, bağlantı tablosunu iki tablo arasında köprü olarak kullanmaya çalışıyorsanız, üç tabloyu verimli bir şekilde nasıl birleştirebileceğinizi düşünmek de iyidir.
Toplu işlemler ve eşzamanlılık
Bağlantı tablolarında sıklıkla yüksek yazma hacmi görülür. Toplu ekleme ve güncellemeler işlem yükünü azaltır.
Ancak popüler yabancı anahtarlarda yüksek çekişme, kilitlenme darboğazları yaratabilir. Performansı izleyin ve paralelleştirmeye olanak tanımak için tabloları bölümleyin.
Normalleştirme vs denormalizasyon
Veritabanı tasarımımıza yaklaşım olarak normalleştirme ve denormalizasyon arasındaki temel farka bir bakalım:
Erişim kalıplarını, ekip uzmanlığını ve operasyonel kısıtları gerçekten düşünün.
Denormalizasyon değiş tokuşları
Denormalizasyon, sık değişmeyen yazma ağırlıklı sistemlerde performansı iyileştirebilir. Bedeli, artan karmaşıklık, daha yüksek bakım yükü ve bayat veri risktir.
Benim görüşüm: Denormalizasyon yalnızca okuma ağırlıklı darboğazlara ölçülü bir yanıt olmalı ve her zaman düzenli tutarlılık kontrolleriyle inşa edilmelidir.
Veritabanı Sistemlerinde Uygulama
SQL ve NoSQL sistemleri, çoktan çoğa sistemlerin uygulanmasına biraz farklı yaklaşımlar getirir.
İlişkisel ve NoSQL mimarileri
PostgreSQL, MySQL ve SQL Server gibi ilişkisel veritabanları, yabancı anahtarlar ve bileşik birincil anahtarlar içeren bağlantı tablolarını kullanarak çoktan çoğa ilişkileri açıkça uygular. Benzer şekilde, Snowflake gibi bulut tabanlı ilişkisel veritabanları da benzer bir tasarım kalıbını izler.
NoSQL sistemleri ise çoktan çoğa ilişkileri genellikle ilişkili kimliklerden oluşan dizileri gömerek veya uygulama mantığı tarafından yönetilen referanslar saklayarak temsil eder. Bu, NoSQL veritabanlarında okuma performansı ve yatay ölçeklenebilirliğin öncelikli olmasındandır. Bu yaklaşım okuma performansını ve şema esnekliğini artırır; ancak normalleştirmeden ödün verir.
Özellik
İlişkisel (SQL)
NoSQL
Uygulama
Bağlantı Tabloları: Yabancı anahtarlar ve bileşik birincil anahtarlar içeren üçüncü bir tablo kullanır.
Gömme veya Referanslama: Kimlik dizileri veya iç içe belgeler kullanır.
Birincil Hedef
Normalleştirme: Veri tutarlılığını sağlar ve fazlalığı ortadan kaldırır.
Performans: Okuma hızını ve yatay ölçeklenebilirliği önceliklendirir.
Esneklik
Katı Şema: Veriyi almak için önceden tanımlı yapılar ve JOIN’ler gerekir.
Yüksek Esneklik: Şemasız tasarımlara ve çeşitli veri türlerine izin verir.
Değiş Tokuş
Karmaşık JOIN’ler: Veri kümesi önemli ölçüde büyüdükçe yavaşlayabilir.
Normalleştirmeden Ödün: Veri çoğaltmaya veya “bayat” veriye yol açabilir.
Örnekler
PostgreSQL, MySQL, SQL Server, Snowflake.
MongoDB, DynamoDB, Cassandra.
SQL vs NoSQL
İyi tanımlanmış bir şema yapısına ihtiyaç duyduğunuzda ilişkisel veritabanlarını tercih edersiniz. Bu veritabanlarıyla çalışmak daha kolaydır ve daha iyi veri yönetimi sağlar. Aşağıdaki durumlarda ilişkisel bir SQL veritabanına odaklanmayı düşünün:
NoSQL veritabanları, esneklik ve toplu işlem yapılabilirliğin öncelikli olduğu durumlar için uygundur. Örneğin MongoDB gibi NoSQL veritabanları, çok sayıda belge üzerinde güncelleme yapmamız gerektiğinde
updateManygibi operatörlerin kullanılmasına olanak tanır. NoSQL uygulamasını düşünmeniz gereken durumlar için bazı kılavuz ilkeler şunlardır:Sonuç
Gerçekçi veri modellerinde çoktan çoğa ilişkiler kaçınılmazdır. Bunları doğru şekilde tasarlamak, veri bütünlüğü, ölçeklenebilirlik ve analitik doğruluk için kritiktir. Uygun şekilde normalleştirilen ve indekslenen bağlantı tabloları, işlem sistemlerinden kurumsal analitiğe kadar ölçeklenen sağlam bir temel sağlar.
Her tasarım, normalleştirme ile performans, sadelik ile esneklik ve soyutlama ile kontrol arasında değiş tokuşlar içerir. Önemli olan erişim kalıplarınızı profillemek, iş yükünüzle uyumlu kalıpları seçmek ve tasarımları şema incelemesi ile sorgu testleri üzerinden doğrulamaktır.
Veritabanı tasarımında becerilerini derinleştirmek isteyen uygulayıcılar için, SQL’de Associate Veri Analisti kariyer yoluna kaydolmanızı şiddetle tavsiye ederim.