यूज़र्स और फॉलोअर्स, छात्र और पाठ्यक्रम, ग्राहक और उत्पाद: हमारी दुनिया स्वाभाविक मेनी-टू-मेनी रिलेशनशिप्स से भरी हुई है। हालाँकि, इन्हें डेटाबेस डिज़ाइनों में हमेशा अच्छी तरह रूपांतरित नहीं किया जाता। खराब तरीके से डिज़ाइन की गई मेनी-टू-मेनी रिलेशनशिप्स, डेटा डुप्लीकेशन, गलत एनालिटिक्स, और प्रोडक्शन सिस्टम्स में दीर्घकालिक मेंटेनेंस की परेशानी के सबसे आम स्रोतों में से एक हैं।
इस लेख में, मैं मेनी-टू-मेनी रिलेशनशिप्स को मूल सिद्धांतों से लेकर वास्तविक दुनिया के इम्प्लीमेंटेशन तक समझाऊँगा। हम उन्नत डिज़ाइन पैटर्न्स, नॉर्मलाइज़ेशन, परफॉर्मेंस संबंधी बातें, और रिलेशनल तथा NoSQL सिस्टम्स में मेनी-टू-मेनी रिलेशनशिप्स कैसे लागू होती हैं, इन पर भी चर्चा करेंगे।
अंत तक पहुँचते-पहुँचते, आप स्केलेबल, मेंटेन करने योग्य स्कीमा डिज़ाइन कर पाएँगे जो जटिल रिलेशनशिप्स को सही ढंग से मॉडल करें, डेटा विसंगतियों से बचें, और भरोसेमंद रिपोर्टिंग व BI वर्कफ़्लोज़ को सपोर्ट करें।
जो पाठक रास्ते में बुनियादी बातों को मज़बूत करना चाहते हैं, उनके लिए मैं हमारा Introduction to Relational Databases in SQL कोर्स लेने की सलाह देता हूँ।
मेनी-टू-मेनी रिलेशनशिप क्या है
मेनी-टू-मेनी रिलेशनशिप (M:N) एक द्विदिश डेटाबेस रिलेशनशिप है जिसमें टेबल A का प्रत्येक रिकॉर्ड टेबल B के कई रिकॉर्ड्स से संबंधित हो सकता है, और टेबल B का प्रत्येक रिकॉर्ड टेबल A के कई रिकॉर्ड्स से संबंधित हो सकता है। सरल रिलेशनशिप प्रकारों के विपरीत, दोनों ओर कार्डिनैलिटी मौजूद होती है।
यह रिलेशनशिप वास्तविक सिस्टम्स में सर्वव्यापी है:
- शिक्षा: एक छात्र कई पाठ्यक्रमों में नामांकन कर सकता है, और प्रत्येक पाठ्यक्रम में कई छात्र हो सकते हैं।
- ई-कॉमर्स: एक उत्पाद कई श्रेणियों में हो सकता है, और प्रत्येक श्रेणी में कई उत्पाद हो सकते हैं।
- सोशल प्लेटफ़ॉर्म: यूज़र्स कई समूहों में शामिल हो सकते हैं, और समूहों में कई यूज़र्स हो सकते हैं।
- हेल्थकेयर: एक मरीज को कई दवाएँ लिखी जा सकती हैं, और प्रत्येक दवा कई मरीजों को लिखी जा सकती है।
यह रिलेशनशिप अपने आप में अर्थ और प्रायः डेटा भी वहन करती है। इस भेद को समझना सही स्कीमा डिज़ाइन और क्वेरी करने के लिए महत्वपूर्ण है, खासकर जब एनालिटिक्स के लिए टेबल्स जोड़ी जाती हैं।
मेनी-टू-मेनी बनाम वन-टू-मेनी रिलेशनशिप
यह समझने के लिए कि मेनी-टू-मेनी रिलेशनशिप्स को विशेष हैंडलिंग की आवश्यकता क्यों होती है, उन्हें सरल कार्डिनैलिटी से तुलना करना उपयोगी है।
- वन-टू-वन (1:1): टेबल A का प्रत्येक रिकॉर्ड टेबल B के ठीक एक रिकॉर्ड से संबंधित होता है, और इसके विपरीत (जैसे, एक यूज़र और उसका यूज़र प्रोफाइल)।
- वन-टू-मेनी (1:N): टेबल A का एक रिकॉर्ड टेबल B के कई रिकॉर्ड्स से संबंधित हो सकता है, पर टेबल B का प्रत्येक रिकॉर्ड केवल टेबल A के एक रिकॉर्ड से संबंधित होता है (जैसे, एक ग्राहक और उसके ऑर्डर)।
|
रिलेशनशिप प्रकार
|
विवरण
|
तर्क
|
उदाहरण
|
|
वन-टू-वन (1:1)
|
टेबल A का प्रत्येक रिकॉर्ड टेबल B में ठीक एक रिकॉर्ड से संबंधित होता है।
|
अद्वितीय युग्मन।
|
User ↔ User Profile
|
|
वन-टू-मेनी (1:N)
|
टेबल A का एक रिकॉर्ड टेबल B के कई रिकॉर्ड्स से संबंधित होता है, लेकिन टेबल B के रिकॉर्ड्स का केवल एक पैरेंट होता है।
|
माता-पिता/संतान संरचना।
|
Customer → Multiple Orders
|
|
मेनी-टू-मेनी (M:N)
|
टेबल A के कई रिकॉर्ड्स टेबल B के कई रिकॉर्ड्स से संबंधित होते हैं।
|
द्विदिश जाल।
|
Students ↔ Courses
|
उदाहरण के लिए, एक वन-टू-मेनी डिज़ाइन में, ऑर्डर्स टेबल आमतौर पर customer_id विदेशी कुंजी रखती है और प्रत्येक अद्वितीय ऑर्डर का एक order_id होता है। प्रत्येक ऑर्डर ठीक एक ग्राहक का होता है, लेकिन एक ग्राहक के कई order_id कीज़ हो सकती हैं।
अब छात्र–पाठ्यक्रम वाले उदाहरण से इसकी तुलना करें। यदि आप course_id को सीधे स्टूडेंट्स टेबल पर स्टोर करने का प्रयास करते हैं, तो प्रत्येक छात्र कई course_id मानों से जुड़ा होगा। उलटे, कोर्स टेबल के अंदर, प्रत्येक कोर्स के पास कई student_id संदर्भ होंगे। सुथरे एकतरफ़ा रिलेशनशिप की बजाय, दोनों दिशाओं में सूचना का आदान-प्रदान होता है।
फ़र्स्ट नॉर्मल फ़ॉर्म का उल्लंघन और मेनी-टू-मेनी समस्या
एक आम समस्या यह है कि मेनी-टू-मेनी रिलेशनशिप्स को सीधे दर्शाने के लिए एक ही कॉलम में कई मानों को स्टोर किया जाता है, जैसे कि एक एरे के रूप में (उदा., students टेबल पर course_ids) या बार-बार दोहराए गए कॉलम जैसे course_1, course_2, course_3।
यह तरीका फ़र्स्ट नॉर्मल फ़ॉर्म (1NF) का उल्लंघन करता है, जो अपेक्षा करता है कि प्रत्येक कॉलम में एटॉमिक, अविभाज्य मान हों। याद ताज़ा करने के लिए इस ब्लॉग को पढ़ें: normalization in SQL ।
1NF का उल्लंघन क्लासिक अपडेट विसंगतियों की ओर ले जाता है:
- इन्सर्शन विसंगतियाँ: नया रिलेशनशिप जोड़ने के लिए मौजूदा रो स्ट्रक्चर में बदलाव करना पड़ता है।
- अपडेट विसंगतियाँ: किसी रिलेशनशिप को बदलने के लिए कई रो, कई कॉलम्स, या एम्बेडेड मानों को अपडेट करना पड़ता है, जिससे असंगति का जोखिम बढ़ता है।
- डिलीशन विसंगतियाँ: एक रिलेशनशिप हटाने पर अनजाने में असंबंधित जानकारी भी हट सकती है।
नॉर्मलाइज़ेशन थ्योरी से परे, एक गंभीर विश्लेषणात्मक परिणाम है जिसे मेनी-टू-मेनी समस्या कहा जाता है। जब मेनी-टू-मेनी रिलेशनशिप वाली टेबल्स को सावधानी से जॉइन नहीं किया जाता, तो रो गुणन आसानी से हो सकता है। इससे कंप्यूट समय में समस्या और विश्लेषण के दौरान एग्रीगेशन त्रुटियाँ हो सकती हैं।
उदाहरण के लिए, student_id के आधार पर courses को students से जोड़ने पर, कई छात्र प्रविष्टियों के कारण प्रत्येक कोर्स कई बार जॉइन हो सकता है। फिर एग्रीगेशन करने की कोशिश करने पर राजस्व या छात्र संख्या जैसे विश्लेषणात्मक अंतर आ सकते हैं।
सही स्कीमा डिज़ाइन का रिपोर्टिंग सटीकता, वित्तीय गणनाओं, और डेटा प्रोडक्ट्स में भरोसे पर सीधा प्रभाव पड़ता है। साथ ही, यह जॉइन्स को सरल बनाता है ताकि मानवीय त्रुटि कम से कम हो। सामान्य जॉइन कमियों पर अधिक जानकारी के लिए यह SQL जॉइन ट्यूटोरियल देखें और इन Top 20 SQL Joins Questions पर अभ्यास करें।
जंक्शन टेबल्स: नींव और संरचना
रिलेशनल सिस्टम्स में मेनी-टू-मेनी रिलेशनशिप्स का मानक समाधान जंक्शन टेबल है (जिसे जॉइन टेबल, ब्रिज टेबल, या एसोसिएटिव टेबल भी कहा जाता है)। सीधे रिलेशनशिप्स स्टोर करने की कोशिश करने की बजाय, आप एक मध्यवर्ती टेबल जोड़ते हैं जो दोनों पैरेंट टेबल्स को संदर्भित करती है।
अवधारणात्मक रूप से, यह A ↔ B को A ← JT→ B में बदल देता है।
अब, प्रत्येक का जंक्शन टेबल के साथ एक वन-टू-मेनी रिलेशनशिप होता है, जो एक सरल विश्लेषणात्मक स्कीमा की अनुमति देता है। मैं बताऊँगा कि हम इन जंक्शन टेबल्स को कैसे बनाते हैं और इनका उपयोग कैसे करते हैं।
संरचना और घटक
एक बुनियादी जंक्शन टेबल में शामिल होते हैं:
- एक फ़ॉरेन की जो टेबल A की प्राइमरी की को संदर्भित करती है
- एक फ़ॉरेन की जो टेबल B की प्राइमरी की को संदर्भित करती है
अधिकांश मामलों में, ये दोनों फ़ॉरेन कीज़ मिलकर एक समग्र प्राइमरी की बनाती हैं। यह सुनिश्चित करता है कि वही रिलेशनशिप दो बार नहीं डाली जा सकती और डेटाबेस स्तर पर विशिष्टता लागू होती है।
उदाहरण के लिए, एक enrollments टेबल अपनी प्राइमरी की के रूप में student_id और course_id का संयोजन उपयोग कर सकती है। अब डेटाबेस के पास रिलेशनशिप के लिए एक अद्वितीय रेफरेंस की है और हम व्यावसायिक उपयोग मामलों का निर्माण शुरू कर सकते हैं।
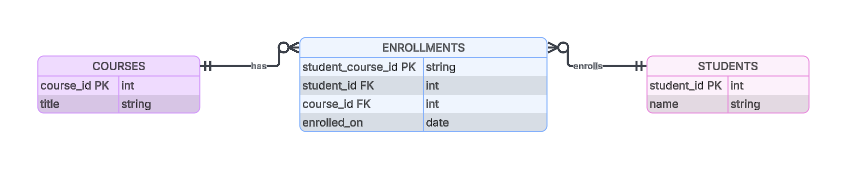
यह उदाहरण दिखाता है कि enrollments जंक्शन टेबल कैसी दिख सकती है।
जंक्शन टेबल्स में गुण जोड़ना
जब एक जंक्शन टेबल अतिरिक्त एट्रिब्यूट्स स्टोर करती है, तो वह शुद्ध संरचनात्मक कलाकृति के बजाय एक एसोसिएटिव एंटिटी के अधिक क़रीब हो जाती है। यह जंक्शन टेबल को रिलेशनशिप के बारे में प्रासंगिक जानकारी रखने देता है। सामान्य उदाहरण शामिल हैं:
-
तिथि: enrollment_date, creation_date, और समान समय-आधारित जानकारी
-
भूमिका: जैसे, समूह में एडमिन बनाम सदस्य
-
मैट्रिक्स: रिकमेंडेशन सिस्टम्स में प्रासंगिकता स्कोरिंग
यह रिलेशनशिप को अधिक अर्थपूर्ण बनने में मदद करता है। क्वेरी जटिलता थोड़ी बढ़ती है, लेकिन स्कीमा वास्तविकता का अधिक सटीक मॉडल बन जाता है। यह समझौता लगभग हमेशा उन सिस्टम्स में सार्थक होता है जहाँ समय के साथ रिलेशनशिप्स विकसित होती हैं। हम और जानकारी जोड़ सकते हैं और जंक्शन टेबल्स को एक उपयोगी विश्लेषणात्मक टूल बना सकते हैं।
डेटा अखंडता बनाए रखना
जंक्शन टेबल्स बड़े पैमाने पर रेफरेंशियल इंटीग्रिटी पर निर्भर रहती हैं। फ़ॉरेन की सीमाएँ सुनिश्चित करती हैं कि प्रत्येक रिलेशनशिप रो वैध पैरेंट रिकॉर्ड्स को संदर्भित करती है, जिससे अनाथ डेटा रोका जाता है।
डिलीशन नियम मायने रखते हैं:
- CASCADE: पैरेंट हटने पर जंक्शन रो अपने-आप हट जाएँ।
- RESTRICT / NO ACTION: यदि रिलेशनशिप्स मौजूद हैं तो पैरेंट रो को हटाने से रोकें।
चयन व्यावसायिक अर्थ-व्यंजना पर निर्भर करता है। कुछ डोमेन्स में स्वतः क्लीनअप उपयुक्त है; अन्य में, ऐतिहासिक रिलेशनशिप्स को संरक्षित रखना चाहिए या हटाने से पहले स्पष्ट रूप से समीक्षा की जानी चाहिए।
नॉर्मलाइज़ेशन और जंक्शन टेबल्स
जंक्शन टेबल्स थर्ड नॉर्मल फ़ॉर्म (3NF) का सीधा अनुप्रयोग हैं। ये पारगमन निर्भरताएँ समाप्त करती हैं और रिलेशनशिप डेटा के अनावश्यक भंडारण को हटाती हैं। इसका समूचा लक्ष्य डेटाबेस के भीतर नॉर्मलाइज़ेशन को बेहतर बनाना है।
कई मामलों में, जंक्शन टेबल्स Boyce–Codd नॉर्मल फ़ॉर्म (BCNF) को पूरा करने में भी मदद करती हैं क्योंकि समग्र प्राइमरी की सभी नॉन-की एट्रिब्यूट्स को पूर्णतः निर्धारित करती है। यह इसलिए महत्वपूर्ण है क्योंकि यह अपडेट विसंगतियों को कम करता है और सुनिश्चित करता है कि किसी रिलेशनशिप को संशोधित करने के लिए ठीक एक रो बदलनी पड़े।
हमारे डेटाबेस में 3NF सुनिश्चित करने के महत्व की गहरी समझ के लिए, इस ट्रांज़िटिव डिपेंडेंसी पर लेख को देखें।
मेनी-टू-मेनी रिलेशनशिप्स का डिज़ाइन और इम्प्लीमेंटेशन
आइए चर्चा करें कि हम वास्तव में अपने डेटाबेस कैसे बनाएँ ताकि मेनी-टू-मेनी रिलेशनशिप्स सपोर्ट हो सकें। हम आपके काम को आसान बनाने के लिए अच्छी प्रथाओं को कवर करेंगे।
नेमिंग कन्वेंशंस और स्कीमा स्पष्टता
स्पष्ट टेबल नामिंग संज्ञानात्मक बोझ कम करती है और मेंटेनबिलिटी में सुधार करती है। आम प्रथाएँ प्रायः TableA_TableB या join_TableATableB जैसी होती हैं, उदाहरण के लिए:
-
student_course
-
user_group
-
join_user_group
कॉलम नामों को पैरेंट टेबल की प्राइमरी कीज़ को प्रतिबिंबित करना चाहिए (जैसे, student_id, course_id) ताकि जॉइन्स स्पष्ट और पढ़ने में आसान हों। जैसे-जैसे स्कीमा बढ़ते हैं और टीमें फैलती हैं, स्थिरता अत्यंत महत्वपूर्ण हो जाती है।
आम पैटर्न्स और विविधताएँ
हम अपने जंक्शन टेबल्स कई तरीकों से बना सकते हैं—बहुत सरल रिलेशनशिप ट्रैकिंग से लेकर अधिक जटिल पॉलीमॉर्फिक रिलेशनशिप्स तक।
साधारण जंक्शन टेबल्स
साधारण जंक्शन टेबल्स में केवल फ़ॉरेन कीज़ होती हैं और वे स्थिर या कम-प्रसंग वाले रिलेशनशिप्स के लिए आदर्श हैं। इन्हें बनाए रखना बहुत आसान होता है और न्यूनतम ओवरहेड रहता है क्योंकि ये सामान्यतः केवल यह दिखाने से संबंधित होती हैं कि दो टेबल्स कैसे संबंधित हैं। इनमें कोई समयगत या प्रसंगगत डेटा नहीं होता।
स्व-रेफरेंसिंग मेनी-टू-मेनी रिलेशनशिप्स
स्व-रेफरेंसिंग मेनी-टू-मेनी रिलेशनशिप्स तब होती हैं जब दोनों फ़ॉरेन कीज़ एक ही टेबल को संदर्भित करती हैं।
उदाहरण के लिए, यदि हम एक सोशल मीडिया ऐप को ट्रैक कर रहे हैं जिसमें यूज़र्स, उनके फॉलोअर्स, और वे किन्हें फॉलो कर रहे हैं—इनका ट्रैक रखना शामिल है—तो हमारे पास दोनों दिशाओं में user_id से follower_id का रिलेशनशिप हो सकता है। अमान्य या सममित डुप्लीकेट्स को रोकने के लिए अतिरिक्त बाधाओं की आवश्यकता हो सकती है।
पॉलीमॉर्फिक मेनी-टू-मेनी रिलेशनशिप्स
पॉलीमॉर्फिक मेनी-टू-मेनी रिलेशनशिप्स एक प्रकार के डिस्क्रिमिनेटर का उपयोग करके एक जंक्शन टेबल को कई एंटिटी प्रकारों से जोड़ने देती हैं। यह लचीलापन प्रदान करती है लेकिन इंटीग्रिटी प्रवर्तन को एप्लिकेशन लॉजिक में स्थानांतरित करती है और क्वेरीज़ को जटिल बनाती है।
उदाहरण के लिए, सोशल मीडिया ऐप्स के लिए Tag नामक जंक्शन टेबल Posts, Comments, और Users से संबंधित हो सकती है, जिसमें टैग को उचित एंटिटी से जोड़ने के लिए एक अतिरिक्त प्रसंगगत कॉलम हो।
टेम्पोरल और वेटेड रिलेशनशिप्स
टेम्पोरल और वेटेड रिलेशनशिप्स दोनों ही अतिरिक्त एट्रिब्यूट्स में रिलेशनशिप के बारे में जानकारी स्टोर करते हैं।
टेम्पोरल मेनी-टू-मेनी रिलेशनशिप्स ऐसे कॉलम जोड़ती हैं जो समयगत जानकारी देते हैं, जैसे active_from, active_to, या created_on, ताकि ऐतिहासिक वैधता को ट्रैक किया जा सके। हमारे पहले वाले छात्र–पाठ्यक्रम डेटाबेस में enrolled_on कुंजी, टेम्पोरल रिलेशनशिप का एक उदाहरण है।
ये ऑडिट ट्रेल्स, धीरे-धीरे बदलती रिलेशनशिप्स, और पॉइंट-इन-टाइम विश्लेषण के लिए आवश्यक हैं। इससे थोड़ी जटिलता बढ़ती है, जहाँ उपयोगकर्ताओं को सही समयगत पैमाने पर फ़िल्टर करने और निष्क्रिय हो सकने वाली पंक्तियों पर विचार करने में सावधानी बरतनी चाहिए।
वेटेड रिलेशनशिप्स दूसरी ओर, रैंकिंग या स्ट्रेंथ मैट्रिक्स स्टोर करती हैं। रिकमेंडेशन इंजन, टैगिंग सिस्टम्स, और प्रासंगिकता स्कोरिंग प्रायः इस पैटर्न पर निर्भर रहते हैं ताकि सिफ़ारिश के भरोसे जैसे पहलुओं को ट्रैक किया जा सके।
मल्टी-वे रिलेशनशिप्स
जहाँ अधिकांश OLTP सिस्टम्स दो से अधिक एंटिटीज़ को शामिल करने वाली रिलेशनशिप्स से बचते हैं, एनालिटिक्स सिस्टम्स उन्हें अक्सर उपयोग करते हैं। डायमेंशनल मॉडल्स में फ़ैक्ट टेबल्स प्रभावी रूप से विभिन्न ग्रैन्युलैरिटी स्तरों पर टेबल्स को जोड़ने वाली जंक्शन टेबल्स की तरह कार्य करती हैं। ये डिज़ाइन शक्तिशाली होते हैं लेकिन अनुशासित क्वेरीइंग और स्पष्ट दस्तावेज़ीकरण की आवश्यकता होती है।
एक संभावित डिज़ाइन यह होगा कि आप अपनी जंक्शन टेबल उन सभी भाग लेने वाली एंटिटीज़ की फ़ॉरेन कीज़ के साथ बनाएँ।
उदाहरण के लिए, यदि हम अपने छात्र और पाठ्यक्रम उदाहरण पर आगे बढ़ें, तो तीसरी टेबल कक्षा कक्ष संख्याएँ हो सकती हैं। एक जंक्शन टेबल में किसी विशेष कक्षा में किसी विशेष कमरे में छात्र के लिए फ़ॉरेन कीज़ हो सकती हैं। यह देखना आसान है कि जैसे-जैसे हम रिलेशनशिप्स की संख्या बढ़ाते हैं, क्वेरीइंग और स्कीमा घातांकी रूप से अधिक जटिल हो जाते हैं।
डेटाबेस बनाने में गहराई से जाने के लिए, हमारा database design कोर्स ज़रूर लें।
परफॉर्मेंस ऑप्टिमाइज़ेशन और क्वेरी दक्षता
किसी भी जटिल डेटाबेस डिज़ाइन के साथ, हमें परफॉर्मेंस और क्वेरी संबंधी बातों पर ध्यान देना पड़ता है। जितने अधिक हिस्से जोड़ेंगे, परफॉर्मेंस बॉटलनेक्स से टकराने की संभावना उतनी ही अधिक होगी!
क्वेरी पैटर्न्स और ऑप्टिमाइज़ेशन
आइए पहले देखें कि हम अपनी जंक्शन टेबल्स को किन तरीकों से क्वेरी कर सकते हैं। सामान्य एक्सेस पैटर्न्स में शामिल हैं:
- टेबल A में दिए गए किसी एंटिटी के लिए टेबल B की सभी संबंधित एंटिटीज़ लाना
- रिलेशनशिप्स की गणना करना
- रिलेशनशिप एट्रिब्यूट्स द्वारा फ़िल्टर करना
इन क्वेरीज़ को ऑप्टिमाइज़ करने के लिए:
-
जंक्शन टेबल में फ़ॉरेन कीज़ को इंडेक्स करें
-
GROUP BY या DISTINCT का उपयोग करें ताकि ओवर-काउंटिंग रोकी जा सके
-
रीड-हैवी वर्कलोड्स के लिए कवरिंग इंडेक्स पर विचार करें
-
जुड़ रही डेटा की मात्रा सीमित करने के लिए WHERE स्टेटमेंट्स को विशिष्ट रखें।
ये तकनीकें कुशल जॉइन्स और एग्रीगेशन्स की नींव हैं। याद रखें, यदि आप जंक्शन टेबल का उपयोग दो टेबल्स को पुल करने के लिए कर रहे हैं, तो यह सोचना अच्छा है कि आप तीन टेबल्स को कुशलता से कैसे जॉइन कर सकते हैं।
बल्क ऑपरेशन्स और कन्करेंसी
जंक्शन टेबल्स पर अक्सर उच्च राइट वॉल्यूम आता है। बैच इन्सर्ट्स और अपडेट्स ट्रांज़ैक्शन ओवरहेड कम करते हैं।
हालाँकि, लोकप्रिय फ़ॉरेन कीज़ पर उच्च कंटेन्शन लॉकिंग बॉटलनेक्स बना सकती है। परफॉर्मेंस की मॉनिटरिंग करें और पैरेललाइज़ेशन की अनुमति देने के लिए टेबल्स को पार्टिशन करें।
नॉर्मलाइज़ेशन बनाम डी-नॉर्मलाइज़ेशन
आइए एक क्षण लें और अपने डेटाबेस डिज़ाइन के दृष्टिकोण के रूप में नॉर्मलाइज़ेशन और डी-नॉर्मलाइज़ेशन के मुख्य अंतर को देखें:
- नॉर्मलाइज़्ड डिज़ाइन्स राइट-हैवी, कंसिस्टेंसी-क्रिटिकल सिस्टम्स (जैसे, फाइनेंस, ERP) के लिए उपयुक्त हैं। यदि सख्त कंसिस्टेंसी चाहिए जहाँ डुप्लीकेशन या अतिरिक्त डेटा का कोई मौका न हो, तो सख्ती से नॉर्मलाइज़्ड डिज़ाइन पर ध्यान दें।
- डी-नॉर्मलाइज़्ड डिज़ाइन्स रीड-हैवी एनालिटिक्स के लिए उपयुक्त हैं जहाँ इवेंचुअल कंसिस्टेंसी स्वीकार्य है। यदि डेटा की उपलब्धता अधिक महत्वपूर्ण है और हम डेटा के बाद में “सेटल” होने से ठीक हैं, तो हम डी-नॉर्मलाइज़्ड डिज़ाइन अपना सकते हैं, बशर्ते हम सर्वोत्तम प्रथाओं पर सख्त मार्गदर्शन दें।
एक्सेस पैटर्न्स, टीम विशेषज्ञता, और परिचालन बाधाओं पर सच में विचार करें।
डी-नॉर्मलाइज़ेशन के समझौते
डी-नॉर्मलाइज़ेशन उन राइट-हैवी सिस्टम्स में परफॉर्मेंस सुधार सकती है जो बार-बार नहीं बदलते। इसकी कीमत है बढ़ी हुई जटिलता, मेंटेनेंस बोझ, और बासी डेटा का जोखिम।
मेरी राय: डी-नॉर्मलाइज़ेशन केवल रीड-हैवी बॉटलनेक्स के मापित उत्तर के रूप में होनी चाहिए और हमेशा नियमित कंसिस्टेंसी जाँचों के साथ बनाई जानी चाहिए।
विभिन्न डेटाबेस सिस्टम्स में इम्प्लीमेंटेशन
SQL और NoSQL सिस्टम्स में मेनी-टू-मेनी सिस्टम्स के इम्प्लीमेंटेशन के लिए थोड़े अलग दृष्टिकोण होते हैं।
रिलेशनल और NoSQL आर्किटेक्चर्स
रिलेशनल डेटाबेस जैसे PostgreSQL, MySQL, और SQL Server, फ़ॉरेन कीज़ और समग्र प्राइमरी कीज़ वाली जंक्शन टेबल्स का उपयोग करके मेनी-टू-मेनी रिलेशनशिप्स को स्पष्ट रूप से लागू करते हैं। इसी प्रकार, क्लाउड-आधारित रिलेशनल डेटाबेस जैसे Snowflake भी समान डिज़ाइन पैटर्न का पालन करते हैं।
NoSQL सिस्टम्स अक्सर संबंधित IDs की एरेज़ एम्बेड करके या एप्लिकेशन लॉजिक द्वारा प्रबंधित रेफरेंसेज़ स्टोर करके मेनी-टू-मेनी रिलेशनशिप्स का प्रतिनिधित्व करते हैं। ऐसा NoSQL डेटाबेस में रीड परफॉर्मेंस और हॉरिज़ॉन्टल स्केलेबिलिटी को प्राथमिकता देने के कारण होता है। इससे रीड परफॉर्मेंस और स्कीमा लचीलापन बेहतर होता है लेकिन नॉर्मलाइज़ेशन का त्याग करना पड़ता है।
|
फ़ीचर
|
रिलेशनल (SQL)
|
NoSQL
|
|
इम्प्लीमेंटेशन
|
जंक्शन टेबल्स: फ़ॉरेन कीज़ और समग्र प्राइमरी कीज़ वाली तीसरी टेबल का उपयोग।
|
एम्बेडिंग या रेफरेंसिंग: IDs की एरेज़ या नेस्टेड डॉक्यूमेंट्स का उपयोग।
|
|
प्राथमिक लक्ष्य
|
नॉर्मलाइज़ेशन: डेटा कंसिस्टेंसी सुनिश्चित करना और अनावश्यकता को समाप्त करना।
|
परफॉर्मेंस: रीड स्पीड और हॉरिज़ॉन्टल स्केलेबिलिटी को प्राथमिकता।
|
|
लचीलापन
|
कठोर स्कीमा: डेटा प्राप्त करने के लिए पूर्वनिर्धारित संरचनाएँ और जॉइन्स आवश्यक।
|
उच्च लचीलापन: स्कीमा-लेस डिज़ाइन्स और विविध डेटा प्रकारों की अनुमति।
|
|
समझौता
|
जटिल जॉइन्स: डेटा सेट के बहुत बढ़ने पर धीमे हो सकते हैं।
|
नॉर्मलाइज़ेशन का त्याग: डेटा डुप्लीकेशन या "stale" डेटा का खतरा।
|
|
उदाहरण
|
PostgreSQL, MySQL, SQL Server, Snowflake.
|
MongoDB, DynamoDB, Cassandra.
|
SQL बनाम NoSQL
जब आपको एक अच्छी तरह परिभाषित स्कीमा संरचना चाहिए, तो रिलेशनल डेटाबेस पसंद किए जाते हैं। ये डेटाबेस मैनीपुलेट करने में आसान होते हैं और बेहतर डेटा प्रबंधन की अनुमति देते हैं। निम्न परिस्थितियों में रिलेशनल SQL डेटाबेस पर ध्यान केंद्रित करने पर विचार करें:
- रिलेशनशिप्स बार-बार बदलती हैं
- इंटीग्रिटी व्यवसाय के लिए महत्वपूर्ण है
- क्वेरीज़ में जटिल जॉइन्स शामिल हैं
NoSQL डेटाबेस उन स्थितियों के लिए उपयुक्त हैं जहाँ लचीलापन और बल्क ऑपरेबिलिटी प्राथमिकता हैं। उदाहरण के लिए, MongoDB जैसे NoSQL डेटाबेस हमें updateMany जैसे ऑपरेटर्स का उपयोग करने देते हैं जब हमें असंख्य डॉक्यूमेंट्स में अपडेट करना हो। यहाँ कुछ मार्गदर्शक सिद्धांत हैं कि आपको कब NoSQL इम्प्लीमेंटेशन पर विचार करना चाहिए:
- कार्डिनैलिटी पूर्वानुमेय है
- रीड्स, राइट्स की तुलना में बहुत अधिक हैं
- स्कीमा लचीलापन सख्त कंसिस्टेंसी से अधिक मूल्यवान है
निष्कर्ष
यथार्थवादी डेटा मॉडलों में मेनी-टू-मेनी रिलेशनशिप्स अपरिहार्य हैं। उन्हें सही तरीके से डिज़ाइन करना डेटा इंटीग्रिटी, स्केलेबिलिटी, और विश्लेषणात्मक शुद्धता के लिए अत्यंत महत्वपूर्ण है। जब जंक्शन टेबल्स ठीक से नॉर्मलाइज़्ड और इंडेक्स्ड होती हैं, तो वे एक मजबूत नींव प्रदान करती हैं जो ट्रांज़ैक्शनल सिस्टम्स से लेकर एंटरप्राइज़ एनालिटिक्स तक स्केल करती हैं।
हर डिज़ाइन में समझौते होते हैं: नॉर्मलाइज़ेशन बनाम परफॉर्मेंस, सरलता बनाम लचीलापन, और एब्स्ट्रैक्शन बनाम नियंत्रण। कुंजी यह है कि अपने एक्सेस पैटर्न्स की प्रोफाइलिंग करें, अपने वर्कलोड के अनुरूप पैटर्न्स चुनें, और स्कीमा रिव्यू तथा क्वेरी टेस्टिंग के माध्यम से डिज़ाइनों को मान्य करें।
जो प्रैक्टिशनर डेटाबेस डिज़ाइन में अपनी कौशल गहराई तक ले जाना चाहते हैं, मैं उन्हें हमारे Associate Data Analyst in SQL करियर ट्रैक में नामांकन करने की अत्यधिक अनुशंसा करता हूँ।


यूज़र्स और फॉलोअर्स, छात्र और पाठ्यक्रम, ग्राहक और उत्पाद: हमारी दुनिया स्वाभाविक मेनी-टू-मेनी रिलेशनशिप्स से भरी हुई है। हालाँकि, इन्हें डेटाबेस डिज़ाइनों में हमेशा अच्छी तरह रूपांतरित नहीं किया जाता। खराब तरीके से डिज़ाइन की गई मेनी-टू-मेनी रिलेशनशिप्स, डेटा डुप्लीकेशन, गलत एनालिटिक्स, और प्रोडक्शन सिस्टम्स में दीर्घकालिक मेंटेनेंस की परेशानी के सबसे आम स्रोतों में से एक हैं।
इस लेख में, मैं मेनी-टू-मेनी रिलेशनशिप्स को मूल सिद्धांतों से लेकर वास्तविक दुनिया के इम्प्लीमेंटेशन तक समझाऊँगा। हम उन्नत डिज़ाइन पैटर्न्स, नॉर्मलाइज़ेशन, परफॉर्मेंस संबंधी बातें, और रिलेशनल तथा NoSQL सिस्टम्स में मेनी-टू-मेनी रिलेशनशिप्स कैसे लागू होती हैं, इन पर भी चर्चा करेंगे।
अंत तक पहुँचते-पहुँचते, आप स्केलेबल, मेंटेन करने योग्य स्कीमा डिज़ाइन कर पाएँगे जो जटिल रिलेशनशिप्स को सही ढंग से मॉडल करें, डेटा विसंगतियों से बचें, और भरोसेमंद रिपोर्टिंग व BI वर्कफ़्लोज़ को सपोर्ट करें।
जो पाठक रास्ते में बुनियादी बातों को मज़बूत करना चाहते हैं, उनके लिए मैं हमारा Introduction to Relational Databases in SQL कोर्स लेने की सलाह देता हूँ।
मेनी-टू-मेनी रिलेशनशिप क्या है
मेनी-टू-मेनी रिलेशनशिप (M:N) एक द्विदिश डेटाबेस रिलेशनशिप है जिसमें टेबल A का प्रत्येक रिकॉर्ड टेबल B के कई रिकॉर्ड्स से संबंधित हो सकता है, और टेबल B का प्रत्येक रिकॉर्ड टेबल A के कई रिकॉर्ड्स से संबंधित हो सकता है। सरल रिलेशनशिप प्रकारों के विपरीत, दोनों ओर कार्डिनैलिटी मौजूद होती है।
यह रिलेशनशिप वास्तविक सिस्टम्स में सर्वव्यापी है:
यह रिलेशनशिप अपने आप में अर्थ और प्रायः डेटा भी वहन करती है। इस भेद को समझना सही स्कीमा डिज़ाइन और क्वेरी करने के लिए महत्वपूर्ण है, खासकर जब एनालिटिक्स के लिए टेबल्स जोड़ी जाती हैं।
मेनी-टू-मेनी बनाम वन-टू-मेनी रिलेशनशिप
यह समझने के लिए कि मेनी-टू-मेनी रिलेशनशिप्स को विशेष हैंडलिंग की आवश्यकता क्यों होती है, उन्हें सरल कार्डिनैलिटी से तुलना करना उपयोगी है।
रिलेशनशिप प्रकार
विवरण
तर्क
उदाहरण
वन-टू-वन (1:1)
टेबल A का प्रत्येक रिकॉर्ड टेबल B में ठीक एक रिकॉर्ड से संबंधित होता है।
अद्वितीय युग्मन।
User ↔ User Profile
वन-टू-मेनी (1:N)
टेबल A का एक रिकॉर्ड टेबल B के कई रिकॉर्ड्स से संबंधित होता है, लेकिन टेबल B के रिकॉर्ड्स का केवल एक पैरेंट होता है।
माता-पिता/संतान संरचना।
Customer → Multiple Orders
मेनी-टू-मेनी (M:N)
टेबल A के कई रिकॉर्ड्स टेबल B के कई रिकॉर्ड्स से संबंधित होते हैं।
द्विदिश जाल।
Students ↔ Courses
उदाहरण के लिए, एक वन-टू-मेनी डिज़ाइन में, ऑर्डर्स टेबल आमतौर पर
customer_idविदेशी कुंजी रखती है और प्रत्येक अद्वितीय ऑर्डर का एकorder_idहोता है। प्रत्येक ऑर्डर ठीक एक ग्राहक का होता है, लेकिन एक ग्राहक के कईorder_idकीज़ हो सकती हैं।अब छात्र–पाठ्यक्रम वाले उदाहरण से इसकी तुलना करें। यदि आप
course_idको सीधे स्टूडेंट्स टेबल पर स्टोर करने का प्रयास करते हैं, तो प्रत्येक छात्र कईcourse_idमानों से जुड़ा होगा। उलटे, कोर्स टेबल के अंदर, प्रत्येक कोर्स के पास कईstudent_idसंदर्भ होंगे। सुथरे एकतरफ़ा रिलेशनशिप की बजाय, दोनों दिशाओं में सूचना का आदान-प्रदान होता है।फ़र्स्ट नॉर्मल फ़ॉर्म का उल्लंघन और मेनी-टू-मेनी समस्या
एक आम समस्या यह है कि मेनी-टू-मेनी रिलेशनशिप्स को सीधे दर्शाने के लिए एक ही कॉलम में कई मानों को स्टोर किया जाता है, जैसे कि एक एरे के रूप में (उदा.,
studentsटेबल परcourse_ids) या बार-बार दोहराए गए कॉलम जैसेcourse_1,course_2,course_3।यह तरीका फ़र्स्ट नॉर्मल फ़ॉर्म (1NF) का उल्लंघन करता है, जो अपेक्षा करता है कि प्रत्येक कॉलम में एटॉमिक, अविभाज्य मान हों। याद ताज़ा करने के लिए इस ब्लॉग को पढ़ें: normalization in SQL ।
1NF का उल्लंघन क्लासिक अपडेट विसंगतियों की ओर ले जाता है:
नॉर्मलाइज़ेशन थ्योरी से परे, एक गंभीर विश्लेषणात्मक परिणाम है जिसे मेनी-टू-मेनी समस्या कहा जाता है। जब मेनी-टू-मेनी रिलेशनशिप वाली टेबल्स को सावधानी से जॉइन नहीं किया जाता, तो रो गुणन आसानी से हो सकता है। इससे कंप्यूट समय में समस्या और विश्लेषण के दौरान एग्रीगेशन त्रुटियाँ हो सकती हैं।
उदाहरण के लिए,
student_idके आधार परcoursesकोstudentsसे जोड़ने पर, कई छात्र प्रविष्टियों के कारण प्रत्येक कोर्स कई बार जॉइन हो सकता है। फिर एग्रीगेशन करने की कोशिश करने पर राजस्व या छात्र संख्या जैसे विश्लेषणात्मक अंतर आ सकते हैं।सही स्कीमा डिज़ाइन का रिपोर्टिंग सटीकता, वित्तीय गणनाओं, और डेटा प्रोडक्ट्स में भरोसे पर सीधा प्रभाव पड़ता है। साथ ही, यह जॉइन्स को सरल बनाता है ताकि मानवीय त्रुटि कम से कम हो। सामान्य जॉइन कमियों पर अधिक जानकारी के लिए यह SQL जॉइन ट्यूटोरियल देखें और इन Top 20 SQL Joins Questions पर अभ्यास करें।
जंक्शन टेबल्स: नींव और संरचना
रिलेशनल सिस्टम्स में मेनी-टू-मेनी रिलेशनशिप्स का मानक समाधान जंक्शन टेबल है (जिसे जॉइन टेबल, ब्रिज टेबल, या एसोसिएटिव टेबल भी कहा जाता है)। सीधे रिलेशनशिप्स स्टोर करने की कोशिश करने की बजाय, आप एक मध्यवर्ती टेबल जोड़ते हैं जो दोनों पैरेंट टेबल्स को संदर्भित करती है।
अवधारणात्मक रूप से, यह A ↔ B को A ← JT→ B में बदल देता है।
अब, प्रत्येक का जंक्शन टेबल के साथ एक वन-टू-मेनी रिलेशनशिप होता है, जो एक सरल विश्लेषणात्मक स्कीमा की अनुमति देता है। मैं बताऊँगा कि हम इन जंक्शन टेबल्स को कैसे बनाते हैं और इनका उपयोग कैसे करते हैं।
संरचना और घटक
एक बुनियादी जंक्शन टेबल में शामिल होते हैं:
अधिकांश मामलों में, ये दोनों फ़ॉरेन कीज़ मिलकर एक समग्र प्राइमरी की बनाती हैं। यह सुनिश्चित करता है कि वही रिलेशनशिप दो बार नहीं डाली जा सकती और डेटाबेस स्तर पर विशिष्टता लागू होती है।
उदाहरण के लिए, एक
enrollmentsटेबल अपनी प्राइमरी की के रूप मेंstudent_idऔरcourse_idका संयोजन उपयोग कर सकती है। अब डेटाबेस के पास रिलेशनशिप के लिए एक अद्वितीय रेफरेंस की है और हम व्यावसायिक उपयोग मामलों का निर्माण शुरू कर सकते हैं।यह उदाहरण दिखाता है कि
enrollmentsजंक्शन टेबल कैसी दिख सकती है।जंक्शन टेबल्स में गुण जोड़ना
जब एक जंक्शन टेबल अतिरिक्त एट्रिब्यूट्स स्टोर करती है, तो वह शुद्ध संरचनात्मक कलाकृति के बजाय एक एसोसिएटिव एंटिटी के अधिक क़रीब हो जाती है। यह जंक्शन टेबल को रिलेशनशिप के बारे में प्रासंगिक जानकारी रखने देता है। सामान्य उदाहरण शामिल हैं:
तिथि:
enrollment_date,creation_date, और समान समय-आधारित जानकारीभूमिका: जैसे, समूह में एडमिन बनाम सदस्य
मैट्रिक्स: रिकमेंडेशन सिस्टम्स में प्रासंगिकता स्कोरिंग
यह रिलेशनशिप को अधिक अर्थपूर्ण बनने में मदद करता है। क्वेरी जटिलता थोड़ी बढ़ती है, लेकिन स्कीमा वास्तविकता का अधिक सटीक मॉडल बन जाता है। यह समझौता लगभग हमेशा उन सिस्टम्स में सार्थक होता है जहाँ समय के साथ रिलेशनशिप्स विकसित होती हैं। हम और जानकारी जोड़ सकते हैं और जंक्शन टेबल्स को एक उपयोगी विश्लेषणात्मक टूल बना सकते हैं।
डेटा अखंडता बनाए रखना
जंक्शन टेबल्स बड़े पैमाने पर रेफरेंशियल इंटीग्रिटी पर निर्भर रहती हैं। फ़ॉरेन की सीमाएँ सुनिश्चित करती हैं कि प्रत्येक रिलेशनशिप रो वैध पैरेंट रिकॉर्ड्स को संदर्भित करती है, जिससे अनाथ डेटा रोका जाता है।
डिलीशन नियम मायने रखते हैं:
चयन व्यावसायिक अर्थ-व्यंजना पर निर्भर करता है। कुछ डोमेन्स में स्वतः क्लीनअप उपयुक्त है; अन्य में, ऐतिहासिक रिलेशनशिप्स को संरक्षित रखना चाहिए या हटाने से पहले स्पष्ट रूप से समीक्षा की जानी चाहिए।
नॉर्मलाइज़ेशन और जंक्शन टेबल्स
जंक्शन टेबल्स थर्ड नॉर्मल फ़ॉर्म (3NF) का सीधा अनुप्रयोग हैं। ये पारगमन निर्भरताएँ समाप्त करती हैं और रिलेशनशिप डेटा के अनावश्यक भंडारण को हटाती हैं। इसका समूचा लक्ष्य डेटाबेस के भीतर नॉर्मलाइज़ेशन को बेहतर बनाना है।
कई मामलों में, जंक्शन टेबल्स Boyce–Codd नॉर्मल फ़ॉर्म (BCNF) को पूरा करने में भी मदद करती हैं क्योंकि समग्र प्राइमरी की सभी नॉन-की एट्रिब्यूट्स को पूर्णतः निर्धारित करती है। यह इसलिए महत्वपूर्ण है क्योंकि यह अपडेट विसंगतियों को कम करता है और सुनिश्चित करता है कि किसी रिलेशनशिप को संशोधित करने के लिए ठीक एक रो बदलनी पड़े।
हमारे डेटाबेस में 3NF सुनिश्चित करने के महत्व की गहरी समझ के लिए, इस ट्रांज़िटिव डिपेंडेंसी पर लेख को देखें।
मेनी-टू-मेनी रिलेशनशिप्स का डिज़ाइन और इम्प्लीमेंटेशन
आइए चर्चा करें कि हम वास्तव में अपने डेटाबेस कैसे बनाएँ ताकि मेनी-टू-मेनी रिलेशनशिप्स सपोर्ट हो सकें। हम आपके काम को आसान बनाने के लिए अच्छी प्रथाओं को कवर करेंगे।
नेमिंग कन्वेंशंस और स्कीमा स्पष्टता
स्पष्ट टेबल नामिंग संज्ञानात्मक बोझ कम करती है और मेंटेनबिलिटी में सुधार करती है। आम प्रथाएँ प्रायः
TableA_TableBयाjoin_TableATableBजैसी होती हैं, उदाहरण के लिए:student_courseuser_groupjoin_user_groupकॉलम नामों को पैरेंट टेबल की प्राइमरी कीज़ को प्रतिबिंबित करना चाहिए (जैसे,
student_id,course_id) ताकि जॉइन्स स्पष्ट और पढ़ने में आसान हों। जैसे-जैसे स्कीमा बढ़ते हैं और टीमें फैलती हैं, स्थिरता अत्यंत महत्वपूर्ण हो जाती है।आम पैटर्न्स और विविधताएँ
हम अपने जंक्शन टेबल्स कई तरीकों से बना सकते हैं—बहुत सरल रिलेशनशिप ट्रैकिंग से लेकर अधिक जटिल पॉलीमॉर्फिक रिलेशनशिप्स तक।
साधारण जंक्शन टेबल्स
साधारण जंक्शन टेबल्स में केवल फ़ॉरेन कीज़ होती हैं और वे स्थिर या कम-प्रसंग वाले रिलेशनशिप्स के लिए आदर्श हैं। इन्हें बनाए रखना बहुत आसान होता है और न्यूनतम ओवरहेड रहता है क्योंकि ये सामान्यतः केवल यह दिखाने से संबंधित होती हैं कि दो टेबल्स कैसे संबंधित हैं। इनमें कोई समयगत या प्रसंगगत डेटा नहीं होता।
स्व-रेफरेंसिंग मेनी-टू-मेनी रिलेशनशिप्स
स्व-रेफरेंसिंग मेनी-टू-मेनी रिलेशनशिप्स तब होती हैं जब दोनों फ़ॉरेन कीज़ एक ही टेबल को संदर्भित करती हैं।
उदाहरण के लिए, यदि हम एक सोशल मीडिया ऐप को ट्रैक कर रहे हैं जिसमें यूज़र्स, उनके फॉलोअर्स, और वे किन्हें फॉलो कर रहे हैं—इनका ट्रैक रखना शामिल है—तो हमारे पास दोनों दिशाओं में
user_idसेfollower_idका रिलेशनशिप हो सकता है। अमान्य या सममित डुप्लीकेट्स को रोकने के लिए अतिरिक्त बाधाओं की आवश्यकता हो सकती है।पॉलीमॉर्फिक मेनी-टू-मेनी रिलेशनशिप्स
पॉलीमॉर्फिक मेनी-टू-मेनी रिलेशनशिप्स एक प्रकार के डिस्क्रिमिनेटर का उपयोग करके एक जंक्शन टेबल को कई एंटिटी प्रकारों से जोड़ने देती हैं। यह लचीलापन प्रदान करती है लेकिन इंटीग्रिटी प्रवर्तन को एप्लिकेशन लॉजिक में स्थानांतरित करती है और क्वेरीज़ को जटिल बनाती है।
उदाहरण के लिए, सोशल मीडिया ऐप्स के लिए
Tagनामक जंक्शन टेबलPosts,Comments, औरUsersसे संबंधित हो सकती है, जिसमें टैग को उचित एंटिटी से जोड़ने के लिए एक अतिरिक्त प्रसंगगत कॉलम हो।टेम्पोरल और वेटेड रिलेशनशिप्स
टेम्पोरल और वेटेड रिलेशनशिप्स दोनों ही अतिरिक्त एट्रिब्यूट्स में रिलेशनशिप के बारे में जानकारी स्टोर करते हैं।
टेम्पोरल मेनी-टू-मेनी रिलेशनशिप्स ऐसे कॉलम जोड़ती हैं जो समयगत जानकारी देते हैं, जैसे
active_from,active_to, याcreated_on, ताकि ऐतिहासिक वैधता को ट्रैक किया जा सके। हमारे पहले वाले छात्र–पाठ्यक्रम डेटाबेस मेंenrolled_onकुंजी, टेम्पोरल रिलेशनशिप का एक उदाहरण है।ये ऑडिट ट्रेल्स, धीरे-धीरे बदलती रिलेशनशिप्स, और पॉइंट-इन-टाइम विश्लेषण के लिए आवश्यक हैं। इससे थोड़ी जटिलता बढ़ती है, जहाँ उपयोगकर्ताओं को सही समयगत पैमाने पर फ़िल्टर करने और निष्क्रिय हो सकने वाली पंक्तियों पर विचार करने में सावधानी बरतनी चाहिए।
वेटेड रिलेशनशिप्स दूसरी ओर, रैंकिंग या स्ट्रेंथ मैट्रिक्स स्टोर करती हैं। रिकमेंडेशन इंजन, टैगिंग सिस्टम्स, और प्रासंगिकता स्कोरिंग प्रायः इस पैटर्न पर निर्भर रहते हैं ताकि सिफ़ारिश के भरोसे जैसे पहलुओं को ट्रैक किया जा सके।
मल्टी-वे रिलेशनशिप्स
जहाँ अधिकांश OLTP सिस्टम्स दो से अधिक एंटिटीज़ को शामिल करने वाली रिलेशनशिप्स से बचते हैं, एनालिटिक्स सिस्टम्स उन्हें अक्सर उपयोग करते हैं। डायमेंशनल मॉडल्स में फ़ैक्ट टेबल्स प्रभावी रूप से विभिन्न ग्रैन्युलैरिटी स्तरों पर टेबल्स को जोड़ने वाली जंक्शन टेबल्स की तरह कार्य करती हैं। ये डिज़ाइन शक्तिशाली होते हैं लेकिन अनुशासित क्वेरीइंग और स्पष्ट दस्तावेज़ीकरण की आवश्यकता होती है।
एक संभावित डिज़ाइन यह होगा कि आप अपनी जंक्शन टेबल उन सभी भाग लेने वाली एंटिटीज़ की फ़ॉरेन कीज़ के साथ बनाएँ।
उदाहरण के लिए, यदि हम अपने छात्र और पाठ्यक्रम उदाहरण पर आगे बढ़ें, तो तीसरी टेबल कक्षा कक्ष संख्याएँ हो सकती हैं। एक जंक्शन टेबल में किसी विशेष कक्षा में किसी विशेष कमरे में छात्र के लिए फ़ॉरेन कीज़ हो सकती हैं। यह देखना आसान है कि जैसे-जैसे हम रिलेशनशिप्स की संख्या बढ़ाते हैं, क्वेरीइंग और स्कीमा घातांकी रूप से अधिक जटिल हो जाते हैं।
डेटाबेस बनाने में गहराई से जाने के लिए, हमारा database design कोर्स ज़रूर लें।
परफॉर्मेंस ऑप्टिमाइज़ेशन और क्वेरी दक्षता
किसी भी जटिल डेटाबेस डिज़ाइन के साथ, हमें परफॉर्मेंस और क्वेरी संबंधी बातों पर ध्यान देना पड़ता है। जितने अधिक हिस्से जोड़ेंगे, परफॉर्मेंस बॉटलनेक्स से टकराने की संभावना उतनी ही अधिक होगी!
क्वेरी पैटर्न्स और ऑप्टिमाइज़ेशन
आइए पहले देखें कि हम अपनी जंक्शन टेबल्स को किन तरीकों से क्वेरी कर सकते हैं। सामान्य एक्सेस पैटर्न्स में शामिल हैं:
इन क्वेरीज़ को ऑप्टिमाइज़ करने के लिए:
जंक्शन टेबल में फ़ॉरेन कीज़ को इंडेक्स करें
GROUP BYयाDISTINCTका उपयोग करें ताकि ओवर-काउंटिंग रोकी जा सकेरीड-हैवी वर्कलोड्स के लिए कवरिंग इंडेक्स पर विचार करें
जुड़ रही डेटा की मात्रा सीमित करने के लिए
WHEREस्टेटमेंट्स को विशिष्ट रखें।ये तकनीकें कुशल जॉइन्स और एग्रीगेशन्स की नींव हैं। याद रखें, यदि आप जंक्शन टेबल का उपयोग दो टेबल्स को पुल करने के लिए कर रहे हैं, तो यह सोचना अच्छा है कि आप तीन टेबल्स को कुशलता से कैसे जॉइन कर सकते हैं।
बल्क ऑपरेशन्स और कन्करेंसी
जंक्शन टेबल्स पर अक्सर उच्च राइट वॉल्यूम आता है। बैच इन्सर्ट्स और अपडेट्स ट्रांज़ैक्शन ओवरहेड कम करते हैं।
हालाँकि, लोकप्रिय फ़ॉरेन कीज़ पर उच्च कंटेन्शन लॉकिंग बॉटलनेक्स बना सकती है। परफॉर्मेंस की मॉनिटरिंग करें और पैरेललाइज़ेशन की अनुमति देने के लिए टेबल्स को पार्टिशन करें।
नॉर्मलाइज़ेशन बनाम डी-नॉर्मलाइज़ेशन
आइए एक क्षण लें और अपने डेटाबेस डिज़ाइन के दृष्टिकोण के रूप में नॉर्मलाइज़ेशन और डी-नॉर्मलाइज़ेशन के मुख्य अंतर को देखें:
एक्सेस पैटर्न्स, टीम विशेषज्ञता, और परिचालन बाधाओं पर सच में विचार करें।
डी-नॉर्मलाइज़ेशन के समझौते
डी-नॉर्मलाइज़ेशन उन राइट-हैवी सिस्टम्स में परफॉर्मेंस सुधार सकती है जो बार-बार नहीं बदलते। इसकी कीमत है बढ़ी हुई जटिलता, मेंटेनेंस बोझ, और बासी डेटा का जोखिम।
मेरी राय: डी-नॉर्मलाइज़ेशन केवल रीड-हैवी बॉटलनेक्स के मापित उत्तर के रूप में होनी चाहिए और हमेशा नियमित कंसिस्टेंसी जाँचों के साथ बनाई जानी चाहिए।
विभिन्न डेटाबेस सिस्टम्स में इम्प्लीमेंटेशन
SQL और NoSQL सिस्टम्स में मेनी-टू-मेनी सिस्टम्स के इम्प्लीमेंटेशन के लिए थोड़े अलग दृष्टिकोण होते हैं।
रिलेशनल और NoSQL आर्किटेक्चर्स
रिलेशनल डेटाबेस जैसे PostgreSQL, MySQL, और SQL Server, फ़ॉरेन कीज़ और समग्र प्राइमरी कीज़ वाली जंक्शन टेबल्स का उपयोग करके मेनी-टू-मेनी रिलेशनशिप्स को स्पष्ट रूप से लागू करते हैं। इसी प्रकार, क्लाउड-आधारित रिलेशनल डेटाबेस जैसे Snowflake भी समान डिज़ाइन पैटर्न का पालन करते हैं।
NoSQL सिस्टम्स अक्सर संबंधित IDs की एरेज़ एम्बेड करके या एप्लिकेशन लॉजिक द्वारा प्रबंधित रेफरेंसेज़ स्टोर करके मेनी-टू-मेनी रिलेशनशिप्स का प्रतिनिधित्व करते हैं। ऐसा NoSQL डेटाबेस में रीड परफॉर्मेंस और हॉरिज़ॉन्टल स्केलेबिलिटी को प्राथमिकता देने के कारण होता है। इससे रीड परफॉर्मेंस और स्कीमा लचीलापन बेहतर होता है लेकिन नॉर्मलाइज़ेशन का त्याग करना पड़ता है।
फ़ीचर
रिलेशनल (SQL)
NoSQL
इम्प्लीमेंटेशन
जंक्शन टेबल्स: फ़ॉरेन कीज़ और समग्र प्राइमरी कीज़ वाली तीसरी टेबल का उपयोग।
एम्बेडिंग या रेफरेंसिंग: IDs की एरेज़ या नेस्टेड डॉक्यूमेंट्स का उपयोग।
प्राथमिक लक्ष्य
नॉर्मलाइज़ेशन: डेटा कंसिस्टेंसी सुनिश्चित करना और अनावश्यकता को समाप्त करना।
परफॉर्मेंस: रीड स्पीड और हॉरिज़ॉन्टल स्केलेबिलिटी को प्राथमिकता।
लचीलापन
कठोर स्कीमा: डेटा प्राप्त करने के लिए पूर्वनिर्धारित संरचनाएँ और जॉइन्स आवश्यक।
उच्च लचीलापन: स्कीमा-लेस डिज़ाइन्स और विविध डेटा प्रकारों की अनुमति।
समझौता
जटिल जॉइन्स: डेटा सेट के बहुत बढ़ने पर धीमे हो सकते हैं।
नॉर्मलाइज़ेशन का त्याग: डेटा डुप्लीकेशन या "stale" डेटा का खतरा।
उदाहरण
PostgreSQL, MySQL, SQL Server, Snowflake.
MongoDB, DynamoDB, Cassandra.
SQL बनाम NoSQL
जब आपको एक अच्छी तरह परिभाषित स्कीमा संरचना चाहिए, तो रिलेशनल डेटाबेस पसंद किए जाते हैं। ये डेटाबेस मैनीपुलेट करने में आसान होते हैं और बेहतर डेटा प्रबंधन की अनुमति देते हैं। निम्न परिस्थितियों में रिलेशनल SQL डेटाबेस पर ध्यान केंद्रित करने पर विचार करें:
NoSQL डेटाबेस उन स्थितियों के लिए उपयुक्त हैं जहाँ लचीलापन और बल्क ऑपरेबिलिटी प्राथमिकता हैं। उदाहरण के लिए, MongoDB जैसे NoSQL डेटाबेस हमें
updateManyजैसे ऑपरेटर्स का उपयोग करने देते हैं जब हमें असंख्य डॉक्यूमेंट्स में अपडेट करना हो। यहाँ कुछ मार्गदर्शक सिद्धांत हैं कि आपको कब NoSQL इम्प्लीमेंटेशन पर विचार करना चाहिए:निष्कर्ष
यथार्थवादी डेटा मॉडलों में मेनी-टू-मेनी रिलेशनशिप्स अपरिहार्य हैं। उन्हें सही तरीके से डिज़ाइन करना डेटा इंटीग्रिटी, स्केलेबिलिटी, और विश्लेषणात्मक शुद्धता के लिए अत्यंत महत्वपूर्ण है। जब जंक्शन टेबल्स ठीक से नॉर्मलाइज़्ड और इंडेक्स्ड होती हैं, तो वे एक मजबूत नींव प्रदान करती हैं जो ट्रांज़ैक्शनल सिस्टम्स से लेकर एंटरप्राइज़ एनालिटिक्स तक स्केल करती हैं।
हर डिज़ाइन में समझौते होते हैं: नॉर्मलाइज़ेशन बनाम परफॉर्मेंस, सरलता बनाम लचीलापन, और एब्स्ट्रैक्शन बनाम नियंत्रण। कुंजी यह है कि अपने एक्सेस पैटर्न्स की प्रोफाइलिंग करें, अपने वर्कलोड के अनुरूप पैटर्न्स चुनें, और स्कीमा रिव्यू तथा क्वेरी टेस्टिंग के माध्यम से डिज़ाइनों को मान्य करें।
जो प्रैक्टिशनर डेटाबेस डिज़ाइन में अपनी कौशल गहराई तक ले जाना चाहते हैं, मैं उन्हें हमारे Associate Data Analyst in SQL करियर ट्रैक में नामांकन करने की अत्यधिक अनुशंसा करता हूँ।