Utenti e follower, studenti e corsi, clienti e prodotti: il nostro mondo è pieno di relazioni molti-a-molti naturali. Tuttavia, non sempre vengono tradotte correttamente nella progettazione dei database. Relazioni molti-a-molti progettate male sono tra le fonti più comuni di duplicazione dei dati, analisi errate e problemi di manutenzione a lungo termine nei sistemi in produzione.
In questo articolo, analizzerò le relazioni molti-a-molti dai primi principi fino all’implementazione nel mondo reale. Esploreremo anche pattern di progettazione avanzati, normalizzazione, considerazioni sulle prestazioni e come le relazioni molti-a-molti vengono implementate nei sistemi relazionali e NoSQL.
Alla fine, dovresti essere in grado di progettare schemi scalabili e manutenibili che modellino correttamente relazioni complesse, evitino anomalie nei dati e supportino reportistica e flussi BI affidabili.
Per chi vuole rinforzare le basi lungo il percorso, consiglio di seguire il corso Introduction to Relational Databases in SQL.
Che cos’è una relazione molti-a-molti
Una relazione molti-a-molti (M:N) è una relazione bidirezionale in un database in cui ogni record nella Tabella A può essere collegato a molti record nella Tabella B, e ogni record nella Tabella B può essere collegato a molti record nella Tabella A. A differenza dei tipi di relazione più semplici, la cardinalità esiste su entrambi i lati.
Questa relazione è onnipresente nei sistemi reali:
- Istruzione: Uno studente può iscriversi a molti corsi e ogni corso può avere molti studenti.
- E-commerce: Un prodotto può appartenere a più categorie e ogni categoria può contenere molti prodotti.
- Piattaforme social: Gli utenti possono unirsi a molti gruppi e i gruppi possono contenere molti utenti.
- Sanità: A un paziente possono essere prescritti più farmaci e ogni farmaco può essere prescritto a molti pazienti.
La relazione porta con sé un significato e spesso anche dati propri. Capire questa distinzione è fondamentale per una progettazione e interrogazione corrette dello schema, soprattutto quando si uniscono tabelle per l’analisi.
Relazione molti-a-molti vs. uno-a-molti
Per capire perché le relazioni molti-a-molti richiedono una gestione speciale, è utile metterle a confronto con cardinalità più semplici.
- Uno-a-uno (1:1): Ogni record nella Tabella A è collegato esattamente a un record nella Tabella B, e viceversa (ad es., un utente e il suo profilo).
- Uno-a-molti (1:N): Un record nella Tabella A può essere collegato a molti record nella Tabella B, ma ogni record nella Tabella B è collegato a un solo record nella Tabella A (ad es., un cliente e i suoi ordini).
|
Tipo di relazione
|
Descrizione
|
Logica
|
Esempio
|
|
Uno-a-uno (1:1)
|
Ogni record nella Tabella A è collegato esattamente a uno nella Tabella B.
|
Associazione univoca.
|
Utente ↔ Profilo utente
|
|
Uno-a-molti (1:N)
|
Un record nella Tabella A è collegato a molti nella Tabella B, ma i record della Tabella B hanno un solo genitore.
|
Struttura genitore/figlio.
|
Cliente → Ordini multipli
|
|
Molti-a-molti (M:N)
|
Più record nella Tabella A sono collegati a più record nella Tabella B.
|
Rete bidirezionale.
|
Studenti ↔ Corsi
|
Per esempio, in un design uno-a-molti, una tabella degli ordini contiene in genere una chiave esterna customer_id con ogni ordine univoco dotato di un order_id. Ogni ordine appartiene esattamente a un cliente, ma un cliente può avere molte chiavi order_id.
Ora confrontalo con l’esempio studente–corso. Se provi a salvare course_id direttamente nella tabella degli studenti, ogni studente sarebbe collegato a più valori di course_id. Al contrario, nella tabella dei corsi, ogni corso avrebbe più riferimenti student_id. Invece di una relazione unidirezionale ordinata, entrambe le direzioni condividono informazioni avanti e indietro.
Un problema comune è cercare di rappresentare direttamente le relazioni molti-a-molti memorizzando più valori in un’unica colonna usando un array (ad es., course_ids in una tabella students) o colonne ripetute come course_1, course_2, course_3.
Questo approccio viola la Prima Forma Normale (1NF), che richiede che ogni colonna contenga valori atomici e indivisibili. Leggi questo blog sulla normalizzazione in SQL per un ripasso.
La violazione della 1NF porta alle classiche anomalie di aggiornamento:
- Anomalie di inserimento: Aggiungere una nuova relazione richiede di modificare la struttura di una riga esistente.
- Anomalie di aggiornamento: Cambiare una relazione richiede l’aggiornamento di più righe, più colonne o valori incorporati, aumentando il rischio di incoerenze.
- Anomalie di eliminazione: Rimuovere una relazione può eliminare accidentalmente informazioni non correlate.
Oltre alla teoria della normalizzazione, c’è una seria conseguenza analitica nota come problema molti-a-molti. Quando le tabelle con una relazione molti-a-molti non vengono unite con attenzione, si può facilmente incorrere in una moltiplicazione delle righe. Questo può causare problemi nei tempi di calcolo ed errori di aggregazione nelle analisi.
Ad esempio, unendo courses a students in base a student_id si può far sì che ogni corso venga unito più volte a causa di molteplici voci per studente. Poi tentando di aggregare si può incorrere in discrepanze analitiche come entrate o conteggi di studenti.
Una progettazione corretta dello schema influisce direttamente sull’accuratezza dei report, sui calcoli finanziari e sulla fiducia nei prodotti data-driven. Inoltre, aiuta a semplificare le join per ridurre al minimo l’errore umano. Per maggiori dettagli sugli errori comuni nelle join, guarda questo tutorial sulle join SQL ed esercitati con queste Top 20 domande sulle join SQL.
Tabelle ponte: fondamenti e struttura
La soluzione standard alle relazioni molti-a-molti nei sistemi relazionali è la tabella ponte (chiamata anche tabella di join, tabella ponte/bridge o tabella associativa). Invece di cercare di memorizzare le relazioni direttamente, si introduce una tabella intermedia che fa riferimento a entrambe le tabelle genitore.
Concettualmente, questo trasforma A ↔ B in A ← JT→ B.
Ora, ciascuna ha una relazione uno-a-molti con la tabella ponte, consentendo uno schema analitico semplificato. Esaminerò come costruiamo queste tabelle ponte e come vengono utilizzate.
Anatomia e componenti
Una tabella ponte di base contiene:
- Una chiave esterna che fa riferimento alla chiave primaria della Tabella A
- Una chiave esterna che fa riferimento alla chiave primaria della Tabella B
Nella maggior parte dei casi, queste due chiavi esterne insieme formano una chiave primaria composta. Questo garantisce che la stessa relazione non possa essere inserita due volte e impone l’unicità a livello di database.
Ad esempio, una tabella enrollments potrebbe usare la concatenazione di student_id e course_id come chiave primaria. Il database ora ha una chiave di riferimento univoca per la relazione e possiamo iniziare a costruire casi d’uso di business.
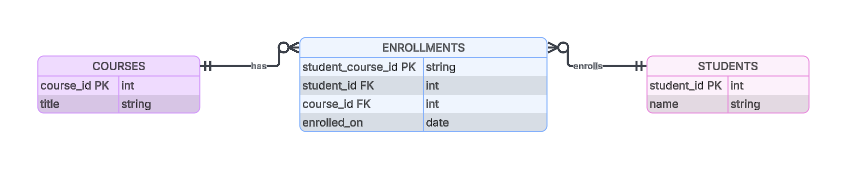
Esempio di come potrebbe apparire una tabella ponte enrollments.
Aggiungere attributi alle tabelle ponte
Quando una tabella ponte memorizza attributi aggiuntivi, si avvicina a un’entità associativa più che a un semplice artefatto strutturale. Questo consente alla tabella ponte di contenere informazioni contestuali sulla relazione. Esempi comuni includono:
-
Data: enrollment_date, creation_date e informazioni simili basate sul tempo
-
Ruolo: ad es., amministratore vs. membro in un gruppo
-
Metriche: punteggio di rilevanza nei sistemi di raccomandazione
Questo aiuta la relazione a portare più significato. La complessità delle query aumenta leggermente, ma lo schema modella la realtà in modo più accurato. Questo compromesso vale quasi sempre in sistemi in cui le relazioni evolvono nel tempo. Possiamo aggiungere più informazioni e rendere le tabelle ponte uno strumento analitico utile.
Mantenere l’integrità dei dati
Le tabelle ponte si basano fortemente sull’integrità referenziale. I vincoli di chiave esterna garantiscono che ogni riga di relazione faccia riferimento a record genitore validi, prevenendo dati orfani.
Le regole di eliminazione sono importanti:
- CASCADE: Rimuove automaticamente le righe della tabella ponte quando un genitore viene eliminato.
- RESTRICT / NO ACTION: Impedisce l’eliminazione di una riga genitore se esistono ancora relazioni.
La scelta dipende dalla semantica di business. In alcuni domini è appropriata la pulizia automatica; in altri, le relazioni storiche devono essere preservate o riviste esplicitamente prima della rimozione.
Normalizzazione e tabelle ponte
Le tabelle ponte sono un’applicazione diretta della Terza Forma Normale (3NF). Eliminano le dipendenze transitive e rimuovono l’archiviazione ridondante dei dati di relazione. Il loro obiettivo è migliorare la normalizzazione all’interno del database.
In molti casi, le tabelle ponte aiutano anche a soddisfare la Boyce–Codd Normal Form (BCNF) perché la chiave primaria composta determina completamente tutti gli attributi non chiave. Questo è importante perché minimizza le anomalie di aggiornamento e garantisce che modificare una relazione richieda di cambiare esattamente una riga.
Per comprendere più a fondo l’importanza di assicurare la 3NF nei nostri database, dai un’occhiata a questo articolo sulla dipendenza transitiva.
Progettare e implementare relazioni molti-a-molti
Vediamo come possiamo effettivamente costruire i nostri database per supportare relazioni molti-a-molti. Tratteremo buone pratiche per semplificarti la vita.
Convenzioni di denominazione e chiarezza dello schema
Una denominazione chiara delle tabelle riduce il carico cognitivo e migliora la manutenibilità. Le convenzioni comuni includono in genere TableA_TableB o join_TableATableB, ad esempio:
-
student_course
-
user_group
-
join_user_group
I nomi delle colonne dovrebbero rispecchiare le chiavi primarie delle tabelle genitore (ad es., student_id, course_id) per rendere le join ovvie e leggibili. La coerenza diventa cruciale man mano che gli schemi crescono e i team si ampliano.
Pattern comuni e varianti
Ci sono diversi modi in cui possiamo costruire le nostre tabelle ponte, dal semplice tracciamento delle relazioni a relazioni polimorfe più complesse.
Tabelle ponte semplici
Le tabelle ponte semplici contengono solo chiavi esterne e sono ideali per relazioni statiche o a basso contesto. Sono molto semplici da mantenere con un overhead minimo, poiché in genere si limitano a mostrare come due tabelle sono correlate. Queste tabelle ponte non hanno dati temporali o contestuali.
Relazioni molti-a-molti auto-referenti
Le relazioni molti-a-molti auto-referenti si verificano quando entrambe le chiavi esterne fanno riferimento alla stessa tabella.
Ad esempio, se stiamo tracciando un’app di social media che include il tracciamento degli utenti, dei loro follower e di chi seguono, potremmo avere una relazione di user_id con follower_id in entrambe le direzioni. Potrebbero essere necessari vincoli aggiuntivi per prevenire duplicati non validi o simmetrici.
Relazioni molti-a-molti polimorfe
Le relazioni molti-a-molti polimorfe consentono a una singola tabella ponte di collegare più tipi di entità utilizzando un discriminatore di tipo. Questo offre flessibilità ma sposta l’applicazione dell’integrità nella logica applicativa e complica le query.
Per esempio, una tabella ponte chiamata Tag per app social potrebbe collegare Posts, Comments e Users con una colonna contestuale aggiuntiva per associare il tag all’entità corretta.
Relazioni temporali e pesate
Le relazioni temporali e pesate memorizzano entrambe informazioni sulla relazione in attributi aggiuntivi.
Le relazioni molti-a-molti temporali aggiungono colonne che forniscono informazioni temporali, come active_from, active_to o created_on, per tracciare la validità storica. La chiave enrolled_on nel nostro precedente database studenti–corsi è un esempio di relazione temporale.
Queste sono essenziali per audit trail, relazioni in lento cambiamento e analisi al punto nel tempo. Aggiunge un po’ di complessità, per cui gli utenti devono fare attenzione a filtrare sulla scala temporale corretta e considerare le righe che potrebbero essere inattive.
Le relazioni pesate, invece, memorizzano metriche di ranking o intensità. I motori di raccomandazione, i sistemi di tagging e i punteggi di rilevanza si basano comunemente su questo pattern per tracciare aspetti come la confidenza della raccomandazione.
Relazioni a più vie
Sebbene la maggior parte dei sistemi OLTP eviti relazioni che coinvolgono più di due entità, i sistemi analitici le utilizzano frequentemente. Le tabelle dei fatti nei modelli dimensionali fungono di fatto da tabelle ponte collegando tabelle a vari livelli di granularità. Questi design sono potenti ma richiedono interrogazioni disciplinate e documentazione chiara.
Un possibile design sarebbe creare la tabella ponte con chiavi esterne verso tutte le entità partecipanti.
Per esempio, se partiamo dal nostro esempio studenti e corsi, una terza tabella potrebbe essere i numeri delle aule. Una tabella ponte può contenere le chiavi esterne per uno studente in una particolare classe in una particolare aula. È facile vedere che, man mano che ampliamo il numero di relazioni, interrogazioni e schema diventano esponenzialmente più complessi.
Per approfondire la costruzione dei database, assicurati di seguire il nostro corso sulla progettazione di database.
Ottimizzazione delle prestazioni ed efficienza delle query
Con qualsiasi progettazione di database complessa, dobbiamo considerare prestazioni e interrogazioni. Più pezzi aggiungiamo, più è probabile imbattersi in colli di bottiglia!
Pattern di query e ottimizzazione
Vediamo innanzitutto alcuni modi in cui potremmo interrogare le nostre tabelle ponte. I pattern di accesso comuni includono:
- Recuperare tutte le entità correlate della Tabella B per una data entità nella Tabella A
- Contare le relazioni
- Filtrare in base agli attributi della relazione
Per ottimizzare queste query:
-
Indicizza le chiavi esterne nella tabella ponte
-
Usa GROUP BY o DISTINCT per evitare sovracontaggi
-
Valuta indici coprenti per carichi di lavoro fortemente in lettura
-
Sii specifico nelle clausole WHERE per limitare la quantità di dati uniti.
Queste tecniche sono fondamentali per join e aggregazioni efficienti. Ricorda anche che, se stai usando la tabella ponte per collegare due tabelle, è utile pensare a come potresti unire tre tabelle in modo efficiente.
Operazioni massicce e concorrenza
Le tabelle ponte spesso registrano un volume elevato di scritture. Gli inserimenti e aggiornamenti in batch riducono l’overhead delle transazioni.
Tuttavia, un’elevata contesa su chiavi esterne molto popolari può creare colli di bottiglia dovuti ai lock. Assicurati di monitorare le prestazioni e partizionare le tabelle per consentire la parallelizzazione.
Normalizzazione vs denormalizzazione
Prendiamoci un attimo per vedere la differenza chiave tra normalizzazione e denormalizzazione come approccio alla progettazione del database:
- I design normalizzati si adattano a sistemi con molte scritture e in cui la coerenza è critica (ad es., finanza, ERP). Se è richiesta una coerenza rigorosa senza possibilità di duplicazione o dati superflui, concentra l’attenzione su un design strettamente normalizzato.
- I design denormalizzati si adattano ad analisi con molte letture in cui è accettabile la coerenza eventuale. Se l’accessibilità dei dati è più importante e siamo d’accordo che i dati “si assestino” in un secondo momento, allora possiamo usare un design denormalizzato, a patto di fornire indicazioni rigorose sulle best practice.
Rifletti davvero sui pattern di accesso, sulla competenza del team e sui vincoli operativi.
Compromessi della denormalizzazione
La denormalizzazione può migliorare le prestazioni su sistemi con molte scritture che non cambiano frequentemente. Il costo è una complessità aggiuntiva, un aumento dell’onere di manutenzione e un rischio di dati obsoleti.
Il mio parere: la denormalizzazione dovrebbe essere solo una risposta ponderata a colli di bottiglia in lettura e dovrebbe sempre essere costruita con controlli regolari di coerenza.
Implementazione nei diversi sistemi di database
I sistemi SQL e NoSQL adottano approcci leggermente diversi all’implementazione di sistemi molti-a-molti.
Architetture relazionali e NoSQL
I database relazionali come PostgreSQL, MySQL e SQL Server implementano esplicitamente le relazioni molti-a-molti utilizzando tabelle ponte con chiavi esterne e chiavi primarie composte. Allo stesso modo, i database relazionali cloud come Snowflake seguono un pattern di progettazione simile.
I sistemi NoSQL spesso rappresentano le relazioni molti-a-molti incorporando array di ID correlati o memorizzando riferimenti gestiti dalla logica applicativa. Questo è dovuto alla priorità delle prestazioni in lettura e della scalabilità orizzontale nei database NoSQL. Migliora le prestazioni in lettura e la flessibilità dello schema, ma sacrifica la normalizzazione.
|
Funzionalità
|
Relazionale (SQL)
|
NoSQL
|
|
Implementazione
|
Tabelle ponte: utilizza una terza tabella con chiavi esterne e chiavi primarie composte.
|
Incorporamento o riferimenti: utilizza array di ID o documenti annidati.
|
|
Obiettivo primario
|
Normalizzazione: garantisce coerenza dei dati ed elimina le ridondanze.
|
Prestazioni: priorità alla velocità di lettura e alla scalabilità orizzontale.
|
|
Flessibilità
|
Schema rigido: richiede strutture predefinite e join per recuperare i dati.
|
Alta flessibilità: consente design senza schema e tipi di dati vari.
|
|
Compromesso
|
Join complesse: possono diventare più lente con la crescita significativa del dataset.
|
Sacrifica la normalizzazione: può portare a duplicazioni o dati "obsoleti".
|
|
Esempi
|
PostgreSQL, MySQL, SQL Server, Snowflake.
|
MongoDB, DynamoDB, Cassandra.
|
SQL vs NoSQL
I database relazionali sono preferiti quando serve una struttura di schema ben definita. Questi database sono più facili da manipolare e consentono una migliore gestione dei dati. Considera di concentrarti sull’uso di un database relazionale SQL quando:
- Le relazioni cambiano frequentemente
- L’integrità è critica per il business
- Le query coinvolgono join complesse
I database NoSQL sono adatti a situazioni in cui flessibilità e operazioni in massa sono priorità. Ad esempio, i database NoSQL come MongoDB consentono l’uso di operatori come updateMany quando serve aggiornare un gran numero di documenti. Ecco alcuni principi guida su quando considerare un’implementazione NoSQL:
- La cardinalità è prevedibile
- Le letture superano di gran lunga le scritture
- La flessibilità dello schema prevale sulla coerenza rigorosa
Conclusione
Le relazioni molti-a-molti sono inevitabili in modelli di dati realistici. Progettarle correttamente è fondamentale per l’integrità dei dati, la scalabilità e la correttezza analitica. Le tabelle ponte, quando adeguatamente normalizzate e indicizzate, forniscono una base solida che scala dai sistemi transazionali all’analitica enterprise.
Ogni progetto implica compromessi: normalizzazione contro prestazioni, semplicità contro flessibilità e astrazione contro controllo. La chiave è profilare i pattern di accesso, scegliere i pattern allineati al carico di lavoro e convalidare i design tramite revisione dello schema e test delle query.
Per chi pratica e desidera approfondire le competenze nella progettazione di database, consiglio vivamente di iscriversi al nostro percorso di carriera Associate Data Analyst in SQL.





Utenti e follower, studenti e corsi, clienti e prodotti: il nostro mondo è pieno di relazioni molti-a-molti naturali. Tuttavia, non sempre vengono tradotte correttamente nella progettazione dei database. Relazioni molti-a-molti progettate male sono tra le fonti più comuni di duplicazione dei dati, analisi errate e problemi di manutenzione a lungo termine nei sistemi in produzione.
In questo articolo, analizzerò le relazioni molti-a-molti dai primi principi fino all’implementazione nel mondo reale. Esploreremo anche pattern di progettazione avanzati, normalizzazione, considerazioni sulle prestazioni e come le relazioni molti-a-molti vengono implementate nei sistemi relazionali e NoSQL.
Alla fine, dovresti essere in grado di progettare schemi scalabili e manutenibili che modellino correttamente relazioni complesse, evitino anomalie nei dati e supportino reportistica e flussi BI affidabili.
Per chi vuole rinforzare le basi lungo il percorso, consiglio di seguire il corso Introduction to Relational Databases in SQL.
Che cos’è una relazione molti-a-molti
Una relazione molti-a-molti (M:N) è una relazione bidirezionale in un database in cui ogni record nella Tabella A può essere collegato a molti record nella Tabella B, e ogni record nella Tabella B può essere collegato a molti record nella Tabella A. A differenza dei tipi di relazione più semplici, la cardinalità esiste su entrambi i lati.
Questa relazione è onnipresente nei sistemi reali:
La relazione porta con sé un significato e spesso anche dati propri. Capire questa distinzione è fondamentale per una progettazione e interrogazione corrette dello schema, soprattutto quando si uniscono tabelle per l’analisi.
Relazione molti-a-molti vs. uno-a-molti
Per capire perché le relazioni molti-a-molti richiedono una gestione speciale, è utile metterle a confronto con cardinalità più semplici.
Tipo di relazione
Descrizione
Logica
Esempio
Uno-a-uno (1:1)
Ogni record nella Tabella A è collegato esattamente a uno nella Tabella B.
Associazione univoca.
Utente ↔ Profilo utente
Uno-a-molti (1:N)
Un record nella Tabella A è collegato a molti nella Tabella B, ma i record della Tabella B hanno un solo genitore.
Struttura genitore/figlio.
Cliente → Ordini multipli
Molti-a-molti (M:N)
Più record nella Tabella A sono collegati a più record nella Tabella B.
Rete bidirezionale.
Studenti ↔ Corsi
Per esempio, in un design uno-a-molti, una tabella degli ordini contiene in genere una chiave esterna
customer_idcon ogni ordine univoco dotato di unorder_id. Ogni ordine appartiene esattamente a un cliente, ma un cliente può avere molte chiaviorder_id.Ora confrontalo con l’esempio studente–corso. Se provi a salvare
course_iddirettamente nella tabella degli studenti, ogni studente sarebbe collegato a più valori dicourse_id. Al contrario, nella tabella dei corsi, ogni corso avrebbe più riferimentistudent_id. Invece di una relazione unidirezionale ordinata, entrambe le direzioni condividono informazioni avanti e indietro.Violazione della Prima Forma Normale e il problema molti-a-molti
Un problema comune è cercare di rappresentare direttamente le relazioni molti-a-molti memorizzando più valori in un’unica colonna usando un array (ad es.,
course_idsin una tabellastudents) o colonne ripetute comecourse_1,course_2,course_3.Questo approccio viola la Prima Forma Normale (1NF), che richiede che ogni colonna contenga valori atomici e indivisibili. Leggi questo blog sulla normalizzazione in SQL per un ripasso.
La violazione della 1NF porta alle classiche anomalie di aggiornamento:
Oltre alla teoria della normalizzazione, c’è una seria conseguenza analitica nota come problema molti-a-molti. Quando le tabelle con una relazione molti-a-molti non vengono unite con attenzione, si può facilmente incorrere in una moltiplicazione delle righe. Questo può causare problemi nei tempi di calcolo ed errori di aggregazione nelle analisi.
Ad esempio, unendo
coursesastudentsin base astudent_idsi può far sì che ogni corso venga unito più volte a causa di molteplici voci per studente. Poi tentando di aggregare si può incorrere in discrepanze analitiche come entrate o conteggi di studenti.Una progettazione corretta dello schema influisce direttamente sull’accuratezza dei report, sui calcoli finanziari e sulla fiducia nei prodotti data-driven. Inoltre, aiuta a semplificare le join per ridurre al minimo l’errore umano. Per maggiori dettagli sugli errori comuni nelle join, guarda questo tutorial sulle join SQL ed esercitati con queste Top 20 domande sulle join SQL.
Tabelle ponte: fondamenti e struttura
La soluzione standard alle relazioni molti-a-molti nei sistemi relazionali è la tabella ponte (chiamata anche tabella di join, tabella ponte/bridge o tabella associativa). Invece di cercare di memorizzare le relazioni direttamente, si introduce una tabella intermedia che fa riferimento a entrambe le tabelle genitore.
Concettualmente, questo trasforma A ↔ B in A ← JT→ B.
Ora, ciascuna ha una relazione uno-a-molti con la tabella ponte, consentendo uno schema analitico semplificato. Esaminerò come costruiamo queste tabelle ponte e come vengono utilizzate.
Anatomia e componenti
Una tabella ponte di base contiene:
Nella maggior parte dei casi, queste due chiavi esterne insieme formano una chiave primaria composta. Questo garantisce che la stessa relazione non possa essere inserita due volte e impone l’unicità a livello di database.
Ad esempio, una tabella
enrollmentspotrebbe usare la concatenazione distudent_idecourse_idcome chiave primaria. Il database ora ha una chiave di riferimento univoca per la relazione e possiamo iniziare a costruire casi d’uso di business.Esempio di come potrebbe apparire una tabella ponte
enrollments.Aggiungere attributi alle tabelle ponte
Quando una tabella ponte memorizza attributi aggiuntivi, si avvicina a un’entità associativa più che a un semplice artefatto strutturale. Questo consente alla tabella ponte di contenere informazioni contestuali sulla relazione. Esempi comuni includono:
Data:
enrollment_date,creation_datee informazioni simili basate sul tempoRuolo: ad es., amministratore vs. membro in un gruppo
Metriche: punteggio di rilevanza nei sistemi di raccomandazione
Questo aiuta la relazione a portare più significato. La complessità delle query aumenta leggermente, ma lo schema modella la realtà in modo più accurato. Questo compromesso vale quasi sempre in sistemi in cui le relazioni evolvono nel tempo. Possiamo aggiungere più informazioni e rendere le tabelle ponte uno strumento analitico utile.
Mantenere l’integrità dei dati
Le tabelle ponte si basano fortemente sull’integrità referenziale. I vincoli di chiave esterna garantiscono che ogni riga di relazione faccia riferimento a record genitore validi, prevenendo dati orfani.
Le regole di eliminazione sono importanti:
La scelta dipende dalla semantica di business. In alcuni domini è appropriata la pulizia automatica; in altri, le relazioni storiche devono essere preservate o riviste esplicitamente prima della rimozione.
Normalizzazione e tabelle ponte
Le tabelle ponte sono un’applicazione diretta della Terza Forma Normale (3NF). Eliminano le dipendenze transitive e rimuovono l’archiviazione ridondante dei dati di relazione. Il loro obiettivo è migliorare la normalizzazione all’interno del database.
In molti casi, le tabelle ponte aiutano anche a soddisfare la Boyce–Codd Normal Form (BCNF) perché la chiave primaria composta determina completamente tutti gli attributi non chiave. Questo è importante perché minimizza le anomalie di aggiornamento e garantisce che modificare una relazione richieda di cambiare esattamente una riga.
Per comprendere più a fondo l’importanza di assicurare la 3NF nei nostri database, dai un’occhiata a questo articolo sulla dipendenza transitiva.
Progettare e implementare relazioni molti-a-molti
Vediamo come possiamo effettivamente costruire i nostri database per supportare relazioni molti-a-molti. Tratteremo buone pratiche per semplificarti la vita.
Convenzioni di denominazione e chiarezza dello schema
Una denominazione chiara delle tabelle riduce il carico cognitivo e migliora la manutenibilità. Le convenzioni comuni includono in genere
TableA_TableBojoin_TableATableB, ad esempio:student_courseuser_groupjoin_user_groupI nomi delle colonne dovrebbero rispecchiare le chiavi primarie delle tabelle genitore (ad es.,
student_id,course_id) per rendere le join ovvie e leggibili. La coerenza diventa cruciale man mano che gli schemi crescono e i team si ampliano.Pattern comuni e varianti
Ci sono diversi modi in cui possiamo costruire le nostre tabelle ponte, dal semplice tracciamento delle relazioni a relazioni polimorfe più complesse.
Tabelle ponte semplici
Le tabelle ponte semplici contengono solo chiavi esterne e sono ideali per relazioni statiche o a basso contesto. Sono molto semplici da mantenere con un overhead minimo, poiché in genere si limitano a mostrare come due tabelle sono correlate. Queste tabelle ponte non hanno dati temporali o contestuali.
Relazioni molti-a-molti auto-referenti
Le relazioni molti-a-molti auto-referenti si verificano quando entrambe le chiavi esterne fanno riferimento alla stessa tabella.
Ad esempio, se stiamo tracciando un’app di social media che include il tracciamento degli utenti, dei loro follower e di chi seguono, potremmo avere una relazione di
user_idconfollower_idin entrambe le direzioni. Potrebbero essere necessari vincoli aggiuntivi per prevenire duplicati non validi o simmetrici.Relazioni molti-a-molti polimorfe
Le relazioni molti-a-molti polimorfe consentono a una singola tabella ponte di collegare più tipi di entità utilizzando un discriminatore di tipo. Questo offre flessibilità ma sposta l’applicazione dell’integrità nella logica applicativa e complica le query.
Per esempio, una tabella ponte chiamata
Tagper app social potrebbe collegarePosts,CommentseUserscon una colonna contestuale aggiuntiva per associare il tag all’entità corretta.Relazioni temporali e pesate
Le relazioni temporali e pesate memorizzano entrambe informazioni sulla relazione in attributi aggiuntivi.
Le relazioni molti-a-molti temporali aggiungono colonne che forniscono informazioni temporali, come
active_from,active_toocreated_on, per tracciare la validità storica. La chiaveenrolled_onnel nostro precedente database studenti–corsi è un esempio di relazione temporale.Queste sono essenziali per audit trail, relazioni in lento cambiamento e analisi al punto nel tempo. Aggiunge un po’ di complessità, per cui gli utenti devono fare attenzione a filtrare sulla scala temporale corretta e considerare le righe che potrebbero essere inattive.
Le relazioni pesate, invece, memorizzano metriche di ranking o intensità. I motori di raccomandazione, i sistemi di tagging e i punteggi di rilevanza si basano comunemente su questo pattern per tracciare aspetti come la confidenza della raccomandazione.
Relazioni a più vie
Sebbene la maggior parte dei sistemi OLTP eviti relazioni che coinvolgono più di due entità, i sistemi analitici le utilizzano frequentemente. Le tabelle dei fatti nei modelli dimensionali fungono di fatto da tabelle ponte collegando tabelle a vari livelli di granularità. Questi design sono potenti ma richiedono interrogazioni disciplinate e documentazione chiara.
Un possibile design sarebbe creare la tabella ponte con chiavi esterne verso tutte le entità partecipanti.
Per esempio, se partiamo dal nostro esempio studenti e corsi, una terza tabella potrebbe essere i numeri delle aule. Una tabella ponte può contenere le chiavi esterne per uno studente in una particolare classe in una particolare aula. È facile vedere che, man mano che ampliamo il numero di relazioni, interrogazioni e schema diventano esponenzialmente più complessi.
Per approfondire la costruzione dei database, assicurati di seguire il nostro corso sulla progettazione di database.
Ottimizzazione delle prestazioni ed efficienza delle query
Con qualsiasi progettazione di database complessa, dobbiamo considerare prestazioni e interrogazioni. Più pezzi aggiungiamo, più è probabile imbattersi in colli di bottiglia!
Pattern di query e ottimizzazione
Vediamo innanzitutto alcuni modi in cui potremmo interrogare le nostre tabelle ponte. I pattern di accesso comuni includono:
Per ottimizzare queste query:
Indicizza le chiavi esterne nella tabella ponte
Usa
GROUP BYoDISTINCTper evitare sovracontaggiValuta indici coprenti per carichi di lavoro fortemente in lettura
Sii specifico nelle clausole
WHEREper limitare la quantità di dati uniti.Queste tecniche sono fondamentali per join e aggregazioni efficienti. Ricorda anche che, se stai usando la tabella ponte per collegare due tabelle, è utile pensare a come potresti unire tre tabelle in modo efficiente.
Operazioni massicce e concorrenza
Le tabelle ponte spesso registrano un volume elevato di scritture. Gli inserimenti e aggiornamenti in batch riducono l’overhead delle transazioni.
Tuttavia, un’elevata contesa su chiavi esterne molto popolari può creare colli di bottiglia dovuti ai lock. Assicurati di monitorare le prestazioni e partizionare le tabelle per consentire la parallelizzazione.
Normalizzazione vs denormalizzazione
Prendiamoci un attimo per vedere la differenza chiave tra normalizzazione e denormalizzazione come approccio alla progettazione del database:
Rifletti davvero sui pattern di accesso, sulla competenza del team e sui vincoli operativi.
Compromessi della denormalizzazione
La denormalizzazione può migliorare le prestazioni su sistemi con molte scritture che non cambiano frequentemente. Il costo è una complessità aggiuntiva, un aumento dell’onere di manutenzione e un rischio di dati obsoleti.
Il mio parere: la denormalizzazione dovrebbe essere solo una risposta ponderata a colli di bottiglia in lettura e dovrebbe sempre essere costruita con controlli regolari di coerenza.
Implementazione nei diversi sistemi di database
I sistemi SQL e NoSQL adottano approcci leggermente diversi all’implementazione di sistemi molti-a-molti.
Architetture relazionali e NoSQL
I database relazionali come PostgreSQL, MySQL e SQL Server implementano esplicitamente le relazioni molti-a-molti utilizzando tabelle ponte con chiavi esterne e chiavi primarie composte. Allo stesso modo, i database relazionali cloud come Snowflake seguono un pattern di progettazione simile.
I sistemi NoSQL spesso rappresentano le relazioni molti-a-molti incorporando array di ID correlati o memorizzando riferimenti gestiti dalla logica applicativa. Questo è dovuto alla priorità delle prestazioni in lettura e della scalabilità orizzontale nei database NoSQL. Migliora le prestazioni in lettura e la flessibilità dello schema, ma sacrifica la normalizzazione.
Funzionalità
Relazionale (SQL)
NoSQL
Implementazione
Tabelle ponte: utilizza una terza tabella con chiavi esterne e chiavi primarie composte.
Incorporamento o riferimenti: utilizza array di ID o documenti annidati.
Obiettivo primario
Normalizzazione: garantisce coerenza dei dati ed elimina le ridondanze.
Prestazioni: priorità alla velocità di lettura e alla scalabilità orizzontale.
Flessibilità
Schema rigido: richiede strutture predefinite e join per recuperare i dati.
Alta flessibilità: consente design senza schema e tipi di dati vari.
Compromesso
Join complesse: possono diventare più lente con la crescita significativa del dataset.
Sacrifica la normalizzazione: può portare a duplicazioni o dati "obsoleti".
Esempi
PostgreSQL, MySQL, SQL Server, Snowflake.
MongoDB, DynamoDB, Cassandra.
SQL vs NoSQL
I database relazionali sono preferiti quando serve una struttura di schema ben definita. Questi database sono più facili da manipolare e consentono una migliore gestione dei dati. Considera di concentrarti sull’uso di un database relazionale SQL quando:
I database NoSQL sono adatti a situazioni in cui flessibilità e operazioni in massa sono priorità. Ad esempio, i database NoSQL come MongoDB consentono l’uso di operatori come
updateManyquando serve aggiornare un gran numero di documenti. Ecco alcuni principi guida su quando considerare un’implementazione NoSQL:Conclusione
Le relazioni molti-a-molti sono inevitabili in modelli di dati realistici. Progettarle correttamente è fondamentale per l’integrità dei dati, la scalabilità e la correttezza analitica. Le tabelle ponte, quando adeguatamente normalizzate e indicizzate, forniscono una base solida che scala dai sistemi transazionali all’analitica enterprise.
Ogni progetto implica compromessi: normalizzazione contro prestazioni, semplicità contro flessibilità e astrazione contro controllo. La chiave è profilare i pattern di accesso, scegliere i pattern allineati al carico di lavoro e convalidare i design tramite revisione dello schema e test delle query.
Per chi pratica e desidera approfondire le competenze nella progettazione di database, consiglio vivamente di iscriversi al nostro percorso di carriera Associate Data Analyst in SQL.