Gebruikers en volgers, studenten en cursussen, klanten en producten: onze wereld zit vol natuurlijke many-to-many-relaties. Toch worden die niet altijd goed vertaald naar databaseontwerpen. Slecht ontworpen many-to-many-relaties zijn een van de meest voorkomende bronnen van dataduplicatie, foutieve analyses en langdurige onderhoudsproblemen in productiesystemen.
In dit artikel behandel ik many-to-many-relaties van de basisprincipes tot en met implementatie in de praktijk. We bekijken ook geavanceerde ontwerppatronen, normalisatie, prestatie-overwegingen en hoe many-to-many-relaties worden geïmplementeerd in relationele en NoSQL-systemen.
Aan het einde kun je schaalbare, onderhoudbare schema’s ontwerpen die complexe relaties correct modelleren, data-anomalieën vermijden en betrouwbare rapportage- en BI-workflows ondersteunen.
Voor lezers die onderweg hun fundament willen versterken, raad ik onze Introduction to Relational Databases in SQL-cursus aan.
Wat is een many-to-many-relatie
Een many-to-many-relatie (M:N) is een bidirectionele databaserelatie waarbij elk record in Tabel A kan verwijzen naar meerdere records in Tabel B, en elk record in Tabel B naar meerdere records in Tabel A. In tegenstelling tot eenvoudigere relatietypen is er aan beide kanten cardinaliteit.
Deze relatie is alomtegenwoordig in echte systemen:
- Onderwijs: Een student kan zich inschrijven voor meerdere cursussen, en elke cursus kan veel studenten hebben.
- E-commerce: Een product kan tot meerdere categorieën behoren, en elke categorie kan veel producten bevatten.
- Sociale platforms: Gebruikers kunnen lid worden van meerdere groepen, en groepen kunnen veel gebruikers bevatten.
- Gezondheidszorg: Een patiënt kan meerdere medicijnen voorgeschreven krijgen, en elk medicijn kan aan veel patiënten worden voorgeschreven.
De relatie draagt betekenis en vaak ook eigen data. Dit onderscheid begrijpen is cruciaal voor correct schemaontwerp en query’s, vooral bij het joinen van tabellen voor analytics.
Many-to-many versus one-to-many-relatie
Om te begrijpen waarom many-to-many-relaties speciale behandeling vereisen, helpt het om ze te contrasteren met eenvoudigere cardinaliteiten.
- One-to-one (1:1): Elk record in Tabel A verwijst naar precies één record in Tabel B, en omgekeerd (bijv. een gebruiker en een gebruikersprofiel).
- One-to-many (1:N): Eén record in Tabel A kan verwijzen naar veel records in Tabel B, maar elk record in Tabel B verwijst naar slechts één record in Tabel A (bijv. een klant en diens bestellingen).
|
Relatietype
|
Beschrijving
|
Logica
|
Voorbeeld
|
|
One-to-one (1:1)
|
Elk record in Tabel A verwijst naar precies één in Tabel B.
|
Unieke koppeling.
|
Gebruiker ↔ Gebruikersprofiel
|
|
One-to-many (1:N)
|
Eén record in Tabel A verwijst naar veel in Tabel B, maar Tabel B-records hebben slechts één ouder.
|
Ouder/kind-structuur.
|
Klant → Meerdere bestellingen
|
|
Many-to-many (M:N)
|
Meerdere records in Tabel A verwijzen naar meerdere records in Tabel B.
|
Bidirectioneel web.
|
Studenten ↔ Cursussen
|
Neem bijvoorbeeld: in een one-to-many-ontwerp bevat een orders-tabel doorgaans een customer_id-vreemde sleutel en heeft elke unieke bestelling een order_id. Elke bestelling hoort bij precies één klant, maar een klant kan veel order_id-sleutels hebben.
Vergelijk dit nu met het student–cursusvoorbeeld. Als je probeert course_id direct in de students-tabel op te slaan, wordt elke student gekoppeld aan meerdere course_id-waarden. Omgekeerd zou in de course-tabel elke cursus meerdere verwijzingen naar student_id hebben. In plaats van een nette eenrichtingsrelatie delen beide richtingen informatie over en weer.
Schending van de Eerste Normaalvorm en het many-to-many-probleem
Een veelvoorkomend probleem is proberen many-to-many-relaties direct te representeren door meerdere waarden in één kolom op te slaan met behulp van een array (bijv. course_ids in een students-tabel) of herhaalde kolommen zoals course_1, course_2, course_3.
Deze aanpak schendt de Eerste Normaalvorm (1NF), die vereist dat elke kolom atomische, ondeelbare waarden bevat. Lees deze blog over normalisatie in SQL als opfrisser.
Het schenden van 1NF leidt tot klassieke update-anomalieën:
- Invoeganomalieën: Een nieuwe relatie toevoegen vereist het aanpassen van een bestaande rijstructuur.
- Update-anomalieën: Een relatie wijzigen vereist het bijwerken van meerdere rijen, meerdere kolommen of ingesloten waarden, wat de kans op inconsistentie vergroot.
- Verwijderingsanomalieën: Het verwijderen van één relatie kan per ongeluk niet-gerelateerde informatie verwijderen.
Los van de normalisatietheorie is er een ernstige analytische consequentie, bekend als het many-to-many-probleem. Wanneer tabellen met een many-to-many-relatie niet zorgvuldig gejoint worden, kan dit gemakkelijk leiden tot rijvermenigvuldiging. Dit kan zorgen voor langere rekentijden en aggregatiefouten in analyses.
Als je bijvoorbeeld courses joint met students op basis van student_id, kan elke cursus meerdere keren gejoint worden door meerdere studentenrecords. Daarna kan aggregeren leiden tot analytische afwijkingen zoals omzet- of studentenaantallen.
Correct schemaontwerp heeft direct invloed op rapportage-nauwkeurigheid, financiële berekeningen en vertrouwen in dataprodukten. Bovendien helpt het joins te vereenvoudigen, zodat menselijke fouten worden beperkt. Voor meer details over veelvoorkomende join-valkuilen, bekijk deze SQL-join-tutorial en oefen met deze Top 20 SQL Joins Questions.
Junctietabellen: fundament en structuur
De standaardoplossing voor many-to-many-relaties in relationele systemen is de junctie- of koppelttabel (ook wel join-, brug- of associatietabel genoemd). In plaats van relaties direct op te slaan, introduceer je een tussentabel die naar beide oudertabellen verwijst.
Conceptueel transformeert dit A ↔ B naar A ← JT → B.
Nu heeft elk een one-to-many-relatie met de junctietabel, wat een vereenvoudigd analytisch schema mogelijk maakt. Ik laat zien hoe we deze junctietabellen opbouwen en gebruiken.
Anatomie en componenten
Een basis-junctietabel bevat:
- Eén vreemde sleutel die verwijst naar de primaire sleutel van Tabel A
- Eén vreemde sleutel die verwijst naar de primaire sleutel van Tabel B
In de meeste gevallen vormen deze twee vreemde sleutels samen een samengestelde primaire sleutel. Dit garandeert dat dezelfde relatie niet tweemaal kan worden ingevoegd en dwingt uniciteit af op databaseniveau.
Een enrollments-tabel kan bijvoorbeeld een concatenatie van student_id en course_id gebruiken als primaire sleutel. De database heeft nu een unieke referentiesleutel voor de relatie en we kunnen business-use-cases gaan bouwen.
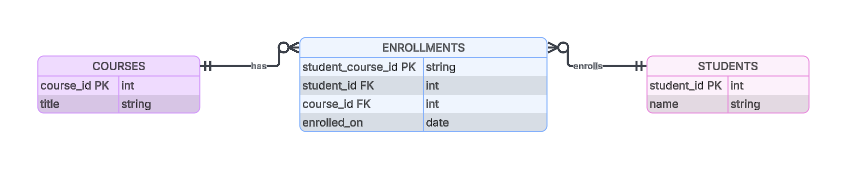
Voorbeeld van hoe een junctietabel enrollments eruit kan zien.
Attributen toevoegen aan junctietabellen
Wanneer een junctietabel extra attributen opslaat, wordt het meer een associatieve entiteit dan puur een structureel artefact. Dit stelt de junctietabel in staat contextuele informatie over de relatie te bevatten. Veelvoorkomende voorbeelden zijn:
-
Datum: enrollment_date, creation_date en vergelijkbare tijdgebaseerde informatie
-
Rol: bijv. admin versus lid in een groep
-
Metrieken: relevantie-scores in aanbevelingssystemen
Dit helpt de relatie meer betekenis te dragen. De querycomplexiteit neemt iets toe, maar het schema modelleert de werkelijkheid nauwkeuriger. Deze trade-off is bijna altijd de moeite waard in systemen waar relaties in de tijd evolueren. We kunnen meer informatie toevoegen en junctietabellen tot een nuttig analytisch hulpmiddel maken.
Dataconsistentie waarborgen
Junctietabellen leunen sterk op referentiële integriteit. Vreemde-sleutelbeperkingen zorgen ervoor dat elke relatieregel naar geldige ouderrecords verwijst, waardoor verweesde data wordt voorkomen.
Verwijderingsregels zijn belangrijk:
- CASCADE: Verwijder automatisch junctierijen wanneer een ouder wordt verwijderd.
- RESTRICT / NO ACTION: Voorkom het verwijderen van een ouderrij als er nog relaties bestaan.
De keuze hangt af van de business-semantiek. In sommige domeinen is automatische opschoning gepast; in andere moeten historische relaties bewaard blijven of expliciet worden beoordeeld vóór verwijdering.
Normalisatie en junctietabellen
Junctietabellen zijn een directe toepassing van de Derde Normaalvorm (3NF). Ze elimineren transitieve afhankelijkheden en verwijderen redundante opslag van relatiegegevens. Het hele doel is de normalisatie binnen de database te verbeteren.
In veel gevallen helpen junctietabellen ook te voldoen aan Boyce–Codd-normaalvorm (BCNF), omdat de samengestelde primaire sleutel alle niet-sleutelattributen volledig bepaalt. Dit is belangrijk omdat het update-anomalieën minimaliseert en garandeert dat het wijzigen van een relatie precies één rij vereist.
Voor een diepere uitleg over het belang van het waarborgen van 3NF in onze databases, bekijk dit artikel over transitieve afhankelijkheid.
Many-to-many-relaties ontwerpen en implementeren
Laten we bespreken hoe we onze databases daadwerkelijk kunnen bouwen om many-to-many-relaties te ondersteunen. We behandelen goede praktijken om je leven makkelijker te maken.
Naamgevingsconventies en schemaclariteit
Duidelijke tabelnamen verlagen de cognitieve belasting en verbeteren het onderhoud. Gangbare conventies omvatten doorgaans TableA_TableB of join_TableATableB, bijvoorbeeld:
-
student_course
-
user_group
-
join_user_group
Kolomnamen moeten primaire sleutels van de oudertabellen spiegelen (bijv. student_id, course_id) om joins duidelijk en leesbaar te maken. Consistentie wordt cruciaal naarmate schema’s groeien en teams uitbreiden.
Veelvoorkomende patronen en variaties
Er zijn verschillende manieren om onze junctietabellen te bouwen, van heel eenvoudige relatie-tracking tot complexere polymorfe relaties.
Eenvoudige junctietabellen
Eenvoudige junctietabellen bevatten alleen vreemde sleutels en zijn ideaal voor statische of laag-contextuele relaties. Ze zijn zeer eenvoudig te onderhouden met minimale overhead, omdat ze doorgaans alleen laten zien hoe twee tabellen aan elkaar gerelateerd zijn. Deze junctietabellen hebben geen temporele of contextuele data.
Zelf-refererende many-to-many-relaties
Zelf-refererende many-to-many-relaties ontstaan wanneer beide vreemde sleutels naar dezelfde tabel verwijzen.
Als we bijvoorbeeld een socialmedia-app bijhouden met gebruikers, hun volgers en wie ze volgen, kunnen we een relatie hebben van user_id naar follower_id in beide richtingen. Extra beperkingen kunnen nodig zijn om ongeldige of symmetrische duplicaten te voorkomen.
Polymorfe many-to-many-relaties
Polymorfe many-to-many-relaties stellen één junctietabel in staat meerdere entiteitstypen te koppelen met behulp van een typediscriminator. Dit biedt flexibiliteit, maar verschuift de handhaving van integriteit naar de applicatielogica en maakt query’s complexer.
Een junctietabel genaamd Tag voor socialmedia-apps kan bijvoorbeeld Posts, Comments en Users relateren met een extra contextkolom om de tag aan de juiste entiteit te koppelen.
Temporele en gewogen relaties
Zowel temporele als gewogen relaties slaan informatie over de relatie op in extra attributen.
Temporele many-to-many-relaties voegen kolommen toe die temporele informatie bieden, zoals active_from, active_to of created_on, om historische geldigheid bij te houden. De sleutel enrolled_on in onze eerdere student-cursusdatabase is één voorbeeld van een temporele relatie.
Deze zijn essentieel voor audittrails, langzaam veranderende relaties en point-in-time-analyses. Dit voegt wat complexiteit toe, waarbij gebruikers zorgvuldig moeten filteren op de juiste temporele schaal en rekening moeten houden met rijen die mogelijk inactief zijn.
Gewogen relaties daarentegen slaan rangorde- of sterktemetingen op. Aanbevelingsengines, taggingsystemen en relevantiescores leunen vaak op dit patroon om zaken als aanbevelingsvertrouwen te volgen.
Meerwegrelaties
Hoewel de meeste OLTP-systemen relaties met meer dan twee entiteiten vermijden, gebruiken analysetrajecten ze vaak. Feitentabellen in dimensionale modellen fungeren in feite als junctietabellen die tabellen op verschillende granulariteitsniveaus verbinden. Deze ontwerpen zijn krachtig, maar vereisen gedisciplineerde query’s en duidelijke documentatie.
Een mogelijk ontwerp is om je junctietabel te maken met vreemde sleutels naar alle deelnemende entiteiten.
Als we bijvoorbeeld voortbouwen op ons studenten- en cursusvoorbeeld, kan een derde tabel klaslokaalnummers zijn. Een junctietabel kan de vreemde sleutels bevatten voor een student in een specifieke les in een specifieke ruimte. Het is gemakkelijk te zien dat naarmate we het aantal relaties uitbreiden, query’s en schema’s exponentieel complexer worden.
Voor een verdiepende duik in het bouwen van databases, volg zeker onze cursus over databaseontwerp.
Prestatie-optimalisatie en query-efficiëntie
Bij elk complex databaseontwerp moeten we kijken naar performance en query-overwegingen. Hoe meer onderdelen we toevoegen, hoe groter de kans op prestatieknelpunten!
Querypatronen en optimalisatie
Laten we eerst kijken naar manieren waarop we onze junctietabellen kunnen bevragen. Veelvoorkomende toegangspatronen zijn:
- Alle gerelateerde entiteiten uit Tabel B ophalen voor een gegeven entiteit in Tabel A
- Relaties tellen
- Filteren op relatie-attributen
Om deze query’s te optimaliseren:
-
Indexeer vreemde sleutels in de junctietabel
-
Gebruik GROUP BY of DISTINCT om over-telling te voorkomen
-
Overweeg covering-indexen voor leeszware workloads
-
Wees specifiek in WHERE-clausules om te beperken hoeveel data gejoint wordt.
Deze technieken zijn fundamenteel voor efficiënte joins en aggregaties. Onthoud ook: als je de junctietabel gebruikt om twee tabellen te overbruggen, is het goed om na te denken over hoe je drie tabellen efficiënt joint.
Bulkoperaties en gelijktijdigheid
Junctietabellen zien vaak een hoog schrijfvolume. Batchinserts en -updates verlagen de transactiekosten.
Hoge concurrentie op populaire vreemde sleutels kan echter vergrendelingsknelpunten creëren. Zorg dat je performance monitort en partitioneer tabellen om parallellisatie mogelijk te maken.
Normalisatie versus denormalisatie
Laten we even stilstaan bij het belangrijkste verschil tussen normalisatie en denormalisatie als aanpak voor ons databaseontwerp:
- Genormaliseerde ontwerpen passen bij schrijfzware, consistentie-kritische systemen (bijv. finance, ERP). Als strikte consistentie zonder kans op duplicatie of overtollige data vereist is, focus dan op een strikt genormaliseerd ontwerp.
- Gedenormaliseerde ontwerpen passen bij leeszware analytics waar eventual consistency acceptabel is. Als data-toegankelijkheid belangrijker is en we oké zijn met data die later “settelt”, dan kunnen we een gedenormaliseerd ontwerp gebruiken, mits we strikte richtlijnen voor best practices bieden.
Denk goed na over toegangspatronen, teamexpertise en operationele randvoorwaarden.
Trade-offs bij denormalisatie
Denormalisatie kan de performance verbeteren bij schrijfzware systemen die niet vaak veranderen. De keerzijde is extra complexiteit, een hogere onderhoudslast en risico op verouderde data.
Mijn twee cent: denormalisatie moet alleen een weloverwogen reactie zijn op leeszware knelpunten en moet altijd worden gebouwd met regelmatige consistentiecontroles.
Implementatie in verschillende databasesystemen
SQL- en NoSQL-systemen hebben iets verschillende benaderingen voor de implementatie van many-to-many-systemen.
Relationele en NoSQL-architecturen
Relationele databases zoals PostgreSQL, MySQL en SQL Server implementeren many-to-many-relaties expliciet met junctietabellen met vreemde sleutels en samengestelde primaire sleutels. Evenzo volgen cloudgebaseerde relationele databases zoals Snowflake een vergelijkbaar ontwerppatroon.
NoSQL-systemen representeren many-to-many-relaties vaak door arrays met gerelateerde ID’s in te bedden of verwijzingen op te slaan die door applicatielogica worden beheerd. Dit komt door de prioriteit van leesperformance en horizontale schaalbaarheid in NoSQL-databases. Dit verbetert de leesperformance en schemaflexibiliteit, maar gaat ten koste van normalisatie.
|
Kenmerk
|
Relationeel (SQL)
|
NoSQL
|
|
Implementatie
|
Junctietabellen: gebruikt een derde tabel met vreemde sleutels en samengestelde primaire sleutels.
|
Embedding of refereren: gebruikt arrays met ID’s of geneste documenten.
|
|
Primair doel
|
Normalisatie: zorgt voor dataconsistentie en elimineert redundantie.
|
Performance: geeft prioriteit aan leessnelheid en horizontale schaalbaarheid.
|
|
Flexibiliteit
|
Rigide schema: vereist vooraf gedefinieerde structuren en joins om data op te halen.
|
Hoge flexibiliteit: staat schemaloze ontwerpen en uiteenlopende datatypen toe.
|
|
Trade-off
|
Complexe joins: kunnen trager worden naarmate de dataset sterk groeit.
|
Levert normalisatie in: kan leiden tot dataduplicatie of “stale” data.
|
|
Voorbeelden
|
PostgreSQL, MySQL, SQL Server, Snowflake.
|
MongoDB, DynamoDB, Cassandra.
|
SQL versus NoSQL
Relationele databases hebben de voorkeur wanneer je een goed gedefinieerde schemastructuur nodig hebt. Deze databases zijn eenvoudiger te manipuleren en maken beter databeheer mogelijk. Overweeg je te focussen op een relationele SQL-database wanneer:
- Relaties vaak veranderen
- Integriteit bedrijfskritisch is
- Query’s complexe joins bevatten
NoSQL-databases zijn geschikt wanneer flexibiliteit en bulkbewerkingen prioriteit hebben. Zo staan NoSQL-databases zoals MongoDB operators toe zoals updateMany wanneer we updates over een veelheid aan documenten moeten uitvoeren. Enkele leidende principes voor wanneer je een NoSQL-implementatie zou overwegen:
- Cardinaliteit is voorspelbaar
- Reads overtreffen writes ruimschoots
- Schemaflexibiliteit weegt zwaarder dan strikte consistentie
Conclusie
Many-to-many-relaties zijn onvermijdelijk in realistische datamodellen. Ze correct ontwerpen is cruciaal voor dataintegriteit, schaalbaarheid en analytische juistheid. Junctietabellen vormen, mits goed genormaliseerd en geïndexeerd, een robuuste basis die schaalt van transactionele systemen tot enterprise-analytics.
Elk ontwerp kent trade-offs: normalisatie versus performance, eenvoud versus flexibiliteit en abstractie versus controle. De sleutel is je toegangspatronen profileren, patronen kiezen die bij je workload passen en ontwerpen valideren via schemareviews en querytests.
Voor professionals die hun vaardigheden in databaseontwerp willen verdiepen, raad ik sterk aan je in te schrijven voor onze Associate Data Analyst in SQL-carrièreroute.




Gebruikers en volgers, studenten en cursussen, klanten en producten: onze wereld zit vol natuurlijke many-to-many-relaties. Toch worden die niet altijd goed vertaald naar databaseontwerpen. Slecht ontworpen many-to-many-relaties zijn een van de meest voorkomende bronnen van dataduplicatie, foutieve analyses en langdurige onderhoudsproblemen in productiesystemen.
In dit artikel behandel ik many-to-many-relaties van de basisprincipes tot en met implementatie in de praktijk. We bekijken ook geavanceerde ontwerppatronen, normalisatie, prestatie-overwegingen en hoe many-to-many-relaties worden geïmplementeerd in relationele en NoSQL-systemen.
Aan het einde kun je schaalbare, onderhoudbare schema’s ontwerpen die complexe relaties correct modelleren, data-anomalieën vermijden en betrouwbare rapportage- en BI-workflows ondersteunen.
Voor lezers die onderweg hun fundament willen versterken, raad ik onze Introduction to Relational Databases in SQL-cursus aan.
Wat is een many-to-many-relatie
Een many-to-many-relatie (M:N) is een bidirectionele databaserelatie waarbij elk record in Tabel A kan verwijzen naar meerdere records in Tabel B, en elk record in Tabel B naar meerdere records in Tabel A. In tegenstelling tot eenvoudigere relatietypen is er aan beide kanten cardinaliteit.
Deze relatie is alomtegenwoordig in echte systemen:
De relatie draagt betekenis en vaak ook eigen data. Dit onderscheid begrijpen is cruciaal voor correct schemaontwerp en query’s, vooral bij het joinen van tabellen voor analytics.
Many-to-many versus one-to-many-relatie
Om te begrijpen waarom many-to-many-relaties speciale behandeling vereisen, helpt het om ze te contrasteren met eenvoudigere cardinaliteiten.
Relatietype
Beschrijving
Logica
Voorbeeld
One-to-one (1:1)
Elk record in Tabel A verwijst naar precies één in Tabel B.
Unieke koppeling.
Gebruiker ↔ Gebruikersprofiel
One-to-many (1:N)
Eén record in Tabel A verwijst naar veel in Tabel B, maar Tabel B-records hebben slechts één ouder.
Ouder/kind-structuur.
Klant → Meerdere bestellingen
Many-to-many (M:N)
Meerdere records in Tabel A verwijzen naar meerdere records in Tabel B.
Bidirectioneel web.
Studenten ↔ Cursussen
Neem bijvoorbeeld: in een one-to-many-ontwerp bevat een orders-tabel doorgaans een
customer_id-vreemde sleutel en heeft elke unieke bestelling eenorder_id. Elke bestelling hoort bij precies één klant, maar een klant kan veelorder_id-sleutels hebben.Vergelijk dit nu met het student–cursusvoorbeeld. Als je probeert
course_iddirect in de students-tabel op te slaan, wordt elke student gekoppeld aan meerderecourse_id-waarden. Omgekeerd zou in de course-tabel elke cursus meerdere verwijzingen naarstudent_idhebben. In plaats van een nette eenrichtingsrelatie delen beide richtingen informatie over en weer.Schending van de Eerste Normaalvorm en het many-to-many-probleem
Een veelvoorkomend probleem is proberen many-to-many-relaties direct te representeren door meerdere waarden in één kolom op te slaan met behulp van een array (bijv.
course_idsin eenstudents-tabel) of herhaalde kolommen zoalscourse_1,course_2,course_3.Deze aanpak schendt de Eerste Normaalvorm (1NF), die vereist dat elke kolom atomische, ondeelbare waarden bevat. Lees deze blog over normalisatie in SQL als opfrisser.
Het schenden van 1NF leidt tot klassieke update-anomalieën:
Los van de normalisatietheorie is er een ernstige analytische consequentie, bekend als het many-to-many-probleem. Wanneer tabellen met een many-to-many-relatie niet zorgvuldig gejoint worden, kan dit gemakkelijk leiden tot rijvermenigvuldiging. Dit kan zorgen voor langere rekentijden en aggregatiefouten in analyses.
Als je bijvoorbeeld
coursesjoint metstudentsop basis vanstudent_id, kan elke cursus meerdere keren gejoint worden door meerdere studentenrecords. Daarna kan aggregeren leiden tot analytische afwijkingen zoals omzet- of studentenaantallen.Correct schemaontwerp heeft direct invloed op rapportage-nauwkeurigheid, financiële berekeningen en vertrouwen in dataprodukten. Bovendien helpt het joins te vereenvoudigen, zodat menselijke fouten worden beperkt. Voor meer details over veelvoorkomende join-valkuilen, bekijk deze SQL-join-tutorial en oefen met deze Top 20 SQL Joins Questions.
Junctietabellen: fundament en structuur
De standaardoplossing voor many-to-many-relaties in relationele systemen is de junctie- of koppelttabel (ook wel join-, brug- of associatietabel genoemd). In plaats van relaties direct op te slaan, introduceer je een tussentabel die naar beide oudertabellen verwijst.
Conceptueel transformeert dit A ↔ B naar A ← JT → B.
Nu heeft elk een one-to-many-relatie met de junctietabel, wat een vereenvoudigd analytisch schema mogelijk maakt. Ik laat zien hoe we deze junctietabellen opbouwen en gebruiken.
Anatomie en componenten
Een basis-junctietabel bevat:
In de meeste gevallen vormen deze twee vreemde sleutels samen een samengestelde primaire sleutel. Dit garandeert dat dezelfde relatie niet tweemaal kan worden ingevoegd en dwingt uniciteit af op databaseniveau.
Een
enrollments-tabel kan bijvoorbeeld een concatenatie vanstudent_idencourse_idgebruiken als primaire sleutel. De database heeft nu een unieke referentiesleutel voor de relatie en we kunnen business-use-cases gaan bouwen.Voorbeeld van hoe een junctietabel
enrollmentseruit kan zien.Attributen toevoegen aan junctietabellen
Wanneer een junctietabel extra attributen opslaat, wordt het meer een associatieve entiteit dan puur een structureel artefact. Dit stelt de junctietabel in staat contextuele informatie over de relatie te bevatten. Veelvoorkomende voorbeelden zijn:
Datum:
enrollment_date,creation_dateen vergelijkbare tijdgebaseerde informatieRol: bijv. admin versus lid in een groep
Metrieken: relevantie-scores in aanbevelingssystemen
Dit helpt de relatie meer betekenis te dragen. De querycomplexiteit neemt iets toe, maar het schema modelleert de werkelijkheid nauwkeuriger. Deze trade-off is bijna altijd de moeite waard in systemen waar relaties in de tijd evolueren. We kunnen meer informatie toevoegen en junctietabellen tot een nuttig analytisch hulpmiddel maken.
Dataconsistentie waarborgen
Junctietabellen leunen sterk op referentiële integriteit. Vreemde-sleutelbeperkingen zorgen ervoor dat elke relatieregel naar geldige ouderrecords verwijst, waardoor verweesde data wordt voorkomen.
Verwijderingsregels zijn belangrijk:
De keuze hangt af van de business-semantiek. In sommige domeinen is automatische opschoning gepast; in andere moeten historische relaties bewaard blijven of expliciet worden beoordeeld vóór verwijdering.
Normalisatie en junctietabellen
Junctietabellen zijn een directe toepassing van de Derde Normaalvorm (3NF). Ze elimineren transitieve afhankelijkheden en verwijderen redundante opslag van relatiegegevens. Het hele doel is de normalisatie binnen de database te verbeteren.
In veel gevallen helpen junctietabellen ook te voldoen aan Boyce–Codd-normaalvorm (BCNF), omdat de samengestelde primaire sleutel alle niet-sleutelattributen volledig bepaalt. Dit is belangrijk omdat het update-anomalieën minimaliseert en garandeert dat het wijzigen van een relatie precies één rij vereist.
Voor een diepere uitleg over het belang van het waarborgen van 3NF in onze databases, bekijk dit artikel over transitieve afhankelijkheid.
Many-to-many-relaties ontwerpen en implementeren
Laten we bespreken hoe we onze databases daadwerkelijk kunnen bouwen om many-to-many-relaties te ondersteunen. We behandelen goede praktijken om je leven makkelijker te maken.
Naamgevingsconventies en schemaclariteit
Duidelijke tabelnamen verlagen de cognitieve belasting en verbeteren het onderhoud. Gangbare conventies omvatten doorgaans
TableA_TableBofjoin_TableATableB, bijvoorbeeld:student_courseuser_groupjoin_user_groupKolomnamen moeten primaire sleutels van de oudertabellen spiegelen (bijv.
student_id,course_id) om joins duidelijk en leesbaar te maken. Consistentie wordt cruciaal naarmate schema’s groeien en teams uitbreiden.Veelvoorkomende patronen en variaties
Er zijn verschillende manieren om onze junctietabellen te bouwen, van heel eenvoudige relatie-tracking tot complexere polymorfe relaties.
Eenvoudige junctietabellen
Eenvoudige junctietabellen bevatten alleen vreemde sleutels en zijn ideaal voor statische of laag-contextuele relaties. Ze zijn zeer eenvoudig te onderhouden met minimale overhead, omdat ze doorgaans alleen laten zien hoe twee tabellen aan elkaar gerelateerd zijn. Deze junctietabellen hebben geen temporele of contextuele data.
Zelf-refererende many-to-many-relaties
Zelf-refererende many-to-many-relaties ontstaan wanneer beide vreemde sleutels naar dezelfde tabel verwijzen.
Als we bijvoorbeeld een socialmedia-app bijhouden met gebruikers, hun volgers en wie ze volgen, kunnen we een relatie hebben van
user_idnaarfollower_idin beide richtingen. Extra beperkingen kunnen nodig zijn om ongeldige of symmetrische duplicaten te voorkomen.Polymorfe many-to-many-relaties
Polymorfe many-to-many-relaties stellen één junctietabel in staat meerdere entiteitstypen te koppelen met behulp van een typediscriminator. Dit biedt flexibiliteit, maar verschuift de handhaving van integriteit naar de applicatielogica en maakt query’s complexer.
Een junctietabel genaamd
Tagvoor socialmedia-apps kan bijvoorbeeldPosts,CommentsenUsersrelateren met een extra contextkolom om de tag aan de juiste entiteit te koppelen.Temporele en gewogen relaties
Zowel temporele als gewogen relaties slaan informatie over de relatie op in extra attributen.
Temporele many-to-many-relaties voegen kolommen toe die temporele informatie bieden, zoals
active_from,active_toofcreated_on, om historische geldigheid bij te houden. De sleutelenrolled_onin onze eerdere student-cursusdatabase is één voorbeeld van een temporele relatie.Deze zijn essentieel voor audittrails, langzaam veranderende relaties en point-in-time-analyses. Dit voegt wat complexiteit toe, waarbij gebruikers zorgvuldig moeten filteren op de juiste temporele schaal en rekening moeten houden met rijen die mogelijk inactief zijn.
Gewogen relaties daarentegen slaan rangorde- of sterktemetingen op. Aanbevelingsengines, taggingsystemen en relevantiescores leunen vaak op dit patroon om zaken als aanbevelingsvertrouwen te volgen.
Meerwegrelaties
Hoewel de meeste OLTP-systemen relaties met meer dan twee entiteiten vermijden, gebruiken analysetrajecten ze vaak. Feitentabellen in dimensionale modellen fungeren in feite als junctietabellen die tabellen op verschillende granulariteitsniveaus verbinden. Deze ontwerpen zijn krachtig, maar vereisen gedisciplineerde query’s en duidelijke documentatie.
Een mogelijk ontwerp is om je junctietabel te maken met vreemde sleutels naar alle deelnemende entiteiten.
Als we bijvoorbeeld voortbouwen op ons studenten- en cursusvoorbeeld, kan een derde tabel klaslokaalnummers zijn. Een junctietabel kan de vreemde sleutels bevatten voor een student in een specifieke les in een specifieke ruimte. Het is gemakkelijk te zien dat naarmate we het aantal relaties uitbreiden, query’s en schema’s exponentieel complexer worden.
Voor een verdiepende duik in het bouwen van databases, volg zeker onze cursus over databaseontwerp.
Prestatie-optimalisatie en query-efficiëntie
Bij elk complex databaseontwerp moeten we kijken naar performance en query-overwegingen. Hoe meer onderdelen we toevoegen, hoe groter de kans op prestatieknelpunten!
Querypatronen en optimalisatie
Laten we eerst kijken naar manieren waarop we onze junctietabellen kunnen bevragen. Veelvoorkomende toegangspatronen zijn:
Om deze query’s te optimaliseren:
Indexeer vreemde sleutels in de junctietabel
Gebruik
GROUP BYofDISTINCTom over-telling te voorkomenOverweeg covering-indexen voor leeszware workloads
Wees specifiek in
WHERE-clausules om te beperken hoeveel data gejoint wordt.Deze technieken zijn fundamenteel voor efficiënte joins en aggregaties. Onthoud ook: als je de junctietabel gebruikt om twee tabellen te overbruggen, is het goed om na te denken over hoe je drie tabellen efficiënt joint.
Bulkoperaties en gelijktijdigheid
Junctietabellen zien vaak een hoog schrijfvolume. Batchinserts en -updates verlagen de transactiekosten.
Hoge concurrentie op populaire vreemde sleutels kan echter vergrendelingsknelpunten creëren. Zorg dat je performance monitort en partitioneer tabellen om parallellisatie mogelijk te maken.
Normalisatie versus denormalisatie
Laten we even stilstaan bij het belangrijkste verschil tussen normalisatie en denormalisatie als aanpak voor ons databaseontwerp:
Denk goed na over toegangspatronen, teamexpertise en operationele randvoorwaarden.
Trade-offs bij denormalisatie
Denormalisatie kan de performance verbeteren bij schrijfzware systemen die niet vaak veranderen. De keerzijde is extra complexiteit, een hogere onderhoudslast en risico op verouderde data.
Mijn twee cent: denormalisatie moet alleen een weloverwogen reactie zijn op leeszware knelpunten en moet altijd worden gebouwd met regelmatige consistentiecontroles.
Implementatie in verschillende databasesystemen
SQL- en NoSQL-systemen hebben iets verschillende benaderingen voor de implementatie van many-to-many-systemen.
Relationele en NoSQL-architecturen
Relationele databases zoals PostgreSQL, MySQL en SQL Server implementeren many-to-many-relaties expliciet met junctietabellen met vreemde sleutels en samengestelde primaire sleutels. Evenzo volgen cloudgebaseerde relationele databases zoals Snowflake een vergelijkbaar ontwerppatroon.
NoSQL-systemen representeren many-to-many-relaties vaak door arrays met gerelateerde ID’s in te bedden of verwijzingen op te slaan die door applicatielogica worden beheerd. Dit komt door de prioriteit van leesperformance en horizontale schaalbaarheid in NoSQL-databases. Dit verbetert de leesperformance en schemaflexibiliteit, maar gaat ten koste van normalisatie.
Kenmerk
Relationeel (SQL)
NoSQL
Implementatie
Junctietabellen: gebruikt een derde tabel met vreemde sleutels en samengestelde primaire sleutels.
Embedding of refereren: gebruikt arrays met ID’s of geneste documenten.
Primair doel
Normalisatie: zorgt voor dataconsistentie en elimineert redundantie.
Performance: geeft prioriteit aan leessnelheid en horizontale schaalbaarheid.
Flexibiliteit
Rigide schema: vereist vooraf gedefinieerde structuren en joins om data op te halen.
Hoge flexibiliteit: staat schemaloze ontwerpen en uiteenlopende datatypen toe.
Trade-off
Complexe joins: kunnen trager worden naarmate de dataset sterk groeit.
Levert normalisatie in: kan leiden tot dataduplicatie of “stale” data.
Voorbeelden
PostgreSQL, MySQL, SQL Server, Snowflake.
MongoDB, DynamoDB, Cassandra.
SQL versus NoSQL
Relationele databases hebben de voorkeur wanneer je een goed gedefinieerde schemastructuur nodig hebt. Deze databases zijn eenvoudiger te manipuleren en maken beter databeheer mogelijk. Overweeg je te focussen op een relationele SQL-database wanneer:
NoSQL-databases zijn geschikt wanneer flexibiliteit en bulkbewerkingen prioriteit hebben. Zo staan NoSQL-databases zoals MongoDB operators toe zoals
updateManywanneer we updates over een veelheid aan documenten moeten uitvoeren. Enkele leidende principes voor wanneer je een NoSQL-implementatie zou overwegen:Conclusie
Many-to-many-relaties zijn onvermijdelijk in realistische datamodellen. Ze correct ontwerpen is cruciaal voor dataintegriteit, schaalbaarheid en analytische juistheid. Junctietabellen vormen, mits goed genormaliseerd en geïndexeerd, een robuuste basis die schaalt van transactionele systemen tot enterprise-analytics.
Elk ontwerp kent trade-offs: normalisatie versus performance, eenvoud versus flexibiliteit en abstractie versus controle. De sleutel is je toegangspatronen profileren, patronen kiezen die bij je workload passen en ontwerpen valideren via schemareviews en querytests.
Voor professionals die hun vaardigheden in databaseontwerp willen verdiepen, raad ik sterk aan je in te schrijven voor onze Associate Data Analyst in SQL-carrièreroute.