Kursus
Pengembangan Kode dengan Bantuan AI untuk Developer
1 jam 30 menit
10.7K
Di hari yang sama dengan peluncuran GLM-5.3 Flash, tim Qwen dari Alibaba membuka bobot Qwen3.8-Flash-Next, sebuah model mixture-of-experts (MoE) multimodal yang sekaligus menjadi pratinjau awal arsitektur di balik keluarga Qwen4 yang akan datang.
Ini mencerminkan apa yang dilakukan Qwen3-Next untuk Qwen3.5: merilis perubahan arsitektur sebelum lini model lengkap agar komunitas dapat mengupasnya terlebih dahulu.
Cerita besarnya di sini adalah biaya. Berkat arsitektur baru yang sangat efisien, Qwen3.8-Flash-Next memerlukan kira-kira sepersembilan biaya pelatihan pendahulunya, Qwen3.7-Plus. Namun, ia tidak mengorbankan kemampuan; bahkan mengungguli jagoan seperti Claude Opus 4.6 Max pada uji pengkodean utama seperti SWE-bench.
Dalam artikel ini, saya akan membahas semua hal baru pada Qwen3.8-Flash-Next, meninjau arsitektur dan fiturnya, serta mengeksplorasi tolok ukurnya. Untuk pembahasan mendalam tentang cara mengunduh dan menjalankan model secara lokal, baca tutorial Qwen3.8-Flash-Next kami. Jika Anda ingin konteks tentang model Tiongkok lainnya, lihat panduan kami untuk Qwen3.8-Max dan tutorial kami tentang menjalankan DeepSeek-V4-Flash-0731 secara lokal. Saya juga menyarankan Anda melihat rilis baru Qwen3.8-Omni-Flash.
Qwen3.8-Flash-Next adalah model MoE multimodal dari tim Qwen milik Alibaba, dirilis 26 Agustus 2026, diposisikan sebagai kuda kerja yang hemat biaya alih-alih andalan kelas atas.
Model ini berada di bawah kelas Max dalam hal kecerdasan, tetapi mengalahkan hampir semua kompetitor dalam hal harga—itulah inti dari lini "Flash".
Model ini secara native mendukung jendela konteks 262.144 token, dapat diperluas hingga 1.000.000 token dengan YaRN (metode [Yet another RoPE extensioN], sebuah teknik pengkodean posisi yang memperluas jendela konteks model, memungkinkan menangani input teks besar sambil mempertahankan performa aslinya).
Model ini menangani teks, gambar, dan video melalui satu API, yang menjadi salah satu alasan pengulas menyebutnya "primadona komunitas semalam" dalam rangkuman rilis Agustus 2026.
Yang membuat rilis ini penting bagi praktisi adalah rasio tolok ukur per dolar.
Qwen3.8-Flash-Next mengungguli saudara 27B-nya pada setiap tolok ukur yang dipublikasikan, dan melampaui Claude Opus 4.6 Max pada sebagian besar evaluasi pengkodean dan agen yang praktis, sambil hanya mengaktifkan 6B parameter per token. Ini adalah pratinjau arsitektur Qwen4, jadi pilihan desain di sini memberi sinyal ke mana arah Alibaba berikutnya.
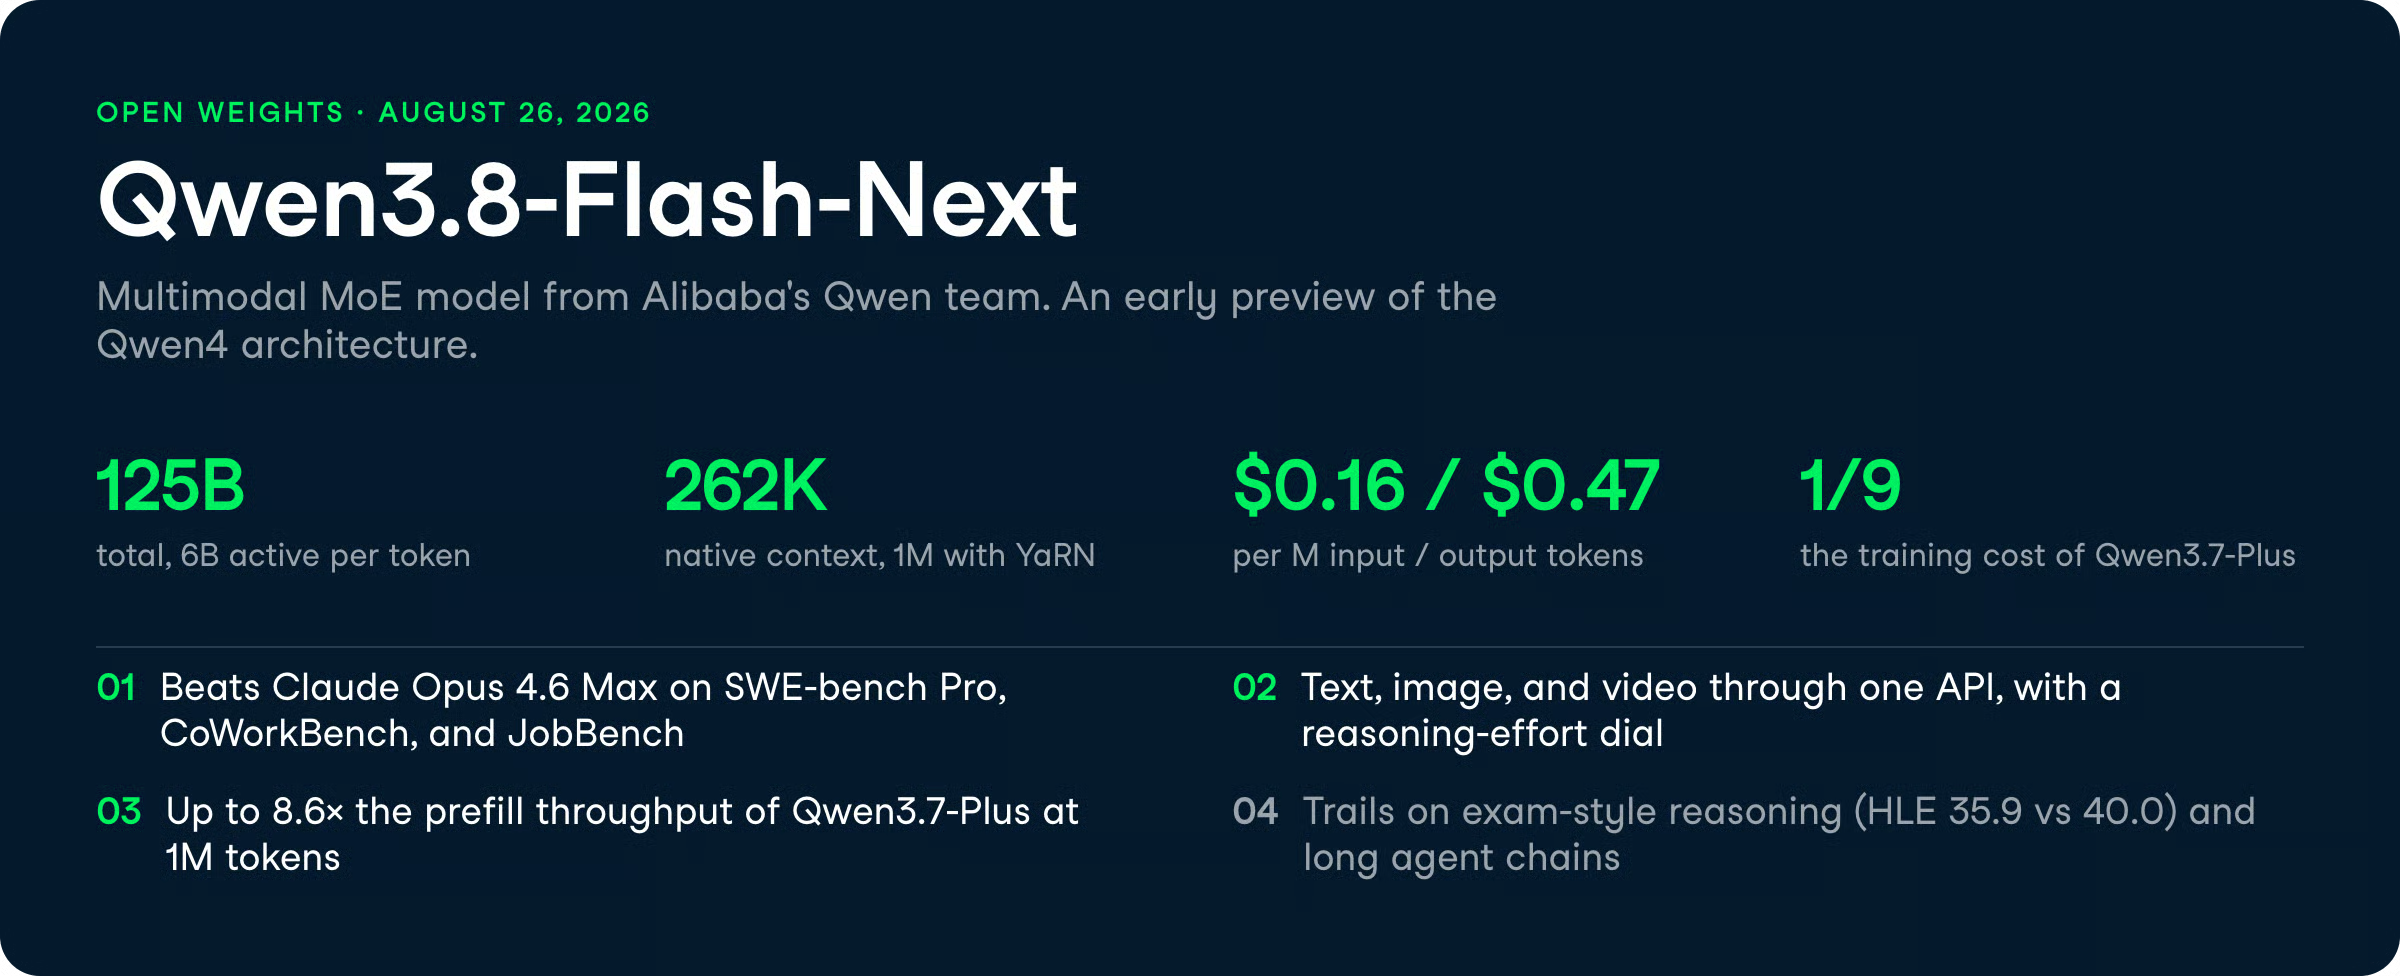
Qwen3.8-Flash-Next meningkatkan model pada empat sumbu: attention, residual, embedding, dan optimisasi.
Di bawah ini, saya uraikan apa manfaat masing-masing perubahan bagi Anda sebagai pengguna, bukan sekadar apa itu.
Keuntungan praktis terbesar adalah kecepatan pada input yang panjang.
Qwen3.8-Flash-Next menggunakan desain attention hibrida, di mana sebagian besar riwayat konteks dikompresi untuk menghemat ruang, dan menggunakan alat "Sparse Attention" terarah untuk mengambil hanya detail yang paling relevan saat dibutuhkan.
Peningkatan kecepatan pada 1 juta token sangat besar: hingga 7,6x pemrosesan prompt (prefill) lebih cepat dan 4,9x generasi (decode) lebih cepat. Dalam penyiapan penyajian tipikal dengan prefiks yang di-cache, throughput keseluruhan melonjak 8,6x dibanding Qwen3.7-Plus.
Bagi siapa pun yang menjalankan pengambilan data ber-volume tinggi atau agen pengkodean skala repositori, perbedaan throughput tersebut adalah fiturnya.
Anda membayar komputasi, dan desain ini memangkas tagihan tepat pada urutan panjang yang dulu terkenal mahal.
Qwen menggunakan trik cerdas bernama N-gram Embedding untuk menambahkan 51 miliar parameter secara praktis gratis. Alih-alih hanya melihat satu token pada satu waktu, model melihat token saat ini plus tetangga terdekatnya, memberi model "memori pola lokal" yang besar.
Karena model tahu apa yang perlu diakses sejak awal, tambahan 51B parameter ini berada di memori sistem standar (RAM), bukan di GPU. Parameter tersebut diambil secara otomatis di balik layar, artinya tidak pernah secara permanen memakan memori GPU atau memperlambat komputasi per token.
Anda mendapatkan kecerdasan model yang jauh lebih besar tanpa membayar pajak VRAM yang biasa.
Qwen3.8-Flash-Next menangani teks, gambar, dan video melalui satu antarmuka, dan kemampuan visinya jauh melampaui kelas biayanya.
Model ini dengan nyaman mengungguli Claude Opus 4.6 Max pada uji penggunaan ponsel (84,5 vs 62,0 pada AndroidWorld) dan pemahaman visual dunia nyata (88,5 vs 73,9 pada RealWorldQA).
Model ini juga unggul pada matematika visual, mencetak hingga 95,7 pada MathVision (jauh di depan skor Opus 65,5).
Jika alur kerja Anda melibatkan penguraian tangkapan layar, bagan, atau UI aplikasi, Qwen menawarkan keunggulan nyata dibanding Claude pada titik harga ini.
API menyediakan kenop reasoning effort dengan tiga pengaturan (tinggi, sedang, dan rendah), memungkinkan Anda menukar pemikiran mendalam dengan latensi lebih rendah dan permintaan yang lebih murah.
Model ini juga dibekali modul prediksi multi-token, yang pada dasarnya berarti memprediksi beberapa langkah ke depan untuk mempercepat generasi dalam beban kerja dunia nyata.
Implikasi praktisnya adalah kontrol.
Anda dapat menurunkan penalaran untuk trafik ber-volume tinggi yang sensitif terhadap biaya, dan meningkatkannya untuk tugas agen yang kompleks, semuanya menggunakan ID model yang sama.
Di seluruh angka yang dipublikasikan, Qwen3.8-Flash-Next unggul pada sebagian besar tolok ukur pengkodean dan kerja agen, sementara tertinggal pada beberapa evaluasi penalaran bergaya ujian.
Model ini mengalahkan saudara 27B-nya di semua area, dengan kesenjangan terbesar pada pekerjaan agen.
Semua perbandingan di bawah berasal dari tabel rilis Qwen kecuali dinyatakan lain.
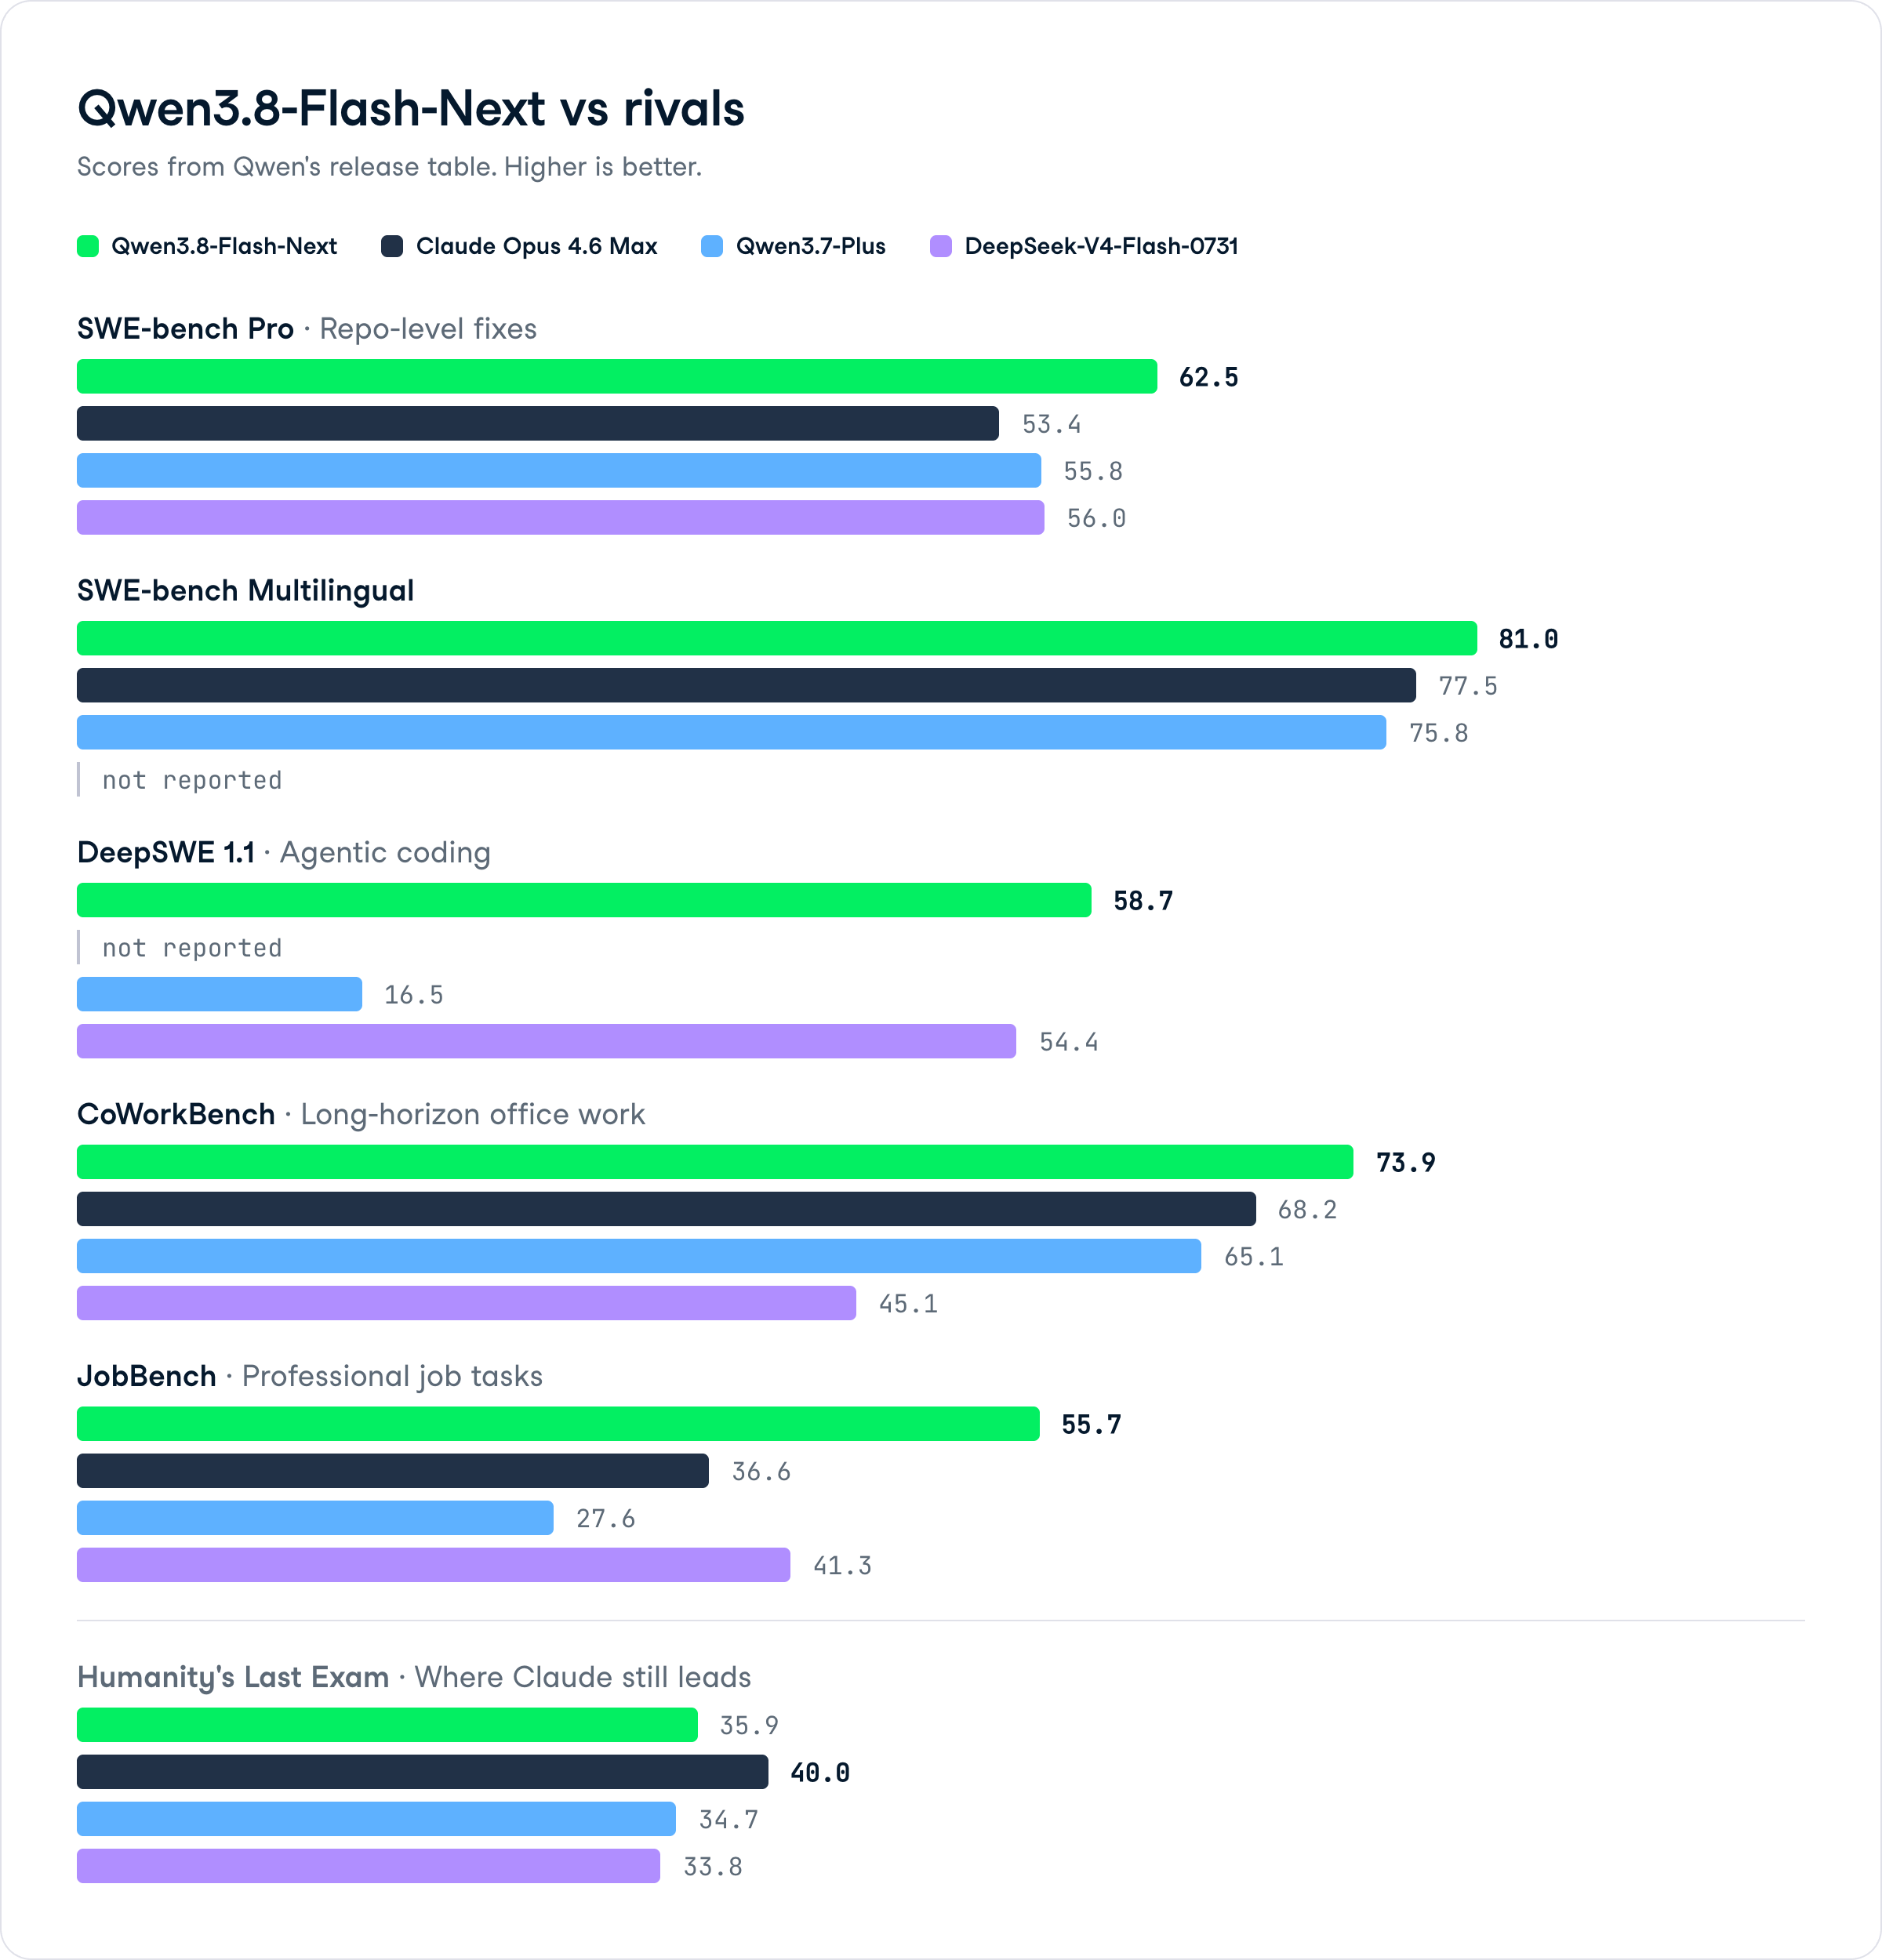
SWE-bench Pro mengukur perbaikan perangkat lunak tingkat repositori yang nyata, dan Qwen3.8-Flash-Next mencetak 62,5, di depan skor 53,4 milik Claude Opus 4.6 Max dan 55,8 milik Qwen3.7-Plus.
Pada SWE-bench Multilingual, yang menguji perbaikan lintas bahasa, model ini mencapai 81,0 dibanding 77,5 milik Opus 4.6 Max.
Inilah angka-angka yang mengangkat rilis ini.
Fakta bahwa model 6B-aktif dapat mengalahkan Claude kelas Max pada rekayasa tingkat repositori adalah alasan ia menarik begitu banyak perhatian.
DeepSWE 1.1 mengevaluasi pengkodean agen melalui harness seperti Claude Code dan mini-SWE-agent, dan Qwen3.8-Flash-Next mencetak 58,7 dibanding 42,2 milik saudara 27B-nya dan 16,5 milik Qwen3.7-Plus.
DeepSeek-V4-Flash-0731 berada di 54,4 pada metrik ini.
Saat kami menjalankan DeepSeek-V4-Flash-0731 sebagai agen pengkodean dalam tutorial kami, model tersebut membangun situs analitik saham lengkap dari satu prompt dalam sekitar 20 menit, menghasilkan percakapan sekitar 33 token per detik.
Kesenjangan DeepSWE antara kedua model menyiratkan bahwa Qwen3.8-Flash-Next seharusnya tampil baik dalam loop pengkodean agen serupa.
Di sisi agen, model ini mencatat angka kuat di beberapa evaluasi:
Kesenjangan pada JobBench paling mencolok.
Pada tugas alur kerja profesional, Qwen3.8-Flash-Next mencetak hampir 20 poin di atas Claude kelas Max—hasil seperti ini layak diuji untuk otomasi tingkat perusahaan.
Pada penalaran umum, Qwen3.8-Flash-Next mencapai 91,7 pada GPQA Diamond (penalaran ilmiah), sedikit di atas 91,3 milik Claude Opus 4.6 Max, dan 91,9 pada LiveCodeBench v6 (pengkodean kompetitif) dibanding 88,8 milik Opus 4.6 Max.
Namun, tidak menang di semua tempat.
Pada Humanity's Last Exam (HLE), yang menguji penalaran multidisipliner, model ini mencetak 35,9 dibanding 40,0 milik Claude Opus 4.6 Max. Pada Agents' Last Exam Pass@1, DeepSeek-V4-Flash-0731 unggul tipis 25,2 melawan 24,3.
Pola ini konsisten pada pelacak independen: Qwen3.8-Flash-Next unggul pada pengkodean praktis dan kerja agen, sementara Claude tetap unggul pada beberapa tolok ukur penalaran bergaya ujian.
Qwen3.8-Flash-Next-Base menang pada 8 dari 14 tolok ukur pra-pelatihan melawan model dasar Qwen3.8-27B dan Qwen3.7-Plus yang jauh lebih besar.
Model ini unggul pada MMLU-Pro (73,23), SuperGPQA (51,36), BBH (90,87), GSM8K (93,29), EvalPlus (78,76), SWEBench-Pretrain (50,99), MGSM (89,33), dan MMMLU (84,86).
Yang menarik, model ini melakukannya dengan 6B parameter aktif dibanding 17B aktif dan total 397B pada Qwen3.7-Plus, dan tetap dalam selisih satu poin pada MMLU, MMLU-Redux, GPQA, MATH, dan MultiPL-E.
Parameter embedding N-gram 51B dialamatkan secara deterministik dan tidak pernah masuk ke anggaran matmul per token, jadi ini adalah efisiensi nyata, bukan trik menghitung parameter.
Berikut perbandingan model ini dengan Claude Opus 4.6 Max, pendahulunya Qwen3.7-Plus, dan DeepSeek-V4-Flash-0731 pada evaluasi utama.
| Tolok Ukur | Qwen3.8-Flash-Next | Claude Opus 4.6 Max | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 53.4 | 55.8 | 56.0 |
| SWE-bench Multilingual | 81.0 | 77.5 | 75.8 | -- |
| DeepSWE 1.1 | 58.7 | -- | 16.5 | 54.4 |
| CoWorkBench | 73.9 | 68.2 | 65.1 | 45.1 |
| JobBench | 55.7 | 36.6 | 27.6 | 41.3 |
| GPQA Diamond | 91.7 | 91.3 | 90.3 | 90.8 |
| LiveCodeBench v6 | 91.9 | 88.8 | 89.6 | 90.6 |
| HLE | 35.9 | 40.0 | 34.7 | 33.8 |
Bobot Qwen3.8-Flash-Next tersedia sekarang sebagai model berbobot terbuka di Hugging Face dan ModelScope.
Versi produksi, dengan konteks 1M secara default dan alat bawaan, disajikan sebagai Qwen3.8-Flash di QwenCloud dengan ID model qwen3.8-flash.
Penetapan harga adalah area kompetitif utama model ini:
Sebagai perbandingan, liputan Qwen3.8-Max kami mencantumkan model tersebut di $2,00 untuk input dan $6,00 untuk output per sejuta token, jadi Flash-Next mengalahkan saudara Max-nya sendiri lebih dari 10x pada biaya input.
QwenCloud mendukung API Chat Completions dan Responses yang kompatibel dengan OpenAI serta antarmuka yang kompatibel dengan Anthropic, sehingga dapat digunakan pada Claude Code, Codex, dan Qwen Code dengan perubahan konfigurasi minimal.
Perlu dicatat bahwa saat pengumuman, API tercantum sebagai segera hadir, jadi periksa QwenCloud untuk ketersediaan terbaru.
GLM-5.3-Flash adalah model hemat biaya lainnya yang diluncurkan pada hari yang sama, dan merupakan pesaing paling langsung yang layak dibandingkan berdampingan.
| Qwen3.8-Flash-Next | GLM-5.3-Flash | |
|---|---|---|
| Arsitektur | 125B total / 6B aktif | 320B total / 18B aktif |
| Konteks native | 262K (1M dengan YaRN) | 1M token |
| DeepSWE v1.1 | 58.7 | 63.4 |
| SWE-bench Pro | 62.5 | Tidak dipublikasikan |
| Harga input | $0,16/1M | ~$0,075/1M (promo) |
| Multimodal | Ya | Ya |
GLM-5.3-Flash unggul pada DeepSWE v1.1 (63,4 vs 58,7) dan mencetak 84,3 pada Terminal-Bench 2.1, sebuah tolok ukur yang tidak dipublikasikan angkanya oleh Qwen.
Model ini juga memiliki harga input lebih rendah selama masa promosi dan jendela konteks 1M token secara native, tanpa perlu YaRN.
Qwen3.8-Flash-Next unggul pada SWE-bench Pro (62,5), CoWorkBench (73,9), dan JobBench (55,7), di mana GLM tidak mempublikasikan angka setara. Qwen juga mengaktifkan parameter per token yang jauh lebih sedikit (6B vs 18B), membuatnya jauh lebih murah untuk self-host dan lebih cepat disajikan dalam skala besar.
Singkatnya, GLM memiliki angka yang lebih kuat pada tolok ukur yang sama-sama mereka publikasikan. Qwen memimpin pada evaluasi alur kerja perkantoran dan profesional, serta merupakan pilihan yang lebih baik jika Anda menjalankan infrastruktur sendiri. Untuk pembahasan lengkap GLM-5.3-Flash, lihat panduan penuh kami.
Qwen3.8-Flash-Next adalah pernyataan jelas dari Alibaba bahwa efisiensi biaya adalah medan pertempuran.
Mengalahkan Claude Opus 4.6 Max pada SWE-bench Pro, CoWorkBench, dan JobBench dengan 6B parameter aktif, pada $0,16 per sejuta token input, adalah tawaran serius bagi siapa pun yang menjalankan beban kerja pengkodean atau agen ber-volume tinggi.
Saya akan memperlakukannya sebagai default kuat untuk pipeline berbasis alat dan berat pengkodean, dengan dua catatan.
Laporan komunitas menandai ketidakstabilan sesekali pada rantai agen yang sangat panjang dan kerapuhan ketika alat mengembalikan JSON non-standar, serta model ini kurang konservatif pada aspek keamanan dibanding seri Claude, jadi diperlukan prompt yang hati-hati untuk konten batas.
Hasil HLE dan Agents' Last Exam juga menunjukkan bahwa ini bukan model yang tepat untuk penalaran bergaya ujian yang paling sulit.
Sebagai pratinjau awal arsitektur Qwen4, desain hibrida GDN + QSA dan N-gram Embedding patut diperhatikan, karena inilah fondasi keluarga Qwen4 penuh nantinya.
Jika Alibaba dapat mempertahankan rasio tolok ukur per dolar ini pada tingkat flagship, percakapan harga di garis depan akan berubah.
Jika Anda ingin membangun alur kerja agen dan pengkodean di sekitar model seperti ini, saya menyarankan untuk memulai dengan AI Agent Fundamentals skill track kami untuk mengejar konsep dasarnya.
Kursus Teratas DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt