
Last chance! 50% off DataCamp Premium
Sale ends in
Persaingan model frontier di akhir 2026 sebagian besar berubah menjadi perlombaan harga, bukan kemampuan mentah. Hanya pada bulan September, kita sudah melihat GPT-6 Astra dari OpenAI dan Claude Fable 5.1 dari Anthropic sama-sama berada di kisaran $10 per 1M token input dan $50 per 1M token output, dan keduanya tidak tersedia pada paket gratis.
Jawaban DeepSeek adalah mengambil arah yang sama sekali berbeda.
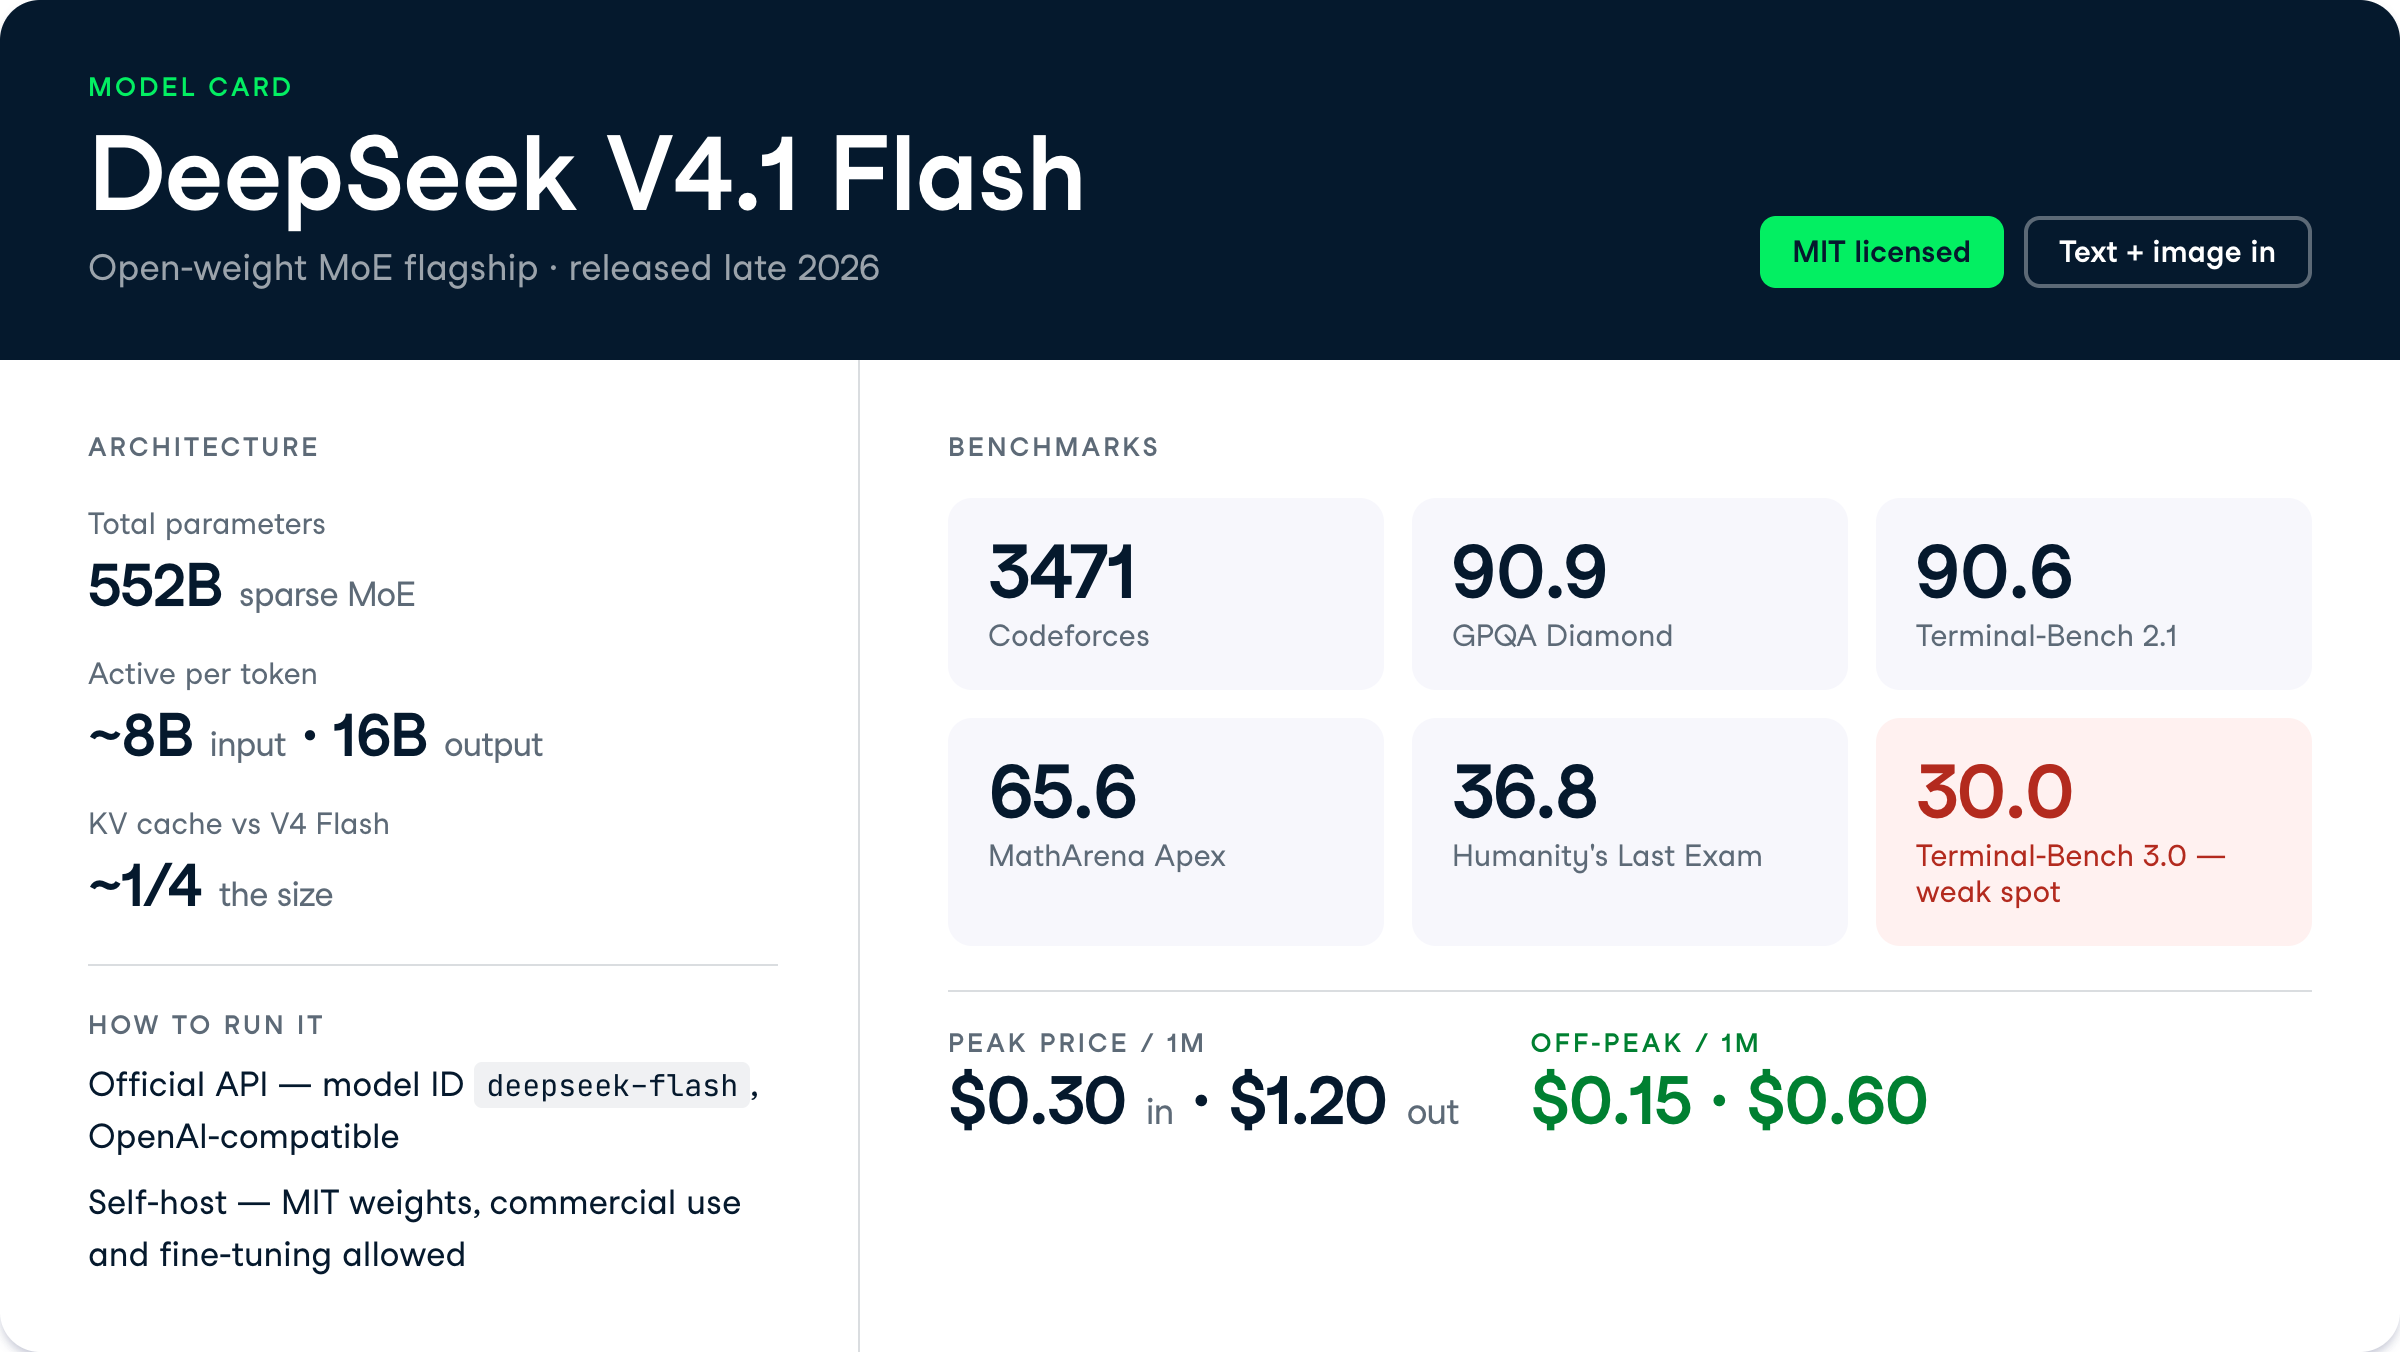
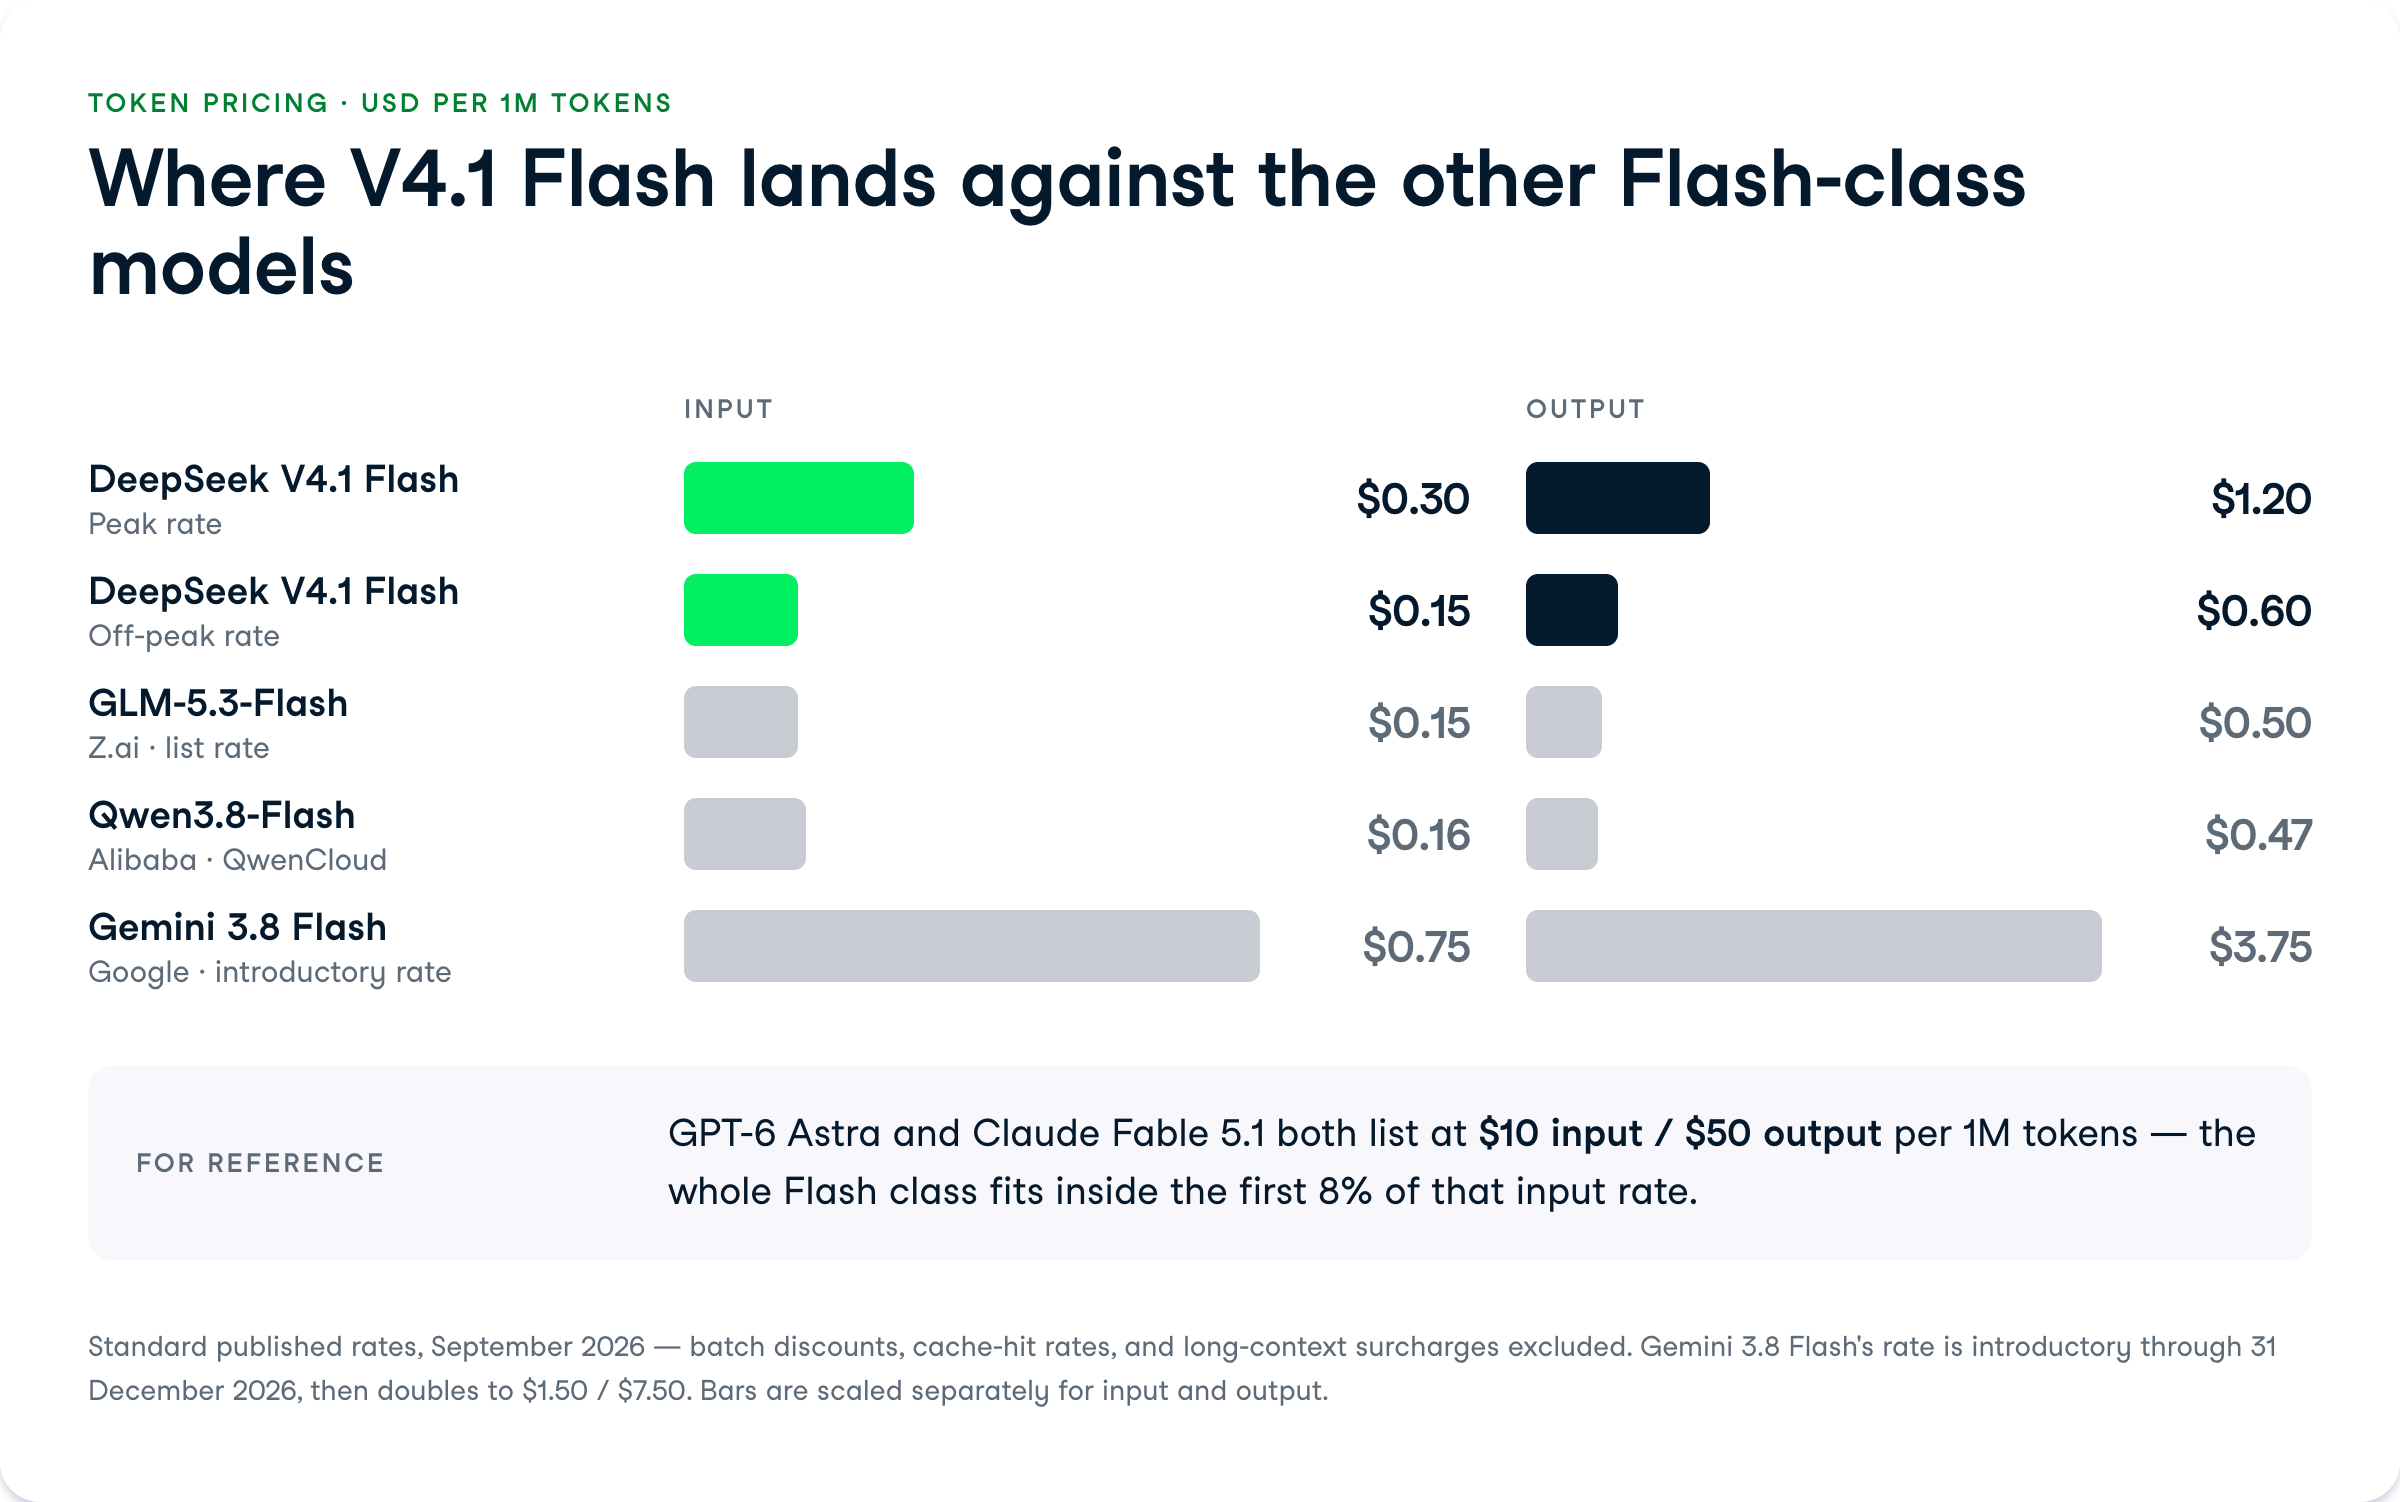
DeepSeek V4.1 Flash adalah model mixture-of-experts dengan 552 miliar parameter yang mengaktifkan sekitar 8 miliar parameter untuk input dan 16 miliar untuk output, dilengkapi bobot terbuka berlisensi MIT, dan berharga $0,30/$1,20 per 1M token pada jam sibuk, turun menjadi $0,15/$0,60 di luar jam sibuk, mengalahkan model Flash serupa lainnya seperti Gemini 3.8 Flash dan GLM-5.3-Flash.
Dalam artikel ini, saya akan membahas semua hal baru pada DeepSeek V4.1 Flash, melihat fitur-fiturnya, dan mengulas tolok ukurnya. Jika Anda ingin melihat model ini beraksi, baca tutorial API DeepSeek V4.1 kami.
Untuk mempelajari lebih lanjut tentang keluarga DeepSeek, lihat panduan kami tentang menjalankan DeepSeek-V4-Flash-0731 dengan Unsloth Studio dan OpenCode, serta perbandingan DeepSeek v4.1 Flash vs Gemini 3.8 Flash.
DeepSeek V4.1 Flash adalah model terbaru dalam lini Flash DeepSeek, diposisikan sebagai tier efisien dan ber-throughput tinggi, bukan kelas berat untuk riset.
Ini adalah arsitektur mixture-of-experts (MoE) jarang (sparse) dengan total 552 miliar parameter, di mana hanya sekitar 8 miliar yang aktif per token saat input dan 16 miliar saat output. Aktivasi jarang itulah yang menjaga biaya penyajian tetap rendah sambil tetap meraih skor setara frontier pada sejumlah tolok ukur.
Perubahan utama dibanding generasi sebelumnya adalah efisiensi.
DeepSeek mengecilkan KV cache menjadi sekitar seperempat ukuran V4 Flash sebelumnya, yang mengurangi jejak memori dan memungkinkan model melayani konteks lebih panjang dengan biaya lebih murah. Perusahaan juga menyatakan bahwa V4.1 Flash melampaui V4 Pro 0813 lama dalam hal kinerja, biaya, kecepatan, dan total waktu, sehingga V4 Pro dihentikan secara bertahap.
Di sisi tolok ukur, angka yang menonjol adalah Terminal-Bench 2.1 sebesar 90,6. Saat kami menguji DeepSeek-V4-Flash-0731 sebelumnya, model itu mendapat 82,7 pada tolok ukur yang sama, sehingga V4.1 Flash benar-benar naik kelas dalam kerja terminal agentik di keluarga yang sama.
Fitur V4.1 Flash dibangun di atas dua ide: biaya rendah, dan tetap terbuka. Berikut kemampuan yang paling relevan bagi data scientist atau ML engineer.
V4.1 Flash dilengkapi bobot berlisensi MIT, lisensi umum paling permisif yang mengizinkan penggunaan komersial, redistribusi, dan fine-tuning tanpa ambang pendapatan.
Bagi tim dengan kendala privasi data, ini berarti Anda bisa menjalankan model sepenuhnya di perangkat keras sendiri alih-alih mengirim permintaan ke API DeepSeek.
Konsekuensinya, lisensi MIT mengalihkan tanggung jawab keamanan, fine-tuning, dan optimasi inferensi kepada Anda.
Saat kami menjalankan V4-Flash-0731 sebelumnya secara lokal, model ini membutuhkan tiga GPU NVIDIA A100 80GB pada kuantisasi Q8, jadi self-host hanya masuk akal bila Anda memiliki memori GPU yang memadai.
V4.1 Flash menerima gambar langsung sebagai input, tanpa adaptor visi atau langkah prapemrosesan terpisah. Ini memungkinkan Anda memasukkan tangkapan layar, bagan, atau pemindaian dokumen ke permintaan yang sama bersama teks, yang berguna untuk pipeline berbasis dokumen dan alur kerja agen UI.
Input multimodal native pada tingkat harga ini tidak lazim. Pada evaluasi ZeroBench-main dengan tools, V4.1 Flash mencetak 49,0, yang memberi gambaran kasar tentang kemampuannya melakukan penalaran atas input visual.
KV cache di V4.1 Flash sekitar seperempat ukuran V4 Flash sebelumnya, yang menurunkan biaya memori untuk menahan konteks panjang dalam sesi penyajian.
Bagi siapa pun yang menjalankan inferensi selalu aktif, KV cache yang lebih kecil berarti lebih banyak sesi simultan per GPU atau overhead memori per permintaan yang lebih rendah.
Digabungkan dengan harga input cache-hit sebesar $0,006 per 1M token pada jam sibuk, ini membuat penggunaan ulang konteks menjadi sangat murah. Jika Anda berulang kali mengirim sistem prompt atau dokumen yang sama antar permintaan, bagian yang di-cache nyaris tidak berbiaya.
DeepSeek menjalankan skema harga dua tingkat, di mana harga di luar jam sibuk ditetapkan setengah dari harga jam sibuk, dengan tujuan mendorong beban kerja batch dan terjadwal masuk ke jendela di luar jam sibuk. Itu mengubah $0,30/$1,20 menjadi $0,15/$0,60 per 1M token jika Anda bisa menjadwalkan job.
Peringatannya bersifat operasional. Beban kerja selalu aktif menjadi lebih sulit diprediksi biayanya, dan untuk mendapatkan diskon Anda perlu logika penjadwalan job yang harus Anda bangun dan pelihara sendiri.
Penampilan terkuat V4.1 Flash ada pada tolok ukur agentik dan penalaran, di mana model ini meraih skor setara frontier dengan biaya token yang jauh lebih rendah.
Skornya turun tajam pada evaluasi agentik tersulit, hal yang perlu diketahui sebelum Anda mengarahkannya ke tugas berjangka panjang.
V4.1 Flash mencetak 90,6 pada Terminal-Bench 2.1, yang mengukur seberapa baik model menyelesaikan tugas multi-langkah di lingkungan terminal.
Sebagai pembanding, DeepSeek-V4-Flash-0731 mencetak 82,7 pada tolok ukur yang sama dalam pengujian kami, dan GPT-5.6 Terra mencapai 87,4 dalam perbandingan Terra vs. Sonnet 5 kami.
Gambarnya berubah pada evaluasi agentik yang lebih sulit.
V4.1 Flash turun ke 30,0 pada Terminal-Bench 3.0, jadi model ini menangani tugas terminal standar dengan baik tetapi kesulitan pada suite agentik yang lebih menuntut. Peringkat Codeforces 3471 menandakan kemampuan competitive programming yang kuat.
Pada GPQA Diamond, sekumpulan pertanyaan sains tingkat pascasarjana yang dirancang sulit dijawab hanya dari ingatan, V4.1 Flash mencetak 90,9.
Itu adalah hasil kuat untuk model di kelas harga ini dan menempatkannya setara dengan model frontier yang jauh lebih mahal.
Pada Humanity's Last Exam (HLE), tolok ukur tingkat pakar yang sengaja brutal, V4.1 Flash mencetak 36,8, atau 39,1 dengan konfigurasi bertanda bintang.
Sebagai perbandingan, evaluasi sains agentik seperti Terminal-Bench-Science 0.1 menunjukkan Claude Fable 5.1 di 52,6% melawan pesaing yang lebih tangguh, jadi V4.1 Flash tidak memuncaki evaluasi pakar tersulit, tetapi juga tidak malu-malu.
V4.1 Flash mencetak 65,6 pada MathArena Apex, tolok ukur matematika kompetisi yang menghargai penalaran simbolik multi-langkah.
Ini salah satu hasil terkuat model dan menunjukkan bahwa ini adalah pilihan masuk akal untuk beban kerja kuantitatif dan sarat matematika.
Skor di kisaran pertengahan 60-an di sini penting bagi siapa pun yang membangun alat yang membutuhkan penalaran aritmetika dan aljabar yang andal, karena banyak model yang lebih murah justru runtuh pada tugas-tugas ini.
Keputusan di sini kurang tentang varian model dan lebih tentang bagaimana Anda menerapkan V4.1 Flash, karena bobot yang sama berjalan dalam tiga cara. Pilihan Anda bergantung pada prediktabilitas biaya, privasi data, dan apakah Anda bisa menjadwalkan job.
DeepSeek juga menjalankan masa migrasi. Mulai pukul 12:00 Waktu Beijing pada 14 September 2026 hingga rilis V4.1 Pro di masa mendatang, permintaan ke endpoint lama dialihkan, yang mendorong pengguna yang ada ke keluarga V4.1. Jika Anda masih menggunakan V4 Pro 0813, model itu sedang dihentikan, jadi rencanakan perpindahan ke V4.1 Flash sekarang.
| Kasus penggunaan | Rekomendasi | Alasan |
|---|---|---|
| Agen coding berkapasitas tinggi dan selalu aktif | API resmi, harga puncak | $0,30/$1,20 per 1M sudah jauh di bawah pesaing frontier; tanpa overhead penjadwalan |
| Job penalaran atau matematika dalam batch besar | API resmi, di luar puncak | Di luar puncak memangkas tarif menjadi $0,15/$0,60 per 1M jika Anda bisa menjadwalkan run |
| Data sensitif atau proprietary | Self-host bobot MIT | Inferensi tetap di perangkat keras Anda sendiri; memerlukan memori GPU yang memadai |
| Penggunaan ulang konteks berat | API dengan prompt caching | Input cache-hit sebesar $0,006 per 1M membuat konteks berulang nyaris gratis |
V4.1 Flash adalah salah satu model andal termurah yang tersedia, terutama di luar jam sibuk. Berikut rincian harga tokennya.
| Tarif | Puncak | Di luar puncak |
|---|---|---|
| Input per 1M token | $0,30 | $0,15 |
| Output per 1M token | $1,20 | $0,60 |
| Input cache-hit per 1M token | $0,006 | Tidak dipublikasikan |
Harga di luar jam sibuk ditetapkan setengah dari puncak, dan skema ini dirancang untuk mendorong beban kerja batch dan terjadwal masuk ke jendela di luar puncak.
Untuk konteks harga puncak, GPT-6 Astra dan Claude Fable 5.1 sama-sama mengenakan biaya $10 per 1M input dan $50 per 1M output, sehingga V4.1 Flash kira-kira 30x lebih murah pada input dan 40x lebih murah pada output saat puncak.
Model yang dihentikan, V4 Pro 0813, dihargai $0,435 per 1M input dan $0,87 per 1M output dengan konteks 1M token.
Karena DeepSeek mengklaim V4.1 Flash melampaui V4 Pro dalam hal kinerja, biaya, dan kecepatan, nyaris tidak ada alasan untuk tetap memakai model lama.
V4.1 Flash tersedia melalui API resmi DeepSeek, dan bobot berlisensi MIT-nya dipublikasikan untuk self-hosting.
Mulai 14 September 2026, permintaan ke endpoint lama dialihkan ke keluarga V4.1 hingga V4.1 Pro dirilis.
V4.1 Flash hadir sebagai model API dan rilis bobot terbuka, jadi ada dua cara untuk mengaksesnya.
Pada API, ID model umumnya tercantum sebagai deepseek-flash, dan endpoint-nya kompatibel dengan OpenAI, yang berarti sebagian besar kode klien OpenAI yang ada bekerja dengan mengganti base URL.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_KEY",
    base_url="https://api.deepseek.com",
)
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices.message.content)
Untuk self-host, bobot berlisensi MIT memungkinkan penggunaan komersial, redistribusi, dan fine-tuning tanpa ambang pendapatan.
Saat kami menjalankan V4-Flash-0731 sebelumnya secara lokal dengan Unsloth Studio, model ini membutuhkan tiga GPU NVIDIA A100 80GB pada kuantisasi Q8, jadi siapkan perangkat keras serupa untuk pengaturan presisi penuh.
Untuk panduan lokal lengkap, lihat tutorial kami tentang menjalankan DeepSeek-V4-Flash dengan Unsloth Studio dan OpenCode, yang membahas distribusi GPU dan pengaturan inferensi secara rinci.
V4.1 Flash adalah pernyataan DeepSeek tentang harga dan keterbukaan, sementara model frontier lain merangkak menuju $10/$50 per 1M token dan membatasi akses di balik tier berbayar.
Model MoE 552B dengan bobot MIT, input gambar native, skor 90,9 pada GPQA Diamond, dan harga puncak 30x di bawah GPT-6 Astra adalah tawaran serius untuk beban kerja berkapasitas tinggi.
Saya akan beralih ke model ini untuk agen coding dan job penalaran batch, terutama jika Anda bisa menjadwalkan di luar puncak.
Kelemahannya muncul saat melihat skor 30,0 pada Terminal-Bench 3.0, yang menunjukkan ia goyah pada tugas agentik tersulit, dan penagihan puncak/di luar puncak menambah pekerjaan penjadwalan yang harus Anda tangani.
Jika Anda ingin membangun alur kerja agen di sekitar model seperti ini, jalur keterampilan AI Agent Fundamentals kami adalah tempat yang tepat untuk memulai.
Kursus DataCamp Teratas
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




