Kursus
Pengembangan Kode dengan Bantuan AI untuk Developer
1 jam 30 menit
10.7K
Z.ai telah merilis GLM-5.3-Flash, saudara kandung yang dioptimalkan biayanya dari model andalan GLM-5.3, yang awalnya hadir dengan nama sandi pratinjau anonim sebelum diumumkan ke publik sebagai "Ox Alpha." Qwen3.8-Flash-Next diluncurkan pada hari yang sama, jadi segmen LLM kelas hemat langsung ramai.
Jika Anda mengikuti persaingan antara lab Tiongkok open-weight dan frontier di Barat, rilis ini layak disimak.
Klaim utamanya sederhana: performa coding dan agen mendekati frontier dengan sebagian kecil biaya.
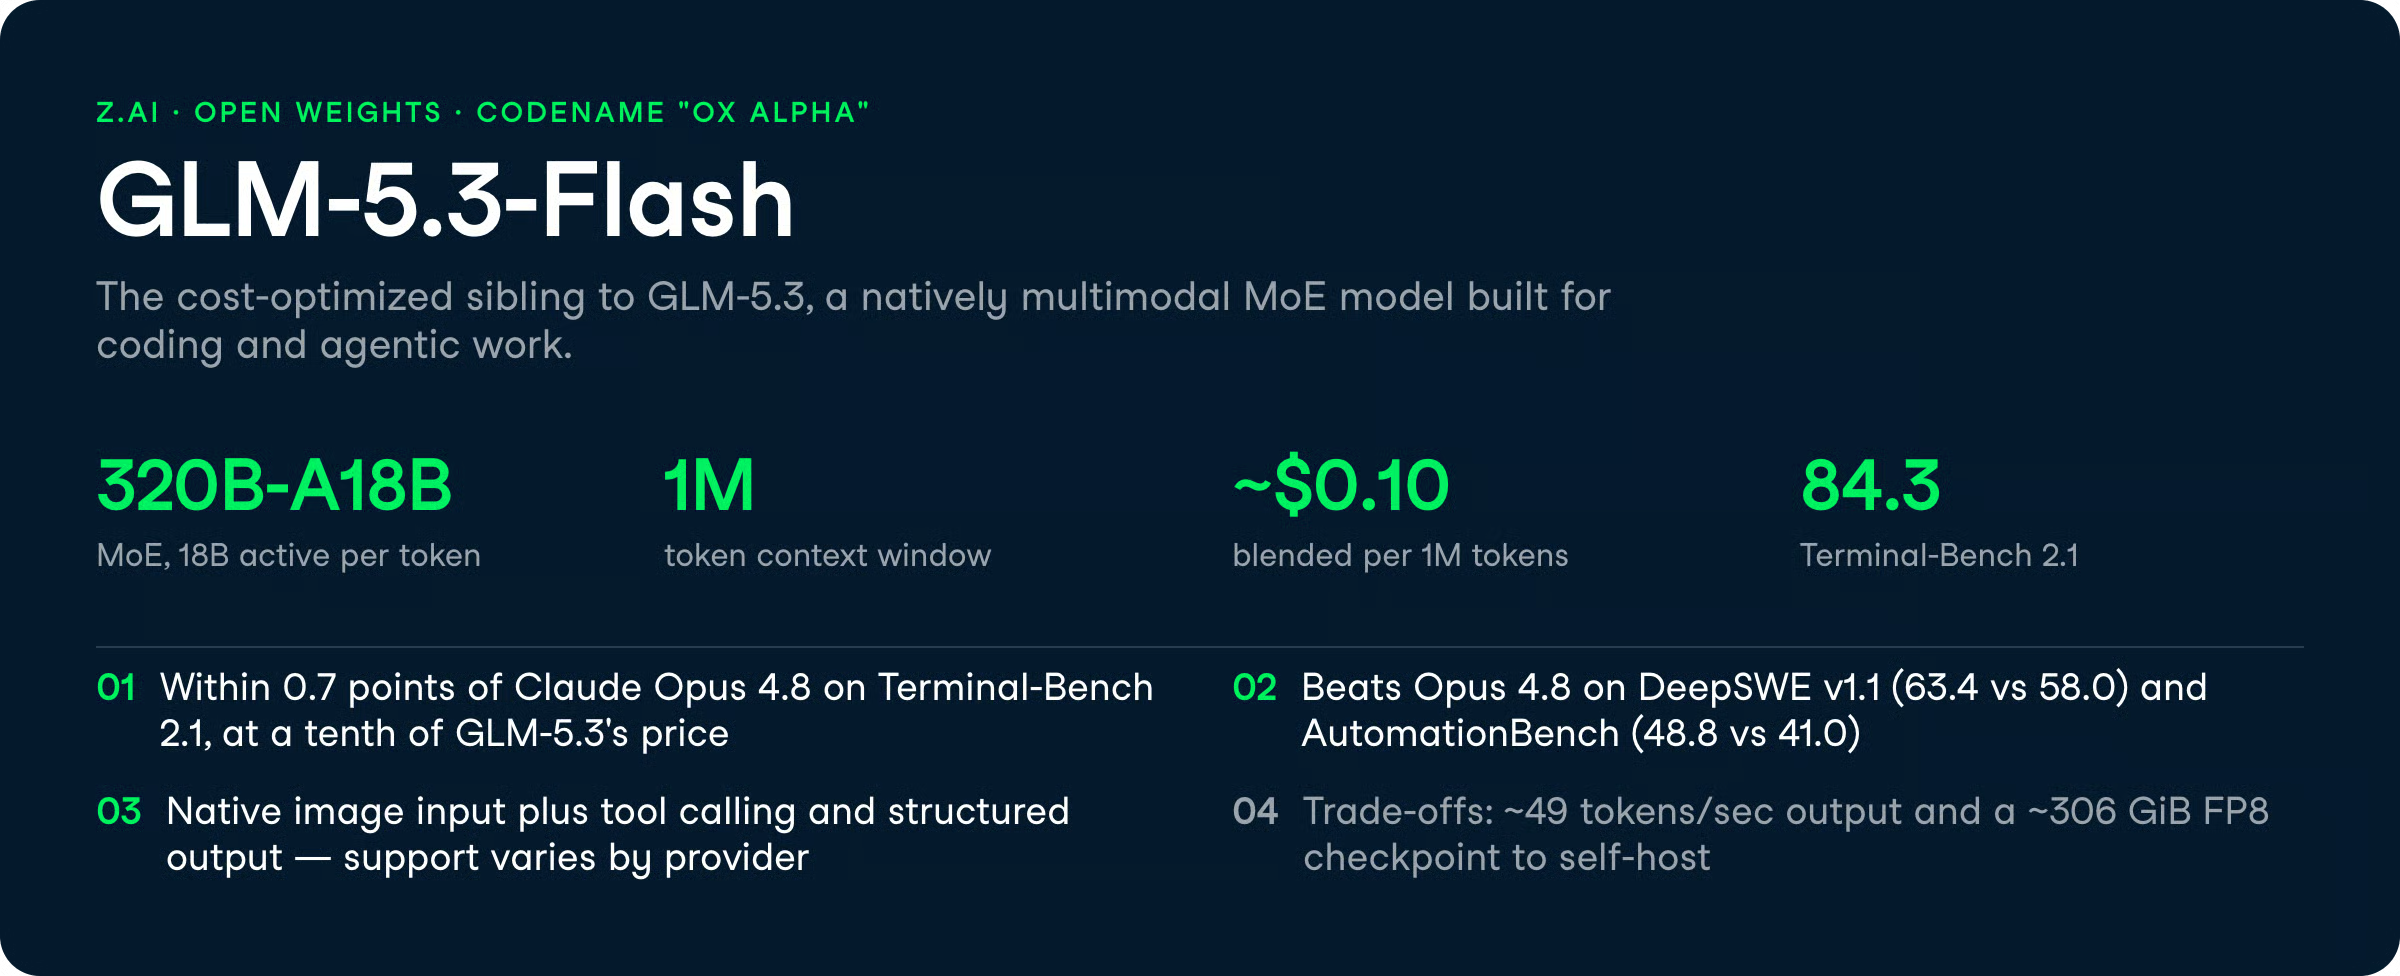
GLM-5.3-Flash meraih skor 84,3 pada Terminal-Bench 2.1, menempatkannya cukup dekat dengan Claude Opus 4.8 (85,0) dan GPT-5.6 Terra (87,4).
Model ini menggunakan desain mixture-of-experts dalam konfigurasi 320B-A18B (320B parameter agregat, 18B aktif per token), mendukung jendela konteks 1M token, dan bersifat multimodal secara native.
Dalam artikel ini, saya akan membahas semua hal baru pada GLM-5.3-Flash, menyoroti fitur dan menelusuri tolok ukurnya. Untuk melihat model ini beraksi, pastikan untuk membaca tutorial GLM-5.3-Flash kami, di mana kami menggunakannya bersama CrewAI untuk membuat tim analis keuangan multi-agen.
Jika Anda ingin membandingkannya dengan model kelas hemat lain yang dirilis di hari yang sama, lihat panduan kami tentang Qwen3.8-Flash-Next, dan untuk model MoE serupa yang kami jalankan secara lokal, lihat tutorial kami tentang menjalankan DeepSeek-V4-Flash-0731.
GLM-5.3-Flash adalah model Z.ai yang dioptimalkan biaya dalam keluarga GLM-5.3, berada di bawah GLM-5.3 andalan dari sisi kapabilitas tetapi jauh di bawah dari sisi harga.
Artificial Analysis menilainya pada indeks kecerdasan 57, dibandingkan 60 untuk GLM-5.3.
Pertukarannya adalah kecepatan dan biaya: Flash disajikan dengan harga sekitar sepersepuluh dari GLM-5.2, atau sekitar sepersembilan dari harga gabungan GLM-5.3, dan berjalan lebih lambat per token.
Model ini pertama kali dirilis sebagai pratinjau anonim sebelum diberi nama, dan komunitas dengan cepat melekatkan nama sandi "Ox Alpha" padanya.
Checkpoint publik tersedia sebagai zai-org/GLM-5.3-Flash di Hugging Face, dengan dukungan konteks panjang (~1M token) serta kemampuan pemanggilan alat dan multimodal yang diekspos melalui ekosistem di sekitarnya.
Tolok ukur yang paling penting di sini adalah Terminal-Bench 2.1, di mana GLM-5.3-Flash mencapai 84,3. Itu berada di atas 82,7 yang kami lihat untuk DeepSeek-V4-Flash-0731, dan hanya 0,7 poin di belakang Claude Opus 4.8. Untuk model dengan estimasi harga gabungan berbobot penggunaan sekitar $0,10 per 1M token, itulah inti cerita rilis ini.
GLM-5.3-Flash dibuat untuk developer yang menginginkan performa agen dan coding tanpa harga kelas andalan.
Berikut kapabilitas yang penting untuk pekerjaan praktis.
Anda dapat menjalankan agen coding dan alur kerja otomatisasi pada titik harga yang membuat penggunaan volume tinggi menjadi realistis.
GLM-5.3-Flash meraih skor 84,3 pada Terminal-Bench 2.1 dan 63,4 pada DeepSWE v1.1, naik tajam dari 46,2 milik GLM-5.2 pada evaluasi DeepSWE yang sama.
Bagi praktisi, daya tariknya adalah menjalankan tugas coding yang akan mahal pada model kelas Opus.
Beberapa perbandingan membingkai Flash sebagai "kuat" untuk coding dan agen otomatisasi dengan biaya yang jauh lebih rendah daripada GLM-5.3, dan lompatan DeepSWE atas GLM-5.2 menunjukkan peningkatan coding yang nyata alih-alih spesifik tolok ukur.
Anda dapat memasukkan seluruh basis kode, dokumen panjang, atau jejak agen multi-berkas dalam satu permintaan.
GLM-5.3-Flash mendukung jendela konteks 1M token, menyamai GLM-5.3 serta jendela 1M pada GPT-5.6 Terra dan Claude Sonnet 5.
Namun, beberapa laporan komunitas menyebutkan terjadinya "drift" atensi pada panjang ekstrem di atas kira-kira 700K token, keterbatasan yang juga dimiliki sebagian besar rekan dengan jendela konteks besar.
Dilaporkan memiliki daya ingat yang baik melintasi ratusan ribu token, tetapi jangan berasumsi penarikan informasi sempurna di ujung terjauh jendela.
Anda dapat menghubungkan GLM-5.3-Flash ke kerangka agen dengan pemanggilan fungsi dan skema JSON yang ditegakkan. Model ini meraih skor 78,4 pada Toolathlon dan 48,8 pada AutomationBench, yang terakhir merupakan lompatan besar dari 26,2 milik GLM-5.2.
Satu hal yang perlu diperhatikan: dukungan bervariasi menurut penyedia.
Beberapa gateway menandai keluaran terstruktur sebagai tidak didukung, dan penanganan prompt sistem berbeda antar penyedia hosted, sehingga Anda mungkin perlu menyesuaikan skema alat dan mode JSON per endpoint.
Anda dapat mengirimkan gambar bersamaan dengan teks untuk pembacaan grafik, analisis dokumen, dan penalaran visual.
GLM-5.3-Flash meraih 89,4% pada CharXiv-R, 80,5 pada MMVU, dan 78,0 pada Chartography, yang menunjukkan kemampuan solid untuk menangani grafik dan dokumen visual.
Dukungan multimodal bersifat native alih-alih tempelan, namun seperti halnya pemanggilan alat, permukaannya bergantung pada penyedia yang Anda gunakan. Checkout Hugging Face murni mungkin tidak mengekspos semua yang dimiliki API hosted.
GLM-5.3-Flash mencetak 57 pada Artificial Analysis Intelligence Index v4.1.1 dengan biaya $0,045 per tugas (diskon). Z.ai mengatakan tingkat kecerdasan tersebut sebelumnya berbiaya sekitar sepuluh kali lipat.
Evaluasi enam tolok ukur di bawah ini membandingkan Flash dengan GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra, dan Gemini 3.7 Flash.
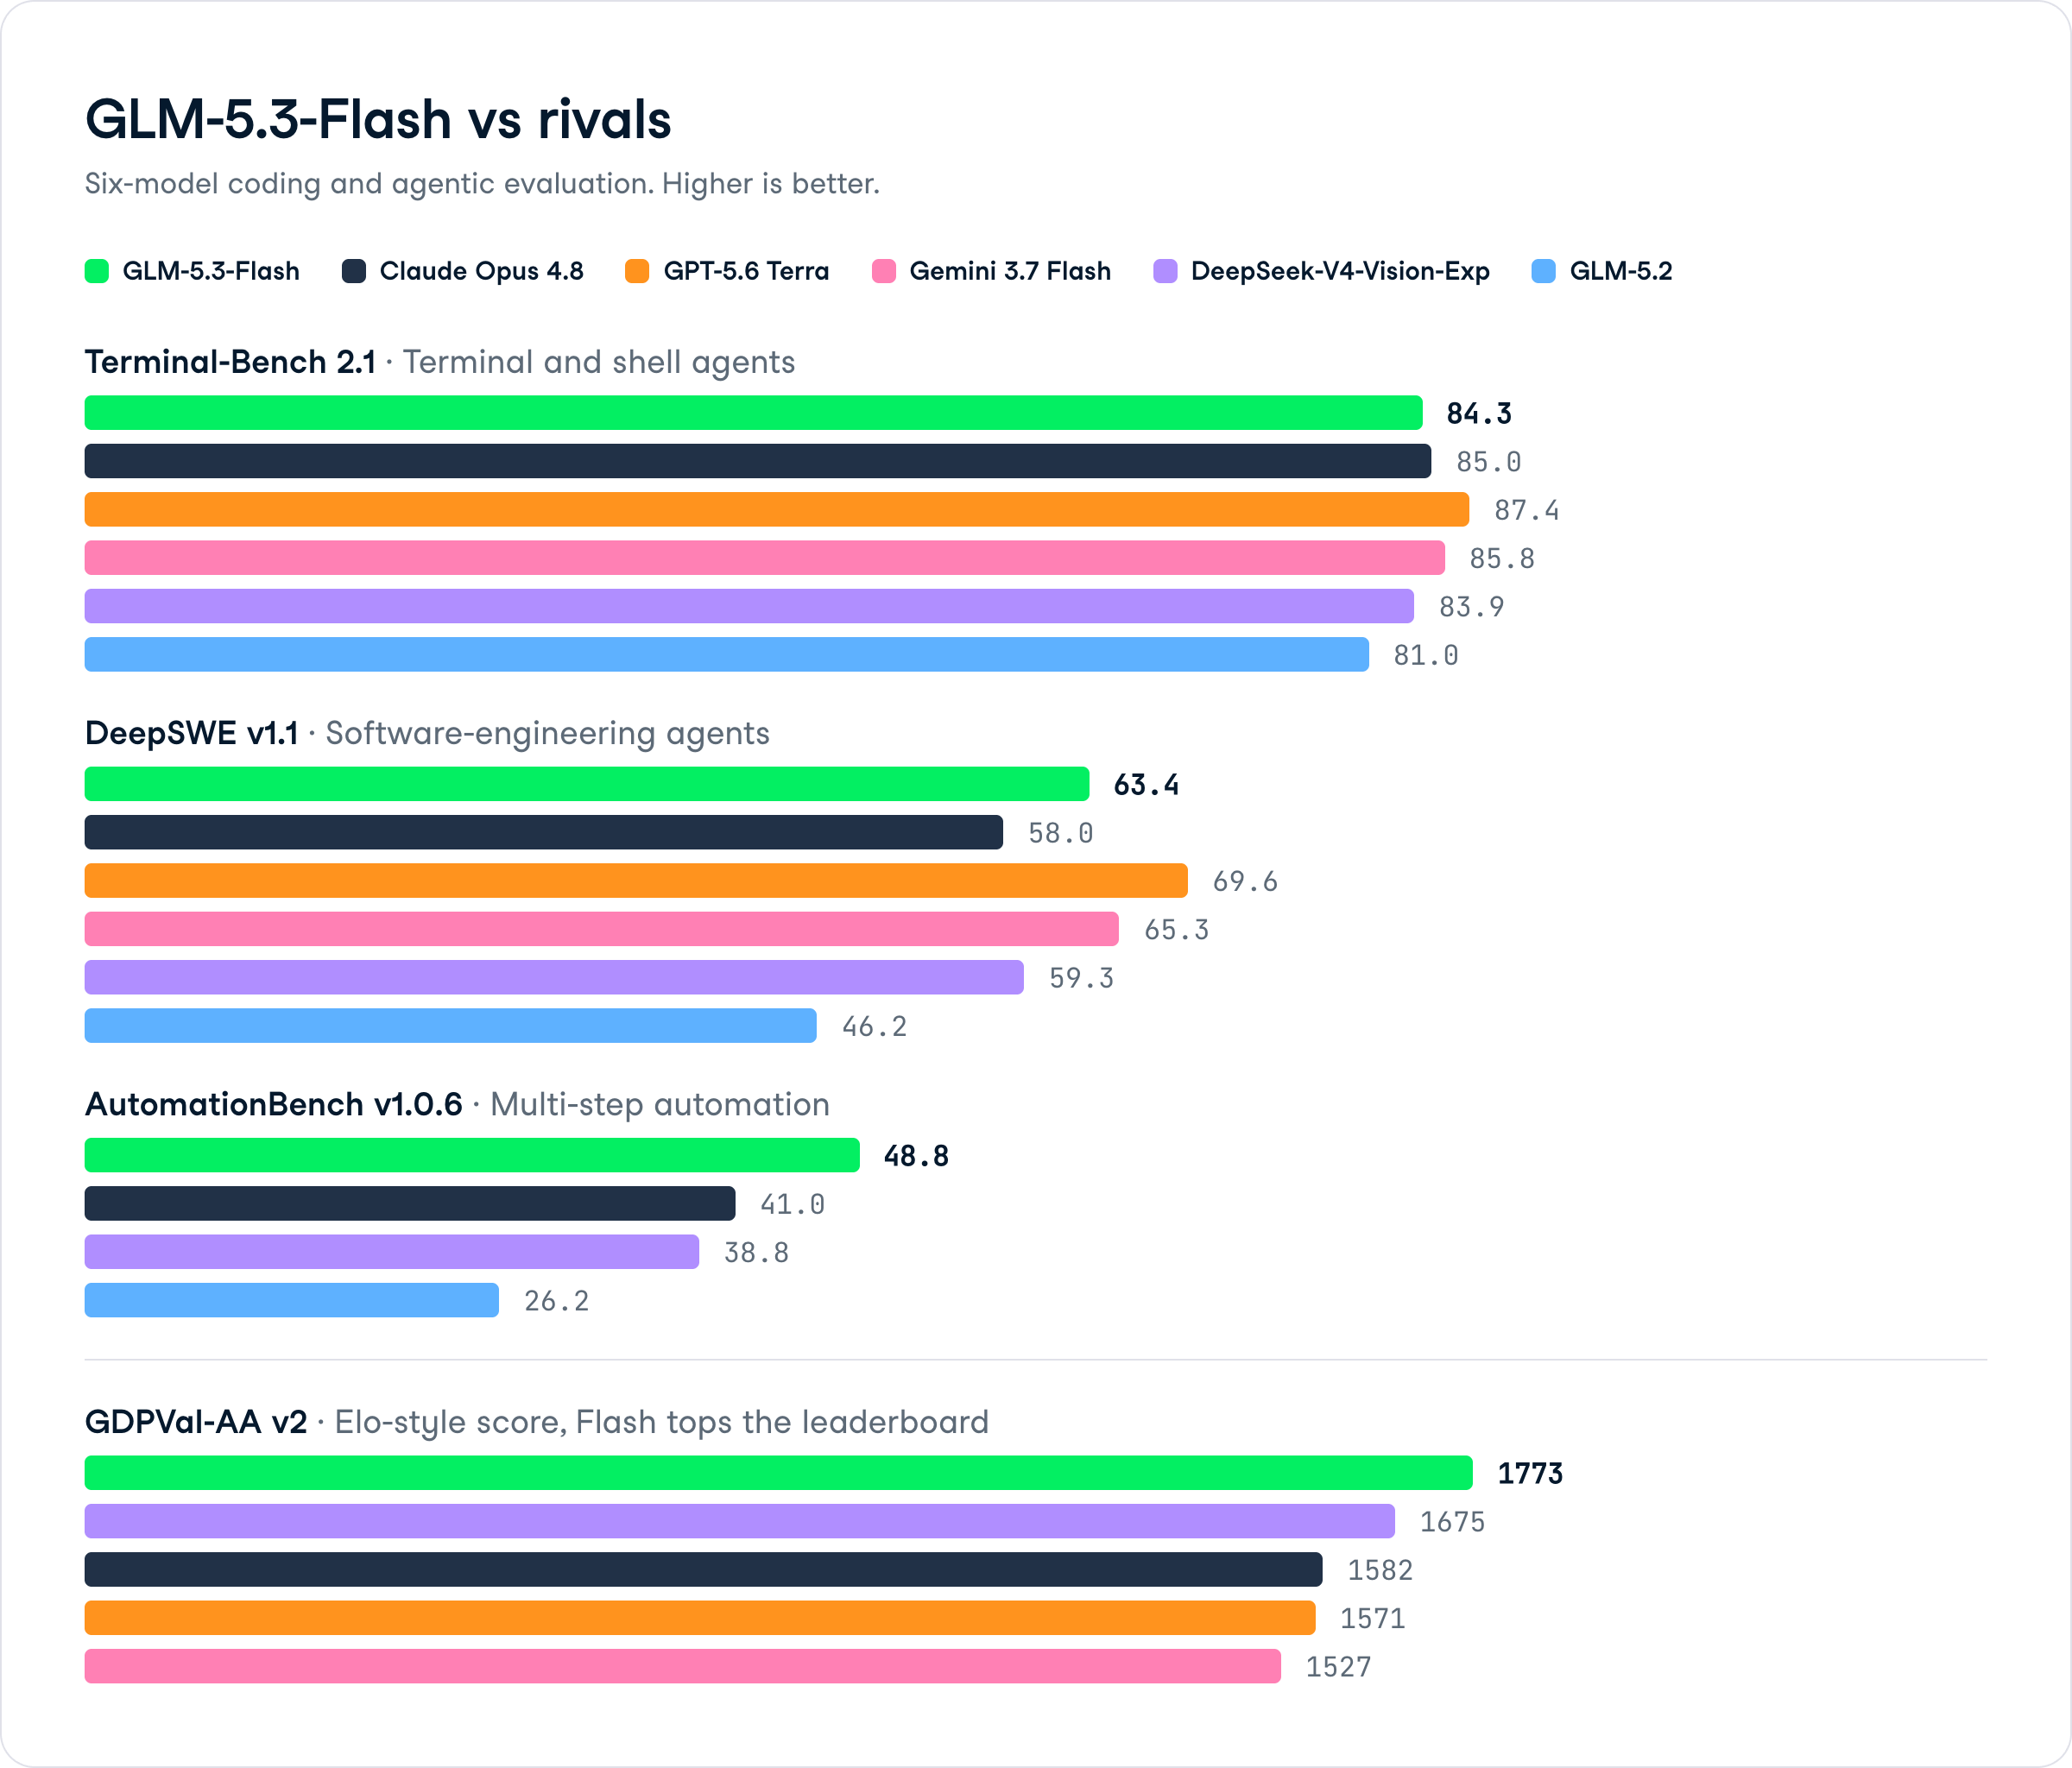
Pada tolok ukur agen rekayasa perangkat lunak ini, GLM-5.3-Flash meraih 63,4, di depan Claude Opus 4.8 (58,0) dan DeepSeek-V4-Vision-Exp (59,3), serta naik dari 46,2 milik GLM-5.2.
Ia tertinggal dari GPT-5.6 Terra (69,6) dan Gemini 3.7 Flash (65,3), tetapi mengungguli Claude dengan biaya kelas Flash adalah tajuk praktisnya di sini.
GLM-5.3-Flash meraih 48,8 pada alur kerja otomatisasi multi-langkah, keunggulan terbesar atas Claude Opus 4.8 (41,0) dan DeepSeek-V4-Vision-Exp (38,8) di antara semua tolok ukur dalam set ini.
GLM-5.2 meraih 26,2, jadi ini juga peningkatan antargenerasi yang paling tajam.
Pada evaluasi pengembangan umum dan pemrograman ini, Flash berada di puncak papan peringkat dengan 1773, di depan DeepSeek-V4-Vision-Exp (1675), Claude Opus 4.8 (1582), GPT-5.6 Terra (1571), dan Gemini 3.7 Flash (1527).
Flash meraih 84,3 pada tugas agen terminal dan shell, berada tepat di bawah Claude Opus 4.8 (85,0) dan Gemini 3.7 Flash (85,8), serta di belakang GPT-5.6 Terra (87,4). Ia unggul tipis atas GLM-5.2 (81,0) dan DeepSeek-V4-Vision-Exp (83,9). Kompetitif, bukan dominan.
GLM-5.3-Flash tersedia melalui API Z.ai dan berbagai gateway pihak ketiga, termasuk Baseten, Deep Infra, Venice AI, dan Requesty.
Checkpoint publik zai-org/GLM-5.3-Flash ada di Hugging Face untuk self-hosting.
Daftar harga dasar resmi Z.ai dan promosi waktu terbatasnya adalah sebagai berikut:
Apidog melaporkan harga gabungan berbobot penggunaan sekitar $0,10 per 1M token untuk Flash, dibandingkan sekitar $0,90 untuk GLM-5.3.
Gateway pihak ketiga memasang harga berbeda: EmpirioLabs di $0,07 input / $0,25 output, Venice AI di $0,09 / $0,31, dan Requesty di $0,14 / $0,45 dengan promo diskon 55% hingga 9 Sep 2026.
Kendala utamanya adalah throughput dan perangkat keras.
Flash menyajikan ~49 token/detik dibanding ~86 untuk GLM-5.3, dan Artificial Analysis menilainya 2/4 untuk kecepatan.
Self-hosting juga tidak ringan: checkpoint FP8 berukuran ~306 GiB hanya untuk bobot sebelum KV-cache dan runtime, jadi Anda memerlukan beberapa GPU ber-memori besar (bayangkan >4×80 GiB) alih-alih satu kartu.
Pilihan di antara keduanya bermuara pada biaya versus indeks kecerdasan dan throughput. Tabel di bawah merangkum pertukarannya.
| Atribut | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Indeks kecerdasan (Artificial Analysis) | 57 | 60 |
| Harga gabungan / 1M token | ~$0,10 | ~$0,90 |
| Kecepatan keluaran | ~49 token/detik | ~86 token/detik |
| Waktu ke token pertama | ~1,52 dtk | ~1,57 dtk |
| Terminal-Bench 2.1 | 84,3 | T/A dalam catatan |
| Jendela konteks | 1M | 1M |
Pilih Flash ketika biaya per token menjadi batasan dan pekerjaan Anda adalah coding atau agen. Pilih GLM-5.3 ketika Anda memerlukan tambahan indeks kecerdasan dan throughput sekitar dua kali lipat.
Keduanya diluncurkan pada 26 Agustus 2026, menyasar tier agen hemat yang sama. GLM-5.3-Flash unggul tipis atas Qwen3.8-Flash-Next pada satu tolok ukur yang mereka bagikan langsung (DeepSWE v1.1: 63,4 vs 58,7), tetapi kedua model dibangun cukup berbeda sehingga pilihan lebih bergantung pada beban kerja Anda daripada satu skor tunggal.
| GLM-5.3-Flash | Qwen3.8-Flash-Next | |
|---|---|---|
| Arsitektur | 320B total / 18B aktif | 125B total / 6B aktif |
| Konteks native | 1M token | 262K (1M dengan YaRN) |
| DeepSWE v1.1 | 63,4 | 58,7 |
| Harga input | ~$0,075/1M (promo) | $0,16/1M |
| Multimodal | Ya (native) | Ya (native) |
GLM-5.3-Flash mengaktifkan tiga kali lebih banyak parameter per token, yang kemungkinan menjelaskan keunggulan DeepSWE dan hasil Terminal-Bench 2.1 (84,3).
Qwen3.8-Flash-Next menandingi dengan skor yang dilaporkan lebih kuat pada SWE-bench Pro (62,5) serta tolok ukur perkantoran dan agen seperti CoWorkBench (73,9) dan JobBench (55,7), di mana GLM tidak memublikasikan angka sebanding.
Soal harga, GLM lebih murah selama periode promonya. Soal efisiensi parameter, Qwen menghasilkan lebih banyak dengan jejak aktif yang lebih kecil. Untuk self-hosting, checkpoint Qwen yang lebih kecil jauh lebih mudah dijalankan secara lokal.
Jika prioritas Anda adalah agen coding dan throughput agen yang mentah, GLM-5.3-Flash memiliki angka yang lebih kuat pada titik perbandingan langsung. Jika alur kerja Anda banyak perkantoran, multimodal, atau diuntungkan oleh checkpoint self-hosted yang lebih kecil, Qwen3.8-Flash-Next patut diuji terlebih dahulu.
Lihat panduan lengkap Qwen3.8-Flash-Next kami untuk uraian menyeluruh.
GLM-5.3-Flash menunjukkan taruhan jelas Z.ai pada segmen agen hemat: mendekati satu-dua poin dari Opus 4.8 dan GPT-5.6 Terra pada evaluasi coding, lalu menawarkannya dengan harga satu ordo magnitudo lebih rendah.
Skor 84,3 pada Terminal-Bench 2.1 dengan harga gabungan sekitar $0,10 per 1M token adalah tawarannya, dan itu sangat menarik untuk coding dan otomatisasi volume tinggi.
Keterbatasannya datang pada kecepatan dan infrastruktur.
Dengan ~49 token/detik, ini bukan model untuk streaming sensitif latensi, dan checkpoint FP8 ~306 GiB menutup kemungkinan penerapan lokal kasual. Pengguna pratinjau awal di r/opencodeCLI melaporkan waktu antre dan start lambat saat beban tinggi, meski GA kemungkinan telah meningkatkannya.
Pendapat saya, jika biaya per token menjadi batasan utama dan pekerjaan Anda adalah coding atau agen, GLM-5.3-Flash layak diuji melawan GPT-5.6 Terra dan Claude Opus 4.8 sebelum Anda berkomitmen.
Jika Anda memerlukan tambahan 3 poin indeks kecerdasan dan throughput yang lebih cepat, GLM-5.3 penuh ada alasannya. Ia juga hadir di hari yang sama dengan Qwen3.8-Flash-Next, jadi kelas hemat memang patut dibandingkan saat ini.
Jika Anda ingin terbiasa bekerja dengan model seperti ini, saya merekomendasikan AI Fundamentals skill track kami untuk membangun dasar, lalu tutorial tentang menjalankan model MoE Flash secara lokal untuk praktik langsung.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt