
{count, plural, one {Kursus} other {Kursus}}
Pengembangan Kode dengan Bantuan AI untuk Developer
{hours} jam {minutes} menit
10.9K
Pembaruan: 2 September 2026: Alibaba merilis Qwen3.8-Max-0902, snapshot peningkatan Qwen3.8-Max yang berfokus pada performa coding dan agen. Bagian di bawah telah ditambahkan untuk mencerminkan benchmark baru.
Pada 2 September 2026, Alibaba merilis Qwen3.8-Max-0902, peningkatan pascapelatihan untuk Qwen3.8-Max. Arsitektur tidak berubah: 2,4 triliun parameter, konteks 1M token, dan harga yang sama ($2/1M input, $6/1M output). Fokusnya sepenuhnya pada coding dan pekerjaan agen berjangka panjang.
Hasil menonjol adalah Code Arena WebDev, di mana Qwen3.8-Max-0902 menempati peringkat pertama secara keseluruhan dengan 1.691 poin, unggul 3 poin dari Claude Opus 5 Max (1.687), 17 poin dari Kimi K3 Max (1.674), dan 22 poin dari Qwen3.8-Max sebelumnya (1.669). Model ini juga memegang posisi teratas pada Pareto frontier pada campuran $5 per sejuta token.
Semua 8 benchmark coding meningkat. Kenaikan terbesar ada pada TerminalBench 3.0 (11,3 menjadi 29,0) dan ProgramBench Almost Solved (10,5 menjadi 28,0), keduanya lebih dari dua kali lipat. Tabel di bawah menunjukkan gambaran lengkap di kategori coding, agen, dan multimodal.
| Benchmark | Qwen3.8-Max-0902 | Qwen3.8-Max | Claude Opus 5 |
|---|---|---|---|
| Coding | |||
| TerminalBench 3.0 | 29.0 | 11.3 | 42.7 |
| DeepSWE 1.1 | 69.3 | 56.6 | 73.6 |
| NL2Repo-Bench | 64.9 | 55.9 | 72.3 |
| ProgramBench (Almost Solved) | 28.0 | 10.5 | 41.5 |
| SWE-Marathon | 44.8 | 39.1 | 50.0 |
| MLS-Bench-Lite | 50.1 | 41.0 | 49.8 |
| SWE-Atlas QnA | 66.3 | 60.3 | 63.2 |
| QwenSWEBench V2 | 70.0 | 55.1 | 68.0 |
| Agen | |||
| CoWorkBench | 76.1 | 74.8 | 79.6 |
| JobBench | 64.0 | 53.4 | 67.8 |
| Toolathlon Verified | 73.3 | 72.5 | 77.6 |
| WorkArena (Elo) | 1468 | 1348 | 1437 |
| Multimodal | |||
| MMMU-Pro | 82.7 | 82.3 | 82.6 |
| ERQA | 78.3 | 77.8 | 67.3 |
Tebal menandakan Qwen3.8-Max-0902 unggul atas Claude Opus 5 pada benchmark tersebut. Semua hasil diambil dari tabel perbandingan yang dipublikasikan Alibaba.
Dibanding Claude Opus 5, pembaruan 0902 memimpin pada tiga benchmark coding (MLS-Bench-Lite, SWE-Atlas QnA, QwenSWEBench V2) dan menang di WorkArena serta kedua evaluasi multimodal yang dipublikasikan. Claude masih unggul pada TerminalBench 3.0, DeepSWE 1.1, dan benchmark koordinasi agen. Harga tidak berubah, jadi jika Anda sudah menggunakan Qwen3.8-Max, ini adalah peningkatan gratis dengan dorongan berarti pada coding. Qwen juga merilis Qwen3.8-Omni-Flash pada 18 September.
Artikel Asli
Tim Qwen dari Alibaba merilis Qwen3.8-Max pada 3 Agustus 2026, dan model ini tepat menyasar wilayah pasar terdepan yang paling kompetitif: rekayasa perangkat lunak otonom dan pekerjaan enterprise berjangka panjang. Ini adalah pertama kalinya Qwen berencana membuka sumber model kelas Max, dengan bobot (weights) dijadwalkan rilis pekan depan bersama Qwen3.8-27B yang lebih kecil.
Qwen3.8-Max adalah model mixture-of-experts (MoE) dengan 2,4 triliun parameter, 95B parameter aktif, jendela konteks 1M token, serta input native teks, gambar, dan video. Klaim utama: skor 86,1 pada OSWorld-Verified, di depan GPT-5.6 Sol Max dengan 83,2, Claude Fable 5 dengan 85,0, dan Gemini 3.1 Pro dengan 76,2. Model ini juga mencatat skor PaperBench tertinggi yang dilaporkan sebesar 93,0 dan harga $2/$6 per sejuta token input/output.
Di artikel ini, saya akan membahas semua hal baru di Qwen3.8-Max, melihat fitur coding dan agen, menelusuri benchmark, serta menyiapkan uji coba langsung untuk Anda jalankan. Untuk liputan terkait, lihat panduan kami tentang Grok 4.5, GPT-5.6 Terra vs Claude Sonnet 5, dan panduan lengkap API Claude. Anda juga bisa membaca tentang Qwen3.8-Flash terbaru.
Qwen3.8-Max adalah model paling andal di keluarga Qwen, arsitektur MoE spars dengan total 2,4 triliun parameter dan sekitar 95B parameter aktif per forward pass.
Model ini dibangun di atas fondasi arsitektur Qwen 3.5 dan menargetkan empat jalur khusus:
Perubahan struktural terbesar dari Qwen3.7-Max adalah skala dan komitmen open-weight. Qwen belum pernah merilis weights untuk model kelas Max sebelumnya, dan perusahaan menyatakan Qwen3.8-Max dan Qwen3.8-27B akan hadir di Hugging Face dan ModelScope pekan depan.
Alibaba belum mengungkapkan lisensi, jadi belum jelas apakah akan dirilis di bawah lisensi permisif seperti Apache 2.0 atau lisensi kustom yang lebih ketat.
Berita besar pada sisi benchmark yang paling penting adalah penggunaan komputer berbasis agen.
Di OSWorld-Verified, yang mengukur seberapa baik agen mengoperasikan lingkungan desktop nyata, Qwen3.8-Max memimpin semua model proprietari yang diuji Qwen sebagai pembanding.
Untuk model yang akan bisa di-host sendiri, ini adalah proposisi yang benar-benar berbeda dibanding rilis open-weight biasa yang tertinggal satu generasi dari frontier.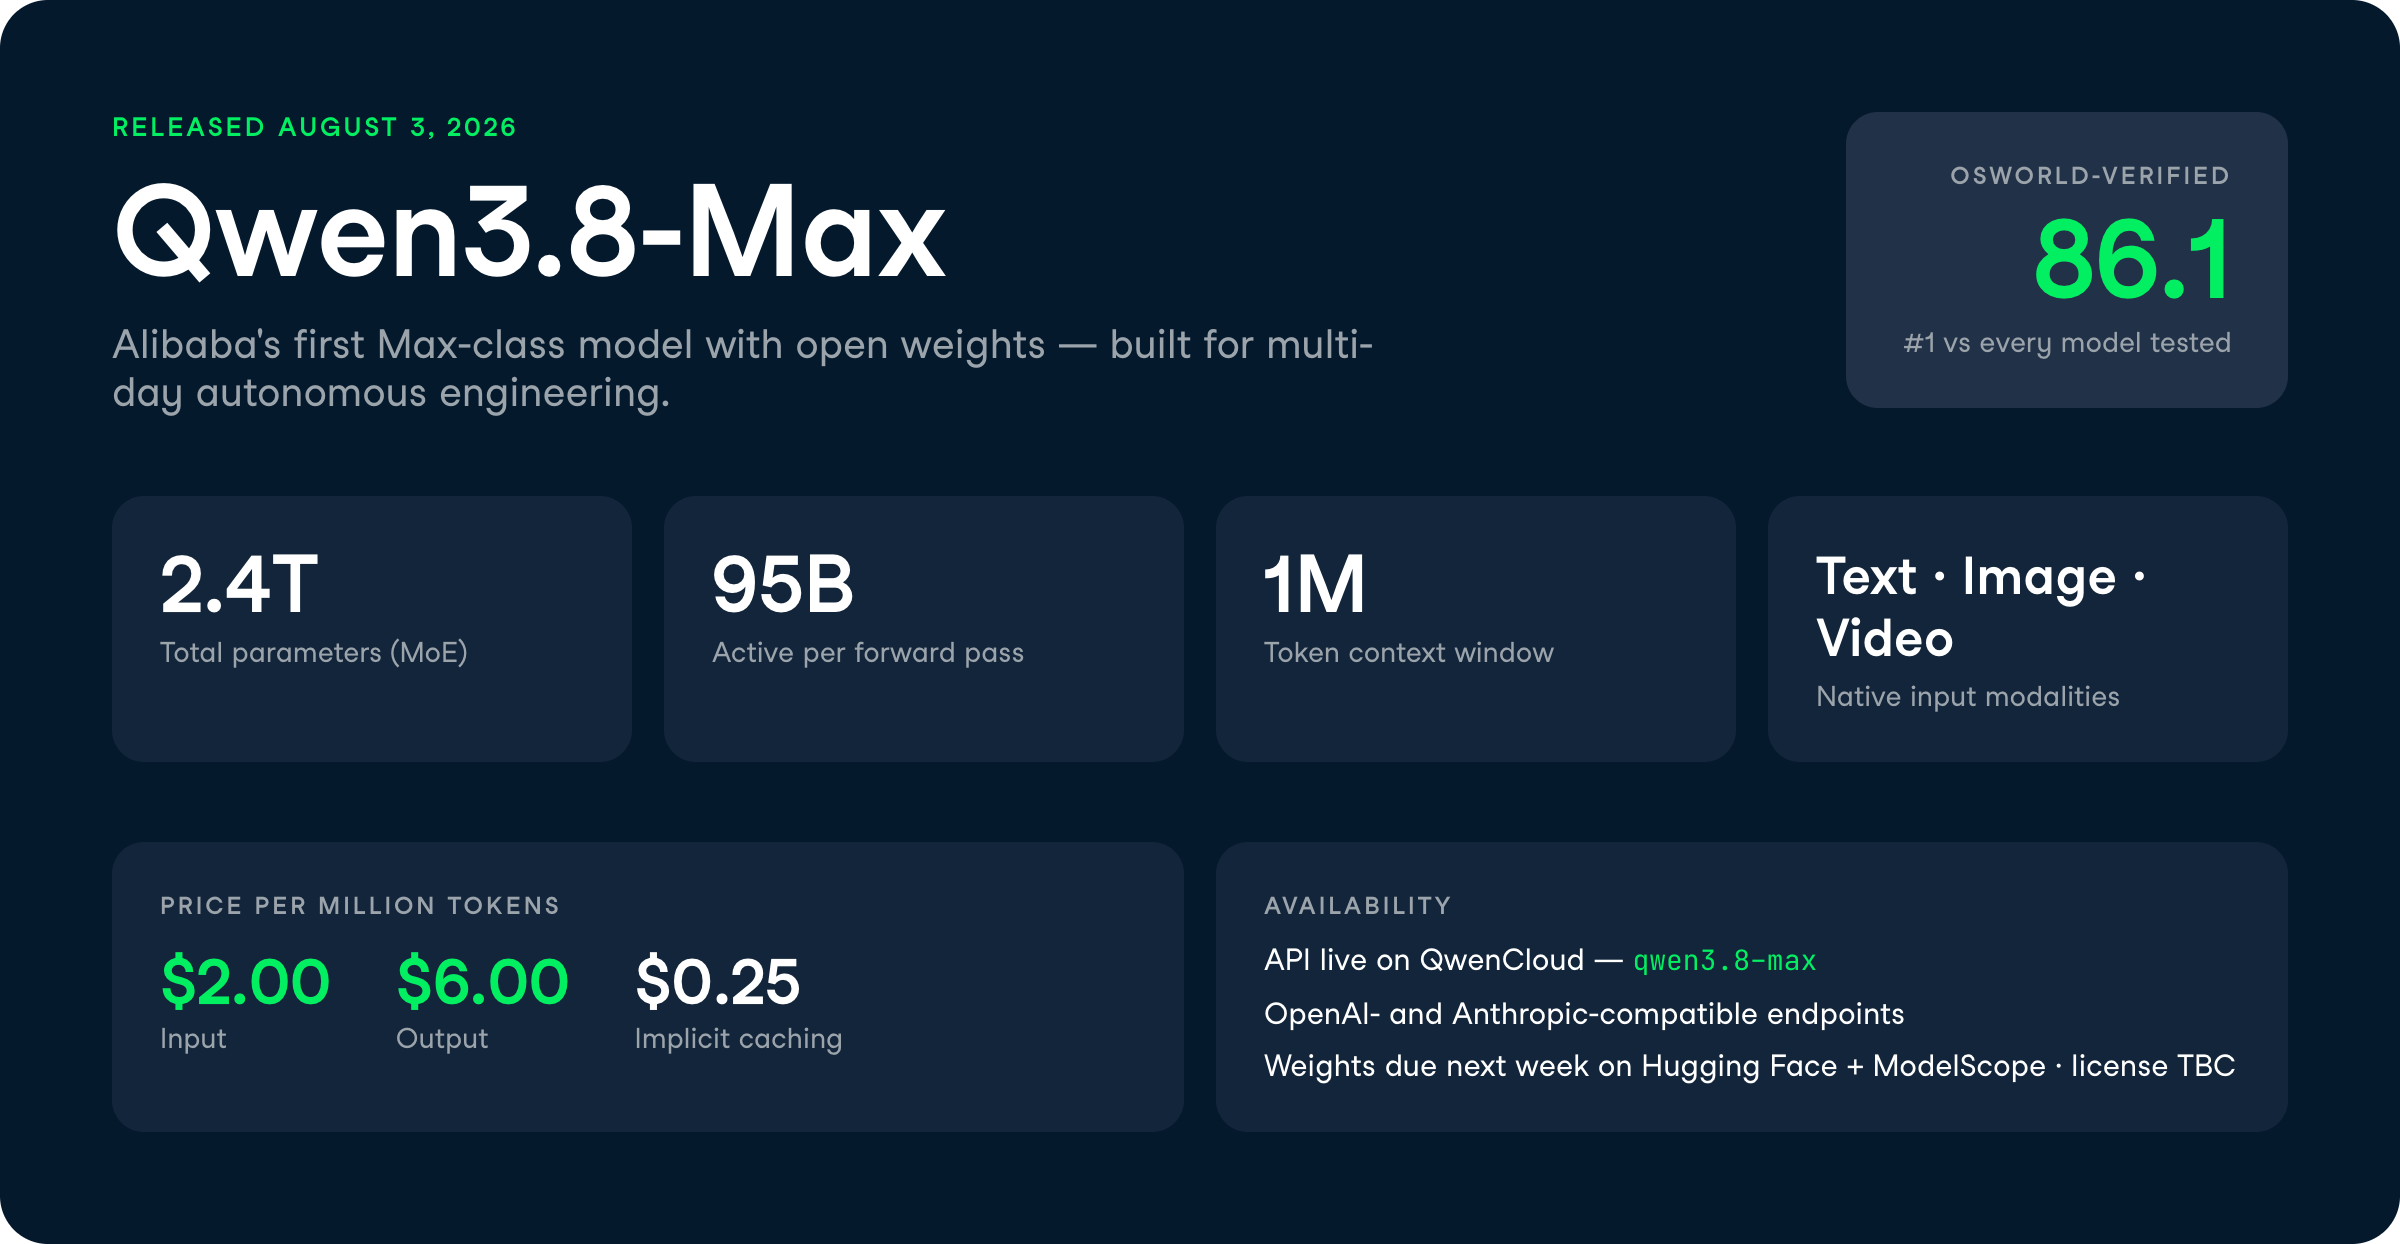
Tema yang mengalir di Qwen3.8-Max adalah otonomi dalam rentang waktu panjang.
Qwen membingkai setiap kapabilitas dengan gagasan yang sama: model tidak mengikuti rencana tetap; ia mengoreksi diri melalui loop umpan balik selama berhari-hari pekerjaan berkelanjutan.
Berikut fitur-fitur yang paling menonjol bagi saya.
Qwen3.8-Max dapat membawa proyek coding dari folder kosong hingga hasil akhir selama berhari-hari kerja berkelanjutan tanpa campur tangan manusia.
Demo andalan perusahaan berjalan sekitar 16 hari operasi sepenuhnya otonom, membangun harness CLI yang berevolusi sendiri dengan total 265 commit, 127 PR, dan 151 isu.
Mekanismenya adalah loop umpan balik: kebutuhan masuk sebagai isu GitHub, agen mengklaim dan mengeksekusinya, lalu memicu build, unit test, end-to-end test, dan cek CI sebelum merge.
Bagi praktisi, ini mengarah pada model yang dirancang untuk menjalankan pipeline engineering tanpa pengawasan alih-alih menjawab pertanyaan kode satu kali.
Pengecualian yang jelas: ini adalah pertunjukan vendor.
Menjalankan otonom 16 hari di lingkungan terkontrol tidak sama dengan mengarahkannya ke monorepo produksi Anda lalu berlalu begitu saja.
Qwen3.8-Max dapat membaca paper riset, mereproduksi eksperimennya dalam kode dari nol, lalu mencoba mengalahkan metodenya.
Dalam contoh Qwen, model bekerja sekitar 5 hari (~125 jam), menulis kira-kira 7.600 baris kode, melakukan lebih dari 1.100 aksi, dan menjalankan 33 putaran pelatihan GPU tanpa kode awal.
Ia pertama mereproduksi enam temuan utama paper, lalu menjalankan loop perbaikan diri berupa hipotesis, kode, run GPU, dan analisis sepanjang 4 putaran dan 18 ide.
Metode akhir yang ditemukannya mengalahkan pendekatan paper dengan selisih 2,71 poin pada AIME24, sebuah benchmark matematika level kompetisi.
Ini adalah alur kerja yang biasanya memakan waktu sepekan tim riset hanya untuk setup sebelum eksperimen dimulai.
Dynamic Workflows memungkinkan Qwen3.8-Max merencanakan tugas secara terprogram dan mengirim banyak sub-agen secara paralel.
Dalam demo riset kuantitatif, model mengurai 6 deskripsi faktor singkat menjadi masing-masing 50 arah riset, mengirim sekitar 330 sub-agen, dan menyelesaikan kira-kira 6.000 backtest, sembari menyesuaikan alur kerja di tengah jalan.
Yang membedakan dari skrip tetap adalah model bertindak berdasarkan bukti.
Ketika mendapati sinyal overfitting, model memangkas faktor-faktor redundan per putaran; saat ensembel tiga model tampak kurang robust dibanding sintesis arah tetap pada irisan data kecil, ia beralih kerangka secara mandiri.
Faktor terpilih mencapai excess Sharpe ratio 0,64 hingga 1,48—hasil konkret yang bisa diverifikasi, bukan sekadar kesan.
Qwen3.8-Max menggunakan visi sepanjang eksekusi, bukan hanya untuk membaca input.
Selama tugas, model memeriksa output antara miliknya, menemukan masalah seperti antarmuka yang tidak sejajar atau objek menghadap arah yang salah, lalu merevisi rencana untuk memperbaikinya.
Di sisi input, ia menangani PDF lebih dari 200 halaman yang mencakup teks, bagan, dan tata letak, serta dapat memroses video lebih dari 100 jam dengan membangun grafik memori video tentang orang, peristiwa, dan stempel waktu.
Qwen juga merilis Qwen-MM-Plugins, pustaka ekstensi harness yang menambahkan pemrosesan gambar dan video, memori multimodal, dan penggunaan alat visual ke kerangka agen yang ada.
Bagi siapa pun yang membangun agen berbasis dokumen atau video yang berat, grafik memori adalah hal yang patut diperhatikan.
Qwen3.8-Max menyediakan parameter reasoning_effort agar Anda bisa menukar biaya dengan kedalaman. Tiga level memungkinkan Anda menyetel seberapa banyak model berpikir sebelum menjawab:
xhigh (default): untuk tugas kompleks yang membutuhkan analisis menyeluruhmedium: menyeimbangkan akurasi dan kecepatanlow: penalaran efisien yang dioptimalkan untuk kecepatan dan biayaPerlu dicatat: seorang komentator r/LocalLLaMA menyebut model Qwen cenderung overthinking, dan DeepSeek V4 Flash menghabiskan lebih sedikit waktu untuk bernalar meski kadang menghasilkan output yang lebih rendah kualitasnya. Jika beban kerja Anda sensitif latensi, turunkan ke low sebelum menganggap default adalah pilihan tepat.
Rangkaian benchmark Qwen sangat condong ke eksekusi berjangka panjang alih-alih ujian statis, sesuai dengan posisi model.
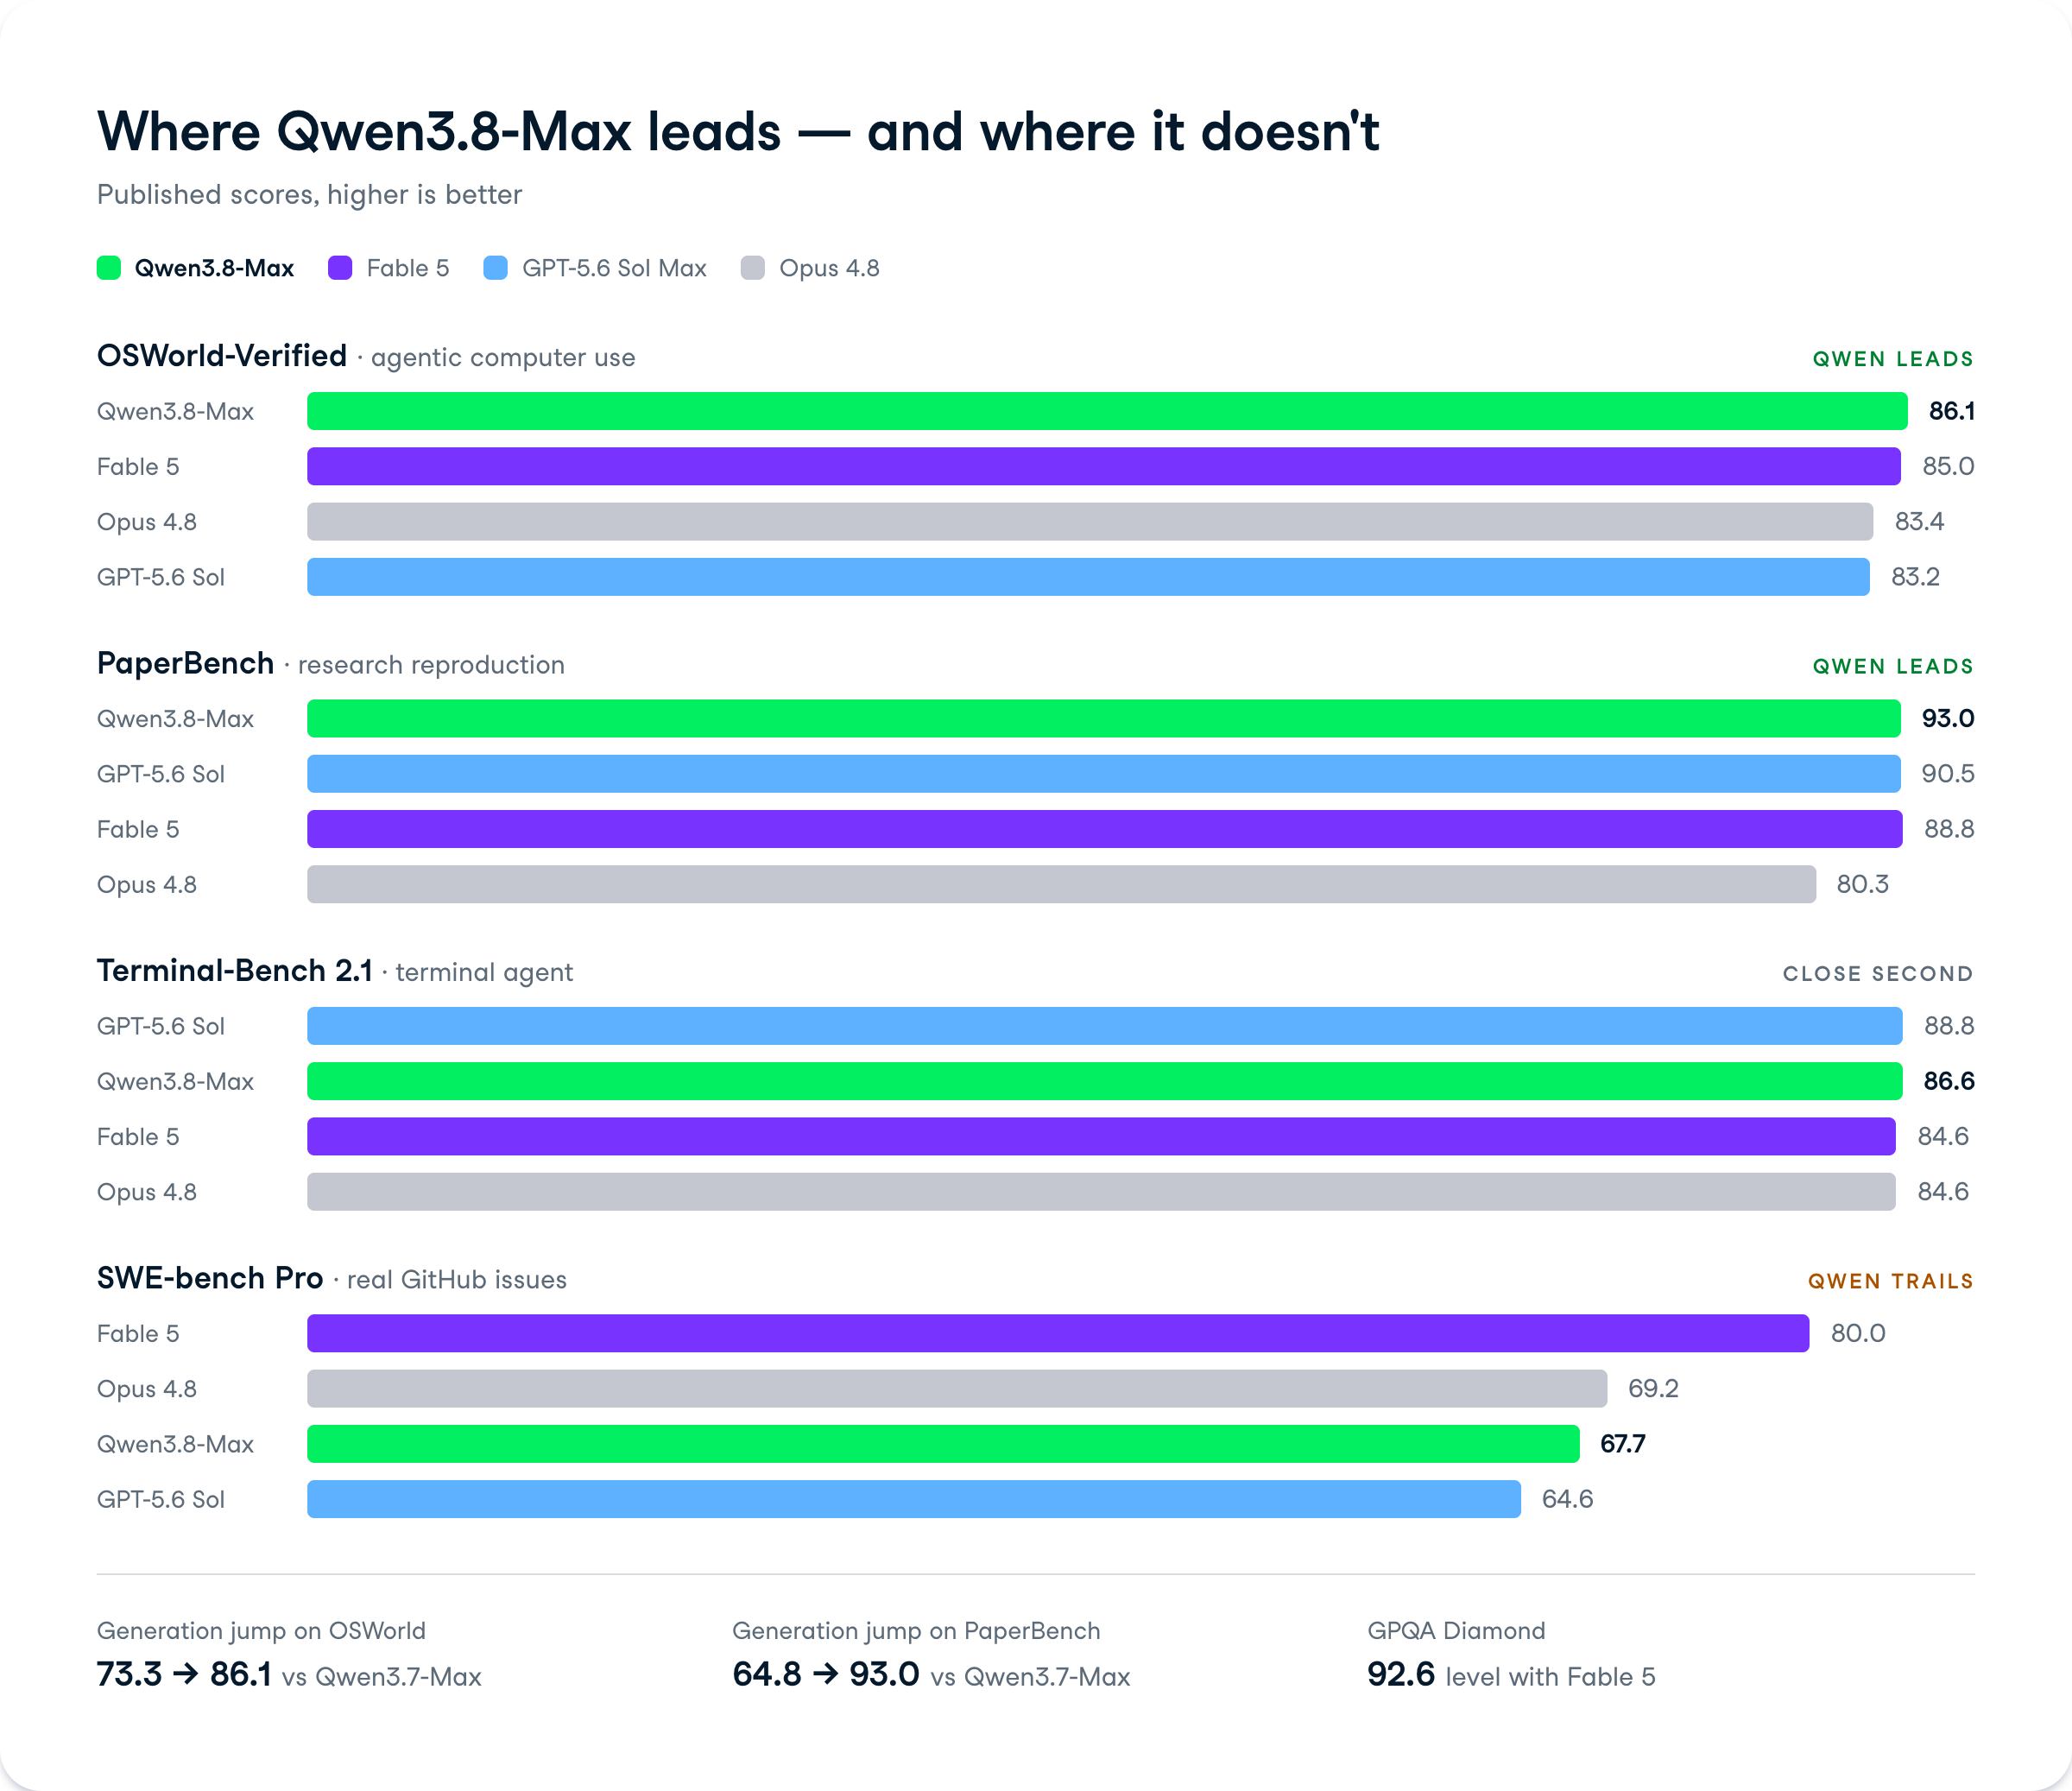
Di tabel yang dipublikasikan, Qwen3.8-Max memimpin atau sangat kompetitif pada penggunaan komputer berbasis agen, reproduksi riset, dan coding, meski tertinggal dari GPT-5.6 Sol Max dan Fable 5 pada beberapa evaluasi rekayasa perangkat lunak.
Model ini menawarkan profil seimbang yang luas alih-alih mendominasi setiap kategori.
| Benchmark (Kategori) | Qwen 3.8 Max | Qwen 3.7 Max | Opus 4.8 | Fable 5 | Gemini 3.1-Pro | GPT5.6 Sol (max) |
|---|---|---|---|---|---|---|
| SWE-Pro (Rekayasa Perangkat Lunak) | 67.7 | 60.6 | 69.2 | 80.0 | - | 64.6 |
| TerminalBench-2.1 (Agen Terminal) | 86.6 | 74.5 | 84.6 | 84.6 | - | 88.8 |
| PaperBench (Reproduksi Riset) | 93.0 | 64.8 | 80.3 | 88.8 | - | 90.5 |
| FrontierSWE (Rekayasa Perangkat Lunak) | 73.5 | 40.7 | 70.0 | 88.8 | - | - |
| QwenReactBench (Frontend React) | 1724 | 1538 | 1694 | 1770 | - | 1564 |
| CoWorkBench (Tugas Rekan Profesional) | 74.8 | 64.6 | 72.3 | 75.9 | - | 71.5 |
| JobBench (Agen Mendukung Alur Kerja Manusia) | 53.4 | 31.3 | 48.4 | 57.4 | - | 45.4 |
| Agents' Last Exam (Tugas Bernilai Jangka Panjang) | 52.4 | 31.1 | 45.1 | - | - | 53.6 |
| BabyVision (Penalaran Visual)* | 82.0 / 91.3 | 64.7 / 70.4 | 28.4 / 81.2 | 42.5 / 90.5 | 55.9 / 68.3 | 65.5 / 88.9 |
| CharXiv (RQ) (Penalaran Bagan)* | 88.4 / 93.5 | 85.8 / 85.9 | 78.5 / 89.9 | 87.9 / 93.5 | 84.4 / 89.9 | 85.1 / 89.1 |
| ERQA (Penalaran Embodied) | 77.8 | 69.8 | 57.2 | 70.0 | 68.0 | 70.0 |
| PerceptionBench (Persepsi Visual) | 63.5 | 51.1 | 47.2 | 57.2 | 56.2 | 59.7 |
| LVBench (Pemahaman Video Panjang) | 81.8 | 76.2 | 67.3 | 75.1 | - | 78.8 |
| Vision2Web (Pengembangan Web Visual) | 69.0 | 42.1 | 62.4 | 70.5 | - | 62.1 |
| MobileWorld (Penggunaan Mobile Berbasis Agen) | 77.8 | 51.2 | 67.5 | 85.5 | 58.1 | 76.9 |
| OSWorld-Verified (Penggunaan Komputer Berbasis Agen) | 86.1 | 73.3 | 83.4 | 85.0 | 76.2 | 83.2 |
Catatan Penting:
* Skor Ganda: Untuk benchmark dengan dua metrik (BabyVision dan CharXiv), nilai diformat sebagai w/o python / w/ python berdasarkan angka dalam dan atas yang ditampilkan pada bar khusus tersebut.
* Data Hilang (-): Tanda hubung menunjukkan benchmark di mana model tertentu tidak diuji atau skornya tidak disertakan dalam grafik.
Qwen3.8-Max meraih 86,1 pada OSWorld-Verified, di depan Fable 5 (85,0), GPT-5.6 Sol Max (83,2), dan Gemini 3.1 Pro (76,2).
Benchmark ini mengukur seberapa andal agen penggunaan komputer mengoperasikan lingkungan desktop nyata, mengklik antarmuka dan menyelesaikan tugas multi-langkah.
Bagi siapa pun yang membangun agen untuk mengendalikan aplikasi nyata alih-alih memanggil API, ini adalah angka yang paling penting. Qwen3.7-Max hanya mencetak 73,3 di sini, jadi lonjakannya signifikan dalam keluarga.
Pada PaperBench, Qwen3.8-Max mencatat 93,0, skor tertinggi yang dilaporkan, mengungguli GPT-5.6 Sol di 90,5 dan Fable 5 di 88,8.
PaperBench mengukur kemampuan model mereproduksi eksperimen dalam paper riset menjadi kode, yang berkaitan langsung dengan demo reproduksi riset 5 hari.
Ini adalah lompatan besar dari Qwen3.7-Max di 64,8. Jika pekerjaan Anda melibatkan mengubah paper menjadi pipeline yang berjalan, ini sinyal kuat.
Qwen3.8-Max mencetak 86,6 pada Terminal-Bench 2.1, berada di antara GPT-5.6 Sol di 88,8 dan 84,6 yang dicatat Opus 4.8 serta Fable 5.
Benchmark ini menguji agen yang bekerja di terminal untuk menyelesaikan tugas rekayasa dalam batas waktu.
Ini peningkatan nyata dari 74,5 milik Qwen3.7-Max, dan menempatkan model open-weight cukup dekat dengan skor proprietari teratas untuk pekerjaan agen di command line.
Di sini Qwen3.8-Max tertinggal. Skornya 67,7 pada SWE-bench Pro, di belakang Fable 5 di 80,0 dan Opus 4.8 di 69,2, meski unggul atas GPT-5.6 Sol di 64,6.
SWE-bench Pro mengukur penyelesaian isu GitHub nyata dalam basis kode profesional.
Ini adalah titik lemah yang jujur. Saat kami mengulas Grok 4.5, Fable 5 juga memimpin SWE-Bench Pro di 80,4, jadi model Anthropic masih yang harus dikalahkan pada evaluasi spesifik ini.
Pada GPQA Diamond, benchmark penalaran sains tingkat pascasarjana, Qwen3.8-Max meraih 92,6, setara Fable 5 (92,6) dan sedikit di belakang GPT-5.6 Sol di 94,1. Model ini juga memimpin di IFBench (mengikuti instruksi) dengan 82,8, HealthBench 60,2, dan PRBench-Finance 58,3.
Pola ini konsisten: kuat pada pekerjaan agen dan terapan, kompetitif pada penalaran, dan sesekali tertinggal pada ujian penalaran terberat, Humanity's Last Exam, di mana skornya 43,6 dibanding 53,3 milik Fable 5.
Qwen3.8-Max tersedia sekarang melalui QwenCloud dengan ID model API qwen3.8-max. API mendukung endpoint chat completions dan responses yang kompatibel dengan OpenAI serta antarmuka yang kompatibel dengan Anthropic, sehingga Anda bisa mengarahkan Claude Code atau Codex ke model ini dengan perubahan konfigurasi minimal.
Harga berada di tingkat menengah dan lebih murah daripada model proprietari AS teratas yang menjadi pembandingnya:
Total gabungan $8 itu kurang dari sepertiga harga Claude Opus 5 yang $30 dan kurang dari seperempat GPT-5.6 Sol Standard yang $35. Ini menyamai Grok 4.5, yang juga mematok $2/$6, seperti kami catat dalam liputan Grok 4.5. Weights terbuka untuk Qwen3.8-Max dan Qwen3.8-27B dijadwalkan hadir di Hugging Face dan ModelScope pekan depan, meski syarat lisensinya belum dipublikasikan.
Qwen3.8-Max adalah pernyataan Alibaba tentang di mana open weights bisa bersaing. Memuncaki OSWorld-Verified dan PaperBench melawan Fable 5 dan GPT-5.6 Sol Max, dengan model yang bisa di-host sendiri dan dihargai $2/$6, adalah langkah yang memberi tekanan pada seluruh tier proprietari dalam hal biaya per tugas agen.
Pengecualiannya nyata. Run coding otonom 16 hari dan reproduksi riset 5 hari adalah pertunjukan vendor, bukan reproduksi independen, dan lisensi untuk weights pekan depan masih belum diketahui. Di r/LocalLLaMA, perdebatan yang lebih menarik adalah tentang Qwen3.8-27B yang lebih kecil, dengan beberapa komentator lebih antusias menjejalkan kecerdasan ke satu GPU konsumen daripada menjalankan raksasa 2,4T yang hanya bisa dijalankan oleh segelintir setup.
Pendapat saya: jika Anda membangun agen yang mengoperasikan antarmuka nyata atau mereproduksi pipeline riset, Qwen3.8-Max layak diuji secara serius, terutama setelah weights dirilis dan Anda bisa self-host. Jika pekerjaan Anda murni rekayasa perangkat lunak profesional pada isu GitHub yang rumit, Fable 5 masih memimpin SWE-bench Pro, jadi jalankan keduanya sebelum memutuskan.
Jika Anda ingin menjadi terbiasa bekerja dengan model seperti ini melalui API-nya, saya merekomendasikan AI Fundamentals skill track kami untuk membangun fondasi terlebih dahulu.
Kursus Teratas di DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt




