
Last chance! 50% off DataCamp Premium
Sale ends in
Algoritme optimasi berperan krusial dalam deep learning: algoritme ini menyetel bobot model untuk meminimalkan fungsi loss selama pelatihan. Salah satu algoritme tersebut adalah optimizer Adam.
Adam menjadi sangat populer dalam deep learning karena kemampuannya menggabungkan keunggulan momentum dan laju pembelajaran adaptif. Hal ini menjadikannya sangat efisien untuk melatih jaringan saraf dalam. Adam juga memerlukan penyetelan hiperparameter yang minimal, sehingga luas diakses dan efektif di berbagai tugas.
Pada 2017, Ilya Loshchilov dan Frank Hutter memperkenalkan versi yang lebih maju dari algoritme Adam populer dalam makalah mereka "Decoupled Weight Decay Regularization." Mereka menamainya AdamW, yang menonjol karena memisahkan weight decay dari proses pembaruan gradien. Pemisahan ini merupakan peningkatan krusial dibanding Adam dan membantu generalisasi model yang lebih baik.
AdamW menjadi semakin penting dalam aplikasi deep learning modern, khususnya dalam menangani model skala besar. Kemampuannya yang unggul dalam mengatur pembaruan bobot berkontribusi pada adopsinya dalam tugas-tugas yang menuntut kinerja dan stabilitas tinggi.
Dalam tutorial ini, kita akan membahas perbedaan utama antara Adam dan AdamW, berbagai kasus penggunaan, dan menerapkan panduan langkah demi langkah untuk mengimplementasikan AdamW di PyTorch.
Adam dan AdamW adalah optimizer adaptif yang banyak digunakan dalam deep learning. Perbedaan besar di antara keduanya ada pada cara mereka menangani regularisasi bobot, yang memengaruhi efektivitasnya dalam berbagai skenario.
Sementara Adam menggabungkan momentum dan laju pembelajaran adaptif untuk menawarkan optimasi yang efisien, Adam memasukkan regularisasi L2 dengan cara yang dapat menghambat performa. AdamW mengatasi hal ini dengan memisahkan weight decay dari pembaruan laju pembelajaran, memberikan pendekatan yang lebih efektif untuk model besar dan meningkatkan generalisasi. Weight decay, bentuk regularisasi L2, memberi penalti pada bobot besar dalam model. Adam memasukkan weight decay ke dalam proses pembaruan gradien, sedangkan AdamW menerapkannya secara terpisah setelah pembaruan gradien
Berikut beberapa cara lain mereka berbeda:
Meskipun keduanya dirancang untuk mengelola momentum dan menyesuaikan laju pembelajaran secara dinamis, keduanya berbeda secara mendasar dalam perlakuan terhadap weight decay.
Pada Adam, weight decay diterapkan secara tidak langsung sebagai bagian dari pembaruan gradien, yang secara tidak sengaja dapat mengubah dinamika pembelajaran dan mengganggu proses optimasi. AdamW, sebaliknya, memisahkan weight decay dari langkah gradien, memastikan regularisasi berdampak langsung pada parameter tanpa mengubah mekanisme pembelajaran adaptif.
Desain ini menghasilkan regularisasi yang lebih presisi, membantu model lebih baik melakukan generalisasi, khususnya pada tugas-tugas yang melibatkan dataset besar dan kompleks. Akibatnya, kedua optimizer ini sering kali memiliki kasus penggunaan yang sangat berbeda.
Adam berkinerja lebih baik pada tugas di mana regularisasi kurang krusial atau ketika efisiensi komputasi diprioritaskan dibanding generalisasi. Contohnya meliputi:
AdamW unggul pada skenario ketika overfitting menjadi perhatian dan ukuran model cukup besar. Misalnya:
Lalu mengapa memilih AdamW dibanding Adam? Sederhana. AdamW menawarkan beberapa manfaat kunci yang meningkatkan performanya, khususnya dalam skenario pemodelan yang kompleks.
AdamW mengatasi sejumlah keterbatasan yang ditemukan pada optimizer Adam, sehingga membuatnya lebih efektif dalam optimasi dan berkontribusi pada pelatihan model yang lebih baik serta lebih tangguh.
Berikut beberapa keunggulan yang menonjol:
Kekuatan inti AdamW terletak pada pendekatannya terhadap weight decay, yang dipisahkan dari pembaruan gradien adaptif khas Adam. Penyesuaian ini memastikan regularisasi diterapkan langsung pada bobot model, meningkatkan generalisasi tanpa berdampak negatif pada dinamika laju pembelajaran.
Optimizer ini dibangun di atas sifat adaptif Adam, mempertahankan manfaat momentum dan penyesuaian laju pembelajaran per-parameter. Penerapan weight decay secara independen mengatasi salah satu kelemahan utama Adam: kecenderungannya memengaruhi pembaruan gradien selama regularisasi. Pemisahan ini memungkinkan AdamW mempertahankan pembelajaran yang stabil, bahkan pada model yang kompleks dan skala besar, sekaligus menekan overfitting.
Pada bagian berikut, kita akan menelusuri teori di balik weight decay dan regularisasi serta matematika yang mendasari proses optimasi AdamW.
Regularisasi L2 adalah teknik untuk mencegah overfitting. Tujuannya dicapai dengan menambahkan suku penalti pada fungsi loss, yang menghalangi nilai bobot menjadi besar. Teknik ini membantu menciptakan model yang lebih sederhana dan lebih baik melakukan generalisasi ke data baru.
Pada optimizer tradisional, seperti Adam, weight decay diterapkan sebagai bagian dari pembaruan gradien, yang tanpa sengaja memengaruhi laju pembelajaran dan dapat menyebabkan performa suboptimal.
AdamW menyempurnakan ini dengan memisahkan weight decay dari perhitungan gradien. Dengan kata lain, alih-alih menerapkan weight decay selama pembaruan gradien, AdamW memperlakukannya sebagai langkah terpisah, menerapkannya langsung pada bobot setelah pembaruan gradien. Ini mencegah weight decay mengganggu proses optimasi, menghasilkan pelatihan yang lebih stabil dan generalisasi yang lebih baik.
AdamW memodifikasi optimizer Adam tradisional dengan mengubah cara penerapan weight decay. Persamaan inti untuk AdamW dapat direpresentasikan sebagai berikut:
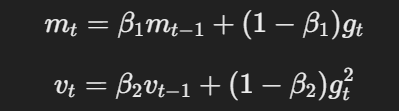
Persamaan untuk momentum dan laju pembelajaran adaptif
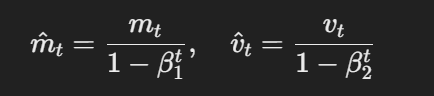
Rumus untuk estimasi terkoreksi bias
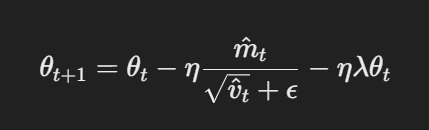
Pembaruan parameter dengan weight decay terpisah
Di sini, η adalah laju pembelajaran, λ adalah faktor weight decay, dan θt merepresentasikan parameter. Suku weight decay terpisah λθt memastikan regularisasi diterapkan secara independen dari pembaruan gradien, yang merupakan perbedaan utama dari Adam.
Mengimplementasikan AdamW di PyTorch itu mudah; bagian ini memberikan panduan komprehensif untuk menyiapkannya. Ikuti langkah-langkah berikut untuk mempelajari cara fine-tuning model secara efektif dengan Adam Optimizer.
Catatan: tutorial ini mengasumsikan Anda sudah memasang PyTorch. Lihat Dokumentasi untuk panduan apa pun.
Langkah 1: Impor pustaka yang diperlukan
import torch
import torch.nn as nn
import torch.optim as optim
Import torch.nn.functional as F
Langkah 2: Definisikan model
class SimpleCNN(nn.Module):
    def __init__(self):
        super(SimpleCNN, self).__init__()
        self.conv1 = nn.Conv2d(3, 32, kernel_size=3, stride=1, padding=1)
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
        self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
        self.fc1 = nn.Linear(64 * 8 * 8, 128)
        self.fc2 = nn.Linear(128, 10)

    def forward(self, x):
        x = self.pool(F.relu(self.conv1(x)))
        x = self.pool(F.relu(self.conv2(x)))
        x = x.view(-1, 64 * 8 * 8)
        x = F.relu(self.fc1(x))
        x = self.fc2(x)
Langkah 3: Tetapkan hiperparameter
learning_rate = 1e-4
weight_decay = 1e-2
num_epochs = 10 # number of epochs
Langkah 4: Inisialisasi optimizer AdamW dan siapkan fungsi loss
optimizer = optim.AdamW(model.parameters(), lr=learning_rate, weight_decay=weight_decay)
criterion = nn.CrossEntropyLoss()
Voila!
Sekarang Anda siap mulai melatih model CNN Anda, dan itulah yang akan kita lakukan di bagian berikutnya.
Di atas, kita telah mendefinisikan model, menetapkan hiperparameter, menginisialisasi optimizer (AdamW), dan menyiapkan fungsi loss.
Untuk melatih model, kita perlu mengimpor beberapa modul lagi;
from torch.utils.data import DataLoader # provides an iterable of the dataset
import torchvision
import torchvision.transforms as transforms
Selanjutnya, definisikan dataset dan dataloader. Untuk contoh ini, kita akan menggunakan dataset CIFAR-10:
# Define transformations for the training set
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)),
])
# Load CIFAR-10 dataset
train_dataset = torchvision.datasets.CIFAR10(root='./data', train=True, download=True, transform=transform)
val_dataset = torchvision.datasets.CIFAR10(root='./data', train=False, download=True, transform=transform)
# Create data loaders
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
val_loader = DataLoader(val_dataset, batch_size=32, shuffle=False)
Karena kita sudah mendefinisikan model, langkah berikutnya adalah mengimplementasikan training loop untuk mengoptimalkan model menggunakan AdamW.
Berikut tampilannya:
for epoch in range(num_epochs):
    model.train()  # Set the model to training mode
    running_loss = 0.0
    for inputs, labels in train_loader:
        optimizer.zero_grad()  # Clear gradients
        outputs = model(inputs)  # Forward pass
        loss = criterion(outputs, labels)  # Calculate loss
        loss.backward()  # Backward pass
        optimizer.step()  # Update weights
        running_loss += loss.item()
    print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {running_loss/len(train_loader):.4f}')
Langkah terakhir adalah memvalidasi performa model pada dataset validasi yang telah kita buat sebelumnya.
Berikut kodenya:
model.eval()  # Set the model to evaluation mode
correct = 0
total = 0
with torch.no_grad():
    for inputs, labels in val_loader:
        outputs = model(inputs)  # Forward pass
        _, predicted = torch.max(outputs.data, 1)  # Get predicted class
        total += labels.size(0)  # Update total samples
        correct += (predicted == labels).sum().item()  # Update correct predictions
accuracy = 100 * correct / total
print(f'Validation Accuracy: {accuracy:.2f}%')
Selesai.
Sekarang Anda tahu cara mengimplementasikan AdamW di PyTorch.
Baik, kita telah menetapkan bahwa AdamW populer karena pengelolaan weight decay yang lebih efektif daripada pendahulunya, Adam.
Lalu apa saja kasus penggunaan umum untuk optimizer ini?
Kita akan membahasnya di bagian ini…
AdamW sangat bermanfaat dalam melatih model besar seperti BERT, GPT, dan arsitektur transformer lainnya. Model-model seperti ini biasanya memiliki jutaan bahkan miliaran parameter, yang sering kali menuntut algoritme optimasi yang efisien untuk menangani pembaruan bobot yang kompleks dan tantangan generalisasi.
AdamW telah menjadi optimizer pilihan pada tugas visi komputer yang melibatkan CNN dan tugas NLP yang melibatkan transformer. Kemampuannya mencegah overfitting menjadikannya ideal untuk tugas yang melibatkan dataset besar dan arsitektur kompleks. Pemisahan weight decay berarti AdamW menghindari masalah yang ditemui Adam dalam melakukan over-regularizing pada model.
Penyetelan hiperparameter adalah proses memilih nilai terbaik untuk parameter yang mengatur pelatihan model pembelajaran mesin namun tidak dipelajari dari data itu sendiri. Parameter ini secara langsung memengaruhi bagaimana model dioptimalkan dan melakukan konvergensi.
Penyetelan yang tepat atas hiperparameter ini pada AdamW sangat penting untuk mencapai pelatihan yang efisien, menghindari overfitting, dan memastikan model melakukan generalisasi dengan baik ke data yang belum terlihat.
Pada bagian ini, kita akan mengeksplorasi cara fine-tuning hiperparameter kunci AdamW untuk performa optimal.
Learning rate adalah hiperparameter yang mengontrol seberapa besar penyesuaian bobot model terhadap gradien loss pada setiap langkah pelatihan. Learning rate yang lebih tinggi mempercepat pelatihan tetapi dapat menyebabkan model melampaui bobot optimal, sementara laju yang lebih rendah memungkinkan penyesuaian lebih halus namun dapat memperlambat pelatihan atau membuatnya terjebak pada local minima.
Weight decay, di sisi lain, adalah teknik regularisasi yang digunakan untuk mencegah overfitting dengan memberi penalti pada bobot besar dalam model. Tepatnya, weight decay menambahkan penalti kecil yang proporsional dengan ukuran bobot model selama pelatihan, membantu mengurangi kompleksitas model dan meningkatkan generalisasi ke data baru.
Untuk memilih nilai learning rate dan weight decay yang optimal untuk AdamW:
AdamW muncul sebagai salah satu optimizer paling efektif dalam deep learning, khususnya untuk model skala besar. Hal ini karena kemampuannya memisahkan weight decay dari pembaruan gradien. Tepatnya, desain AdamW meningkatkan regularisasi dan membantu model melakukan generalisasi lebih baik, terutama saat menangani arsitektur kompleks dan dataset yang luas.
Seperti ditunjukkan dalam tutorial ini, mengimplementasikan AdamW di PyTorch itu mudah—hanya memerlukan beberapa penyesuaian dari Adam. Namun, penyetelan hiperparameter tetap menjadi langkah krusial untuk memaksimalkan efektivitas AdamW. Menemukan keseimbangan yang tepat antara learning rate dan weight decay sangat penting untuk memastikan optimizer bekerja efisien tanpa menyebabkan overfitting atau underfitting pada model.
Sekarang Anda sudah cukup tahu untuk mengimplementasikan AdamW pada model Anda sendiri. Untuk melanjutkan pembelajaran, lihat beberapa sumber berikut:
Kursus Teratas DataCamp
Kursus
Program
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt





