
Cursus
Intermediate Deep Learning with PyTorch
4 uur
29.9K
Optimalisatie-algoritmen spelen een cruciale rol in deep learning: ze finetunen modelgewichten om verliesfuncties tijdens het trainen te minimaliseren. Een van deze algoritmen is de Adam-optimizer.
Adam werd enorm populair in deep learning dankzij de combinatie van de voordelen van momentum en adaptieve leersnelheden. Hierdoor is het zeer efficiënt voor het trainen van diepe neurale netwerken. Het vereist ook minimale afstemming van hyperparameters, waardoor het breed inzetbaar en effectief is voor uiteenlopende taken.
In 2017 introduceerden Ilya Loshchilov en Frank Hutter een geavanceerdere versie van het populaire Adam-algoritme in hun paper "Decoupled Weight Decay Regularization." Ze noemden het AdamW, dat opvalt doordat het weight decay loskoppelt van het gradiëntupdateproces. Deze scheiding is een cruciale verbetering ten opzichte van Adam en helpt bij betere generalisatie van modellen.
AdamW is steeds belangrijker geworden in moderne deep-learningtoepassingen, met name bij grootschalige modellen. Dankzij het superieure vermogen om gewichtsupdates te reguleren, wordt het vaak gebruikt voor taken die hoge prestaties en stabiliteit vereisen.
In deze tutorial bespreken we de belangrijkste verschillen tussen Adam en AdamW, de verschillende use-cases, en geven we een stapsgewijze handleiding voor het implementeren van AdamW in PyTorch.
Adam en AdamW zijn beide adaptieve optimizers die veel worden gebruikt in deep learning. Het grote verschil is hoe ze gewichtregularisatie afhandelen, wat hun effectiviteit in verschillende scenario's beïnvloedt.
Hoewel Adam momentum en adaptieve leersnelheden combineert voor efficiënte optimalisatie, verwerkt het L2-regularisatie op een manier die de prestaties kan belemmeren. AdamW pakt dit aan door weight decay los te koppelen van de update van de leersnelheid, wat een effectievere aanpak biedt voor grote modellen en de generalisatie verbetert. Weight decay, een vorm van L2-regularisatie, straft grote gewichten in het model. Adam verwerkt weight decay in het gradiëntupdateproces, terwijl AdamW het afzonderlijk toepast na de gradiëntupdate
Hier zijn nog enkele manieren waarop ze verschillen:
Hoewel beide optimizers zijn ontworpen om momentum te beheren en leersnelheden dynamisch aan te passen, verschillen ze fundamenteel in hun behandeling van weight decay.
Bij Adam wordt weight decay indirect toegepast als onderdeel van de gradiëntupdate, wat onbedoeld de leerdynamiek kan wijzigen en het optimalisatieproces kan verstoren. AdamW daarentegen scheidt weight decay van de gradiëntstap, zodat regularisatie direct invloed heeft op de parameters zonder het adaptieve leermechanisme te veranderen.
Dit ontwerp leidt tot preciezere regularisatie, waardoor modellen beter generaliseren, met name bij taken met grote en complexe datasets. Als gevolg daarvan hebben de twee optimizers vaak heel verschillende use-cases.
Adam presteert beter bij taken waar regularisatie minder cruciaal is of wanneer rekenefficiëntie belangrijker is dan generalisatie. Voorbeelden:
AdamW blinkt uit in scenario's waar overfitting een zorg is en de modelgrootte aanzienlijk is. Bijvoorbeeld:
Waarom zou je AdamW boven Adam gebruiken? Simpel. AdamW biedt verschillende belangrijke voordelen die de prestaties verbeteren, vooral in complexe modelscenario's.
Het pakt enkele beperkingen van de Adam-optimizer aan, waardoor het effectiever optimaliseert en bijdraagt aan verbeterde training en robuustheid van modellen.
Hier zijn enkele van de opvallende voordelen:
De kernkracht van AdamW ligt in de aanpak van weight decay, die is losgekoppeld van de adaptieve gradiëntupdates die kenmerkend zijn voor Adam. Deze aanpassing zorgt dat regularisatie direct wordt toegepast op de gewichten van het model, waardoor de generalisatie verbetert zonder de dynamiek van de leersnelheid negatief te beïnvloeden.
De optimizer bouwt voort op het adaptieve karakter van Adam en behoudt de voordelen van momentum en leersnelheidsaanpassingen per parameter. Weight decay onafhankelijk toepassen pakt een van de belangrijkste tekortkomingen van Adam aan: de neiging om gradiëntupdates tijdens regularisatie te beïnvloeden. Deze scheiding stelt AdamW in staat een stabiel leerproces te behouden, zelfs in complexe en grootschalige modellen, terwijl overfitting binnen de perken blijft.
In de volgende secties verkennen we de theorie achter weight decay en regularisatie en de wiskunde die ten grondslag ligt aan het optimalisatieproces van AdamW.
L2-regularisatie is een techniek om overfitting te voorkomen. Dit gebeurt door een strafterm aan de verliesfunctie toe te voegen, waardoor grote gewichtswaarden worden ontmoedigd. Deze techniek helpt eenvoudigere modellen te creëren die beter generaliseren naar nieuwe data.
In traditionele optimizers, zoals Adam, wordt weight decay toegepast als onderdeel van de gradiëntupdate, wat onbedoeld de leersnelheden beïnvloedt en kan leiden tot suboptimale prestaties.
AdamW verbetert dit door weight decay los te koppelen van de gradiëntberekening. Met andere woorden: in plaats van weight decay tijdens de gradiëntupdate toe te passen, behandelt AdamW het als een aparte stap en past het direct toe op de gewichten na de gradiëntupdate. Dit voorkomt dat weight decay het optimalisatieproces verstoort, wat leidt tot stabielere training en betere generalisatie.
AdamW wijzigt de traditionele Adam-optimizer door te veranderen hoe weight decay wordt toegepast. De kernvergelijkingen voor AdamW kunnen als volgt worden weergegeven:
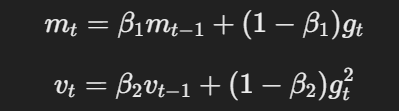
De vergelijking voor momentum en adaptieve leersnelheid
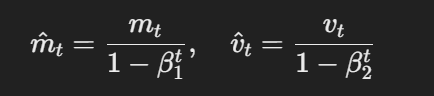
De formule voor bias-gecorrigeerde schattingen
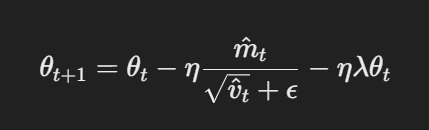
Parameterupdate met losgekoppelde weight decay
Hier is η de leersnelheid, λ de weight-decayfactor en θt de parameters. Deze losgekoppelde weight-decayterm λθt zorgt ervoor dat regularisatie onafhankelijk van de gradiëntupdate wordt toegepast, wat het belangrijkste verschil met Adam is.
AdamW implementeren in PyTorch is eenvoudig; deze sectie geeft een uitgebreide gids voor het opzetten. Volg deze stappen om te leren hoe je modellen effectief finetunet met Adam Optimizer.
Let op: deze tutorial gaat ervan uit dat je PyTorch al hebt geïnstalleerd. Raadpleeg de documentatie voor eventuele hulp.
Stap 1: Importeer de benodigde libraries
import torch
import torch.nn as nn
import torch.optim as optim
Import torch.nn.functional as F
Stap 2: Definieer het model
class SimpleCNN(nn.Module):
    def __init__(self):
        super(SimpleCNN, self).__init__()
        self.conv1 = nn.Conv2d(3, 32, kernel_size=3, stride=1, padding=1)
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
        self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
        self.fc1 = nn.Linear(64 * 8 * 8, 128)
        self.fc2 = nn.Linear(128, 10)

    def forward(self, x):
        x = self.pool(F.relu(self.conv1(x)))
        x = self.pool(F.relu(self.conv2(x)))
        x = x.view(-1, 64 * 8 * 8)
        x = F.relu(self.fc1(x))
        x = self.fc2(x)
Stap 3: Stel de hyperparameters in
learning_rate = 1e-4
weight_decay = 1e-2
num_epochs = 10 # number of epochs
Stap 4: Initialiseer de AdamW-optimizer en stel de verliesfunctie in
optimizer = optim.AdamW(model.parameters(), lr=learning_rate, weight_decay=weight_decay)
criterion = nn.CrossEntropyLoss()
Voilà!
Nu ben je klaar om je CNN-model te trainen, en dat is precies wat we in de volgende sectie gaan doen.
Hierboven hebben we het model gedefinieerd, de hyperparameters ingesteld, de optimizer (AdamW) geïnitialiseerd en de verliesfunctie ingesteld.
Om het model te trainen, moeten we nog een paar modules importeren;
from torch.utils.data import DataLoader # provides an iterable of the dataset
import torchvision
import torchvision.transforms as transforms
Definieer vervolgens de dataset en de dataloaders. Voor dit voorbeeld gebruiken we de CIFAR-10-dataset:
# Define transformations for the training set
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)),
])
# Load CIFAR-10 dataset
train_dataset = torchvision.datasets.CIFAR10(root='./data', train=True, download=True, transform=transform)
val_dataset = torchvision.datasets.CIFAR10(root='./data', train=False, download=True, transform=transform)
# Create data loaders
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
val_loader = DataLoader(val_dataset, batch_size=32, shuffle=False)
Aangezien we ons model al hebben gedefinieerd, is de volgende stap het implementeren van de trainingslus om het model te optimaliseren met AdamW.
Zo ziet dat eruit:
for epoch in range(num_epochs):
    model.train()  # Set the model to training mode
    running_loss = 0.0
    for inputs, labels in train_loader:
        optimizer.zero_grad()  # Clear gradients
        outputs = model(inputs)  # Forward pass
        loss = criterion(outputs, labels)  # Calculate loss
        loss.backward()  # Backward pass
        optimizer.step()  # Update weights
        running_loss += loss.item()
    print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {running_loss/len(train_loader):.4f}')
De laatste stap is de prestaties van het model valideren op de validatieset die we eerder hebben gemaakt.
Hier is de code:
model.eval()  # Set the model to evaluation mode
correct = 0
total = 0
with torch.no_grad():
    for inputs, labels in val_loader:
        outputs = model(inputs)  # Forward pass
        _, predicted = torch.max(outputs.data, 1)  # Get predicted class
        total += labels.size(0)  # Update total samples
        correct += (predicted == labels).sum().item()  # Update correct predictions
accuracy = 100 * correct / total
print(f'Validation Accuracy: {accuracy:.2f}%')
En dat is het.
Je weet nu hoe je AdamW in PyTorch implementeert.
Oké, we hebben vastgesteld dat AdamW populair werd door de effectievere behandeling van weight decay dan zijn voorganger Adam.
Maar wat zijn nu veelvoorkomende use-cases voor deze optimizer?
Daar gaan we in deze sectie op in…
AdamW is bijzonder nuttig bij het trainen van grote modellen zoals BERT, GPT en andere transformer-architecturen. Dergelijke modellen hebben doorgaans miljoenen of zelfs miljarden parameters en vereisen dus efficiënte optimalisatie-algoritmen die complexe gewichtsupdates en generalisatie-uitdagingen aankunnen.
AdamW is uitgegroeid tot de optimizer bij uitstek in computervisiontaken met CNN's en NLP-taken met transformers. Het vermogen om overfitting te voorkomen maakt het ideaal voor taken met grote datasets en complexe architecturen. Door het loskoppelen van weight decay vermijdt AdamW de problemen die Adam ervaart met over-regularisatie van modellen.
Hyperparametertuning is het proces van het kiezen van de beste waarden voor parameters die het trainen van een machinelearningmodel sturen, maar niet uit de data zelf worden geleerd. Deze parameters beïnvloeden direct hoe het model optimaliseert en convergeert.
Een goede afstemming van deze hyperparameters in AdamW is essentieel voor efficiënte training, het vermijden van overfitting en het waarborgen dat het model goed generaliseert naar onzichtbare data.
In deze sectie bespreken we hoe je de belangrijkste hyperparameters van AdamW fijnstemt voor optimale prestaties.
De leersnelheid is een hyperparameter die bepaalt hoeveel de modelgewichten worden aangepast ten opzichte van de verliesgradiënt tijdens elke trainingsstap. Een hogere leersnelheid versnelt de training maar kan ervoor zorgen dat het model de optimale gewichten overschiet, terwijl een lagere snelheid fijnere aanpassingen mogelijk maakt maar de training kan vertragen of in lokale minima kan vastlopen.
Weight decay is daarentegen een regularisatietechniek om overfitting te voorkomen door grote gewichten in het model te bestraffen. Concreet voegt weight decay tijdens de training een kleine straf toe die evenredig is met de grootte van de modelgewichten, wat helpt de modelcomplexiteit te verminderen en de generalisatie naar nieuwe data te verbeteren.
Zo kies je optimale leersnelheden en weight-decaywaarden voor AdamW:
AdamW is uitgegroeid tot een van de meest effectieve optimizers in deep learning, vooral voor grootschalige modellen. Dit komt door het vermogen om weight decay los te koppelen van gradiëntupdates. Het ontwerp van AdamW verbetert de regularisatie en helpt modellen beter te generaliseren, met name bij complexe architecturen en omvangrijke datasets.
Zoals in deze tutorial is getoond, is het implementeren van AdamW in PyTorch eenvoudig—het vereist slechts een paar aanpassingen ten opzichte van Adam. Hyperparametertuning blijft echter cruciaal om de effectiviteit van AdamW te maximaliseren. De juiste balans vinden tussen leersnelheid en weight decay is essentieel om te zorgen dat de optimizer efficiënt werkt zonder over- of onderfitting.
Je weet nu genoeg om AdamW in je eigen modellen te implementeren. Ga verder met leren via deze resources:
Topcursussen op DataCamp
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

