
{count, plural, one {Kursus} other {Kursus}}
Pengantar Deep Learning dengan PyTorch
{hours} jam
92.2K
Adam, singkatan dari Adaptive Moment Estimation, adalah algoritma optimisasi populer yang digunakan dalam machine learning dan, paling sering, di deep learning.
Adam menggabungkan gagasan utama dari dua teknik optimisasi tangguh lainnya: momentum dan RMSprop. Disebut adaptif karena menyesuaikan laju pembelajaran (learning rate) untuk setiap parameter.
Berikut fitur dan keunggulan utamanya:
Singkatnya, Adam membuat model belajar lebih efisien dengan terus menyesuaikan learning rate tiap parameter dan, sebagai konsekuensinya, cenderung konvergen jauh lebih cepat dibanding stochastic gradient descent standar. Untuk banyak aplikasi deep learning, ini adalah pilihan default yang kuat.
Adam memadukan gagasan kunci dari beberapa algoritma optimisasi penting lainnya, memperkuat kelebihannya sekaligus mengatasi kekurangannya. Kita perlu meninjaunya sebelum memahami intuisi di balik Adam dan mengimplementasikannya di Python.
Untuk memahami intuisi di balik algoritma optimisasi ini, mari lanjutkan analogi dari pendahuluan.
Bayangkan Anda bermata tertutup di wilayah perbukitan yang rumit. Tugas Anda adalah menemukan titik terendah di medan tersebut. Tingkat “kebukitan” medan merepresentasikan loss function dari model machine learning. Titik “terendah” keseluruhan (minimum global) adalah solusi optimal sistem.
Sekarang, mari hubungkan: Posisi Anda saat ini di medan merepresentasikan keadaan parameter model saat ini. Ketinggian di setiap titik merepresentasikan nilai loss untuk parameter tersebut. Cara Anda bernavigasi juga berkaitan dengan penyesuaian parameter model secara matematis.
Setiap algoritma optimisasi adalah strategi untuk menavigasi lanskap masalah ini dengan sukses, membimbing pemecah masalah ke mana harus melangkah berikutnya dan seberapa besar langkahnya. Beberapa algoritma memindai seluruh area sebelum memutuskan langkah berikutnya, sementara yang lain mengandalkan informasi terbatas agar lebih cepat.
Ada juga algoritma yang menggunakan alat seperti momentum dan adaptasi ukuran langkah; pemecah masalah yang baik tahu kapan harus “menekan gas” dan kapan harus mengendur.
Gradient descent adalah “kitab suci” optimisasi dalam machine learning, karena menjadi fondasi bagi banyak algoritma lainnya.
Jika Anda menggunakan Gradient Descent (GD), Anda dengan saksama meraba seluruh area di sekitar Anda (menggunakan seluruh dataset) sebelum mengambil setiap langkah. Pemeriksaan menyeluruh ini memungkinkan Anda membuat keputusan yang sangat akurat tentang arah turunan, tetapi memakan banyak waktu. Anda selalu bergerak ke arah turunan tercuram, artinya Anda konsisten menuju tempat yang lebih rendah. Namun, jika mencapai lekukan kecil (minimum lokal), Anda bisa terjebak di sana, tak mampu mendeteksi bahwa ada titik yang lebih rendah di tempat lain.
Fitur utama GD:
Dalam skenario ini, Anda terburu-buru dan tak punya waktu untuk meraba seluruh area di sekitar Anda. Sebagai gantinya, Anda memeriksa hanya satu titik acak dekat kaki Anda (satu data point). Ini membuat setiap langkah lebih cepat tetapi kurang akurat. Anda juga bisa memeriksa kumpulan kecil titik, yang dikenal sebagai mini-batch gradient descent, yang akan kita bahas lebih lanjut.
Jalur Anda lebih acak daripada gradient descent; kadang terlihat seperti jalur pelaut mabuk. Sesekali Anda bisa naik bukit. Jalur berisik ini justru bisa menjadi keunggulan terbesar: Anda sangat mungkin lolos dari minimum lokal.
Namun saat semakin dekat ke dasar, Anda perlu mengambil langkah lebih kecil (menurunkan learning rate) untuk menghindari melampaui titik terendah.
Fitur utama SGD:
Catatan: Pada titik ini, saya sangat menyarankan membaca artikel terpisah kami tentang GD dan SGD, karena membahas detail dua algoritma krusial ini dengan jauh lebih mendalam. Ini juga akan membantu Anda memahami bagian pengodean berikutnya dengan lebih jelas.
Sekarang Anda berada di atas skateboard di antara perbukitan. Saat Anda mendorong ke suatu arah, momentum skateboard membuat Anda terus bergerak ke arah yang sama untuk sementara waktu.
Momentum ini seperti rata-rata bergerak dari arah Anda sebelumnya. Ini membantu Anda melewati tonjolan kecil dan cekungan lokal, bahkan mungkin membantu Anda menemukan titik yang lebih rendah di kejauhan.
Jika Anda telah bergerak ke suatu arah untuk beberapa saat, momentum terakumulasi dan Anda melaju lebih cepat. Dengan begitu, Anda bisa konvergen ke titik terendah lebih cepat, terutama di medan dengan kemiringan turun yang konsisten.
Fitur utama SGD dengan Momentum:
Bayangkan Anda memiliki sepatu berteknologi tinggi yang dapat menyesuaikan cengkeramannya berdasarkan medan yang Anda lalui. Sepatu ini melacak gradien permukaan tanah di setiap arah, menyimpan rata-rata eksponensial yang meluruh dari gradien yang dikuadratkan. Di area dengan kemiringan yang sering berubah, sepatu memberi cengkeraman lebih besar, memungkinkan Anda melangkah lebih kecil dan hati-hati. Di area yang lebih mulus dengan kemiringan konsisten, sepatu memberi langkah yang lebih panjang.
“Ukuran langkah” adaptif ini membantu Anda menavigasi lereng curam maupun landai secara efektif, mencegah Anda mengambil langkah terlalu besar di area curam atau terlalu kecil di area datar.
Fitur utama RMSprop:
Adam ibarat menggabungkan skateboard Anda (momentum) dengan sepatu adaptif (RMSprop) dan menambahkan sistem navigasi pintar.
Bagian skateboard (momentum) membuat Anda tetap bergerak ke arah yang benar secara umum. Ini berarti di area menurun yang halus dan konsisten, Adam memungkinkan Anda bergerak cepat. Di medan yang rumit dan berubah-ubah, ia membantu Anda mempertahankan kecepatan stabil namun hati-hati.
Sepatu adaptif (RMSprop) merasakan ke mana Anda bergerak dan menyesuaikan cengkeraman skateboard. Sistem navigasi pintar (koreksi bias) dalam Adam sangat penting pada awal perjalanan, ketika Anda mulai dari titik acak dan belum banyak tahu tentang medannya.
Kombinasi atribut ini menjelaskan mengapa Adam sering menemukan titik terendah (solusi masalah) dengan sangat efisien dan mengapa strukturnya dapat menangani berbagai jenis medan (berbagai jenis masalah machine learning) dengan baik.
Fitur utama Adam:
Seperti yang Anda lihat, setiap algoritma yang disebutkan membangun di atas yang sebelumnya, dengan tujuan mengoptimalkan proses menemukan titik terendah dengan mengatasi berbagai tantangan dalam aneka jenis masalah optimisasi.
Sebelum masuk ke detail implementasi Adam dan algoritma lain yang disebutkan, berikut ringkasan tabel yang membandingkan waktu jalan dan kinerja RMSE masing-masing pada contoh masalah regresi:
import pandas as pd
# Disable scientific notation
pd.set_option("display.float_format", "{:.4f}".format)
comparison_table = pd.read_csv('optimization_results.csv')
comparison_table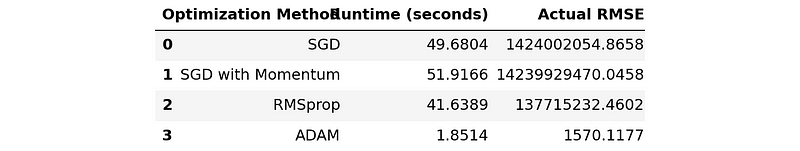
Tabel ini belum sepenuhnya menggambarkan perbedaan besar antara Adam dan yang lain, jadi mari kita buat bagan batang:
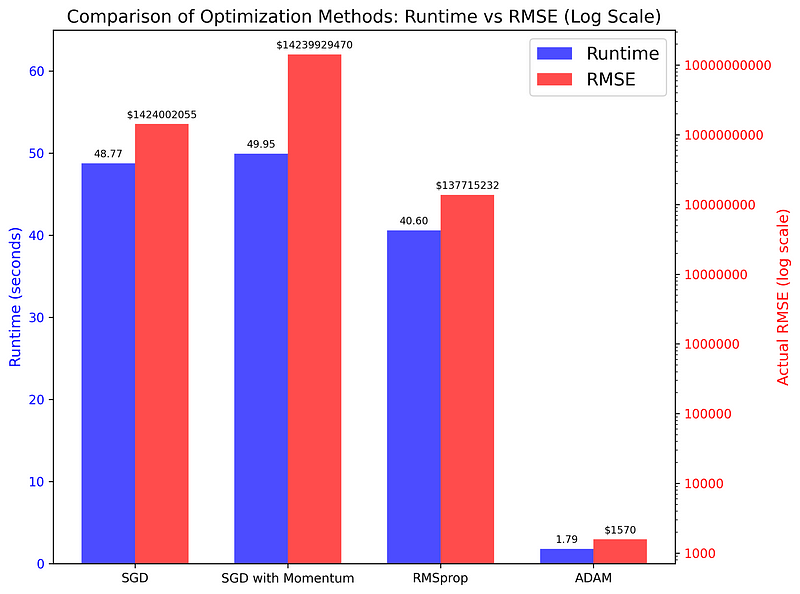
Plot membandingkan waktu jalan dan skor RMSE dari empat algoritma pada tugas regresi sederhana. Seperti terlihat, perbedaannya luar biasa (ingat, sumbu kanan berskala logaritmik), menunjukkan bahwa Adam adalah pilihan unggul untuk sebagian besar tugas optimisasi.
Kita akan melihat kode yang menghasilkan tabel dan plot ini nanti.
Sekarang setelah kita membahas konsep prasyarat untuk Adam dan intuisinya, kita bisa mulai mengimplementasikannya di Python. Sepanjang jalan, kita akan menjelaskan matematika yang diperlukan untuk memahami implementasinya. Kita akan membangun kode selangkah demi selangkah, dimulai dari Stochastic Gradient Descent.
Sebelumnya, kami menyebutkan bahwa SGD hanya menggunakan satu data point untuk memutuskan ke mana harus melangkah berikutnya. Dalam praktiknya, versi vanilla SGD ini jarang digunakan karena hasilnya bisa berisik (jalurnya di perbukitan tidak menentu).
Untuk mengatasinya, para profesional sering menggunakan variasi bernama Mini-Batch Gradient Descent yang menggunakan batch data point, misalnya 32, 64, atau 128, sebelum mengambil setiap langkah (ini seperti memindai jalur sempit alih-alih pandangan 360 derajat sebelum melangkah).
Jadi, kita akan membangun kode dasar untuk Adam dengan versi SGD ini.
Agar kode sesederhana mungkin, kita pilih masalah regresi kecil: memprediksi harga berlian berdasarkan ukuran karatnya.
Mari impor pustaka yang diperlukan terlebih dahulu:
import seaborn as sns
import numpy as np
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
np.random.seed(42)
Berikutnya, kita memuat dataset Diamonds dari Seaborn, mengambil sampel darinya, dan membangun array fitur dan target:
# Load the data
dataset_size = 20_000
diamonds = sns.load_dataset("diamonds")
# Extract the target and the feature
xy = diamonds[["carat", "price"]].values
np.random.shuffle(xy)  # Shuffle the data
xy = xy[:dataset_size]
xy.shape
Output:
(20000, 2)Regresi linear mengharuskan kita menormalkan data:
# Normalize the data
mean = np.mean(xy, axis=0)
std = np.std(xy, axis=0)
xy_normalized = (xy - mean) / std
Sekarang, kita dapat membagi data untuk membuat set pelatihan dan pengujian:
# Split the data
train_size = int(0.8 * dataset_size)
train_xy, test_xy = xy[:train_size], xy[train_size:]
train_xy.shape
(16000, 2)Untuk menyelesaikan tugas, kita punya beragam model, namun agar sederhana kita pilih Simple Linear Regression dan mendefinisikannya sebagai fungsi:
def model(m, x, b):
   """
   Simple Linear Regression: f(x) = m * x + b, where
   - x: diamond carat
   - m: price increase per carat
   - b: base diamond price
   - f(x): predicted diamond price
   """

   return m * x + b
Model Regresi Linear kita hanya memiliki dua parameter, m dan b, jadi tugas untuk SGD (dan nanti, untuk Adam) adalah menemukan nilai optimalnya.
Kita juga harus mendefinisikan loss function, Mean Squared Error, yang akan diminimalkan oleh algoritma kita:
def mean_squared_error(y_true, y_pred):
   """
   MSE as a loss function. It is defined as:
   Loss = (1/n) * Σ((y - f(x))²), where:
   - n: the length of the dataset
   - y: the true diamond price
   - f(x): predicted diamond price, i.e. m*x + b
   """
   return np.mean((y_true - y_pred) ** 2)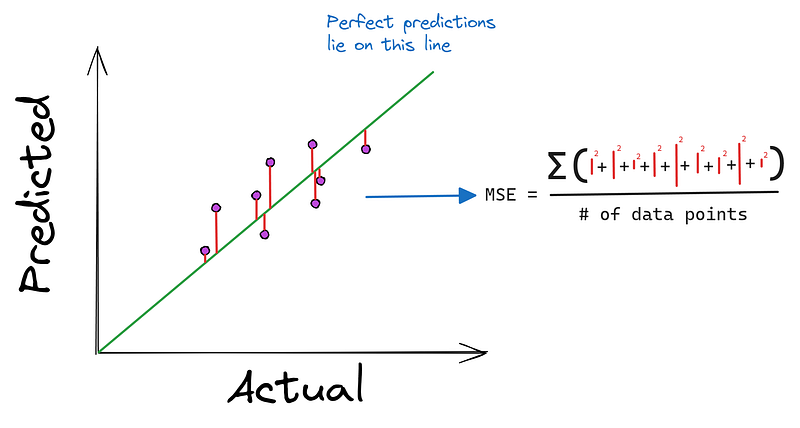
Sekarang, kita mendefinisikan fungsi bernama stochastic_gradient_descent yang menerima enam argumen:
x dan y merepresentasikan satu fitur dan target dalam masalah kita.epochs menunjukkan berapa kali kita ingin melakukan penurunan (lebih lanjut nanti).learning_rate adalah ukuran langkah.batch_size untuk mengendalikan seberapa sering kita memperbarui parameterstopping_threshold menetapkan nilai minimum penurunan loss pada setiap langkahdef stochastic_gradient_descent(
x, y, epochs=100, learning_rate=0.01, batch_size=32, stopping_threshold=1e-6
):
"""
SGD with support for mini-batches.
"""
# Initialize the model parameters randomly
m = np.random.randn()
b = np.random.randn()
n = len(x) # The number of data points
previous_loss = np.infDi dalam fungsi, pertama-tama kita inisialisasi parameter yang ingin dioptimalkan dengan nilai acak (memulai di lokasi acak di perbukitan). Kita juga menetapkan loss awal ke tak hingga, mewakili status masalah yang belum terpecahkan.
Lalu, kita memulai loop for yang berjalan selama epochs iterasi. Di dalam loop, kita mengacak data untuk mencegah pembelajaran pola yang bergantung urutan dalam data:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       # Shuffle the data
       indices = np.random.permutation(n)
       x = x[indices]
       y = y[indices]
Kemudian, kita memulai loop lain yang dikendalikan oleh parameter batch_size dan mengekstrak batch saat ini:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           x_batch = x[j:j + batch_size]
           y_batch = y[j:j + batch_size]
Di dalam loop bagian dalam ini, kita menghitung gradien (turunan parsial) untuk kedua parameter (menunjukkan ke mana kita perlu melangkah berikutnya):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Make predictions with current m, b
           y_pred = model(m, x_batch, b)
           # Compute the gradients
           m_gradient = 2 * np.mean(x_batch * (y_batch - y_pred))
           b_gradient = 2 * np.mean(y_batch - y_pred)
Setelah menghitung gradien, ada langkah penting yaitu clipping gradien:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           clip_value = 1.0
           m_gradient = np.clip(m_gradient, -clip_value, clip_value)
           b_gradient = np.clip(b_gradient, -clip_value, clip_value)
Gradient clipping mencegah masalah umum exploding gradients, di mana besaran gradien menuju tak hingga.
Setelah clipping, kita memperbarui parameter menggunakan learning rate (kita mengambil langkah ke arah gradien yang dikendalikan oleh learning rate):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           m -= learning_rate * m_gradient
           b -= learning_rate * b_gradient
Sekarang, di bawah loop induk (setelah semua batch dieksplor), kita menghitung loss untuk epoch saat ini (lihat seberapa jauh kita turun dari posisi awal):
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       y_pred = model(m, x, b)
       current_loss = loss(y, y_pred)
Jika loss epoch lebih kecil daripada stopping_threshold, kita hentikan seluruh proses:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       if abs(previous_loss - current_loss) < stopping_threshold:
           break
       previous_loss = current_loss
Pada akhirnya (setelah epoch habis atau ambang penghentian tercapai), kita mengembalikan m dan b, yang kini telah dioptimalkan:
def stochastic_gradient_descent(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update the model parameters
           ...
       # Compute the epoch loss
       ...
       # Check against the stopping threshold
       ...
return m, bSekarang, mari tambahkan momentum ke SGD. Kode versi ini tidak banyak berbeda dari versi mini-batch.
Kita mendefinisikan fungsi baru dengan parameter momentum:
def stochastic_gradient_descent_with_momentum(
       x, y, epochs=100, learning_rate=0.01, batch_size=32,
       stopping_threshold=1e-6, momentum=0.9
):
   """
   SGD with momentum and support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize velocity terms
   v_m = 0
   v_b = 0

   n = len(x)
   previous_loss = np.inf
Di dalam fungsi, kita akan mendefinisikan dua variabel lagi, v_m dan v_b, untuk melacak akumulasi gradien yang akan menjadi momentum kita. Kita set ke 0 terlebih dahulu, karena kita belum memiliki momentum di awal algoritma.
Selanjutnya, sisa kode sama hingga setelah kita melakukan clipping pada gradien:
def sgd_with_momentum(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Gradient clipping
           ...
           # Update velocity terms
           v_m = momentum * v_m + learning_rate * m_gradient
           v_b = momentum * v_b + learning_rate * b_gradient
           # Update the model parameters using velocity
           m -= v_m
           b -= v_b
Setelah gradien di-clipping, kita gunakan aturan pembaruan momentum untuk memodifikasi suku kecepatan. Berikut tampilan tingkat tingginya:
# Initialize
v_m = 0
v_b = 0
...
# Update velocity terms
v_m = momentum * v_m + learning_rate * m_gradient
v_b = momentum * v_b + learning_rate * b_gradient
# Update the model parameters using velocity
m -= v_m
b -= v_b
Kecepatan v_* mengakumulasi gradien seiring waktu. Artinya, jika kita bergerak ke arah yang konsisten, kita akan membangun kecepatan ke arah tersebut.
Di area di mana gradien berubah cepat (seperti lembah sempit pada lanskap loss), momentum membantu meredam osilasi. Kita mengembangkan inersia yang cukup untuk tidak terjebak dalam variasi lokal kecil seperti minimum lokal atau titik pelana.
Bagian momentum * v_m itulah yang mengakumulasi gradien. Misalnya, jika kita memiliki gradien positif besar, maka kecepatannya akan sama besarnya, dan pembaruan pada parameter menjadi lebih besar. Jadi, momentum 0,9 berarti kita mempertahankan 90% kecepatan perubahan sebelumnya untuk langkah berikutnya. Pada setiap langkah ke-N, kita akan menggunakan 90% dari total kecepatan gradien dari langkah N-1.
Pada titik ini, saya mendorong Anda untuk mencoba beberapa nilai acak untuk m dan b serta gradiennya dan gunakan aturan pembaruan momentum untuk melihat bagaimana parameter berubah saat Anda naik atau turun bukit.
Sekarang, mari lihat implementasi RMSprop. Seperti SGD dengan momentum, perubahan utama terjadi saat memperbarui parameter.
Pertama, kita mendefinisikan fungsi baru dengan dua parameter tambahan, beta dan epsilon (tanpa momentum):
def rmsprop_optimization(
   x, y, epochs=100, learning_rate=0.01, batch_size=32,
   stopping_threshold=1e-6, beta=0.9, epsilon=1e-8,
):
   """
   RMSprop optimization with support for mini-batches.
   """
   # Initialize the model parameters randomly
   m = np.random.randn()
   b = np.random.randn()
   # Initialize accumulators for squared gradients
   s_m = 0
   s_b = 0
   n = len(x)
   previous_loss = np.inf
Selain itu, di dalam fungsi kita membuat dua variabel baru untuk mengakumulasi gradien kuadrat, yaitu s_m dan s_b.
Sekarang, saat memasuki tahap pembaruan, kita menghitung ulang gradien kuadrat lalu memperbarui parameter:
def rmsprop_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # RMSprop doesn't need gradient clipping
           # Update accumulators
           s_m = beta * s_m + (1 - beta) * (m_gradient**2)
           s_b = beta * s_b + (1 - beta) * (b_gradient**2)
           # Update parameters
           m -= learning_rate * m_gradient / (np.sqrt(s_m) + epsilon)
           b -= learning_rate * b_gradient / (np.sqrt(s_b) + epsilon)
           # The rest of the code is the same
Di sini, kita melihat dua parameter baru digunakan:
epsilon adalah nilai kecil, biasanya 1e-8, untuk mencegah pembagian dengan nol saat melakukan pembaruan.beta adalah parameter laju peluruhan, biasanya sekitar 0,9.Parameter beta mengendalikan seberapa banyak riwayat yang kita pertimbangkan. Beta yang lebih tinggi berarti kita mengambil pandangan jangka lebih panjang atas gradien masa lalu, sedangkan beta lebih rendah membuat algoritma lebih responsif terhadap gradien terbaru.
Anda tidak perlu khawatir tentang matematika di balik aturan pembaruan RMSprop. Yang penting adalah logikanya.
Intinya, empat baris di atas melakukan hal berikut:
Dalam praktik, RMSprop sering berkinerja lebih baik daripada SGD dasar atau SGD dengan momentum, terutama untuk masalah optimisasi non-cembung yang sering ditemui di deep learning.
Sekali lagi, kita mendefinisikan fungsi baru:
def adam_optimization(
   x,
   y,
   epochs=100,
   learning_rate=0.001,
   batch_size=32,
   stopping_threshold=1e-6,
   beta1=0.9,
   beta2=0.999,
   epsilon=1e-8,
):
   """
   Adam optimization with support for mini-batches.
   """
   # Initialize the model parameters
   m = np.random.randn()
   b = np.random.randn()
   # Initialize first and second moment vectors
   m_m, v_m = 0, 0
   m_b, v_b = 0, 0
   n = len(x)
   previous_loss = np.inf
   t = 0  # Initialize timestep
Kali ini, kita mendefinisikan lima variabel baru untuk menangkap vektor momen pertama dan kedua serta langkah waktu. Dalam konteks Adam:
1. Vektor momen pertama (m):
2. Vektor momen kedua (v):
Selanjutnya, kodenya tetap sama hingga setelah kita menghitung gradien (kita tidak perlu clipping untuk Adam):
def adam_optimization(...):
   ...
   for i in range(epochs):
       ...
       for j in range(0, n, batch_size):
           # Extract the current batch
           ...
           # Compute the gradients
           ...
           # Adam doesn't need gradient clipping

           # Update biased first moment estimate
           m_m = beta1 * m_m + (1 - beta1) * m_gradient
           m_b = beta1 * m_b + (1 - beta1) * b_gradient
           # Update biased second raw moment estimate
           v_m = beta2 * v_m + (1 - beta2) * (m_gradient**2)
           v_b = beta2 * v_b + (1 - beta2) * (b_gradient**2)
           # Compute bias-corrected first moment estimate
           m_m_hat = m_m / (1 - beta1**t)
           m_b_hat = m_b / (1 - beta1**t)
           # Compute bias-corrected second raw moment estimate
           v_m_hat = v_m / (1 - beta2**t)
           v_b_hat = v_b / (1 - beta2**t)
           # Update parameters
           m -= learning_rate * m_m_hat / (np.sqrt(v_m_hat) + epsilon)
           b -= learning_rate * m_b_hat / (np.sqrt(v_b_hat) + epsilon)
       # The rest of the code is the same
Sekali lagi, jangan khawatir tentang baris-baris kode ini, karena melibatkan terlalu banyak matematika. Dalam praktik, Anda hampir tak pernah harus mengimplementasikan Adam dari nol karena yang Anda perlukan adalah intuisi di balik aturan pembaruannya.
Momen pertama bertindak seperti momentum, mengakumulasi gradien masa lalu untuk memberi optimisasi rasa arah dan kecepatan. Ini membantu Adam bergerak lebih cepat ke arah yang konsisten dan meredam osilasi pada lanskap gradien yang berisik.
Momen kedua, seperti pada RMSprop, menyesuaikan learning rate untuk tiap parameter. Ini secara efektif menormalkan pembaruan parameter, memperlambat pembelajaran untuk parameter dengan gradien besar dan mempercepatnya untuk yang bergradien kecil. Ini memungkinkan Adam menangani parameter pada skala berbeda secara efektif.
Adam juga memasukkan koreksi bias untuk rata-rata bergerak ini, yang sangat penting pada tahap awal pelatihan. Koreksi ini membantu Adam memulai dengan ukuran langkah yang lebih akurat, berpotensi menghasilkan kemajuan awal yang lebih cepat.
Dengan menggabungkan elemen-elemen ini, Adam sering mencapai konvergensi lebih cepat daripada metode optimisasi yang lebih sederhana. Ini sangat efektif pada masalah dengan gradien berisik, objektif yang tidak stasioner, atau dataset yang sangat besar. Sifat adaptif Adam membuatnya relatif tidak sensitif terhadap learning rate awal, sering kali membutuhkan penyetelan hiperparameter yang lebih sedikit dibanding metode lain.
Sekarang, mari lihat cara menghasilkan tabel ringkasan yang kita lihat sebelumnya:
comparison_table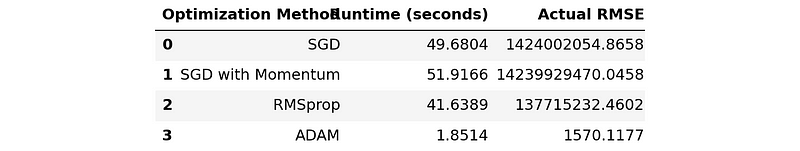
Kita mendefinisikan fungsi bernama run_optimization untuk melatih model regresi linear menggunakan fungsi optimisasi kita. Fungsi ini juga akan menangkap waktu jalan dan skor RMSE:
import time
def run_optimization(opt_func, x, y, **kwargs):
   # Start a timer
   start_time = time.time()

   # Run the optimization function
   m, b = opt_func(x, y, **kwargs)

   # End the timer
   end_time = time.time()
   # Run the model on the test set with found parameters
   y_preds = model(m, test_xy[:, 0], b)
   y_preds_denormalized = y_preds * std[1] + mean[1]
   y_true_denormalized = test_xy[:, 1] * std[1] + mean[1]

   # Compute MSE and RMSE
   actual_mse = np.mean((y_true_denormalized - y_preds_denormalized) ** 2)
   return end_time - start_time, np.sqrt(actual_mse)
Sekarang, kita akan memanggil fungsi ini empat kali untuk masing-masing fungsi optimisasi kita, menyimpan hasilnya ke dalam daftar di mana setiap item adalah tiga-tuple (nama algoritma, waktu jalan dalam detik, skor RMSE):
# Run all optimization methods
results = []
results.append(
   (
       "SGD",
       *run_optimization(
           stochastic_gradient_descent,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
       ),
   )
)
results.append(
   (
       "SGD with Momentum",
       *run_optimization(
           stochastic_gradient_descent_with_momentum,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.1,
           epochs=10000,
           batch_size=64,
           momentum=0.9,
       ),
   )
)
results.append(
   (
       "RMSprop",
       *run_optimization(
           rmsprop_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta=0.9,
           epsilon=1e-8,
       ),
   )
)
results.append(
   (
       "Adam",
       *run_optimization(
           adam_optimization,
           train_xy[:, 0],
           train_xy[:, 1],
           learning_rate=0.01,
           epochs=10000,
           batch_size=64,
           beta1=0.9,
           beta2=0.999,
           epsilon=1e-8,
       ),
   )
)
Untuk perbandingan yang adil, kita menjaga learning rate, jumlah epoch, dan ukuran batch tetap sama.
Setelah itu, kita dapat membuat tabel:
from tabulate import tabulate  # pip install tabulate
# Create and print the table
headers = ["Optimization Method", "Runtime (seconds)", "Actual RMSE"]
print(tabulate(results, headers=headers, floatfmt=".4f"))
# Save the table
pd.DataFrame(results, columns=headers).to_csv("optimization_results.csv", index=False)
Berikut hasil akhirnya:
Optimization Method      Runtime (seconds)       Actual RMSE
---------------------  -------------------  ----------------
SGD                                49.9305   1424002054.8658
SGD with Momentum                  50.7744  14239929470.0458
RMSprop                            41.9895    137715232.4602
Adam                                1.8462         1570.1177
Sebelum melanjutkan, saya mendorong Anda bereksperimen dengan parameter setiap fungsi optimisasi. Kemungkinan Anda dapat membuat masing-masing, terutama Adam, lebih cepat dan lebih akurat dengan menyesuaikan learning rate, menambah ukuran batch, atau mengendalikan bias.
Lihat bagian kesimpulan untuk tautan ke kode lengkap skrip perbandingan dan cara membuat plot yang kita lihat di awal.
Menggunakan Adam dalam praktik tidak memerlukan membaca artikel panjang seperti ini dan menulisnya dari nol sendiri. Implementasinya di PyTorch sudah sangat mumpuni untuk tugas pembelajaran terawasi apa pun dalam deep learning.
Berikut cuplikan singkat dan minimal yang menguraikan alur kerja PyTorch khas yang menggunakan optimizer Adam dari modul torch.optim:
# Import necessary modules
import torch
import torch.nn as nn
import torch.optim as optim
# Define your model
model = nn.Sequential(
   nn.Linear(10, 50),
   nn.ReLU(),
   nn.Linear(50, 1)
)
# Initialize Adam optimizer
optimizer = optim.Adam(model.parameters(), lr=0.001, betas=(0.9, 0.999), eps=1e-08, weight_decay=0)
# Training loop
for epoch in range(num_epochs):
   for batch in dataloader:
       # Zero the gradients
       optimizer.zero_grad()

       # Forward pass
       outputs = model(batch)
       loss = criterion(outputs, targets)

       # Backward pass
       loss.backward()

       # Update weights
       optimizer.step()
# Adjusting learning rate
scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=30, gamma=0.1)
for epoch in range(num_epochs):
   train(...)
   scheduler.step()
Untuk mempelajari lebih lanjut tentang penggunaan PyTorch secara umum dan algoritma optimisasinya, lihat kursus pengantar dari DataCamp berikut:
Dalam artikel ini, kita mempelajari seluk-beluk optimizer Adam yang populer. Kita mulai membangun intuisi terlebih dahulu, melalui pembahasan algoritma fondasionalnya seperti gradient descent, SGD, dan RMSprop. Kita melihat bagaimana Adam menggabungkan gagasan utama dari semuanya, menghasilkan algoritma yang sangat fleksibel dan berkinerja baik.
Lalu, kita membahas cara mengimplementasikan Optimizer Adam di Python hanya dengan NumPy. Seperti intuisinya, kita membangun kode dari algoritma dasar, dari mini-batch gradient descent melalui RMSprop hingga Adam. Kita juga menyaksikan perbedaan mencolok antara Adam dan algoritma lain dalam hal kecepatan dan performa dengan membuat skrip benchmarking sederhana.
Pada akhirnya, kita menunjukkan cara menggunakan Adam di PyTorch, seperti yang akan Anda lakukan dalam praktik, untuk menyelesaikan masalah deep learning. Berikut beberapa tautan ke skrip yang kita gunakan dalam tutorial:
Dan beberapa sumber terkait untuk mempelajari lebih lanjut tentang PyTorch dan fungsi optimisasinya:
Terima kasih telah membaca!
Kursus PyTorch Teratas
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt




