
Last chance! 50% off DataCamp Premium
Sale ends in
Optimizasyon algoritmaları derin öğrenmede hayati bir rol oynar: eğitim sırasında kayıp fonksiyonlarını en aza indirmek için model ağırlıklarını ince ayar yaparlar. Bu algoritmalardan biri de Adam optimize edicidir.
Adam, momentum ve uyarlanabilir öğrenme oranlarının avantajlarını birleştirme yeteneği sayesinde derin öğrenmede son derece popüler hale geldi. Bu da onu derin sinir ağlarının eğitimi için oldukça verimli kıldı. Ayrıca hiperparametre ayarı gereksinimi minimum düzeydedir; bu sayede çeşitli görevlerde yaygın olarak erişilebilir ve etkilidir.
2017’de Ilya Loshchilov ve Frank Hutter, "Decoupled Weight Decay Regularization" başlıklı makalelerinde popüler Adam algoritmasının daha gelişmiş bir sürümünü tanıttılar. Buna AdamW adını verdiler; ağırlık çürümesini gradyan güncelleme sürecinden ayırmasıyla öne çıkar. Bu ayrım, Adam’a kıyasla kritik bir iyileştirmedir ve modelin daha iyi genelleşmesine yardımcı olur.
AdamW, özellikle büyük ölçekli modelleri ele alırken modern derin öğrenme uygulamalarında giderek daha önemli hale geldi. Ağırlık güncellemelerini düzenleme konusundaki üstün yeteneği, yüksek performans ve kararlılık gerektiren görevlerde benimsenmesine katkıda bulundu.
Bu eğitimde Adam ve AdamW arasındaki temel farklılıklar ile farklı kullanım senaryolarına değinecek ve PyTorch’ta AdamW’nin adım adım nasıl uygulanacağını göstereceğiz.
Adam ve AdamW, derin öğrenmede yaygın olarak kullanılan uyarlanabilir optimize edicilerdir. Aralarındaki büyük fark, ağırlık düzenlemesini ele alış biçimleridir; bu da farklı senaryolardaki etkililiklerini etkiler.
Adam, momentum ve uyarlanabilir öğrenme oranlarını birleştirerek verimli optimizasyon sunarken, L2 düzenlemesini performansı engelleyebilecek bir biçimde içerir. AdamW, ağırlık çürümesini öğrenme oranı güncellemesinden ayırarak bunu çözer; bu da büyük modeller için daha etkili bir yaklaşım sunar ve genelleştirmeyi iyileştirir. Ağırlık çürümesi, L2 düzenlemesinin bir türüdür ve modeldeki büyük ağırlıkları cezalandırır. Adam ağırlık çürümesini gradyan güncelleme sürecine dahil ederken, AdamW bunu gradyan güncellemesinden sonra ayrı olarak uygular.
İşte farklılaştıkları bazı diğer noktalar:
Her iki optimize edici de momentumu yönetmek ve öğrenme oranlarını dinamik olarak ayarlamak için tasarlanmış olsa da, ağırlık çürümesini ele alışlarında temelden ayrışırlar.
Adam’da ağırlık çürümesi, gradyan güncellemesinin bir parçası olarak dolaylı biçimde uygulanır; bu da öğrenme dinamiklerini istemeden değiştirebilir ve optimizasyon sürecine müdahale edebilir. AdamW ise ağırlık çürümesini gradyan adımından ayırır; böylece düzenleme, uyarlanabilir öğrenme mekanizmasını değiştirmeden doğrudan parametreleri etkiler.
Bu tasarım, daha hassas bir düzenleme sağlar; özellikle büyük ve karmaşık veri kümeleri içeren görevlerde modellerin daha iyi genelleşmesine yardımcı olur. Bunun bir sonucu olarak iki optimize edici sıklıkla oldukça farklı kullanım alanlarına sahiptir.
Adam, düzenlemenin daha az kritik olduğu veya hesaplama verimliliğinin genelleştirmeye kıyasla önceliklendirildiği görevlerde daha iyi performans gösterir. Örnekler:
AdamW, aşırı öğrenmenin bir endişe olduğu ve model boyutunun büyük olduğu senaryolarda öne çıkar. Örneğin:
Peki neden biri Adam yerine AdamW kullanmak istesin? Basit. AdamW, özellikle karmaşık modelleme senaryolarında performansını artıran birkaç temel fayda sunar.
Adam optimize edicideki bazı sınırlamaları ele alır; böylece optimizasyonda daha etkili hale gelir ve model eğitimi ile sağlamlığının artmasına katkıda bulunur.
Öne çıkan diğer avantajlar şunlardır:
AdamW’nin temel gücü, Adam’a özgü uyarlanabilir gradyan güncellemelerinden ayrıştırılmış ağırlık çürümesine yaklaşımında yatar. Bu ayarlama, düzenlemenin doğrudan model ağırlıklarına uygulanmasını sağlar; böylece öğrenme oranı dinamiklerini olumsuz etkilemeden genelleştirmeyi iyileştirir.
Optimize edici, Adam’ın uyarlanabilir doğası üzerine inşa edilir; momentum ve parametre başına öğrenme oranı ayarlamalarının avantajlarını korur. Ağırlık çürümesini bağımsız uygulamak, Adam’ın temel eksikliklerinden birini giderir: düzenleme sırasında gradyan güncellemelerini etkileme eğilimi. Bu ayrım, AdamW’nin karmaşık ve büyük ölçekli modellerde bile istikrarlı öğrenmeyi sürdürmesine olanak tanır ve aşırı öğrenmeyi kontrol altında tutar.
Takip eden bölümlerde ağırlık çürümesi ve düzenleme arkasındaki teoriyi ve AdamW’nin optimizasyon sürecinin temelini oluşturan matematiği inceleyeceğiz.
L2 düzenlemesi, aşırı öğrenmeyi önlemek için kullanılan bir tekniktir. Bunu, kayıp fonksiyonuna bir ceza terimi ekleyerek, büyük ağırlık değerlerini caydırarak başarır. Bu teknik, yeni verilere daha iyi genelleşen daha basit modeller oluşturmaya yardımcı olur.
Adam gibi geleneksel optimize edicilerde ağırlık çürümesi, gradyan güncellemesinin bir parçası olarak uygulanır; bu da öğrenme oranlarını istemeden etkileyebilir ve optimal olmayan performansa yol açabilir.
AdamW, ağırlık çürümesini gradyan hesaplamasından ayırarak bunu iyileştirir. Başka bir deyişle, ağırlık çürümesini gradyan güncellemesi sırasında uygulamak yerine, AdamW bunu ayrı bir adım olarak ele alır ve gradyan güncellemesinden sonra doğrudan ağırlıklara uygular. Bu, ağırlık çürümesinin optimizasyon sürecine müdahale etmesini engeller; daha istikrarlı eğitim ve daha iyi genelleştirme sağlar.
AdamW, ağırlık çürümesinin uygulanma şeklini değiştirerek geleneksel Adam optimize ediciyi değiştirir. AdamW’nin çekirdek denklemleri şu şekilde temsil edilebilir:
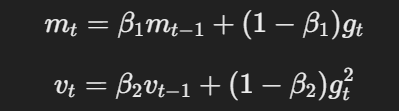
Momentum ve uyarlanabilir öğrenme oranı denklemi
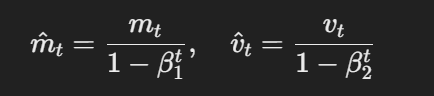
Önyargı düzeltilmiş tahminlerin formülü
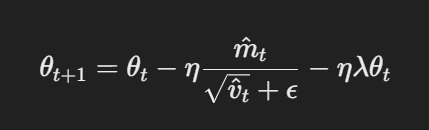
Ayrıştırılmış ağırlık çürümesiyle parametre güncellemesi
Burada η öğrenme oranını, λ ağırlık çürüme katsayısını ve θt parametreleri temsil eder. Bu ayrıştırılmış ağırlık çürüme terimi λθt, düzenlemenin gradyan güncellemesinden bağımsız olarak uygulanmasını sağlar; bu, Adam’dan temel farktır.
AdamW’nin PyTorch’ta uygulanması kolaydır; bu bölüm, kuruluma yönelik kapsamlı bir rehber sunar. Adam Optimize Edici ile modelleri etkili şekilde nasıl ince ayarlayacağınızı öğrenmek için şu adımları izleyin.
Not: bu eğitim, PyTorch’un halihazırda kurulu olduğunu varsayar. Her türlü yönlendirme için Belgelere bakın.
Adım 1: Gerekli kütüphaneleri içe aktarın
import torch
import torch.nn as nn
import torch.optim as optim
Import torch.nn.functional as F
Adım 2: Modeli tanımlayın
class SimpleCNN(nn.Module):
    def __init__(self):
        super(SimpleCNN, self).__init__()
        self.conv1 = nn.Conv2d(3, 32, kernel_size=3, stride=1, padding=1)
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
        self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
        self.fc1 = nn.Linear(64 * 8 * 8, 128)
        self.fc2 = nn.Linear(128, 10)

    def forward(self, x):
        x = self.pool(F.relu(self.conv1(x)))
        x = self.pool(F.relu(self.conv2(x)))
        x = x.view(-1, 64 * 8 * 8)
        x = F.relu(self.fc1(x))
        x = self.fc2(x)
Adım 3: Hiperparametreleri ayarlayın
learning_rate = 1e-4
weight_decay = 1e-2
num_epochs = 10 # number of epochs
Adım 4: AdamW optimize edicisini başlatın ve kayıp fonksiyonunu ayarlayın
optimizer = optim.AdamW(model.parameters(), lr=learning_rate, weight_decay=weight_decay)
criterion = nn.CrossEntropyLoss()
Voila!
Artık CNN modelinizi eğitmeye hazırsınız; bir sonraki bölümde bunu yapacağız.
Yukarıda modeli tanımladık, hiperparametreleri belirledik, optimize ediciyi (AdamW) başlattık ve kayıp fonksiyonunu kurduk.
Modeli eğitmek için birkaç modülü daha içe aktarmamız gerekecek;
from torch.utils.data import DataLoader # provides an iterable of the dataset
import torchvision
import torchvision.transforms as transforms
Sonra veri kümesini ve veri yükleyicileri tanımlayın. Bu örnekte CIFAR-10 veri kümesini kullanacağız:
# Define transformations for the training set
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)),
])
# Load CIFAR-10 dataset
train_dataset = torchvision.datasets.CIFAR10(root='./data', train=True, download=True, transform=transform)
val_dataset = torchvision.datasets.CIFAR10(root='./data', train=False, download=True, transform=transform)
# Create data loaders
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
val_loader = DataLoader(val_dataset, batch_size=32, shuffle=False)
Modelimizi zaten tanımladığımıza göre, bir sonraki adım AdamW kullanarak modeli optimize etmek için eğitim döngüsünü uygulamaktır.
İşte nasıl göründüğü:
for epoch in range(num_epochs):
    model.train()  # Set the model to training mode
    running_loss = 0.0
    for inputs, labels in train_loader:
        optimizer.zero_grad()  # Clear gradients
        outputs = model(inputs)  # Forward pass
        loss = criterion(outputs, labels)  # Calculate loss
        loss.backward()  # Backward pass
        optimizer.step()  # Update weights
        running_loss += loss.item()
    print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {running_loss/len(train_loader):.4f}')
Son adım, daha önce oluşturduğumuz doğrulama veri kümesi üzerinde modelin performansını doğrulamaktır.
Kod burada:
model.eval()  # Set the model to evaluation mode
correct = 0
total = 0
with torch.no_grad():
    for inputs, labels in val_loader:
        outputs = model(inputs)  # Forward pass
        _, predicted = torch.max(outputs.data, 1)  # Get predicted class
        total += labels.size(0)  # Update total samples
        correct += (predicted == labels).sum().item()  # Update correct predictions
accuracy = 100 * correct / total
print(f'Validation Accuracy: {accuracy:.2f}%')
Ve işte bu kadar.
Artık AdamW’yi PyTorch’ta nasıl uygulayacağınızı biliyorsunuz.
Tamam, AdamW’nin selefi Adam’a kıyasla ağırlık çürümesini daha etkili şekilde yönetmesi sayesinde popülerlik kazandığını ortaya koyduk.
Peki bu optimize edicinin yaygın kullanım alanları nelerdir?
Bu bölümde buna gireceğiz…
AdamW, BERT, GPT ve diğer transformer mimarileri gibi büyük modellerin eğitiminde özellikle faydalıdır. Bu tür modeller tipik olarak milyonlarca hatta milyarlarca parametreye sahiptir; bu da çoğu zaman karmaşık ağırlık güncellemelerini ve genelleştirme zorluklarını ele alabilen verimli optimizasyon algoritmalarına ihtiyaç duydukları anlamına gelir.
AdamW, CNN’leri içeren bilgisayarlı görü görevlerinde ve transformer’ları içeren NLP görevlerinde tercih edilen optimize edici haline geldi. Aşırı öğrenmeyi önleme yeteneği, büyük veri kümeleri ve karmaşık mimarileri içeren görevler için onu ideal kılar. Ağırlık çürümesinin ayrıştırılması, AdamW’nin, Adam’ın modelleri aşırı düzenleme sorunlarından kaçınmasını sağlar.
Hiperparametre ayarlama, bir makine öğrenimi modelinin eğitimini yöneten fakat verinin kendisinden öğrenilmeyen parametreler için en iyi değerlerin seçilmesi sürecidir. Bu parametreler, modelin nasıl optimize edildiğini ve yakınsadığını doğrudan etkiler.
AdamW’de bu hiperparametrelerin uygun şekilde ayarlanması, verimli eğitim sağlamak, aşırı öğrenmeden kaçınmak ve modelin görülmemiş verilere iyi genelleşmesini temin etmek için esastır.
Bu bölümde, en iyi performans için AdamW’nin temel hiperparametrelerini nasıl ince ayarlayacağımızı keşfedeceğiz.
Öğrenme oranı, her eğitim adımında kayıp gradyanına göre model ağırlıklarının ne kadar ayarlanacağını kontrol eden bir hiperparametredir. Daha yüksek bir öğrenme oranı eğitimi hızlandırır ancak modelin optimal ağırlıkları aşmasına neden olabilir; daha düşük bir oran daha ince ayarlara izin verir ancak eğitimi yavaşlatabilir veya yerel minimumlarda takılabilir.
Öte yandan ağırlık çürümesi, modeldeki büyük ağırlıkları cezalandırarak aşırı öğrenmeyi önlemek için kullanılan bir düzenleme tekniğidir. Yani, ağırlık çürümesi, eğitim sırasında model ağırlıklarının büyüklüğüyle orantılı küçük bir ceza ekler; bu da model karmaşıklığını azaltmaya ve yeni verilere genelleştirmeyi iyileştirmeye yardımcı olur.
AdamW için en uygun öğrenme oranlarını ve ağırlık çürümesi değerlerini seçmek üzere:
AdamW, özellikle büyük ölçekli modeller için derin öğrenmede en etkili optimize edicilerden biri olarak ortaya çıktı. Bu, ağırlık çürümesini gradyan güncellemelerinden ayırma yeteneği sayesindedir. Yani, AdamW’nin tasarımı düzenlemeyi iyileştirir ve özellikle karmaşık mimariler ve kapsamlı veri kümeleriyle çalışırken modellerin daha iyi genelleşmesine yardımcı olur.
Bu eğitimde gösterildiği gibi, AdamW’nin PyTorch’ta uygulanması basittir—Adam’dan yalnızca birkaç ayarlama gerektirir. Bununla birlikte, hiperparametre ayarlaması AdamW’nin etkinliğini en üst düzeye çıkarmak için kritik bir adımdır. Öğrenme oranı ile ağırlık çürümesi arasındaki doğru dengeyi bulmak, optimize edicinin modeli aşırı ya da yetersiz uyumlamadan verimli şekilde çalışmasını sağlamak için esastır.
Artık AdamW’yi kendi modellerinizde uygulayacak kadar bilgi sahibisiniz. Öğrenmeye devam etmek için şu kaynaklara göz atın:
En İyi DataCamp Kursları
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.





