
Last chance! 50% off DataCamp Premium
Sale ends in
डीप लर्निंग में ऑप्टिमाइज़ेशन एल्गोरिदम अहम भूमिका निभाते हैं: ये ट्रेनिंग के दौरान लॉस फ़ंक्शन को न्यूनतम करने के लिए मॉडल के वेट्स को फाइन-ट्यून करते हैं। ऐसा ही एक एल्गोरिदम है Adam optimizer.
मोमेंटम और एडैप्टिव लर्निंग रेट्स के फ़ायदे को जोड़ने की क्षमता के कारण Adam डीप लर्निंग में बेहद लोकप्रिय हुआ। इसने डीप न्यूरल नेटवर्क्स को ट्रेन करना अत्यंत कुशल बना दिया। साथ ही इसमें हाइपरपैरामीटर्स की न्यूनतम ट्यूनिंग की ज़रूरत होती है, जिससे यह विभिन्न कार्यों में व्यापक रूप से उपयोगी और प्रभावी बन जाता है।
2017 में, Ilya Loshchilov और Frank Hutter ने अपने पेपर "Decoupled Weight Decay Regularization." में लोकप्रिय Adam एल्गोरिदम का एक उन्नत संस्करण प्रस्तुत किया। उन्होंने इसे AdamW नाम दिया, जो वेट डिके को ग्रेडिएंट अपडेट प्रक्रिया से अलग करने के लिए जाना जाता है। यह पृथक्करण Adam की तुलना में एक महत्वपूर्ण सुधार है और बेहतर मॉडल जनरलाइज़ेशन में मदद करता है।
AdamW आधुनिक डीप लर्निंग अनुप्रयोगों में, विशेषकर बड़े पैमाने के मॉडलों को संभालने में, लगातार अधिक महत्वपूर्ण होता गया है। वेट अपडेट्स को नियंत्रित करने की इसकी बेहतर क्षमता ने उच्च प्रदर्शन और स्थिरता की मांग करने वाले कार्यों में इसके अपनाने में योगदान दिया है।
इस ट्यूटोरियल में, हम Adam और AdamW के बीच प्रमुख अंतर, उनके विभिन्न उपयोग मामलों पर चर्चा करेंगे, और PyTorch में AdamW को लागू करने के लिए चरण-दर-चरण मार्गदर्शिका प्रस्तुत करेंगे।
Adam और AdamW दोनों ही डीप लर्निंग में व्यापक रूप से उपयोग किए जाने वाले एडैप्टिव ऑप्टिमाइज़र हैं। उनके बीच बड़ा अंतर यह है कि वे वेट रेग्युलराइज़ेशन को कैसे हैंडल करते हैं, जो अलग-अलग परिदृश्यों में उनकी प्रभावशीलता को प्रभावित करता है।
जहां Adam मोमेंटम और एडैप्टिव लर्निंग रेट्स को जोड़कर प्रभावी ऑप्टिमाइज़ेशन देता है, वहीं यह L2 रेग्युलराइज़ेशन को ऐसे तरीके से शामिल करता है जो प्रदर्शन में बाधा डाल सकता है। AdamW इसे वेट डिके को लर्निंग रेट अपडेट से अलग करके संबोधित करता है, जो बड़े मॉडलों के लिए अधिक प्रभावी दृष्टिकोण देता है और जनरलाइज़ेशन में सुधार करता है। वेट डिके, जो L2 रेग्युलराइज़ेशन का एक रूप है, मॉडल में बड़े वेट्स पर पेनल्टी लगाता है। Adam वेट डिके को ग्रेडिएंट अपडेट प्रक्रिया में शामिल करता है, जबकि AdamW इसे ग्रेडिएंट अपडेट के बाद अलग से लागू करता है
वे अन्य किन तरीकों से अलग हैं, यहाँ देखें:
हालाँकि दोनों ऑप्टिमाइज़र मोमेंटम को मैनेज करने और लर्निंग रेट्स को डायनेमिक रूप से समायोजित करने के लिए डिज़ाइन किए गए हैं, वे वेट डिके के उपचार में बुनियादी रूप से भिन्न हैं।
Adam में, वेट डिके ग्रेडिएंट अपडेट का हिस्सा होने के नाते परोक्ष रूप से लागू होता है, जो सीखने की गतिशीलता को अनजाने में बदल सकता है और ऑप्टिमाइज़ेशन प्रक्रिया में बाधा डाल सकता है। जबकि AdamW वेट डिके को ग्रेडिएंट स्टेप से अलग कर देता है, जिससे रेग्युलराइज़ेशन सीधे पैरामीटर्स को प्रभावित करता है बिना एडैप्टिव लर्निंग मैकेनिज़्म को बदले।
यह डिज़ाइन अधिक सटीक रेग्युलराइज़ेशन की ओर ले जाता है, जो मॉडलों को बेहतर जनरलाइज़ करने में मदद करता है, खासकर बड़े और जटिल डेटासेट्स से जुड़े कार्यों में। परिणामस्वरूप, दोनों ऑप्टिमाइज़र के उपयोग के मामले अक्सर काफी अलग होते हैं।
Adam उन कार्यों में बेहतर प्रदर्शन करता है जहाँ रेग्युलराइज़ेशन कम महत्वपूर्ण होता है या जहाँ जनरलाइज़ेशन की तुलना में कम्प्यूटेशनल दक्षता को प्राथमिकता दी जाती है। उदाहरणों में शामिल हैं:
AdamW उन परिदृश्यों में उत्कृष्ट प्रदर्शन करता है जहाँ ओवरफिटिंग चिंता का विषय है और मॉडल का आकार बड़ा है। उदाहरण के लिए:
तो कोई Adam की बजाय AdamW क्यों चुने? सरल। AdamW कई महत्वपूर्ण फायदे प्रदान करता है जो विशेषकर जटिल मॉडलिंग परिदृश्यों में इसके प्रदर्शन को बढ़ाते हैं।
यह Adam optimizer में पाई गई कुछ सीमाओं को दूर करता है, जिससे ऑप्टिमाइज़ेशन अधिक प्रभावी होता है और मॉडल ट्रेनिंग व मजबूती में सुधार होता है।
यहाँ कुछ प्रमुख फायदे दिए गए हैं:
AdamW की मूल शक्ति उसके वेट डिके के दृष्टिकोण में है, जिसे Adam की सामान्य एडैप्टिव ग्रेडिएंट अपडेट्स से अलग किया गया है। यह समायोजन सुनिश्चित करता है कि रेग्युलराइज़ेशन सीधे मॉडल के वेट्स पर लागू हो, जिससे लर्निंग रेट की गतिशीलता को नकारात्मक रूप से प्रभावित किए बिना जनरलाइज़ेशन में सुधार हो।
यह ऑप्टिमाइज़र Adam की एडैप्टिव प्रकृति पर आधारित है और मोमेंटम व प्रति-पैरामीटर लर्निंग रेट समायोजन के लाभ बनाए रखता है। वेट डिके को स्वतंत्र रूप से लागू करना Adam की एक प्रमुख कमी को दूर करता है: रेग्युलराइज़ेशन के दौरान ग्रेडिएंट अपडेट्स पर इसका प्रभाव। यह पृथक्करण AdamW को जटिल और बड़े पैमाने के मॉडलों में भी स्थिर सीखने की अनुमति देता है, साथ ही ओवरफिटिंग को नियंत्रित रखता है।
आगे के अनुभागों में, हम वेट डिके और रेग्युलराइज़ेशन के पीछे के सिद्धांतों और AdamW की ऑप्टिमाइज़ेशन प्रक्रिया को आधार देने वाले गणित का अन्वेषण करेंगे।
L2 रेग्युलराइज़ेशन ओवरफिटिंग को रोकने के लिए उपयोग की जाने वाली तकनीक है। यह लॉस फ़ंक्शन में एक पेनल्टी टर्म जोड़कर बड़े वेट वैल्यूज़ को हतोत्साहित करता है। यह तकनीक सरल मॉडल बनाने में मदद करती है जो नए डेटा पर बेहतर जनरलाइज़ करते हैं।
ट्रेडिशनल ऑप्टिमाइज़र्स, जैसे Adam, में वेट डिके को ग्रेडिएंट अपडेट का हिस्सा बनाकर लागू किया जाता है, जो अनजाने में लर्निंग रेट्स को प्रभावित करता है और उप-इष्टतम प्रदर्शन का कारण बन सकता है।
AdamW इस पर सुधार करता है ग्रेडिएंट गणना से वेट डिके को डिकपल करके। दूसरे शब्दों में, ग्रेडिएंट अपडेट के दौरान वेट डिके लागू करने के बजाय, AdamW इसे एक अलग चरण मानता है और ग्रेडिएंट अपडेट के बाद सीधे वेट्स पर लागू करता है। यह वेट डिके को ऑप्टिमाइज़ेशन प्रक्रिया में दखल देने से रोकता है, जिससे ट्रेनिंग अधिक स्थिर होती है और जनरलाइज़ेशन बेहतर होता है।
AdamW पारंपरिक Adam ऑप्टिमाइज़र को इस तरह संशोधित करता है कि वेट डिके कैसे लागू किया जाए। AdamW के मूल समीकरणों को निम्नलिखित रूप में दर्शाया जा सकता है:
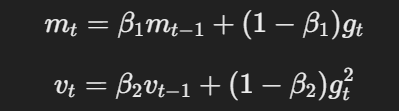
मोमेंटम और एडैप्टिव लर्निंग रेट का समीकरण
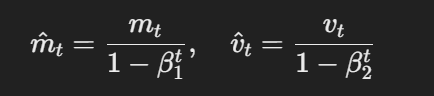
बायस-सही किए गए आकलन का सूत्र
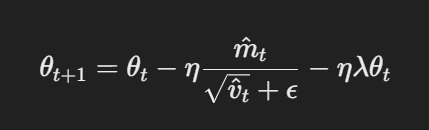
डिकपल्ड वेट डिके के साथ पैरामीटर अपडेट
यहाँ, η लर्निंग रेट है, λ वेट डिके फ़ैक्टर है, और θt पैरामीटर्स को प्रदर्शित करता है। यह डिकपल्ड वेट डिके टर्म λθt सुनिश्चित करता है कि रेग्युलराइज़ेशन ग्रेडिएंट अपडेट से स्वतंत्र रूप से लागू हो, जो Adam से मुख्य अंतर है।
PyTorch में AdamW लागू करना सीधा-सादा है; यह अनुभाग इसे सेटअप करने की विस्तृत गाइड देता है। इन चरणों का पालन करें ताकि आप Adam Optimizer के साथ मॉडलों को प्रभावी ढंग से फाइन-ट्यून करना सीख सकें।
ध्यान दें: यह ट्यूटोरियल मानता है कि आपने पहले से PyTorch इंस्टॉल कर रखा है। किसी भी मार्गदर्शन के लिए डॉक्यूमेंटेशन देखें।
चरण 1: ज़रूरी लाइब्रेरीज़ इम्पोर्ट करें
import torch
import torch.nn as nn
import torch.optim as optim
Import torch.nn.functional as F
चरण 2: मॉडल परिभाषित करें
class SimpleCNN(nn.Module):
    def __init__(self):
        super(SimpleCNN, self).__init__()
        self.conv1 = nn.Conv2d(3, 32, kernel_size=3, stride=1, padding=1)
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
        self.conv2 = nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1)
        self.fc1 = nn.Linear(64 * 8 * 8, 128)
        self.fc2 = nn.Linear(128, 10)

    def forward(self, x):
        x = self.pool(F.relu(self.conv1(x)))
        x = self.pool(F.relu(self.conv2(x)))
        x = x.view(-1, 64 * 8 * 8)
        x = F.relu(self.fc1(x))
        x = self.fc2(x)
चरण 3: हाइपरपैरामीटर्स सेट करें
learning_rate = 1e-4
weight_decay = 1e-2
num_epochs = 10 # number of epochs
चरण 4: AdamW ऑप्टिमाइज़र इनिशियलाइज़ करें और लॉस फ़ंक्शन सेट करें
optimizer = optim.AdamW(model.parameters(), lr=learning_rate, weight_decay=weight_decay)
criterion = nn.CrossEntropyLoss()
Voilà!
अब आप अपने CNN मॉडल को ट्रेन करने के लिए तैयार हैं, और अगले अनुभाग में हम यही करेंगे।
ऊपर, हमने मॉडल परिभाषित किया, हाइपरपैरामीटर्स सेट किए, ऑप्टिमाइज़र (AdamW) को इनिशियलाइज़ किया, और लॉस फ़ंक्शन सेट किया।
मॉडल को ट्रेन करने के लिए, हमें कुछ और मॉड्यूल्स इम्पोर्ट करने होंगे;
from torch.utils.data import DataLoader # provides an iterable of the dataset
import torchvision
import torchvision.transforms as transforms
अगला, डेटासेट और डाटालोडर्स परिभाषित करें। इस उदाहरण के लिए, हम CIFAR-10 डेटासेट का उपयोग करेंगे:
# Define transformations for the training set
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)),
])
# Load CIFAR-10 dataset
train_dataset = torchvision.datasets.CIFAR10(root='./data', train=True, download=True, transform=transform)
val_dataset = torchvision.datasets.CIFAR10(root='./data', train=False, download=True, transform=transform)
# Create data loaders
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)
val_loader = DataLoader(val_dataset, batch_size=32, shuffle=False)
चूँकि हमने अपना मॉडल पहले ही परिभाषित कर लिया है, अगला चरण AdamW का उपयोग करके मॉडल को ऑप्टिमाइज़ करने के लिए ट्रेनिंग लूप लागू करना है।
यह इस प्रकार दिखता है:
for epoch in range(num_epochs):
    model.train()  # Set the model to training mode
    running_loss = 0.0
    for inputs, labels in train_loader:
        optimizer.zero_grad()  # Clear gradients
        outputs = model(inputs)  # Forward pass
        loss = criterion(outputs, labels)  # Calculate loss
        loss.backward()  # Backward pass
        optimizer.step()  # Update weights
        running_loss += loss.item()
    print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {running_loss/len(train_loader):.4f}')
अंतिम चरण पहले बनाए गए वैलिडेशन डेटासेट पर मॉडल के प्रदर्शन का मूल्यांकन करना है।
कोड यहाँ है:
model.eval()  # Set the model to evaluation mode
correct = 0
total = 0
with torch.no_grad():
    for inputs, labels in val_loader:
        outputs = model(inputs)  # Forward pass
        _, predicted = torch.max(outputs.data, 1)  # Get predicted class
        total += labels.size(0)  # Update total samples
        correct += (predicted == labels).sum().item()  # Update correct predictions
accuracy = 100 * correct / total
print(f'Validation Accuracy: {accuracy:.2f}%')
और बस हो गया।
अब आप जानते हैं कि PyTorch में AdamW कैसे लागू करें।
ठीक है, तो हमने स्थापित कर लिया है कि AdamW अपने पूर्ववर्ती Adam की तुलना में वेट डिके को अधिक प्रभावी ढंग से प्रबंधित करने के कारण लोकप्रिय हुआ।
पर इस ऑप्टिमाइज़र के कुछ सामान्य उपयोग के मामले क्या हैं?
हम इस अनुभाग में इसमें उतरेंगे…
AdamW, BERT, GPT और अन्य ट्रांसफॉर्मर आर्किटेक्चर जैसे बड़े मॉडलों की ट्रेनिंग में विशेष रूप से लाभकारी है। ऐसे मॉडलों में आमतौर पर मिलियनों या अरबों पैरामीटर्स होते हैं, जिसका अर्थ है कि उन्हें ऐसे कुशल ऑप्टिमाइज़ेशन एल्गोरिदम की आवश्यकता होती है जो जटिल वेट अपडेट्स और जनरलाइज़ेशन चुनौतियों को संभाल सकें।
AdamW, CNNs से जुड़े कंप्यूटर विज़न कार्यों और ट्रांसफॉर्मर्स से जुड़े NLP कार्यों में पसंदीदा ऑप्टिमाइज़र बन गया है। ओवरफिटिंग को रोकने की इसकी क्षमता इसे बड़े डेटासेट्स और जटिल आर्किटेक्चर्स से जुड़े कार्यों के लिए आदर्श बनाती है। वेट डिके के डिकपलिंग के कारण AdamW उन समस्याओं से बचता है जो Adam में ओवर-रेग्युलराइज़ेशन की वजह से आती हैं।
हाइपरपैरामीटर ट्यूनिंग वह प्रक्रिया है जिसमें ऐसे पैरामीटर्स के सर्वोत्तम मान चुने जाते हैं जो मशीन लर्निंग मॉडल के ट्रेनिंग को नियंत्रित करते हैं, लेकिन डेटा से नहीं सीखे जाते। ये पैरामीटर्स सीधे प्रभावित करते हैं कि मॉडल कैसे ऑप्टिमाइज़ और कन्वर्ज होता है।
AdamW में इन हाइपरपैरामीटर्स की उचित ट्यूनिंग कुशल ट्रेनिंग प्राप्त करने, ओवरफिटिंग से बचने और यह सुनिश्चित करने के लिए आवश्यक है कि मॉडल अनदेखे डेटा पर अच्छी तरह जनरलाइज़ करे।
इस अनुभाग में, हम इष्टतम प्रदर्शन के लिए AdamW के प्रमुख हाइपरपैरामीटर्स को फाइन-ट्यून करना सीखेंगे।
लर्निंग रेट एक हाइपरपैरामीटर है जो यह नियंत्रित करता है कि प्रत्येक ट्रेनिंग स्टेप के दौरान लॉस ग्रेडिएंट के सापेक्ष मॉडल वेट्स को कितना समायोजित किया जाए। उच्च लर्निंग रेट ट्रेनिंग को तेज़ करता है लेकिन मॉडल को इष्टतम वेट्स से आगे निकलने का कारण बन सकता है, जबकि कम रेट अधिक सूक्ष्म समायोजन की अनुमति देता है लेकिन ट्रेनिंग को धीमा बना सकता है या लोकल मिनिमा में फँसा सकता है।
वहीं दूसरी ओर, वेट डिके एक रेग्युलराइज़ेशन तकनीक है जिसका उपयोग मॉडल में बड़े वेट्स पर पेनल्टी लगाकर ओवरफिटिंग को रोकने के लिए किया जाता है। अर्थात, वेट डिके ट्रेनिंग के दौरान मॉडल वेट्स के आकार के अनुपात में एक छोटा पेनल्टी जोड़ता है, जिससे मॉडल की जटिलता कम करने और नए डेटा पर जनरलाइज़ेशन सुधारने में मदद मिलती है।
AdamW के लिए इष्टतम लर्निंग रेट और वेट डिके मान चुनने के लिए:
AdamW डीप लर्निंग में, खासकर बड़े पैमाने के मॉडलों के लिए, सबसे प्रभावी ऑप्टिमाइज़र्स में से एक बनकर उभरा है। इसका कारण है वेट डिके को ग्रेडिएंट अपडेट्स से डिकपल करना। अर्थात, AdamW का डिज़ाइन रेग्युलराइज़ेशन में सुधार करता है और मॉडलों को बेहतर जनरलाइज़ करने में मदद करता है, विशेषकर जटिल आर्किटेक्चर्स और व्यापक डेटासेट्स के साथ काम करते समय।
जैसा कि इस ट्यूटोरियल में दिखाया गया है, PyTorch में AdamW को लागू करना सीधा है—Adam से केवल कुछ समायोजन चाहिए। हालाँकि, AdamW की प्रभावशीलता को अधिकतम करने के लिए हाइपरपैरामीटर ट्यूनिंग अभी भी एक अहम कदम है। लर्निंग रेट और वेट डिके के बीच सही संतुलन खोजना आवश्यक है ताकि ऑप्टिमाइज़र ओवरफिटिंग या अंडरफिटिंग के बिना कुशलतापूर्वक काम करे।
अब आप अपने स्वयं के मॉडलों में AdamW लागू करने के लिए पर्याप्त जानते हैं। अपने सीखने को आगे बढ़ाने के लिए, इन संसाधनों को देखें:
टॉप DataCamp कोर्सेज़
कोर्स
लर्निंग पाथ
कोर्स
