Program
Pengembangan Aplikasi Kecerdasan Buatan
21 jam
AWS Multi-Agent Orchestrator adalah kerangka kerja fleksibel dengan beragam alat yang dirancang untuk mengelola agen AI dan memfasilitasi percakapan multi-giliran yang kompleks. Komponen bawaannya memungkinkan pengembangan dan penerapan yang cepat, sehingga kita bisa fokus pada aplikasi tanpa perlu membangun komponen ini dari awal.
AWS Multi-Agent Orchestrator menawarkan fitur-fitur berikut:
Kerangka kerja ini diimplementasikan untuk mendukung Python dan TypeScript.
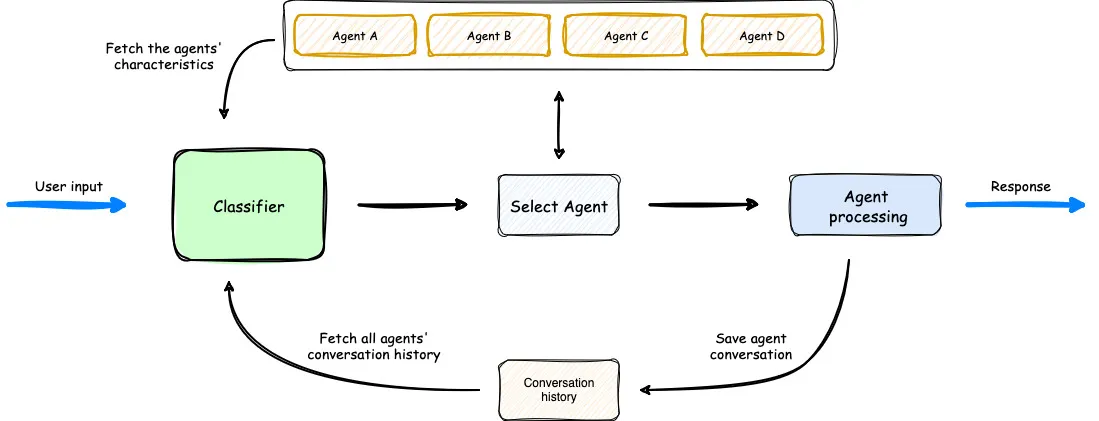
Gambaran umum cara kerja Multi-Agent Orchestrator. (Sumber)
Pada diagram di atas, kita melihat bahwa pengklasifikasi mempertimbangkan agen yang tersedia, prompt pengguna, dan riwayat percakapan sebelumnya untuk memilih agen optimal bagi masukan pengguna. Kemudian, agen memproses permintaan tersebut. Alurnya sederhana namun efektif.
Untuk penyiapan cepat lingkungan, Anda dapat mengikuti instruksi dalam dokumentasi.
Pertama, kita membuat folder baru dan lingkungan Python baru untuk memasang pustaka yang diperlukan.
mkdir test_multi_agent_orchestrator
cd test_multi_agent_orchestrator
python -m venv venv
source venv/bin/activate  # On Windows use venv\\Scripts\\activate
Dengan lingkungan virtual baru yang sudah aktif, pasang pustaka berikut
pip install multi-agent-orchestratorSelanjutnya, kita perlu mengonfigurasi akun AWS. Jika Anda belum memiliki akun AWS, daftar gratis untuk akun free tier. Setelah mendaftar, unduh AWS CLI.
AWS CLI juga perlu dikonfigurasi. Untuk petunjuk lengkap, ikuti Menyiapkan AWS CLI, namun Anda bisa mengambil cara yang lebih mudah dengan menggunakan perintah aws configure dan memberikan AWS access key ID serta secret access key. Anda bisa mendapatkan kunci tersebut setelah membuat pengguna baru di dasbor Anda.
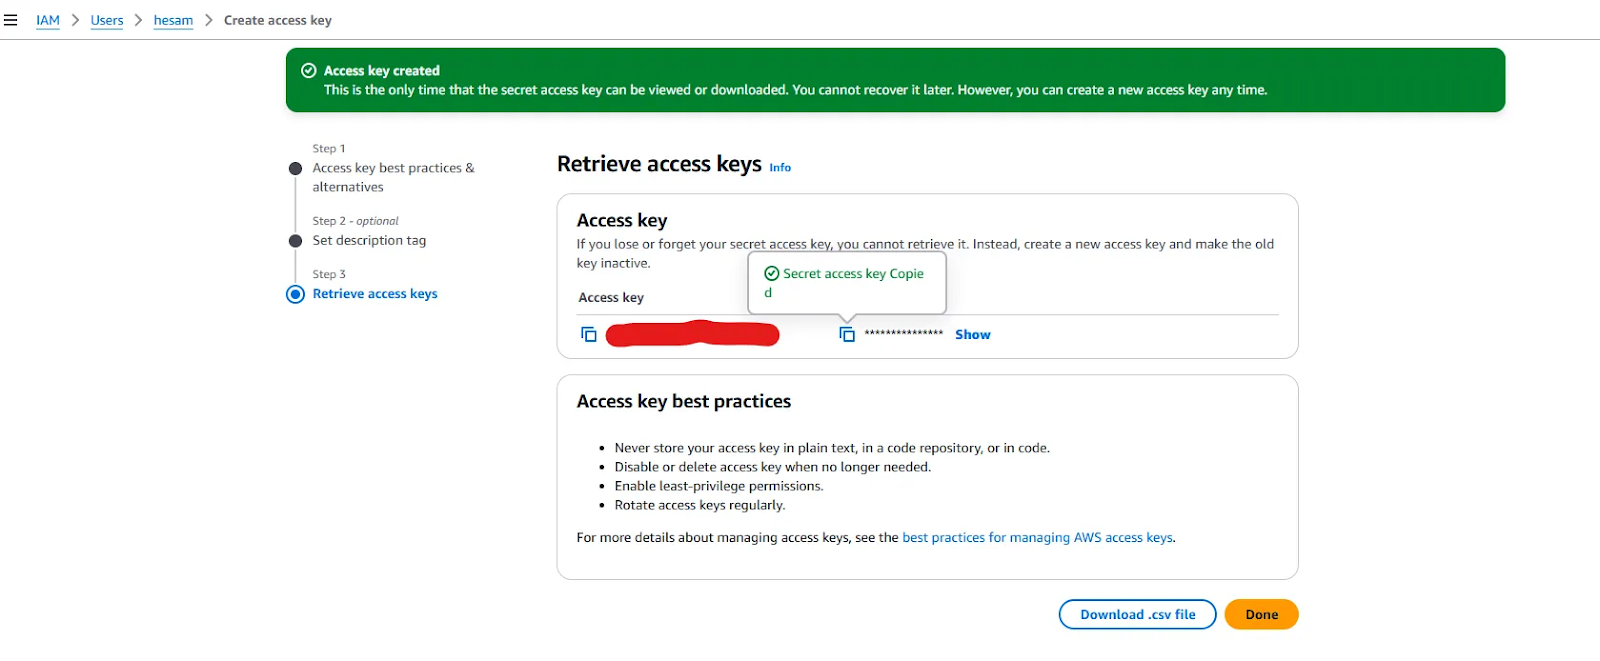
Kunci akses yang diberikan saat membuat pengguna baru.
Dengan kunci akses di tangan, jalankan aws configure dan berikan kunci tersebut, pilih nama region (daftar lengkap tersedia di sini) yang paling dekat dengan Anda, dan atur format keluaran default ke json.
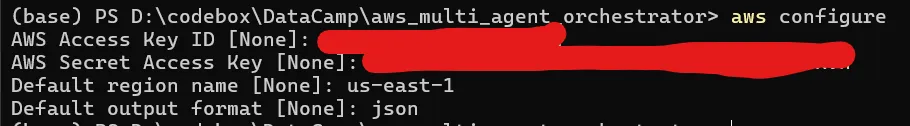
Jika CLI Anda terkonfigurasi dengan benar, menjalankan perintah aws sts get-caller-identity akan menampilkan AWS account ID, user ID, dan ARN Anda.
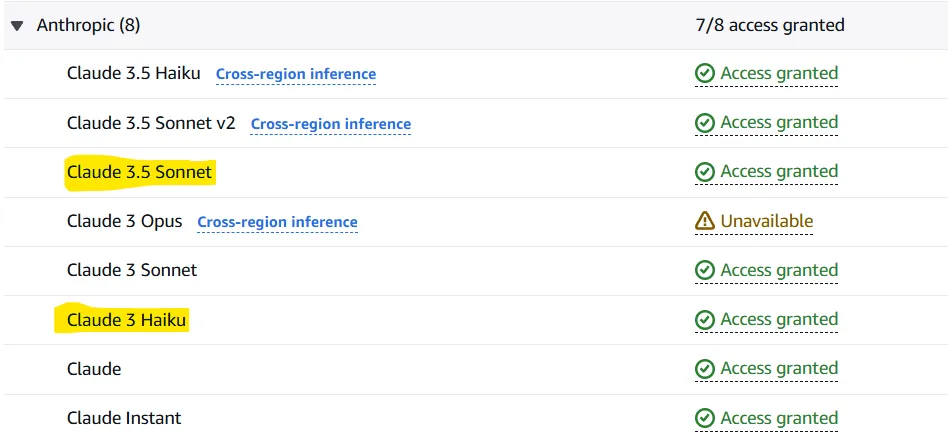
Sekarang AWS CLI sudah siap, kita perlu mengonfigurasi AWS Bedrock untuk memberikan akses ke LLM yang akan kita butuhkan. Amazon Bedrock adalah layanan yang memungkinkan Anda menguji dan memanggil model dasar (seperti Llama 3.2 atau Claude 3.5 Sonnet) melalui API. Multi-Agent Orchestrator menggunakan layanan ini untuk memanggil dua model secara default:
Tentu, model-model ini bisa diubah, tetapi mari lanjutkan dengan pilihan default.
Untuk memberikan akses ke dua model ini, buka Amazon Bedrock > Model Access dan pilih “Modify model access.” Pilih dua model tersebut (dan lainnya jika Anda mau) serta lengkapi informasi yang diperlukan. Bagian ini akan terlihat seperti berikut:
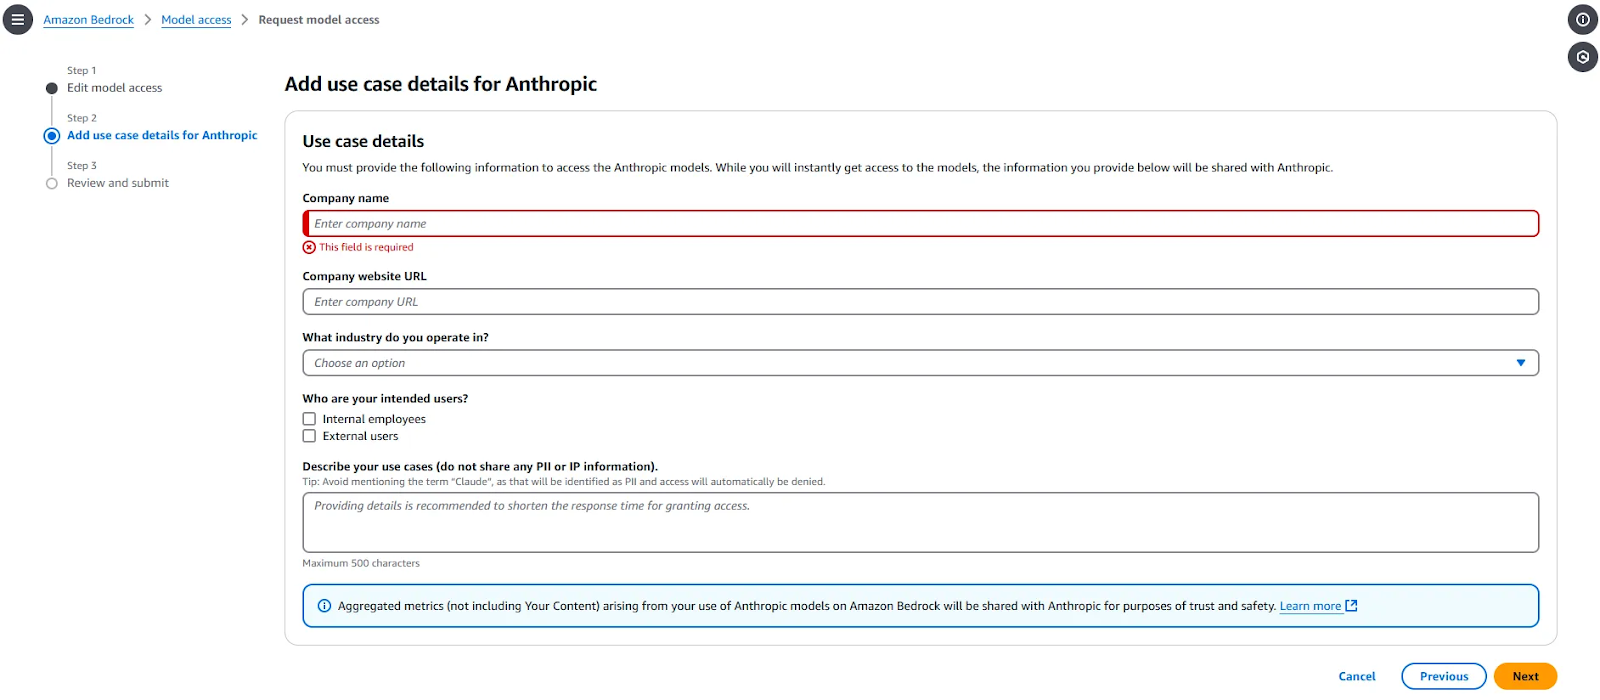
Setelah menyelesaikan permintaan, model akan tersedia dalam 1–2 menit. Saat akses diberikan untuk model yang diminta, Anda akan melihat tulisan “Access granted” di depannya.
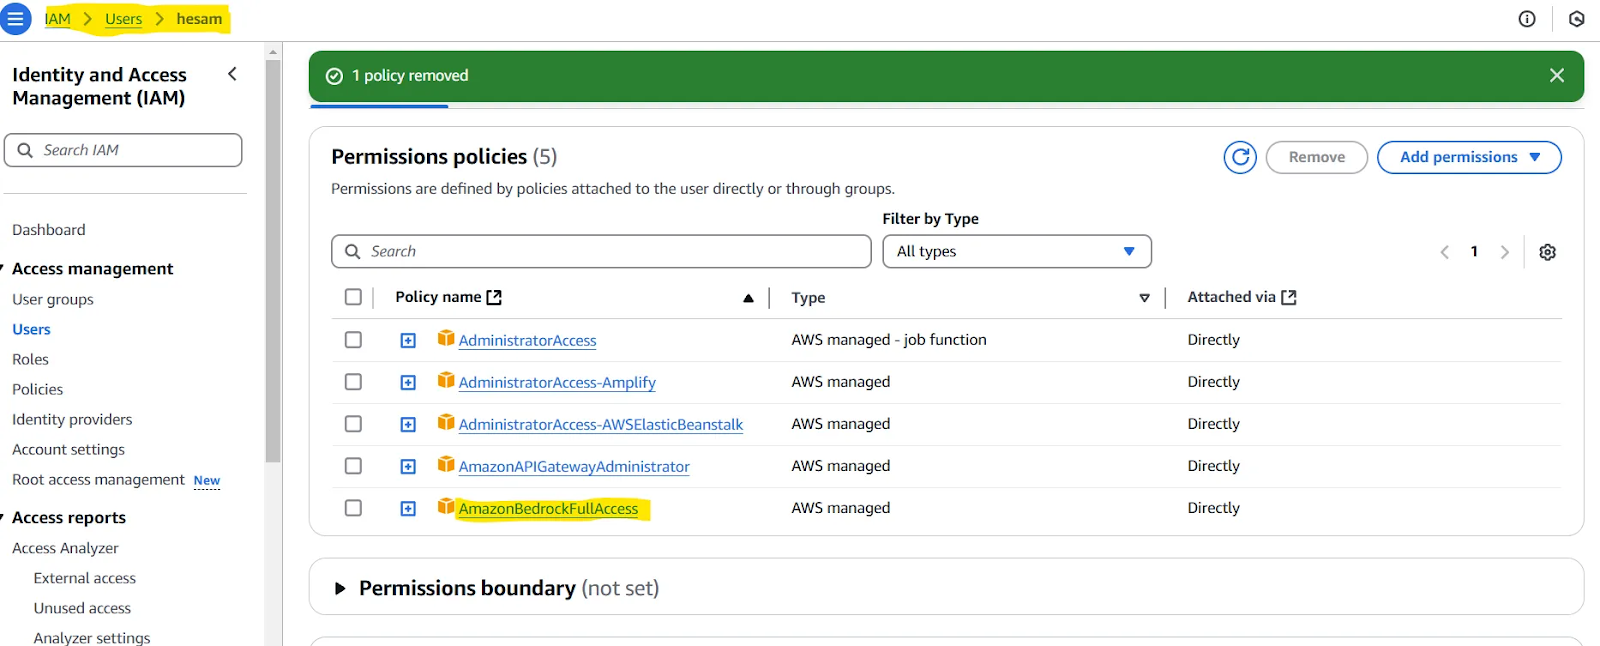
Catatan: Anda mungkin diminta menetapkan kebijakan (policy) kepada pengguna yang Anda buat. Anda bisa mengujinya jika mengalami masalah pada subbagian berikutnya dari artikel ini (Uji penyiapan Anda). Jika demikian, lihat halaman ini. Singkatnya, Anda perlu memberi pengguna yang Anda definisikan akses ke AmazonBedrockFullAccess.
Untuk memeriksa apakah semua langkah sebelumnya sudah disiapkan dengan benar, gunakan kode ini:
import uuid
import asyncio
import json
import sys
from typing import Optional, List, Dict, Any
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator, OrchestratorConfig
from multi_agent_orchestrator.agents import (
    BedrockLLMAgent,
    BedrockLLMAgentOptions,
    AgentResponse,
    AgentCallbacks,
)
from multi_agent_orchestrator.types import ConversationMessage, ParticipantRole

orchestrator = MultiAgentOrchestrator(
    options=OrchestratorConfig(
        LOG_AGENT_CHAT=True,
        LOG_CLASSIFIER_CHAT=True,
        LOG_CLASSIFIER_RAW_OUTPUT=True,
        LOG_CLASSIFIER_OUTPUT=True,
        LOG_EXECUTION_TIMES=True,
        MAX_RETRIES=3,
        USE_DEFAULT_AGENT_IF_NONE_IDENTIFIED=True,
        MAX_MESSAGE_PAIRS_PER_AGENT=10,
    )
)


class BedrockLLMAgentCallbacks(AgentCallbacks):
    def on_llm_new_token(self, token: str) -> None:
        # handle response streaming here
        print(token, end="", flush=True)


tech_agent = BedrockLLMAgent(
    BedrockLLMAgentOptions(
        name="Tech Agent",
        streaming=True,
        description=(
            "Specializes in technology areas including software development, hardware, AI, "
            "cybersecurity, blockchain, cloud computing, emerging tech innovations, and pricing/costs "
            "related to technology products and services."
        ),
        model_id="anthropic.claude-3-sonnet-20240229-v1:0",
        callbacks=BedrockLLMAgentCallbacks(),
    )
)

orchestrator.add_agent(tech_agent)


async def handle_request(
    _orchestrator: MultiAgentOrchestrator, _user_input: str, _user_id: str, _session_id: str
):
    response: AgentResponse = await _orchestrator.route_request(
        _user_input, _user_id, _session_id
    )
    # Print metadata
    print("\nMetadata:")
    print(f"Selected Agent: {response.metadata.agent_name}")
    if response.streaming:
        print("Response:", response.output.content[0]["text"])
    else:
        print("Response:", response.output.content[0]["text"])


if __name__ == "__main__":
    USER_ID = "user123"
    SESSION_ID = str(uuid.uuid4())
    print("Welcome to the interactive Multi-Agent system. Type 'quit' to exit.")
    while True:
        # Get user input
        user_input = input("\nYou: ").strip()
        if user_input.lower() == "quit":
            print("Exiting the program. Goodbye!")
            sys.exit()
        # Run the async function
        asyncio.run(handle_request(orchestrator, user_input, USER_ID, SESSION_ID))
Jika Anda dapat memberi prompt dan menerima jawaban, semuanya berfungsi dengan baik.
Repositori AWS Multi-Agent Orchestrator menyediakan beberapa proyek contoh dalam TypeScript dan Python. Sekarang kita akan menulis aplikasi Python yang disederhanakan yang terdiri dari dua agen: Python Developer Agent dan ML Expert Agent.
Kita juga akan menggunakan Chainlit, paket Python sumber terbuka, untuk membuat UI sederhana bagi aplikasi. Untuk memulai, pasang pustaka yang diperlukan:
chainlit==1.2.0
multi_agent_orchestrator==0.0.18
Kita menggunakan kode di bawah ini untuk aplikasi demo, tetapi mari kita jelaskan terlebih dahulu:
“anthropic.claude-3-haiku-20240307-v1:0” sebagai model untuk pengklasifikasi. Pengklasifikasi ini akan memilih agen mana yang digunakan saat masukan pengguna baru datang.MultiAgentOrchestrator dan mendefinisikan beberapa konfigurasi.BedrockLLMAgent digunakan untuk membuat agen kita. name dan description disediakan untuk tiap agen. Untuk satu agen, Anda bisa memilih model apa pun yang dapat diakses atau bahkan menggunakan Ollama untuk menjalankannya secara lokal. Mengatur streaming=True dan meneruskan ChainlitAgentCallbacks() sebagai callback akan membuat agen mengembalikan respons secara streaming alih-alih utuh. Terakhir, kita menambahkan tiap agen ke orchestrator.user_session diatur, dan bagian utama untuk menangani pesan pengguna dan agen didefinisikan.### 1
import uuid
import chainlit as cl
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator, OrchestratorConfig
from multi_agent_orchestrator.classifiers import BedrockClassifier, BedrockClassifierOptions
from multi_agent_orchestrator.agents import AgentResponse
from multi_agent_orchestrator.agents import BedrockLLMAgent, BedrockLLMAgentOptions, AgentCallbacks
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator
from multi_agent_orchestrator.types import ConversationMessage
import asyncio
import chainlit as cl
class ChainlitAgentCallbacks(AgentCallbacks):
def on_llm_new_token(self, token: str) -> None:
asyncio.run(cl.user_session.get("current_msg").stream_token(token))
### 2
# Initialize the orchestrator & classifier
custom_bedrock_classifier = BedrockClassifier(BedrockClassifierOptions(
model_id='anthropic.claude-3-haiku-20240307-v1:0',
inference_config={
'maxTokens': 500,
'temperature': 0.7,
'topP': 0.9
}
))
### 3
orchestrator = MultiAgentOrchestrator(options=OrchestratorConfig(
LOG_AGENT_CHAT=True,
LOG_CLASSIFIER_CHAT=True,
LOG_CLASSIFIER_RAW_OUTPUT=True,
LOG_CLASSIFIER_OUTPUT=True,
LOG_EXECUTION_TIMES=True,
MAX_RETRIES=3,
USE_DEFAULT_AGENT_IF_NONE_IDENTIFIED=False,
MAX_MESSAGE_PAIRS_PER_AGENT=10,
),
classifier=custom_bedrock_classifier
)
### 4
def create_python_dev():
return BedrockLLMAgent(BedrockLLMAgentOptions(
name="Python Developer Agent",
streaming=True,
description="Experienced Python developer specialized in writing, debugging, and evaluating only Python code.",
model_id="anthropic.claude-3-sonnet-20240229-v1:0",
callbacks=ChainlitAgentCallbacks()
))
def create_ml_expert():
return BedrockLLMAgent(BedrockLLMAgentOptions(
name="Machine Learning Expert",
streaming=True,
description="Expert in areas related to machine learning including deep learning, pytorch, tensorflow, scikit-learn, and large language models.",
model_id="anthropic.claude-3-sonnet-20240229-v1:0",
callbacks=ChainlitAgentCallbacks()
))
# Add agents to the orchestrator
orchestrator.add_agent(create_python_dev())
orchestrator.add_agent(create_ml_expert())
### 5
@cl.on_chat_start
async def start():
cl.user_session.set("user_id", str(uuid.uuid4()))
cl.user_session.set("session_id", str(uuid.uuid4()))
cl.user_session.set("chat_history", [])
@cl.on_message
async def main(message: cl.Message):
user_id = cl.user_session.get("user_id")
session_id = cl.user_session.get("session_id")
msg = cl.Message(content="")
await msg.send() # Send the message immediately to start streaming
cl.user_session.set("current_msg", msg)
response:AgentResponse = await orchestrator.route_request(message.content, user_id, session_id, {})
# Handle non-streaming or problematic responses
if isinstance(response, AgentResponse) and response.streaming is False:
# Handle regular response
if isinstance(response.output, str):
await msg.stream_token(response.output)
elif isinstance(response.output, ConversationMessage):
await msg.stream_token(response.output.content[0].get('text'))
await msg.update()
if __name__ == "__main__":
cl.run()Sekarang saatnya menjalankan aplikasi. Untuk melakukannya, pertama jalankan chainlit run [app.py](<http://app.py/>) -w . Anda sekarang dapat menguji aplikasi di tab baru yang terbuka di peramban Anda.
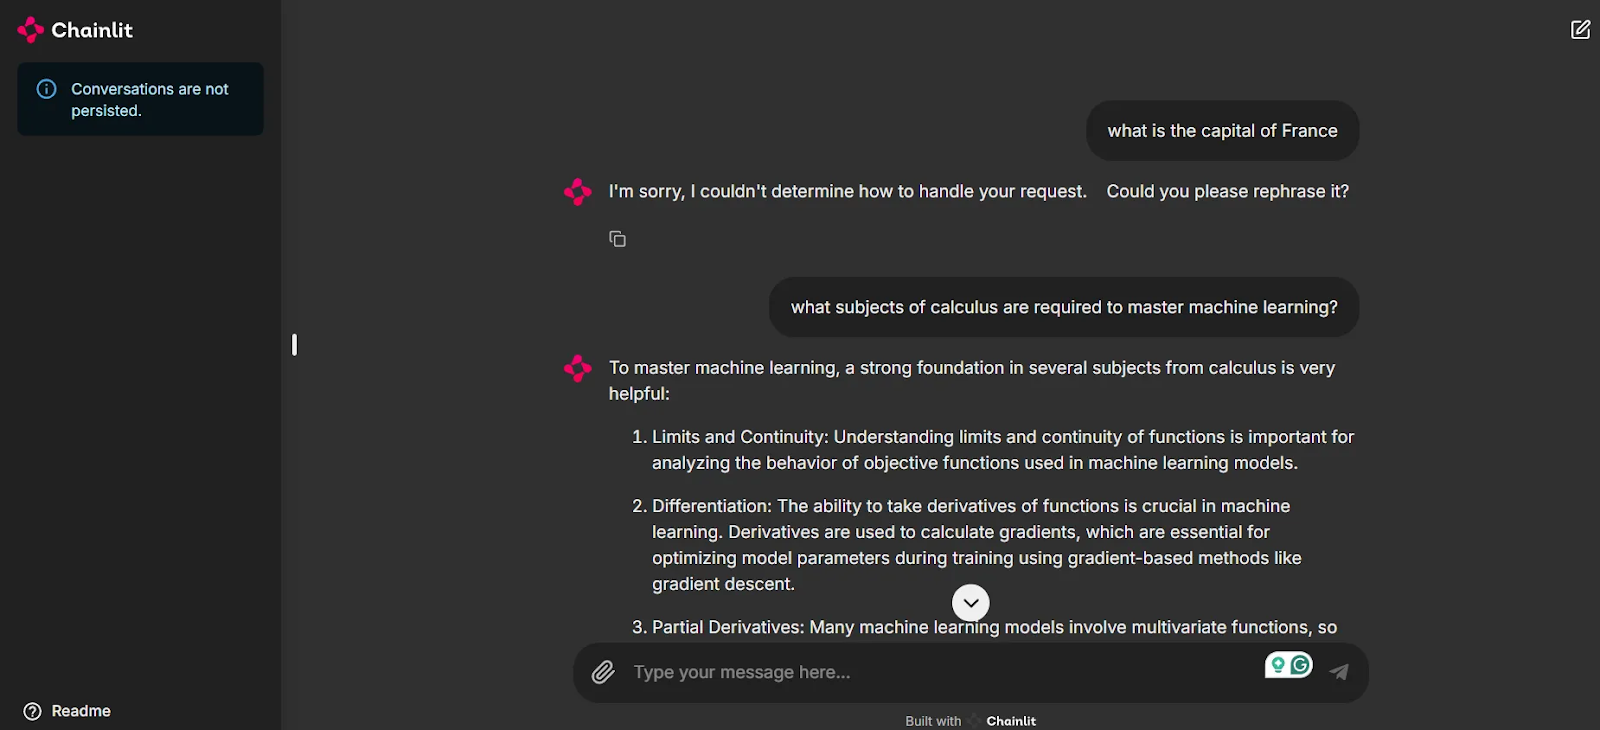
Seperti yang terlihat pada tangkapan layar, kini kita memiliki UI untuk menguji aplikasi dan mengobrol dengan para agen.
Perhatikan bahwa karena prompt pertama “What is the capital of France?” tidak terkait dengan salah satu agen kita, sistem tidak memberikan jawaban. Ini penting untuk menjaga percakapan tetap relevan dan menghindari pengeluaran kredit yang tidak perlu saat menggunakan model-model ini. Namun, ketika diberi pertanyaan yang relevan, agen Machine Learning Expert kita akan berperan memberikan respons, berkat perutean cerdas dari Multi-Agent Orchestrator.
Dalam blog ini, kita telah memperkenalkan kerangka kerja AWS Multi-Agent Orchestrator yang terbaru, menyoroti beberapa fiturnya yang unik, menguraikan langkah-langkah menyiapkan lingkungan, mengeksplorasi model dasar yang disajikan oleh Amazon Bedrock, dan mengimplementasikan proyek demo.
Pada saat artikel ini ditulis, kerangka kerja tersebut belum memiliki dokumentasi yang komprehensif dan mendetail. Untuk memanfaatkan fitur lain, seperti memori dan penggunaan alat (tools), Anda harus membaca basis kode dan melihat proyek contoh yang disediakan.
Tetap mencermati kerangka kerja AI agentik adalah pilihan bijak untuk mengikuti bidang yang bergerak cepat ini. AWS Multi-Agent Orchestrator adalah opsi menjanjikan yang dibangun di atas infrastruktur layanan AWS, dan perkembangannya layak untuk diamati.
Pelajari AI dengan kursus-kursus ini!
Program
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt




