

AWS Multi-Agent Orchestrator क्या है?
AWS Multi-Agent Orchestrator एक लचीला, टूल-समृद्ध फ्रेमवर्क है जिसे AI एजेंट्स को प्रबंधित करने और जटिल मल्टी-टर्न वार्तालापों को सुगम बनाने के लिए डिज़ाइन किया गया है। इसके प्री-बिल्ट कॉम्पोनेंट्स तेज़ी से विकास और परिनियोजन संभव बनाते हैं, ताकि हम अपनी एप्लिकेशन पर ध्यान केंद्रित कर सकें और इन कॉम्पोनेंट्स को शुरू से न बनाना पड़े।
AWS Multi-Agent Orchestrator निम्न सुविधाएँ प्रदान करता है:
- इंटेलिजेंट रूटिंग: प्रत्येक क्वेरी के लिए सर्वोत्तम एजेंट को गतिशील रूप से पहचानता है।
- स्ट्रीमिंग और नॉन-स्ट्रीमिंग प्रतिक्रियाएँ: दोनों प्रकार के एजेंट रेस्पॉन्स फ़ॉर्मैट्स को सपोर्ट करता है।
- संदर्भ प्रबंधन: मल्टी-टर्न वार्तालापों में संगति और इतिहास को मैनेज करता है।
- विस्तारक्षम: नए एजेंट बनाएं या मौजूदा एजेंट्स को संशोधित करें।
- यूनिवर्सल डिप्लॉयमेंट: AWS Lambda, लोकल वातावरण और क्लाउड प्लेटफ़ॉर्म्स पर कार्य करता है।
यह फ्रेमवर्क Python और TypeScript दोनों के लिए सपोर्ट प्रदान करता है।
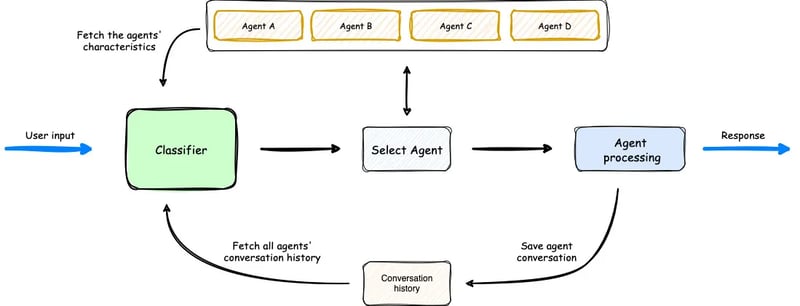
Multi-Agent Orchestrator कैसे काम करता है, इसका एक ओवरव्यू। (Source)
ऊपर दिए डायग्राम में, क्लासिफायर उपलब्ध एजेंट्स, यूज़र प्रॉम्प्ट और पिछली बातचीत के इतिहास को देखते हुए यूज़र इनपुट के लिए उपयुक्त एजेंट चुनता है। इसके बाद एजेंट रिक्वेस्ट प्रोसेस करता है। वर्कफ़्लो सरल है, लेकिन प्रभावी।
AWS Multi-Agent Orchestrator सेट अप करना
तेज़ी से वातावरण सेट अप करने के लिए, आप दस्तावेज़ में दिए निर्देशों का पालन कर सकते हैं।
सबसे पहले, हम एक नया फ़ोल्डर और आवश्यक लाइब्रेरीज़ इंस्टॉल करने के लिए एक नया Python वातावरण बनाते हैं।
mkdir test_multi_agent_orchestrator
cd test_multi_agent_orchestrator
python -m venv venv
source venv/bin/activate # On Windows use venv\\Scripts\\activateनए वर्चुअल वातावरण को सक्रिय करने के बाद, लाइब्रेरी इंस्टॉल करें
pip install multi-agent-orchestratorअगला कदम हमारे AWS खाते को कॉन्फ़िगर करना है। यदि आपके पास AWS खाता नहीं है, तो निःशुल्क फ्री टियर अकाउंट के लिए साइन अप करें। साइन अप करने के बाद, AWS CLI डाउनलोड करें।
AWS CLI को भी कॉन्फ़िगर करने की आवश्यकता है। विस्तृत निर्देशों के लिए, Setting up the AWS CLI का पालन करें, पर आप एक सरल तरीका भी अपना सकते हैं: कमांड aws configure चलाएँ और AWS access key ID व secret access key दें। ये कुंजियाँ आप अपने डैशबोर्ड में नया यूज़र बनाकर प्राप्त कर सकते हैं।
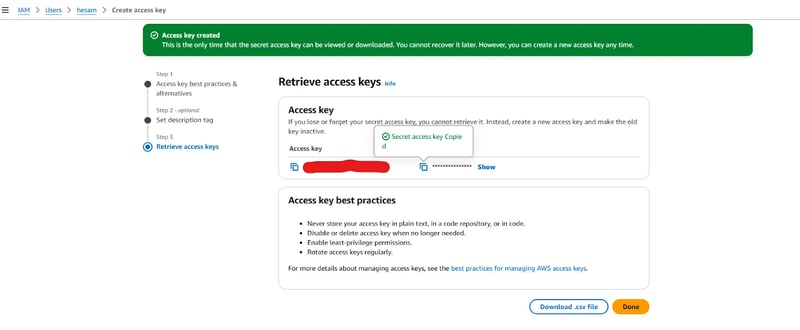
नए यूज़र बनाते समय दी गई एक्सेस कीज़।
एक्सेस कीज़ मिलने के बाद, aws configure चलाएँ, कुंजियाँ प्रदान करें, क्षेत्र (region) का नाम चुनें (पूरी सूची यहाँ दी गई है) जो आपके सबसे नज़दीक हो, और डिफ़ॉल्ट आउटपुट फ़ॉर्मैट json सेट करें।
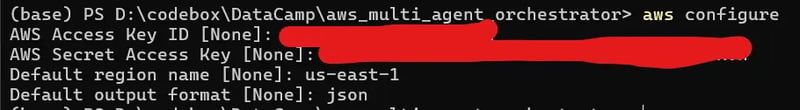
यदि आपका CLI सही ढंग से कॉन्फ़िगर है, तो aws sts get-caller-identity कमांड चलाने पर आपका AWS अकाउंट ID, यूज़र ID और ARN दिखना चाहिए।
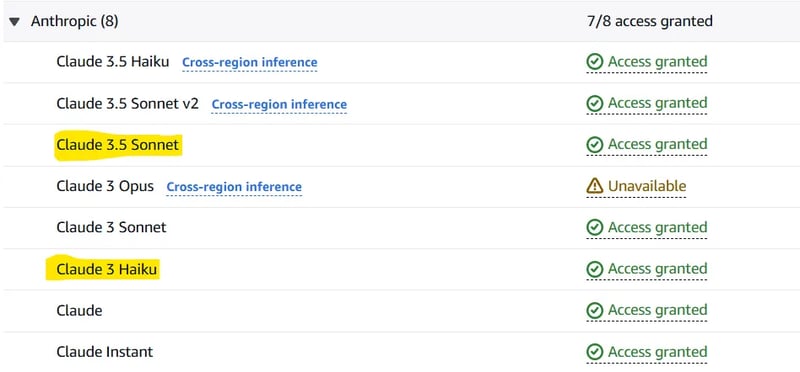
अब जब AWS CLI तैयार है, हमें AWS Bedrock कॉन्फ़िगर करना है ताकि जिन LLMs की हमें आवश्यकता होगी, उन तक पहुँच मिल सके। Amazon Bedrock एक सेवा है जो आपको API के माध्यम से फाउंडेशनल मॉडल्स (जैसे Llama 3.2 या Claude 3.5 Sonnet) को आज़माने और कॉल करने देती है। Multi-Agent Orchestrator डिफ़ॉल्ट रूप से इस सेवा का उपयोग दो मॉडल्स को कॉल करने के लिए करता है:
- क्लासिफायर के रूप में Claude 3.5 Sonnet
- एजेंट के रूप में Claude 3 Haiku
बेशक, इन मॉडलों को बदला जा सकता है, लेकिन फिलहाल हम डिफ़ॉल्ट विकल्प के साथ जारी रखते हैं।
इन दोनों मॉडलों तक पहुँच देने के लिए Amazon Bedrock > Model Access पर जाएँ और “Modify model access” चुनें। दोनों मॉडलों (और चाहें तो अन्य) का चयन करें और आवश्यक जानकारी भरें। यह भाग इस प्रकार दिखेगा:
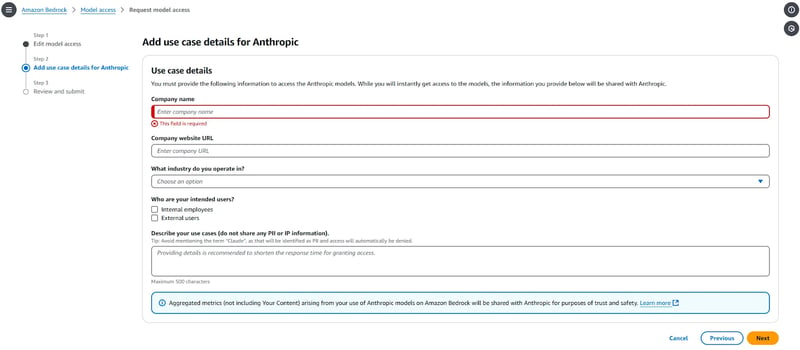
अनुरोध पूरा होने के 1–2 मिनट में मॉडल उपलब्ध हो जाएँगे। जब अनुरोधित मॉडलों के लिए एक्सेस मिल जाता है, तो उनके सामने “Access granted” दिखना चाहिए।
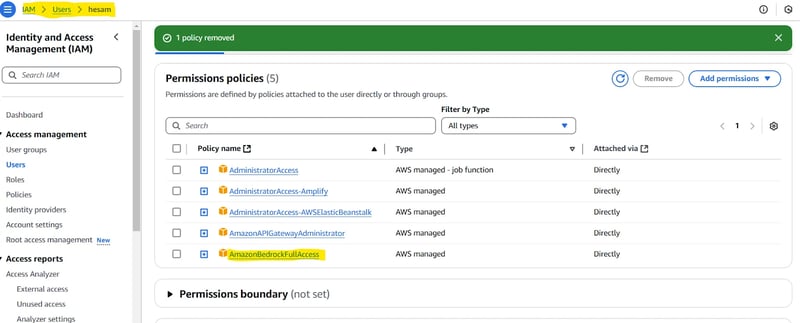
नोट: आपको बनाए गए यूज़र को एक पॉलिसी असाइन करने की आवश्यकता हो सकती है। आप इसे हमारे लेख के अगले उपखंड (अपना सेटअप जाँचें) में समस्या आने पर परख सकते हैं। यदि ऐसा हो, तो यह पेज देखें। संक्षेप में, आपको परिभाषित यूज़र को AmazonBedrockFullAccess की अनुमति देनी होगी।
अपना सेटअप जाँचें
यह जाँचने के लिए कि क्या ऊपर दिए गए सभी चरण ठीक से सेट अप हैं, यह कोड उपयोग करें:
import uuid
import asyncio
import json
import sys
from typing import Optional, List, Dict, Any
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator, OrchestratorConfig
from multi_agent_orchestrator.agents import (
BedrockLLMAgent,
BedrockLLMAgentOptions,
AgentResponse,
AgentCallbacks,
)
from multi_agent_orchestrator.types import ConversationMessage, ParticipantRole
orchestrator = MultiAgentOrchestrator(
options=OrchestratorConfig(
LOG_AGENT_CHAT=True,
LOG_CLASSIFIER_CHAT=True,
LOG_CLASSIFIER_RAW_OUTPUT=True,
LOG_CLASSIFIER_OUTPUT=True,
LOG_EXECUTION_TIMES=True,
MAX_RETRIES=3,
USE_DEFAULT_AGENT_IF_NONE_IDENTIFIED=True,
MAX_MESSAGE_PAIRS_PER_AGENT=10,
)
)
class BedrockLLMAgentCallbacks(AgentCallbacks):
def on_llm_new_token(self, token: str) -> None:
# handle response streaming here
print(token, end="", flush=True)
tech_agent = BedrockLLMAgent(
BedrockLLMAgentOptions(
name="Tech Agent",
streaming=True,
description=(
"Specializes in technology areas including software development, hardware, AI, "
"cybersecurity, blockchain, cloud computing, emerging tech innovations, and pricing/costs "
"related to technology products and services."
),
model_id="anthropic.claude-3-sonnet-20240229-v1:0",
callbacks=BedrockLLMAgentCallbacks(),
)
)
orchestrator.add_agent(tech_agent)
async def handle_request(
_orchestrator: MultiAgentOrchestrator, _user_input: str, _user_id: str, _session_id: str
):
response: AgentResponse = await _orchestrator.route_request(
_user_input, _user_id, _session_id
)
# Print metadata
print("\nMetadata:")
print(f"Selected Agent: {response.metadata.agent_name}")
if response.streaming:
print("Response:", response.output.content[0]["text"])
else:
print("Response:", response.output.content[0]["text"])
if __name__ == "__main__":
USER_ID = "user123"
SESSION_ID = str(uuid.uuid4())
print("Welcome to the interactive Multi-Agent system. Type 'quit' to exit.")
while True:
# Get user input
user_input = input("\nYou: ").strip()
if user_input.lower() == "quit":
print("Exiting the program. Goodbye!")
sys.exit()
# Run the async function
asyncio.run(handle_request(orchestrator, user_input, USER_ID, SESSION_ID))यदि आप प्रॉम्प्ट कर सकते हैं और उत्तर प्राप्त कर रहे हैं, तो सब कुछ ठीक से काम कर रहा है।
AWS Multi-Agent Orchestrator के साथ डेमो प्रोजेक्ट
AWS Multi-Agent Orchestrator रिपॉज़िटरी TypeScript और Python में कई उदाहरण प्रोजेक्ट्स प्रदान करती है। अब हम दो एजेंट्स—Python Developer Agent और ML Expert Agent—से मिलकर बना एक सरल Python एप्लिकेशन लिखेंगे।
हम Chainlit, एक ओपन-सोर्स Python पैकेज, का उपयोग एप्लिकेशन के लिए सरल UI लागू करने में भी करेंगे। शुरुआत करने के लिए आवश्यक लाइब्रेरीज़ इंस्टॉल करें:
chainlit==1.2.0
multi_agent_orchestrator==0.0.18हम नीचे दिया कोड अपने डेमो एप्लिकेशन के लिए उपयोग करेंगे, लेकिन पहले इसे समझ लेते हैं:
- हम आवश्यक लाइब्रेरीज़ इम्पोर्ट करने से शुरू करते हैं।
- हम अपने क्लासिफायर के लिए
“anthropic.claude-3-haiku-20240307-v1:0”मॉडल का उपयोग करते हैं। यह क्लासिफायर नए यूज़र इनपुट आने पर तय करेगा कि किस एजेंट का उपयोग करना है। MultiAgentOrchestratorको बनाए गए क्लासिफायर के साथ पास किया जाता है और कुछ कॉन्फ़िगरेशन परिभाषित किए जाते हैं।BedrockLLMAgentक्लास का उपयोग हमारे एजेंट्स बनाने के लिए किया जाता है। प्रत्येक एजेंट के लिएnameऔरdescriptionदी जाती है। किसी एजेंट के लिए, आप किसी भी एक्सेसिबल मॉडल का चयन कर सकते हैं या Ollama का उपयोग करके उन्हें लोकल रूप से चला सकते हैं।streaming=Trueसेट करना औरcallbackके रूप मेंChainlitAgentCallbacks()पास करना एजेंट्स को पूरी प्रतिक्रिया के बजाय स्ट्रीम्ड प्रतिक्रियाएँ लौटाने देगा। अंत में, हम प्रत्येक एजेंट को ऑर्केस्ट्रेटर में जोड़ते हैं।user_sessionसेट किया जाता है, और यूज़र व एजेंट संदेशों को संभालने वाला मुख्य सेक्शन परिभाषित किया जाता है।
### 1
import uuid
import chainlit as cl
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator, OrchestratorConfig
from multi_agent_orchestrator.classifiers import BedrockClassifier, BedrockClassifierOptions
from multi_agent_orchestrator.agents import AgentResponse
from multi_agent_orchestrator.agents import BedrockLLMAgent, BedrockLLMAgentOptions, AgentCallbacks
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator
from multi_agent_orchestrator.types import ConversationMessage
import asyncio
import chainlit as cl
class ChainlitAgentCallbacks(AgentCallbacks):
def on_llm_new_token(self, token: str) -> None:
asyncio.run(cl.user_session.get("current_msg").stream_token(token))
### 2
# Initialize the orchestrator & classifier
custom_bedrock_classifier = BedrockClassifier(BedrockClassifierOptions(
model_id='anthropic.claude-3-haiku-20240307-v1:0',
inference_config={
'maxTokens': 500,
'temperature': 0.7,
'topP': 0.9
}
))
### 3
orchestrator = MultiAgentOrchestrator(options=OrchestratorConfig(
LOG_AGENT_CHAT=True,
LOG_CLASSIFIER_CHAT=True,
LOG_CLASSIFIER_RAW_OUTPUT=True,
LOG_CLASSIFIER_OUTPUT=True,
LOG_EXECUTION_TIMES=True,
MAX_RETRIES=3,
USE_DEFAULT_AGENT_IF_NONE_IDENTIFIED=False,
MAX_MESSAGE_PAIRS_PER_AGENT=10,
),
classifier=custom_bedrock_classifier
)
### 4
def create_python_dev():
return BedrockLLMAgent(BedrockLLMAgentOptions(
name="Python Developer Agent",
streaming=True,
description="Experienced Python developer specialized in writing, debugging, and evaluating only Python code.",
model_id="anthropic.claude-3-sonnet-20240229-v1:0",
callbacks=ChainlitAgentCallbacks()
))
def create_ml_expert():
return BedrockLLMAgent(BedrockLLMAgentOptions(
name="Machine Learning Expert",
streaming=True,
description="Expert in areas related to machine learning including deep learning, pytorch, tensorflow, scikit-learn, and large language models.",
model_id="anthropic.claude-3-sonnet-20240229-v1:0",
callbacks=ChainlitAgentCallbacks()
))
# Add agents to the orchestrator
orchestrator.add_agent(create_python_dev())
orchestrator.add_agent(create_ml_expert())
### 5
@cl.on_chat_start
async def start():
cl.user_session.set("user_id", str(uuid.uuid4()))
cl.user_session.set("session_id", str(uuid.uuid4()))
cl.user_session.set("chat_history", [])
@cl.on_message
async def main(message: cl.Message):
user_id = cl.user_session.get("user_id")
session_id = cl.user_session.get("session_id")
msg = cl.Message(content="")
await msg.send() # Send the message immediately to start streaming
cl.user_session.set("current_msg", msg)
response:AgentResponse = await orchestrator.route_request(message.content, user_id, session_id, {})
# Handle non-streaming or problematic responses
if isinstance(response, AgentResponse) and response.streaming is False:
# Handle regular response
if isinstance(response.output, str):
await msg.stream_token(response.output)
elif isinstance(response.output, ConversationMessage):
await msg.stream_token(response.output.content[0].get('text'))
await msg.update()
if __name__ == "__main__":
cl.run()अब एप्लिकेशन चलाने का समय है। ऐसा करने के लिए, पहले chainlit run [app.py](<http://app.py/>) -w चलाएँ। अब आप अपने ब्राउज़र में खुले नए टैब में एप्लिकेशन का परीक्षण कर सकते हैं।
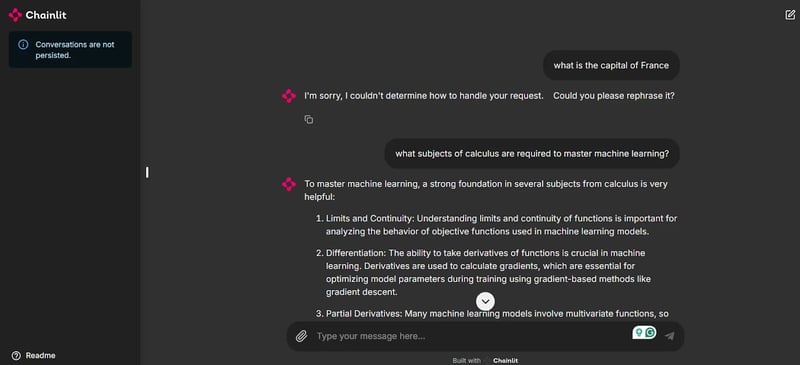
जैसा कि स्क्रीनशॉट में दिख रहा है, अब हमें अपनी एप्लिकेशन का परीक्षण करने और एजेंट्स से चैट करने के लिए एक UI मिल गया है।
ध्यान दें कि चूँकि पहला प्रॉम्प्ट “What is the capital of France?” हमारे किसी भी एजेंट से संबंधित नहीं है, इसलिए सिस्टम उत्तर नहीं देता। यह चैट्स को प्रासंगिक रखने और इन मॉडलों का उपयोग करते समय अनावश्यक क्रेडिट खर्च करने से बचने की कुंजी है। हालाँकि, जब संबंधित प्रश्न पूछा जाता है, तो हमारा Machine Learning Expert एजेंट Multi-Agent Orchestrator की इंटेलिजेंट रूटिंग की बदौलत उत्तर देने के लिए सक्रिय हो जाता है।
निष्कर्ष
इस ब्लॉग में, हमने हालिया AWS Multi-Agent Orchestrator फ्रेमवर्क का परिचय दिया, इसकी कुछ विशेष खूबियों को रेखांकित किया, वातावरण सेट अप करने के चरण बताए, Amazon Bedrock द्वारा प्रदान किए जाने वाले फाउंडेशनल मॉडलों का अन्वेषण किया, और एक डेमो प्रोजेक्ट लागू किया।
इस लेख को लिखते समय, फ्रेमवर्क में व्यापक और विस्तृत डॉक्यूमेंटेशन का अभाव है। मेमोरी और टूल उपयोग जैसी अन्य विशेषताओं का लाभ उठाने के लिए, आपको कोडबेस पढ़ना होगा और दिए गए उदाहरण प्रोजेक्ट्स पर नज़र डालनी होगी।
तेज़ी से विकसित हो रहे इस क्षेत्र के साथ बने रहने के लिए एजेंटिक AI फ्रेमवर्क्स पर जिज्ञासु नज़र रखना समझदारी है। AWS Multi-Agent Orchestrator AWS सेवाओं के इन्फ्रास्ट्रक्चर पर बना एक आशाजनक विकल्प है, और इसके विकास पर नज़र रखना worthwhile है।

कृत्रिम बुद्धिमत्ता में मास्टर'स छात्र और एआई तकनीकी लेखक। मैं नवीनतम एआई तकनीक पर अंतर्दृष्टि साझा करता/करती हूँ, एमएल शोध को सुलभ बनाता/बनाती हूँ, और जटिल एआई विषयों को सरल करता/करती हूँ ताकि आप हमेशा अग्रिम पंक्ति में बने रहें।
एजेंटिक AI के क्षेत्र में हर हफ्ते कुछ नया देखने को मिलता है। AWS Multi-Agent Orchestrator एक हालिया फ्रेमवर्क है जिसका उपयोग हम एक से अधिक AI एजेंट्स को प्रबंधित करने के लिए कर सकते हैं। चाहे हम ग्राहक सहायता प्रणाली बना रहे हों या कोई विशेष मल्टी-एजेंट एप्लिकेशन, इस फ्रेमवर्क पर विचार करना उपयुक्त है।
इस ट्यूटोरियल में, मैं बताऊंगा कि AWS Multi-Agent Orchestrator को खास क्या बनाता है, वातावरण सेट अप करने के चरण-दर-चरण निर्देश दूंगा, और फ्रेमवर्क को ऐक्शन में देखने के लिए एक डेमो प्रोजेक्ट विकसित करेंगे।