Leerpad
AI-toepassingen ontwikkelen
21 uur
De AWS Multi-Agent Orchestrator is een flexibel framework vol tools om AI-agents te beheren en complexe gesprekken met meerdere beurten te faciliteren. Dankzij de kant-en-klare componenten kun je snel ontwikkelen en deployen, zodat je je kunt richten op je applicatie zonder deze bouwstenen opnieuw te hoeven maken.
De AWS Multi-Agent Orchestrator biedt de volgende features:
Het framework is geïmplementeerd met ondersteuning voor zowel Python als TypeScript.
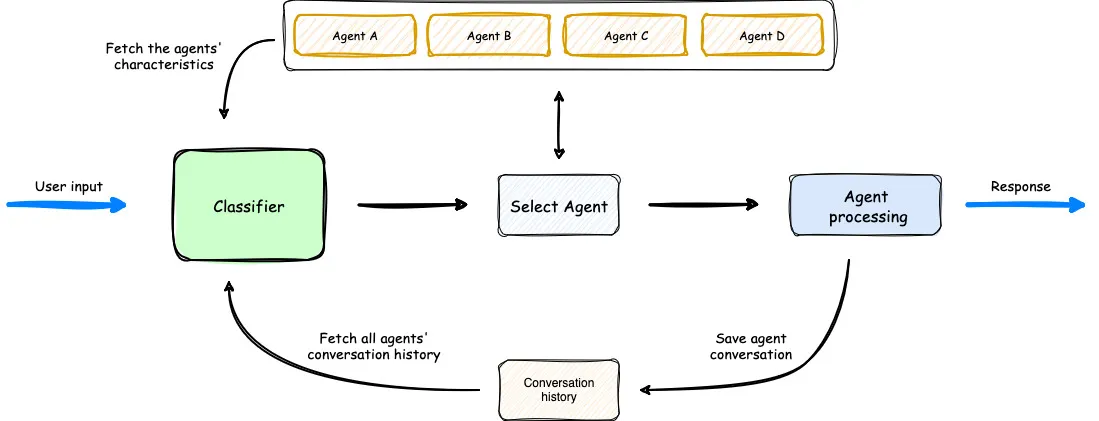
Een overzicht van hoe Multi-Agent Orchestrator werkt. (Bron)
In het bovenstaande diagram zien we dat de classifier de beschikbare agents, de gebruikersprompt en de eerdere gespreksgeschiedenis meeneemt om de optimale agent voor de gebruikersinvoer te kiezen. Vervolgens verwerkt de agent het verzoek. De workflow is eenvoudig maar doeltreffend.
Voor een snelle setup van de omgeving kun je de instructies in de documentatie volgen.
We maken eerst een nieuwe map en een nieuwe Python-omgeving om de vereiste libraries te installeren.
mkdir test_multi_agent_orchestrator
cd test_multi_agent_orchestrator
python -m venv venv
source venv/bin/activate  # On Windows use venv\\Scripts\\activate
Met de nieuwe virtuele omgeving geactiveerd, installeer je de library
pip install multi-agent-orchestratorVervolgens moeten we onze AWS-account configureren. Als je nog geen AWS-account hebt, meld je dan gratis aan voor een free tier-account. Download daarna de AWS CLI.
De AWS CLI moet ook geconfigureerd worden. Voor gedetailleerde instructies volg je Setting up the AWS CLI, maar je kunt ook een eenvoudigere aanpak kiezen door het commando aws configure te gebruiken en de AWS access key ID en secret access key op te geven. Je kunt deze sleutels verkrijgen nadat je een nieuwe gebruiker in je dashboard hebt aangemaakt.
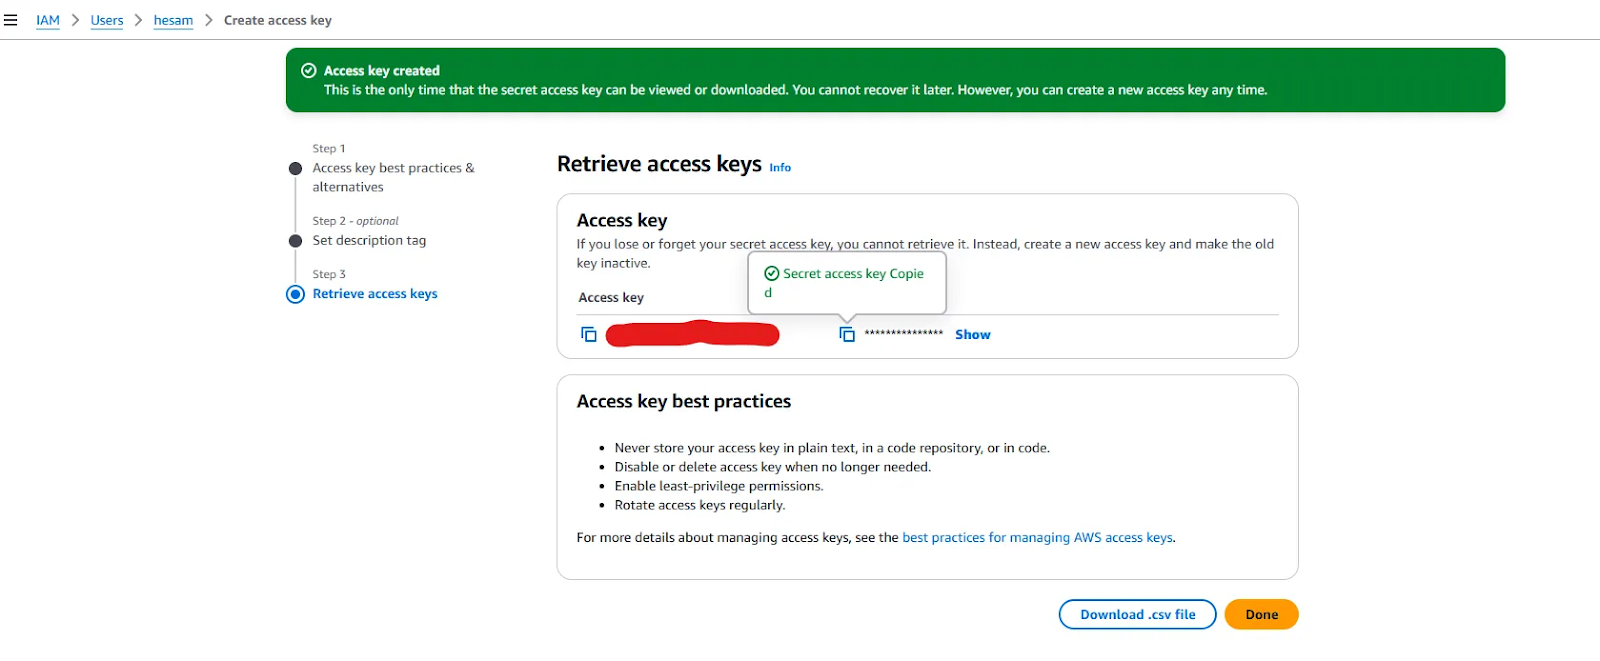
Access keys die worden verstrekt bij het aanmaken van een nieuwe gebruiker.
Met de access keys bij de hand voer je aws configure uit, geef je de sleutels op, kies je de regiobenaming (een volledige lijst vind je hier) die het dichtst bij je in de buurt ligt en stel je het standaarduitvoerformaat in op json.
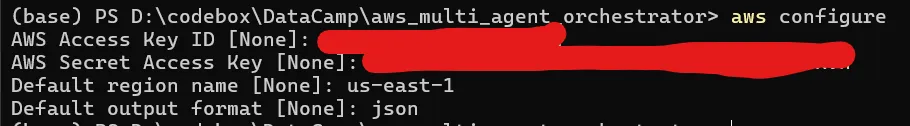
Als je CLI correct is geconfigureerd, zou het commando aws sts get-caller-identity je AWS-account-ID, user ID en ARN moeten tonen.
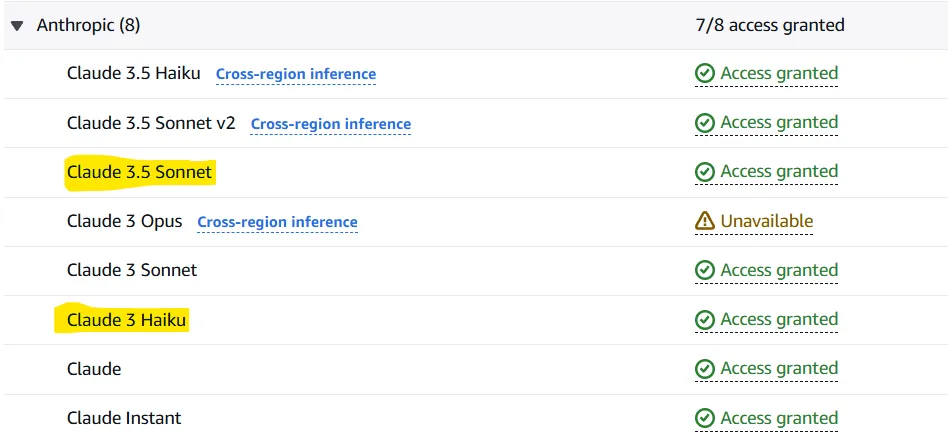
Nu de AWS CLI klaar is voor gebruik, moeten we AWS Bedrock configureren om toegang te geven tot de LLM's die we nodig hebben. Amazon Bedrock is een service waarmee je via een API foundation models (zoals Llama 3.2 of Claude 3.5 Sonnet) kunt testen en aanroepen. De Multi-Agent Orchestrator gebruikt deze service standaard om twee modellen aan te roepen:
Natuurlijk kun je deze modellen wijzigen, maar we gaan door met de standaardkeuze.
Om toegang te geven tot deze twee modellen, ga je naar Amazon Bedrock > Model Access en kies je "Modify model access". Selecteer de twee modellen (en eventueel andere) en vul de vereiste informatie in. Dit ziet er ongeveer zo uit:
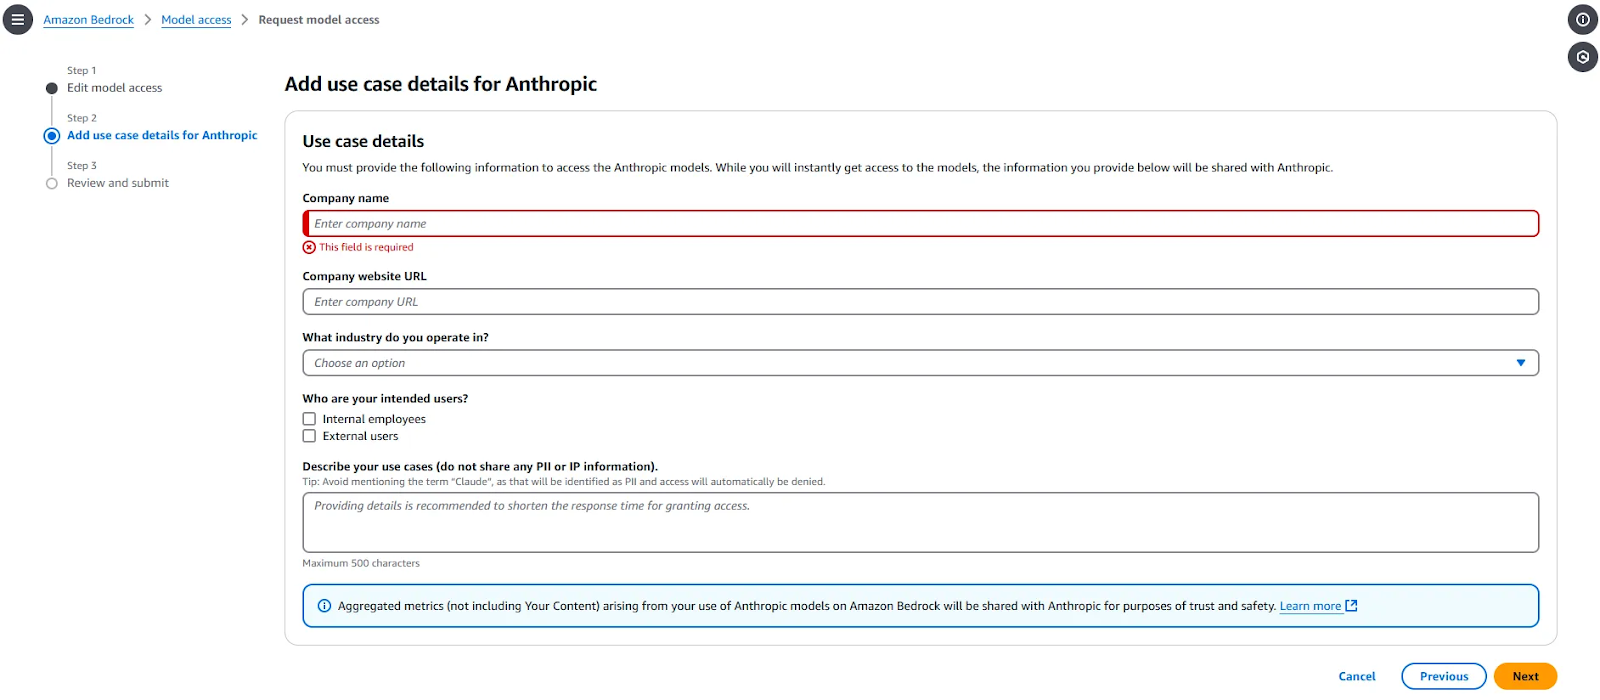
Na het afronden van de aanvraag zijn de modellen binnen 1-2 minuten beschikbaar. Wanneer toegang is verleend voor de aangevraagde modellen, zie je "Access granted" ervoor staan.
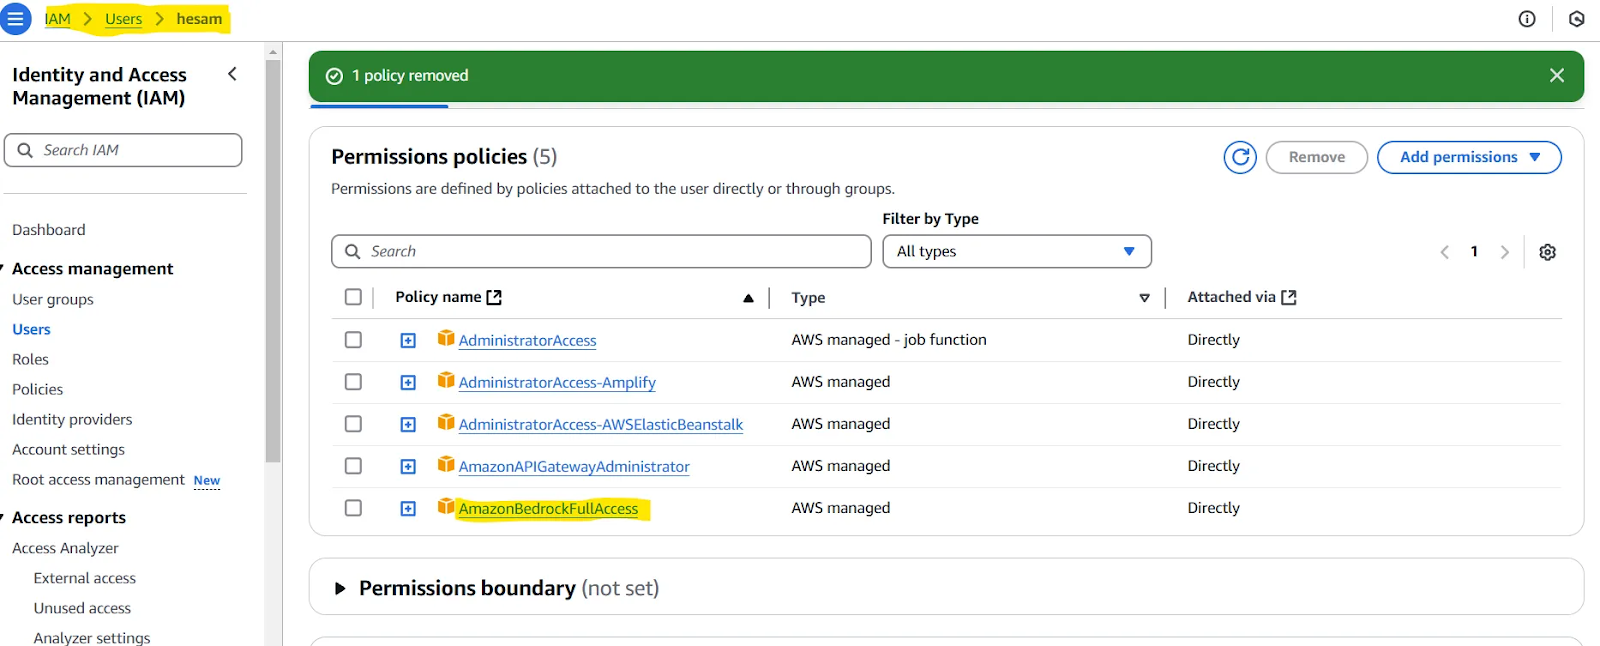
Let op: mogelijk moet je een policy toewijzen aan de gebruiker die je hebt aangemaakt. Je kunt dit testen als je problemen tegenkomt in de volgende subsectie van ons artikel (Test je setup). Raadpleeg in dat geval deze pagina. Samengevat: je moet de door jou gedefinieerde gebruiker toegang geven tot AmazonBedrockFullAccess.
Om te controleren of alle voorgaande stappen goed zijn ingesteld, gebruik je deze code:
import uuid
import asyncio
import json
import sys
from typing import Optional, List, Dict, Any
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator, OrchestratorConfig
from multi_agent_orchestrator.agents import (
    BedrockLLMAgent,
    BedrockLLMAgentOptions,
    AgentResponse,
    AgentCallbacks,
)
from multi_agent_orchestrator.types import ConversationMessage, ParticipantRole

orchestrator = MultiAgentOrchestrator(
    options=OrchestratorConfig(
        LOG_AGENT_CHAT=True,
        LOG_CLASSIFIER_CHAT=True,
        LOG_CLASSIFIER_RAW_OUTPUT=True,
        LOG_CLASSIFIER_OUTPUT=True,
        LOG_EXECUTION_TIMES=True,
        MAX_RETRIES=3,
        USE_DEFAULT_AGENT_IF_NONE_IDENTIFIED=True,
        MAX_MESSAGE_PAIRS_PER_AGENT=10,
    )
)


class BedrockLLMAgentCallbacks(AgentCallbacks):
    def on_llm_new_token(self, token: str) -> None:
        # handle response streaming here
        print(token, end="", flush=True)


tech_agent = BedrockLLMAgent(
    BedrockLLMAgentOptions(
        name="Tech Agent",
        streaming=True,
        description=(
            "Specializes in technology areas including software development, hardware, AI, "
            "cybersecurity, blockchain, cloud computing, emerging tech innovations, and pricing/costs "
            "related to technology products and services."
        ),
        model_id="anthropic.claude-3-sonnet-20240229-v1:0",
        callbacks=BedrockLLMAgentCallbacks(),
    )
)

orchestrator.add_agent(tech_agent)


async def handle_request(
    _orchestrator: MultiAgentOrchestrator, _user_input: str, _user_id: str, _session_id: str
):
    response: AgentResponse = await _orchestrator.route_request(
        _user_input, _user_id, _session_id
    )
    # Print metadata
    print("\nMetadata:")
    print(f"Selected Agent: {response.metadata.agent_name}")
    if response.streaming:
        print("Response:", response.output.content[0]["text"])
    else:
        print("Response:", response.output.content[0]["text"])


if __name__ == "__main__":
    USER_ID = "user123"
    SESSION_ID = str(uuid.uuid4())
    print("Welcome to the interactive Multi-Agent system. Type 'quit' to exit.")
    while True:
        # Get user input
        user_input = input("\nYou: ").strip()
        if user_input.lower() == "quit":
            print("Exiting the program. Goodbye!")
            sys.exit()
        # Run the async function
        asyncio.run(handle_request(orchestrator, user_input, USER_ID, SESSION_ID))
Als je kunt prompten en een antwoord krijgt, werkt alles zoals het hoort.
De repository van AWS Multi-Agent Orchestrator bevat meerdere voorbeeldprojecten in TypeScript en Python. We schrijven nu een vereenvoudigde Python-toepassing met twee agents: Python Developer Agent en ML Expert Agent.
We gebruiken ook Chainlit, een open-source Python-pakket, om een eenvoudige UI voor de applicatie te implementeren. Installeer om te beginnen de benodigde libraries:
chainlit==1.2.0
multi_agent_orchestrator==0.0.18
We gebruiken onderstaande code voor onze demo-applicatie, maar eerst even de uitleg:
“anthropic.claude-3-haiku-20240307-v1:0” als model voor onze classifier. Deze classifier kiest welke agent wordt gebruikt wanneer er nieuwe gebruikersinvoer binnenkomt.MultiAgentOrchestrator en definiëren enkele configuraties.BedrockLLMAgent wordt gebruikt om onze agents te maken. Voor elke agent geven we een name en een description op. Voor een agent kun je elk van de toegankelijke modellen kiezen of zelfs Ollama gebruiken om ze lokaal te draaien. Door streaming=True in te stellen en ChainlitAgentCallbacks() als callback door te geven, retourneren de agents gestreamde in plaats van volledige antwoorden. Tot slot voegen we elke agent toe aan de orchestrator.user_session wordt ingesteld en de hoofdsectie om gebruikers- en agentberichten af te handelen wordt gedefinieerd.### 1
import uuid
import chainlit as cl
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator, OrchestratorConfig
from multi_agent_orchestrator.classifiers import BedrockClassifier, BedrockClassifierOptions
from multi_agent_orchestrator.agents import AgentResponse
from multi_agent_orchestrator.agents import BedrockLLMAgent, BedrockLLMAgentOptions, AgentCallbacks
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator
from multi_agent_orchestrator.types import ConversationMessage
import asyncio
import chainlit as cl
class ChainlitAgentCallbacks(AgentCallbacks):
def on_llm_new_token(self, token: str) -> None:
asyncio.run(cl.user_session.get("current_msg").stream_token(token))
### 2
# Initialize the orchestrator & classifier
custom_bedrock_classifier = BedrockClassifier(BedrockClassifierOptions(
model_id='anthropic.claude-3-haiku-20240307-v1:0',
inference_config={
'maxTokens': 500,
'temperature': 0.7,
'topP': 0.9
}
))
### 3
orchestrator = MultiAgentOrchestrator(options=OrchestratorConfig(
LOG_AGENT_CHAT=True,
LOG_CLASSIFIER_CHAT=True,
LOG_CLASSIFIER_RAW_OUTPUT=True,
LOG_CLASSIFIER_OUTPUT=True,
LOG_EXECUTION_TIMES=True,
MAX_RETRIES=3,
USE_DEFAULT_AGENT_IF_NONE_IDENTIFIED=False,
MAX_MESSAGE_PAIRS_PER_AGENT=10,
),
classifier=custom_bedrock_classifier
)
### 4
def create_python_dev():
return BedrockLLMAgent(BedrockLLMAgentOptions(
name="Python Developer Agent",
streaming=True,
description="Experienced Python developer specialized in writing, debugging, and evaluating only Python code.",
model_id="anthropic.claude-3-sonnet-20240229-v1:0",
callbacks=ChainlitAgentCallbacks()
))
def create_ml_expert():
return BedrockLLMAgent(BedrockLLMAgentOptions(
name="Machine Learning Expert",
streaming=True,
description="Expert in areas related to machine learning including deep learning, pytorch, tensorflow, scikit-learn, and large language models.",
model_id="anthropic.claude-3-sonnet-20240229-v1:0",
callbacks=ChainlitAgentCallbacks()
))
# Add agents to the orchestrator
orchestrator.add_agent(create_python_dev())
orchestrator.add_agent(create_ml_expert())
### 5
@cl.on_chat_start
async def start():
cl.user_session.set("user_id", str(uuid.uuid4()))
cl.user_session.set("session_id", str(uuid.uuid4()))
cl.user_session.set("chat_history", [])
@cl.on_message
async def main(message: cl.Message):
user_id = cl.user_session.get("user_id")
session_id = cl.user_session.get("session_id")
msg = cl.Message(content="")
await msg.send() # Send the message immediately to start streaming
cl.user_session.set("current_msg", msg)
response:AgentResponse = await orchestrator.route_request(message.content, user_id, session_id, {})
# Handle non-streaming or problematic responses
if isinstance(response, AgentResponse) and response.streaming is False:
# Handle regular response
if isinstance(response.output, str):
await msg.stream_token(response.output)
elif isinstance(response.output, ConversationMessage):
await msg.stream_token(response.output.content[0].get('text'))
await msg.update()
if __name__ == "__main__":
cl.run()Het is nu tijd om de applicatie te draaien. Voer hiervoor eerst chainlit run [app.py](<http://app.py/>) -w uit. Je kunt je applicatie nu testen in het nieuwe tabblad dat in je browser is geopend.
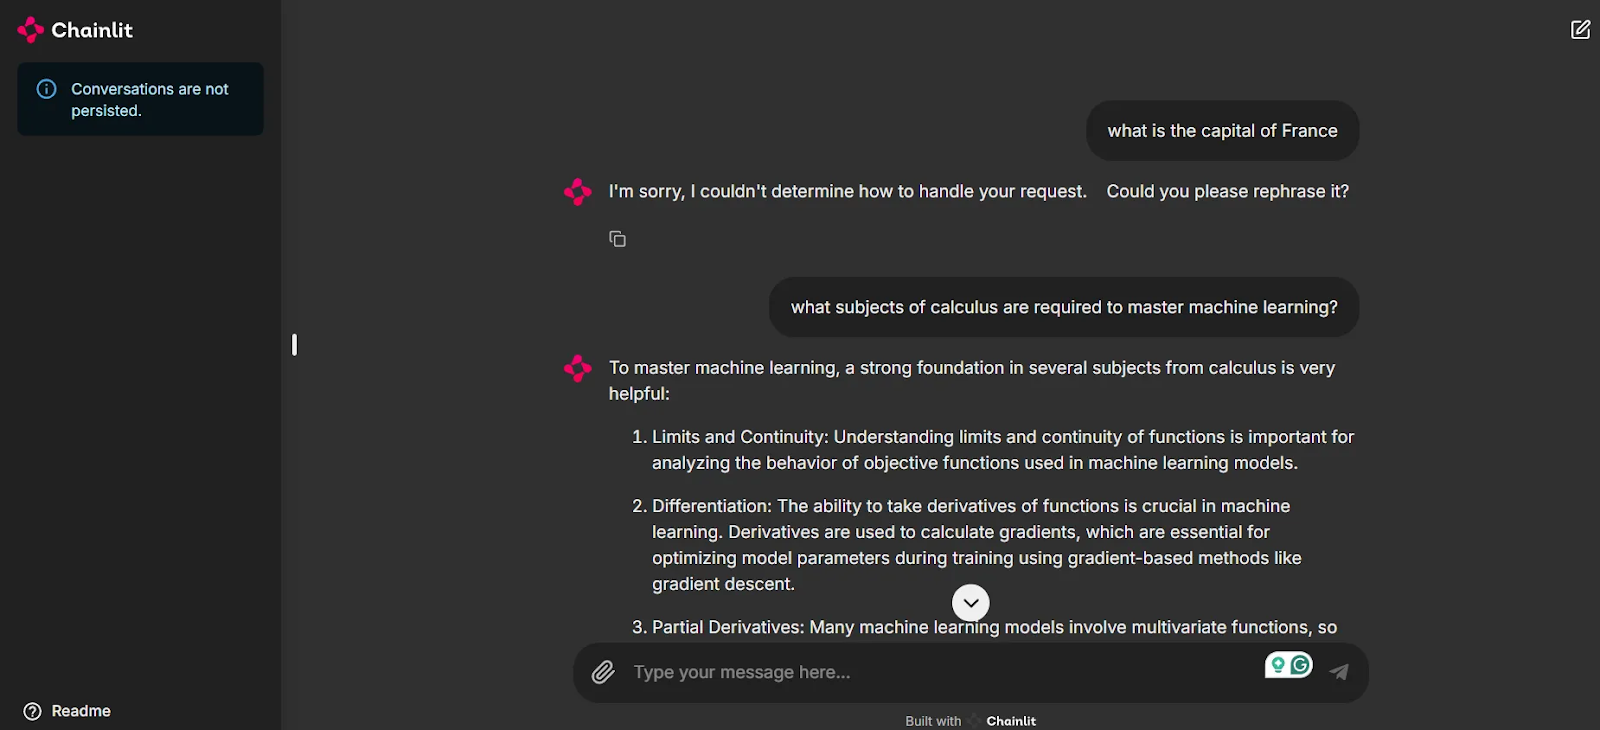
Zoals je in de screenshot kunt zien, hebben we nu een UI om onze applicatie te testen en met de agents te chatten.
Merk op dat omdat de eerste prompt “What is the capital of France?” niet gerelateerd is aan een van onze agents, het systeem geen antwoord geeft. Dit is cruciaal om de chats relevant te houden en onnodige credits te vermijden bij het gebruik van deze modellen. Wanneer echter een gerelateerde vraag wordt gesteld, komt onze Machine Learning Expert-agent in actie om een antwoord te geven, dankzij de intelligente routing van de Multi-Agent Orchestrator.
In deze blog hebben we het recente AWS Multi-Agent Orchestrator-framework geïntroduceerd, enkele unieke features uitgelicht, de stappen om de omgeving in te richten uiteengezet, de foundation models van Amazon Bedrock verkend en een demoproject geïmplementeerd.
Op het moment van schrijven ontbreekt het framework aan uitgebreide en gedetailleerde documentatie. Om te profiteren van andere features, zoals geheugen en toolgebruik, moet je de codebase lezen en de meegeleverde voorbeeldprojecten bekijken.
Een nieuwsgierige blik houden op agentische AI-frameworks is verstandig om dit snel evoluerende vakgebied bij te benen. De AWS Multi-Agent Orchestrator is een veelbelovende optie, gebouwd op de infrastructuur van AWS-services, en de verdere ontwikkeling is het volgen waard.
Leer AI met deze cursussen!
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

