Programma
Sviluppare applicazioni AI
21 ore
L’AWS Multi-Agent Orchestrator è un framework flessibile e ricco di strumenti, progettato per gestire agenti AI e facilitare conversazioni complesse multi-turno. I suoi componenti predefiniti consentono di sviluppare e distribuire rapidamente, così possiamo concentrarci sulla nostra applicazione senza dover ricostruire questi componenti da zero.
AWS Multi-Agent Orchestrator offre le seguenti funzionalità:
Il framework è implementato con supporto sia per Python sia per TypeScript.
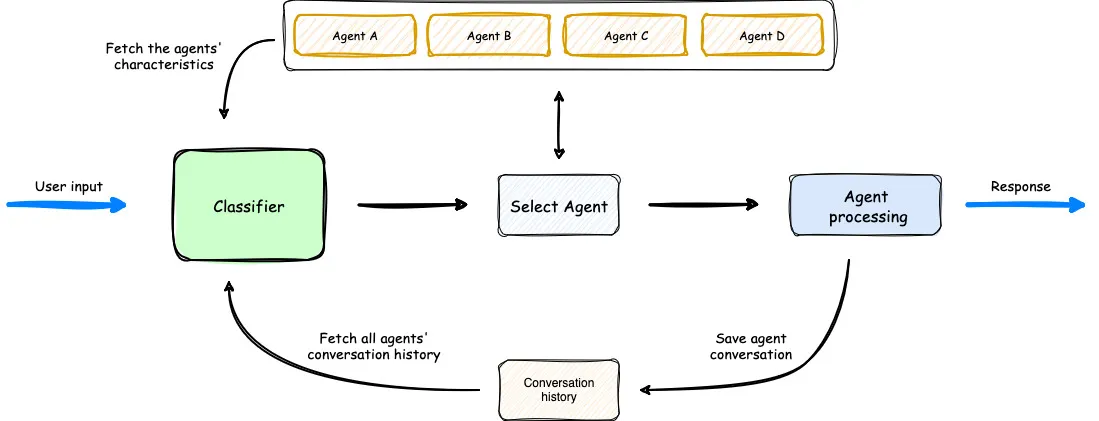
Panoramica del funzionamento di Multi-Agent Orchestrator. (Fonte)
Nel diagramma sopra, vediamo che il classificatore considera gli agenti disponibili, il prompt dell’utente e la cronologia della conversazione per selezionare l’agente migliore per l’input. Quindi l’agente elabora la richiesta. Il flusso è semplice ma efficace.
Per una configurazione rapida dell’ambiente, puoi seguire le istruzioni nella documentazione.
Per prima cosa, creiamo una nuova cartella e un nuovo ambiente Python per installare le librerie richieste.
mkdir test_multi_agent_orchestrator
cd test_multi_agent_orchestrator
python -m venv venv
source venv/bin/activate  # On Windows use venv\\Scripts\\activate
Con il nuovo ambiente virtuale attivato, installa la libreria
pip install multi-agent-orchestratorSuccessivamente, dobbiamo configurare il nostro account AWS. Se non ne hai uno, registrati gratuitamente per un account free tier. Dopo la registrazione, scarica l’AWS CLI.
Anche l’AWS CLI deve essere configurata. Per istruzioni dettagliate, segui Configurare l’AWS CLI, ma puoi procedere in modo più semplice usando il comando aws configure e fornendo l’AWS access key ID e la secret access key. Puoi ottenere queste chiavi dopo aver creato un nuovo utente nella tua dashboard.
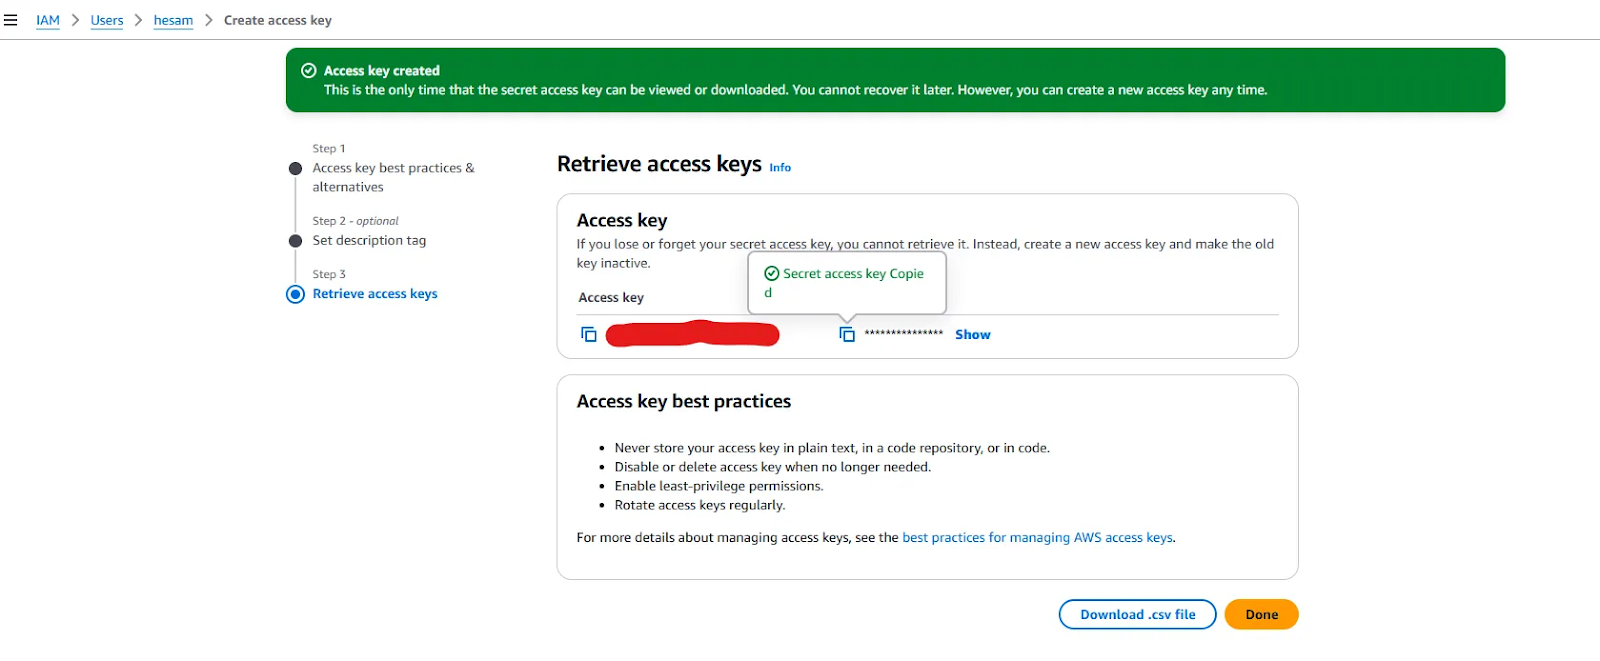
Chiavi di accesso fornite quando si crea un nuovo utente.
Con le chiavi a portata di mano, esegui aws configure e fornisci le chiavi, seleziona il nome della regione ( qui trovi l’elenco completo) più vicina a te e imposta il formato di output predefinito su json.
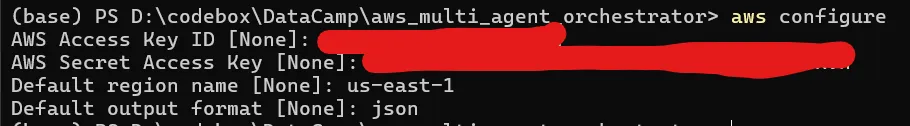
Se la tua CLI è configurata correttamente, eseguendo il comando aws sts get-caller-identity dovresti vedere l’ID dell’account AWS, l’ID utente e l’ARN.
Ora che l’AWS CLI è pronta, dobbiamo configurare AWS Bedrock per dare accesso ai LLM di cui avremo bisogno. Amazon Bedrock è un servizio che consente di testare e chiamare modelli fondamentali (come Llama 3.2 o Claude 3.5 Sonnet) tramite API. Il Multi-Agent Orchestrator usa questo servizio per chiamare due modelli per impostazione predefinita:
Ovviamente, questi modelli possono essere cambiati, ma proseguiamo con la scelta predefinita.
Per concedere l’accesso a questi due modelli, vai su Amazon Bedrock > Model Access e seleziona “Modify model access”. Seleziona i due modelli (e altri se vuoi) e compila le informazioni richieste. Questa parte apparirà così:
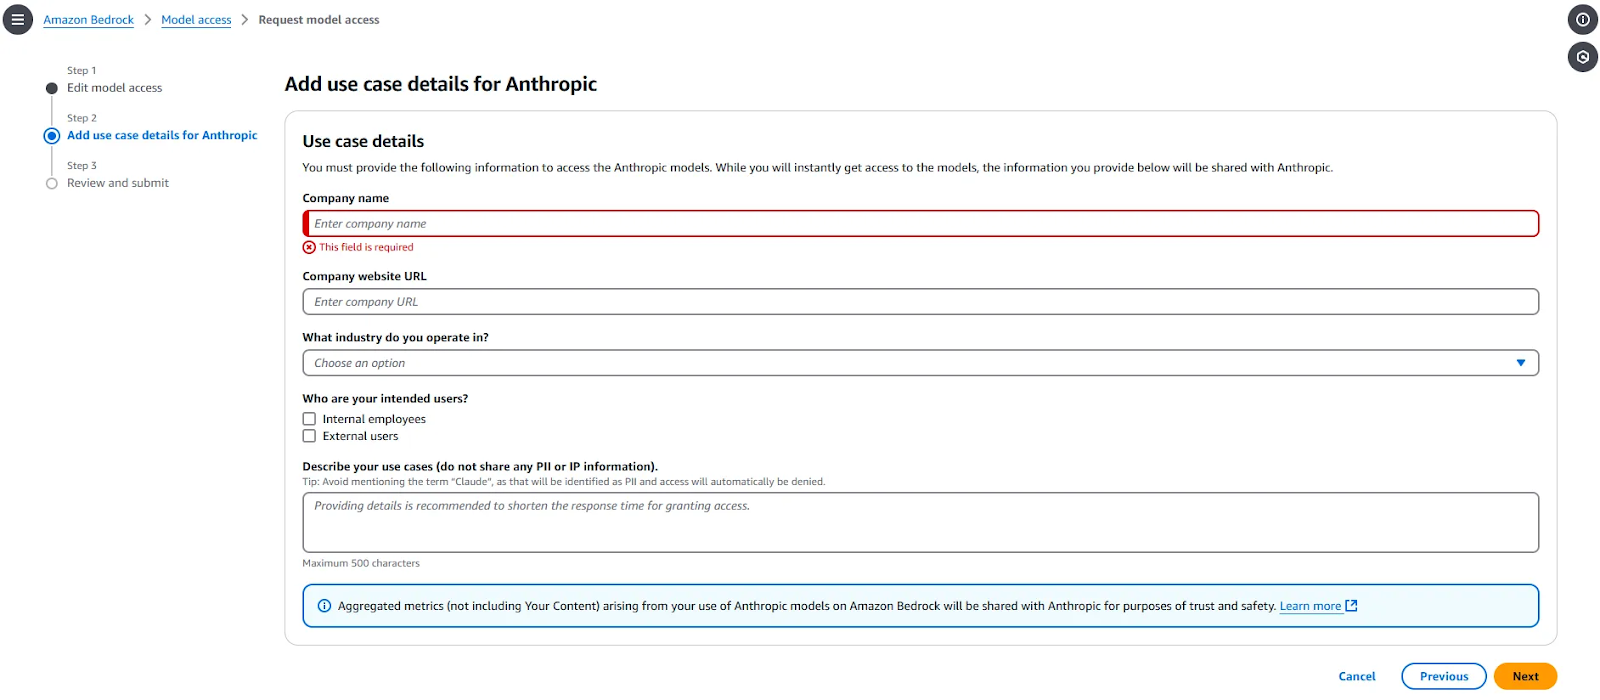
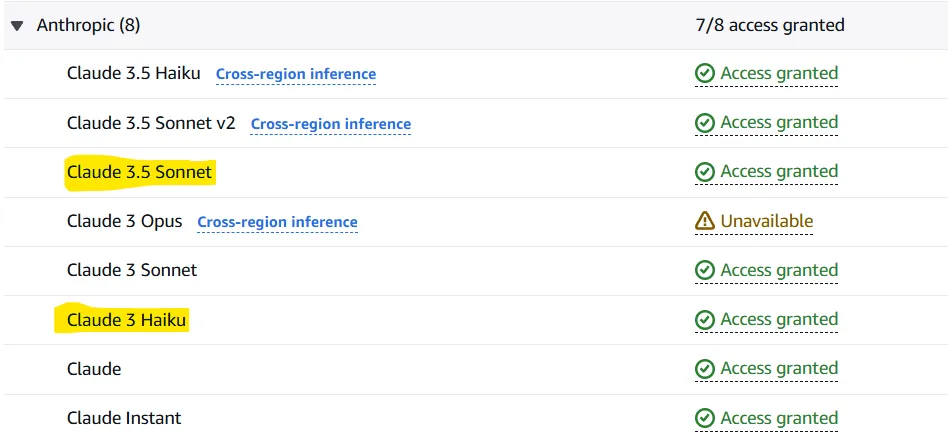
Dopo aver completato la richiesta, i modelli saranno disponibili in 1-2 minuti. Quando l’accesso è concesso per i modelli richiesti, dovresti vedere “Access granted” davanti a ciascuno.
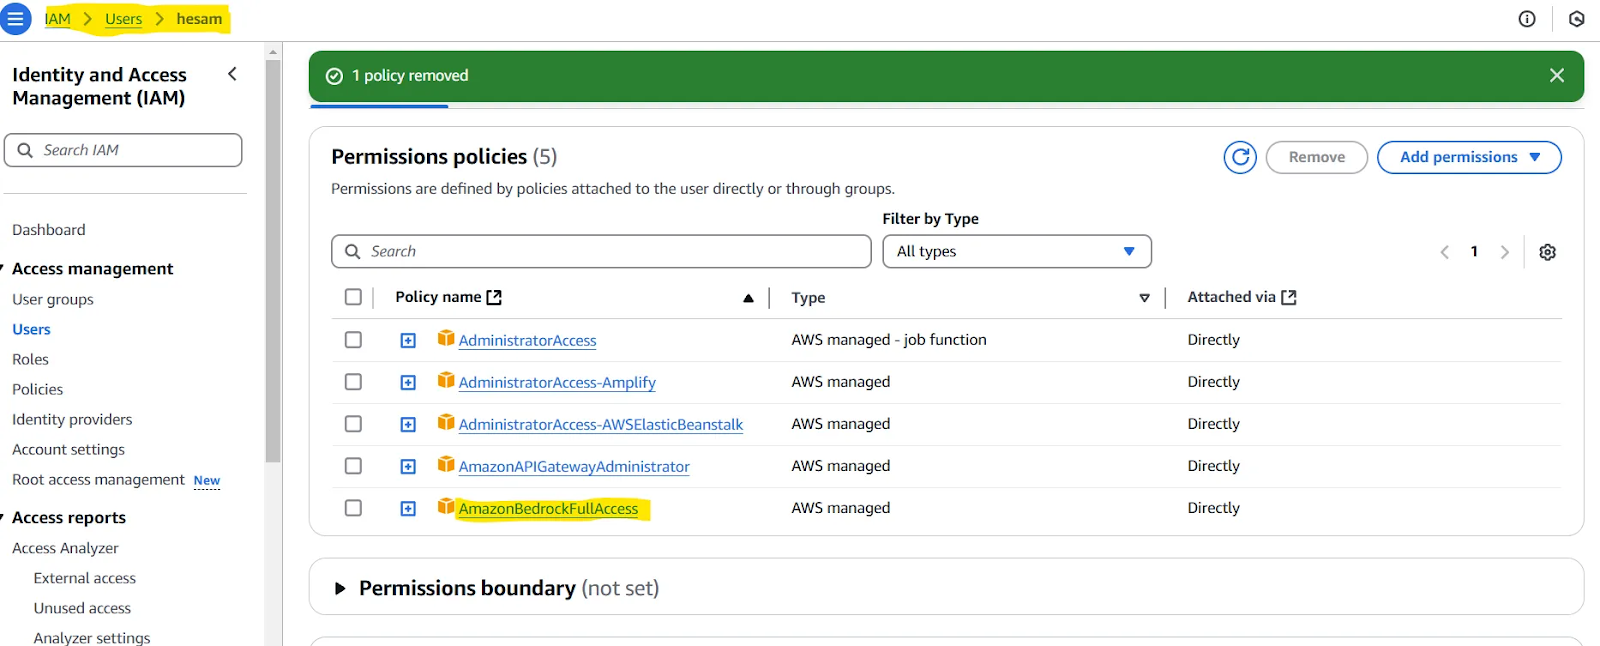
Nota: potrebbe essere necessario assegnare una policy all’utente che hai creato. Puoi verificarlo se riscontri problemi nella prossima sottosezione dell’articolo (Testa la tua configurazione). In tal caso, consulta questa pagina. In sintesi, dovresti concedere all’utente definito l’accesso a AmazonBedrockFullAccess.
Per verificare che tutti i passaggi precedenti siano stati eseguiti correttamente, usa questo codice:
import uuid
import asyncio
import json
import sys
from typing import Optional, List, Dict, Any
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator, OrchestratorConfig
from multi_agent_orchestrator.agents import (
    BedrockLLMAgent,
    BedrockLLMAgentOptions,
    AgentResponse,
    AgentCallbacks,
)
from multi_agent_orchestrator.types import ConversationMessage, ParticipantRole

orchestrator = MultiAgentOrchestrator(
    options=OrchestratorConfig(
        LOG_AGENT_CHAT=True,
        LOG_CLASSIFIER_CHAT=True,
        LOG_CLASSIFIER_RAW_OUTPUT=True,
        LOG_CLASSIFIER_OUTPUT=True,
        LOG_EXECUTION_TIMES=True,
        MAX_RETRIES=3,
        USE_DEFAULT_AGENT_IF_NONE_IDENTIFIED=True,
        MAX_MESSAGE_PAIRS_PER_AGENT=10,
    )
)


class BedrockLLMAgentCallbacks(AgentCallbacks):
    def on_llm_new_token(self, token: str) -> None:
        # handle response streaming here
        print(token, end="", flush=True)


tech_agent = BedrockLLMAgent(
    BedrockLLMAgentOptions(
        name="Tech Agent",
        streaming=True,
        description=(
            "Specializes in technology areas including software development, hardware, AI, "
            "cybersecurity, blockchain, cloud computing, emerging tech innovations, and pricing/costs "
            "related to technology products and services."
        ),
        model_id="anthropic.claude-3-sonnet-20240229-v1:0",
        callbacks=BedrockLLMAgentCallbacks(),
    )
)

orchestrator.add_agent(tech_agent)


async def handle_request(
    _orchestrator: MultiAgentOrchestrator, _user_input: str, _user_id: str, _session_id: str
):
    response: AgentResponse = await _orchestrator.route_request(
        _user_input, _user_id, _session_id
    )
    # Print metadata
    print("\nMetadata:")
    print(f"Selected Agent: {response.metadata.agent_name}")
    if response.streaming:
        print("Response:", response.output.content[0]["text"])
    else:
        print("Response:", response.output.content[0]["text"])


if __name__ == "__main__":
    USER_ID = "user123"
    SESSION_ID = str(uuid.uuid4())
    print("Welcome to the interactive Multi-Agent system. Type 'quit' to exit.")
    while True:
        # Get user input
        user_input = input("\nYou: ").strip()
        if user_input.lower() == "quit":
            print("Exiting the program. Goodbye!")
            sys.exit()
        # Run the async function
        asyncio.run(handle_request(orchestrator, user_input, USER_ID, SESSION_ID))
Se riesci a inviare un prompt e ricevere una risposta, tutto funziona correttamente.
Il repository di AWS Multi-Agent Orchestrator fornisce diversi progetti di esempio in TypeScript e Python. Ora scriveremo un’applicazione Python semplificata composta da due agenti: Python Developer Agent e ML Expert Agent.
Useremo anche Chainlit, un pacchetto Python open source, per implementare una semplice UI per l’applicazione. Per iniziare, installa le librerie necessarie:
chainlit==1.2.0
multi_agent_orchestrator==0.0.18
Useremo il codice qui sotto per la nostra applicazione demo, ma prima spieghiamolo:
“anthropic.claude-3-haiku-20240307-v1:0” come modello per il nostro classificatore. Questo classificatore sceglierà quale agente usare quando arriva un nuovo input dell’utente.MultiAgentOrchestrator e definiamo alcune configurazioni.BedrockLLMAgent è usata per creare i nostri agenti. Per ciascun agente vengono forniti un name e una description. Per un agente, puoi scegliere uno qualsiasi dei modelli accessibili o persino usare Ollama per eseguirli in locale. Impostando streaming=True e passando ChainlitAgentCallbacks() come callback gli agenti restituiranno risposte in streaming anziché complete. Infine, aggiungiamo ogni agente all’orchestrator.user_session e definita la sezione principale per gestire i messaggi di utente e agenti.### 1
import uuid
import chainlit as cl
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator, OrchestratorConfig
from multi_agent_orchestrator.classifiers import BedrockClassifier, BedrockClassifierOptions
from multi_agent_orchestrator.agents import AgentResponse
from multi_agent_orchestrator.agents import BedrockLLMAgent, BedrockLLMAgentOptions, AgentCallbacks
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator
from multi_agent_orchestrator.types import ConversationMessage
import asyncio
import chainlit as cl
class ChainlitAgentCallbacks(AgentCallbacks):
def on_llm_new_token(self, token: str) -> None:
asyncio.run(cl.user_session.get("current_msg").stream_token(token))
### 2
# Initialize the orchestrator & classifier
custom_bedrock_classifier = BedrockClassifier(BedrockClassifierOptions(
model_id='anthropic.claude-3-haiku-20240307-v1:0',
inference_config={
'maxTokens': 500,
'temperature': 0.7,
'topP': 0.9
}
))
### 3
orchestrator = MultiAgentOrchestrator(options=OrchestratorConfig(
LOG_AGENT_CHAT=True,
LOG_CLASSIFIER_CHAT=True,
LOG_CLASSIFIER_RAW_OUTPUT=True,
LOG_CLASSIFIER_OUTPUT=True,
LOG_EXECUTION_TIMES=True,
MAX_RETRIES=3,
USE_DEFAULT_AGENT_IF_NONE_IDENTIFIED=False,
MAX_MESSAGE_PAIRS_PER_AGENT=10,
),
classifier=custom_bedrock_classifier
)
### 4
def create_python_dev():
return BedrockLLMAgent(BedrockLLMAgentOptions(
name="Python Developer Agent",
streaming=True,
description="Experienced Python developer specialized in writing, debugging, and evaluating only Python code.",
model_id="anthropic.claude-3-sonnet-20240229-v1:0",
callbacks=ChainlitAgentCallbacks()
))
def create_ml_expert():
return BedrockLLMAgent(BedrockLLMAgentOptions(
name="Machine Learning Expert",
streaming=True,
description="Expert in areas related to machine learning including deep learning, pytorch, tensorflow, scikit-learn, and large language models.",
model_id="anthropic.claude-3-sonnet-20240229-v1:0",
callbacks=ChainlitAgentCallbacks()
))
# Add agents to the orchestrator
orchestrator.add_agent(create_python_dev())
orchestrator.add_agent(create_ml_expert())
### 5
@cl.on_chat_start
async def start():
cl.user_session.set("user_id", str(uuid.uuid4()))
cl.user_session.set("session_id", str(uuid.uuid4()))
cl.user_session.set("chat_history", [])
@cl.on_message
async def main(message: cl.Message):
user_id = cl.user_session.get("user_id")
session_id = cl.user_session.get("session_id")
msg = cl.Message(content="")
await msg.send() # Send the message immediately to start streaming
cl.user_session.set("current_msg", msg)
response:AgentResponse = await orchestrator.route_request(message.content, user_id, session_id, {})
# Handle non-streaming or problematic responses
if isinstance(response, AgentResponse) and response.streaming is False:
# Handle regular response
if isinstance(response.output, str):
await msg.stream_token(response.output)
elif isinstance(response.output, ConversationMessage):
await msg.stream_token(response.output.content[0].get('text'))
await msg.update()
if __name__ == "__main__":
cl.run()È il momento di eseguire l’applicazione. Per farlo, esegui prima chainlit run [app.py](<http://app.py/>) -w. Ora puoi testare la tua applicazione nella nuova scheda aperta nel browser.
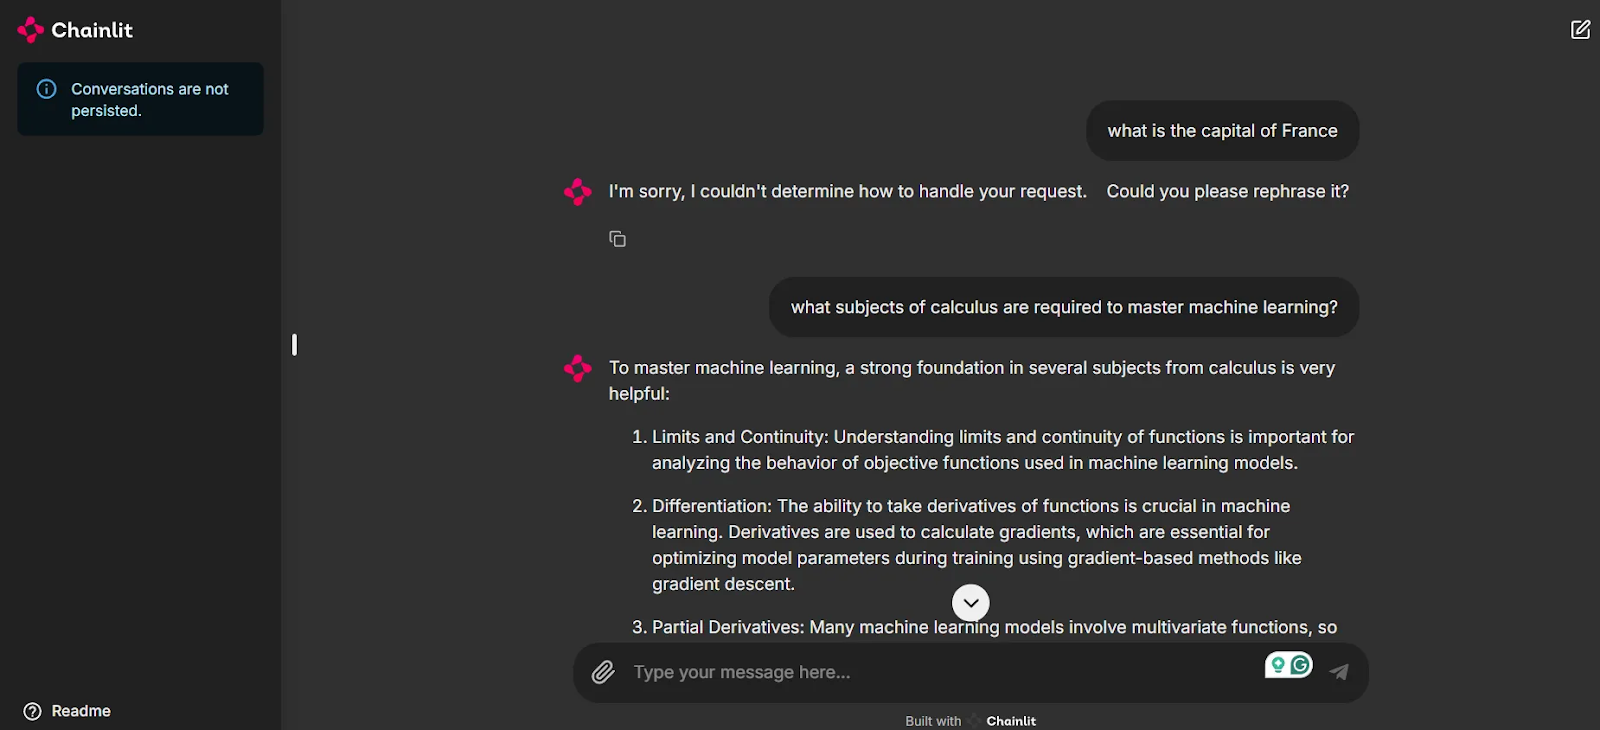
Come puoi vedere nello screenshot, ora abbiamo una UI per testare l’applicazione e chattare con gli agenti.
Nota che, poiché il primo prompt “Qual è la capitale della Francia?” non è pertinente a nessuno dei nostri agenti, il sistema non fornisce una risposta. Questo è fondamentale per mantenere le chat rilevanti ed evitare di spendere crediti inutili quando si usano questi modelli. Tuttavia, quando si pone una domanda pertinente, il nostro agente Machine Learning Expert entra in gioco per fornire una risposta, grazie all’instradamento intelligente del Multi-Agent Orchestrator.
In questo blog abbiamo introdotto il recente framework AWS Multi-Agent Orchestrator, evidenziato alcune sue funzionalità uniche, delineato i passaggi per configurare l’ambiente, esplorato i modelli fondamentali offerti da Amazon Bedrock e implementato un progetto demo.
Al momento della stesura di questo articolo, al framework manca una documentazione completa e dettagliata. Per sfruttare altre funzionalità, come memoria e uso di tool, devi leggere il codice e dare un’occhiata ai progetti di esempio forniti.
Tenere d’occhio con curiosità i framework di AI agentica è una buona scelta per restare al passo in questo campo frenetico. AWS Multi-Agent Orchestrator è un’opzione promettente costruita sulle infrastrutture dei servizi AWS, e il suo sviluppo merita attenzione.
Impara l’AI con questi corsi!
Programma
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



