Kursus
Konsep Large Language Models (LLM)
2 jam
113.3K
Bayangkan sebuah Large Language Model (LLM) di mana jawaban yang Anda terima tidak hanya relevan; tetapi juga dikurasi dengan cermat, diprioritaskan, dan disesuaikan agar tepat dengan kebutuhan Anda. Meskipun LLM telah merevolusi ranah AI, model ini tidak bebas dari keterbatasan. Masalah seperti halusinasi dan kedaluwarsa data dapat menurunkan akurasi dan relevansi output. Di sinilah Retrieval-Augmented Generation (RAG) dan reranking berperan, menawarkan cara untuk meningkatkan LLM dengan mengintegrasikannya dengan proses pencarian informasi yang dinamis dan mutakhir. Penasaran dengan langkah-langkah “resep” ini? Teruskan membaca.
LLM telah merevolusi ranah AI dan mendorong batasan dari apa yang dapat kita capai dengan menggunakan AI. Model ini telah menjadi alat andalan bagi siapa pun yang mencari solusi NLP serbaguna di hampir semua domain dengan memodelkan beragam tugas pemahaman dan generasi bahasa alami, seperti yang ditunjukkan di bawah ini.
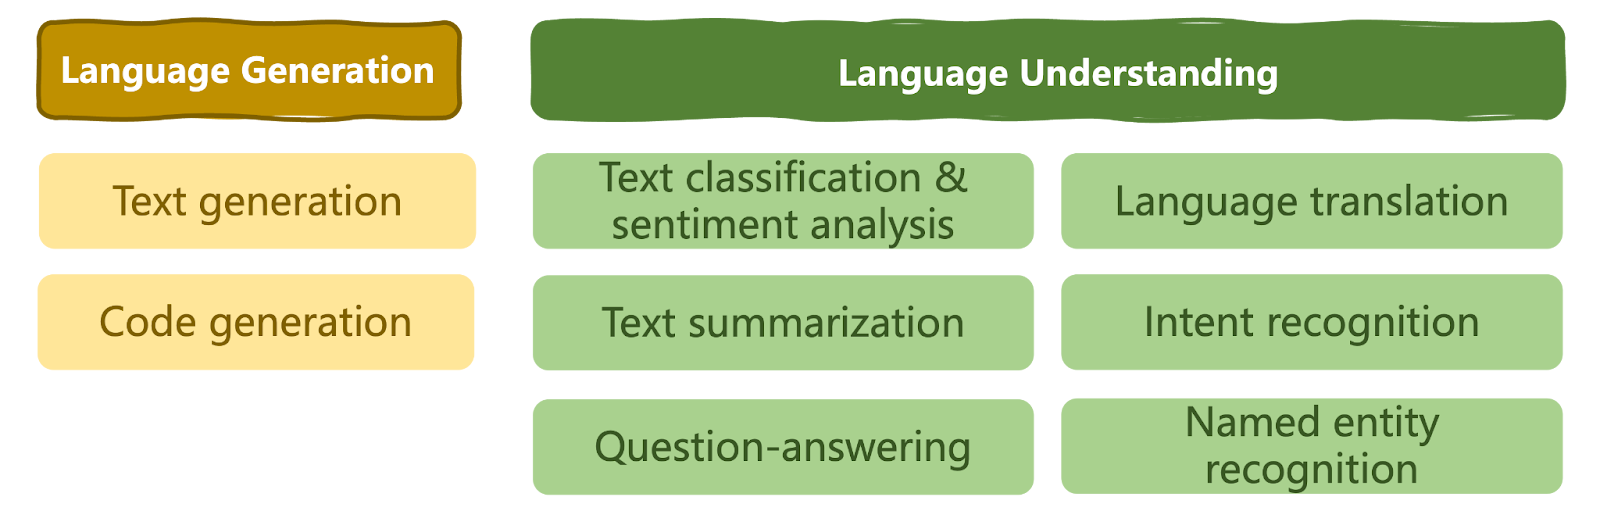
Taksonomi tugas bahasa yang dapat diselesaikan oleh LLM | Iván Palomares
Terlepas dari kemampuannya, LLM juga memiliki keterbatasan pada skenario tertentu. Bergantung pada kasus penggunaan spesifik dan pengetahuan yang dipelajari dari dataset masif tempat model dilatih, LLM terkadang gagal menghasilkan teks yang koheren, relevan, atau tepat konteks. Kadang-kadang, ketika tidak ada data faktual yang relevan untuk menyusun jawaban atas pertanyaan pengguna, model bahkan dapat menghasilkan informasi yang salah atau tidak masuk akal seolah-olah itu benar. Fenomena ini dikenal sebagai halusinasi.
Pertimbangkan, misalnya, pertanyaan: "Apa gejala flu yang umum?"
LLM standar mungkin menghasilkan jawaban berdasarkan pengetahuan umum, dengan mencantumkan gejala umum seperti demam, batuk, dan nyeri tubuh.
Namun, kecuali jika model dilatih pada data virus flu yang sangat spesifik domain, LLM mungkin tidak mempertimbangkan variasi tingkat keparahan gejala atau membedakan antar strain flu, sehingga memberikan jawaban yang cukup generik dan bahkan terasa “otomatis” kepada berbagai pengguna, terlepas dari situasi atau kebutuhan mereka.
Lebih jauh lagi, jika misalnya model dilatih pada data klinis flu yang dikumpulkan hingga Desember 2023, lalu muncul strain flu baru yang cepat menyebar pada Januari 2024, LLM mandiri tidak akan mampu memberikan jawaban akurat karena kurangnya pengetahuan terbaru tentang domain masalah.
Masalah “kedaluwarsa data” ini dikenal sebagai knowledge cut-off.
Dalam beberapa kasus, solusi untuk masalah di atas adalah sering melatih ulang dan melakukan fine-tuning LLM pada informasi yang segar dan mutakhir. Namun, apakah ini selalu langkah terbaik?
LLM (Large Language Models) diketahui menantang dan mahal secara komputasi untuk dilatih. Model membutuhkan jutaan hingga miliaran instance data teks dan sering kali ribuan teks spesifik domain untuk fine-tuning (lihat diagram di bawah).
Sebagian besar LLM, bahkan yang spesifik domain, biasanya di-fine-tune untuk bekerja di domain cakupan luas, seperti kesehatan. Oleh karena itu, memasukkan data yang lebih rinci untuk mengakomodasi semua kemungkinan nuansa kontekstual di seluruh domain mungkin bukan solusi paling efisien.
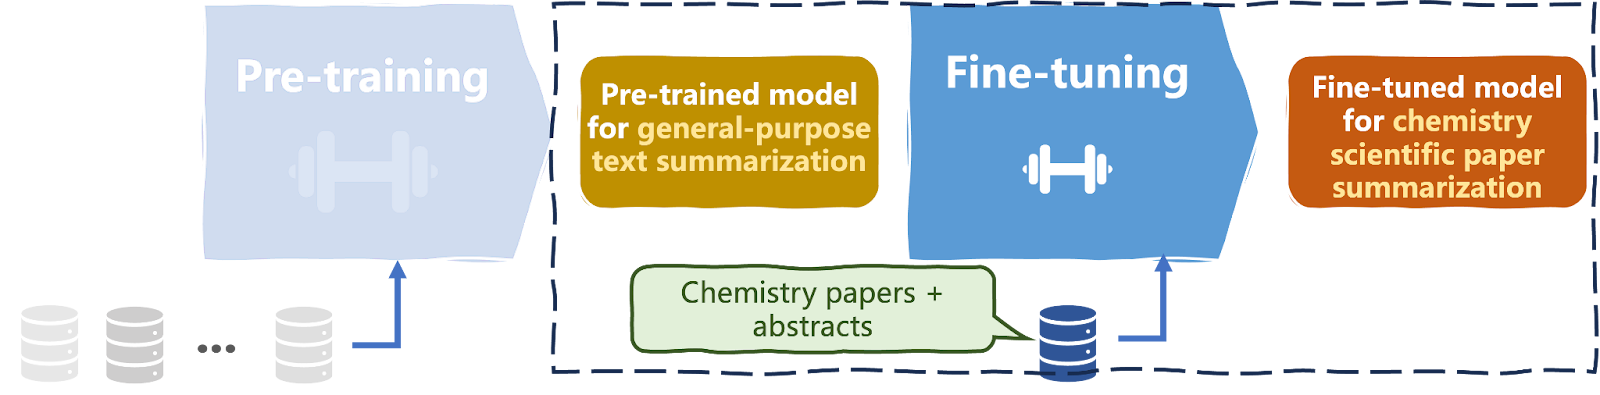
Pra-pelatihan dan fine-tuning sebuah LLM | Iván Palomares
Di sinilah RAG (Retrieval Augmented Generation) membantu!
RAG adalah proses pencarian informasi yang mengoptimalkan output yang dihasilkan oleh LLM. LLM mengandalkan pengetahuan yang diperoleh dari data tempat mereka dibangun untuk menghasilkan respons.
Sementara itu, RAG merujuk pada basis pengetahuan eksternal.
Dengan menggabungkan keduanya, RAG dapat digunakan untuk meningkatkan kualitas, relevansi bagi pengguna, koherensi, dan kebenaran dari output “mentah” yang dihasilkan LLM dengan mengambil pengetahuan dari basis pengetahuan tersebut.
Hasilnya, kebutuhan untuk terus-menerus melatih ulang LLM agar menyesuaikan diri dengan konteks dan situasi baru yang terus bermunculan menjadi jauh berkurang.
Alur kerja umum dari sistem RAG dijelaskan secara sederhana di bawah ini:
Kembali ke contoh flu, dengan RAG, model dapat mengambil informasi terbaru dan relevan dari database medis atau artikel terkini, sehingga mampu menghasilkan jawaban yang lebih bernuansa dan akurat bagi pasien atau praktisi.
Model dapat memasukkan wawasan tentang strain flu saat ini, variasi gejala di wilayah tertentu, atau pola yang sedang muncul, sehingga memberikan respons yang lebih relevan dan koheren terhadap pertanyaan pengguna.
Reranking adalah proses pencarian informasi di mana himpunan hasil awal yang diambil diurutkan ulang untuk meningkatkan relevansi terhadap kueri, kebutuhan, dan konteks pengguna, sehingga meningkatkan kualitas output keseluruhan. Begini cara kerjanya:
Diagram berikut menggambarkan proses reranking:
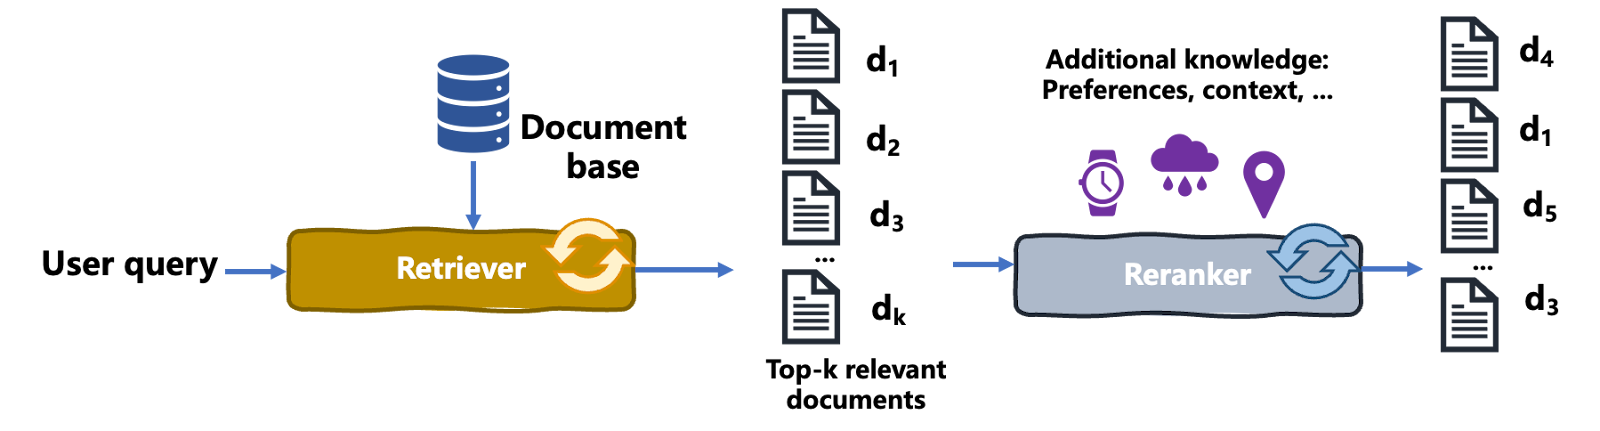
Proses reranking | Iván Palomares
Mari perjelas satu poin penting di sini: reranking mengurutkan ulang dokumen yang diambil berdasarkan berbagai kriteria, seperti preferensi pengguna. Namun, reranking berbeda dari mesin rekomendasi, seperti yang menyarankan produk relevan untuk dibeli di situs e-niaga.
Reranking digunakan pada kasus penggunaan pencarian di mana pengguna memberikan kueri input secara waktu nyata.
Sebaliknya, mesin rekomendasi secara proaktif membuat saran yang dipersonalisasi untuk pengguna berdasarkan interaksi dan preferensi mereka dari waktu ke waktu.
Mari kita tinjau lagi contoh flu.
Bayangkan seorang tenaga kesehatan menelusuri "perawatan terbaik untuk gejala flu." Sistem retrieval awal mungkin mengembalikan daftar dokumen, termasuk informasi umum tentang flu, pedoman perawatan, dan artikel penelitian.
Namun, model reranking, mungkin dengan menggunakan data spesifik pasien dan informasi kontekstual tambahan, kemudian dapat mengurutkan ulang dokumen-dokumen tersebut untuk memprioritaskan protokol perawatan yang paling relevan dan terbaru, kiat perawatan pasien, serta studi terulas sejawat yang langsung membahas gejala flu dan penanganannya, sehingga memprioritaskan hasil yang “langsung ke pokok masalah”.
Singkatnya, reranking menata ulang daftar dokumen yang diambil berdasarkan kriteria relevansi tambahan untuk menampilkan yang paling relevan bagi pengguna spesifik terlebih dahulu.
Reranking sangat berguna pada Large Language Models (LLM) yang dilengkapi Retrieval-Augmented Generation (RAG). RAG menggabungkan LLM dengan pengambilan dokumen eksternal untuk memberikan respons yang lebih terinformasi dan akurat.
Setelah pengambilan dokumen awal berdasarkan kueri, proses reranking dapat memperhalus seleksi, memastikan LLM bekerja dengan informasi yang paling relevan dan berkualitas tinggi.
Proses ini meningkatkan performa keseluruhan LLM, memperbaiki akurasi dan relevansi respons, khususnya pada domain spesialis di mana informasi presisi sangat krusial.
Tidak ada satu resep tunggal untuk mengimplementasikan reranker. Beberapa pendekatan telah mapan, di antaranya:
Sekarang kita memahami manfaat memasukkan RAG ke dalam LLM, serta mekanisme reranking untuk pencarian pengetahuan, saatnya mengintegrasikan elemen-elemen ini dan melihatnya beraksi.
Contoh ini menggunakan pustaka Langchain (versi komunitas) untuk membangun pipeline RAG sederhana dengan reranking. Pelajari lebih banyak tentang pengembangan aplikasi LLM dengan Langchain di kursus Developing LLM Applications dan tutorial cara membangun aplikasi LLM dengan Langchain.
Kodenya diimplementasikan dalam notebook Google Colab.
pip install -U langchain-communityPertama, kita memasang langchain-community di notebook.
Berikutnya, impor paket, kelas, dan fungsi yang diperlukan.
import os
from langchain.vectorstores import FAISS
from langchain.embeddings import OpenAIEmbeddings
from langchain.llms import OpenAI
from langchain.prompts import PromptTemplate
from langchain.text_splitter import CharacterTextSplitter
from langchain.schema import Document
from langchain.chains.qa_with_sources import load_qa_with_sources_chain
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np
Fungsi berikut didefinisikan untuk memuat daftar dokumen (berkas .txt) dari direktori lokal yang dapat diakses notebook Anda. Dokumen inilah yang akan diambil dan di-rerank untuk meningkatkan output LLM:
# Function to load documents from a directory
def load_documents_from_directory(directory_path):
    documents = []
    for filename in os.listdir(directory_path):
        if filename.endswith(".txt"):
            with open(os.path.join(directory_path, filename), 'r') as file:
                documents.append(file.read())
    return documents

# Load documents from the specified directory
directory_path = "./sample_data"
documents = load_documents_from_directory(directory_path)
Untuk mengoptimalkan performa representasi embedding dokumen teks, kita membatasi ukurannya hingga 1000 dan membagi dokumen yang lebih panjang menjadi potongan yang lebih kecil. Kelas CharacterTextSplitter membantu melakukannya.
Argumen chunk_overlap diatur ke 0 untuk menghindari tumpang tindih bagian teks antar potongan.
# Split documents into chunks for better embedding performance
text_splitter = CharacterTextSplitter(chunk_size=1000, chunk_overlap=0)
docs = text_splitter.split_documents(documents)
Kita akan menggunakan embedding OpenAI untuk membangun penyimpanan vektor embedding. Perhatikan bahwa bergantung pada lingkungan tempat Anda menjalankan kode, Anda mungkin perlu mendapatkan kunci validasi dari OpenAI yang didefinisikan dalam OPENAI_API_KEY.
# Initialize OpenAI embeddings
embeddings = OpenAIEmbeddings()

# Build FAISS vector store upong document chunk embeddings
vector_store = FAISS.from_documents(docs, embeddings)

# Load and initialize OpenAI LLM
llm = OpenAI(model="text-davinci-003", temperature=0.7)
FAISS membuat penyimpanan vektor dari embedding. Kita perlu memberikan dua argumen ke fungsi from_documents()-nya: potongan dokumen, dan instance embedding yang telah diinisialisasi dengan OpenAIEmbeddings.
Setelah itu, kita hadirkan salah satu aktor utama: LLM! Kita menggunakan OpenAI untuk memuat model text-davinci-003, menetapkan temperature model yang cukup tinggi 0,7 untuk memberi ruang orisinalitas dalam generasi teks.
Mari ambil beberapa langkah lagi:
# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Define the RAG chain with reranking using a QA chain
qa_chain = load_qa_with_sources_chain(llm, prompt_template=prompt_template, retriever=vector_store.as_retriever())

# Example question
question = "What are the common symptoms of the flu and how can it be treated?"

# Generate an answer using the QA chain
response = qa_chain(question=question)

print(response)
Kode di atas pertama-tama mendefinisikan templat prompt tanya-jawab. Lalu memanggil fungsi load_qa_with_sources_chain() untuk membuat pipeline tanya-jawab (atau chain dalam istilah Langchain). Argumen retriever-nya memungkinkan memasukkan komponen retrieval ke dalam pipeline LLM, sehingga mengaktifkan RAG.
Akhirnya, sebuah pertanyaan dirumuskan, dan kita menjalankan pipeline qa_chain yang telah didefinisikan. Voila!
Berikut outputnya (bergantung pada dokumen yang Anda baca):
“Gejala flu yang umum termasuk demam, batuk, sakit tenggorokan, hidung berair atau tersumbat, nyeri tubuh, sakit kepala, menggigil, dan kelelahan. Beberapa orang mungkin mengalami muntah dan diare, terutama anak-anak. Flu dapat diobati dengan obat antivirus, yang dapat membuat penyakit lebih ringan dan memperpendek durasi sakit. Obat antivirus juga dapat mencegah komplikasi serius seperti pneumonia. Perawatan segera direkomendasikan untuk individu yang sangat sakit atau berisiko tinggi mengalami komplikasi.”
Contoh sebelumnya terlihat baik, kecuali belum memasukkan fase reranking. Memodifikasi kode untuk memasukkan reranking relatif mudah.
Daftar impor tetap sama, karena pada versi sebelumnya kita sudah melakukan semua impor yang diperlukan untuk fase reranking — meskipun beberapa di antaranya belum digunakan:
# Previous code here
#...

# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Reranking function
def rerank_documents(question, retrieved_docs, top_n=5):
    question_embedding = embeddings.embed_text(question)
    doc_embeddings = [doc.embedding for doc in retrieved_docs]
    similarities = cosine_similarity([question_embedding], doc_embeddings)[0]

    ranked_indices = np.argsort(similarities)[::-1]  # Sort by descending similarity
    ranked_docs = [retrieved_docs[i] for i in ranked_indices[:top_n]]
    return ranked_docs
Seperti terlihat, pertama-tama kita mendefinisikan fungsi rerank_documents yang menggunakan cosine similarity pada embedding untuk menghitung kemiripan antara embedding pertanyaan dan embedding dokumen, lalu mengembalikan top-n dokumen berperingkat tertinggi.
# Custom QA chain with reranking
class CustomQAWithReranking:
    def __init__(self, llm, retriever, prompt_template, top_n=5):
        self.llm = llm
        self.retriever = retriever
        self.prompt_template = prompt_template
        self.top_n = top_n

    def __call__(self, question):
        retrieved_docs = self.retriever.retrieve_documents(question)
        ranked_docs = rerank_documents(question, retrieved_docs, self.top_n)
        context = "\n".join([doc.page_content for doc in ranked_docs])
        prompt = self.prompt_template.format(context=context, question=question)
        return self.llm(prompt)
Kelas CustomQAWithReranking mengintegrasikan langkah retrieval dan reranking ke dalam pipeline LLM, yang akan dipanggil dengan memanggil fungsi call () di kelas ini.
# Define the custom QA chain with reranking
qa_chain = CustomQAWithReranking(llm, vector_store.as_retriever(), prompt_template)

# Example question
question = "What are the benefits of using multi-vector rerankers?"

# Generate an answer using the custom QA chain
response = qa_chain(question)
Yang tersisa hanyalah menginstansiasi again qa_chain. Perhatikan kali ini kita melakukannya dengan mendefinisikan objek dari kelas yang baru saja kita buat, yang merangkum sebagian besar logika pada versi sebelumnya ditambah mekanisme reranking kustom kita.
Terakhir, kita merumuskan pertanyaan dan memanggil chain untuk mendapatkan respons.
Dalam ranah LLM dan AI secara keseluruhan, RAG tampaknya akan terus bertahan. Membiarkan LLM mengakses dan mengambil pengetahuan dari sumber eksternal sebagai bagian dari proses untuk menghasilkan jawaban telah menjadi alternatif yang banyak diterima dibanding pelatihan ulang dan fine-tuning LLM secara terus-menerus.
Artikel ini membahas reranking sebagai pendekatan yang berguna untuk memasukkan pencarian informasi yang efektif sebagai bagian dari pipeline LLM. Artikel ini menyoroti cara kerja proses reranking, jenis-jenis reranker, dan contoh praktis menggunakan Langchain dan OpenAI API.
Tertarik mempelajari lebih jauh? Lihat sumber daya tambahan berikut:
Pelajari Lebih Lanjut tentang LLM
Kursus
Kursus
Program
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




