Kurs
Large Language Models (LLMs) Kavramları
2 sa
113.3K
Aldığınız yanıtların yalnızca ilgili değil; aynı zamanda özenle derlenmiş, önceliklendirilmiş ve tam gereksinimlerinize uygun şekilde rafine edildiği bir Büyük Dil Modeli (LLM) hayal edin. LLM'ler yapay zeka alanında devrim yarattı, ancak sınırlamaları da yok değil. Halüsinasyonlar ve verilerin eskimesi gibi sorunlar, çıktılarının doğruluğunu ve ilgililiğini zayıflatabilir. İşte bu noktada, Retrieval-Augmented Generation (RAG) ve yeniden sıralama devreye girer; LLM'leri dinamik, güncel bilgi getirme süreçleriyle entegre ederek geliştirme imkânı sunar. Bu tarifin adımlarını merak mı ediyorsunuz? Okumaya devam edin.
LLM'ler yapay zeka alanında devrim yaratmış ve yapay zekâyla neler başarabileceğimizin sınırlarını zorlamıştır. Aşağıda gösterildiği gibi, pek çok doğal dil anlama ve üretme görevini modelleyerek, neredeyse her alanda çok yönlü NLP çözümleri arayan herkes için başvurulan araç haline gelmiştir.
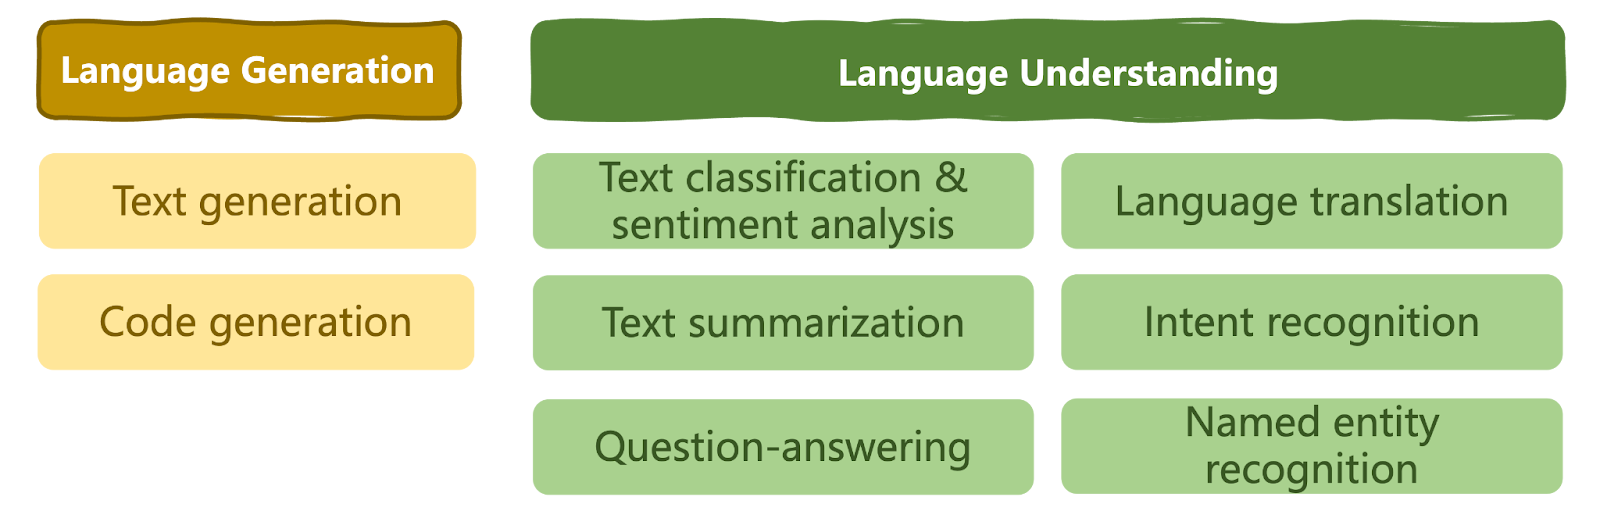
LLM'lerin çözebildiği dil görevlerine ilişkin bir sınıflandırma | Iván Palomares
Yeteneklerine rağmen, LLM'lerin belirli senaryolarda sınırlamaları da vardır. Özel kullanım durumuna ve eğitildikleri geniş veri setinden öğrendikleri bilgiye bağlı olarak LLM'ler bazen tutarlı, ilgili veya bağlama uygun metin üretemeyebilir. Bazen de, kullanıcı sorularına yanıt oluşturacak ilgili ve doğru veri olmadığında, gerçeğe uygunmuş gibi yanlış veya anlamsız bilgiler üretebilirler. Bu olguya halüsinasyon denir.
Örneğin şu soruyu düşünün: "Gribin yaygın belirtileri nelerdir?"
Standart bir LLM, genel bilgiye dayanarak ateş, öksürük ve vücut ağrıları gibi yaygın belirtileri listeleyen bir yanıt üretebilir.
Ancak, çok özel grip virüsü verileriyle eğitilmemişse, LLM belirti şiddetindeki farklılıkları göz önünde bulundurmayabilir veya grip türleri arasında ayrım yapmayabilir; böylece, kullanıcıların koşulları veya ihtiyaçları ne olursa olsun oldukça genel ve hatta bir bakıma “otomatik” yanıtlar verebilir.
Dahası, örneğin model Aralık 2023'e kadar toplanan klinik grip verileriyle eğitilmişse ve Ocak 2024'te yeni bir grip türü ortaya çıkıp hızla yayılırsa, bağımsız bir LLM, alanla ilgili güncel bilgi eksikliğinden dolayı doğru yanıtlar veremez.
Bu “veri eskimesi” sorununa bilgi kesim noktası (knowledge cut-off) denir.
Bazı durumlarda, yukarıdaki sorunun çözümü LLM'i sık sık yeniden eğitmek ve güncel bilgilerle ince ayar yapmak olabilir. Peki bu mutlaka en iyi yol mudur?
LLM'lerin (Büyük Dil Modelleri) eğitilmesinin zor ve hesaplama açısından maliyetli olduğu bilinir. Milyonlarca ila milyarlarca metin örneği ve genellikle ince ayar için binlerce alana özgü metin gerektirirler (aşağıdaki diyagrama bakın).
Çoğu LLM, alan odaklı olanlar bile, genellikle sağlık gibi geniş kapsamlı alanlarda çalışacak şekilde ince ayar yapılır. Bu nedenle, alan genelindeki tüm olası bağlamsal nüansları karşılamak için yeni, çok ayrıntılı veriler eklemek en verimli çözüm olmayabilir.
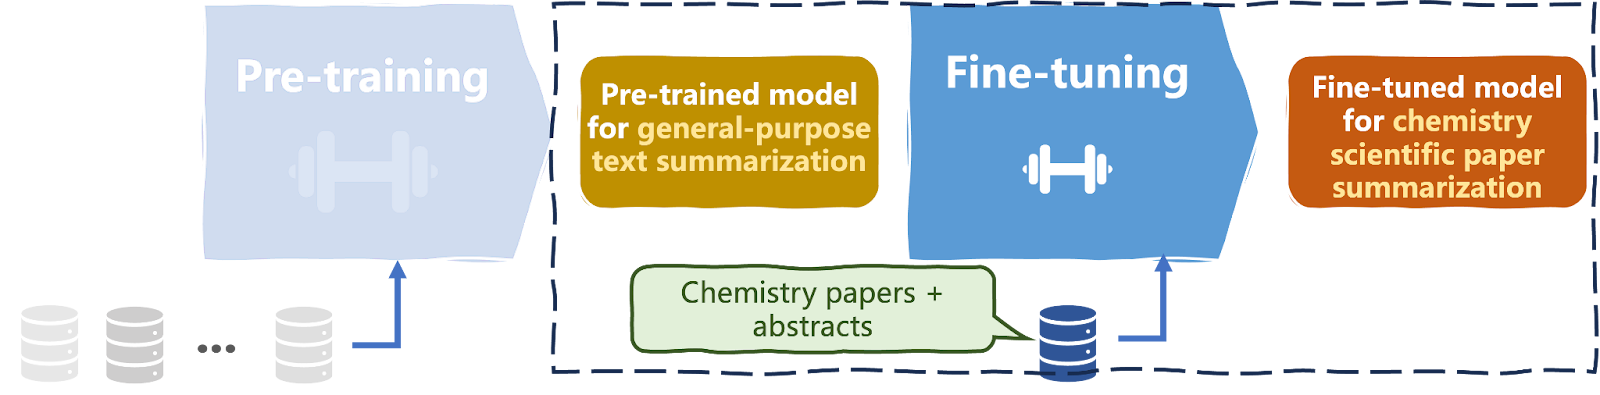
Bir LLM'in ön eğitim ve ince ayarı | Iván Palomares
İşte burada RAG (Retrieval Augmented Generation) yardıma koşuyor!
RAG, bir LLM'in ürettiği çıktıları optimize eden bir bilgi getirme sürecidir. LLM'ler, yanıt üretmek için eğitildikleri verilerden edindikleri bilgiye dayanır.
RAG ise harici bir bilgi tabanına işaret eder.
İki çözümü birleştirerek, RAG, LLM tarafından üretilen “ham” çıktının kalitesini, kullanıcıya uygunluğunu, tutarlılığını ve doğruluğunu, söz konusu bilgi tabanından bilgi getirerek artırmak için kullanılabilir.
Böylece, LLM'i sürekli olarak yeni bağlamlara ve durumlara uyarlamak için yeniden eğitme gereksinimi büyük ölçüde ortadan kalkar.
Bir RAG sisteminin genel iş akışı basitleştirilmiş şekilde aşağıda açıklanmıştır:
Grip örneğine dönersek, RAG ile model, tıbbi veri tabanlarından veya yakın tarihli makalelerden güncel ve ilgili bilgileri getirebilir; böylece hasta ya da sağlık çalışanının sorusuna daha incelikli ve doğru bir yanıt üretmesini sağlar.
Güncel grip türleri, belirtilerde bölgesel farklılıklar veya ortaya çıkan kalıplara ilişkin içgörüleri dahil edebilir; böylece kullanıcının sorgusuna daha ilgili ve tutarlı bir yanıt sunar.
Yeniden sıralama, ilk getirilen sonuç kümesinin, kullanıcı sorgusu, ihtiyaçları ve bağlamına göre ilgililiği artırmak amacıyla yeniden düzenlendiği bir bilgi getirme sürecidir; böylece genel çıktı kalitesi iyileştirilir. Nasıl çalıştığı şöyle:
Aşağıdaki diyagram yeniden sıralama sürecini göstermektedir:
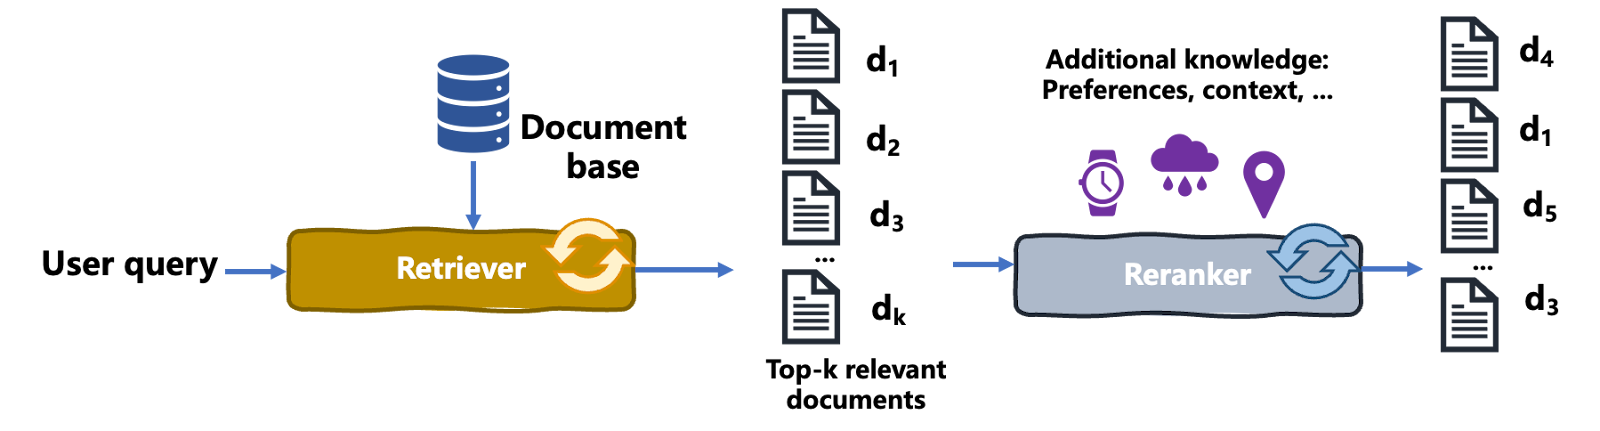
Yeniden sıralama süreci | Iván Palomares
Önemli bir noktayı netleştirelim: yeniden sıralama, getirilen belgeleri kullanıcı tercihleri gibi çeşitli ölçütlere göre yeniden düzenler. Ancak, yeniden sıralama, öneri motorlarından farklıdır; e-ticaret sitelerinde satın almaya uygun ürünler öneren türden sistemlerden söz ediyoruz.
Yeniden sıralama, kullanıcının gerçek zamanlı bir giriş sorgusu sağladığı arama kullanım durumlarında kullanılır.
Buna karşılık öneri motorları, kullanıcıların zaman içindeki etkileşimlerine ve tercihlerine dayanarak kişiselleştirilmiş önerileri proaktif olarak oluşturur.
Grip örneğine geri dönelim.
Bir sağlık profesyonelinin "grip belirtileri için en iyi tedaviler" ifadesini aradığını düşünün. İlk getirme sistemi, genel grip bilgileri, tedavi kılavuzları ve araştırma makaleleri dahil bir belge listesi döndürebilir.
Ancak bir yeniden sıralama modeli, muhtemelen ek hasta verileri ve bağlamsal bilgileri kullanarak, bu belgeleri en ilgili ve en güncel tedavi protokollerini, hasta bakım ipuçlarını ve doğrudan grip belirtileri ile yönetimine yönelik hakemli araştırmaları öne çıkaracak şekilde yeniden sıralayabilir; böylece “doğrudan konuya” giden sonuçları önceliklendirmiş olur.
Özetle, yeniden sıralama, getirilen belge listesini ek ilgililik ölçütlerine göre yeniden düzenleyerek, belirli kullanıcı için en ilgili olanları önce gösterir.
Yeniden sıralama, Retrieval-Augmented Generation (RAG) ile donatılmış Büyük Dil Modellerinde (LLM'ler) özellikle faydalıdır. RAG, daha bilgili ve doğru yanıtlar sağlamak için LLM'leri harici belge getirme ile birleştirir.
Bir sorguya dayalı ilk belge getirmeden sonra, yeniden sıralama süreci seçimi iyileştirerek LLM'in en ilgili ve yüksek kaliteli bilgilerle çalışmasını sağlar.
Bu süreç, özellikle kesin bilginin kritik olduğu uzmanlık alanlarında, LLM'in genel performansını artırır; yanıt doğruluğunu ve ilgililiğini geliştirir.
Bir yeniden sıralayıcı uygulamak için tek bir reçete yoktur. Kurulmuş çeşitli yaklaşımlar vardır; bunlardan bazıları şunlardır:
Artık RAG'i LLM'lere dahil etmenin faydalarını ve bilgi getirme için yeniden sıralama mekanizmalarını anladığımıza göre, bu unsurları bir araya getirip iş başında görme zamanı.
Bu örnek, yeniden sıralama içeren basit bir RAG hattı kurmak için Langchain kütüphanesini (community sürümü) kullanır. Langchain ile LLM uygulamaları geliştirme hakkında çok daha fazlasını Developing LLM Applications kursunda ve Langchain ile LLM uygulamaları nasıl oluşturulur başlıklı bu öğreticide keşfedin.
Kod bir Google Colab defterinde uygulanmıştır.
pip install -U langchain-communityÖnce defterimize langchain-community kuruyoruz.
Ardından gerekli paketleri, sınıfları ve işlevleri içe aktarın.
import os
from langchain.vectorstores import FAISS
from langchain.embeddings import OpenAIEmbeddings
from langchain.llms import OpenAI
from langchain.prompts import PromptTemplate
from langchain.text_splitter import CharacterTextSplitter
from langchain.schema import Document
from langchain.chains.qa_with_sources import load_qa_with_sources_chain
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np
Aşağıdaki işlev, kod defterinizin okuyabildiği yerel bir dizinden belge (.txt dosyaları) listesini yüklemek için tanımlanmıştır. Bunlar, LLM çıktısını geliştirmek için getirilecek ve yeniden sıralanacak belgelerdir:
# Function to load documents from a directory
def load_documents_from_directory(directory_path):
    documents = []
    for filename in os.listdir(directory_path):
        if filename.endswith(".txt"):
            with open(os.path.join(directory_path, filename), 'r') as file:
                documents.append(file.read())
    return documents

# Load documents from the specified directory
directory_path = "./sample_data"
documents = load_documents_from_directory(directory_path)
Metin belgelerinin gömme temsillerinin performansını optimize etmek için boyutlarını 1000 ile sınırlandırıyor ve daha uzun belgeleri küçük parçalara ayırıyoruz. CharacterTextSplitter sınıfı bu işi yapmamıza yardımcı olur.
chunk_overlap bağımsız değişkeni, parçalar arasında metin çakışmasını önlemek için 0 olarak ayarlanır.
# Split documents into chunks for better embedding performance
text_splitter = CharacterTextSplitter(chunk_size=1000, chunk_overlap=0)
docs = text_splitter.split_documents(documents)
OpenAI gömmelerini kullanarak bir gömme vektör deposu oluşturacağız. Kodu çalıştırdığınız ortama bağlı olarak, OPENAI_API_KEY içinde tanımlı OpenAI'den bir doğrulama anahtarı almanız gerekebilir.
# Initialize OpenAI embeddings
embeddings = OpenAIEmbeddings()

# Build FAISS vector store upong document chunk embeddings
vector_store = FAISS.from_documents(docs, embeddings)

# Load and initialize OpenAI LLM
llm = OpenAI(model="text-davinci-003", temperature=0.7)
FAISS, gömmelerden bir vektör deposu oluşturur. from_documents() işlevine iki argüman geçirmemiz gerekir: belge parçaları ve OpenAIEmbeddings yardımıyla başlatılmış gömme örneği.
Sonrasında başrol oyuncularından birini sahneye alıyoruz: LLM! text-davinci-003 modelini yüklemek için OpenAI'ı kullanıyor ve metin üretiminde bir miktar özgünlüğe izin vermek için model sıcaklığını 0.7 gibi orta-yüksek bir değere ayarlıyoruz.
Birkaç adım daha atalım:
# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Define the RAG chain with reranking using a QA chain
qa_chain = load_qa_with_sources_chain(llm, prompt_template=prompt_template, retriever=vector_store.as_retriever())

# Example question
question = "What are the common symptoms of the flu and how can it be treated?"

# Generate an answer using the QA chain
response = qa_chain(question=question)

print(response)
Yukarıdaki kod önce bir soru-cevap istem şablonu tanımlar. Ardından load_qa_with_sources_chain() işlevini çağırarak bir soru-cevap hattı (Langchain terminolojisiyle zincir) oluşturur. retriever bağımsız değişkeni, LLM hattına bir getirme bileşeni dahil etmeyi sağlar ve böylece RAG etkinleşir.
Son olarak bir soru formüle eder ve tanımladığımız qa_chain hattını çalıştırırız. İşte bu kadar!
Çıktı şöyle (okuduğunuz belgelere bağlıdır):
“Gribin yaygın belirtileri arasında ateş, öksürük, boğaz ağrısı, burun akıntısı veya tıkanıklığı, vücut ağrıları, baş ağrısı, üşüme ve yorgunluk yer alır. Bazı kişiler, özellikle çocuklar, kusma ve ishâl yaşayabilir. Grip, hastalığın şiddetini azaltan ve süresini kısaltan antiviral ilaçlarla tedavi edilebilir. Antiviral ilaçlar zatürre gibi ciddi komplikasyonları da önleyebilir. Çok hasta olan veya komplikasyon riski yüksek kişiler için hızlı tedavi önerilir.”
Önceki örnek güzel görünüyordu; ancak yeniden sıralama aşamasını içermiyordu. Kodu yeniden sıralamayı içerecek şekilde değiştirmek nispeten kolaydır.
İçe aktarmalar listesi aynıdır; çünkü önceki sürümde, bazılarını henüz kullanmamış olsak da yeniden sıralama aşaması için gerekli tüm içe aktarmaları zaten yapmıştık:
# Previous code here
#...

# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Reranking function
def rerank_documents(question, retrieved_docs, top_n=5):
    question_embedding = embeddings.embed_text(question)
    doc_embeddings = [doc.embedding for doc in retrieved_docs]
    similarities = cosine_similarity([question_embedding], doc_embeddings)[0]

    ranked_indices = np.argsort(similarities)[::-1]  # Sort by descending similarity
    ranked_docs = [retrieved_docs[i] for i in ranked_indices[:top_n]]
    return ranked_docs
Gördüğünüz gibi, önce rerank_documents adlı ve gömmeler üzerinde kosinüs benzerliği kullanan bir işlev tanımlıyoruz; soru gömmesi ile belge gömmeleri arasındaki benzerliği hesaplayıp en iyi n belgenin sıralamasını döndürüyor.
# Custom QA chain with reranking
class CustomQAWithReranking:
    def __init__(self, llm, retriever, prompt_template, top_n=5):
        self.llm = llm
        self.retriever = retriever
        self.prompt_template = prompt_template
        self.top_n = top_n

    def __call__(self, question):
        retrieved_docs = self.retriever.retrieve_documents(question)
        ranked_docs = rerank_documents(question, retrieved_docs, self.top_n)
        context = "\n".join([doc.page_content for doc in ranked_docs])
        prompt = self.prompt_template.format(context=context, question=question)
        return self.llm(prompt)
CustomQAWithReranking sınıfı, LLM hattındaki getirme ve yeniden sıralama adımlarını LLM'e entegre eder; bu sınıftaki call () işlevi çağrılarak tetiklenir.
# Define the custom QA chain with reranking
qa_chain = CustomQAWithReranking(llm, vector_store.as_retriever(), prompt_template)

# Example question
question = "What are the benefits of using multi-vector rerankers?"

# Generate an answer using the custom QA chain
response = qa_chain(question)
Geriye yalnızca qa_chain örneğini yine oluşturmamız kalıyor. Bu kez, önceki sürümdeki mantığın çoğunu ve özel yeniden sıralama mekanizmamızı kapsülleyen, az önce oluşturduğumuz sınıfın bir nesnesini tanımlayarak yapacağımızı unutmayın.
Son olarak soruyu formüle ediyor ve yanıt almak için zinciri çağırıyoruz.
LLM'ler ve genel olarak yapay zekâ dünyasında, RAG büyük olasılıkla kalıcı olacak. Bir LLM'in, yanıt üretme sürecinin parçası olarak harici kaynaklardan bilgiye erişip getirmesi, LLM'lerin sürekli yeniden eğitilmesine ve ince ayar yapılmasına yaygın bir alternatif haline geldi.
Bu makale, bir LLM hattının parçası olarak etkili bilgi getirmeyi dahil etmede yararlı bir yaklaşım olarak yeniden sıralamayı ele aldı. Yeniden sıralama sürecinin nasıl çalıştığını, farklı yeniden sıralayıcı türlerini ve Langchain ile OpenAI API'sini kullanan pratik bir örneği vurguladı.
Daha fazlasını öğrenmek ister misiniz? Şu ek kaynaklara göz atın:
LLM'ler Hakkında Daha Fazla Bilgi Edinin
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




