Corso
Concetti sui Large Language Models (LLM)
2 ore
113.4K
Immagina un Large Language Model (LLM) in cui le risposte non sono solo pertinenti, ma anche scelte con cura, prioritarizzate e affinate per soddisfare esattamente le tue esigenze. Anche se gli LLM hanno rivoluzionato il campo dell’IA, non sono privi di limiti. Problemi come allucinazioni e obsolescenza dei dati possono compromettere l’accuratezza e la rilevanza degli output. È qui che entrano in gioco la Retrieval-Augmented Generation (RAG) e il reranking, offrendo un modo per potenziare gli LLM integrandoli con processi di recupero delle informazioni dinamici e aggiornati. Curioso dei passaggi di questa ricetta? Continua a leggere.
Gli LLM hanno rivoluzionato il campo dell’IA e spinto i confini di ciò che possiamo ottenere con l’IA. Sono diventati lo strumento di riferimento per chiunque cerchi soluzioni NLP versatili in praticamente qualsiasi ambito, modellando una serie di attività di comprensione e generazione del linguaggio naturale, come mostrato di seguito.
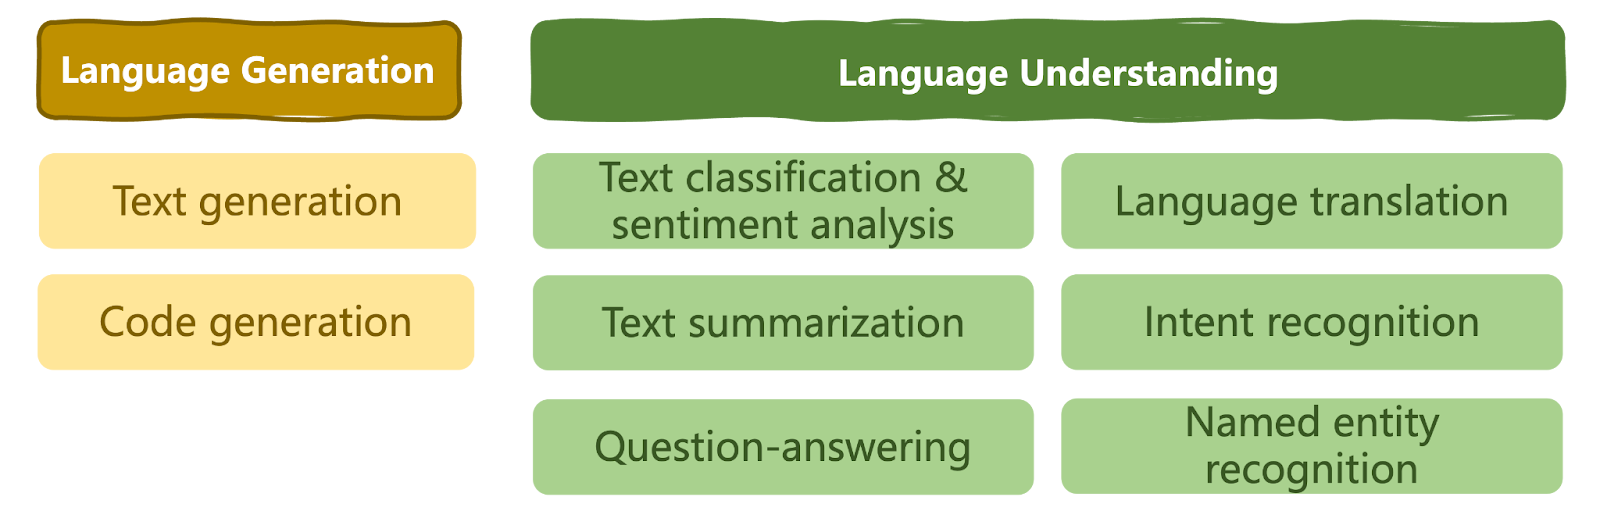
Una tassonomia dei compiti linguistici risolvibili dagli LLM | Iván Palomares
Nonostante le loro capacità, gli LLM presentano anche limiti in alcuni scenari. A seconda del caso d’uso specifico e delle conoscenze apprese dall’ampio dataset su cui sono stati addestrati, a volte gli LLM non riescono a generare testo coerente, pertinente o adeguato al contesto. Talvolta, in assenza di dati veritieri e rilevanti per rispondere alle domande degli utenti, possono persino generare informazioni errate o prive di senso come se fossero vere. Questo fenomeno è noto come allucinazione.
Considera, per esempio, la domanda: "Quali sono i sintomi comuni dell’influenza?"
Un LLM standard potrebbe generare una risposta basata su conoscenze generali, elencando sintomi comuni come febbre, tosse e dolori muscolari.
Tuttavia, a meno che non sia stato addestrato su dati molto specifici del virus influenzale, l’LLM potrebbe non considerare le variazioni nella gravità dei sintomi o distinguere tra i ceppi influenzali, fornendo quindi risposte piuttosto generiche e persino un po’ “automatiche” a utenti diversi, indipendentemente dalle loro circostanze o necessità.
Inoltre, se ad esempio il modello fosse stato addestrato su dati clinici dell’influenza raccolti fino a dicembre 2023 e a gennaio 2024 comparisse un nuovo ceppo influenzale che si diffonde rapidamente nella popolazione, un LLM standalone non sarebbe in grado di fornire risposte accurate per mancanza di conoscenze aggiornate sul dominio del problema.
Questo problema di “obsolescenza dei dati” è noto come knowledge cut-off.
In alcuni casi, la soluzione al problema sopra descritto potrebbe essere riaddestrare e ottimizzare frequentemente l’LLM su informazioni nuove e aggiornate. Ma è davvero la strada migliore?
È risaputo che gli LLM (Large Language Models) sono difficili e costosi da addestrare dal punto di vista computazionale. Richiedono milioni o miliardi di istanze testuali e spesso migliaia di testi specifici di dominio per il fine-tuning (vedi schema sotto).
La maggior parte degli LLM, anche quelli specifici di dominio, sono in genere ottimizzati per funzionare in domini di ampio respiro, come la salute. Pertanto, introdurre nuovi dati molto granulari per coprire tutte le possibili sfumature contestuali del dominio potrebbe non essere la soluzione più efficiente.
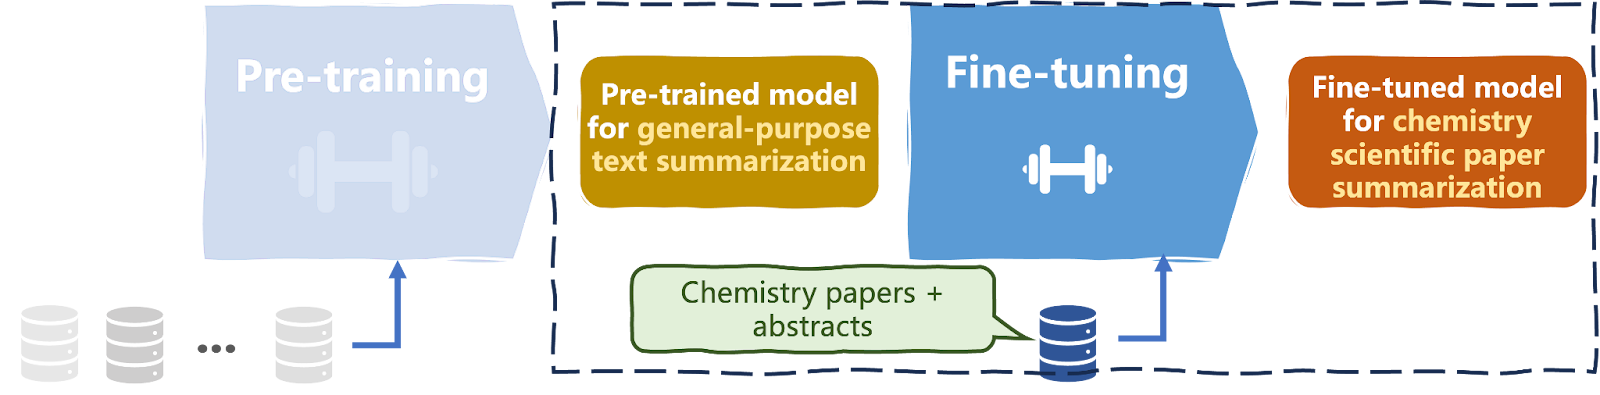
Pre-training e fine-tuning di un LLM | Iván Palomares
È qui che RAG (Retrieval Augmented Generation) viene in aiuto!
RAG è un processo di recupero delle informazioni tramite il quale si ottimizzano gli output prodotti da un LLM. Gli LLM si basano sulle conoscenze acquisite dai dati su cui sono stati generati per produrre risposte.
Nel frattempo, RAG punta a una base di conoscenza esterna.
Combinando entrambe le soluzioni, RAG può essere utilizzato per migliorare la qualità, la pertinenza per l’utente, la coerenza e la veridicità dell’output “grezzo” generato dall’LLM, recuperando conoscenze dalla base di conoscenza menzionata.
Di conseguenza, la necessità di riaddestrare continuamente l’LLM per adattarlo a contesti e situazioni sempre nuovi viene in gran parte eliminata.
Il flusso di lavoro generale di un sistema RAG è descritto in modo semplificato di seguito:
Tornando all’esempio dell’influenza, con RAG il modello potrebbe recuperare informazioni aggiornate e pertinenti da database medici o articoli recenti, consentendogli di generare una risposta più sfumata e accurata alla richiesta del paziente o del professionista.
Potrebbe integrare informazioni sui ceppi influenzali attuali, variazioni regionali dei sintomi o pattern emergenti, fornendo così una risposta più pertinente e coerente alla domanda dell’utente.
Il reranking è un processo di recupero delle informazioni in cui un insieme iniziale di risultati recuperati viene riordinato per migliorarne la pertinenza rispetto alla query, alle esigenze e al contesto dell’utente, migliorando così la qualità complessiva dell’output. Ecco come funziona:
Il seguente diagramma illustra il processo di reranking:
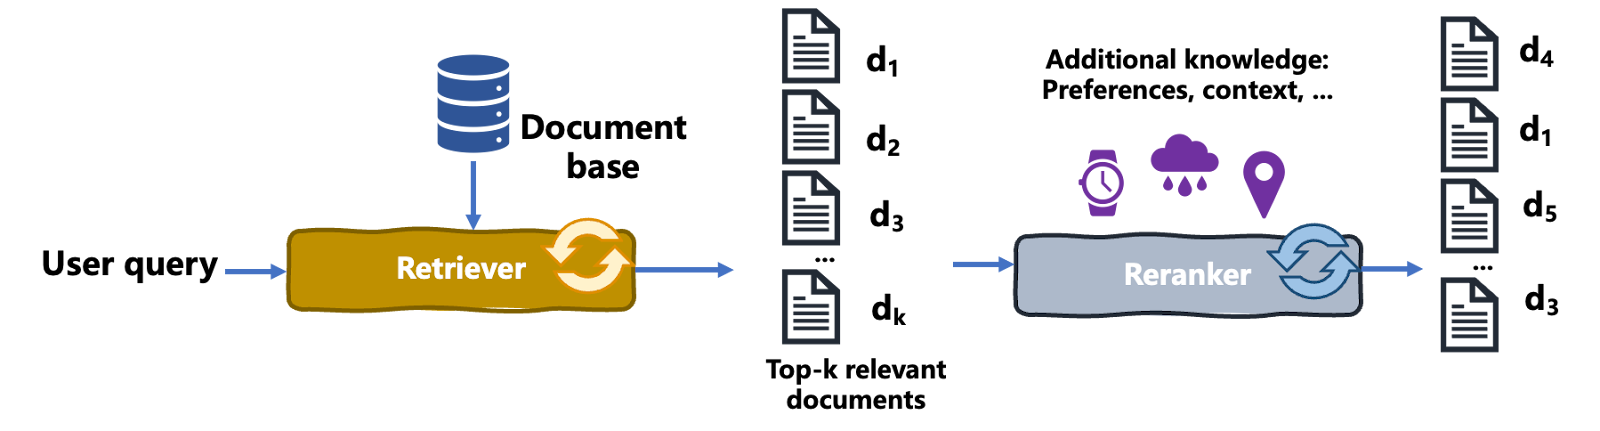
Processo di reranking | Iván Palomares
Chiariamo un punto importante: il reranking riordina i documenti recuperati sulla base di vari criteri, come le preferenze dell’utente. Tuttavia, il reranking è diverso dai motori di raccomandazione, come quelli che suggeriscono prodotti da acquistare sui siti di e-commerce.
Il reranking si usa in casi d’uso di ricerca in cui l’utente fornisce una query in tempo reale.
Al contrario, i motori di raccomandazione creano proattivamente suggerimenti personalizzati per gli utenti sulla base delle loro interazioni e preferenze nel tempo.
Rivediamo l’esempio dell’influenza.
Immagina che un professionista sanitario cerchi "migliori trattamenti per i sintomi dell’influenza." Un sistema di recupero iniziale potrebbe restituire un elenco di documenti, tra cui informazioni generali sull’influenza, linee guida terapeutiche e articoli di ricerca.
Ma un modello di reranking, magari utilizzando dati aggiuntivi specifici del paziente e informazioni contestuali, può quindi riordinare questi documenti per dare priorità ai protocolli terapeutici più pertinenti e recenti, ai consigli di assistenza al paziente e agli studi peer-reviewed che affrontano direttamente i sintomi influenzali e la loro gestione, privilegiando così risultati che vanno “dritti al punto”.
In sintesi, il reranking riorganizza un elenco di documenti recuperati sulla base di ulteriori criteri di pertinenza per mostrare per primi quelli più rilevanti per il singolo utente.
Il reranking è particolarmente utile nei Large Language Model (LLM) dotati di Retrieval-Augmented Generation (RAG). RAG combina gli LLM con il recupero di documenti esterni per fornire risposte più informate e accurate.
Dopo il recupero iniziale dei documenti in base a una query, un processo di reranking può affinare la selezione, assicurando che l’LLM lavori con le informazioni più pertinenti e di alta qualità.
Questo processo migliora le prestazioni complessive dell’LLM, incrementando accuratezza e pertinenza delle risposte, soprattutto in domini specializzati in cui le informazioni precise sono fondamentali.
Non esiste una ricetta unica per implementare un reranker. Sono stati proposti diversi approcci, fra cui:
Ora che abbiamo compreso i vantaggi di integrare RAG negli LLM, così come i meccanismi di reranking per il recupero delle conoscenze, è il momento di integrare questi elementi e vederli in azione.
Questo esempio usa la libreria Langchain (versione community) per costruire una semplice pipeline RAG con reranking. Scopri molto di più sullo sviluppo di applicazioni LLM con Langchain nel corso Developing LLM Applications e in questo tutorial su come costruire applicazioni LLM con Langchain.
Il codice è stato implementato in un notebook Google Colab.
pip install -U langchain-communityPer prima cosa, installiamo langchain-community nel nostro notebook.
Poi importiamo i pacchetti, le classi e le funzioni necessarie.
import os
from langchain.vectorstores import FAISS
from langchain.embeddings import OpenAIEmbeddings
from langchain.llms import OpenAI
from langchain.prompts import PromptTemplate
from langchain.text_splitter import CharacterTextSplitter
from langchain.schema import Document
from langchain.chains.qa_with_sources import load_qa_with_sources_chain
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np
La funzione seguente carica un elenco di documenti (file .txt) da una directory locale da cui il tuo notebook deve poter leggere. Questi saranno i documenti da recuperare e riordinare per migliorare gli output dell’LLM:
# Function to load documents from a directory
def load_documents_from_directory(directory_path):
    documents = []
    for filename in os.listdir(directory_path):
        if filename.endswith(".txt"):
            with open(os.path.join(directory_path, filename), 'r') as file:
                documents.append(file.read())
    return documents

# Load documents from the specified directory
directory_path = "./sample_data"
documents = load_documents_from_directory(directory_path)
Per ottimizzare le prestazioni delle rappresentazioni di embedding dei documenti testuali, ne limitiamo la dimensione a 1000 e dividiamo i documenti più lunghi in blocchi più piccoli. La classe CharacterTextSplitter aiuta a svolgere il compito.
L’argomento chunk_overlap è impostato a 0 per evitare sovrapposizioni di testo tra i blocchi.
# Split documents into chunks for better embedding performance
text_splitter = CharacterTextSplitter(chunk_size=1000, chunk_overlap=0)
docs = text_splitter.split_documents(documents)
Useremo le embedding di OpenAI per costruire il nostro archivio vettoriale di embedding. Nota che, a seconda dell’ambiente in cui esegui il codice, potrebbe essere necessaria una chiave di validazione di OpenAI definita in OPENAI_API_KEY.
# Initialize OpenAI embeddings
embeddings = OpenAIEmbeddings()

# Build FAISS vector store upong document chunk embeddings
vector_store = FAISS.from_documents(docs, embeddings)

# Load and initialize OpenAI LLM
llm = OpenAI(model="text-davinci-003", temperature=0.7)
FAISS crea un archivio vettoriale a partire dagli embedding. Dobbiamo passare due argomenti alla sua funzione from_documents(): i blocchi di documento e l’istanza di embedding inizializzata con l’aiuto di OpenAIEmbeddings.
Dopodiché portiamo in scena uno dei protagonisti: l’LLM! Usiamo OpenAI per caricare il modello text-davinci-003, impostando una temperatura del modello moderatamente alta a 0,7 per consentire un certo grado di originalità nella generazione del testo.
Facciamo ancora qualche passo:
# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Define the RAG chain with reranking using a QA chain
qa_chain = load_qa_with_sources_chain(llm, prompt_template=prompt_template, retriever=vector_store.as_retriever())

# Example question
question = "What are the common symptoms of the flu and how can it be treated?"

# Generate an answer using the QA chain
response = qa_chain(question=question)

print(response)
Il codice sopra definisce innanzitutto un prompt di domanda-risposta. Quindi chiama la funzione load_qa_with_sources_chain() per creare una pipeline di domanda-risposta (o chain nel gergo di Langchain). Il suo argomento retriever consente di incorporare un componente di retrieval nella pipeline dell’LLM, abilitando così RAG.
Infine viene formulata una domanda e si esegue la pipeline definita qa_chain. Voilà!
Ecco l’output (dipende dai documenti da cui leggerai):
“I sintomi comuni dell’influenza includono febbre, tosse, mal di gola, naso che cola o chiuso, dolori muscolari, mal di testa, brividi e affaticamento. Alcune persone, in particolare i bambini, possono avere vomito e diarrea. L’influenza può essere trattata con farmaci antivirali, che possono rendere la malattia più lieve e accorciare la durata dei sintomi. I farmaci antivirali possono anche prevenire complicazioni gravi come la polmonite. Si raccomanda un trattamento tempestivo per le persone molto malate o ad alto rischio di complicazioni.”
L’esempio precedente era valido, tranne per il fatto che non incorporava la fase di reranking. Modificare il codice per includere il reranking è relativamente semplice.
L’elenco degli import è lo stesso, dato che nella versione precedente abbiamo già effettuato tutti gli import necessari per la fase di reranking — anche se non ne avevamo ancora usati alcuni:
# Previous code here
#...

# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Reranking function
def rerank_documents(question, retrieved_docs, top_n=5):
    question_embedding = embeddings.embed_text(question)
    doc_embeddings = [doc.embedding for doc in retrieved_docs]
    similarities = cosine_similarity([question_embedding], doc_embeddings)[0]

    ranked_indices = np.argsort(similarities)[::-1]  # Sort by descending similarity
    ranked_docs = [retrieved_docs[i] for i in ranked_indices[:top_n]]
    return ranked_docs
Come possiamo vedere, prima definiamo una funzione rerank_documents che usa la similarità coseno sugli embedding per calcolare la somiglianza tra l’embedding della domanda e quelli dei documenti, restituendo i top-n documenti meglio classificati.
# Custom QA chain with reranking
class CustomQAWithReranking:
    def __init__(self, llm, retriever, prompt_template, top_n=5):
        self.llm = llm
        self.retriever = retriever
        self.prompt_template = prompt_template
        self.top_n = top_n

    def __call__(self, question):
        retrieved_docs = self.retriever.retrieve_documents(question)
        ranked_docs = rerank_documents(question, retrieved_docs, self.top_n)
        context = "\n".join([doc.page_content for doc in ranked_docs])
        prompt = self.prompt_template.format(context=context, question=question)
        return self.llm(prompt)
La classe CustomQAWithReranking integra nella pipeline dell’LLM i passaggi di retrieval e reranking, che verranno invocati chiamando la funzione call () in questa classe.
# Define the custom QA chain with reranking
qa_chain = CustomQAWithReranking(llm, vector_store.as_retriever(), prompt_template)

# Example question
question = "What are the benefits of using multi-vector rerankers?"

# Generate an answer using the custom QA chain
response = qa_chain(question)
Non resta che istanziare di nuovo qa_chain. Nota che questa volta lo faremo definendo un oggetto della classe appena creata, che incapsula gran parte della logica della versione precedente insieme al nostro meccanismo di reranking personalizzato.
Infine, formuliamo la domanda e invochiamo la chain per ottenere una risposta.
Nel mondo degli LLM e dell’IA in generale, RAG è con ogni probabilità qui per restare. Consentire a un LLM di accedere e recuperare conoscenze da fonti esterne come parte del processo di generazione delle risposte è diventata un’alternativa ampiamente accettata al riaddestramento e fine-tuning costanti degli LLM.
Questo articolo ha illustrato il reranking come approccio utile per incorporare un recupero delle informazioni efficace all’interno di una pipeline LLM. Ha evidenziato come funziona il processo di reranking, i diversi tipi di reranker e un esempio pratico con Langchain e l’API OpenAI.
Vuoi saperne di più? Dai un’occhiata a queste risorse aggiuntive:
Approfondisci gli LLM
Corso
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



