Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
109.8K
Stell dir ein Large Language Model (LLM) vor, dessen Antworten nicht nur passend sind, sondern sorgfältig kuratiert, priorisiert und auf deine genauen Bedürfnisse zugeschnitten. LLMs haben die KI-Welt im Sturm erobert – ganz ohne Grenzen sind sie jedoch nicht. Halluzinationen und veraltete Daten können Genauigkeit und Relevanz der Ausgaben beeinträchtigen. Genau hier kommen Retrieval-Augmented Generation (RAG) und Reranking ins Spiel: Sie erweitern LLMs um dynamische, aktuelle Informationsabrufprozesse. Neugierig auf das Rezept? Lies weiter.
LLMs haben die Möglichkeiten von KI deutlich erweitert. Sie sind zur ersten Anlaufstelle für vielseitige NLP-Lösungen in nahezu jedem Bereich geworden, da sie eine Vielzahl von Aufgaben zum Sprachverständnis und zur Textgenerierung abdecken – wie unten dargestellt.
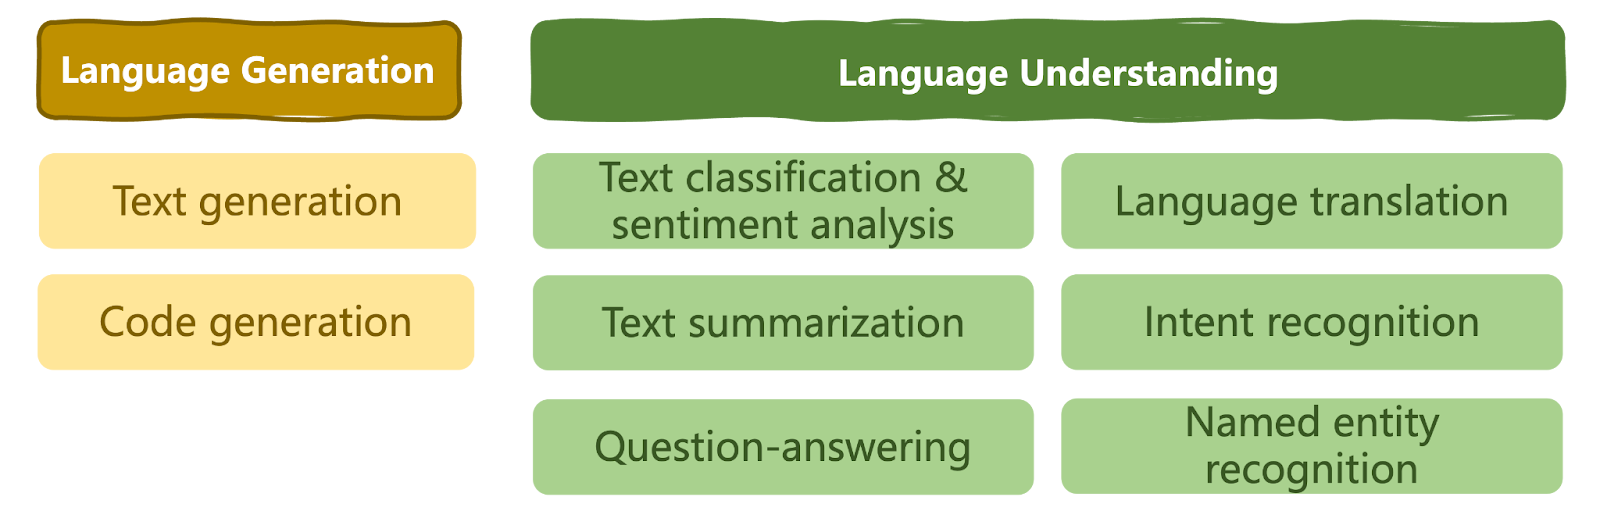
A taxonomy of solvable language tasks by LLMs | Iván Palomares
Trotz ihrer Stärken stoßen LLMs in bestimmten Szenarien an Grenzen. Abhängig vom Use Case und dem in der Trainingsmenge enthaltenen Wissen liefern LLMs mitunter keine kohärenten, relevanten oder kontextgerechten Texte. Fehlen ihnen verlässliche Fakten, können sie sogar falsche oder unsinnige Inhalte als wahr präsentieren – das nennt man Halluzination.
Nehmen wir die Frage: „Was sind typische Grippesymptome?“
Ein Standard-LLM gibt darauf meist allgemeines Wissen wieder: Fieber, Husten, Gliederschmerzen.
Ohne sehr domänenspezifische Trainingsdaten zu Influenzaviren berücksichtigt das LLM jedoch vermutlich keine Unterschiede in der Ausprägung oder zwischen Stämmen – die Antworten bleiben generisch und wirken teils „automatisiert“, unabhängig von Nutzerkontext oder Bedarf.
Kommt hinzu, dass ein Modell, das z. B. nur bis Dezember 2023 mit klinischen Grippedaten trainiert wurde, eine neue, seit Januar 2024 zirkulierende Variante nicht kennt. Ein isoliertes LLM kann dann mangels aktuellem Wissensstand keine präzisen Antworten liefern.
Dieses Problem der „Datenveraltung“ ist als Knowledge Cut-off bekannt.
Eine naheliegende Lösung wäre häufiges Retraining und Fine-Tuning mit frischen Daten. Aber ist das wirklich der beste Weg?
LLMs sind in Training und Betrieb anspruchsvoll und rechenintensiv. Sie benötigen Millionen bis Milliarden Textbeispiele und oft tausende domänenspezifische Texte fürs Fine-Tuning (siehe Diagramm unten).
Viele LLMs – auch domänenspezifische – sind für breit gefasste Bereiche wie Gesundheit optimiert. Immer neues, feinkörniges Wissen für sämtliche Kontexte nachzuschieben, ist daher meist wenig effizient.
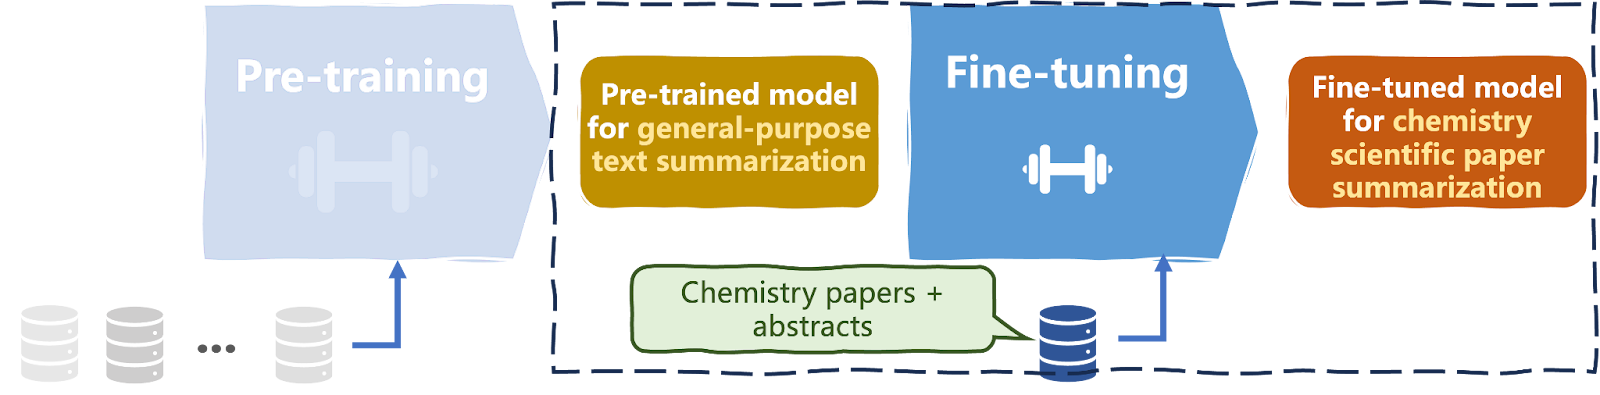
Pre-training and fine-tuning an LLM | Iván Palomares
Hier hilft RAG (Retrieval Augmented Generation) weiter!
RAG ist ein Informationsabruf-Prozess, der die von einem LLM erzeugten Ausgaben optimiert. LLMs erzeugen Antworten auf Basis des in ihren Trainingsdaten gelernten Wissens.
RAG greift hingegen auf eine externe Wissensbasis zu.
Durch die Kombination beider Ansätze verbessert RAG die Qualität, Relevanz, Kohärenz und Faktentreue der „rohen“ LLM-Ausgabe, indem es gezielt Wissen aus der erwähnten Wissensbasis beisteuert.
So entfällt weitgehend die Notwendigkeit, das LLM ständig neu zu trainieren, um es an neue Kontexte anzupassen.
Der allgemeine Workflow eines RAG-Systems lässt sich vereinfacht so beschreiben:
Zurück zum Grippebeispiel: Mit RAG kann das Modell aktuelle Informationen aus medizinischen Datenbanken oder Artikeln abrufen und so eine differenziertere, präzisere Antwort für Patientinnen, Patienten oder Fachpersonal liefern.
Es kann Erkenntnisse zu aktuellen Stämmen, regionalen Symptomvarianten oder neuen Mustern einbeziehen – und damit relevanter und kohärenter auf die Anfrage reagieren.
Reranking ist ein Informationsabruf-Verfahren, bei dem eine erste Treffermenge neu sortiert wird, um die Relevanz zur Nutzeranfrage, zum Bedarf und Kontext zu erhöhen – und damit die Gesamtqualität der Ausgabe zu steigern. So funktioniert es:
Das folgende Diagramm veranschaulicht den Reranking-Prozess:
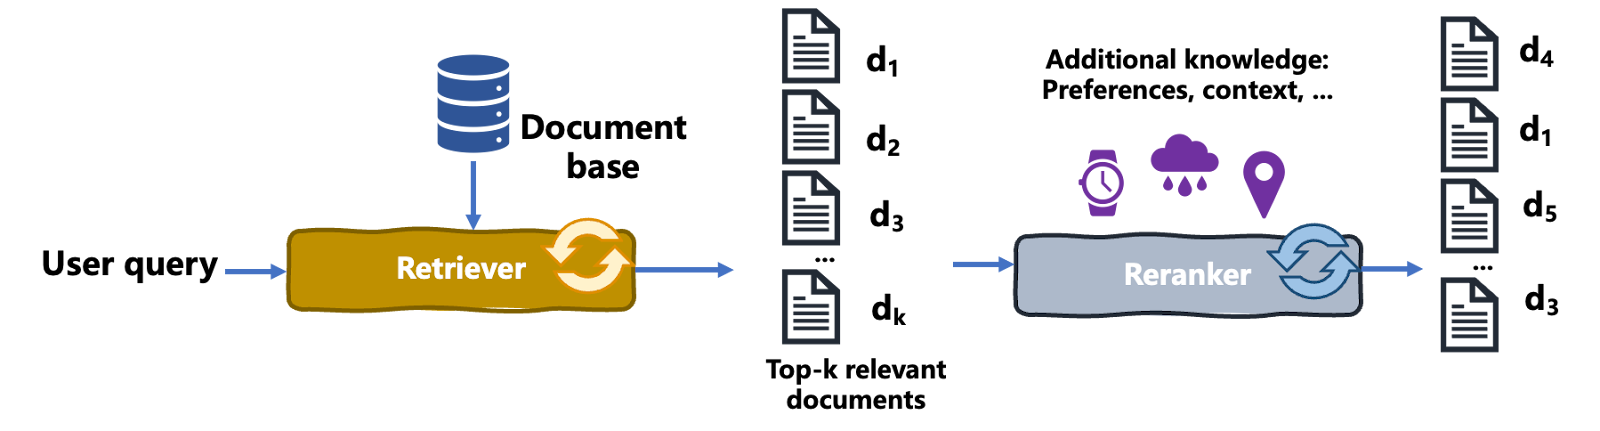
Reranking process | Iván Palomares
Wichtig zur Einordnung: Reranking ordnet abgerufene Dokumente nach Kriterien wie Nutzerpräferenzen neu. Reranking ist jedoch etwas anderes als Recommendation Engines, wie sie etwa in E‑Commerce passende Produkte vorschlagen.
Reranking wird in Suchszenarien genutzt, in denen Nutzende in Echtzeit eine Anfrage stellen.
Recommendation Engines hingegen erzeugen proaktiv personalisierte Vorschläge auf Basis historischer Interaktionen und Präferenzen.
Zurück zur Grippe.
Sucht eine medizinische Fachkraft nach „beste Behandlungen für Grippesymptome“, liefert das erste Retrieval vielleicht allgemeine Infos, Leitlinien und Studien.
Ein Reranking-Modell kann diese Liste – ggf. unter Einbezug patientenspezifischer und kontextueller Daten – so neu ordnen, dass die relevantesten und aktuellsten Behandlungsprotokolle, Praxistipps und peer‑reviewte Studien ganz oben stehen. Kurz: Ergebnisse, die „ohne Umwege“ zur Sache kommen.
Zusammengefasst: Reranking organisiert eine Trefferliste anhand zusätzlicher Relevanzkriterien so um, dass das Wichtigste für die konkrete Person zuerst erscheint.
Reranking entfaltet besonderen Nutzen bei Large Language Models (LLMs) mit Retrieval-Augmented Generation (RAG). RAG verbindet LLMs mit externem Dokumentenabruf, um fundiertere, genauere Antworten zu liefern.
Nach dem ersten Dokumentenabruf kann Reranking die Auswahl weiter verfeinern, damit das LLM mit den relevantesten und qualitativ hochwertigsten Informationen arbeitet.
Das steigert die Gesamtleistung des LLMs – insbesondere in spezialisierten Domänen, in denen Präzision entscheidend ist.
Für Reranker gibt es kein Patentrezept. Etablierte Ansätze sind unter anderem:
Nachdem wir die Vorteile von RAG in LLMs und die Reranking-Mechanismen verstanden haben, integrieren wir beides und schauen es uns in Aktion an.
Im Beispiel nutzen wir die Langchain-Bibliothek (Community-Version), um eine einfache RAG-Pipeline mit Reranking zu bauen. Mehr zu LLM-Anwendungen mit Langchain findest du im Developing LLM Applications course und in diesem Tutorial zum Bauen von LLM-Anwendungen mit Langchain.
Der Code läuft in einem Google Colab Notebook.
pip install -U langchain-communityZuerst installieren wir langchain-community im Notebook.
Als Nächstes importieren wir die benötigten Pakete, Klassen und Funktionen.
import os
from langchain.vectorstores import FAISS
from langchain.embeddings import OpenAIEmbeddings
from langchain.llms import OpenAI
from langchain.prompts import PromptTemplate
from langchain.text_splitter import CharacterTextSplitter
from langchain.schema import Document
from langchain.chains.qa_with_sources import load_qa_with_sources_chain
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np
Die folgende Funktion lädt eine Liste von Dokumenten (.txt-Dateien) aus einem lokalen Verzeichnis, auf das dein Notebook zugreifen kann. Diese Dokumente werden für Retrieval und Reranking genutzt, um die LLM-Ausgaben zu verbessern:
# Function to load documents from a directory
def load_documents_from_directory(directory_path):
    documents = []
    for filename in os.listdir(directory_path):
        if filename.endswith(".txt"):
            with open(os.path.join(directory_path, filename), 'r') as file:
                documents.append(file.read())
    return documents

# Load documents from the specified directory
directory_path = "./sample_data"
documents = load_documents_from_directory(directory_path)
Um die Qualität der Embeddings zu steigern, begrenzen wir die Chunk-Größe auf 1000 Zeichen und zerlegen längere Dokumente in kleinere Abschnitte. Dabei hilft die Klasse CharacterTextSplitter.
Das Argument chunk_overlap steht auf 0, damit sich Textstellen nicht überlappen.
# Split documents into chunks for better embedding performance
text_splitter = CharacterTextSplitter(chunk_size=1000, chunk_overlap=0)
docs = text_splitter.split_documents(documents)
Wir verwenden OpenAI-Embeddings, um unseren Vektorspeicher aufzubauen. Je nach Laufumgebung brauchst du dafür evtl. einen OpenAI-Schlüssel in OPENAI_API_KEY.
# Initialize OpenAI embeddings
embeddings = OpenAIEmbeddings()

# Build FAISS vector store upong document chunk embeddings
vector_store = FAISS.from_documents(docs, embeddings)

# Load and initialize OpenAI LLM
llm = OpenAI(model="text-davinci-003", temperature=0.7)
FAISS erstellt aus den Embeddings einen Vektorspeicher. An from_documents() übergeben wir die Dokument-Chunks und die initialisierte Embeddings-Instanz von OpenAIEmbeddings.
Danach holen wir den Hauptdarsteller auf die Bühne: das LLM. Wir laden das OpenAI-Modell text-davinci-003 und setzen eine moderate Temperatur von 0,7 für etwas Originalität in der Textgenerierung.
Weiter geht’s:
# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Define the RAG chain with reranking using a QA chain
qa_chain = load_qa_with_sources_chain(llm, prompt_template=prompt_template, retriever=vector_store.as_retriever())

# Example question
question = "What are the common symptoms of the flu and how can it be treated?"

# Generate an answer using the QA chain
response = qa_chain(question=question)

print(response)
Zuerst definieren wir eine Prompt-Vorlage für Question Answering. Dann erstellt load_qa_with_sources_chain() eine QA-Pipeline (in Langchain „Chain“). Über das Retriever-Argument binden wir die Retrieval-Komponente ein – das aktiviert RAG.
Anschließend formulieren wir eine Frage und führen die definierte Pipeline qa_chain aus. Voilà!
So könnte die Ausgabe aussehen (abhängig von deinen Dokumenten):
„Häufige Grippesymptome sind Fieber, Husten, Halsschmerzen, eine laufende oder verstopfte Nase, Gliederschmerzen, Kopfschmerzen, Schüttelfrost und Müdigkeit. Manche, vor allem Kinder, haben zusätzlich Erbrechen und Durchfall. Behandelt wird die Grippe mit antiviralen Medikamenten, die den Verlauf mildern und verkürzen können. Sie helfen zudem, Komplikationen wie Lungenentzündung zu vermeiden. Eine frühzeitige Behandlung wird besonders für schwer Erkrankte oder Menschen mit hohem Risiko empfohlen.“
Das vorige Beispiel war gut, enthielt aber noch kein Reranking. Die Anpassung ist recht unkompliziert.
Die Importliste bleibt gleich – wir hatten bereits alles Nötige für die Reranking-Phase eingebunden, auch wenn wir manches noch nicht genutzt haben:
# Previous code here
#...

# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Reranking function
def rerank_documents(question, retrieved_docs, top_n=5):
    question_embedding = embeddings.embed_text(question)
    doc_embeddings = [doc.embedding for doc in retrieved_docs]
    similarities = cosine_similarity([question_embedding], doc_embeddings)[0]

    ranked_indices = np.argsort(similarities)[::-1]  # Sort by descending similarity
    ranked_docs = [retrieved_docs[i] for i in ranked_indices[:top_n]]
    return ranked_docs
Wir definieren eine Funktion rerank_documents, die per Kosinus-Ähnlichkeit die Nähe zwischen Frage-Embedding und Dokument-Embeddings berechnet und die Top‑n Dokumente zurückgibt.
# Custom QA chain with reranking
class CustomQAWithReranking:
    def __init__(self, llm, retriever, prompt_template, top_n=5):
        self.llm = llm
        self.retriever = retriever
        self.prompt_template = prompt_template
        self.top_n = top_n

    def __call__(self, question):
        retrieved_docs = self.retriever.retrieve_documents(question)
        ranked_docs = rerank_documents(question, retrieved_docs, self.top_n)
        context = "\n".join([doc.page_content for doc in ranked_docs])
        prompt = self.prompt_template.format(context=context, question=question)
        return self.llm(prompt)
Die Klasse CustomQAWithReranking integriert Retrieval und Reranking in die LLM-Pipeline und wird über die Methode call() aufgerufen.
# Define the custom QA chain with reranking
qa_chain = CustomQAWithReranking(llm, vector_store.as_retriever(), prompt_template)

# Example question
question = "What are the benefits of using multi-vector rerankers?"

# Generate an answer using the custom QA chain
response = qa_chain(question)
Zum Schluss instanziieren wir qa_chain erneut – diesmal als Objekt unserer Klasse, die die Logik der ersten Version plus das Custom-Reranking kapselt.
Dann stellen wir die Frage und rufen die Chain auf, um eine Antwort zu erhalten.
Im Umfeld von LLMs – und KI insgesamt – hat sich RAG fest etabliert. Externe Wissensquellen in die Antwortgenerierung einzubinden, ist eine verbreitete Alternative zum ständigen Retraining und Fine-Tuning.
Dieser Artikel hat Reranking als wirkungsvolle Methode für effektiven Informationsabruf in einer LLM-Pipeline vorgestellt, den Prozess erklärt, verschiedene Reranker-Typen skizziert und ein Praxisbeispiel mit Langchain und der OpenAI API gezeigt.
Du willst tiefer einsteigen? Diese Ressourcen helfen weiter:
Mehr über LLMs lernen
Kurs
Kurs
Lernpfad