Khóa học
Các khái niệm về Large Language Models (LLMs)
2 giờ
113.3K
Hãy tưởng tượng một Mô hình Ngôn ngữ Lớn (LLM) mà câu trả lời bạn nhận được không chỉ phù hợp mà còn được chọn lọc kỹ, ưu tiên và tinh chỉnh để đáp ứng đúng nhu cầu của bạn. Dù LLM đã làm thay đổi lĩnh vực AI, chúng vẫn có những hạn chế. Các vấn đề như ảo giác (hallucination) và dữ liệu lỗi thời có thể làm giảm độ chính xác và mức độ liên quan của kết quả. Đây là lúc Retrieval-Augmented Generation (RAG) và reranking phát huy tác dụng, mang đến cách tăng cường LLM bằng cách tích hợp các quy trình truy xuất thông tin động, luôn cập nhật. Muốn biết các bước thực hiện? Hãy đọc tiếp.
LLM đã tạo ra cuộc cách mạng trong lĩnh vực AI và mở rộng ranh giới những gì chúng ta có thể đạt được nhờ AI. Bằng cách mô hình hóa nhiều tác vụ hiểu và sinh ngôn ngữ tự nhiên, như minh họa dưới đây, chúng đã trở thành công cụ ưa dùng cho bất kỳ ai tìm kiếm giải pháp NLP linh hoạt ở hầu như mọi lĩnh vực.
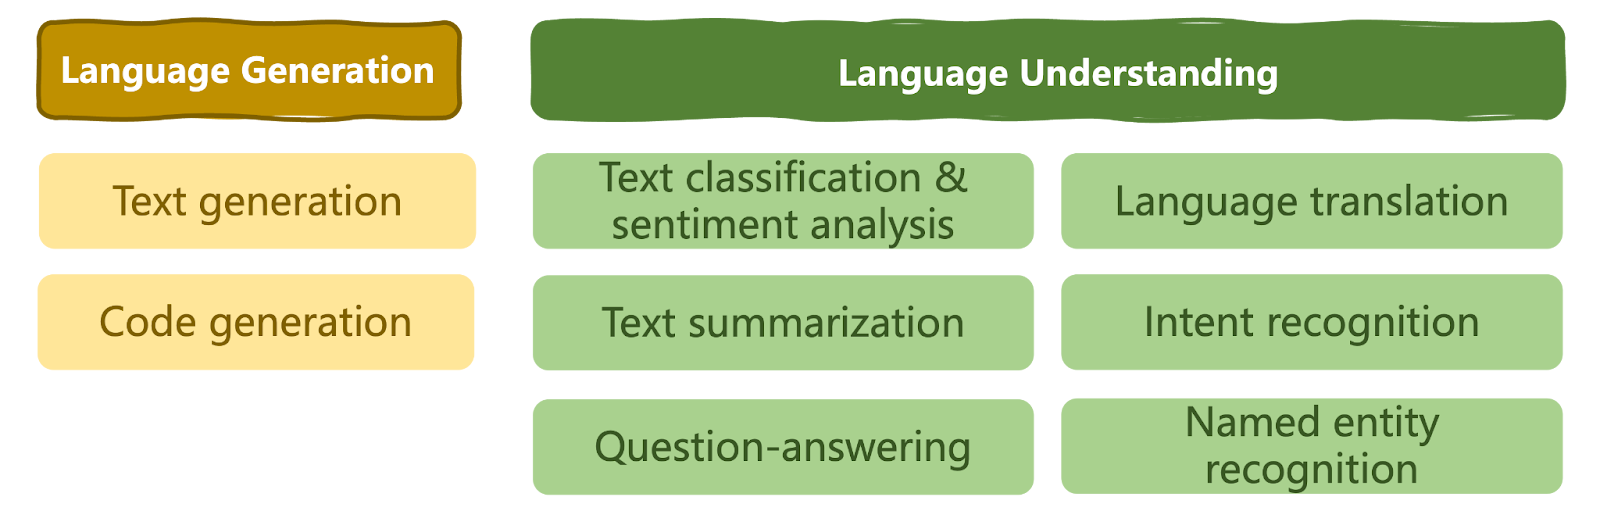
Phân loại các tác vụ ngôn ngữ có thể giải bởi LLM | Iván Palomares
Dù rất mạnh mẽ, LLM vẫn có hạn chế trong một số tình huống. Tùy vào bài toán cụ thể và kiến thức học được từ tập dữ liệu khổng lồ đã dùng để huấn luyện, LLM đôi khi không tạo ra văn bản mạch lạc, phù hợp hoặc đúng ngữ cảnh. Đôi khi, khi thiếu dữ liệu sự thật liên quan để trả lời truy vấn, chúng có thể tạo ra thông tin sai hoặc vô nghĩa như thể đúng. Hiện tượng này gọi là ảo giác.
Chẳng hạn, với câu hỏi: "Những triệu chứng cúm thường gặp là gì?"
Một LLM tiêu chuẩn có thể tạo câu trả lời dựa trên kiến thức chung, liệt kê các triệu chứng phổ biến như sốt, ho và đau nhức cơ thể.
Tuy nhiên, trừ khi được huấn luyện trên dữ liệu virus cúm chuyên sâu theo lĩnh vực, LLM có thể không xét đến mức độ nặng nhẹ khác nhau của triệu chứng hoặc phân biệt các chủng cúm, từ đó đưa ra câu trả lời khá chung chung và thậm chí có phần “tự động” cho các người dùng khác nhau bất kể hoàn cảnh hay nhu cầu.
Hơn nữa, nếu mô hình được huấn luyện trên dữ liệu lâm sàng về cúm chỉ đến tháng 12/2023, rồi sang tháng 1/2024 xuất hiện một chủng cúm mới lan nhanh trong cộng đồng, thì một LLM độc lập sẽ không thể đưa ra câu trả lời chính xác do thiếu kiến thức cập nhật về miền vấn đề.
Bài toán “dữ liệu lỗi thời” này được gọi là knowledge cut-off (mốc cắt kiến thức).
Trong một số trường hợp, giải pháp có thể là thường xuyên huấn luyện lại và tinh chỉnh LLM với thông tin mới, cập nhật. Nhưng đây có nhất thiết là hướng đi tối ưu?
LLM (Mô hình Ngôn ngữ Lớn) nổi tiếng là khó và tốn kém để huấn luyện. Chúng cần từ hàng triệu đến hàng tỷ mẫu văn bản và thường hàng nghìn văn bản chuyên ngành để tinh chỉnh (xem sơ đồ dưới đây).
Hầu hết LLM, kể cả loại chuyên ngành, thường được tinh chỉnh để hoạt động trên các lĩnh vực rộng như y tế. Do đó, đưa vào các dữ liệu rất chi tiết để bao quát mọi sắc thái ngữ cảnh trong toàn bộ lĩnh vực có thể không phải giải pháp hiệu quả nhất.
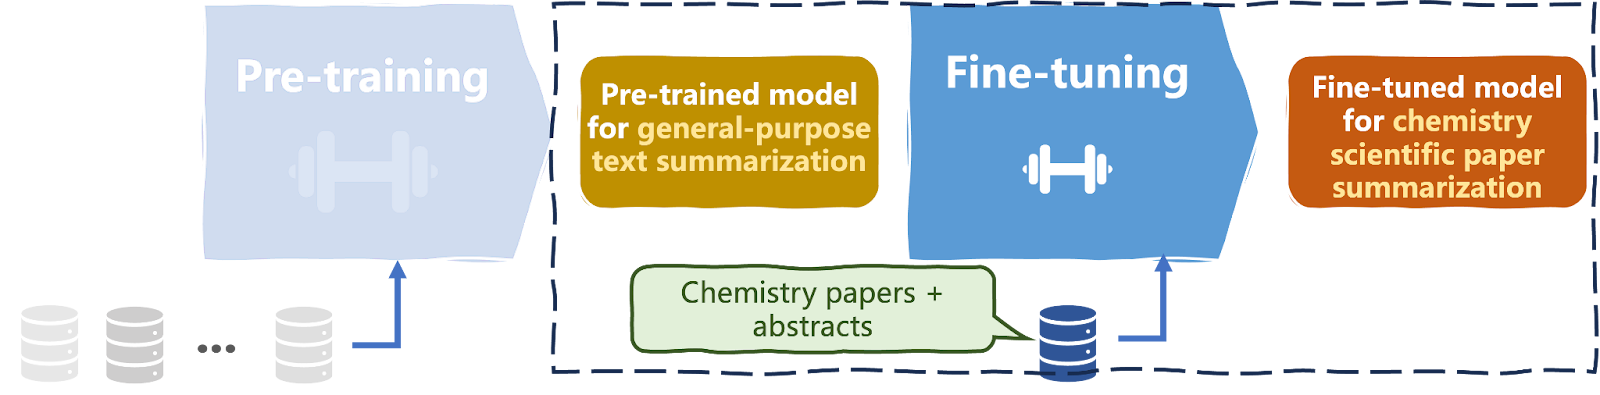
Huấn luyện sơ bộ và tinh chỉnh một LLM | Iván Palomares
Đây chính là lúc RAG (Retrieval Augmented Generation) phát huy tác dụng!
RAG là một quy trình truy xuất thông tin giúp tối ưu đầu ra do LLM tạo ra. LLM dựa trên kiến thức học được từ dữ liệu đã dùng để huấn luyện nhằm tạo phản hồi.
Trong khi đó, RAG trỏ đến một kho tri thức bên ngoài.
Bằng cách kết hợp cả hai, RAG có thể nâng cao chất lượng, mức độ liên quan với người dùng, tính mạch lạc và tính xác thực của đầu ra “thô” do LLM tạo bằng cách truy xuất kiến thức từ kho tri thức nói trên.
Nhờ vậy, nhu cầu liên tục huấn luyện lại LLM để thích ứng với các ngữ cảnh và tình huống mới phát sinh phần lớn được loại bỏ.
Quy trình tổng quát của một hệ thống RAG được mô tả đơn giản như sau:
Quay lại ví dụ về cúm, với RAG, mô hình có thể truy xuất thông tin cập nhật, liên quan từ các cơ sở dữ liệu y khoa hoặc bài viết gần đây, cho phép tạo câu trả lời tinh tế và chính xác hơn cho bệnh nhân hoặc nhân viên y tế.
Mô hình có thể đưa vào các thông tin về các chủng cúm hiện tại, biến thiên vùng miền của triệu chứng, hoặc các xu hướng mới nổi, từ đó cung cấp phản hồi phù hợp và mạch lạc hơn với truy vấn của người dùng.
Reranking là một quy trình truy xuất thông tin, trong đó một tập kết quả truy xuất ban đầu được sắp xếp lại để cải thiện mức độ liên quan với truy vấn, nhu cầu và ngữ cảnh của người dùng, qua đó nâng cao chất lượng đầu ra tổng thể. Cách hoạt động như sau:
Sơ đồ sau minh họa quy trình reranking:
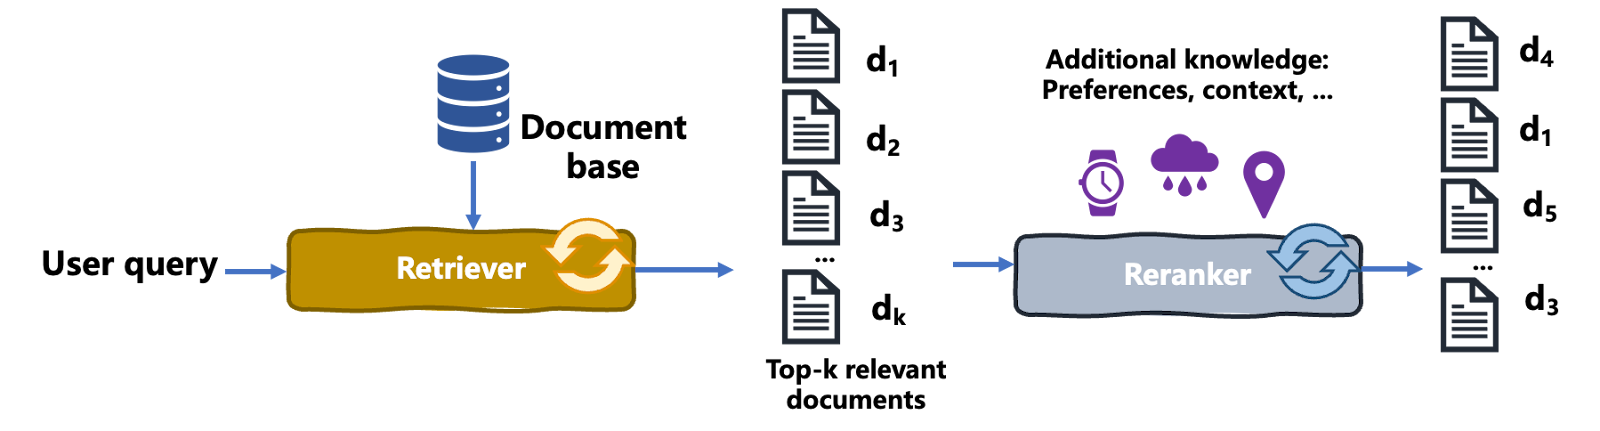
Quy trình reranking | Iván Palomares
Làm rõ một điểm quan trọng: reranking sắp xếp lại các tài liệu đã truy xuất dựa trên nhiều tiêu chí như sở thích người dùng. Tuy nhiên, reranking khác với công cụ gợi ý (recommender engines), như các hệ thống gợi ý sản phẩm trên trang thương mại điện tử.
Reranking được dùng trong các tình huống tìm kiếm khi người dùng đưa vào truy vấn theo thời gian thực.
Ngược lại, công cụ gợi ý chủ động tạo gợi ý cá nhân hóa cho người dùng dựa trên tương tác và sở thích được tích lũy theo thời gian.
Hãy quay lại ví dụ về cúm.
Giả sử một nhân viên y tế tìm kiếm "phác đồ điều trị hiệu quả cho các triệu chứng cúm." Hệ thống truy xuất ban đầu có thể trả về danh sách tài liệu gồm thông tin chung về cúm, hướng dẫn điều trị và các bài nghiên cứu.
Nhưng một mô hình reranking, có thể sử dụng thêm dữ liệu đặc thù bệnh nhân và thông tin ngữ cảnh, sẽ sắp xếp lại các tài liệu này để ưu tiên các phác đồ điều trị phù hợp và cập nhật nhất, các mẹo chăm sóc bệnh nhân, và nghiên cứu đã bình duyệt trực tiếp đề cập đến triệu chứng cúm và cách xử lý — từ đó ưu tiên những kết quả “đi thẳng vào vấn đề”.
Tóm lại, reranking tổ chức lại danh sách tài liệu đã truy xuất dựa trên các tiêu chí liên quan bổ sung để hiển thị trước hết những tài liệu phù hợp nhất với người dùng cụ thể.
Reranking đặc biệt hữu ích trong các Mô hình Ngôn ngữ Lớn (LLM) được trang bị Retrieval-Augmented Generation (RAG). RAG kết hợp LLM với truy xuất tài liệu bên ngoài để cung cấp phản hồi đầy đủ thông tin và chính xác hơn.
Sau khi truy xuất tài liệu lần đầu dựa trên truy vấn, quá trình reranking có thể tinh lọc lựa chọn, đảm bảo LLM làm việc với thông tin liên quan và chất lượng cao nhất.
Quy trình này nâng cao hiệu năng tổng thể của LLM, cải thiện độ chính xác và mức độ liên quan của phản hồi, đặc biệt trong các lĩnh vực chuyên sâu nơi thông tin chính xác là then chốt.
Không có một công thức duy nhất để triển khai reranker. Nhiều cách tiếp cận đã được xây dựng, bao gồm:
Giờ đây, khi đã hiểu lợi ích của việc tích hợp RAG vào LLM cũng như các cơ chế reranking cho truy xuất tri thức, đã đến lúc ghép chúng lại và xem chúng hoạt động.
Ví dụ này dùng thư viện Langchain (phiên bản community) để xây dựng một pipeline RAG đơn giản có reranking. Khám phá thêm về phát triển ứng dụng LLM với Langchain trong khóa học Developing LLM Applications và hướng dẫn xây dựng ứng dụng LLM với Langchain.
Mã được triển khai trong sổ tay Google Colab.
pip install -U langchain-communityĐầu tiên, chúng ta cài đặt langchain-community trong sổ tay.
Tiếp theo, import các gói, lớp và hàm cần thiết.
import os
from langchain.vectorstores import FAISS
from langchain.embeddings import OpenAIEmbeddings
from langchain.llms import OpenAI
from langchain.prompts import PromptTemplate
from langchain.text_splitter import CharacterTextSplitter
from langchain.schema import Document
from langchain.chains.qa_with_sources import load_qa_with_sources_chain
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np
Hàm sau được định nghĩa để tải danh sách tài liệu (tệp .txt) từ một thư mục cục bộ mà sổ tay mã của bạn có thể đọc. Đây sẽ là các tài liệu được truy xuất và rerank để nâng cao đầu ra LLM:
# Function to load documents from a directory
def load_documents_from_directory(directory_path):
    documents = []
    for filename in os.listdir(directory_path):
        if filename.endswith(".txt"):
            with open(os.path.join(directory_path, filename), 'r') as file:
                documents.append(file.read())
    return documents

# Load documents from the specified directory
directory_path = "./sample_data"
documents = load_documents_from_directory(directory_path)
Để tối ưu hiệu năng biểu diễn embedding của tài liệu văn bản, chúng ta giới hạn kích thước ở mức 1000 và chia các tài liệu dài hơn thành các đoạn nhỏ hơn. Lớp CharacterTextSplitter hỗ trợ thực hiện việc này.
Tham số chunk_overlap được đặt là 0 để tránh chồng lấn phần văn bản giữa các đoạn.
# Split documents into chunks for better embedding performance
text_splitter = CharacterTextSplitter(chunk_size=1000, chunk_overlap=0)
docs = text_splitter.split_documents(documents)
Chúng ta sẽ dùng OpenAI embeddings để xây dựng kho vector embedding. Lưu ý rằng tùy môi trường chạy mã, bạn có thể cần khóa xác thực OpenAI đặt trong OPENAI_API_KEY.
# Initialize OpenAI embeddings
embeddings = OpenAIEmbeddings()

# Build FAISS vector store upong document chunk embeddings
vector_store = FAISS.from_documents(docs, embeddings)

# Load and initialize OpenAI LLM
llm = OpenAI(model="text-davinci-003", temperature=0.7)
FAISS tạo một kho vector từ các embedding. Chúng ta cần truyền hai tham số cho hàm from_documents(): các đoạn tài liệu và thể hiện embeddings đã khởi tạo với OpenAIEmbeddings.
Sau đó, đưa nhân vật chính lên sân khấu: LLM! Chúng ta dùng OpenAI để tải model text-davinci-003, đặt nhiệt độ mô hình ở mức 0,7 để cho phép một mức độ sáng tạo nhất định trong việc sinh văn bản.
Hãy thực hiện thêm vài bước:
# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Define the RAG chain with reranking using a QA chain
qa_chain = load_qa_with_sources_chain(llm, prompt_template=prompt_template, retriever=vector_store.as_retriever())

# Example question
question = "What are the common symptoms of the flu and how can it be treated?"

# Generate an answer using the QA chain
response = qa_chain(question=question)

print(response)
Đoạn mã trên đầu tiên định nghĩa một prompt hỏi-đáp. Sau đó gọi hàm load_qa_with_sources_chain() để tạo một pipeline hỏi-đáp (hay “chain” theo thuật ngữ Langchain). Tham số retriever cho phép tích hợp thành phần truy xuất vào pipeline LLM, từ đó kích hoạt RAG.
Cuối cùng, đặt câu hỏi và chạy pipeline qa_chain đã định nghĩa. Vậy là xong!
Đây là đầu ra (phụ thuộc vào tài liệu bạn đọc):
“Các triệu chứng phổ biến của cúm bao gồm sốt, ho, đau họng, sổ mũi hoặc nghẹt mũi, đau nhức cơ thể, đau đầu, ớn lạnh và mệt mỏi. Một số người có thể bị nôn và tiêu chảy, đặc biệt là trẻ em. Cúm có thể được điều trị bằng thuốc kháng virus, giúp làm nhẹ bệnh và rút ngắn thời gian ốm. Thuốc kháng virus cũng có thể ngăn ngừa biến chứng nghiêm trọng như viêm phổi. Khuyến nghị điều trị sớm cho những người bệnh nặng hoặc có nguy cơ cao gặp biến chứng.”
Ví dụ trước trông ổn, nhưng chưa tích hợp giai đoạn reranking. Việc chỉnh sửa mã để thêm reranking khá đơn giản.
Danh sách import giữ nguyên, vì ở phiên bản trước chúng ta đã import đủ cho giai đoạn reranking — dù khi đó chưa dùng đến một số mục:
# Previous code here
#...

# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Reranking function
def rerank_documents(question, retrieved_docs, top_n=5):
    question_embedding = embeddings.embed_text(question)
    doc_embeddings = [doc.embedding for doc in retrieved_docs]
    similarities = cosine_similarity([question_embedding], doc_embeddings)[0]

    ranked_indices = np.argsort(similarities)[::-1]  # Sort by descending similarity
    ranked_docs = [retrieved_docs[i] for i in ranked_indices[:top_n]]
    return ranked_docs
Như thấy ở trên, trước hết chúng ta định nghĩa hàm rerank_documents dùng cosine similarity trên các embedding để tính độ tương đồng giữa embedding của câu hỏi và embedding của tài liệu, trả về top-n tài liệu xếp hạng cao nhất.
# Custom QA chain with reranking
class CustomQAWithReranking:
    def __init__(self, llm, retriever, prompt_template, top_n=5):
        self.llm = llm
        self.retriever = retriever
        self.prompt_template = prompt_template
        self.top_n = top_n

    def __call__(self, question):
        retrieved_docs = self.retriever.retrieve_documents(question)
        ranked_docs = rerank_documents(question, retrieved_docs, self.top_n)
        context = "\n".join([doc.page_content for doc in ranked_docs])
        prompt = self.prompt_template.format(context=context, question=question)
        return self.llm(prompt)
Lớp CustomQAWithReranking tích hợp vào LLM các bước truy xuất và reranking trong pipeline LLM, sẽ được gọi bằng cách gọi hàm call () của lớp này.
# Define the custom QA chain with reranking
qa_chain = CustomQAWithReranking(llm, vector_store.as_retriever(), prompt_template)

# Example question
question = "What are the benefits of using multi-vector rerankers?"

# Generate an answer using the custom QA chain
response = qa_chain(question)
Việc còn lại là khởi tạo again qa_chain. Lưu ý lần này chúng ta làm điều đó bằng cách tạo một đối tượng của lớp vừa xây dựng, lớp này đóng gói hầu hết logic ở phiên bản trước cộng với cơ chế reranking tùy chỉnh.
Cuối cùng, đặt câu hỏi và gọi chain để nhận phản hồi.
Trong thế giới LLM và AI nói chung, RAG gần như chắc chắn sẽ còn gắn bó lâu dài. Việc để một LLM truy cập và truy xuất tri thức từ nguồn bên ngoài như một phần của quá trình tạo phản hồi đã trở thành lựa chọn được chấp nhận rộng rãi thay cho việc liên tục huấn luyện lại và tinh chỉnh LLM.
Bài viết này đã trình bày reranking như một cách hữu ích để đưa truy xuất thông tin hiệu quả vào một pipeline LLM. Bài viết làm rõ cách hoạt động của quy trình reranking, các loại reranker khác nhau, và một ví dụ thực tiễn sử dụng Langchain và OpenAI API.
Muốn tìm hiểu thêm? Hãy tham khảo các tài nguyên sau:
Tìm hiểu thêm về LLM
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
