Cursus
Concepten van Large Language Models (LLMs)
2 uur
113.3K
Stel je een Large Language Model (LLM) voor waarbij de antwoorden die je krijgt niet alleen relevant zijn, maar ook zorgvuldig geselecteerd, geprioriteerd en verfijnd om precies aan jouw behoeften te voldoen. Hoewel LLM’s een revolutie teweeg hebben gebracht in de AI-wereld, zijn ze niet zonder beperkingen. Problemen zoals hallucinaties en verouderde data kunnen de nauwkeurigheid en relevantie van hun output ondermijnen. Hier komen Retrieval-Augmented Generation (RAG) en reranking in beeld: manieren om LLM’s te verbeteren door ze te koppelen aan dynamische, up-to-date informatieophaalprocessen. Benieuwd naar de stappen van dit recept? Lees dan verder.
LLM’s hebben de AI-wereld veranderd en de grenzen verlegd van wat we met AI kunnen bereiken. Ze zijn hét hulpmiddel geworden voor iedereen die veelzijdige NLP-oplossingen zoekt in vrijwel elk domein, door een reeks taken voor natuurlijke taalbegrip en -generatie te modelleren, zoals hieronder te zien is.
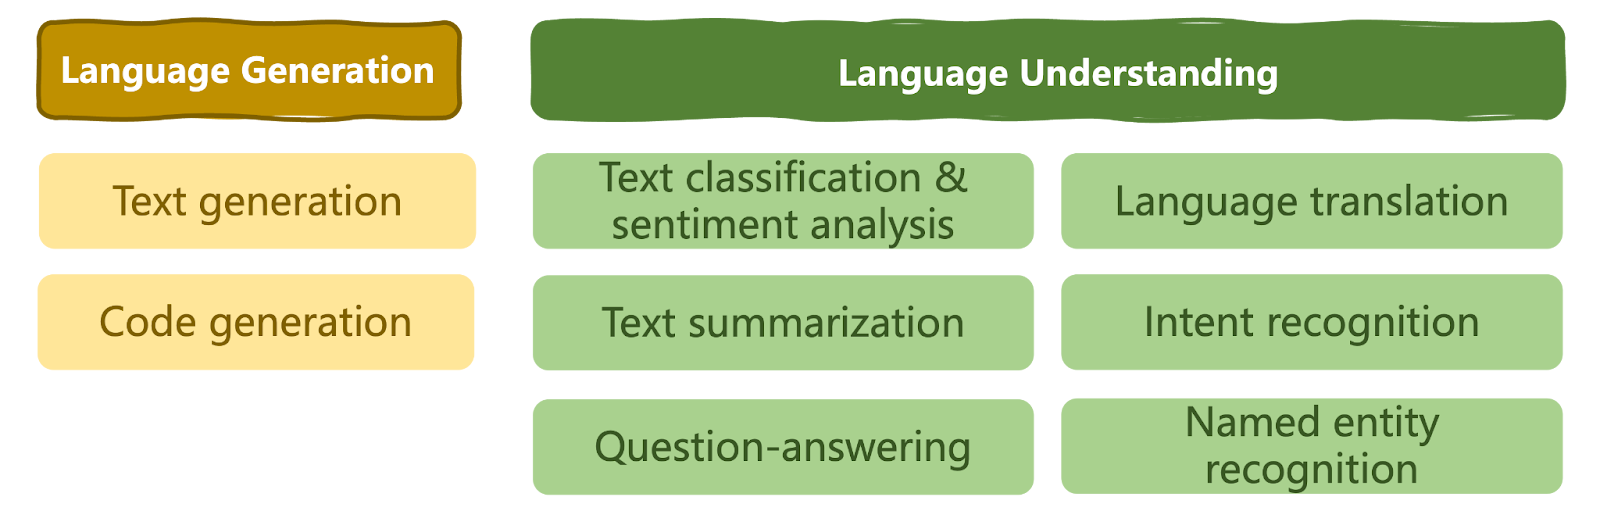
Een taxonomie van oplosbare taalopgaven door LLM’s | Iván Palomares
Ondanks hun capaciteiten hebben LLM’s in bepaalde scenario’s ook beperkingen. Afhankelijk van de specifieke use case en de kennis die ze hebben opgedaan uit de enorme dataset waarop ze zijn getraind, lukt het LLM’s soms niet om coherente, relevante of contextueel passende tekst te genereren. Soms, bij gebrek aan relevante, waarheidsgetrouwe data om een antwoord op gebruikersvragen te formuleren, kunnen ze zelfs onjuiste of onsamenhangende informatie genereren alsof die waar is. Dit fenomeen staat bekend als hallucinatie.
Neem bijvoorbeeld de vraag: "What are the common flu symptoms?"
Een standaard LLM zou een antwoord kunnen geven op basis van algemene kennis, met een opsomming van veelvoorkomende symptomen zoals koorts, hoesten en spierpijn.
Maar tenzij het model is getraind op zeer domeinspecifieke data over griepvirussen, houdt het mogelijk geen rekening met variaties in ernst van symptomen of met verschillen tussen griepstammen, waardoor het vrij generieke en zelfs wat “geautomatiseerde” antwoorden geeft aan verschillende gebruikers, ongeacht hun omstandigheden of behoeften.
Bovendien, als het model bijvoorbeeld is getraind op klinische griepdata tot en met december 2023 en er in januari 2024 een nieuwe griepvariant opduikt en zich snel verspreidt, dan kan een op zichzelf staand LLM geen accurate antwoorden geven vanwege het gebrek aan actuele kennis over het domein.
Dit probleem van “data-veroudering” staat bekend als knowledge cut-off.
In sommige gevallen zou de oplossing kunnen zijn om het LLM regelmatig opnieuw te trainen en te fine-tunen met recente, up-to-date informatie. Maar is dat per se de beste aanpak?
LLM’s (Large Language Models) staan bekend als lastig en kostbaar om te trainen. Ze vereisen miljoenen tot miljarden tekstinstanties en vaak duizenden domeinspecifieke teksten voor fine-tuning (zie diagram hieronder).
De meeste LLM’s, zelfs domeinspecifieke, worden doorgaans gefine-tuned om te werken in breed georiënteerde domeinen, zoals gezondheid. Daarom is het introduceren van nieuwe, fijnmazige data om alle mogelijke contextuele nuances in het domein te dekken, mogelijk niet de meest efficiënte oplossing.
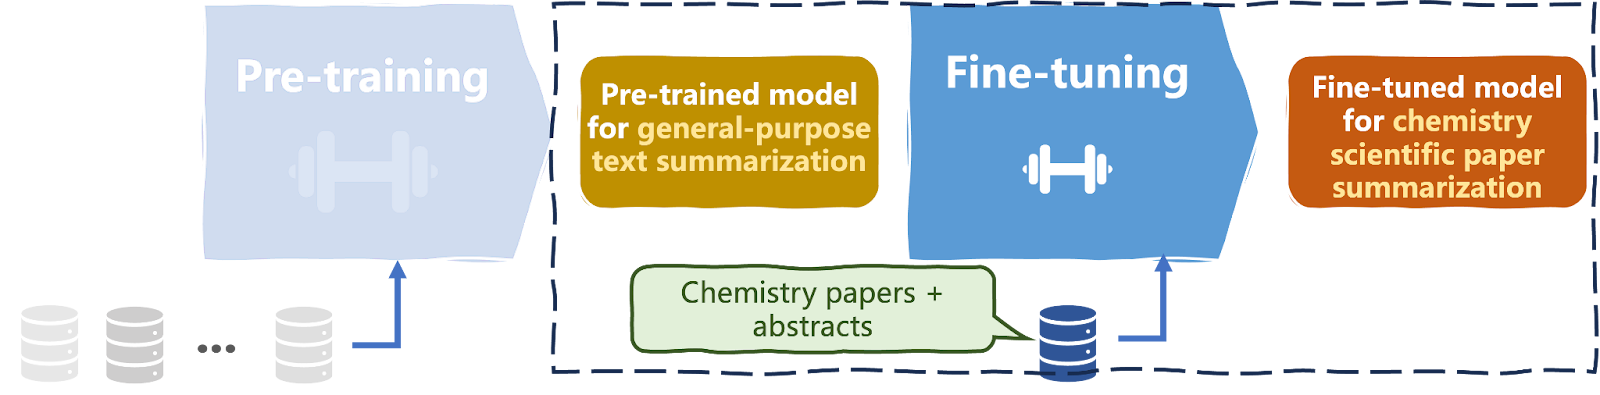
Pre-training en fine-tuning van een LLM | Iván Palomares
Hier komt RAG (Retrieval Augmented Generation) van pas!
RAG is een informatieophaalproces waarmee de output van een LLM wordt geoptimaliseerd. LLM’s vertrouwen op de kennis die ze hebben opgedaan uit de data waarop ze zijn getraind om antwoorden te genereren.
RAG verwijst ondertussen naar een externe kennisbasis.
Door beide oplossingen te combineren, kan RAG de kwaliteit, gebruikersrelevantie, samenhang en waarheidsgetrouwheid van de “ruwe” output van het LLM verbeteren door kennis op te halen uit de eerder genoemde kennisbasis.
Daardoor vervalt grotendeels de noodzaak om het LLM voortdurend opnieuw te trainen om het aan te passen aan steeds nieuwe contexten en situaties.
De algemene workflow van een RAG-systeem wordt hieronder vereenvoudigd beschreven:
Terug naar het griepvoorbeeld: met RAG kan het model actuele, relevante informatie ophalen uit medische databanken of recente artikelen, waardoor het een genuanceerder en accurater antwoord kan geven op de vraag van de patiënt of zorgverlener.
Het kan inzichten opnemen over huidige griepstammen, regionale variaties in symptomen of opkomende patronen, en zo een relevanter en samenhangender antwoord geven op de vraag van de gebruiker.
Reranking is een informatieophaalproces waarbij een initiële set opgehaalde resultaten wordt herordend om de relevantie voor de gebruikersvraag, behoeften en context te verbeteren, en zo de algehele outputkwaliteit te verhogen. Zo werkt het:
Het volgende diagram illustreert het rerankingproces:
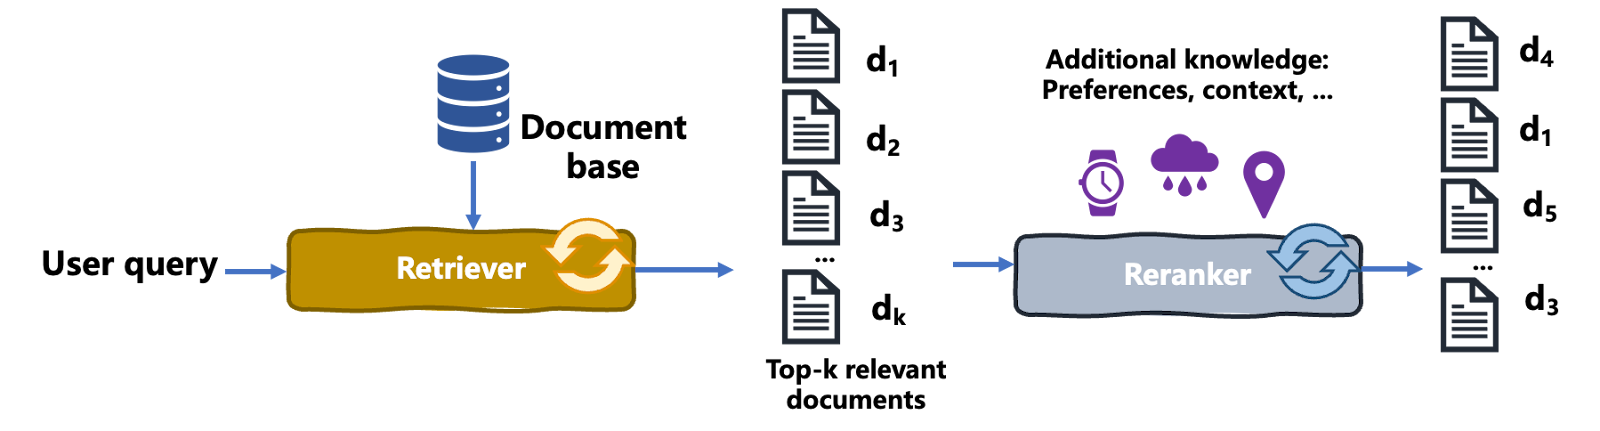
Rerankingproces | Iván Palomares
Laten we hier een belangrijk punt verduidelijken: reranking herordent opgehaalde documenten op basis van diverse criteria, zoals gebruikersvoorkeuren. Maar reranking is iets anders dan aanbevelingssystemen, zoals de systemen die relevante producten voorstellen op e-commercesites.
Reranking wordt gebruikt in zoekcases waarin een gebruiker in realtime een invoervraag geeft.
Aanbevelingssystemen daarentegen doen proactief gepersonaliseerde suggesties aan gebruikers op basis van hun interacties en voorkeuren in de loop van de tijd.
Laten we het griepvoorbeeld nog eens bekijken.
Stel dat een zorgprofessional zoekt naar "best treatments for flu symptoms." Een initieel retrievalsysteem kan een lijst documenten opleveren, waaronder algemene informatie over griep, behandelrichtlijnen en onderzoeksartikelen.
Maar een rerankingmodel, dat mogelijk extra patiëntspecifieke data en contextuele informatie gebruikt, kan deze documenten vervolgens herordenen om de meest relevante en recente behandelprotocollen, tips voor patiëntenzorg en peer-reviewed onderzoeksstudies die direct ingaan op griepsymptomen en de aanpak daarvan te prioriteren, en zo resultaten voorrang geven die “recht op het doel” afgaan.
Kortom, reranking herorganiseert een lijst met opgehaalde documenten op basis van aanvullende relevantiecriteria, zodat de meest relevante voor deze specifieke gebruiker bovenaan staan.
Reranking is bijzonder nuttig in Large Language Models (LLM’s) die zijn uitgerust met Retrieval-Augmented Generation (RAG). RAG combineert LLM’s met externe documentophaal om meer onderbouwde en nauwkeurige antwoorden te geven.
Na de initiële documentophaal op basis van een vraag kan een rerankingproces de selectie verfijnen, zodat het LLM werkt met de meest relevante en hoogwaardige informatie.
Dit proces verbetert de algehele prestaties van het LLM, met nauwkeurigere en relevantere antwoorden als resultaat, vooral in gespecialiseerde domeinen waar precieze informatie cruciaal is.
Er is niet één recept voor het implementeren van een ranker. Er zijn verschillende benaderingen, waaronder:
Nu we de voordelen begrijpen van het integreren van RAG in LLM’s, evenals de rerankingmechanismen voor kennisophaal, is het tijd om deze elementen te combineren en ze in actie te zien.
Dit voorbeeld gebruikt de LangChain-bibliotheek (communityversie) om een eenvoudige RAG-pijplijn met reranking te bouwen. Ontdek veel meer over het ontwikkelen van LLM-toepassingen met LangChain in de cursus Developing LLM Applications en deze tutorial over het bouwen van LLM-toepassingen met LangChain.
De code is geïmplementeerd in een Google Colab-notebook.
pip install -U langchain-communityEerst installeren we langchain-community in ons notebook.
Importeer vervolgens de benodigde packages, classes en functies.
import os
from langchain.vectorstores import FAISS
from langchain.embeddings import OpenAIEmbeddings
from langchain.llms import OpenAI
from langchain.prompts import PromptTemplate
from langchain.text_splitter import CharacterTextSplitter
from langchain.schema import Document
from langchain.chains.qa_with_sources import load_qa_with_sources_chain
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np
De volgende functie is gedefinieerd om een lijst met documenten (.txt-bestanden) te laden uit een lokale map waaruit je notebook kan lezen. Dit zijn de documenten die worden opgehaald en gererankt om LLM-outputs te verbeteren:
# Function to load documents from a directory
def load_documents_from_directory(directory_path):
    documents = []
    for filename in os.listdir(directory_path):
        if filename.endswith(".txt"):
            with open(os.path.join(directory_path, filename), 'r') as file:
                documents.append(file.read())
    return documents

# Load documents from the specified directory
directory_path = "./sample_data"
documents = load_documents_from_directory(directory_path)
Om de prestaties van embedrepresentaties van tekstdocumenten te optimaliseren, beperken we hun grootte tot 1000 en splitsen we langere documenten in kleinere stukken. De class CharacterTextSplitter helpt daarbij.
Het argument chunk_overlap is ingesteld op 0 om overlap van tekstgedeelten tussen chunks te voorkomen.
# Split documents into chunks for better embedding performance
text_splitter = CharacterTextSplitter(chunk_size=1000, chunk_overlap=0)
docs = text_splitter.split_documents(documents)
We gebruiken OpenAI-embeddings om onze embedding-vectorstore op te bouwen. Let op: afhankelijk van de omgeving waarin je de code draait, heb je mogelijk een verificatiesleutel van OpenAI nodig in OPENAI_API_KEY.
# Initialize OpenAI embeddings
embeddings = OpenAIEmbeddings()

# Build FAISS vector store upong document chunk embeddings
vector_store = FAISS.from_documents(docs, embeddings)

# Load and initialize OpenAI LLM
llm = OpenAI(model="text-davinci-003", temperature=0.7)
FAISS maakt een vectorstore op basis van embeddings. We moeten twee argumenten doorgeven aan de functie from_documents(): de documentchunks en de geïnitialiseerde embeddingsinstantie met behulp van OpenAIEmbeddings.
Daarna halen we een van de hoofdrolspelers erbij: het LLM! We gebruiken OpenAI om het model text-davinci-003 te laden, met een redelijk hoge temperatuur van 0,7 om enige originaliteit in de tekstopwekking toe te staan.
Laten we nog een paar stappen zetten:
# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Define the RAG chain with reranking using a QA chain
qa_chain = load_qa_with_sources_chain(llm, prompt_template=prompt_template, retriever=vector_store.as_retriever())

# Example question
question = "What are the common symptoms of the flu and how can it be treated?"

# Generate an answer using the QA chain
response = qa_chain(question=question)

print(response)
Bovenstaande code definieert eerst een vraag-antwoordprompt. Daarna roept het de functie load_qa_with_sources_chain() aan om een vraag-antwoordsysteem (of keten in LangChain-termen) te maken. Het argument retriever maakt het mogelijk om een retrievalcomponent op te nemen in de LLM-pijplijn, en zo RAG te activeren.
Tot slot formuleren we een vraag en voeren we de gedefinieerde pijplijn qa_chain uit. Voilà!
Hier is de output (deze hangt af van de documenten waaruit je leest):
“Veelvoorkomende griepsymptomen zijn koorts, hoesten, keelpijn, een loopneus of verstopte neus, spierpijn, hoofdpijn, koude rillingen en vermoeidheid. Sommige mensen kunnen last krijgen van braken en diarree, vooral kinderen. De griep kan worden behandeld met antivirale medicijnen, die de ziekte milder kunnen maken en de duur kunnen verkorten. Antivirale middelen kunnen ook ernstige complicaties zoals longontsteking voorkomen. Snelle behandeling wordt aanbevolen voor mensen die erg ziek zijn of een hoog risico op complicaties hebben.”
Het vorige voorbeeld zag er goed uit, behalve dat de rerankingfase ontbrak. De code aanpassen om reranking op te nemen is relatief eenvoudig.
De lijst met imports is hetzelfde, omdat we in de vorige versie al alle benodigde imports voor de rerankingfase hebben gedaan — ook al hadden we sommige nog niet gebruikt:
# Previous code here
#...

# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Reranking function
def rerank_documents(question, retrieved_docs, top_n=5):
    question_embedding = embeddings.embed_text(question)
    doc_embeddings = [doc.embedding for doc in retrieved_docs]
    similarities = cosine_similarity([question_embedding], doc_embeddings)[0]

    ranked_indices = np.argsort(similarities)[::-1]  # Sort by descending similarity
    ranked_docs = [retrieved_docs[i] for i in ranked_indices[:top_n]]
    return ranked_docs
Zoals je ziet definiëren we eerst een functie rerank_documents die cosinus-similariteit op embeddings gebruikt om de overeenkomst tussen de embedding van de vraag en die van de documenten te berekenen, en de top-n documenten retourneert.
# Custom QA chain with reranking
class CustomQAWithReranking:
    def __init__(self, llm, retriever, prompt_template, top_n=5):
        self.llm = llm
        self.retriever = retriever
        self.prompt_template = prompt_template
        self.top_n = top_n

    def __call__(self, question):
        retrieved_docs = self.retriever.retrieve_documents(question)
        ranked_docs = rerank_documents(question, retrieved_docs, self.top_n)
        context = "\n".join([doc.page_content for doc in ranked_docs])
        prompt = self.prompt_template.format(context=context, question=question)
        return self.llm(prompt)
De class CustomQAWithReranking integreert in het LLM de stappen voor retrieval en reranking in de LLM-pijplijn, die worden aangeroepen via de functie call () in deze class.
# Define the custom QA chain with reranking
qa_chain = CustomQAWithReranking(llm, vector_store.as_retriever(), prompt_template)

# Example question
question = "What are the benefits of using multi-vector rerankers?"

# Generate an answer using the custom QA chain
response = qa_chain(question)
Het enige wat resteert is qa_chain opnieuw te instantieren. Let op: dit keer doen we dat door een object te definiëren van de zojuist gemaakte class, die het grootste deel van de logica uit onze vorige versie kapselt, plus onze eigen rerankingmechaniek.
Tot slot formuleren we de vraag en roepen we de keten aan om een antwoord te krijgen.
In de wereld van LLM’s en AI in het algemeen lijkt RAG blijvend. Een LLM toegang laten krijgen tot en kennis laten ophalen uit externe bronnen als onderdeel van het proces om antwoorden te genereren, is een breed geaccepteerd alternatief geworden voor constant opnieuw trainen en fine-tunen van LLM’s.
Dit artikel besprak reranking als een nuttige aanpak om effectieve informatieophaal te integreren als onderdeel van een LLM-pijplijn. Het belichtte hoe het rerankingproces werkt, verschillende soorten rankers en een praktisch voorbeeld met LangChain en de OpenAI API.
Meer leren? Bekijk deze extra resources:
Leer meer over LLM’s
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

