Cours
Concepts des grands modèles de langage (LLM)
2 h
109.8K
Imaginez un grand modèle de langage (LLM) dont les réponses ne sont pas seulement pertinentes, mais aussi soigneusement sélectionnées, priorisées et affinées pour correspondre exactement à vos besoins. Bien que les LLM aient révolutionné le domaine de l’IA, ils ont des limites. Des problèmes comme les hallucinations et l’obsolescence des données peuvent nuire à l’exactitude et à la pertinence de leurs sorties. C’est là que le Retrieval-Augmented Generation (RAG) et le reranking entrent en jeu, en proposant d’enrichir les LLM grâce à des processus de recherche d’information dynamiques et à jour. Envie de connaître la recette étape par étape ? Poursuivez votre lecture.
Les LLM ont bouleversé le monde de l’IA et repoussé les limites de ce que nous pouvons accomplir. Ils sont devenus l’outil de référence pour quiconque cherche des solutions NLP polyvalentes, dans pratiquement tous les domaines, en modélisant toute une gamme de tâches de compréhension et de génération du langage naturel, comme illustré ci-dessous.
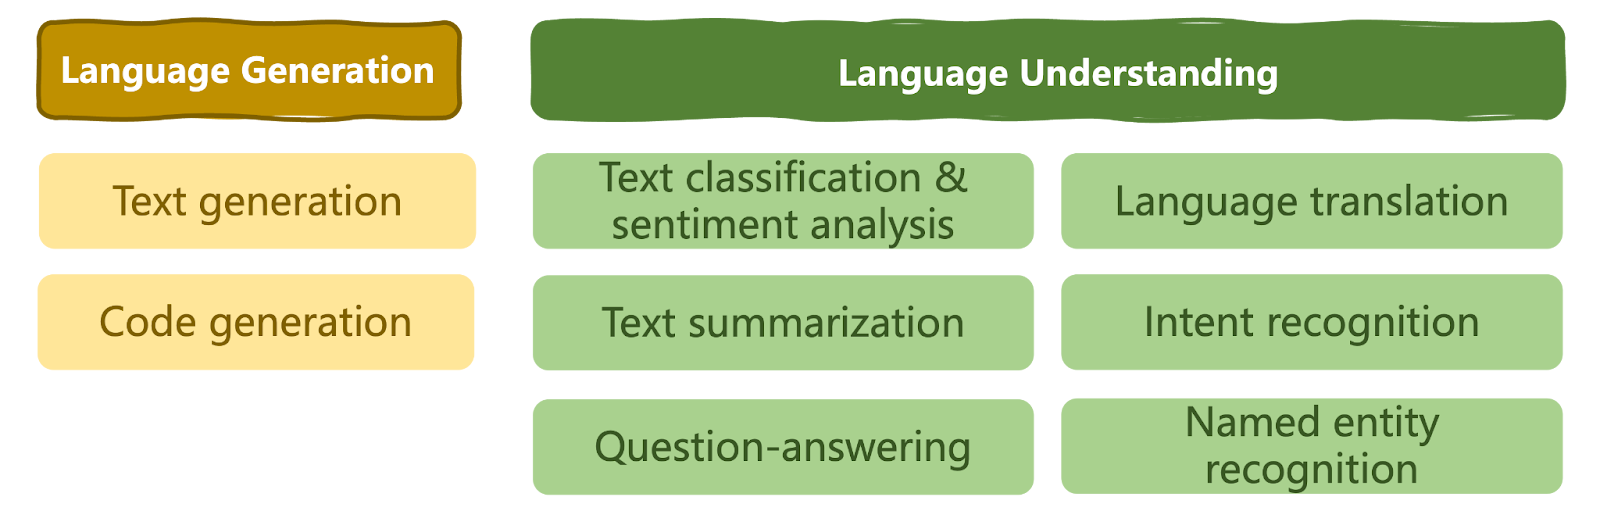
Une taxonomie des tâches linguistiques résolubles par les LLM | Iván Palomares
Malgré leurs capacités, les LLM montrent aussi des limites dans certains scénarios. Selon le cas d’usage et les connaissances apprises à partir des vastes jeux de données d’entraînement, ils peuvent parfois échouer à générer un texte cohérent, pertinent ou contextuellement approprié. Il arrive aussi qu’en l’absence de données factuelles pertinentes pour répondre à une requête, ils produisent des informations incorrectes ou absurdes présentées comme vraies. Ce phénomène est appelé hallucination.
Prenons par exemple la question : « Quels sont les symptômes courants de la grippe ? »
Un LLM standard pourrait s’appuyer sur des connaissances générales et lister des symptômes fréquents comme la fièvre, la toux et les courbatures.
Cependant, à moins d’avoir été entraîné sur des données très spécifiques à certains virus grippaux, le LLM risque de ne pas tenir compte des variations de sévérité des symptômes ou de distinguer les souches, et de fournir des réponses assez génériques, voire quelque peu « automatisées », quel que soit le profil de l’utilisateur.
De plus, si par exemple le modèle a été entraîné sur des données cliniques jusqu’en décembre 2023 et qu’une nouvelle souche grippale apparaît et se propage rapidement en janvier 2024, un LLM autonome sera incapable de répondre avec précision, faute d’informations à jour sur le domaine.
Ce problème « d’obsolescence des données » est connu sous le nom de knowledge cut-off.
Dans certains cas, une solution consisterait à réentraîner et à affiner régulièrement le LLM sur des informations récentes. Mais est-ce vraiment la meilleure voie à suivre ?
L’entraînement des LLM (Large Language Models) est bien connu pour être complexe et coûteux en calcul. Ils exigent des millions à des milliards d’exemples textuels et souvent des milliers de textes spécifiques au domaine pour le fine-tuning (voir schéma ci-dessous).
La plupart des LLM, même spécialisés, sont généralement ajustés pour couvrir des domaines larges, comme la santé. Introduire de nouvelles données très fines pour capter toutes les nuances contextuelles possibles n’est donc pas forcément la solution la plus efficace.
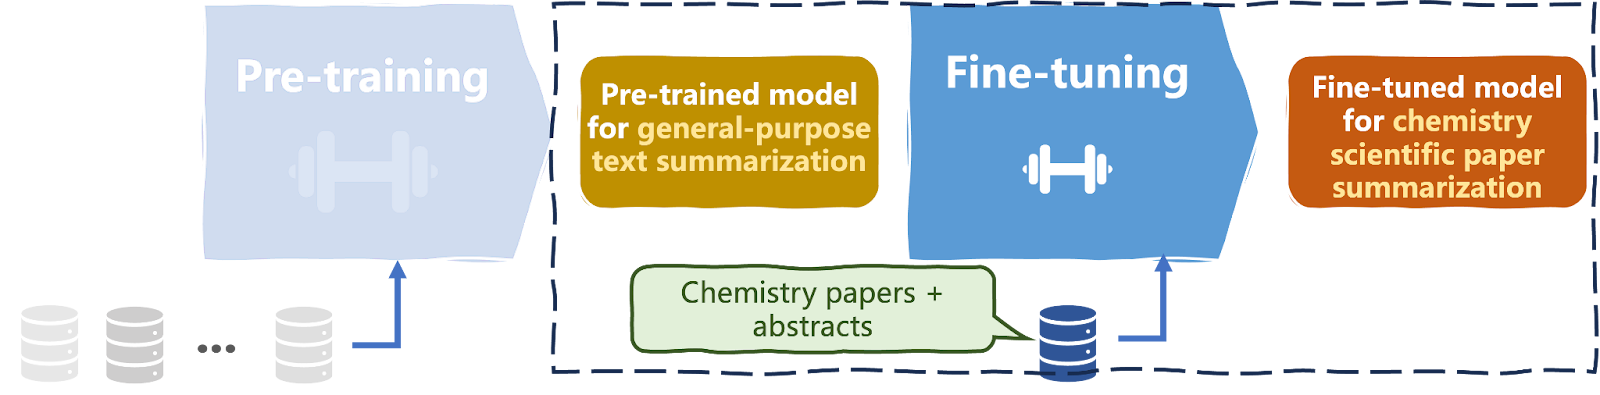
Préentraînement et fine-tuning d’un LLM | Iván Palomares
C’est ici que le RAG (Retrieval Augmented Generation) devient précieux !
RAG est un processus de recherche d’information qui optimise les sorties produites par un LLM. Un LLM génère des réponses en s’appuyant sur les connaissances apprises lors de son entraînement.
En parallèle, RAG s’appuie sur une base de connaissances externe.
En combinant les deux, RAG permet d’améliorer la qualité, la pertinence pour l’utilisateur, la cohérence et la véracité de la sortie « brute » du LLM en récupérant des connaissances dans cette base externe.
Résultat : la nécessité de réentraîner en continu le LLM pour l’adapter à de nouveaux contextes est largement réduite.
Le workflow général d’un système RAG peut se résumer ainsi :
Revenons à l’exemple de la grippe : avec RAG, le modèle pourrait aller chercher des informations à jour et pertinentes dans des bases médicales ou des articles récents, afin de produire une réponse plus nuancée et plus juste à la question du patient ou du praticien.
Il pourrait intégrer des éléments sur les souches actuelles, les variations régionales des symptômes ou des tendances émergentes, et ainsi fournir une réponse plus pertinente et cohérente.
Le reranking est un processus de recherche d’information qui consiste à réordonner un premier ensemble de résultats récupérés pour mieux coller à la requête, aux besoins et au contexte de l’utilisateur, et ainsi améliorer la qualité globale de la sortie. Voici comment cela fonctionne :
Le schéma suivant illustre le processus de reranking :
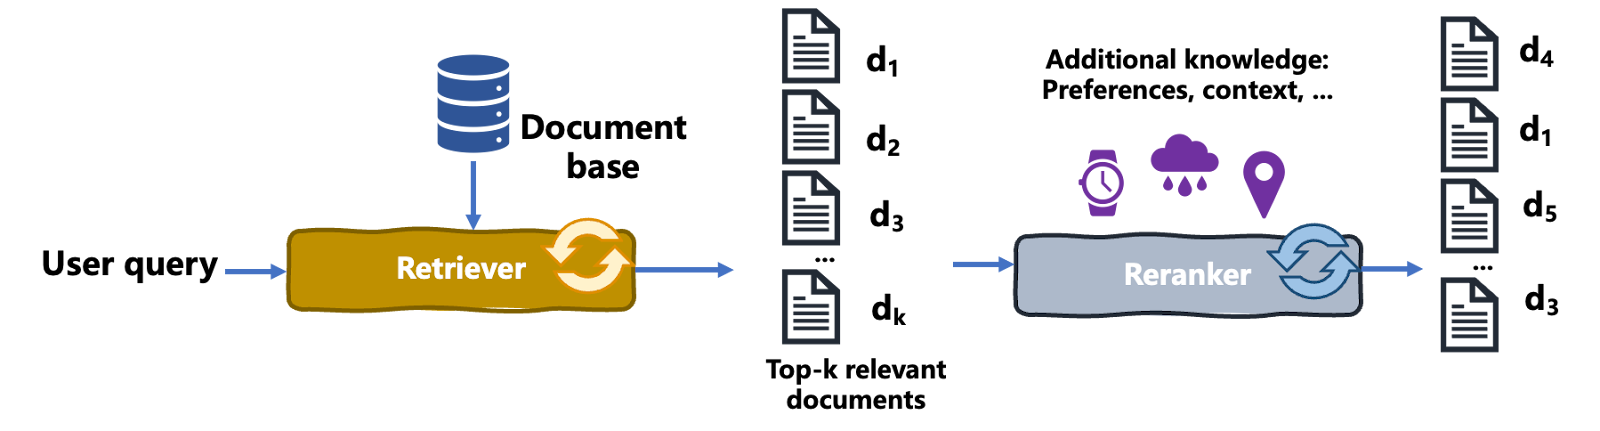
Processus de reranking | Iván Palomares
Précisons un point important : le reranking réordonne les documents récupérés selon divers critères, comme les préférences utilisateur. Cependant, le reranking n’est pas un moteur de recommandation comme ceux qui suggèrent des produits à acheter sur les sites e-commerce.
Le reranking s’emploie dans des cas de recherche où l’utilisateur fournit une requête en temps réel.
À l’inverse, les moteurs de recommandation génèrent de manière proactive des suggestions personnalisées en se basant sur les interactions et préférences au fil du temps.
Revenons à l’exemple de la grippe.
Imaginons qu’un professionnel de santé recherche « best treatments for flu symptoms. » Une première recherche peut renvoyer une liste de documents incluant des informations générales, des recommandations de traitement et des articles de recherche.
Un modèle de reranking, s’appuyant éventuellement sur des données spécifiques au patient et des informations contextuelles, peut ensuite réordonner ces documents pour mettre en tête les protocoles de traitement les plus pertinents et récents, des conseils de prise en charge et des études revues par les pairs traitant directement des symptômes grippaux et de leur gestion, afin d’aller « droit au but ».
En somme, le reranking réorganise une liste de documents récupérés selon des critères de pertinence supplémentaires pour afficher en premier ceux qui conviennent le mieux à l’utilisateur ciblé.
Le reranking est particulièrement utile pour les grands modèles de langage (LLM) équipés de Retrieval-Augmented Generation (RAG). RAG combine des LLM avec la récupération de documents externes pour fournir des réponses plus informées et plus exactes.
Après une première récupération de documents selon la requête, un processus de reranking affine la sélection pour s’assurer que le LLM s’appuie sur l’information la plus pertinente et de meilleure qualité.
Ce processus renforce les performances globales du LLM, en améliorant l’exactitude et la pertinence des réponses, notamment dans les domaines spécialisés où la précision est critique.
Il n’existe pas une seule recette pour implémenter un ranker. Plusieurs approches sont établies, parmi lesquelles :
Maintenant que nous avons vu l’intérêt d’intégrer RAG aux LLM, ainsi que les mécanismes de reranking pour la recherche de connaissances, mettons ces éléments ensemble et observons-les en action.
Cet exemple utilise la bibliothèque Langchain (version community) pour construire un pipeline RAG simple avec reranking. Pour aller plus loin sur le développement d’applications LLM avec Langchain, consultez le cours Developing LLM Applications et ce tutoriel sur la création d’applications LLM avec Langchain.
Le code est implémenté dans un notebook Google Colab.
pip install -U langchain-communityNous installons d’abord langchain-community dans le notebook.
Ensuite, importez les packages, classes et fonctions nécessaires.
import os
from langchain.vectorstores import FAISS
from langchain.embeddings import OpenAIEmbeddings
from langchain.llms import OpenAI
from langchain.prompts import PromptTemplate
from langchain.text_splitter import CharacterTextSplitter
from langchain.schema import Document
from langchain.chains.qa_with_sources import load_qa_with_sources_chain
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np
La fonction suivante charge une liste de documents (fichiers .txt) depuis un répertoire local lisible par votre notebook. Ce sont les documents qui seront récupérés et réordonnés pour améliorer les sorties du LLM :
# Function to load documents from a directory
def load_documents_from_directory(directory_path):
    documents = []
    for filename in os.listdir(directory_path):
        if filename.endswith(".txt"):
            with open(os.path.join(directory_path, filename), 'r') as file:
                documents.append(file.read())
    return documents

# Load documents from the specified directory
directory_path = "./sample_data"
documents = load_documents_from_directory(directory_path)
Pour optimiser les performances des embeddings des documents textuels, nous limitons leur taille à 1000 et découpons les documents plus longs en segments. La classe CharacterTextSplitter nous y aide.
Le paramètre chunk_overlap est fixé à 0 pour éviter tout chevauchement entre segments.
# Split documents into chunks for better embedding performance
text_splitter = CharacterTextSplitter(chunk_size=1000, chunk_overlap=0)
docs = text_splitter.split_documents(documents)
Nous allons utiliser les embeddings OpenAI pour construire notre magasin vectoriel. Selon votre environnement d’exécution, vous pourriez avoir besoin d’une clé d’API OpenAI définie dans OPENAI_API_KEY.
# Initialize OpenAI embeddings
embeddings = OpenAIEmbeddings()

# Build FAISS vector store upong document chunk embeddings
vector_store = FAISS.from_documents(docs, embeddings)

# Load and initialize OpenAI LLM
llm = OpenAI(model="text-davinci-003", temperature=0.7)
FAISS crée un magasin vectoriel à partir des embeddings. Nous devons lui passer deux arguments à la fonction from_documents() : les segments de documents et l’instance d’embeddings initialisée via OpenAIEmbeddings.
Ensuite, place au principal protagoniste : le LLM ! Nous chargeons via OpenAI le modèle text-davinci-003, avec une température de 0,7 pour autoriser une certaine originalité dans la génération.
Poursuivons avec quelques étapes :
# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Define the RAG chain with reranking using a QA chain
qa_chain = load_qa_with_sources_chain(llm, prompt_template=prompt_template, retriever=vector_store.as_retriever())

# Example question
question = "What are the common symptoms of the flu and how can it be treated?"

# Generate an answer using the QA chain
response = qa_chain(question=question)

print(response)
Le code ci-dessus définit d’abord un prompt de question-réponse. Il appelle ensuite la fonction load_qa_with_sources_chain() pour créer une chaîne de question-réponse (pipeline). Son paramètre retriever permet d’intégrer un composant de recherche au pipeline LLM, activant ainsi RAG.
Nous formulons enfin une question et exécutons le pipeline qa_chain. Et voilà !
Voici un exemple de sortie (elle dépend des documents utilisés) :
« Les symptômes courants de la grippe incluent la fièvre, la toux, le mal de gorge, le nez qui coule ou bouché, les courbatures, les maux de tête, les frissons et la fatigue. Certaines personnes, en particulier les enfants, peuvent avoir des vomissements et de la diarrhée. La grippe peut être traitée avec des antiviraux, qui atténuent la maladie et en réduisent la durée. Les antiviraux peuvent également prévenir des complications graves comme la pneumonie. Un traitement rapide est recommandé pour les personnes très malades ou à haut risque de complications. »
L’exemple précédent était convaincant, mais n’intégrait pas la phase de reranking. La modifier pour l’inclure est relativement simple.
La liste des imports reste la même, car nous avions déjà importé tout le nécessaire pour le reranking — même si certaines importations n’étaient pas encore utilisées :
# Previous code here
#...

# Define the prompt template for the LLM
prompt_template = PromptTemplate(template="Answer the question based on the context: {context}\n\nQuestion: {question}\nAnswer:")

# Reranking function
def rerank_documents(question, retrieved_docs, top_n=5):
    question_embedding = embeddings.embed_text(question)
    doc_embeddings = [doc.embedding for doc in retrieved_docs]
    similarities = cosine_similarity([question_embedding], doc_embeddings)[0]

    ranked_indices = np.argsort(similarities)[::-1]  # Sort by descending similarity
    ranked_docs = [retrieved_docs[i] for i in ranked_indices[:top_n]]
    return ranked_docs
Comme on le voit, nous définissons d’abord une fonction rerank_documents qui calcule la similarité cosinus entre l’embedding de la question et ceux des documents, puis renvoie les top‑n documents classés.
# Custom QA chain with reranking
class CustomQAWithReranking:
    def __init__(self, llm, retriever, prompt_template, top_n=5):
        self.llm = llm
        self.retriever = retriever
        self.prompt_template = prompt_template
        self.top_n = top_n

    def __call__(self, question):
        retrieved_docs = self.retriever.retrieve_documents(question)
        ranked_docs = rerank_documents(question, retrieved_docs, self.top_n)
        context = "\n".join([doc.page_content for doc in ranked_docs])
        prompt = self.prompt_template.format(context=context, question=question)
        return self.llm(prompt)
La classe CustomQAWithReranking intègre, dans le pipeline LLM, les étapes de recherche et de reranking, qui seront invoquées via la méthode call() de cette classe.
# Define the custom QA chain with reranking
qa_chain = CustomQAWithReranking(llm, vector_store.as_retriever(), prompt_template)

# Example question
question = "What are the benefits of using multi-vector rerankers?"

# Generate an answer using the custom QA chain
response = qa_chain(question)
Il ne reste qu’à instancier qa_chain à nouveau. Cette fois, nous créons un objet de la classe que nous venons d’écrire, qui encapsule l’essentiel de la logique de la version précédente, avec notre mécanisme de reranking personnalisé.
Enfin, nous formulons la question et appelons la chaîne pour obtenir une réponse.
Dans l’univers des LLM, et de l’IA en général, RAG s’est imposé. Permettre à un LLM d’accéder à des sources externes pour construire ses réponses est devenu une alternative largement adoptée au réentraînement et au fine-tuning permanents.
Cet article a présenté le reranking comme une approche efficace pour intégrer une recherche d’information performante au sein d’un pipeline LLM. Nous avons vu le fonctionnement du reranking, différents types de rankers, et un exemple pratique avec Langchain et l’API OpenAI.
Vous souhaitez aller plus loin ? Découvrez ces ressources complémentaires :
Approfondissez vos connaissances sur les LLM
Cours
Cours
Cursus