
Kursus
Memahami Machine Learning
2 Hr
307.3K
Pernahkah Anda berada dalam situasi di mana model machine learning Anda bisa memprediksi siapa yang akan membeli, tetapi tidak bisa memberi tahu mengapa mereka membeli?
Machine learning tradisional dapat menemukan pola dan memprediksi hasil. Ia akan memberi tahu Anda bahwa seorang pelanggan kemungkinan besar akan churn atau bahwa penjualan akan menurun pada kuartal berikutnya. Namun jika Anda bertanya apakah kampanye pemasaran terbaru Anda benar-benar menyebabkan peningkatan penjualan, atau apakah suatu pengobatan benar-benar memperbaiki hasil pasien, ia tidak tahu harus berbuat apa. Prediksi dan kausalitas adalah dua hal yang berbeda.
Causal machine learning menggabungkan machine learning dengan teknik inferensi kausal. Jadi, alih-alih bertanya "apa yang akan terjadi?", ia bertanya "apa yang terjadi jika kita melakukan intervensi?" - dan itulah pertanyaan di balik setiap keputusan bisnis atau pengobatan medis.
Dalam artikel ini, saya akan membahas konsep inti di balik causal ML, metode yang digunakan untuk mengestimasi sebab-akibat, dan cara menerapkannya di Python.
Jika Anda baru di machine learning, daftar ke Machine Learning Fundamentals in Python yang ramah pemula.
Model ML standar mempelajari pola dari data dan menggunakannya untuk membuat prediksi. Mereka bagus untuk menjawab "apa yang akan terjadi?" tetapi tidak bisa memberi tahu Anda apa yang menyebabkannya terjadi.
Causal machine learning mengajukan pertanyaan yang berbeda. Ia menggabungkan ML dengan teknik inferensi kausal untuk mengestimasi hubungan sebab-akibat dari data. Jadi, alih-alih memprediksi sebuah hasil, ia mengestimasi apa yang akan berubah jika Anda mengambil tindakan tertentu.
Tindakan itu disebut intervensi dan mewakili perubahan yang sengaja Anda lakukan untuk melihat dampaknya. Apakah diskon benar-benar mendorong lebih banyak pembelian, atau pelanggan itu memang akan membeli? Apakah obat baru meningkatkan pemulihan, atau pasien membaik dengan sendirinya?
Ini adalah pertanyaan yang tidak bisa dijawab oleh prediksi, tetapi bisa oleh causal ML.
ML tradisional mempelajari korelasi. Ia menemukan bahwa pelanggan yang menerima email diskon cenderung membeli lebih banyak, dan menggunakan pola itu untuk memprediksi pembelian di masa depan. Namun korelasi tidak memberi tahu Anda apakah email itu menyebabkan pembelian. Mungkin pelanggan tersebut memang sudah berencana membeli.
Causal ML mengestimasi efek kausal dari email terhadap pembelian. Ia bertanya apa yang akan terjadi jika Anda tidak mengirimkannya. Perbedaan antara "hal-hal ini cenderung muncul bersama" dan "hal ini menyebabkan hal itu" adalah yang membedakan ML tradisional dan kausal.
Berikut cara sederhana untuk memikirkannya:
Yang pertama membantu Anda memprediksi. Yang kedua membantu Anda memutuskan. Keduanya berguna.
Sebagian besar keputusan bisnis dan kebijakan bersifat kausal. Anda tidak bertanya "apa yang akan terjadi?" - Anda bertanya "apa yang harus kita lakukan?"
Berikut beberapa contoh konkret:
Metode machine learning standar tidak dapat menjawab pertanyaan-pertanyaan ini karena memperlakukan korelasi sebagai fitur. Dua variabel yang bergerak bersama mungkin memiliki penyebab umum, atau hubungan tersebut murni kebetulan. Causal ML memaksa Anda memikirkan mengapa hal-hal saling terhubung - dan apakah mengubah satu hal benar-benar akan mengubah yang lain.
Sebelum Anda dapat mengestimasi sebab-akibat, Anda perlu memahami beberapa hal yang menjadi dasar setiap analisis kausal.
Setiap pertanyaan kausal memiliki dua bagian: perlakuan dan hasil.
Perlakuan adalah tindakan atau intervensi yang Anda pelajari. Bisa berupa obat yang diberikan kepada pasien, atau diskon yang ditawarkan kepada pelanggan. Hasil adalah apa yang Anda ukur, seperti waktu pemulihan, tingkat pembelian, atau produktivitas.
Tujuan causal ML adalah mengestimasi bagaimana perlakuan mengubah hasil. Ia tidak mengestimasi apakah keduanya berkorelasi, melainkan apakah yang satu benar-benar menyebabkan yang lain.
Anda dapat mengamati apa yang terjadi setelah pasien meminum obat, tetapi Anda tidak dapat mengamati apa yang akan terjadi jika mereka tidak meminumnya. Skenario yang tidak teramati itu disebut kontrafaktual.
Di domain lain, misalnya seorang pelanggan menerima diskon 20% dan melakukan pembelian. Kontrafaktual bertanya: apakah mereka akan membeli tanpa diskon? Anda tidak akan pernah tahu pasti karena Anda tidak bisa memundurkan waktu dan menjalankan kedua versi pada orang yang sama.
Causal ML mengestimasi kontrafaktual ini menggunakan teknik statistik dan asumsi. Kualitas estimasi kausal Anda bergantung pada seberapa baik Anda mendekati apa yang tidak dapat diamati secara langsung.
Confounder adalah variabel yang memengaruhi perlakuan dan hasil sekaligus, sehingga menciptakan kesan palsu tentang kausalitas.
Sebagai contoh, katakanlah Anda mempelajari apakah olahraga mengurangi penyakit jantung. Orang yang lebih sering berolahraga juga cenderung makan lebih sehat. Pola makan memengaruhi kemungkinan berolahraga (perlakuan) dan penyakit jantung (hasil). Jika Anda mengabaikan pola makan, Anda akan melebih-lebihkan seberapa besar peran olahraga saja.
Confounder adalah ancaman terbesar bagi analisis kausal. Mengidentifikasi dan memperhitungkannya adalah yang membuat estimasi kausal dapat diandalkan, dan patut menjadi fokus waktu Anda.
Jika Anda bertanya-tanya bagaimana mengetahui variabel mana yang merupakan confounder dan mana yang bukan, ya, Anda menggambar sebuah graf.
Sebuah directed acyclic graph (DAG) adalah diagram yang memetakan hubungan kausal antar variabel. Setiap simpul merepresentasikan variabel, dan setiap panah menunjuk dari penyebab ke akibat. "Directed" berarti panah memiliki arah. "Acyclic" berarti tidak ada loop - sebuah variabel tidak bisa menyebabkan dirinya sendiri, baik langsung maupun melalui rantai.
Ambil contoh olahraga tadi. DAG sederhana akan memiliki panah dari Diet - Exercise dan Diet - Heart Disease, plus panah dari Exercise - Heart Disease. Graf membuatnya jelas bahwa Diet adalah confounder karena memiliki panah yang menunjuk ke perlakuan dan hasil sekaligus.
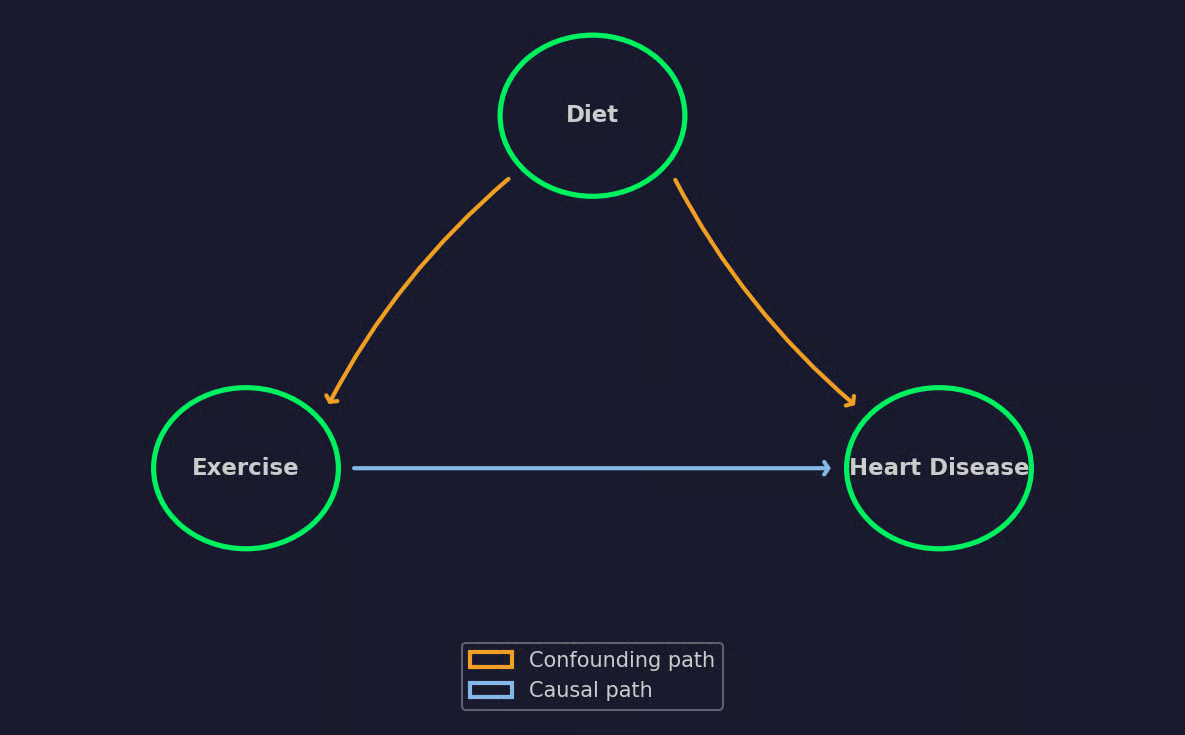
Contoh DAG sederhana
DAG juga memberi tahu Anda variabel mana yang harus dikendalikan dan mana yang dibiarkan. Jika Anda mengendalikan variabel yang salah, Anda justru bisa memperkenalkan bias alih-alih menghilangkannya. Dengan itu, anggap DAG sebagai peta jalan untuk seluruh analisis kausal Anda.
Bagian terbaiknya?
Anda tidak membutuhkan matematika untuk membangun DAG. Anda hanya perlu pengetahuan domain. Graf mengenkode asumsi Anda tentang cara kerja dunia, dan kualitas estimasi kausal Anda bergantung pada apakah asumsi tersebut benar.
Causal ML banyak meminjam dari statistika dan ekonometri, tetapi menskalakan ide-ide ini dengan machine learning. Saya akan membahas empat pendekatan yang paling umum.
Dalam dunia ideal, Anda akan menjalankan eksperimen teracak untuk mengukur efek perlakuan. Namun dalam praktik, penetapan perlakuan jarang acak. Orang yang menerima perlakuan sering kali berbeda dari yang tidak - dan perbedaan itu menciptakan bias.
Metode propensity score mengatasinya dengan mengestimasi probabilitas setiap individu menerima perlakuan, berdasarkan karakteristik yang teramati. Probabilitas itu adalah propensity score.
Setelah Anda memiliki skor, ada dua cara utama untuk menggunakannya:
Kedua metode mencoba mensimulasikan seperti apa eksperimen teracak, menggunakan data observasional.
Terkadang confounder yang perlu Anda kendalikan tidak ada dalam data. Anda tidak bisa mengukurnya, jadi propensity score tidak akan membantu. Di sinilah instrumental variables (IV) berguna.
Instrumen adalah variabel yang memengaruhi perlakuan tetapi tidak memiliki pengaruh langsung terhadap hasil. Ia hanya memengaruhi hasil melalui perlakuan.
Contoh klasiknya adalah mempelajari efek pendidikan terhadap penghasilan. Motivasi memengaruhi seberapa banyak pendidikan yang diperoleh seseorang dan seberapa besar penghasilan mereka - tetapi Anda tidak bisa mengukur motivasi secara langsung. Jarak ke perguruan tinggi terdekat berfungsi sebagai instrumen karena memengaruhi apakah seseorang kuliah, tetapi tidak secara langsung memengaruhi gaji masa depan mereka.
Dalam praktik, menemukan instrumen yang baik itu sulit. Metode ini sangat bagus ketika Anda memilikinya, tetapi instrumen yang lemah atau tidak valid akan menghasilkan hasil yang menyesatkan.
Causal forests memperluas algoritme random forest untuk mengestimasi efek perlakuan alih-alih prediksi. Random forest standar memprediksi hasil, sementara causal forest mengestimasi seberapa besar perlakuan mengubah hasil tersebut untuk berbagai subkelompok.
Ini berguna ketika efek perlakuan bervariasi antar individu. Obat mungkin bekerja baik untuk pasien muda tetapi tidak untuk yang lebih tua. Demikian pula, diskon mungkin meningkatkan pembelian bagi pelanggan sensitif harga tetapi tidak berpengaruh pada pelanggan loyal. Causal forests mendeteksi perbedaan ini dengan membagi data berdasarkan karakteristik yang menghasilkan variasi efek perlakuan terbesar.
Output-nya adalah estimasi efek perlakuan yang dipersonalisasi untuk setiap individu dalam dataset Anda.
Double machine learning (DML) menggabungkan model ML dengan inferensi statistik untuk mendapatkan yang terbaik dari keduanya.
Anda menggunakan satu model ML untuk memprediksi hasil dan satu lagi untuk memprediksi penetapan perlakuan. Lalu Anda melihat residual (bagian yang tidak dapat dijelaskan oleh kedua model), dan hubungan di antaranya memberi Anda efek kausal.
Jika Anda bertanya-tanya mengapa perlu langkah tambahan, ini jawabannya. Model ML sangat bagus menangkap pola, tetapi memperkenalkan bias saat digunakan untuk estimasi kausal. DML menghilangkan bias itu melalui teknik yang disebut cross-fitting, di mana Anda melatih dan memprediksi pada split data yang berbeda untuk menghindari overfitting.
Setelah memilih metode, Anda memerlukan cara untuk merangkum temuan. Di sinilah metrik efek perlakuan berperan.
Average Treatment Effect (ATE) mengukur efek kausal rata-rata dari perlakuan di seluruh populasi Anda. Jika ATE dari kampanye diskon adalah $5, artinya, rata-rata, diskon meningkatkan belanja sebesar $5 per pelanggan.
ATE memberi gambaran besar, tetapi menyembunyikan variasi individu. Rata-rata $5 bisa berarti semua orang membelanjakan $5 lebih banyak, atau bisa berarti setengah pelanggan membelanjakan $10 lebih banyak sementara setengahnya lagi tidak berubah.
Conditional Average Treatment Effect (CATE) mengestimasi efek perlakuan untuk subkelompok tertentu berdasarkan karakteristiknya. Jadi, alih-alih satu angka untuk semua orang, CATE memberi tahu Anda bahwa diskon meningkatkan belanja sebesar $8 untuk pelanggan baru tetapi hanya $2 untuk pelanggan lama.
CATE adalah yang membuat causal ML dapat ditindaklanjuti. ATE memberi tahu Anda apakah sebuah intervensi berhasil. CATE memberi tahu Anda untuk siapa intervensi itu berhasil - dan itulah jawaban yang Anda butuhkan untuk membuat keputusan berbasis data.
Causal ML muncul di mana pun Anda perlu beralih dari "apa yang terjadi?" ke "apa yang harus kita lakukan?" Berikut beberapa contohnya.
Rumah sakit ingin tahu pengobatan mana yang paling efektif untuk profil pasien tertentu. ML standar dapat memprediksi siapa yang berisiko, tetapi causal ML mengestimasi apakah Perlakuan A atau Perlakuan B akan menghasilkan hasil yang lebih baik untuk pasien tersebut. Ini memungkinkan keputusan pengobatan yang dipersonalisasi berdasarkan estimasi efek, bukan rata-rata populasi.
Tim pemasaran menjalankan kampanye promosi dan melihat lonjakan penjualan. Pertanyaannya, apakah kampanye menyebabkan lonjakan itu, atau karena permintaan musiman? Causal ML mengisolasi dampak kampanye yang sebenarnya dengan memperhitungkan confounder seperti waktu, demografi pelanggan, dan riwayat pembelian sebelumnya.
Pemerintah dan institusi perlu mengevaluasi apakah kebijakan menghasilkan hasil yang diinginkan. Apakah program pelatihan kerja menurunkan pengangguran? Apakah insentif pajak meningkatkan investasi? Causal ML menyediakan kerangka untuk evaluasi kebijakan ketika uji acak tidak praktis atau bahkan tidak mungkin.
Tim produk menambahkan fitur baru dan keterlibatan meningkat. Causal ML membantu menentukan apakah fitur tersebut menyebabkan peningkatan atau bertepatan dengan perubahan lain - seperti dorongan pemasaran atau pesaing yang tumbang. Memahami dampak aktual sebuah fitur membedakan keputusan berbasis data dari tebakan acak.
Benang merahnya adalah bahwa keputusan bergantung pada mengetahui mengapa sesuatu terjadi, bukan hanya bahwa sesuatu itu terjadi.
Ada tiga pustaka yang mencakup sebagian besar kasus penggunaan causal ML di Python. Saya akan membahas apa yang dilakukan masing-masing dan menunjukkan alur kerja khasnya.
Sebelum masuk ke kode, berikut cuplikan kode lengkap yang mencakup semua impor dan pembuatan dataset. Anda dapat memasang dependensi yang belum ada dengan pip atau uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
Dataset ini mendefinisikan 1000 pelanggan di toko e-commerce, dan saya mencoba mengestimasi efek kausal dari email diskon dalam dolar. Efek kausal sebenarnya dari diskon adalah $5, tetapi seperti yang terlihat dari output, perbandingan naif melebih-lebihkan efek sebenarnya karena pelanggan yang menerima diskon sudah memiliki lebih banyak pembelian sebelumnya:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")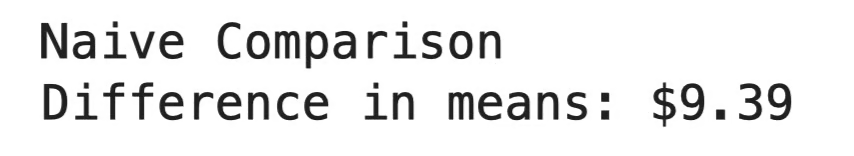
Perbandingan naif
DoWhy adalah kerangka kerja yang dibangun oleh Microsoft untuk inferensi kausal end-to-end. Ia mengikuti proses empat langkah: memodelkan masalah sebagai graf kausal, mengidentifikasi efek kausal, mengestimasinya, lalu menguji apakah estimasi tersebut bertahan di bawah berbagai asumsi.
Yang membuat DoWhy menonjol adalah fokusnya pada validasi. Setelah menghasilkan estimasi, ia menjalankan uji penyangkalan (refutation) yang menantang hasil Anda. Jika estimasi bertahan dari uji tersebut, Anda bisa lebih mempercayainya. Jika tidak, Anda tahu asumsi Anda perlu diperbaiki.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")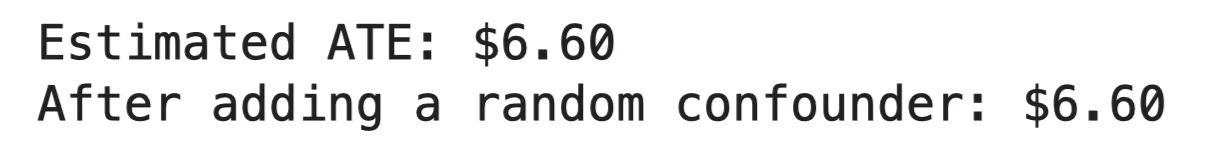
Output DoWhy
Rata-rata, diskon meningkatkan jumlah pembelian sebesar $6,60 per pelanggan. Uji penyangkalan menambahkan variabel acak ke model, dan estimasi tidak berubah sama sekali, yang berarti hasilnya tidak didorong oleh korelasi semu. Jika estimasi bergeser banyak, itu akan menjadi tanda bahaya bahwa asumsi kausalnya keliru.
EconML, juga dari Microsoft, berfokus pada pengestimasian efek perlakuan yang heterogen. Dalam bahasa sederhana, bagaimana efeknya bervariasi di berbagai subkelompok. Ia mengimplementasikan metode seperti Double ML dan Causal Forests yang telah saya bahas.
EconML mengikuti API ala scikit-learn dengan metode .fit() dan .effect().
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")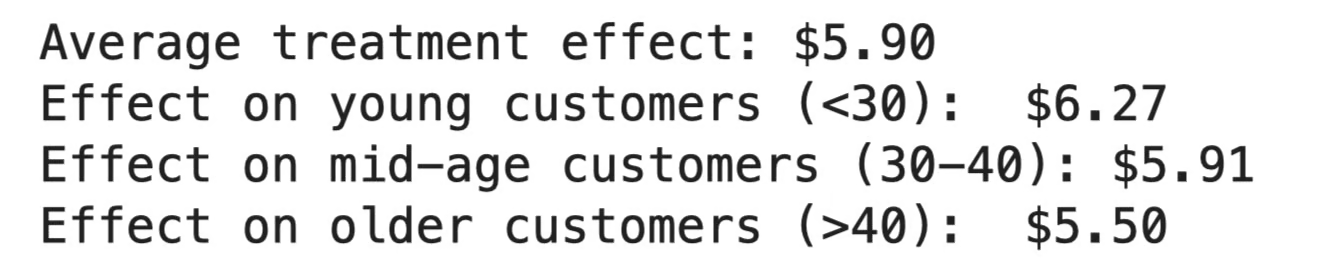
Output EconML
Diskon meningkatkan jumlah pembelian sebesar $5,90 rata-rata, tetapi efeknya tidak seragam. Pelanggan lebih muda merespons paling besar ($6,27), sementara pelanggan yang lebih tua mengalami kenaikan terkecil ($5,50). Jika anggaran Anda terbatas, ini memberi tahu ke mana kampanye harus diarahkan terlebih dahulu.
CausalML, dibangun oleh Uber, dirancang untuk uplift modeling - memprediksi individu mana yang akan paling merespons perlakuan. Ini sangat populer di pemasaran, di mana tujuannya adalah menargetkan pelanggan yang akan mengubah perilaku karena kampanye, bukan yang memang akan konversi.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())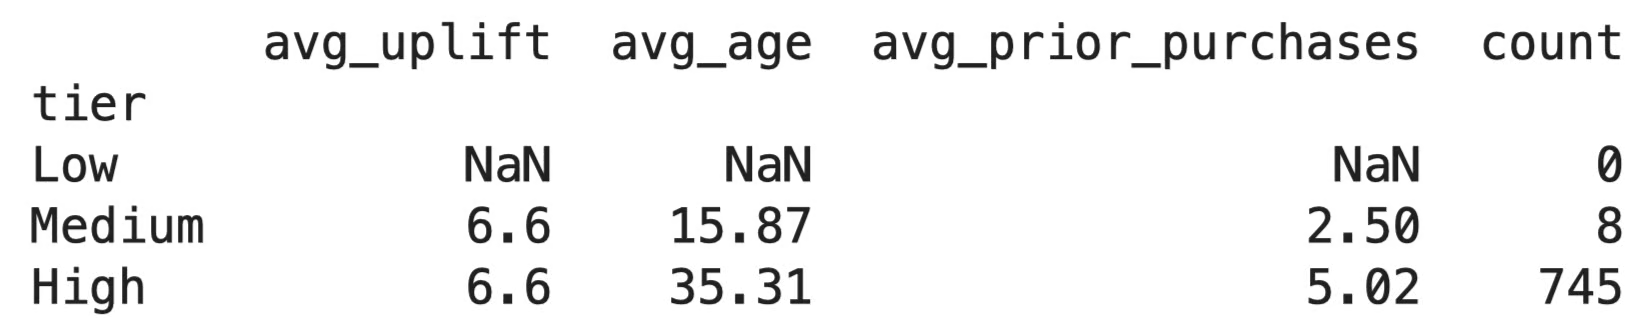
Output CausalML
Skor uplift hampir identik di seluruh pelanggan, yang berarti diskon memiliki efek yang kurang lebih sama pada semua orang - sekitar $6,60 per orang. Ini masuk akal untuk dataset sintetis kita, di mana saya membuat efek perlakuan datar $5 tanpa variasi antar subkelompok. Pada data dunia nyata, Anda biasanya akan melihat sebaran yang lebih lebar, dan di situlah tier penargetan menjadi berguna.
Setiap pustaka memiliki kasus penggunaan ideal. Gunakan:
Ketiganya bekerja baik bersama. Pola umum adalah mendefinisikan graf kausal Anda di DoWhy, mengestimasi efek dengan EconML, dan menggunakan CausalML untuk menafsirkan hasil.
Causal ML terkadang mudah disalahgunakan. Berikut kesalahan yang paling sering membingungkan orang.
Ini klasik. Pelanggan yang lebih sering menggunakan fitur juga membelanjakan lebih banyak, lalu Anda menyimpulkan fitur mendorong belanja. Namun mungkin pelanggan dengan belanja tinggi memang lebih terlibat secara umum. Tanpa kerangka kausal, Anda menebak arah hubungan.
Setiap analisis kausal dimulai dengan pertanyaan: ini pola atau sebab? Jika Anda melewatkan pertanyaan itu, sebanyak apa pun pemodelan tidak akan membantu.
Confounder memengaruhi perlakuan dan hasil sekaligus.
Misalnya Anda mengukur efek program pelatihan terhadap kinerja karyawan. Karyawan yang mendaftar pelatihan cenderung lebih termotivasi. Motivasi mendorong pendaftaran (perlakuan) dan kinerja (hasil). Jika Anda tidak memperhitungkannya, Anda akan mengatribusikan efek motivasi pada program pelatihan.
Solusinya lebih struktural daripada statistik. Gambar DAG Anda, petakan setiap variabel yang bisa memengaruhi kedua sisi, dan putuskan cara menangani masing-masing sebelum Anda melatih satu model pun.
ATE sebesar $5 tidak berarti setiap pelanggan mendapatkan $5. Itu rata-rata, dan rata-rata menyembunyikan banyak hal. Beberapa pelanggan mungkin mendapat $15 sementara yang lain kehilangan $5.
Kebalikannya juga berbahaya. Estimasi CATE untuk subkelompok tidak berarti setiap individu dalam kelompok itu akan merespons dengan cara yang sama. Efek perlakuan adalah estimasi dengan ketidakpastian, bukan jaminan. Selalu periksa interval kepercayaan dan jangan membuat keputusan penargetan hanya berdasarkan estimasi titik.
Angka yang diberikan EconML atau DoWhy hanya sebaik asumsi di belakangnya. Model tidak bisa menjawab pertanyaan seperti ini:
Pertanyaan-pertanyaan itu memerlukan seseorang yang memahami masalahnya. Causal forest akan dengan senang hati menghasilkan estimasi efek perlakuan dari model yang dispesifikasi buruk - hanya saja ia tidak akan memberi tahu Anda bahwa hasilnya salah.
Analisis kausal terbaik menggabungkan kemampuan ML menangani data kompleks dengan manusia yang tahu variabel mana yang penting dan alasannya.
Causal ML mengubah pertanyaan dari "apa yang akan terjadi?" menjadi "apa yang menyebabkannya terjadi?"
Perubahan itu mengubah cara Anda membuat keputusan. Ia membuat Anda beralih dari bereaksi terhadap pola menjadi memahami mekanisme di baliknya. Bahkan ada yang bilang ini satu-satunya cara membuat keputusan yang benar-benar berbasis data.
Namun alat-alat ini hanya bekerja sebaik asumsi yang Anda berikan. Graf kausal yang salah atau salah baca efek perlakuan dapat membawa Anda pada kesimpulan yang terasa “ilmiah” dan berbasis data tetapi keliru. Model tidak akan mengangkat tangan dan memberi tahu Anda.
Hasil terbaik datang dari menggabungkan kemampuan ML menangani data kompleks dengan seseorang yang cukup memahami masalah untuk mengajukan pertanyaan kausal yang tepat. Mulailah dari pengetahuan domain, lalu biarkan model yang bekerja berat. Tidak ada yang lebih dari itu.
Bagian pertama mudah, terutama dengan kursus Supervised Learning with scikit-learn kami. Daftar hari ini untuk mengembangkan keterampilan machine learning Anda dengan pustaka Python yang wajib diketahui.
Belajar dengan DataCamp
Kursus
Kursus
Kursus