Cours
Comprendre le Machine Learning
2 h
307.3K
Vous est-il déjà arrivé d'avoir un modèle de machine learning qui prédit qui va acheter, sans pouvoir expliquer pourquoi ?
Le machine learning traditionnel repère des schémas et prédit des résultats. Il vous dira qu'un client risque de résilier ou que les ventes vont baisser le trimestre prochain. Mais si vous lui demandez si votre dernière campagne marketing a réellement provoqué plus de ventes, ou si un traitement a véritablement amélioré l'état des patients, il ne sait plus quoi faire. Prédiction et causalité sont deux choses différentes.
L'apprentissage automatique causal combine le machine learning avec des techniques d'inférence causale. Au lieu de demander « que va-t-il se passer ? », il pose la question « que se passe-t-il si nous intervenons ? » — et c'est bien la question derrière toute décision business ou tout traitement médical.
Dans cet article, je vous présente les concepts clés de l'apprentissage causal, les méthodes pour estimer la cause et l'effet, et comment les appliquer en Python.
Si vous débutez en machine learning, inscrivez-vous à notre parcours Machine Learning Fundamentals in Python, conçu pour les débutants.
Les modèles de ML standard apprennent des motifs à partir des données pour faire des prédictions. Ils répondent bien à « que va-t-il se passer ? », mais ne peuvent pas vous dire ce qui l'a provoqué.
L'apprentissage automatique causal pose une question différente. Il combine ML et inférence causale pour estimer des relations de cause à effet à partir des données. Plutôt que de prédire un résultat, il estime ce qui changerait si vous preniez une action spécifique.
Cette action est appelée une intervention et représente un changement délibéré pour en mesurer l'effet. La remise a-t-elle réellement stimulé les achats, ou ces clients auraient-ils acheté de toute façon ? Le nouveau médicament a-t-il amélioré la guérison, ou les patients se seraient-ils remis seuls ?
Ce sont des questions auxquelles la prédiction ne répond pas, mais l'apprentissage causal, si.
Le ML traditionnel apprend des corrélations. Il constate que les clients qui reçoivent des emails de remise achètent davantage, et utilise ce motif pour prédire des achats futurs. Mais la corrélation ne dit pas si l'email a causé l'achat. Peut-être prévoyaient-ils déjà d'acheter.
Le ML causal estime l'effet causal de l'email sur les achats. Il demande ce qui se serait passé si vous ne l'aviez pas envoyé. La différence entre « ces choses apparaissent souvent ensemble » et « cette chose a causé cette autre chose » distingue le ML traditionnel du ML causal.
Voici une façon simple d'y penser :
Le premier vous aide à prédire. Le second vous aide à décider. Les deux sont utiles.
La plupart des décisions business et de politiques publiques sont, par nature, causales. Vous ne demandez pas « que va-t-il se passer ? » — vous demandez « que devons-nous faire ? »
Voici des exemples concrets :
Les méthodes de ML standard ne peuvent répondre à aucune de ces questions, car elles traitent la corrélation comme une caractéristique. Deux variables qui évoluent ensemble peuvent partager une cause commune, ou la relation peut être pure coïncidence. Le ML causal vous oblige à réfléchir au pourquoi des liens — et à vérifier si changer l'une changera réellement l'autre.
Avant d'estimer une relation de cause à effet, il faut comprendre quelques notions sur lesquelles repose toute analyse causale.
Toute question causale a deux volets : un traitement et un résultat.
Le traitement est l'action ou l'intervention étudiée. Il peut s'agir d'un médicament administré à des patients, ou d'une remise proposée à des clients. Le résultat est ce que vous mesurez : temps de guérison, taux d'achat, productivité, etc.
L'objectif du ML causal est d'estimer comment le traitement modifie le résultat. Il ne s'agit pas de savoir si les deux sont corrélés, mais de déterminer si l'un cause réellement l'autre.
Vous pouvez observer ce qui s'est passé après la prise d'un médicament, mais vous ne pouvez pas observer ce qui se serait passé s'il n'avait pas été pris. Ce scénario non observé est appelé un contrefactuel.
Autre domaine : un client a reçu une remise de 20 % et a acheté. Le contrefactuel demande : aurait-il acheté sans la remise ? Vous ne le saurez jamais avec certitude, car on ne peut pas remonter le temps et tester les deux versions sur la même personne.
Le ML causal estime ces contrefactuels via des techniques statistiques et des hypothèses. La qualité de votre estimation causale dépend de la justesse de l'approximation de ce que vous ne pouvez pas observer directement.
Un facteur de confusion est une variable qui affecte à la fois le traitement et le résultat, créant une illusion de causalité.
Par exemple, vous étudiez si le sport réduit les maladies cardiaques. Les personnes qui font plus d'exercice ont aussi tendance à mieux manger. L'alimentation affecte la probabilité de faire du sport (traitement) et les maladies cardiaques (résultat). Si vous ignorez l'alimentation, vous surestimerez l'importance du seul exercice.
Les facteurs de confusion sont la principale menace pour l'analyse causale. Les identifier et les prendre en compte rend une estimation fiable — et mérite qu'on y passe du temps.
Vous vous demandez comment déterminer quelles variables sont des confondeurs ou non ? On dessine un graphe.
Un graphe acyclique orienté (DAG) est un schéma qui cartographie les relations causales entre variables. Chaque nœud représente une variable, et chaque flèche va d'une cause vers son effet. « Orienté » signifie que les flèches ont un sens. « Acyclique » signifie sans boucle — une variable ne peut pas se causer elle-même, directement ou via une chaîne.
Reprenons l'exemple du sport. Un DAG simple aurait des flèches de Alimentation → Sport et Alimentation → Maladies cardiaques, plus une flèche de Sport → Maladies cardiaques. Le graphe rend évident qu'Alimentation est un confondeur, car il pointe vers le traitement et vers le résultat.
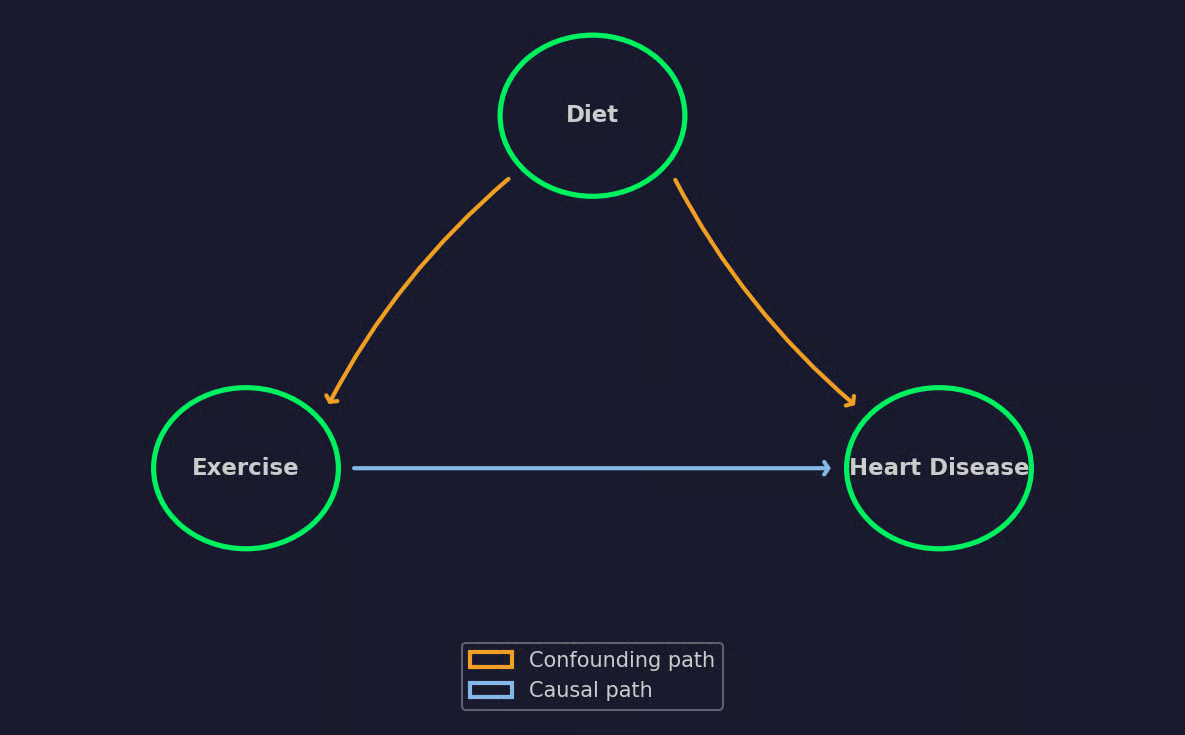
Exemple de DAG simple
Les DAG indiquent aussi quelles variables contrôler et lesquelles laisser de côté. Si vous contrôlez la mauvaise variable, vous pouvez introduire un biais au lieu de le supprimer. Voyez un DAG comme une feuille de route pour toute votre analyse causale.
Le meilleur dans tout ça ?
Vous n'avez pas besoin de maths pour construire un DAG. Vous avez besoin de connaissance métier. Le graphe encode vos hypothèses sur le fonctionnement du monde, et la qualité de vos estimations dépend de la justesse de ces hypothèses.
Le ML causal emprunte beaucoup aux statistiques et à l'économétrie, mais met ces idées à l'échelle grâce au ML. Voici les quatre approches les plus courantes.
Dans l'idéal, vous mèneriez une expérience randomisée pour mesurer l'effet d'un traitement. En pratique, l'assignation n'est que rarement aléatoire. Les personnes traitées diffèrent souvent de celles non traitées — et ces différences créent du biais.
Les méthodes de score de propension estiment la probabilité que chaque individu reçoive le traitement, selon ses caractéristiques observées. Cette probabilité est le score de propension.
Une fois les scores obtenus, deux usages principaux :
Ces deux méthodes cherchent à simuler une expérience randomisée, à partir de données observationnelles.
Parfois, les confondeurs à contrôler ne figurent pas dans vos données. Vous ne pouvez pas les mesurer, donc les scores de propension ne suffisent pas. C'est là qu'interviennent les variables instrumentales (IV).
Un instrument influence le traitement sans effet direct sur le résultat. Il n'agit sur le résultat qu'au travers du traitement.
Exemple classique : mesurer l'effet de l'éducation sur le revenu. La motivation influence à la fois la durée d'études et le salaire — mais se mesure mal. La distance au campus le plus proche est un bon instrument, car elle affecte la probabilité de faire des études, sans effet direct sur le salaire futur.
En pratique, trouver un bon instrument est difficile. La méthode est puissante quand on en dispose, mais un instrument faible ou invalide produira des résultats trompeurs.
Les forêts causales étendent l'algorithme de random forest pour estimer des effets de traitement plutôt que des prédictions. Une forêt classique prédit un résultat ; une forêt causale estime l'ampleur du changement dû au traitement selon les sous-groupes.
Utile lorsque l'effet varie selon les individus. Un médicament peut bien fonctionner chez les plus jeunes mais moins chez les plus âgés. De même, une remise peut stimuler les clients sensibles au prix mais n'avoir aucun effet sur les fidèles. Les forêts causales détectent ces différences en scindant les données selon les caractéristiques qui maximisent la variation des effets de traitement.
La sortie fournit une estimation personnalisée de l'effet du traitement pour chaque individu du jeu de données.
Le double machine learning (DML) combine des modèles de ML et l'inférence statistique pour obtenir le meilleur des deux mondes.
On utilise un modèle de ML pour prédire le résultat et un autre pour prédire l'assignation au traitement. Ensuite, on examine les résidus (les parties qu'aucun modèle n'explique) et leur relation donne l'effet causal.
Pourquoi ces étapes supplémentaires ? Les modèles de ML capturent bien les motifs, mais introduisent du biais lorsqu'ils servent à estimer un effet causal. Le DML supprime ce biais via le cross-fitting : entraîner et prédire sur des découpages différents pour éviter le surapprentissage.
Après avoir choisi une méthode, il faut résumer ce qu'elle a trouvé. C'est le rôle des métriques d'effet de traitement.
L'Average Treatment Effect (ATE) mesure l'effet causal moyen du traitement sur l'ensemble de la population. Si l'ATE d'une campagne de remise est de 5 $, cela signifie qu'en moyenne, la remise a augmenté la dépense de 5 $ par client.
L'ATE donne la vue d'ensemble, mais masque la variation individuelle. Une moyenne de 5 $ peut signifier que tout le monde a dépensé 5 $ de plus, ou que la moitié a dépensé 10 $ de plus tandis que l'autre moitié n'a pas changé.
Le Conditional Average Treatment Effect (CATE) estime l'effet de traitement pour des sous-groupes spécifiques selon leurs caractéristiques. Plutôt qu'un seul nombre pour tous, le CATE vous indique que la remise a augmenté la dépense de 8 $ chez les nouveaux clients, mais de seulement 2 $ chez les clients existants.
Le CATE rend le ML causal actionnable. L'ATE vous dit si une intervention fonctionne. Le CATE vous dit pour qui elle fonctionne — c'est la réponse dont vous avez besoin pour prendre des décisions basées sur les données.
Le ML causal intervient partout où il faut passer de « que s'est-il passé ? » à « que devons-nous faire ? ». Voici quelques exemples.
Un hôpital veut savoir quel traitement fonctionne le mieux pour un profil patient donné. Le ML standard prédit qui est à risque, tandis que le ML causal estime si le traitement A ou B donnera un meilleur résultat pour ce patient précis. Cela permet des décisions personnalisées fondées sur des effets estimés plutôt que des moyennes populationnelles.
Une équipe marketing lance une promotion et observe un pic des ventes. La question : la campagne a-t-elle causé ce pic, ou est-ce l'effet de la saisonnalité ? Le ML causal isole l'impact réel de la campagne en tenant compte de confondeurs comme le timing, la démographie client et l'historique d'achat.
Les gouvernements et institutions doivent évaluer si les politiques produisent les effets attendus. Un programme de formation à l'emploi a-t-il réduit le chômage ? Un avantage fiscal a-t-il accru l'investissement ? Le ML causal fournit un cadre d'évaluation quand les essais randomisés ne sont pas pratiques voire impossibles.
Une équipe produit ajoute une fonctionnalité et l'engagement augmente. Le ML causal aide à déterminer si la fonctionnalité a causé la hausse, ou si elle coïncide avec d'autres facteurs — comme un push marketing ou une panne d'un concurrent. Comprendre l'impact réel d'une fonctionnalité distingue une décision informée des données d'une simple intuition.
Point commun : les décisions reposent sur le pourquoi, pas seulement sur le quoi.
Trois bibliothèques couvrent la plupart des cas d'usage en Python. Voici ce que fait chacune et un flux de travail type.
Avant de passer au code, voici un extrait complet qui couvre les imports et la création du dataset. Vous pouvez installer les dépendances manquantes avec pip ou uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
Le dataset décrit 1000 clients d'une boutique e-commerce, et j'essaie d'estimer l'effet causal d'un email de remise en dollars. Le véritable effet causal de la remise est de 5 $, mais comme on le voit ci-dessous, une comparaison naïve surestime l'effet réel, car les clients ayant reçu une remise avaient déjà davantage d'achats antérieurs :
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")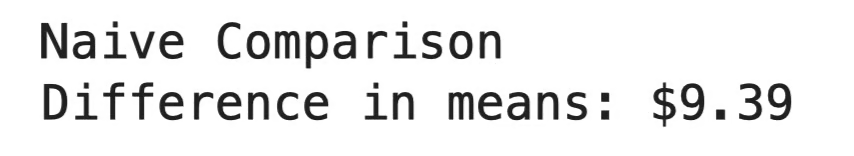
Comparaison naïve
DoWhy est un framework conçu par Microsoft pour l'inférence causale de bout en bout. Il suit quatre étapes : modéliser le problème sous forme de graphe causal, identifier l'effet causal, l'estimer, puis tester la robustesse de l'estimation sous différentes hypothèses.
La force de DoWhy, c'est la validation. Après l'estimation, il lance des tests de réfutation qui challengent votre résultat. Si l'estimation résiste, vous pouvez lui faire davantage confiance. Sinon, vous savez que vos hypothèses sont à revoir.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")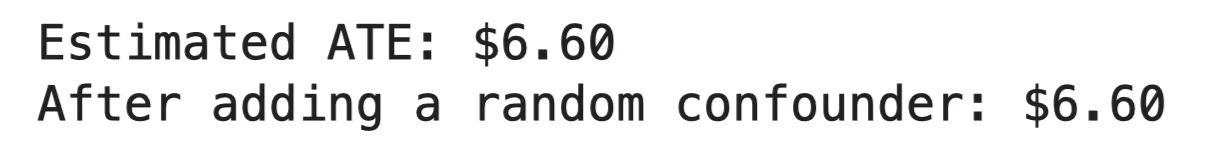
Résultat DoWhy
En moyenne, la remise a augmenté le montant d'achat de 6,60 $ par client. Le test de réfutation a ajouté une variable aléatoire au modèle, et l'estimation n'a pas bougé, signe que le résultat n'est pas porté par des corrélations fallacieuses. Si l'estimation avait beaucoup varié, cela aurait signalé un problème d'hypothèses causales.
EconML, également de Microsoft, se concentre sur l'estimation d'effets de traitement hétérogènes — en clair, comment l'effet varie selon les sous-groupes. Il implémente des méthodes comme le Double ML et les forêts causales évoquées plus haut.
EconML propose une API familière à la scikit-learn, avec des méthodes .fit() et .effect().
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")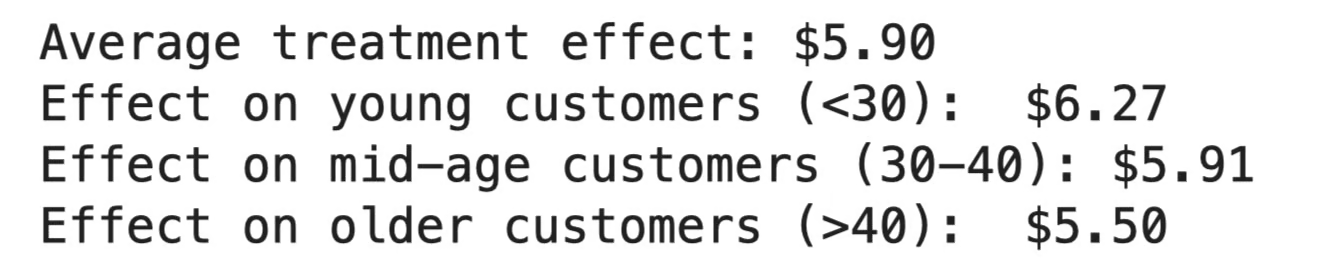
Résultat EconML
La remise a augmenté le montant d'achat de 5,90 $ en moyenne, mais l'effet n'est pas uniforme. Les plus jeunes ont le plus réagi (6,27 $), tandis que les plus âgés ont eu la plus faible hausse (5,50 $). Avec un budget limité, cela vous indique où concentrer la campagne en priorité.
CausalML, développé par Uber, est conçu pour l'uplift modeling — prédire quelles personnes réagiront le plus à un traitement. Il est particulièrement prisé en marketing, où l'objectif est de cibler les clients qui changeront de comportement grâce à la campagne, pas ceux qui auraient converti de toute façon.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())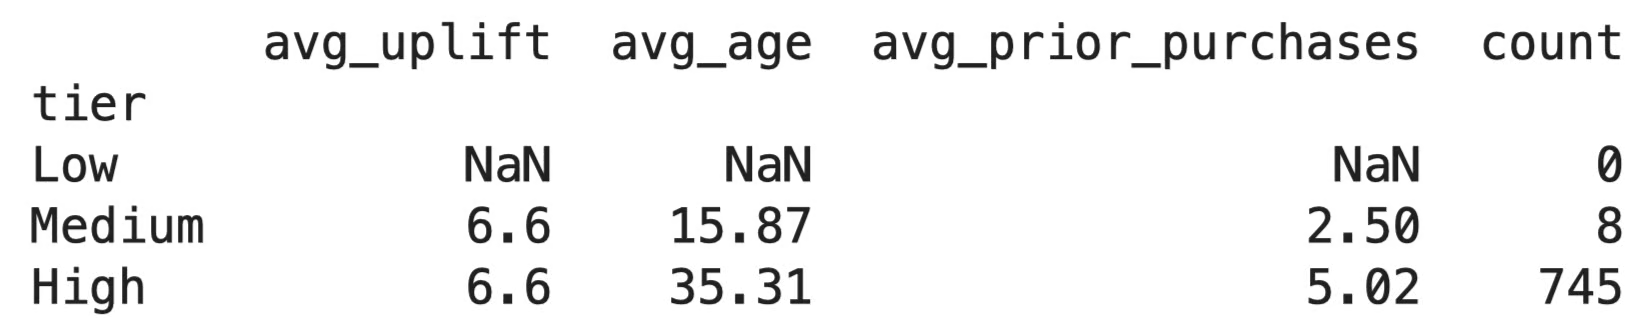
Résultat CausalML
Les scores d'uplift sont presque identiques pour tous, ce qui signifie que la remise a eu grosso modo le même effet pour chacun — environ 6,60 $ par personne. C'est cohérent avec notre jeu synthétique, où nous avons intégré un effet plat de 5 $ sans variation par sous-groupe. Sur des données réelles, la dispersion est généralement plus forte — et les paliers de ciblage deviennent utiles.
Chaque bibliothèque a son cas d'usage idéal. À utiliser :
Les trois se complètent bien. Un schéma courant : définir votre graphe causal dans DoWhy, estimer les effets avec EconML, et utiliser CausalML pour interpréter les résultats.
Le ML causal est parfois mal employé. Voici les pièges les plus courants.
Le grand classique. Les clients qui utilisent davantage une fonctionnalité dépensent aussi plus ; vous concluez que la fonctionnalité dope la dépense. Mais peut-être que les gros dépensiers sont simplement plus engagés partout. Sans cadre causal, vous devinez le sens de la relation.
Toute analyse causale commence par la question : est-ce un motif, ou une cause ? Si vous sautez cette étape, aucun modèle ne vous sauvera.
Un confondeur affecte à la fois le traitement et le résultat.
Vous mesurez l'effet d'un programme de formation sur la performance. Les employés qui s'inscrivent sont souvent plus motivés. La motivation influence l'inscription (traitement) et la performance (résultat). Si vous ne l'intégrez pas, vous attribuerez l'effet de la motivation au programme.
La solution est plus structurelle que statistique. Dessinez votre DAG, cartographiez chaque variable pouvant influencer les deux côtés, et décidez comment les gérer avant d'entraîner le moindre modèle.
Un ATE de 5 $ ne signifie pas que chaque client a gagné 5 $. C'est une moyenne, et les moyennes masquent beaucoup. Certains ont peut-être gagné 15 $ quand d'autres ont perdu 5 $.
L'inverse est tout aussi risqué. Un CATE pour un sous-groupe ne signifie pas que tous les individus du groupe réagiront pareil. Les effets de traitement sont des estimations avec incertitude, pas des garanties. Vérifiez toujours les intervalles de confiance et évitez de cibler sur la seule base d'estimations ponctuelles.
Les chiffres sortis par EconML ou DoWhy ne valent que par les hypothèses qui les sous-tendent. Un modèle ne peut pas répondre à ces questions :
Elles exigent quelqu'un qui comprend le problème. Une forêt causale produira volontiers des estimations sur un modèle mal spécifié — sans vous dire qu'elles sont fausses.
Les meilleures analyses causales marient la capacité du ML à traiter des données complexes et l'expertise humaine pour savoir quelles variables comptent et pourquoi.
Le ML causal remplace la question « que va-t-il se passer ? » par « qu'est-ce qui l'a provoqué ? »
Ce changement transforme la prise de décision. On passe de la réaction à des motifs à la compréhension des mécanismes sous-jacents. Certains diront même que c'est la seule manière de prendre de vraies décisions basées sur les données.
Mais ces outils ne valent que par les hypothèses que vous leur fournissez. Un mauvais graphe causal ou une lecture erronée d'un effet de traitement peut mener à des conclusions qui semblent « scientifiques » et data-driven mais sont fausses. Le modèle ne vous le dira pas.
Les meilleurs résultats viennent de l'alliance entre la puissance du ML et quelqu'un qui comprend assez bien le problème pour poser les bonnes questions causales. Commencez par la connaissance métier, puis laissez le modèle faire le gros du travail. Tout simplement.
La première étape est simple, surtout avec notre cours Supervised Learning with scikit-learn. Inscrivez-vous dès aujourd'hui pour développer vos compétences en machine learning avec une bibliothèque Python incontournable.
Apprenez avec DataCamp
Cours
Cours
Cours
blog
Tutoriel
Tutoriel
Matt Crabtree
5 min
Tutoriel
Samuel Shaibu
9 min
Tutoriel
Mark Pedigo
10 min
Tutoriel
Satyabrata Pal
15 min