Cursus
Inzicht in Machine Learning
2 Hr
307.3K
Heb je weleens meegemaakt dat je machine learning-model kan voorspellen wie er gaat kopen, maar je niet kan vertellen waarom ze kochten?
Traditionele machine learning kan patronen herkennen en uitkomsten voorspellen. Het vertelt je dat een klant waarschijnlijk gaat afhaken of dat de omzet volgend kwartaal zal dalen. Maar als je vraagt of je nieuwste marketingcampagne daadwerkelijk meer verkoop heeft veroorzaakt, of dat een behandeling de patiëntuitkomsten echt heeft verbeterd, dan weet het niet wat het moet doen. Voorspelling en causaliteit zijn twee verschillende dingen.
Causale machine learning combineert machine learning met technieken uit causale inferentie. In plaats van te vragen "wat gaat er gebeuren?", vraagt het "wat gebeurt er als we ingrijpen?" - en dat is de vraag achter elke zakelijke beslissing of medische behandeling.
In dit artikel neem ik je mee door de kernconcepten achter causale ML, de methoden om oorzaak en gevolg te schatten, en hoe je ze toepast in Python.
Als je nieuw bent met machine learning, schrijf je dan in voor onze beginnersvriendelijke Machine Learning Fundamentals in Python track.
Standaard ML-modellen leren patronen uit data en gebruiken die om voorspellingen te doen. Ze zijn goed in het beantwoorden van "wat gaat er gebeuren?", maar ze kunnen je niet vertellen wat de oorzaak was.
Causale machine learning stelt een andere vraag. Het combineert ML met technieken uit causale inferentie om oorzaak-gevolgrelaties uit data te schatten. In plaats van een uitkomst te voorspellen, schat het wat er zou veranderen als je een specifieke actie onderneemt.
Die actie heet een interventie en staat voor een bewuste verandering die je doorvoert om het effect te zien. Dreef de korting écht meer aankopen, of zouden die klanten toch wel gekocht hebben? Verhoogde het nieuwe medicijn het herstel, of knapten patiënten vanzelf op?
Dit zijn vragen die voorspellingen niet kunnen beantwoorden, maar causale ML wel.
Traditionele ML leert correlaties. Het vindt dat klanten die kortingsmails ontvangen meer geneigd zijn te kopen, en gebruikt dat patroon om toekomstige aankopen te voorspellen. Maar correlatie vertelt je niet of de mail de aankoop heeft veroorzaakt. Misschien waren die klanten al van plan te kopen.
Causale ML schat het causale effect van de mail op aankopen. Het vraagt wat er zou zijn gebeurd als je hem níet had gestuurd. Het verschil tussen "deze dingen komen vaak samen voor" en "dit ding veroorzaakte dat ding" is wat traditionele en causale ML scheidt.
Zo kun je er eenvoudig over denken:
De eerste helpt je voorspellen. De tweede helpt je beslissen. Beide zijn nuttig.
De meeste zakelijke en beleidsbeslissingen zijn van nature causaal. Je vraagt niet "wat gaat er gebeuren?" - je vraagt "wat moeten we doen?"
Hier zijn een paar concrete voorbeelden:
Standaard machine learning-methoden kunnen geen van deze vragen beantwoorden, omdat ze correlatie als een feature behandelen. Twee variabelen die samen bewegen kunnen een gemeenschappelijke oorzaak delen, of de relatie kan puur toeval zijn. Causale ML dwingt je na te denken over waarom dingen verbonden zijn - en of het veranderen van de ene de andere daadwerkelijk zal veranderen.
Voordat je oorzaak en gevolg kunt schatten, moet je een paar dingen begrijpen waar elke causale analyse op leunt.
Elke causale vraag heeft twee delen: een behandeling en een uitkomst.
De behandeling is de actie of interventie die je onderzoekt. Dat kan een medicijn zijn dat aan patiënten wordt gegeven, of een korting die aan klanten wordt aangeboden. De uitkomst is wat je meet, zoals hersteltijd, aankoopratio of productiviteit.
Het doel van causale ML is te schatten hoe de behandeling de uitkomst verandert. Het schat niet of de twee gecorreleerd zijn, maar of de een de ander daadwerkelijk veroorzaakt.
Je kunt observeren wat er gebeurde nadat een patiënt het medicijn nam, maar je kunt niet observeren wat er was gebeurd als hij het niet had genomen. Dat niet-geobserveerde scenario heet een contra-feit (counterfactual).
In een andere context: een klant ontving 20% korting en deed een aankoop. Het contra-feit vraagt: zou hij ook gekocht hebben zonder de korting? Je zult het nooit zeker weten, omdat je de tijd niet kunt terugdraaien en beide versies op dezelfde persoon kunt uitvoeren.
Causale ML schat deze contra-feiten met statistische technieken en aannames. De kwaliteit van je causale schatting hangt af van hoe goed je benadert wat je niet direct kunt waarnemen.
Een confounder is een variabele die zowel de behandeling als de uitkomst beïnvloedt, en zo een valse indruk van causaliteit wekt.
Stel, je onderzoekt of beweging hartziekten vermindert. Mensen die meer bewegen, eten vaak ook gezonder. Dieet beïnvloedt zowel de kans op beweging (behandeling) als hartziekten (uitkomst). Als je dieet negeert, overschat je hoeveel alleen beweging uitmaakt.
Confounders zijn de grootste bedreiging voor causale analyses. Ze identificeren en meenemen is wat een causale schatting betrouwbaar maakt, en iets waar je tijd aan moet besteden.
Vraag je je af hoe je uitvogelt welke variabelen confounders zijn en welke niet? Dan teken je een graaf.
Een directed acyclic graph (DAG) is een diagram dat de causale relaties tussen variabelen in kaart brengt. Elke knoop stelt een variabele voor, en elke pijl wijst van oorzaak naar gevolg. "Directed" betekent dat de pijlen een richting hebben. "Acyclic" betekent dat er geen lussen zijn - een variabele kan zichzelf niet veroorzaken, direct of via een keten.
Neem het voorbeeld van beweging van eerder. Een eenvoudige DAG zou pijlen hebben van Dieet → Beweging en Dieet → Hartziekten, plus een pijl van Beweging → Hartziekten. De graaf maakt duidelijk dat Dieet een confounder is, omdat het pijlen heeft naar zowel de behandeling als de uitkomst.
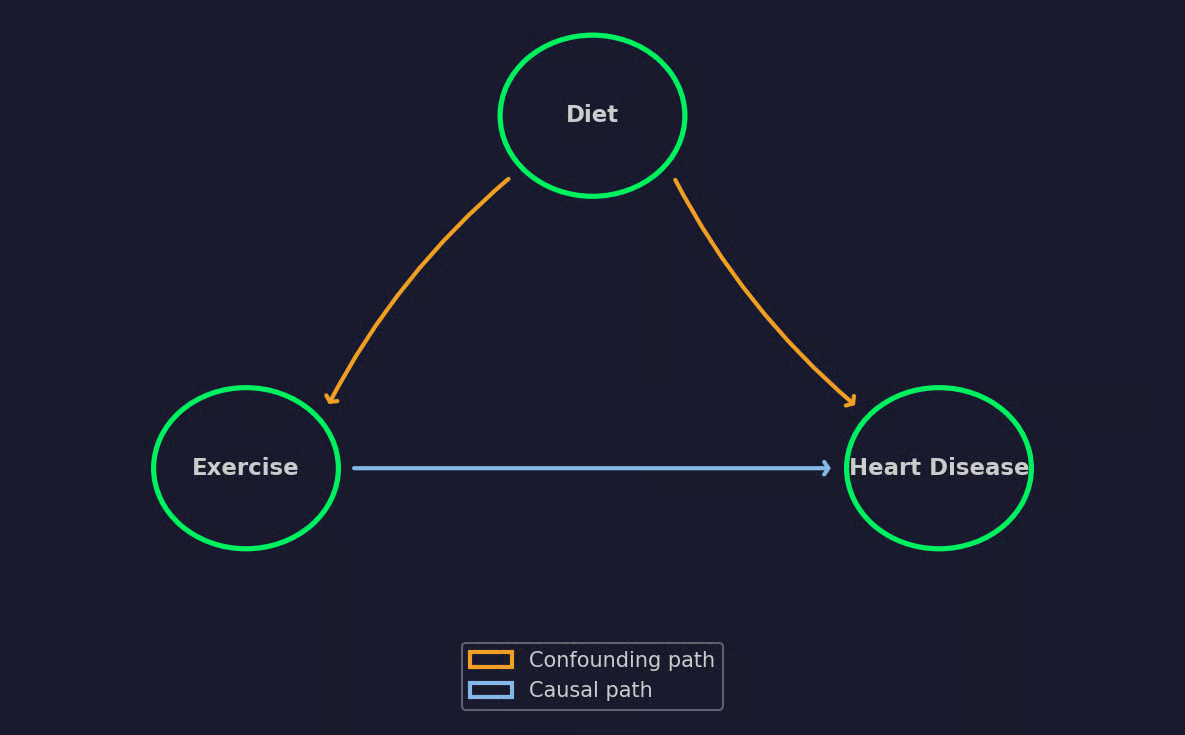
Een eenvoudig DAG-voorbeeld
DAG's vertellen je ook welke variabelen je moet controleren en welke je met rust moet laten. Als je de verkeerde variabele controleert, kun je juist bias introduceren in plaats van die te verwijderen. Zie een DAG dus als een routekaart voor je hele causale analyse.
Het mooiste?
Je hebt geen wiskunde nodig om een DAG te bouwen. Je hebt alleen domeinkennis nodig. De graaf codeert je aannames over hoe de wereld werkt, en de kwaliteit van je causale schattingen hangt af van of die aannames kloppen.
Causale ML leent veel uit statistiek en econometrie, maar schaalt deze ideeën op met machine learning. Ik neem je mee door de vier meest gebruikte aanpakken.
In een ideale wereld voer je een gerandomiseerd experiment uit om het effect van een behandeling te meten. Maar in de praktijk zijn toewijzingen zelden willekeurig. Mensen die de behandeling krijgen, verschillen vaak van degenen die dat niet doen - en die verschillen zorgen voor bias.
Propensity score-methoden pakken dit aan door de kans te schatten dat elk individu de behandeling krijgt, op basis van geobserveerde kenmerken. Die kans is de propensity score.
Als je scores hebt, zijn er twee hoofdmanieren om ze te gebruiken:
Beide methoden proberen met observationele data te simuleren hoe een gerandomiseerd experiment eruit zou hebben gezien.
Soms zitten de confounders die je moet corrigeren niet in je data. Je kunt ze niet meten, dus propensity scores helpen dan niet. Daar komen instrumentele variabelen (IV) in beeld.
Een instrument is een variabele die de behandeling beïnvloedt maar geen direct effect heeft op de uitkomst. Het beïnvloedt de uitkomst alleen via de behandeling.
Een klassiek voorbeeld is het effect van onderwijs op inkomen. Motivatie beïnvloedt zowel hoeveel onderwijs iemand krijgt als wat hij verdient - maar motivatie kun je niet direct meten. De afstand tot de dichtstbijzijnde hogeschool werkt als instrument, omdat die bepaalt of iemand naar school gaat, maar niet direct invloed heeft op het toekomstige salaris.
In de praktijk is het vinden van een goed instrument lastig. De methode is sterk als je er een hebt, maar een zwak of ongeldig instrument levert misleidende resultaten op.
Causale forests breiden het random forest-algoritme uit om behandelingseffecten te schatten in plaats van voorspellingen. Een standaard random forest voorspelt een uitkomst, terwijl een causale forest schat hoeveel de behandeling die uitkomst verandert voor verschillende subgroepen.
Dit is nuttig wanneer het behandelingseffect varieert tussen individuen. Een medicijn kan goed werken voor jongere patiënten maar niet voor oudere. Evenzo kan een korting aankopen verhogen bij prijsgevoelige klanten, maar geen effect hebben bij loyale kopers. Causale forests detecteren deze verschillen door de data te splitsen op kenmerken die de grootste variatie in behandelingseffecten opleveren.
De output is een gepersonaliseerde schatting van het behandelingseffect voor elk individu in je dataset.
Double machine learning (DML) combineert ML-modellen met statistische inferentie om het beste van twee werelden te krijgen.
Je gebruikt één ML-model om de uitkomst te voorspellen en een ander om de behandelingstoewijzing te voorspellen. Daarna kijk je naar de residuen (de delen die geen van beide modellen kon verklaren), en de relatie daartussen geeft je het causale effect.
Als je je afvraagt waarom die extra stappen nodig zijn: ML-modellen zijn geweldig in het vangen van patronen, maar introduceren bias wanneer ze voor causale schatting worden gebruikt. DML verwijdert die bias met een techniek genaamd cross-fitting, waarbij je traint en voorspelt op verschillende splits van de data om overfitting te voorkomen.
Als je een methode hebt gekozen, heb je een manier nodig om samen te vatten wat die heeft gevonden. Daar komen metrics voor behandelingseffect bij kijken.
Average Treatment Effect (ATE) meet het gemiddelde causale effect van de behandeling over je hele populatie. Als de ATE van een kortingscampagne $5 is, betekent dat dat de korting gemiddeld de besteding met $5 per klant heeft verhoogd.
ATE geeft je het grote plaatje, maar verbergt individuele variatie. Een gemiddelde van $5 kan betekenen dat iedereen $5 meer uitgaf, of dat de helft $10 meer uitgaf terwijl de andere helft geen verandering zag.
Conditional Average Treatment Effect (CATE) schat het behandelingseffect voor specifieke subgroepen op basis van hun kenmerken. In plaats van één getal voor iedereen, vertelt CATE je dat de korting de besteding met $8 verhoogde voor nieuwe klanten maar slechts met $2 voor terugkerende.
CATE maakt causale ML toepasbaar. ATE vertelt je of een interventie werkt. CATE vertelt je voor wie hij werkt - en dat is het antwoord dat je nodig hebt om datagedreven beslissingen te nemen.
Causale ML duikt op waar je moet bewegen van "wat is er gebeurd?" naar "wat moeten we doen?" Hier zijn een paar voorbeelden.
Een ziekenhuis wil weten welke behandeling het beste werkt voor een specifiek patiëntenprofiel. Standaard ML kan voorspellen wie risico loopt, maar causale ML schat of Behandeling A of Behandeling B een beter resultaat oplevert voor die specifieke patiënt. Zo kun je gepersonaliseerde behandelkeuzes maken op basis van geschatte effecten in plaats van populatiegemiddelden.
Een marketingteam draait een promotiecampagne en ziet een piek in de verkoop. De vraag is: veroorzaakte de campagne die piek, of werd die gedreven door seizoensvraag? Causale ML isoleert de echte campagnimpact door rekening te houden met confounders zoals timing, klantdemografie en eerder koopgedrag.
Overheden en instellingen moeten beoordelen of beleid het beoogde effect heeft. Verminderde een trainingstraject de werkloosheid? Verhoogde een belastingvoordeel de investeringen? Causale ML biedt een kader voor beleidsevaluatie wanneer gerandomiseerde proeven niet praktisch of zelfs mogelijk zijn.
Een productteam voegt een nieuwe feature toe en de betrokkenheid stijgt. Causale ML helpt bepalen of de feature de toename veroorzaakte of dat die samenviel met andere veranderingen - zoals een marketingpush of een uitvallende concurrent. Het daadwerkelijke effect van een feature begrijpen onderscheidt datagedreven beslissingen van een gok.
De gemene deler is dat beslissingen afhangen van weten waarom iets gebeurde, niet alleen dát het gebeurde.
Er zijn drie libraries die de meeste causale ML-use-cases in Python dekken. Ik leg uit wat elk doet en laat een typische workflow zien.
Voordat we de code induiken, hier een volledige snippet met alle imports en het maken van de dataset. Je kunt ontbrekende dependencies installeren met pip of uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
De dataset beschrijft 1000 klanten in een e-commercestore, en ik probeer het causale effect van een kortingsmail in dollars te schatten. Het ware causale effect van de korting is $5, maar zoals je in de output ziet, overschat een naïeve vergelijking het werkelijke effect omdat klanten die kortingen ontvingen al meer eerdere aankopen hadden:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")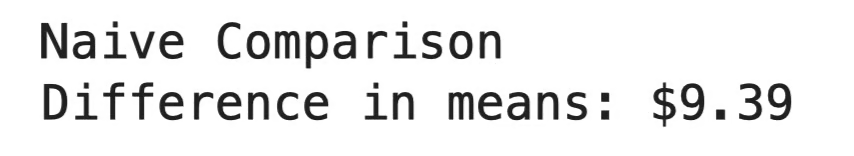
Naïeve vergelijking
DoWhy is een framework van Microsoft voor end-to-end causale inferentie. Het volgt een vierstappenproces: modelleer het probleem als een causale graaf, identificeer het causale effect, schat het, en test vervolgens of de schatting standhoudt onder verschillende aannames.
Wat DoWhy onderscheidt, is de focus op validatie. Na het produceren van een schatting voert het weerleggingstests uit die je resultaat uitdagen. Als de schatting die tests overleeft, kun je er meer op vertrouwen. Zo niet, dan weet je dat je aannames werk nodig hebben.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")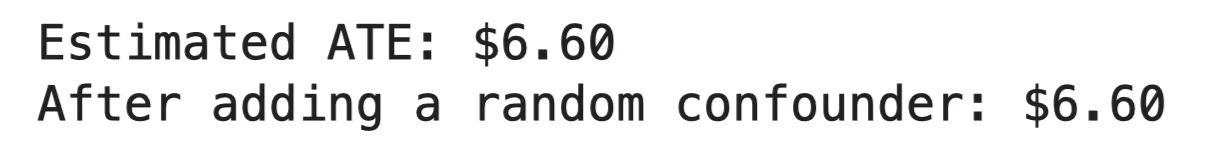
DoWhy-uitvoer
Gemiddeld verhoogde de korting het aankoopbedrag met $6,60 per klant. De weerleggingstest voegde een willekeurige variabele toe aan het model, en de schatting veranderde helemaal niet, wat betekent dat het resultaat niet wordt gedreven door schijncorrelaties. Als de schatting veel was verschoven, was dat een rode vlag geweest dat de causale aannames niet klopten.
EconML, ook van Microsoft, richt zich op heterogene behandelingseffecten. Of in gewone taal: hoe het effect varieert over verschillende subgroepen. Het implementeert methoden als Double ML en Causal Forests die ik eerder behandelde.
EconML volgt een vertrouwde scikit-learn-achtige API met .fit() en .effect()-methoden.
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")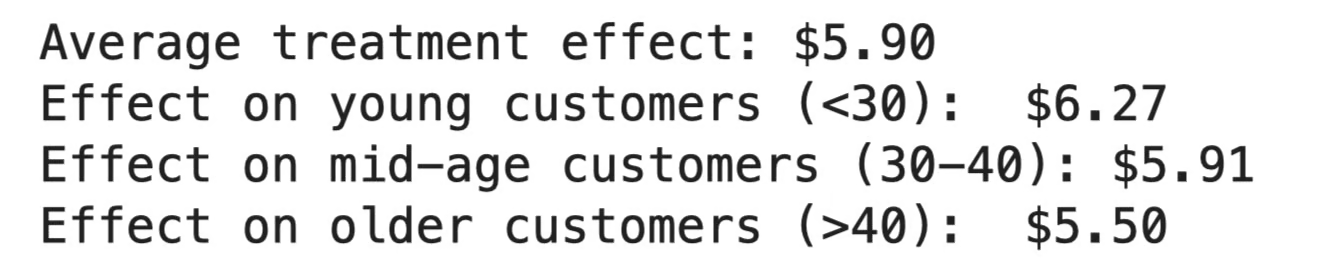
EconML-uitvoer
De korting verhoogde de aankoopbedragen gemiddeld met $5,90, maar het effect was niet uniform. Jongere klanten reageerden het meest ($6,27), terwijl oudere klanten de kleinste stijging zagen ($5,50). Als je budget beperkt is, vertelt dit je waar je de campagne het eerst op richt.
CausalML, ontwikkeld door Uber, is ontworpen voor uplift modeling - voorspellen welke individuen het meest op een behandeling reageren. Het is vooral populair in marketing, waar het doel is klanten te targeten die hun gedrag veranderen door een campagne, niet degenen die toch al zouden converteren.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())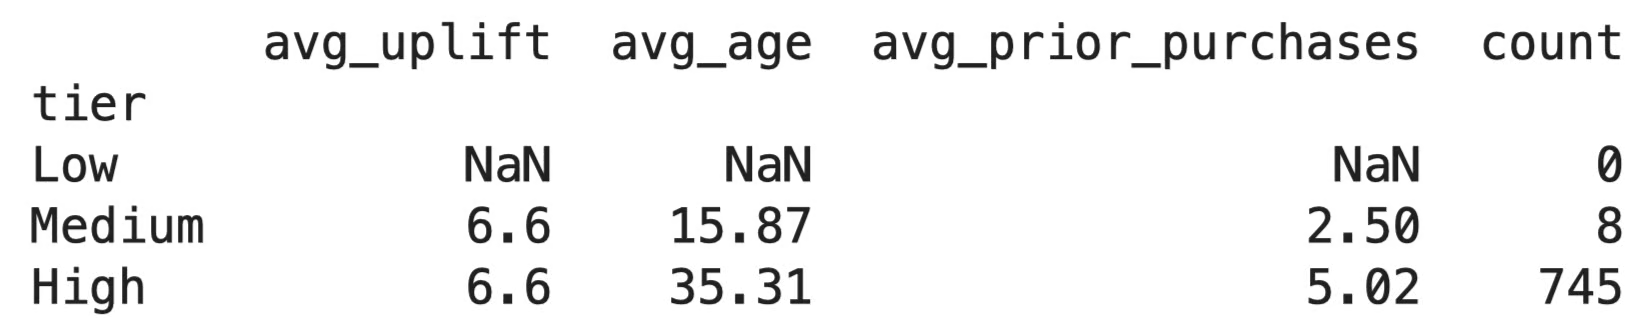
CausalML-uitvoer
De uplift-scores zijn vrijwel identiek voor alle klanten, wat betekent dat de korting ongeveer hetzelfde effect had op iedereen - zo'n $6,60 per persoon. Dat past bij onze synthetische dataset, waarin ik een vlak behandelingseffect van $5 zonder variatie per subgroep heb ingebouwd. In echte data zie je doorgaans meer spreiding, en dan zijn targetingtiers nuttig.
Elke library heeft een ideaal gebruiksscenario. Gebruik:
Alle drie werken goed samen. Een veelvoorkomend patroon is: definieer je causale graaf in DoWhy, schat effecten met EconML, en gebruik CausalML om de resultaten te interpreteren.
Causale ML wordt soms gemakkelijk verkeerd gebruikt. Dit zijn de fouten die het vaakst voor verwarring zorgen.
Deze is klassiek. Klanten die een feature meer gebruiken, geven ook meer uit, dus concludeer je dat de feature de uitgaven drijft. Maar misschien zijn grootverbruikers simpelweg overal meer betrokken. Zonder causaal kader gok je op de richting van de relatie.
Elke causale analyse begint met de vraag: is dit een patroon, of is dit een oorzaak? Als je die vraag overslaat, helpt geen hoeveelheid modelleren je verder.
Een confounder beïnvloedt zowel de behandeling als de uitkomst.
Stel dat je het effect van een trainingsprogramma op werknemersprestaties meet. Werknemers die zich aanmelden voor training zijn vaak meer gemotiveerd. Motivatie drijft zowel deelname (behandeling) als prestaties (uitkomst). Als je daar geen rekening mee houdt, schrijf je het effect van motivatie toe aan het programma.
De oplossing is structureler dan statistisch. Teken je DAG, breng elke variabele in kaart die beide kanten kan beïnvloeden, en beslis hoe je elke meeneemt voordat je één model fit.
Een ATE van $5 betekent niet dat elke klant $5 won. Het is een gemiddelde, en gemiddelden verhullen veel. Sommige klanten wonnen misschien $15 terwijl anderen $5 verloren.
Het omgekeerde is ook riskant. Een CATE-schatting voor een subgroep betekent niet dat elk individu in die groep hetzelfde reageert. Behandelingseffecten zijn schattingen met onzekerheid, geen garanties. Check altijd de betrouwbaarheidsintervallen en neem geen targetingbeslissingen op basis van alleen puntschattingen.
Het getal dat EconML of DoWhy je geeft, is slechts zo goed als de aannames erachter. Een model kan geen vragen beantwoorden als:
Daar is iemand voor nodig die het probleem begrijpt. Een causale forest produceert graag behandelingseffectschattingen uit een slecht gespecificeerd model - het vertelt je alleen niet dat ze fout zijn.
De beste causale analyses combineren het vermogen van ML om complexe data aan te kunnen met een mens die weet welke variabelen ertoe doen en waarom.
Causale ML verandert de vraag van "wat gaat er gebeuren?" naar "wat heeft het veroorzaakt?"
Die verschuiving verandert hoe je beslissingen neemt. Je gaat van reageren op patronen naar het begrijpen van de mechanismen erachter. Sommigen zouden zelfs zeggen dat het de enige manier is om écht datagedreven te beslissen.
Maar de tools werken alleen zo goed als de aannames die je ze geeft. Een verkeerde causale graaf of een misbegrepen behandelingseffect kan je leiden tot conclusies die "wetenschappelijk" en datagedreven aanvoelen maar fout zijn. Het model steekt zijn hand niet op om je te waarschuwen.
De beste resultaten komen van het combineren van het vermogen van ML om complexe data te verwerken met iemand die het probleem goed genoeg begrijpt om de juiste causale vragen te stellen. Begin met domeinkennis en laat het model vervolgens het zware werk doen. Niet meer dan dat.
Het eerste deel is eenvoudig, zeker met onze cursus Supervised Learning with scikit-learn. Schrijf je vandaag in en groei in je machine learning-skills met een onmisbare Python-library.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min