
Courses
Tìm hiểu Machine Learning
2 giờ
307.3K
Bạn đã từng gặp tình huống mô hình học máy có thể dự đoán ai sẽ mua hàng, nhưng lại không thể cho bạn biết vì sao họ mua chưa?
Học máy truyền thống có thể nhận ra mẫu hình và dự đoán kết quả. Nó sẽ cho bạn biết một khách hàng có khả năng rời bỏ hay doanh số sẽ giảm trong quý tới. Nhưng nếu bạn hỏi liệu chiến dịch marketing mới nhất thực sự gây ra tăng doanh số hay không, hoặc liệu một phương pháp điều trị có thực sự cải thiện kết quả cho bệnh nhân hay không, thì nó lại bó tay. Dự đoán và nguyên nhân là hai chuyện khác nhau.
Học máy nhân quả kết hợp học máy với các kỹ thuật suy luận nhân quả. Vì vậy, thay vì hỏi "điều gì sẽ xảy ra?", nó hỏi "điều gì xảy ra nếu chúng ta can thiệp?" - và đó chính là câu hỏi đằng sau mọi quyết định kinh doanh hay điều trị y tế.
Trong bài viết này, tôi sẽ giới thiệu các khái niệm cốt lõi của học máy nhân quả, các phương pháp dùng để ước lượng quan hệ nhân - quả, và cách áp dụng chúng bằng Python.
Nếu bạn mới bắt đầu với học máy, hãy đăng ký lộ trình Nền tảng Học máy với Python thân thiện với người mới.
Các mô hình ML tiêu chuẩn học các mẫu hình từ dữ liệu và dùng chúng để dự đoán. Chúng giỏi trả lời "điều gì sẽ xảy ra?" nhưng không thể nói cho bạn biết điều gì gây ra sự việc đó.
Học máy nhân quả đặt ra một câu hỏi khác. Nó kết hợp ML với các kỹ thuật suy luận nhân quả để ước lượng các mối quan hệ nhân - quả từ dữ liệu. Vì vậy, thay vì dự đoán một kết quả, nó ước tính điều gì sẽ thay đổi nếu bạn thực hiện một hành động cụ thể.
Hành động đó gọi là can thiệp (intervention) và thể hiện một thay đổi có chủ đích bạn thực hiện để xem tác động của nó. Mức giảm giá đó có thực sự thúc đẩy thêm lượt mua, hay những khách hàng đó vốn dĩ đã sẽ mua? Thuốc mới có cải thiện hồi phục, hay bệnh nhân tự hồi phục?
Đây là những câu hỏi mà dự đoán không thể trả lời, nhưng học máy nhân quả thì có.
ML truyền thống học các tương quan. Nó phát hiện khách hàng nhận email giảm giá có xu hướng mua nhiều hơn, và dùng mẫu hình đó để dự đoán các lượt mua trong tương lai. Nhưng tương quan không cho biết liệu email có gây ra hành vi mua hay không. Có thể những khách hàng đó vốn đã định mua.
Học máy nhân quả ước tính tác động nhân quả của email lên lượt mua. Nó hỏi điều gì sẽ xảy ra nếu bạn không gửi email. Sự khác biệt giữa "những thứ này thường xuất hiện cùng nhau" và "thứ này gây ra thứ kia" chính là ranh giới giữa ML truyền thống và ML nhân quả.
Hãy hình dung đơn giản như sau:
Câu hỏi đầu giúp bạn dự đoán. Câu hỏi sau giúp bạn ra quyết định. Cả hai đều hữu ích.
Hầu hết các quyết định kinh doanh và chính sách đều mang tính nhân quả. Bạn không hỏi "điều gì sẽ xảy ra?" - bạn hỏi "chúng ta nên làm gì?"
Dưới đây là vài ví dụ cụ thể:
Các phương pháp học máy tiêu chuẩn không thể trả lời các câu hỏi này vì chúng coi tương quan như một đặc trưng. Hai biến đồng biến có thể cùng chịu ảnh hưởng từ một nguyên nhân chung, hoặc mối quan hệ chỉ là trùng hợp. Học máy nhân quả buộc bạn phải suy nghĩ về lý do vì sao các yếu tố liên quan với nhau - và liệu thay đổi một biến có thực sự làm thay đổi biến kia hay không.
Trước khi ước lượng quan hệ nhân - quả, bạn cần hiểu vài điều mà mọi phân tích nhân quả đều dựa vào.
Mỗi câu hỏi nhân quả có hai phần: một điều trị và một kết quả.
Điều trị là hành động hoặc can thiệp bạn đang nghiên cứu. Nó có thể là loại thuốc cho bệnh nhân, hoặc mức giảm giá dành cho khách hàng. Kết quả là thứ bạn đo lường, như thời gian hồi phục, tỷ lệ mua hàng, hoặc năng suất.
Mục tiêu của học máy nhân quả là ước tính điều trị làm thay đổi kết quả như thế nào. Nó không ước lượng xem hai biến có tương quan hay không, mà là liệu một biến thực sự gây ra biến kia.
Bạn có thể quan sát điều gì xảy ra sau khi bệnh nhân dùng thuốc, nhưng bạn không thể quan sát điều gì sẽ xảy ra nếu họ không dùng. Kịch bản không quan sát được đó gọi là phản thực.
Ở miền khác, giả sử một khách hàng nhận giảm giá 20% và đã mua hàng. Phản thực đặt câu hỏi: họ có mua nếu không có giảm giá không? Bạn sẽ không bao giờ biết chắc, vì bạn không thể tua ngược thời gian và chạy cả hai phiên bản trên cùng một người.
Học máy nhân quả ước lượng các phản thực này bằng các kỹ thuật thống kê và giả định. Chất lượng ước lượng nhân quả của bạn phụ thuộc vào việc bạn tiệm cận những điều không thể quan sát trực tiếp tốt đến đâu.
Biến gây nhiễu là biến ảnh hưởng cả điều trị và kết quả, tạo ra ấn tượng sai về quan hệ nhân quả.
Ví dụ, bạn nghiên cứu liệu tập thể dục có giảm bệnh tim hay không. Người tập nhiều thường cũng ăn uống lành mạnh hơn. Chế độ ăn ảnh hưởng cả khả năng tập thể dục (điều trị) và bệnh tim (kết quả). Nếu bỏ qua chế độ ăn, bạn sẽ ước tính quá mức tầm quan trọng của riêng việc tập thể dục.
Biến gây nhiễu là mối đe dọa lớn nhất đối với phân tích nhân quả. Xác định và xử lý chúng là điều làm cho ước lượng nhân quả đáng tin cậy, và xứng đáng để bạn đầu tư thời gian.
Nếu bạn thắc mắc làm sao biết biến nào là biến gây nhiễu và biến nào không, thì câu trả lời là: hãy vẽ một đồ thị.
Một đồ thị có hướng không chu trình (DAG) là sơ đồ mô tả các quan hệ nhân quả giữa các biến. Mỗi nút đại diện một biến, và mỗi mũi tên chỉ từ nguyên nhân đến hệ quả. "Có hướng" nghĩa là mũi tên có chiều. "Không chu trình" nghĩa là không có vòng lặp - một biến không thể gây ra chính nó, trực tiếp hay qua chuỗi trung gian.
Quay lại ví dụ tập thể dục. Một DAG đơn giản sẽ có các mũi tên từ Chế độ ăn -> Tập thể dục và Chế độ ăn -> Bệnh tim, cộng với mũi tên từ Tập thể dục -> Bệnh tim. Đồ thị khiến bạn thấy rõ Chế độ ăn là biến gây nhiễu vì nó có mũi tên trỏ tới cả điều trị và kết quả.
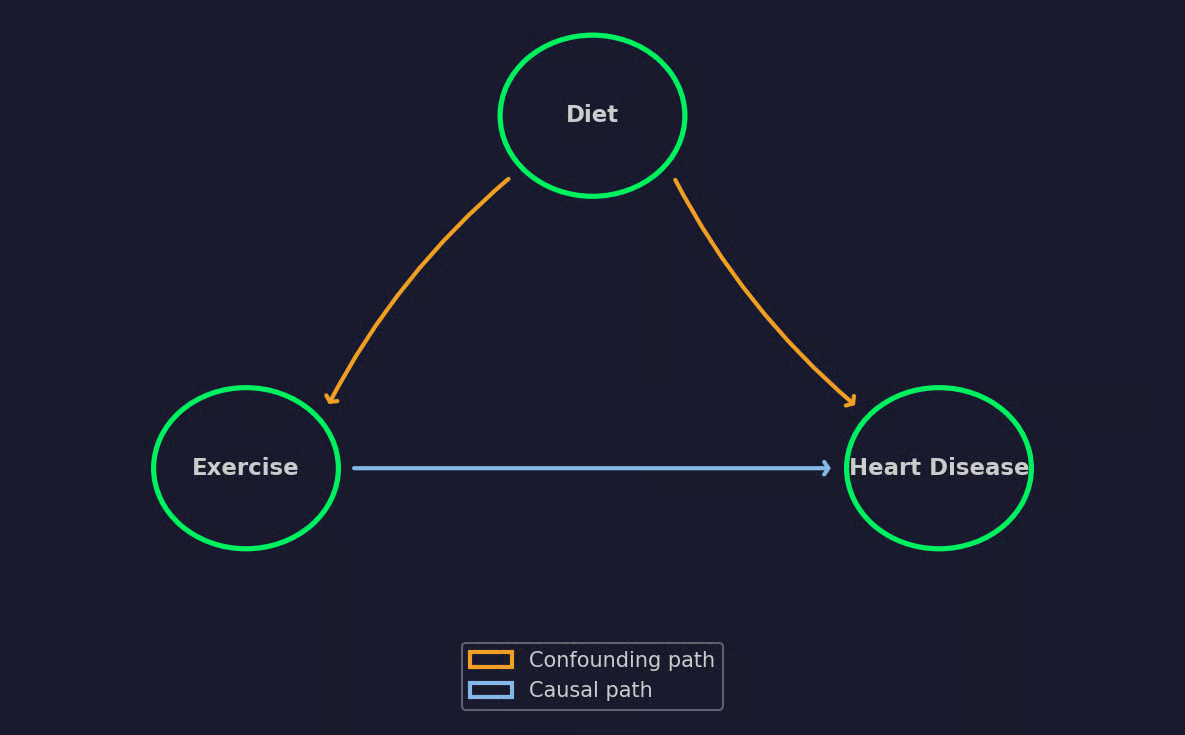
Ví dụ DAG đơn giản
DAG cũng cho bạn biết nên kiểm soát biến nào và nên để nguyên biến nào. Nếu bạn kiểm soát sai biến, bạn có thể vô tình đưa thiên lệch vào thay vì loại bỏ nó. Với điều đó trong đầu, hãy coi DAG là bản đồ lộ trình cho toàn bộ phân tích nhân quả của bạn.
Điều tuyệt nhất?
Bạn không cần toán để xây dựng DAG. Bạn chỉ cần kiến thức miền. Đồ thị mã hóa các giả định của bạn về cách thế giới vận hành, và chất lượng ước lượng nhân quả phụ thuộc vào việc các giả định đó đúng tới đâu.
Học máy nhân quả vay mượn nhiều từ thống kê và kinh tế lượng, nhưng mở rộng các ý tưởng này bằng học máy. Tôi sẽ giới thiệu bốn cách tiếp cận phổ biến nhất.
Trong một thế giới lý tưởng, bạn sẽ chạy thí nghiệm ngẫu nhiên để đo tác động của điều trị. Nhưng trên thực tế, việc gán điều trị hiếm khi ngẫu nhiên. Người nhận điều trị thường khác với người không nhận - và những khác biệt đó tạo ra thiên lệch.
Phương pháp điểm xu hướng giải quyết điều này bằng cách ước tính xác suất mỗi cá nhân nhận điều trị dựa trên các đặc điểm quan sát được của họ. Xác suất đó là điểm xu hướng.
Khi có điểm, có hai cách chính để sử dụng:
Cả hai phương pháp đều cố gắng mô phỏng một thí nghiệm ngẫu nhiên bằng dữ liệu quan sát.
Đôi khi các biến gây nhiễu bạn cần kiểm soát không có trong dữ liệu. Bạn không đo được chúng, nên điểm xu hướng không giúp ích. Đây là lúc biến công cụ (IV) phát huy tác dụng.
Một biến công cụ là biến ảnh hưởng điều trị nhưng không ảnh hưởng trực tiếp kết quả. Nó chỉ tác động đến kết quả thông qua điều trị.
Ví dụ kinh điển là nghiên cứu tác động của giáo dục lên thu nhập. Động lực ảnh hưởng cả mức học vấn và thu nhập - nhưng bạn không thể đo trực tiếp động lực. Khoảng cách tới trường cao đẳng gần nhất là một biến công cụ hợp lý vì nó ảnh hưởng khả năng theo học cao đẳng, nhưng không trực tiếp ảnh hưởng mức lương tương lai.
Trên thực tế, tìm được biến công cụ tốt là khó. Phương pháp này rất hiệu quả khi có biến công cụ phù hợp, nhưng một biến yếu hoặc không hợp lệ sẽ cho kết quả sai lệch.
Rừng nhân quả mở rộng thuật toán random forest để ước lượng tác động điều trị thay vì dự đoán. Một random forest tiêu chuẩn dự đoán kết quả, còn rừng nhân quả ước tính điều trị làm thay đổi kết quả đó bao nhiêu cho các nhóm con khác nhau.
Điều này hữu ích khi tác động điều trị khác nhau giữa các cá nhân. Một loại thuốc có thể hiệu quả với bệnh nhân trẻ nhưng không với người lớn tuổi. Tương tự, một mức giảm giá có thể tăng mua sắm với khách hàng nhạy cảm về giá nhưng không ảnh hưởng đến khách hàng trung thành. Rừng nhân quả phát hiện các khác biệt này bằng cách chia dữ liệu theo những đặc điểm tạo ra biến thiên lớn nhất trong tác động điều trị.
Kết quả là ước lượng tác động điều trị cá nhân hóa cho từng cá thể trong tập dữ liệu.
Học máy kép (DML) kết hợp các mô hình ML với suy luận thống kê để tận dụng ưu điểm của cả hai.
Bạn dùng một mô hình ML để dự đoán kết quả và một mô hình khác để dự đoán việc gán điều trị. Sau đó bạn xem phần dư (những phần mà cả hai mô hình không giải thích được), và mối quan hệ giữa chúng cho bạn tác động nhân quả.
Nếu bạn thắc mắc vì sao cần thêm bước, thì đây là câu trả lời. Mô hình ML giỏi nắm bắt mẫu hình, nhưng chúng đưa vào thiên lệch khi dùng cho ước lượng nhân quả. DML loại bỏ thiên lệch đó bằng kỹ thuật cross-fitting, trong đó bạn huấn luyện và dự đoán trên các tập chia khác nhau để tránh overfitting.
Khi đã chọn phương pháp, bạn cần cách để tóm tắt những gì tìm được. Đó là lúc các thước đo tác động điều trị xuất hiện.
Chỉ số Tác động điều trị trung bình (ATE) đo lường tác động nhân quả trung bình của điều trị trên toàn bộ quần thể. Nếu ATE của chiến dịch giảm giá là $5, nghĩa là trung bình mức giảm giá làm tăng chi tiêu thêm $5 mỗi khách hàng.
ATE cho bạn bức tranh tổng thể, nhưng ẩn đi biến thiên cá nhân. Trung bình $5 có thể nghĩa là ai cũng chi thêm $5, hoặc cũng có thể nghĩa là một nửa khách chi thêm $10 trong khi nửa còn lại không thay đổi.
Chỉ số Tác động điều trị trung bình có điều kiện (CATE) ước tính tác động điều trị cho các nhóm con cụ thể dựa trên đặc điểm của họ. Vì vậy, thay vì một con số cho tất cả, CATE cho bạn biết mức giảm giá làm tăng chi tiêu $8 với khách hàng mới nhưng chỉ $2 với khách hàng cũ.
CATE khiến học máy nhân quả mang tính hành động. ATE cho bạn biết một can thiệp có hiệu quả hay không. CATE cho bạn biết nó hiệu quả với ai - và đó là câu trả lời bạn cần để ra quyết định dựa trên dữ liệu.
Học máy nhân quả xuất hiện ở mọi nơi bạn cần chuyển từ "điều gì đã xảy ra?" sang "chúng ta nên làm gì?" Dưới đây là một vài ví dụ.
Một bệnh viện muốn biết phương pháp điều trị nào hiệu quả nhất cho một hồ sơ bệnh nhân cụ thể. ML tiêu chuẩn có thể dự đoán ai có rủi ro, nhưng ML nhân quả ước tính Liệu Điều trị A hay Điều trị B sẽ cho kết quả tốt hơn với chính bệnh nhân đó. Điều này cho phép ra quyết định điều trị cá nhân hóa dựa trên tác động ước tính thay vì trung bình quần thể.
Một đội marketing chạy chiến dịch khuyến mãi và thấy doanh số tăng vọt. Câu hỏi là, chiến dịch có gây ra sự tăng đó không, hay do nhu cầu mùa vụ? ML nhân quả tách riêng tác động thực của chiến dịch bằng cách tính đến các biến gây nhiễu như thời điểm, nhân khẩu học khách hàng và lịch sử mua trước đó.
Chính phủ và các tổ chức cần đánh giá liệu chính sách có tạo ra kết quả như kỳ vọng không. Chương trình đào tạo nghề có giảm thất nghiệp không? Ưu đãi thuế có tăng đầu tư không? ML nhân quả cung cấp khung đánh giá chính sách khi thử nghiệm ngẫu nhiên không khả thi, thậm chí không thể.
Một đội sản phẩm thêm tính năng mới và mức độ tương tác tăng. ML nhân quả giúp xác định liệu tính năng gây ra mức tăng đó hay nó trùng với thay đổi khác - như chiến dịch marketing hoặc đối thủ gặp sự cố. Hiểu tác động thực của tính năng giúp phân biệt quyết định dựa trên dữ liệu với phỏng đoán ngẫu nhiên.
Điểm chung là các quyết định phụ thuộc vào việc biết vì sao điều gì đó xảy ra, không chỉ là nó đã xảy ra.
Có ba thư viện bao phủ hầu hết các bài toán ML nhân quả trong Python. Tôi sẽ giới thiệu từng thư viện làm gì và minh họa một quy trình điển hình.
Trước khi vào mã, dưới đây là một đoạn mã đầy đủ bao gồm toàn bộ import và tạo dữ liệu. Bạn có thể cài đặt các phụ thuộc còn thiếu bằng pip hoặc uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
Tập dữ liệu định nghĩa 1000 khách hàng trong một cửa hàng thương mại điện tử, và tôi đang cố ước tính tác động nhân quả của email giảm giá tính theo đô la. Tác động nhân quả thực của mức giảm là $5, nhưng như bạn có thể thấy từ đầu ra, so sánh ngây thơ đánh giá quá cao tác động thực vì những khách hàng nhận giảm giá vốn dĩ đã có nhiều lần mua trước đó:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")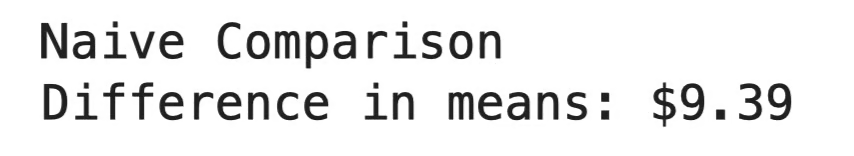
So sánh ngây thơ
DoWhy là một khung làm việc do Microsoft xây dựng cho suy luận nhân quả từ đầu đến cuối. Nó tuân theo quy trình bốn bước: mô hình hóa vấn đề dưới dạng đồ thị nhân quả, xác định tác động nhân quả, ước lượng, rồi kiểm tra xem ước lượng có đứng vững dưới các giả định khác nhau hay không.
Điểm nổi bật của DoWhy là tập trung vào thẩm định. Sau khi cho ra ước lượng, nó chạy các bài kiểm định bác bỏ để thách thức kết quả của bạn. Nếu ước lượng vượt qua các bài kiểm định, bạn có thể tin tưởng hơn. Nếu không, bạn biết các giả định của mình cần được xem lại.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")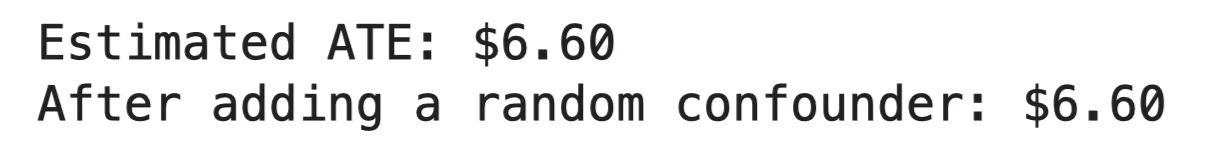
Đầu ra DoWhy
Trung bình, mức giảm giá làm tăng số tiền mua thêm $6,60 mỗi khách hàng. Bài kiểm định bác bỏ đã thêm một biến ngẫu nhiên vào mô hình, và ước lượng không hề thay đổi, nghĩa là kết quả không bị chi phối bởi tương quan ngụy. Nếu ước lượng thay đổi nhiều, đó sẽ là cờ đỏ cho thấy các giả định nhân quả đang có vấn đề.
EconML, cũng từ Microsoft, tập trung vào ước lượng tác động điều trị không đồng nhất. Nói đơn giản, là tác động thay đổi thế nào giữa các nhóm con. Nó hiện thực các phương pháp như Double ML và Causal Forest mà tôi đã đề cập trước đó.
EconML có API quen thuộc kiểu scikit-learn với các phương thức .fit() và .effect().
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")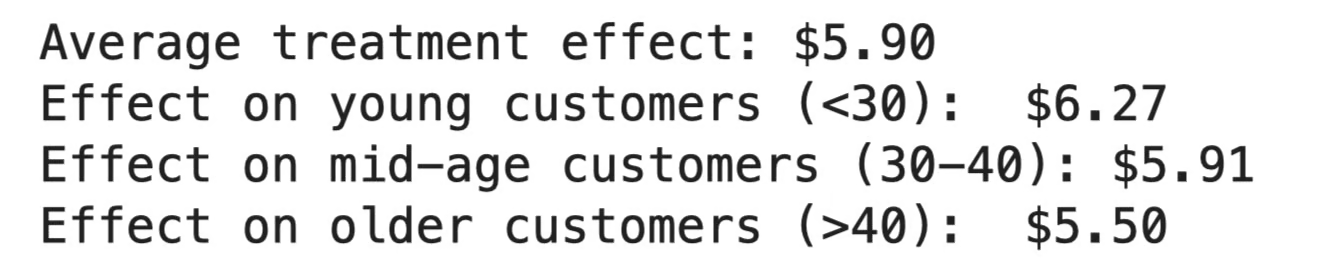
Đầu ra EconML
Mức giảm giá làm tăng số tiền mua trung bình $5,90, nhưng tác động không đồng đều. Khách hàng trẻ phản hồi nhiều nhất ($6,27), trong khi khách hàng lớn tuổi có mức tăng nhỏ nhất ($5,50). Nếu ngân sách hạn chế, điều này cho bạn biết nên ưu tiên chiến dịch vào đâu trước.
CausalML, do Uber xây dựng, được thiết kế cho mô hình uplift - dự đoán cá nhân nào sẽ phản hồi nhiều nhất với điều trị. Nó đặc biệt phổ biến trong marketing, nơi mục tiêu là nhắm đến những khách hàng sẽ thay đổi hành vi vì chiến dịch, chứ không phải những người vốn dĩ sẽ chuyển đổi.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())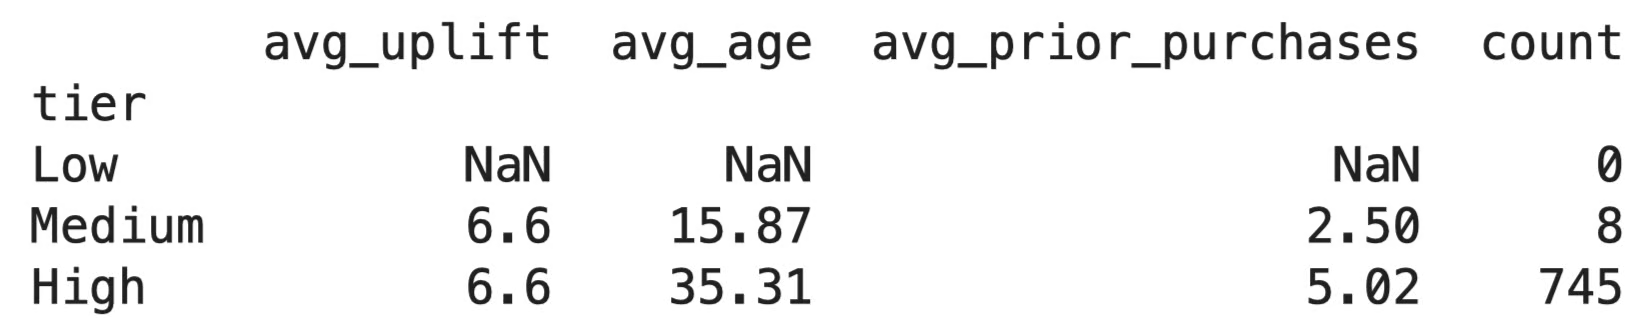
Đầu ra CausalML
Điểm uplift gần như giống nhau giữa tất cả khách hàng, nghĩa là mức giảm giá có tác động gần như tương đương lên mọi người - khoảng $6,60 mỗi người. Điều này hợp lý với tập dữ liệu tổng hợp của chúng ta, nơi tôi đã xây dựng sẵn tác động điều trị phẳng $5 không thay đổi theo nhóm. Với dữ liệu thực, bạn thường sẽ thấy phân tán lớn hơn, và đó là lúc các tầng nhắm mục tiêu phát huy tác dụng.
Mỗi thư viện có trường hợp sử dụng lý tưởng. Hãy dùng:
Cả ba phối hợp tốt với nhau. Mẫu hình phổ biến là xác định đồ thị nhân quả trong DoWhy, ước lượng tác động bằng EconML, và dùng CausalML để diễn giải kết quả.
Học máy nhân quả đôi khi rất dễ bị lạm dụng. Dưới đây là các lỗi khiến mọi người hay nhầm lẫn nhất.
Đây là kinh điển. Khách hàng dùng một tính năng nhiều hơn cũng chi tiêu nhiều hơn, nên bạn kết luận tính năng thúc đẩy chi tiêu. Nhưng có thể khách hàng chi tiêu cao vốn đã gắn bó hơn trên mọi phương diện. Không có khung nhân quả, bạn chỉ đang đoán chiều hướng của mối quan hệ.
Mọi phân tích nhân quả bắt đầu bằng câu hỏi: đây là mẫu hình, hay là nguyên nhân? Nếu bạn bỏ qua câu hỏi đó, thì mô hình phức tạp đến đâu cũng không giúp được.
Biến gây nhiễu ảnh hưởng cả điều trị và kết quả.
Giả sử bạn đo tác động của chương trình đào tạo lên hiệu suất nhân viên. Nhân viên đăng ký đào tạo thường có động lực hơn. Động lực thúc đẩy cả việc ghi danh (điều trị) và hiệu suất (kết quả). Nếu bạn không tính đến, bạn sẽ gán tác động của động lực cho chương trình đào tạo.
Cách khắc phục mang tính cấu trúc hơn là thống kê. Hãy vẽ DAG của bạn, liệt kê mọi biến có thể ảnh hưởng cả hai phía, và quyết định xử lý từng biến trước khi bạn huấn luyện bất kỳ mô hình nào.
ATE $5 không có nghĩa là mọi khách hàng đều tăng $5. Đó là trung bình, và trung bình che giấu rất nhiều điều. Một số khách có thể tăng $15 trong khi số khác giảm $5.
Chiều ngược lại cũng nguy hiểm. Ước lượng CATE cho một nhóm không có nghĩa mọi cá nhân trong nhóm đó sẽ phản hồi như nhau. Tác động điều trị là ước lượng kèm bất định, không phải đảm bảo. Luôn kiểm tra khoảng tin cậy và đừng ra quyết định nhắm mục tiêu chỉ dựa trên ước lượng điểm.
Con số mà EconML hay DoWhy đưa ra chỉ tốt khi các giả định đằng sau chúng tốt. Một mô hình không thể tự trả lời các câu hỏi như:
Chúng cần một người hiểu vấn đề. Một rừng nhân quả sẽ vui vẻ tạo ra ước lượng tác động điều trị từ một mô hình đặc tả kém - nó chỉ không nói cho bạn biết là chúng sai.
Phân tích nhân quả tốt nhất kết hợp khả năng xử lý dữ liệu phức tạp của ML với con người hiểu vấn đề đủ sâu để biết biến nào quan trọng và vì sao.
Học máy nhân quả chuyển câu hỏi từ "điều gì sẽ xảy ra?" sang "điều gì đã gây ra nó?"
Sự chuyển dịch đó thay đổi cách bạn ra quyết định. Nó khiến bạn chuyển từ phản ứng trước mẫu hình sang hiểu cơ chế đằng sau. Có người còn nói đó là cách duy nhất để thực sự ra quyết định dựa trên dữ liệu.
Nhưng công cụ chỉ hoạt động tốt khi các giả định bạn cung cấp là tốt. Một đồ thị nhân quả sai hoặc đọc sai tác động điều trị có thể dẫn bạn đến kết luận nghe có vẻ “khoa học” và dựa trên dữ liệu nhưng lại sai. Mô hình sẽ không giơ tay lên để báo cho bạn.
Kết quả tốt nhất đến từ việc kết hợp khả năng xử lý dữ liệu phức tạp của ML với người hiểu vấn đề đủ để đặt đúng câu hỏi nhân quả. Hãy bắt đầu từ kiến thức miền, rồi để mô hình làm phần nặng nhọc. Chỉ vậy thôi.
Phần đầu rất đơn giản, đặc biệt với khóa học Học có giám sát với scikit-learn của chúng tôi. Đăng ký ngay để nâng cao kỹ năng học máy với một thư viện Python phải-biết.
Học với DataCamp
Courses
Courses
Courses