Courses
Understanding Machine Learning
2 ชม.
307.3K
เคยเจอสถานการณ์ที่โมเดลแมชชีนเลิร์นนิงทำนายได้ว่าใครจะซื้อ แต่บอกไม่ได้ว่าทำไมถึงซื้อหรือไม่?
แมชชีนเลิร์นนิงแบบดั้งเดิมสามารถมองเห็นแพตเทิร์นและทำนายผลลัพธ์ได้ มันจะบอกให้ทราบว่าลูกค้ามีแนวโน้มจะยกเลิกบริการหรือยอดขายไตรมาสหน้าจะลดลง แต่ถ้าถามว่ากลยุทธ์การตลาดล่าสุดเป็นสาเหตุที่ทำให้ยอดขายเพิ่มขึ้นจริงหรือไม่ หรือการรักษาช่วยให้ผลลัพธ์ของผู้ป่วยดีขึ้นจริงหรือไม่ โมเดลก็ไม่รู้จะทำอย่างไร การทำนายกับความเป็นเหตุเป็นผลเป็นคนละเรื่องกัน
Causal machine learning ผสานแมชชีนเลิร์นนิงกับเทคนิคอนุมานเชิงสาเหตุ ดังนั้นแทนที่จะถามว่า "จะเกิดอะไรขึ้น?" มันถามว่า "จะเกิดอะไรขึ้นถ้าเข้าไปแทรกแซง?" — ซึ่งเป็นคำถามเบื้องหลังการตัดสินใจทางธุรกิจหรือการรักษาทางการแพทย์ทุกครั้ง
ในบทความนี้ จะพาไปรู้จักแนวคิดหลักของ Causal ML วิธีการประเมินความเป็นเหตุเป็นผล และการใช้งานด้วย Python
หากเป็นมือใหม่ด้านแมชชีนเลิร์นนิง ลองลงทะเบียนเรียนเส้นทาง Machine Learning Fundamentals in Python ที่เป็นมิตรกับผู้เริ่มต้น
โมเดล ML มาตรฐานเรียนรู้แพตเทิร์นจากข้อมูลและใช้เพื่อทำนายผลลัพธ์ ถนัดตอบคำถามว่า "จะเกิดอะไรขึ้น?" แต่บอกไม่ได้ว่าอะไรเป็นสาเหตุให้มันเกิดขึ้น
Causal machine learning ตั้งคำถามต่างออกไป โดยผสาน ML กับเทคนิคอนุมานเชิงสาเหตุเพื่อประมาณความสัมพันธ์เชิงเหตุและผลจากข้อมูล ดังนั้นแทนที่จะทำนายผลลัพธ์ มันจะประมาณว่าหากลงมือทำบางอย่าง ผลลัพธ์จะเปลี่ยนแปลงอย่างไร
การกระทำนั้นเรียกว่า intervention หรือการแทรกแซง ซึ่งเป็นการเปลี่ยนแปลงโดยตั้งใจเพื่อดูผลลัพธ์ ส่วนลดทำให้ยอดซื้อเพิ่มจริงหรือไม่ หรืออย่างไรลูกค้าก็จะซื้ออยู่แล้ว ยาใหม่ช่วยให้ฟื้นตัวดีขึ้นจริงหรือผู้ป่วยดีขึ้นเองตามธรรมชาติ
คำถามเหล่านี้การทำนายตอบไม่ได้ แต่ Causal ML ตอบได้
ML แบบดั้งเดิมเรียนรู้ความสัมพันธ์เชิงสหสัมพันธ์ มันพบว่าลูกค้าที่ได้รับอีเมลส่วนลดมักซื้อเพิ่ม และใช้แพตเทิร์นนั้นทำนายการซื้อในอนาคต แต่สหสัมพันธ์ไม่ได้บอกว่าอีเมลเป็นสาเหตุของการซื้อ อาจเป็นเพราะลูกค้ากลุ่มนั้นตั้งใจจะซื้ออยู่แล้วก็ได้
Causal ML ประมาณผลเชิงสาเหตุของอีเมลต่อการซื้อ โดยถามว่า ถ้าไม่ได้ส่งอีเมลจะเกิดอะไรขึ้น ความแตกต่างระหว่าง "สิ่งเหล่านี้มักเกิดร่วมกัน" กับ "สิ่งนี้เป็นสาเหตุให้สิ่งนั้นเกิด" คือสิ่งที่แยก ML แบบดั้งเดิมออกจาก Causal ML
ลองคิดแบบง่าย ๆ ว่า:
ข้อแรกช่วยให้ทำนาย ข้อที่สองช่วยให้ตัดสินใจ ทั้งสองอย่างมีประโยชน์
การตัดสินใจทางธุรกิจและนโยบายส่วนใหญ่มีธรรมชาติเป็นเชิงสาเหตุ ไม่ได้ถามว่า "จะเกิดอะไรขึ้น?" — แต่ถามว่า "ควรทำอะไร?"
ตัวอย่างที่ชัดเจนมีดังนี้:
วิธีการของแมชชีนเลิร์นนิงมาตรฐานตอบคำถามเหล่านี้ไม่ได้ เพราะมันปฏิบัติต่อสหสัมพันธ์เหมือนเป็นคุณลักษณะ ตัวแปรสองตัวที่เคลื่อนไปด้วยกันอาจมีสาเหตุร่วมกัน หรืออาจเป็นแค่เรื่องบังเอิญ Causal ML บังคับให้คิดว่าทำไมสิ่งต่าง ๆ จึงเชื่อมโยงกัน — และถ้าเปลี่ยนตัวหนึ่งแล้วอีกตัวจะเปลี่ยนจริงหรือไม่
ก่อนจะประเมินเหตุและผล ต้องเข้าใจองค์ประกอบพื้นฐานที่การวิเคราะห์เชิงสาเหตุพึ่งพา
ทุกคำถามเชิงสาเหตุมีสองส่วน: การรักษาและผลลัพธ์
การรักษาคือการกระทำหรือการแทรกแซงที่ศึกษา อาจเป็นยาที่ให้ผู้ป่วย หรือส่วนลดที่เสนอให้ลูกค้า ส่วนผลลัพธ์คือสิ่งที่วัด เช่น เวลาในการฟื้นตัว อัตราการซื้อ หรือผลิตภาพ
เป้าหมายของ Causal ML คือประมาณว่าการรักษาเปลี่ยนผลลัพธ์อย่างไร ไม่ได้ประมาณว่าเกี่ยวข้องกันหรือไม่ แต่ดูว่าอย่างหนึ่งเป็นสาเหตุให้อีกอย่างหนึ่งจริงหรือไม่
เราสังเกตสิ่งที่เกิดขึ้นหลังผู้ป่วยรับยาได้ แต่สังเกตไม่ได้ว่าสิ่งใดจะเกิดขึ้นถ้าเขาไม่ได้รับยา ฉากทัศน์ที่ไม่ได้สังเกตนั้นเรียกว่า counterfactual
ในอีกโดเมนหนึ่ง สมมติว่าลูกค้าได้รับส่วนลด 20% และตัดสินใจซื้อ Counterfactual จะถามว่า: หากไม่มีส่วนลด เขาจะยังซื้อหรือไม่? ไม่มีทางรู้แน่ชัดเพราะไม่สามารถย้อนเวลาเพื่อลองทั้งสองเวอร์ชันกับคนคนเดียวกันได้
Causal ML ประมาณ counterfactual เหล่านี้ด้วยเทคนิคทางสถิติและสมมติฐานต่าง ๆ คุณภาพของค่าประมาณเชิงสาเหตุขึ้นกับความสามารถในการประมาณสิ่งที่สังเกตโดยตรงไม่ได้
ตัวแปรก่อกวนคือชิ้นข้อมูลที่มีผลต่อทั้งการรักษาและผลลัพธ์ ซึ่งสร้างภาพลวงตาของความเป็นเหตุเป็นผล
เช่น หากกำลังศึกษาว่าการออกกำลังกายลดโรคหัวใจหรือไม่ คนที่ออกกำลังกายมากมักกินอาหารดีขึ้นด้วย อาหารการกินส่งผลทั้งต่อความน่าจะเป็นที่จะออกกำลังกาย (การรักษา) และโรคหัวใจ (ผลลัพธ์) หากมองข้ามอาหาร จะประเมินบทบาทของการออกกำลังกายสูงเกินจริง
ตัวแปรก่อกวนคือภัยคุกคามใหญ่สุดของการวิเคราะห์เชิงสาเหตุ การระบุและจัดการกับมันทำให้ค่าประมาณเชิงสาเชื่อถือได้ และคุ้มค่าที่จะทุ่มเวลาให้
ถ้าสงสัยว่าจะรู้ได้อย่างไรว่าตัวแปรใดเป็นตัวแปรก่อกวนหรือไม่ คำตอบคือ วาดกราฟ
Directed acyclic graph (DAG) คือแผนภาพที่แมปความสัมพันธ์เชิงสาเหตุระหว่างตัวแปร แต่ละโหนดแทนตัวแปรแต่ละตัว ลูกศรชี้จากสาเหตุไปยังผลลัพธ์ "Directed" หมายถึงลูกศรมีทิศทาง "Acyclic" หมายถึงไม่มีวงวน — ตัวแปรไม่สามารถเป็นสาเหตุของตัวเองได้ ทั้งทางตรงหรือผ่านลูกโซ่
ลองยกตัวอย่างการออกกำลังกายจากก่อนหน้า DAG อย่างง่ายจะมีลูกศรจาก อาหาร → ออกกำลังกาย และ อาหาร → โรคหัวใจ รวมถึงลูกศรจาก ออกกำลังกาย → โรคหัวใจ กราฟทำให้เห็นชัดว่าอาหารเป็นตัวแปรก่อกวน เพราะชี้ไปทั้งการรักษาและผลลัพธ์
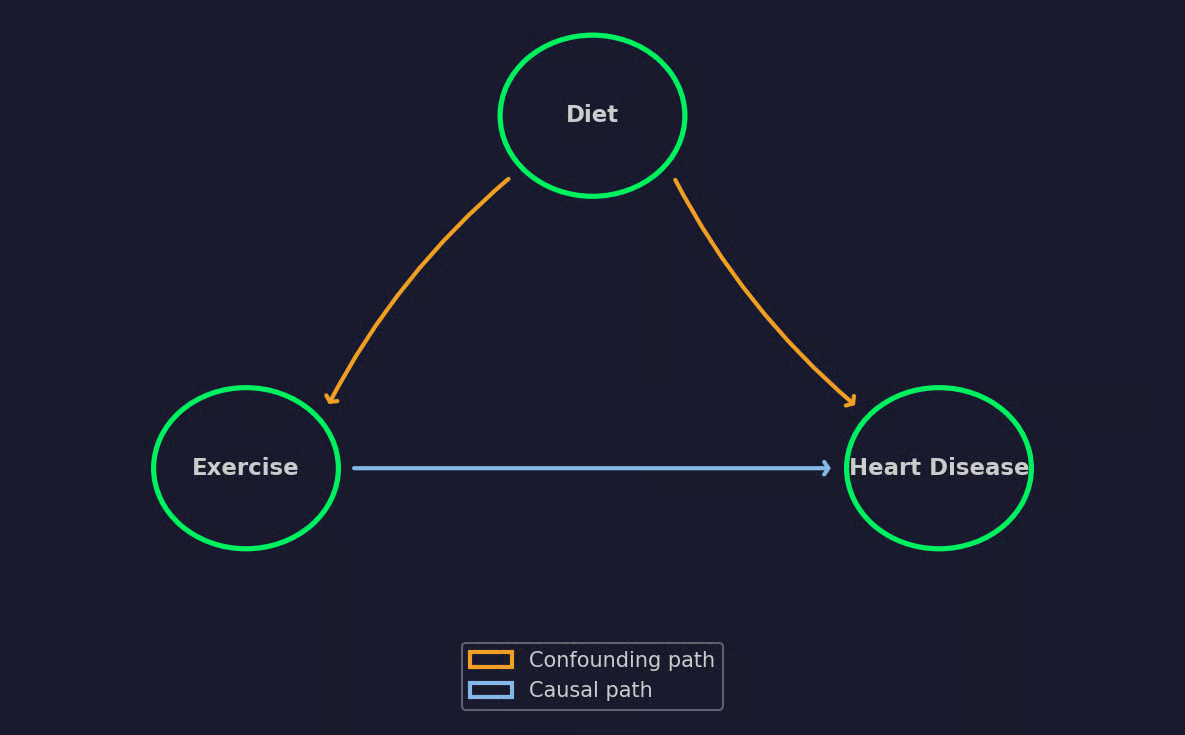
ตัวอย่าง DAG แบบง่าย
DAG ยังบอกด้วยว่าควรควบคุมตัวแปรใดและควรปล่อยตัวแปรใด หากควบคุมตัวแปรผิด อาจสร้างอคติแทนที่จะกำจัดอคติ คิดถึง DAG ว่าเป็นแผนที่นำทางของการวิเคราะห์เชิงสาเหตุทั้งหมด
ส่วนที่ดีที่สุด?
ไม่ต้องใช้คณิตศาสตร์ในการสร้าง DAG แค่ต้องใช้ความรู้เชิงโดเมน กราฟเข้ารหัสสมมติฐานเกี่ยวกับกลไกของโลก และคุณภาพของค่าประมาณเชิงสาเหตุขึ้นกับความถูกต้องของสมมติฐานเหล่านั้น
Causal ML ยืมแนวคิดจากสถิติและเศรษฐมิติ แต่ยกระดับให้ขยายสเกลได้ด้วยแมชชีนเลิร์นนิง ต่อไปนี้คือ 4 วิธีที่พบได้บ่อย
ในโลกอุดมคติ ควรทำการทดลองแบบสุ่มเพื่อวัดผลของการรักษา แต่ในทางปฏิบัติ การมอบการรักษาแทบไม่สุ่ม ผู้ที่ได้รับการรักษามักแตกต่างจากผู้ที่ไม่ได้รับ และความแตกต่างนั้นสร้างอคติ
วิธี Propensity score แก้ปัญหานี้ด้วยการประมาณความน่าจะเป็นที่แต่ละบุคคลจะได้รับการรักษา โดยอิงจากลักษณะที่สังเกตได้ของเขา ความน่าจะเป็นนั้นเรียกว่า propensity score
เมื่อได้คะแนนแล้ว มี 2 วิธีหลักในการใช้:
ทั้งสองวิธีพยายามจำลองว่าถ้าทำการทดลองแบบสุ่มจะมีหน้าตาอย่างไร โดยใช้ข้อมูลเชิงสังเกต
บางครั้งตัวแปรก่อกวนที่ต้องควบคุมไม่มีอยู่ในข้อมูล วัดไม่ได้ จึงใช้ propensity score ไม่ได้ นี่คือตอนที่ต้องใช้ตัวแปรเครื่องมือ (IV)
เครื่องมือคือชิ้นข้อมูลที่มีผลต่อการรักษา แต่ไม่มีผลโดยตรงต่อผลลัพธ์ มีอิทธิพลต่อผลลัพธ์ผ่านการรักษาเท่านั้น
ตัวอย่างคลาสสิกคือศึกษาผลของการศึกษา (education) ต่อรายได้ แรงจูงใจมีผลทั้งต่อระดับการศึกษาและรายได้ แต่แรงจูงใจวัดโดยตรงไม่ได้ ระยะทางถึงมหาวิทยาลัยที่ใกล้ที่สุดใช้เป็นเครื่องมือได้ เพราะมีผลต่อการตัดสินใจเข้าเรียน แต่ไม่กระทบเงินเดือนในอนาคตโดยตรง
ในทางปฏิบัติ การหาตัวแปรเครื่องมือที่ดีทำได้ยาก วิธีนี้ยอดเยี่ยมหากมีเครื่องมือที่เหมาะสม แต่ถ้าเครื่องมืออ่อนหรือใช้ไม่ได้ผล จะให้ผลลัพธ์ที่ทำให้เข้าใจผิด
Causal forests ขยายอัลกอริทึม random forest เพื่อประมาณผลของการรักษาแทนการทำนาย Random forest มาตรฐานทำนายผลลัพธ์ ขณะที่ causal forest ประมาณว่าการรักษาเปลี่ยนผลลัพธ์มากน้อยแค่ไหนในแต่ละกลุ่มย่อย
วิธีนี้มีประโยชน์เมื่อผลของการรักษาแตกต่างกันไปในแต่ละบุคคล ยาอาจได้ผลดีกับคนอายุน้อยกว่าแต่ไม่ค่อยได้ผลกับคนอายุมาก ส่วนลดอาจเพิ่มการซื้อให้ลูกค้าที่อ่อนไหวต่อราคาแต่ไม่กระทบผู้ซื้อต่อเนื่อง Causal forests ตรวจจับความต่างเหล่านี้ด้วยการแยกข้อมูลตามลักษณะที่ทำให้ความแปรปรวนของผลการรักษามากที่สุด
ผลลัพธ์คือค่าประมาณผลการรักษาแบบเฉพาะบุคคลสำหรับแต่ละรายการในชุดข้อมูล
Double machine learning (DML) ผสมผสานโมเดล ML กับอนุมานทางสถิติ เพื่อให้ได้ข้อดีของทั้งสองโลก
ใช้โมเดล ML หนึ่งตัวทำนายผลลัพธ์ และอีกตัวทำนายการมอบการรักษา จากนั้นดูที่เศษเหลือ (residuals) หรือส่วนที่ทั้งสองโมเดลอธิบายไม่ได้ ความสัมพันธ์ระหว่างเศษเหลือให้ค่าผลเชิงสาเหตุ
หากสงสัยว่าทำไมต้องมีขั้นตอนเพิ่ม คำตอบคือ โมเดล ML เก่งในการจับแพตเทิร์น แต่เมื่อใช้ประเมินเชิงสาเหตุอาจก่ออคติ DML กำจัดอคตินั้นด้วยเทคนิคที่เรียกว่า cross-fitting ซึ่งฝึกและทำนายบนสปลิตข้อมูลที่ต่างกันเพื่อหลีกเลี่ยงการฟิตมากเกินไป
เมื่อเลือกวิธีแล้ว ต้องมีวิธีสรุปสิ่งที่ค้นพบ ซึ่งมาตรวัดผลของการรักษาจะช่วยได้
ค่า Average Treatment Effect (ATE) วัดผลเชิงสาเหตุโดยเฉลี่ยของการรักษาทั่วทั้งประชากร หาก ATE ของแคมเปญส่วนลดเท่ากับ $5 หมายความว่าโดยเฉลี่ย ส่วนลดทำให้การใช้จ่ายเพิ่มขึ้น $5 ต่อราย
ATE ให้ภาพรวม แต่ซ่อนความแตกต่างรายบุคคล ค่าเฉลี่ย $5 อาจหมายถึงทุกคนใช้เพิ่ม $5 หรืออาจหมายถึงครึ่งหนึ่งใช้เพิ่ม $10 ขณะที่อีกครึ่งไม่เปลี่ยนแปลง
ค่า Conditional Average Treatment Effect (CATE) ประมาณผลของการรักษาสำหรับกลุ่มย่อยเฉพาะตามคุณลักษณะของพวกเขา ดังนั้นแทนที่จะมีตัวเลขเดียวสำหรับทุกคน CATE จะบอกว่า ส่วนลดเพิ่มการใช้จ่าย $8 สำหรับลูกค้าใหม่ แต่เพียง $2 สำหรับลูกค้าเดิม
CATE ทำให้ Causal ML นำไปใช้ได้จริง ATE บอกว่าการแทรกแซงใช้ได้ผลหรือไม่ CATE บอกว่าได้ผลกับใคร — ซึ่งเป็นคำตอบที่จำเป็นสำหรับการตัดสินใจบนฐานข้อมูล
Causal ML พบได้ทุกที่ที่ต้องขยับจาก "เกิดอะไรขึ้น?" ไปสู่ "ควรทำอะไร?" ต่อไปนี้คือตัวอย่างบางส่วน
โรงพยาบาลต้องการรู้ว่าการรักษาแบบใดได้ผลดีที่สุดสำหรับโปรไฟล์ผู้ป่วยเฉพาะ ML มาตรฐานทำนายได้ว่าใครเสี่ยง แต่ Causal ML ประมาณได้ว่า Treatment A หรือ Treatment B จะให้ผลลัพธ์ที่ดีกว่าสำหรับผู้ป่วยคนนั้น โดยอิงการตัดสินใจการรักษาแบบเฉพาะบุคคลจากค่าประมาณผล ไม่ใช่ค่าเฉลี่ยทั้งประชากร
ทีมการตลาดรันแคมเปญโปรโมชันแล้วเห็นยอดขายพุ่ง คำถามคือ แคมเปญเป็นสาเหตุของยอดพุ่งหรือเกิดจากความต้องการตามฤดูกาล? Causal ML แยกผลกระทบจริงของแคมเปญ โดยคำนึงถึงตัวแปรก่อกวน เช่น ช่วงเวลา ประชากรลูกค้า และพฤติกรรมการซื้อที่ผ่านมา
รัฐบาลและสถาบันต่าง ๆ ต้องประเมินว่านโยบายให้ผลตามที่ตั้งใจหรือไม่ โครงการฝึกอบรมงานช่วยลดการว่างงานหรือไม่? มาตรการลดภาษีกระตุ้นการลงทุนหรือไม่? Causal ML ให้กรอบการประเมินนโยบายเมื่อการทดลองแบบสุ่มไม่สะดวกหรือเป็นไปไม่ได้
ทีมผลิตภัณฑ์เพิ่มฟีเจอร์ใหม่แล้วอัตรามีส่วนร่วมเพิ่มขึ้น Causal ML ช่วยระบุว่าฟีเจอร์เป็นสาเหตุของการเพิ่มขึ้น หรือบังเอิญเกิดพร้อมปัจจัยอื่น เช่น แรงผลักดันจากการตลาดหรือคู่แข่งล่ม การเข้าใจผลกระทบจริงของฟีเจอร์ทำให้การตัดสินใจบนข้อมูลแตกต่างจากการเดา
จุดร่วมคือ การตัดสินใจขึ้นอยู่กับการรู้ว่า “ทำไม” บางสิ่งจึงเกิดขึ้น ไม่ใช่แค่ “มันเกิดขึ้น”
มีไลบรารี 3 ตัวที่ครอบคลุมกรณีใช้งาน Causal ML ส่วนใหญ่ใน Python ต่อไปนี้คือหน้าที่ของแต่ละตัวและเวิร์กโฟลว์ตัวอย่าง
ก่อนลงมือโค้ด นี่คือสแนิปเพตที่ครอบคลุมการนำเข้าและการสร้างชุดข้อมูลทั้งหมด สามารถติดตั้งไลบรารีที่ขาดด้วย pip หรือ uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
ชุดข้อมูลนี้กำหนดลูกค้าอีคอมเมิร์ซ 1000 ราย และพยายามประมาณผลเชิงสาเหตุของอีเมลส่วนลดในหน่วยดอลลาร์ ผลเชิงสาเหตุที่แท้จริงของส่วนลดคือ $5 แต่จากเอาต์พุตจะเห็นว่าการเปรียบเทียบแบบไร้เดียงสาประเมินค่าสูงเกินจริง เพราะลูกค้าที่ได้รับส่วนลดมีการซื้อสะสมมากกว่าอยู่แล้ว:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")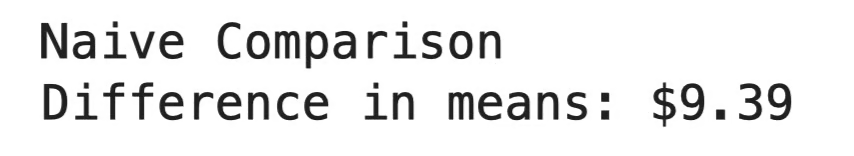
การเปรียบเทียบแบบไร้เดียงสา
DoWhy เป็นเฟรมเวิร์กจาก Microsoft สำหรับงานอนุมานเชิงสาเหตุแบบครบวงจร ทำตามกระบวนการ 4 ขั้น: จำลองปัญหาเป็นกราฟเชิงสาเหตุ ระบุผลเชิงสาเหตุ ประมาณค่า และทดสอบว่าค่าประมาณทนต่อสมมติฐานที่ต่างกันหรือไม่
สิ่งที่ทำให้ DoWhy โดดเด่นคือการเน้นการตรวจสอบความถูกต้อง หลังคำนวณค่าประมาณแล้วจะรันการทดสอบ refutation เพื่อท้าทายผลลัพธ์ หากค่าประมาณรอดการทดสอบ ความน่าเชื่อถือจะสูงขึ้น หากไม่รอด แสดงว่าสมมติฐานต้องปรับปรุง
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")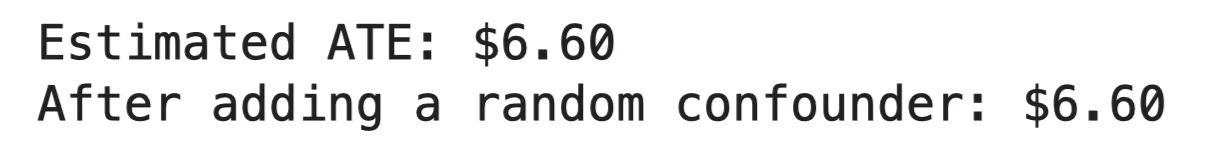
ผลลัพธ์ DoWhy
โดยเฉลี่ย ส่วนลดทำให้ยอดซื้อเพิ่มขึ้น $6.60 ต่อราย การทดสอบ refutation เพิ่มตัวแปรสุ่มเข้าไปในโมเดล และค่าประมาณไม่เปลี่ยนเลย หมายความว่าผลลัพธ์ไม่ได้เกิดจากสหสัมพันธ์ลวง หากค่าประมาณเปลี่ยนมาก จะเป็นสัญญาณเตือนว่าสมมติฐานเชิงสาเหตุคลาดเคลื่อน
EconML จาก Microsoft เช่นกัน โฟกัสที่การประมาณผลการรักษาแบบไม่สม่ำเสมอระหว่างกลุ่ม (heterogeneous treatment effects) หรือพูดง่าย ๆ คือผลที่แตกต่างกันในกลุ่มย่อยต่าง ๆ มีวิธีอย่าง Double ML และ Causal Forests ตามที่กล่าวไป
EconML มี API สไตล์ scikit-learn ที่คุ้นเคยด้วยเมธอด .fit() และ .effect().
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")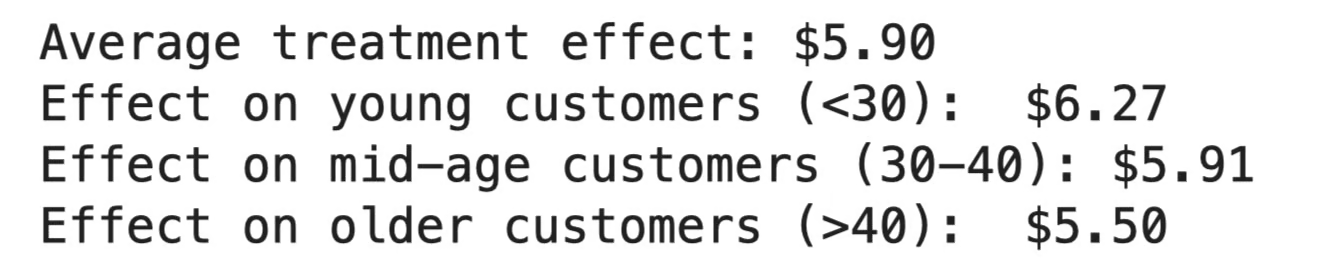
ผลลัพธ์ EconML
ส่วนลดเพิ่มยอดซื้อเฉลี่ย $5.90 แต่ผลไม่ได้เท่ากันทุกคน กลุ่มอายุน้อยตอบสนองมากที่สุด ($6.27) ขณะที่กลุ่มอายุมากเพิ่มน้อยสุด ($5.50) หากงบจำกัด นี่บอกว่าควรเจาะไปที่กลุ่มไหนก่อน
CausalML จาก Uber ออกแบบมาสำหรับ uplift modeling — การทำนายว่าใครจะตอบสนองต่อการรักษามากที่สุด นิยมมากในงานการตลาด ซึ่งเป้าหมายคือเข้าถึงลูกค้าที่จะเปลี่ยนพฤติกรรมเพราะแคมเปญ ไม่ใช่ผู้ที่อย่างไรก็ซื้ออยู่แล้ว
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())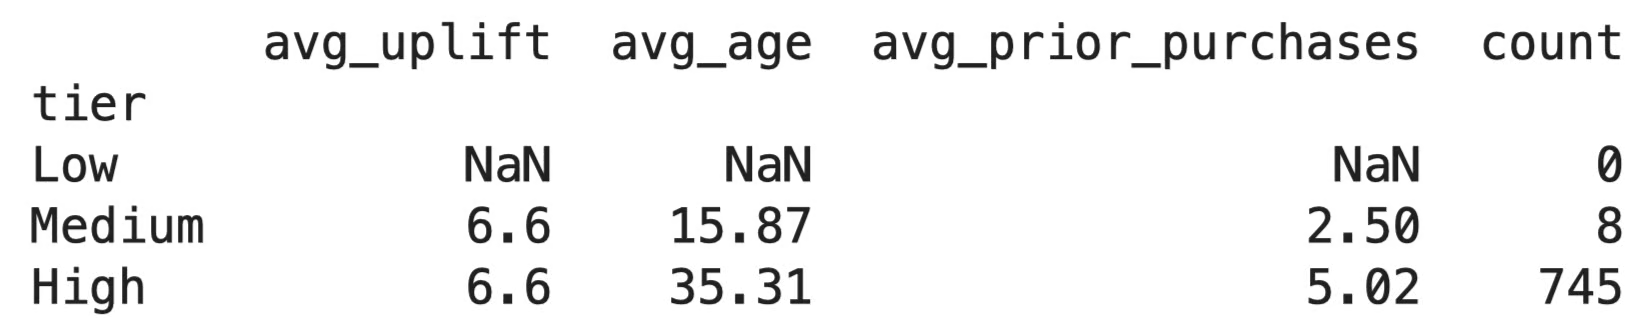
ผลลัพธ์ CausalML
คะแนน uplift แทบจะเท่ากันทุกคน หมายความว่าส่วนลดมีผลใกล้เคียงกัน — ราว $6.60 ต่อคน ซึ่งสอดคล้องกับชุดข้อมูลสังเคราะห์ที่สร้างผลการรักษาคงที่ $5 โดยไม่มีความแปรผันตามกลุ่มย่อย ในข้อมูลจริงมักเห็นการกระจายมากกว่า และนั่นคือจุดที่การแบ่งชั้นเป้าหมายมีประโยชน์
แต่ละไลบรารีมีกรณีใช้งานที่เหมาะ Use:
ทั้งสามทำงานร่วมกันได้ดี ลวดลายที่พบบ่อยคือกำหนดกราฟเชิงสาเหตุใน DoWhy ประมาณผลด้วย EconML และใช้ CausalML เพื่อแปลความหมายผลลัพธ์
Causal ML บางครั้งถูกใช้งานผิดพลาดได้ง่าย ต่อไปนี้คือข้อผิดพลาดที่ทำให้สับสนบ่อยที่สุด
ข้อนี้คลาสสิก ลูกค้าที่ใช้ฟีเจอร์มากกว่ามักใช้จ่ายมากกว่า แล้วสรุปว่าฟีเจอร์ขับเคลื่อนการใช้จ่าย แต่บางทีลูกค้าที่ใช้จ่ายสูงอาจมีส่วนร่วมสูงในทุกมิติ หากไม่มีกรอบเชิงสาเหตุ ก็เดาเอาทิศทางความสัมพันธ์เท่านั้น
การวิเคราะห์เชิงสาเหตุทุกครั้งเริ่มจากคำถามว่า นี่เป็นแค่แพตเทิร์น หรือเป็นสาเหตุ? หากข้ามคำถามนี้ ไม่ว่าจะแบบจำลองอะไร ก็ช่วยไม่ได้
ตัวแปรก่อกวนมีผลทั้งต่อการรักษาและผลลัพธ์
เช่น วัดผลของโปรแกรมอบรมต่อประสิทธิภาพการทำงาน พนักงานที่สมัครเข้าอบรมมักมีแรงจูงใจสูง แรงจูงใจผลักทั้งการลงทะเบียน (การรักษา) และประสิทธิภาพ (ผลลัพธ์) หากไม่คำนึงถึงมัน จะโยนผลของแรงจูงใจให้โปรแกรมอบรม
ทางแก้เป็นเรื่องโครงสร้างมากกว่าสถิติ วาด DAG ระบุทุกตัวแปรที่อาจมีผลทั้งสองด้าน และตัดสินใจว่าจะจัดการอย่างไรก่อนฝึกโมเดลตัวแรก
ATE $5 ไม่ได้หมายความว่าลูกค้าทุกคนได้เพิ่ม $5 มันคือค่าเฉลี่ย ซึ่งซ่อนรายละเอียดไว้มาก บางคนอาจได้เพิ่ม $15 ขณะที่บางคนอาจลดลง $5
ในทางกลับกันก็อันตรายเช่นกัน ค่าประมาณ CATE สำหรับกลุ่มย่อยไม่ได้หมายความว่าทุกคนในกลุ่มจะตอบสนองแบบเดียวกัน ผลการรักษาเป็นค่าประมาณที่มีความไม่แน่นอน ไม่ใช่การรับประกัน ควรตรวจช่วงความเชื่อมั่นเสมอ และอย่าตัดสินใจเจาะเป้าหมายจากค่า point estimate เพียงอย่างเดียว
ตัวเลขที่ EconML หรือ DoWhy ให้มาดีเท่ากับสมมติฐานที่อยู่เบื้องหลังเท่านั้น โมเดลไม่สามารถตอบคำถามอย่างเช่น:
คำถามเหล่านี้ต้องการคนที่เข้าใจปัญหา Causal forest สามารถให้ค่าประมาณผลการรักษาจากโมเดลที่กำหนดผิดได้อย่างราบรื่น — เพียงแต่จะไม่บอกว่านั่นผิด
การวิเคราะห์เชิงสาเหตุที่ดีที่สุด ผสานความสามารถของ ML ในการจัดการข้อมูลซับซ้อนเข้ากับมนุษย์ที่รู้ว่าตัวแปรใดสำคัญและเพราะอะไร
Causal ML เปลี่ยนคำถามจาก "จะเกิดอะไรขึ้น?" เป็น "อะไรเป็นสาเหตุให้มันเกิดขึ้น?"
การเปลี่ยนนี้เปลี่ยนวิธีตัดสินใจ จากการตอบสนองต่อแพตเทิร์น ไปสู่การเข้าใจกลไกเบื้องหลัง บางคนถึงกับบอกว่านี่คือหนทางเดียวที่จะตัดสินใจบนฐานข้อมูลอย่างแท้จริง
แต่วิธีการจะดีเท่ากับสมมติฐานที่ป้อนให้เท่านั้น กราฟเชิงสาเหตุที่ผิดหรือการอ่านค่าผลการรักษาที่คลาดเคลื่อน อาจพาไปสู่ข้อสรุปที่ดู “เป็นวิทยาศาสตร์” และขับเคลื่อนด้วยข้อมูล แต่ผิด โมเดลจะไม่ยกมือเตือน
ผลลัพธ์ที่ดีที่สุดมาจากการผสานความสามารถของ ML กับคนที่เข้าใจปัญหาดีพอจะตั้งคำถามเชิงสาเหตุที่ถูกต้อง เริ่มจากความรู้เชิงโดเมน แล้วปล่อยให้โมเดลทำงานหนัก ที่เหลือก็เท่านี้
ส่วนแรกทำได้ง่าย โดยเฉพาะกับคอร์ส Supervised Learning with scikit-learn สมัครเรียนวันนี้เพื่อพัฒนาทักษะแมชชีนเลิร์นนิงด้วยไลบรารี Python ที่ต้องรู้
เรียนรู้กับ DataCamp
Courses
Courses
Courses