Kurs
Machine Learning verstehen
2 Std.
307.3K
Warst du schon mal in der Situation, dass dein Machine-Learning-Modell vorhersagen kann, wer kauft – dir aber nicht sagen kann, warum gekauft wurde?
Klassisches Machine Learning erkennt Muster und sagt Ergebnisse voraus. Es sagt dir, dass ein Kunde wahrscheinlich abspringt oder dass die Umsätze im nächsten Quartal sinken. Fragst du aber, ob deine letzte Marketingkampagne tatsächlich mehr Verkäufe verursacht hat oder ob eine Behandlung die Patientenergebnisse wirklich verbessert hat, weiß es nicht weiter. Vorhersage und Kausalität sind zwei verschiedene Dinge.
Kausales Machine Learning verbindet ML mit Methoden der Kausalinferenz. Statt zu fragen "Was wird passieren?" fragt es: "Was passiert, wenn wir eingreifen?" – und genau das ist die Frage hinter jeder geschäftlichen Entscheidung oder medizinischen Behandlung.
In diesem Artikel führe ich dich durch die Kernkonzepte des kausalen ML, die Methoden zur Schätzung von Ursache-Wirkungs-Beziehungen und zeige dir, wie du sie in Python anwendest.
Wenn du neu im Machine Learning bist, melde dich für unseren einsteigerfreundlichen Machine Learning Fundamentals in Python-Lernpfad an.
Standard-ML-Modelle lernen Muster aus Daten und nutzen sie für Vorhersagen. Sie beantworten gut die Frage "Was wird passieren?", aber sie sagen dir nicht, was es verursacht hat.
Kausales Machine Learning stellt eine andere Frage. Es kombiniert ML mit Kausalinferenz, um Ursache-Wirkung aus Daten zu schätzen. Statt ein Ergebnis vorherzusagen, schätzt es, was sich ändern würde, wenn du eine bestimmte Maßnahme ergreifst.
Diese Maßnahme heißt Intervention und steht für eine gezielte Änderung, deren Effekt du messen willst. Hat der Rabatt tatsächlich mehr Käufe ausgelöst, oder hätten diese Kundinnen und Kunden ohnehin gekauft? Hat das neue Medikament die Genesung verbessert, oder wurden die Patientinnen und Patienten von selbst gesund?
Das sind Fragen, die Vorhersagen nicht beantworten – kausales ML aber schon.
Klassisches ML lernt Korrelationen. Es findet heraus, dass Kundinnen und Kunden, die Rabatt-E-Mails erhalten, tendenziell mehr kaufen, und nutzt dieses Muster, um künftige Käufe vorherzusagen. Aber Korrelation sagt nicht, ob die E-Mail den Kauf verursacht hat. Vielleicht wollten diese Kundinnen und Kunden ohnehin kaufen.
Kausales ML schätzt den kausalen Effekt der E-Mail auf Käufe. Es fragt, was passiert wäre, wenn du sie nicht gesendet hättest. Der Unterschied zwischen "Diese Dinge treten oft gemeinsam auf" und "Das eine verursacht das andere" trennt klassisches von kausalem ML.
Hier ist eine einfache Merkhilfe:
Das erste hilft dir zu prognostizieren. Das zweite hilft dir zu entscheiden. Beides ist wertvoll.
Die meisten Unternehmens- und Politikentscheidungen sind von Natur aus kausal. Du fragst nicht "Was wird passieren?" – du fragst "Was sollen wir tun?"
Hier sind ein paar konkrete Beispiele:
Standard-ML-Methoden können keine dieser Fragen beantworten, weil sie Korrelation als Feature behandeln. Zwei Variablen, die sich gemeinsam bewegen, können eine gemeinsame Ursache haben oder es ist reiner Zufall. Kausales ML zwingt dich zu überlegen, warum Dinge zusammenhängen – und ob die Änderung des einen tatsächlich das andere verändert.
Bevor du Ursache und Wirkung schätzen kannst, brauchst du ein Verständnis für ein paar Grundlagen, auf denen jede Kausalanalyse aufbaut.
Jede kausale Fragestellung hat zwei Teile: eine Behandlung und ein Ergebnis.
Die Behandlung ist die Aktion oder Intervention, die du untersuchst. Das kann ein Medikament für Patientinnen und Patienten sein oder ein Rabatt für Kundschaft. Das Ergebnis ist, was du misst – zum Beispiel Genesungszeit, Kaufquote oder Produktivität.
Ziel des kausalen ML ist es, zu schätzen, wie die Behandlung das Ergebnis verändert. Es schätzt nicht, ob beide korrelieren, sondern ob das eine das andere tatsächlich verursacht.
Du kannst beobachten, was passiert ist, nachdem eine Patientin ein Medikament genommen hat, aber nicht, was passiert wäre, wenn sie es nicht genommen hätte. Dieses unbeobachtete Szenario heißt kontrafaktisch.
In einem anderen Kontext: Ein Kunde erhielt 20 % Rabatt und kaufte. Das Kontrafaktische fragt: Hätte er ohne Rabatt gekauft? Du wirst es nie sicher wissen, weil du die Zeit nicht zurückdrehen und beide Versionen an derselben Person testen kannst.
Kausales ML schätzt diese Kontrafaktischen mithilfe statistischer Techniken und Annahmen. Die Qualität deiner Schätzung hängt davon ab, wie gut du das Unbeobachtbare annäherst.
Ein Störfaktor ist eine Variable, die sowohl die Behandlung als auch das Ergebnis beeinflusst – und so fälschlich Kausalität suggeriert.
Untersuchst du etwa, ob Sport Herzkrankheiten reduziert: Menschen, die mehr Sport treiben, ernähren sich oft auch gesünder. Die Ernährung beeinflusst sowohl die Wahrscheinlichkeit, Sport zu treiben (Behandlung), als auch Herzkrankheiten (Ergebnis). Ignorierst du die Ernährung, überschätzt du die Bedeutung von Sport allein.
Störfaktoren sind die größte Gefahr für Kausalanalysen. Sie zu identifizieren und zu berücksichtigen macht eine Schätzung verlässlich – und ist die Zeit wert.
Fragst du dich, wie man herausfindet, welche Variablen Störfaktoren sind und welche nicht? Du zeichnest einen Graphen.
Ein gerichteter azyklischer Graph (DAG) ist ein Diagramm, das kausale Beziehungen zwischen Variablen abbildet. Jeder Knoten steht für eine Variable, jeder Pfeil zeigt von der Ursache auf die Wirkung. "Gerichtet" heißt: Die Pfeile haben eine Richtung. "Azyklisch" heißt: Es gibt keine Schleifen – eine Variable kann sich nicht selbst verursachen, weder direkt noch über eine Kette.
Nimm das Sport-Beispiel. Ein einfacher DAG hätte Pfeile von Ernährung → Sport und Ernährung → Herzkrankheit sowie einen Pfeil von Sport → Herzkrankheit. Der Graph macht sofort klar: Ernährung ist ein Störfaktor, weil sie sowohl auf die Behandlung als auch auf das Ergebnis zeigt.
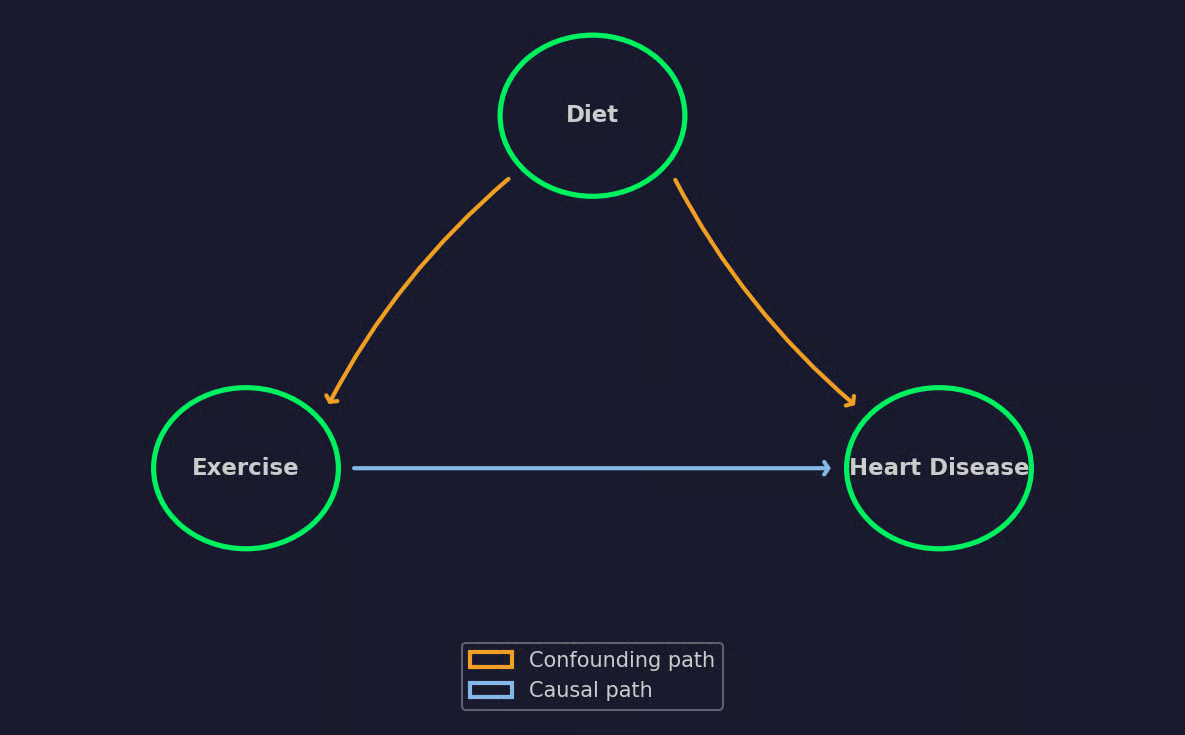
Ein einfaches DAG-Beispiel
DAGs zeigen dir auch, welche Variablen du kontrollieren solltest und welche du in Ruhe lässt. Kontrollierst du die falsche Variable, führst du Bias ein statt ihn zu entfernen. Denk den DAG deshalb als Lernplan für deine gesamte Kausalanalyse.
Das Beste daran?
Du brauchst keine Mathematik, um einen DAG zu bauen. Du brauchst Domänenwissen. Der Graph kodiert deine Annahmen darüber, wie die Welt funktioniert – und die Qualität deiner Schätzungen hängt davon ab, ob diese Annahmen stimmen.
Kausales ML leiht sich viel aus Statistik und Ökonometrie und skaliert diese Ideen mit ML. Ich führe dich durch die vier gängigsten Ansätze.
Im Idealfall führst du ein randomisiertes Experiment durch, um den Effekt einer Behandlung zu messen. In der Praxis sind Zuweisungen selten zufällig. Personen mit Behandlung unterscheiden sich oft von jenen ohne – und diese Unterschiede erzeugen Bias.
Propensity-Score-Methoden schätzen die Wahrscheinlichkeit, mit der eine Person die Behandlung erhält, basierend auf beobachteten Merkmalen. Diese Wahrscheinlichkeit ist der Propensity Score.
Hast du Scores, gibt es zwei Hauptwege, sie zu nutzen:
Beide Methoden versuchen, ein randomisiertes Experiment mit Beobachtungsdaten zu simulieren.
Manchmal fehlen die nötigen Störfaktoren in deinen Daten. Du kannst sie nicht messen, also helfen Propensity Scores nicht. Hier kommen Instrumentvariablen (IV) ins Spiel.
Ein Instrument beeinflusst die Behandlung, hat aber keinen direkten Effekt auf das Ergebnis. Es wirkt auf das Ergebnis nur über die Behandlung.
Klassisches Beispiel: der Effekt von Bildung auf Einkommen. Motivation beeinflusst sowohl die Bildungsjahre als auch das Einkommen – ist aber schwer zu messen. Die Entfernung zur nächsten Hochschule taugt als Instrument, weil sie die Wahrscheinlichkeit eines Studiums beeinflusst, aber nicht direkt das spätere Gehalt.
In der Praxis ist ein gutes Instrument selten. Mit gutem Instrument ist die Methode stark, mit schwachem oder ungültigem führt sie in die Irre.
Causal Forests erweitern den Random-Forest-Algorithmus, um Behandlungseffekte statt Ergebnisse zu schätzen. Ein Standard-Forest sagt ein Ergebnis voraus, ein Causal Forest schätzt, wie stark die Behandlung das Ergebnis für unterschiedliche Subgruppen verändert.
Das ist nützlich, wenn der Effekt zwischen Individuen variiert. Ein Medikament kann bei Jüngeren gut wirken, bei Älteren weniger. Ein Rabatt erhöht Käufe bei Preissensiblen, hat bei Loyalen kaum Effekt. Causal Forests erkennen solche Unterschiede, indem sie nach Merkmalen splitten, die die größte Heterogenität im Effekt erzeugen.
Das Ergebnis ist ein personalisierter Behandlungseffekt für jede Person im Datensatz.
Double Machine Learning (DML) verbindet ML-Modelle mit statistischer Inferenz – das Beste aus beiden Welten.
Du nutzt ein ML-Modell, um das Ergebnis zu prognostizieren, und ein weiteres, um die Behandlungszuweisung zu prognostizieren. Dann betrachtest du die Residuen (den Teil, den keines der Modelle erklärt hat) – ihre Beziehung liefert den kausalen Effekt.
Fragst du dich nach dem Extraaufwand? ML-Modelle erfassen Muster gut, bringen aber Bias in kausale Schätzungen. DML entfernt diesen Bias mittels Cross-Fitting: Trainieren und Vorhersagen auf unterschiedlichen Splits, um Overfitting zu vermeiden.
Hast du eine Methode gewählt, musst du die Ergebnisse zusammenfassen. Hier kommen Kennzahlen für Behandlungseffekte ins Spiel.
Der Average Treatment Effect (ATE) misst den durchschnittlichen kausalen Effekt der Behandlung über die gesamte Population. Hat eine Rabattkampagne einen ATE von 5 $, heißt das: Im Durchschnitt steigerte der Rabatt die Ausgaben um 5 $ pro Kunde.
ATE gibt dir das große Bild, verschleiert aber Unterschiede. 5 $ im Schnitt kann heißen, alle gaben 5 $ mehr aus – oder die Hälfte 10 $ mehr und die andere Hälfte gar nicht.
Der Conditional Average Treatment Effect (CATE) schätzt den Effekt für Subgruppen basierend auf Merkmalen. Statt einer Zahl für alle sagt dir CATE etwa: Der Rabatt erhöhte die Ausgaben um 8 $ bei neuen, aber nur um 2 $ bei wiederkehrenden Kundinnen und Kunden.
CATE macht kausales ML umsetzbar. ATE sagt, ob eine Intervention wirkt. CATE sagt, für wen sie wirkt – und genau das brauchst du für datenbasierte Entscheidungen.
Kausales ML hilft überall dort, wo du von "Was ist passiert?" zu "Was sollen wir tun?" kommen musst. Hier sind ein paar Beispiele.
Ein Krankenhaus will wissen, welche Behandlung für ein bestimmtes Patientenprofil am besten wirkt. Klassisches ML kann Risiken vorhersagen, kausales ML schätzt, ob Behandlung A oder B für diese konkrete Person bessere Ergebnisse bringt. So werden Behandlungsentscheidungen personalisiert – basierend auf geschätzten Effekten statt auf Durchschnittswerten.
Ein Marketingteam startet eine Promo und sieht einen Umsatzsprung. Die Frage ist: Hat die Kampagne ihn verursacht – oder war es Saisonalität? Kausales ML isoliert den wahren Kampagneneffekt, indem es Störfaktoren wie Timing, Demografie und bisheriges Kaufverhalten berücksichtigt.
Regierungen und Institutionen müssen bewerten, ob Maßnahmen wirken. Hat ein Trainingsprogramm die Arbeitslosigkeit gesenkt? Hat ein Steueranreiz Investitionen erhöht? Kausales ML bietet einen Rahmen für Evaluation, wenn Randomized Trials unpraktisch oder unmöglich sind.
Ein Produktteam führt ein neues Feature ein, und das Engagement steigt. Kausales ML hilft zu bestimmen, ob das Feature den Anstieg verursacht hat – oder ob gleichzeitig anderes passierte, etwa eine Marketingoffensive oder ein Wettbewerberausfall. Den tatsächlichen Impact eines Features zu verstehen, trennt dateninformierte Entscheidungen vom Bauchgefühl.
Der gemeinsame Nenner: Gute Entscheidungen brauchen das Warum – nicht nur das Was.
Es gibt drei Bibliotheken, die die meisten Anwendungsfälle abdecken. Ich erkläre dir, wofür sie stehen, und zeige einen typischen Workflow.
Bevor wir in den Code einsteigen, hier ein Snippet mit allen Imports und der Datensatzerstellung. Fehlende Abhängigkeiten installierst du mit pip oder uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
Der Datensatz umfasst 1000 E-Commerce-Kundinnen und -Kunden, und ich möchte den kausalen Effekt einer Rabatt-E-Mail in Dollar schätzen. Der wahre kausale Effekt beträgt 5 $, aber wie du in der Ausgabe siehst, überschätzt ein naiver Vergleich den wahren Effekt, weil rabattierte Kundinnen und Kunden bereits mehr Vorkäufe hatten:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")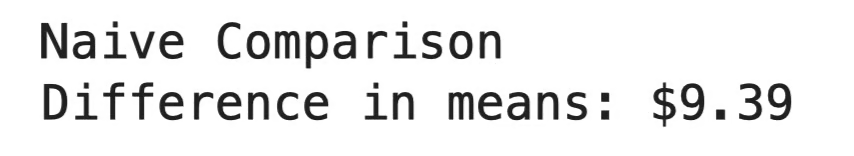
Naiver Vergleich
DoWhy ist ein Framework von Microsoft für End-to-End-Kausalinferenz. Es folgt vier Schritten: Problem als kausalen Graphen modellieren, den kausalen Effekt identifizieren, ihn schätzen und anschließend prüfen, ob die Schätzung unter unterschiedlichen Annahmen Bestand hat.
Das Besondere an DoWhy ist der Fokus auf Validierung. Nach der Schätzung führt es Widerlegungstests durch, die dein Ergebnis herausfordern. Hält die Schätzung stand, kannst du ihr stärker vertrauen. Wenn nicht, weißt du, dass deine Annahmen nachgeschärft werden müssen.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")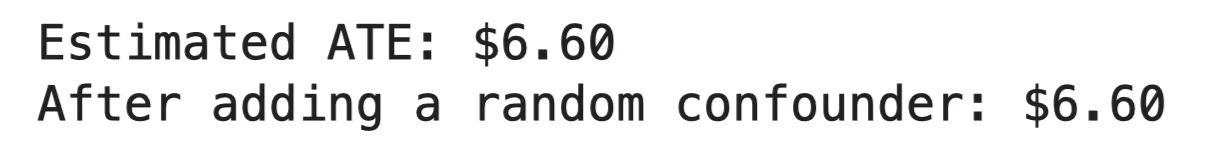
DoWhy-Ausgabe
Im Schnitt erhöhte der Rabatt den Einkaufsbetrag um 6,60 $ pro Kunde. Der Widerlegungstest fügte dem Modell eine Zufallsvariable hinzu, und die Schätzung blieb unverändert – ein Hinweis darauf, dass das Ergebnis nicht durch Scheinkorrelationen getrieben ist. Hätte sich die Schätzung stark verschoben, wäre das ein Warnsignal für falsche Annahmen.
EconML, ebenfalls von Microsoft, konzentriert sich auf heterogene Behandlungseffekte – sprich: wie der Effekt zwischen Subgruppen variiert. Es implementiert Methoden wie Double ML und Causal Forests, die ich oben vorgestellt habe.
EconML folgt einer scikit-learn-ähnlichen API mit .fit() und .effect().
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")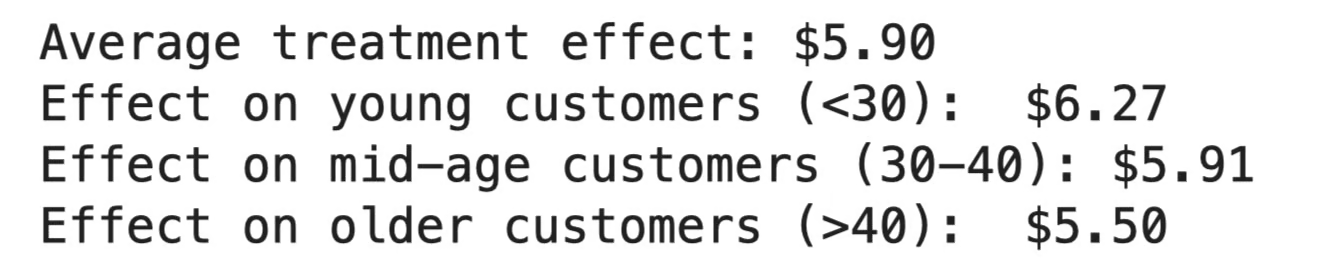
EconML-Ausgabe
Der Rabatt erhöhte die Einkaufsbeträge im Schnitt um 5,90 $, aber nicht gleichmäßig. Jüngere reagierten am stärksten (6,27 $), Ältere am wenigsten (5,50 $). Ist das Budget begrenzt, weißt du, wo du zuerst ansetzen solltest.
CausalML, von Uber entwickelt, ist auf Uplift Modeling ausgelegt – also die Vorhersage, wer am stärksten auf eine Behandlung reagiert. Besonders beliebt im Marketing: Ziel ist es, Personen anzusprechen, die ihr Verhalten aufgrund der Kampagne ändern – nicht jene, die ohnehin konvertiert hätten.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())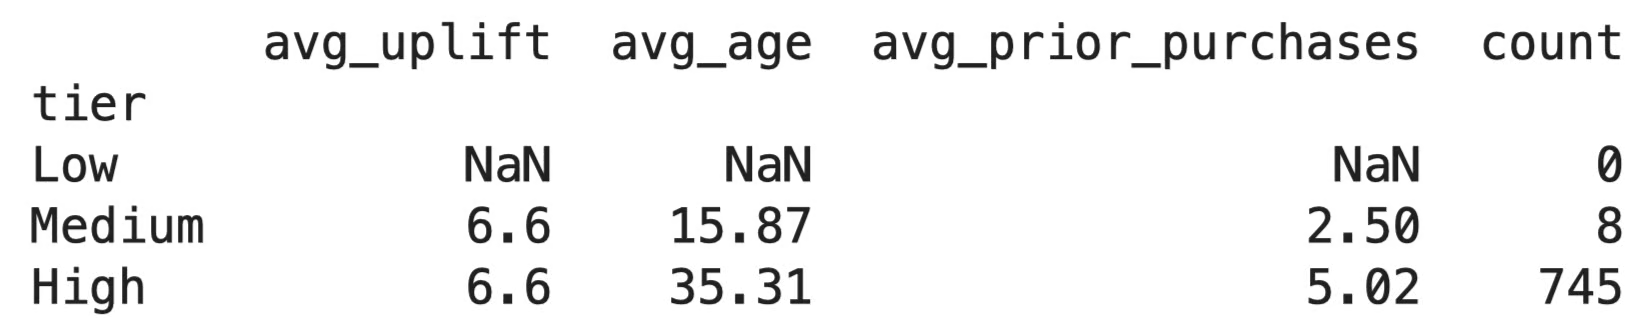
CausalML-Ausgabe
Die Uplift-Scores sind nahezu identisch über alle Kundinnen und Kunden – der Rabatt wirkte also überall ähnlich, rund 6,60 $ pro Person. Das passt zu unserem synthetischen Datensatz mit eingebautem konstantem 5-$-Effekt ohne Variation. In realen Daten siehst du typischerweise mehr Streuung – dann werden Ziel-Segmente wirklich hilfreich.
Jede Bibliothek hat ihr ideales Einsatzfeld. Nutze:
Alle drei lassen sich gut kombinieren. Ein gängiges Muster: Kausalen Graphen in DoWhy definieren, Effekte mit EconML schätzen und CausalML zur Interpretation nutzen.
Kausales ML wird leicht falsch eingesetzt. Das hier sind die häufigsten Stolperfallen.
Der Klassiker: Nutzende eines Features geben mehr aus – also muss das Feature den Umsatz treiben. Vielleicht sind Vielausgebende aber einfach generell engagierter. Ohne kausalen Rahmen rätst du zur Richtung der Beziehung.
Jede Kausalanalyse startet mit der Frage: Ist das ein Muster – oder eine Ursache? Überspringst du sie, hilft dir kein Modell.
Ein Störfaktor beeinflusst Behandlung und Ergebnis.
Misst du den Effekt eines Trainings auf die Leistung: Wer sich anmeldet, ist oft motivierter. Motivation treibt sowohl Teilnahme (Behandlung) als auch Leistung (Ergebnis). Berücksichtigst du sie nicht, schreibst du den Motivationseffekt dem Training zu.
Die Lösung ist strukturell, nicht rein statistisch. Zeichne deinen DAG, mappe alle Variablen, die beide Seiten beeinflussen könnten, und lege vor dem ersten Modell fest, wie du mit ihnen umgehst.
Ein ATE von 5 $ heißt nicht, dass jede Person 5 $ mehr ausgab. Es ist ein Durchschnitt – und der verdeckt viel. Manche gewannen 15 $, andere verloren 5 $.
Auch umgekehrt ist gefährlich: Ein CATE für eine Subgruppe heißt nicht, dass alle Individuen darin gleich reagieren. Behandlungseffekte sind Schätzungen mit Unsicherheit, keine Garantien. Prüfe Konfidenzintervalle und entscheide nie nur auf Basis von Punktschätzungen.
Die Zahl aus EconML oder DoWhy ist nur so gut wie die Annahmen dahinter. Ein Modell beantwortet dir nicht:
Dafür brauchst du jemanden, der das Problem versteht. Ein Causal Forest liefert dir auch aus einem schlecht spezifizierten Modell bereitwillig Effektschätzungen – er sagt dir nur nicht, dass sie falsch sind.
Die besten Kausalanalysen kombinieren MLs Stärke bei komplexen Daten mit Menschen, die wissen, welche Variablen warum wichtig sind.
Kausales ML ändert die Frage von "Was wird passieren?" zu "Was hat es verursacht?"
Dieser Perspektivwechsel verändert Entscheidungen. Du reagierst nicht mehr nur auf Muster, sondern verstehst die Mechanik dahinter. Manche sagen sogar: Es ist der einzige Weg, wirklich datenbasiert zu entscheiden.
Aber die Tools sind nur so gut wie deine Annahmen. Ein falscher kausaler Graph oder ein missdeuteter Effekt führt zu Schlussfolgerungen, die "wissenschaftlich" wirken – aber falsch sind. Das Modell hebt nicht die Hand und warnt dich.
Die besten Ergebnisse entstehen, wenn du MLs Stärke bei komplexen Daten mit jemandem kombinierst, der das Problem so gut versteht, dass er die richtigen kausalen Fragen stellt. Starte mit dem Domänenwissen – lass dann das Modell die Schwerarbeit machen. Mehr ist es nicht.
Der erste Teil ist leicht – besonders mit unserem Kurs Supervised Learning with scikit-learn. Melde dich an und bring deine Machine-Learning-Kompetenzen mit einer unverzichtbaren Python-Bibliothek voran.
Lerne mit DataCamp
Kurs
Kurs
Kurs
Blog
Tutorial
Matt Crabtree
5 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Adel Nehme
6 Min.
Tutorial
Derrick Mwiti
10 Min.
Tutorial
Mark Pedigo
10 Min.