Courses
機械学習を理解する
2時間
307.3K
購入者を予測できても、「なぜ買ったのか」は教えてくれない——そんな機械学習モデルに悩まされたことはありませんか?
従来の機械学習はパターンを見つけ、結果を予測できます。顧客が解約しそうだとか、来期の売上が減少しそうだとか。しかし、「最新のマーケティング施策が本当に売上増の原因だったのか」「治療が実際に患者の転帰を改善したのか」と問うと、お手上げです。予測と因果は別物だからです。
因果機械学習は、機械学習に因果推論の手法を組み合わせます。つまり、「何が起きるか」ではなく「介入すると何が起きるか」を問います——これはあらゆるビジネス判断や医療行為の根底にある問いです。
この記事では、因果機械学習の核となる考え方、因果関係を推定するための手法、そしてPythonでの適用方法を解説します。
機械学習が初めてであれば、初心者向けのMachine Learning Fundamentals in Python トラックに登録してください。
標準的なMLモデルはデータからパターンを学び、予測に用います。「何が起きるか」には強いですが、それが「なぜ起きたのか」は教えてくれません。
因果機械学習は別の問いを立てます。MLと因果推論を組み合わせ、データから原因と結果の関係を推定します。結果を予測するのではなく、特定の行動を取った場合に何がどのように変わるかを見積もります。
この行動は介入と呼ばれ、効果を見るために意図的に加える変化を指します。割引が本当に購入を促したのか、それとも割引がなくても買っていたのか。新薬が回復を改善したのか、それとも自然に良くなったのか。
こうした問いは予測では答えられませんが、因果MLなら可能です。
従来のMLは相関を学びます。割引メールを受け取った顧客は購入が多い、といったパターンを見つけ、それをもとに将来の購入を予測します。しかし、相関はメールが購入の原因だったかを教えてはくれません。もともと買うつもりだったのかもしれません。
因果MLは、メールが購入に与えた因果効果を推定します。送らなかったらどうなっていたかを問います。「一緒に現れがち」なのか「これがあれの原因なのか」の違いが、従来型と因果MLを分けます。
シンプルに言えば、こうです。
前者は予測に役立ち、後者は意思決定に役立ちます。どちらも有用です。
多くのビジネスや政策判断は本質的に因果の問題です。「何が起きるか」ではなく「何をすべきか」を問います。
具体例をいくつか挙げます。
標準的な機械学習はこれらに答えられません。相関を「特徴」として扱うからです。一緒に動く2変数は共通の原因を持つかもしれず、単なる偶然かもしれません。因果MLは、なぜ結びついているのか、片方を変えると本当にもう片方が変わるのかを考えることを促します。
因果効果を推定する前に、すべての因果分析が拠って立ついくつかの要点を理解しておく必要があります。
あらゆる因果の問いは、処置とアウトカムの2要素から成ります。
処置は検討対象の行動や介入です。患者に与える薬や、顧客に提供する割引など。アウトカムは測定対象で、回復時間、購入率、生産性などです。
因果MLの目的は、処置がアウトカムをどう変えるかを推定することです。相関ではなく、実際に原因となっているかを推定します。
薬を服用した後に何が起きたかは観測できますが、服用していなかったらどうなっていたかは観測できません。この観測されないシナリオを反事実と呼びます。
別の例として、顧客が20%割引を受けて購入したとします。反事実は「割引なしでも購入したのか?」と問います。時間を巻き戻して同一人物で両方を試すことはできないため、確信を持つことはできません。
因果MLは統計的手法と仮定により、この反事実を推定します。推定の質は、観測できないものをどれだけうまく近似できるかにかかっています。
交絡因子(交絡変数)は、処置とアウトカムの双方に影響する変数で、誤った因果の印象を生みます。
たとえば運動が心疾患を減らすかを研究するとします。よく運動する人は食生活も良い傾向があります。食事は運動(処置)と心疾患(アウトカム)の双方に影響します。食事を無視すると、運動単独の効果を過大評価してしまいます。
交絡は因果分析の最大の脅威です。これを特定し、考慮に入れることが信頼できる推定につながるため、時間をかける価値があります。
どの変数が交絡で、どれがそうでないかをどう見極めるのか?——その答えは、グラフを描くことです。
有向非循環グラフ(DAG)は、変数間の因果関係を図式化したものです。各ノードが変数、矢印は原因から結果への方向を示します。「有向」は矢印の向きがあること、「非循環」はループがない(直接でも間接でも自分自身を原因にしない)ことを意味します。
先ほどの運動の例を考えます。単純なDAGでは、食事→運動、食事→心疾患、そして運動→心疾患の矢印が引かれます。処置とアウトカムの双方に矢印が伸びる食事が交絡であることがグラフから一目瞭然です。
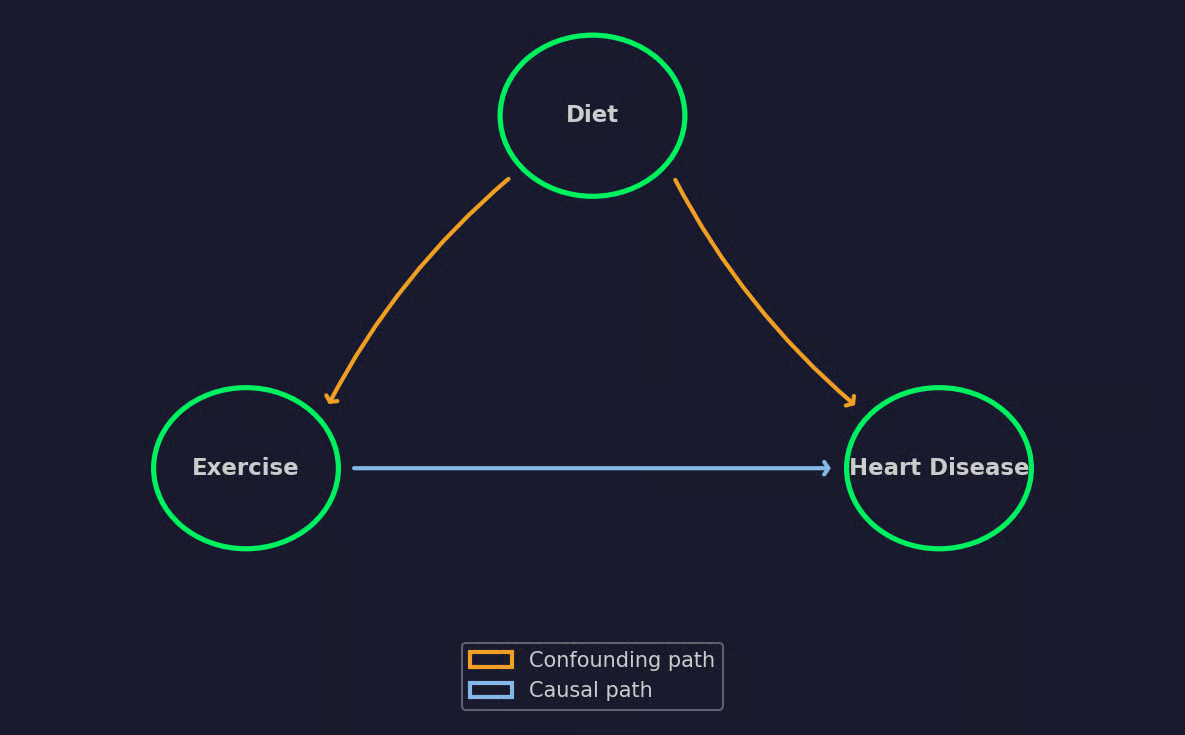
シンプルなDAGの例
DAGは、どの変数をコントロールし、どれに手を触れないかも教えてくれます。誤った変数をコントロールすると、バイアスを除去するどころか導入してしまうことがあります。DAGは因果分析全体のロードマップだと考えてください。
良いところは?
DAGの作成に数学は不要です。必要なのはドメイン知識です。グラフは世界の仕組みに関する仮定を符号化し、推定の質はその仮定が正しいかどうかに依存します。
因果MLは統計学や計量経済学の考え方を採り入れつつ、機械学習でスケールさせます。代表的な4つのアプローチを見ていきます。
理想はランダム化実験で効果を測ることですが、現実には処置割り当ては滅多にランダムではありません。処置群と非処置群の属性が異なり、その違いがバイアスを生みます。
傾向スコア法は、観測された特徴量にもとづき各個体が処置を受ける確率(傾向スコア)を推定して対応します。
スコアを得たら、主に2つの使い方があります。
どちらも観測データでランダム化実験を擬似的に再現しようとするものです。
必要な交絡因子がデータにないこともあります。測定できなければ傾向スコアは役立ちません。そこで操作変数(IV)の出番です。
操作変数とは、処置には影響するが、アウトカムには直接影響せず、処置を通じてのみアウトカムに影響する変数です。
古典的な例は教育が収入に与える効果の推定です。意欲は教育年数と収入の両方に影響しますが、直接測れません。最寄りの大学までの距離は、大学進学には影響するが将来の給与に直接影響しないため、操作変数として機能します。
実務では良い操作変数を見つけるのは難しいものです。適切なら強力ですが、弱い/不適切な操作変数は誤解を招く結果を生みます。
因果フォレストはランダムフォレストを拡張し、予測ではなく処置効果を推定します。標準のランダムフォレストがアウトカムを予測するのに対し、因果フォレストはサブグループごとに処置がアウトカムをどれだけ変えるかを推定します。
個人ごとに処置効果が異なる場合に有用です。薬は若年層には効いても高齢者には効きにくいかもしれません。割引も、価格に敏感な顧客には効いても、ロイヤル顧客には無効かもしれません。因果フォレストは、処置効果の差が最大になる特性でデータを分割して、これらの違いを検出します。
出力は、データ内の各個体に対するパーソナライズされた処置効果の推定です。
ダブルマシンラーニング(DML)は、MLと統計的推論を組み合わせ、両者の長所を活用します。
一つのMLモデルでアウトカムを、もう一つで処置割り当てを予測します。次に、それぞれの残差(モデルで説明しきれない部分)を見て、その関係から因果効果を得ます。
なぜ面倒な手順が必要かというと、MLはパターン抽出に優れる一方、因果推定ではバイアスを導入しがちだからです。DMLはクロスフィッティング(学習と予測に異なるデータ分割を使い過学習を避ける)でそのバイアスを補正します。
手法を選んだら、結果を要約する指標が必要です。そこで処置効果の指標が登場します。
平均処置効果(ATE)は、母集団全体にわたる処置の平均的な因果効果を測ります。割引キャンペーンのATEが$5なら、平均して顧客一人あたり支出が$5増えたことを意味します。
ATEは全体像を示しますが、個別のばらつきを隠します。$5の平均は、全員が$5増えたのか、半数が$10増えもう半数は変化なしなのか、区別しません。
条件付き平均処置効果(CATE)は、特性に基づくサブグループごとの処置効果を推定します。全員に一つの数字を出すのではなく、新規顧客には$8、既存顧客には$2といった具合に差を示します。
CATEは因果MLを実行可能なものにします。ATEは介入が効くかを示し、CATEは「誰に効くか」を示します——データドリブンな意思決定に必要な答えです。
「何が起きたか」から「何をすべきか」へ踏み込む場面で因果MLは活躍します。いくつか例を挙げます。
病院は、特定の患者プロファイルに最適な治療を知りたいと考えます。標準MLはリスクの高い人を予測できますが、因果MLはその患者に対して治療AとBのどちらがより良い転帰をもたらすかを推定します。母集団平均ではなく推定効果にもとづく個別化治療を可能にします。
プロモーションで売上が急増したとします。本当に施策の効果なのか、それとも季節要因なのか。因果MLは、時期、顧客属性、過去の購買行動といった交絡を考慮して、真のキャンペーン効果を切り分けます。
政府や機関は、政策が意図した結果を生むかを評価する必要があります。職業訓練は失業を減らしたのか。税制優遇は投資を増やしたのか。ランダム化試験が現実的でない場面で、因果MLは政策評価の枠組みを提供します。
新機能を追加したらエンゲージメントが上がった。因果MLは、その機能が原因なのか、マーケ施策や競合のダウンといった他の変化が重なったのかを見極めます。機能の実際の影響を把握することが、勘に頼らない意思決定を可能にします。
共通するのは、「起きた」という事実だけでなく、「なぜ起きたか」を知ることが意思決定に不可欠だという点です。
Pythonでの因果MLの大半は3つのライブラリでカバーできます。それぞれの役割と典型的なワークフローを見ていきます。
コードに入る前に、インポートとデータ作成をまとめたスニペットを示します。足りない依存関係はpip や uvでインストールできます。
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
このデータセットはECストアの顧客1000人を定義し、割引メールの金額効果(ドル)を推定します。割引の真の因果効果は$5ですが、出力のとおり、素朴な比較は効果を過大評価します。割引を受けた顧客は、もともと過去購入が多かったためです。
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")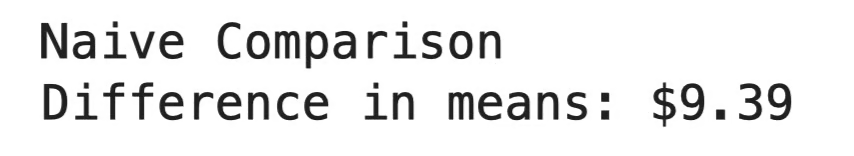
素朴な比較
DoWhy はMicrosoftが開発した、エンドツーエンドの因果推論フレームワークです。因果グラフで問題を定式化し、効果を同定し、推定し、さらに推定が仮定の違いに耐えるかを検証する——という4段階プロセスに従います。
DoWhyの特長は検証への注力です。推定後に反証テストで結果に揺さぶりをかけます。テストを生き延びれば信頼度が増し、そうでなければ仮定の見直しが必要だと分かります。
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")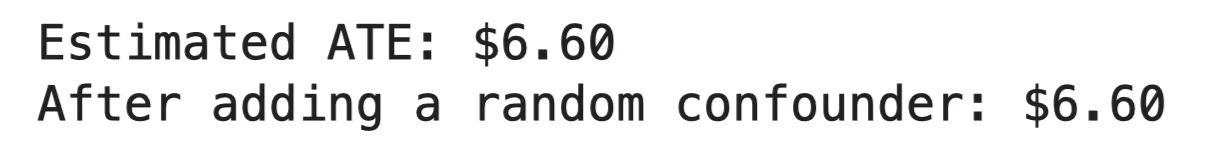
DoWhyの出力
平均すると、割引は顧客一人あたり$6.60の購入額増をもたらしました。反証テストではランダム変数を追加しましたが、推定は全く変わりません。つまり、偶然の相関に引きずられた結果ではないということです。もし大きく変わっていたら、因果の仮定に問題ありという赤信号でした。
EconML もMicrosoft製で、不均一処置効果の推定に特化しています。平たく言えば、サブグループによって効果がどう異なるかを推定します。先ほど触れたDouble MLやCausal Forestsなどを実装しています。
EconMLはscikit-learn風のAPIで、.fit() と .effect() を備えています。
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")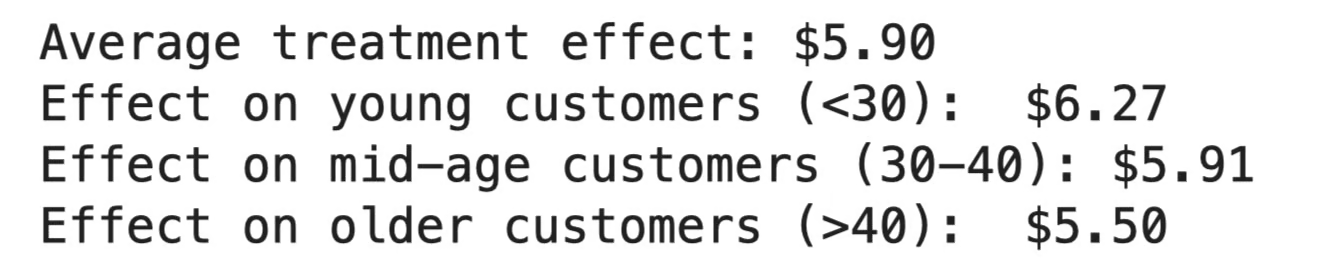
EconMLの出力
割引は平均$5.90の購入額増につながりましたが、効果は一様ではありません。若年層の反応が最も大きく($6.27)、高齢層が最も小さく($5.50)なりました。予算が限られるなら、まずどこを狙うべきかが見えてきます。
CausalML はUber製で、アップリフトモデリング(処置に最も反応する個体の予測)に特化しています。マーケティング領域で人気が高く、キャンペーンで行動が変わる顧客を狙い、もともと購買する人を狙わないために使われます。
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())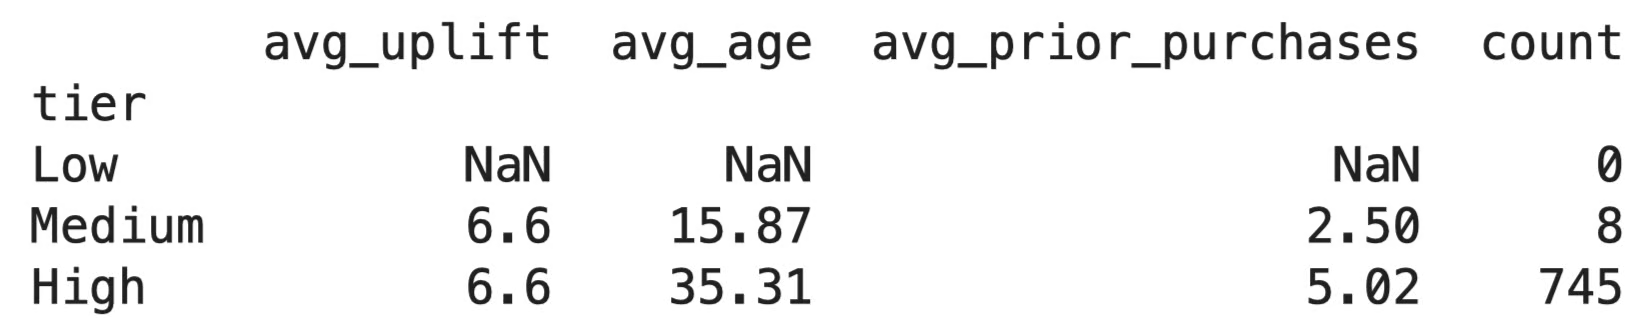
CausalMLの出力
アップリフトは顧客全体でほぼ同じでした。つまり、割引の効果はおおむね誰に対しても同程度(約$6.60)です。これは、合成データでサブグループ差のないフラットな$5の効果を組み込んでいるため妥当です。実データでは通常ばらつきが大きく、そこでターゲティング階層が役立ちます。
各ライブラリには得意領域があります。以下を使い分けてください。
3つは併用も有効です。一般的な流れは、DoWhyで因果グラフを定義し、EconMLで効果を推定し、CausalMLで結果を解釈する、というものです。
因果MLは誤用されがちです。特に混乱を招く誤りを挙げます。
ありがちな誤りです。ある機能をよく使う顧客は支出も多い——だから機能が支出を押し上げる、と結論づける。しかし高支出の顧客は全般的にエンゲージメントが高いだけかもしれません。因果の枠組みなしに関係の向きを当てても、当たりません。
すべての因果分析は、「これはパターンか、原因か?」の問いから始まります。これを飛ばすと、どんなモデリングも役に立ちません。
交絡は処置とアウトカムの両方に影響します。
研修の効果を従業員のパフォーマンスで測るとします。研修に申し込む人は意欲が高い傾向があります。意欲は受講(処置)とパフォーマンス(アウトカム)の両方を押し上げます。これを考慮しなければ、意欲の効果を研修の効果と取り違えてしまいます。
解決は統計より構造です。DAGを描き、両側に影響し得る変数を洗い出し、モデルを当てる前に扱いを決めてください。
ATEが$5でも、全員が$5増えたわけではありません。平均は多くを隠します。ある人は$15増え、別の人は$5減ったかもしれません。
逆方向の誤解も危険です。サブグループのCATEが出ても、グループ内の全員が同様に反応するとは限りません。処置効果は不確実性を伴う推定であり、保証ではありません。常に信頼区間を確認し、点推定だけでターゲティングを行わないでください。
EconMLやDoWhyの数値は、背後の仮定の良し悪し次第です。モデルは次のような問いに答えられません。
これらには問題を理解した人間が必要です。因果フォレストは、仕様の悪いモデルからでも喜んで効果を吐き出します——それが間違いだとは教えてくれません。
最良の因果分析は、複雑なデータを扱うMLの力と、どの変数が重要でなぜ重要かを知る人の知見を組み合わせたときに生まれます。
因果MLは問いを「何が起きるか」から「なぜそれが起きたのか」へと切り替えます。
この転換は意思決定の在り方を変えます。パターンへの反応から、その背後の仕組みの理解へ。実のところ、これこそが真のデータドリブンな意思決定だと言う人もいます。
ただし、ツールは仮定の質次第です。誤った因果グラフや読み違えた処置効果は、「科学的」で「データドリブン」に見えるが誤った結論を導きます。モデルはそれを教えてはくれません。
最良の結果は、複雑なデータを扱うMLの力と、適切な因果の問いを立てられるドメイン知識を併せ持つことで得られます。まずドメイン知識から始め、あとはモデルに任せましょう。それだけです。
第一歩は簡単です。こちらのSupervised Learning with scikit-learn コースから始めましょう。必須のPythonライブラリで機械学習スキルを伸ばしてください。
DataCampで学ぶ
Courses
Courses
Courses