course
Înțelegerea Machine Learning-ului
2 oră
307.3K
Ai fost vreodată în situația în care modelul tău de învățare automată poate prezice cine va cumpăra, dar nu îți poate spune de ce a cumpărat?
Învățarea automată tradițională poate observa tipare și poate prezice rezultate. Îți va spune că un client are șanse mari să plece sau că vânzările vor scădea trimestrul viitor. Dar dacă o întrebi dacă cea mai recentă campanie de marketing chiar a cauzat mai multe vânzări sau dacă un tratament a îmbunătățit cu adevărat rezultatele pacienților, nu știe ce să facă. Predicția și cauzalitatea sunt două lucruri diferite.
Învățarea automată cauzală combină învățarea automată cu tehnici de inferență cauzală. Așadar, în loc să întrebe "ce se va întâmpla?", întreabă "ce se întâmplă dacă intervenim?" - iar aceasta este întrebarea din spatele oricărei decizii de business sau al oricărui tratament medical.
În acest articol, te voi ghida prin conceptele de bază din spatele ML cauzal, metodele folosite pentru a estima relațiile de cauză-efect și cum să le aplici în Python.
Dacă ești nou în învățarea automată, înscrie-te în traseul nostru prietenos pentru începători Bazele învățării automate în Python.
Modelele ML standard învață tipare din date și le folosesc pentru a face predicții. Sunt bune la a răspunde "ce se va întâmpla?", dar nu îți pot spune ce a cauzat acel lucru.
Învățarea automată cauzală pune o întrebare diferită. Combină ML cu tehnici de inferență cauzală pentru a estima relațiile de cauză-efect din date. Așadar, în loc să prezică un rezultat, estimează ce s-ar schimba dacă ai lua o acțiune specifică.
Acea acțiune se numește intervenție și reprezintă o schimbare deliberată pe care o faci pentru a-i vedea efectul. A determinat reducerea de preț mai multe achiziții sau acei clienți ar fi cumpărat oricum? A îmbunătățit noul medicament recuperarea sau pacienții s-au făcut bine de la sine?
Acestea sunt întrebări la care predicțiile nu pot răspunde, dar ML cauzal poate.
ML tradițional învață corelații. Găsește că clienții care primesc e-mailuri cu reduceri tind să cumpere mai mult și folosește acel tipar pentru a prezice achizițiile viitoare. Dar corelația nu îți spune dacă e-mailul a cauzat achiziția. Poate că acei clienți plănuiau deja să cumpere.
ML cauzal estimează efectul cauzal al e-mailului asupra achizițiilor. Întreabă ce s-ar fi întâmplat dacă nu l-ai fi trimis. Diferența dintre "aceste lucruri tind să apară împreună" și "acest lucru a cauzat acel lucru" este ceea ce separă ML tradițional de ML cauzal.
Iată o modalitate simplă de a te gândi la asta:
Primul te ajută să preziți. Al doilea te ajută să decizi. Ambele sunt utile.
Majoritatea deciziilor de business și de politici publice sunt, prin natură, cauzale. Nu întrebi "ce se va întâmpla?" - întrebi "ce ar trebui să facem?"
Iată câteva exemple concrete:
Metodele standard de învățare automată nu pot răspunde la niciuna dintre aceste întrebări pentru că tratează corelația ca pe o caracteristică. Două variabile care se mișcă împreună pot avea o cauză comună sau relația poate fi pură coincidență. ML cauzal te obligă să te gândești de ce sunt conectate lucrurile - și dacă schimbarea uneia chiar o va schimba pe cealaltă.
Înainte să poți estima cauză-efect, trebuie să înțelegi câteva lucruri pe care se bazează orice analiză cauzală.
Fiecare întrebare cauzală are două părți: un tratament și un rezultat.
Tratamentul este acțiunea sau intervenția pe care o studiezi. Poate fi un medicament administrat pacienților sau o reducere oferită clienților. Rezultatul este ceea ce măsori, cum ar fi timpul de recuperare, rata de achiziție sau productivitatea.
Scopul ML cauzal este să estimeze cum schimbă tratamentul rezultatul. Nu estimează dacă cele două sunt corelate, ci dacă unul îl cauzează cu adevărat pe celălalt.
Poți observa ce s-a întâmplat după ce un pacient a luat medicamentul, dar nu poți observa ce s-ar fi întâmplat dacă nu l-ar fi luat. Acea situație neobservată se numește contrafactual.
În alt domeniu, să zicem că un client a primit o reducere de 20% și a făcut o achiziție. Contrafactualul întreabă: ar fi cumpărat fără reducere? Nu vei ști niciodată sigur pentru că nu poți da timpul înapoi și rula ambele versiuni pe aceeași persoană.
ML cauzal estimează aceste contrafactuale folosind tehnici statistice și presupuneri. Calitatea estimării cauzale depinde de cât de bine aproximezi ceea ce nu poți observa direct.
Un confounder este o variabilă care afectează atât tratamentul, cât și rezultatul, ceea ce creează o impresie falsă de cauzalitate.
De exemplu, să zicem că studiezi dacă exercițiul fizic reduce bolile de inimă. Persoanele care fac mai mult sport tind, de asemenea, să mănânce mai sănătos. Dieta afectează atât probabilitatea de a face sport (tratament), cât și bolile de inimă (rezultat). Dacă ignori dieta, vei supraestima cât de mult contează exercițiul singur.
Variabilele de confuzie sunt cea mai mare amenințare pentru analiza cauzală. Identificarea și luarea lor în calcul este ceea ce face o estimare cauzală de încredere și merită să aloci timp acestui lucru.
Dacă te întrebi cum îți dai seama care variabile sunt confounderi și care nu, ei bine, desenezi un graf.
Un graf aciclic orientat (DAG) este o diagramă care cartografiază relațiile cauzale dintre variabile. Fiecare nod reprezintă o variabilă, iar fiecare săgeată indică de la o cauză către efectul ei. "Orientat" înseamnă că săgețile au o direcție. "Aciclic" înseamnă că nu există bucle - o variabilă nu se poate cauza pe sine, direct sau printr-un lanț.
Ia exemplul cu exercițiul de mai devreme. Un DAG simplu ar avea săgeți de la Dietă -> Exercițiu și Dietă -> Boli de Inimă, plus o săgeată de la Exercițiu -> Boli de Inimă. Graful face evident că Dieta este un confounder pentru că are săgeți care indică atât spre tratament, cât și spre rezultat.
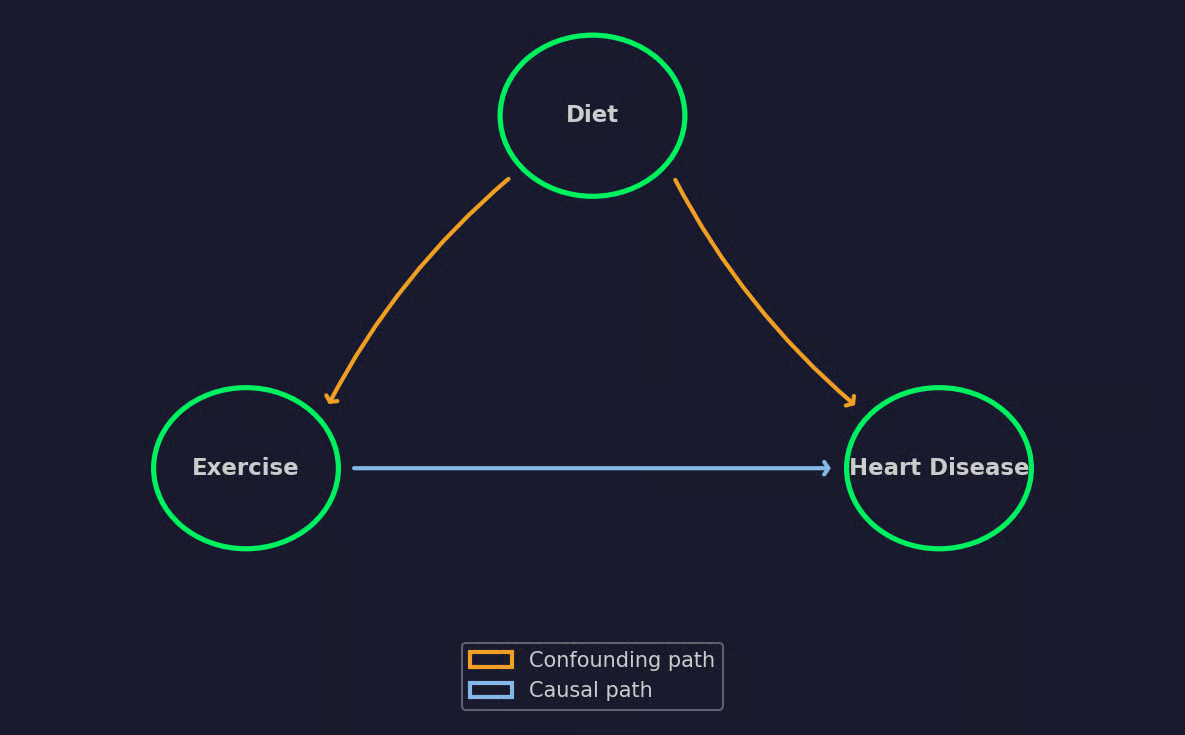
Un exemplu simplu de DAG
DAG-urile îți spun și ce variabile să controlezi și pe care să le lași în pace. Dacă controlezi variabila greșită, poți de fapt să introduci bias în loc să-l elimini. Ține minte: gândește-te la un DAG ca la o hartă pentru întreaga ta analiză cauzală.
Partea cea mai bună?
Nu ai nevoie de matematică pentru a construi un DAG. Ai nevoie doar de cunoștințe de domeniu. Graful codifică presupunerile tale despre cum funcționează lumea, iar calitatea estimărilor cauzale depinde de cât de corecte sunt acele presupuneri.
ML cauzal împrumută mult din statistică și econometrie, dar scalează aceste idei cu învățarea automată. Te voi ghida prin cele patru abordări cele mai comune.
Într-o lume ideală, ai rula un experiment randomizat pentru a măsura efectul unui tratament. Dar în practică, alocările de tratament sunt rareori aleatorii. Persoanele care primesc tratamentul diferă adesea de cele care nu îl primesc - iar aceste diferențe creează bias.
Metodele cu scor de propensitate abordează asta estimând probabilitatea ca fiecare individ să primească tratamentul, pe baza caracteristicilor observate. Acea probabilitate este scorul de propensitate.
După ce ai scorurile, există două moduri principale de a le folosi:
Ambele metode încearcă să simuleze cum ar fi arătat un experiment randomizat, folosind date observaționale.
Uneori, confounderii de care ai nevoie pentru a controla nu se regăsesc în datele tale. Nu îi poți măsura, așa că scorurile de propensitate nu ajută. Aici intervin variabilele instrumentale (IV).
Un instrument este o variabilă care afectează tratamentul, dar nu are efect direct asupra rezultatului. Influențează rezultatul doar prin tratament.
Un exemplu clasic este studiul efectului educației asupra câștigurilor. Motivația afectează atât câtă educație primește cineva, cât și cât câștigă - dar nu poți măsura direct motivația. Distanța până la cea mai apropiată facultate funcționează ca instrument pentru că afectează dacă cineva merge la facultate, dar nu afectează direct salariul viitor.
În practică, găsirea unui instrument bun este dificilă. Metoda e grozavă când ai unul, dar un instrument slab sau invalid va produce rezultate înșelătoare.
Pădurile cauzale extind algoritmul random forest pentru a estima efecte ale tratamentului în loc de predicții. Un random forest standard prezice un rezultat, în timp ce o pădure cauzală estimează cu cât schimbă tratamentul acel rezultat pentru diferite subgrupuri.
Acest lucru e util când efectul tratamentului variază între indivizi. Un medicament poate funcționa bine pentru pacienții mai tineri, dar nu pentru cei mai în vârstă. La fel, o reducere poate crește achizițiile pentru clienții sensibili la preț, dar să nu aibă efect asupra celor loiali. Pădurile cauzale detectează aceste diferențe împărțind datele pe caracteristici care produc cea mai mare variație a efectelor tratamentului.
Rezultatul este o estimare personalizată a efectului tratamentului pentru fiecare individ din setul tău de date.
Double machine learning (DML) combină modelele ML cu inferența statistică pentru a obține ce e mai bun din ambele lumi.
Folosesti un model ML pentru a prezice rezultatul și un altul pentru a prezice alocarea tratamentului. Apoi te uiți la reziduuri (părțile pe care niciun model nu le-a putut explica), iar relația dintre ele îți dă efectul cauzal.
Dacă te întrebi de ce pașii în plus, iată răspunsul. Modelele ML sunt excelente la captarea tiparelor, dar introduc bias când sunt folosite pentru estimare cauzală. DML elimină acel bias printr-o tehnică numită cross-fitting, unde antrenezi și prezici pe împărțiri diferite ale datelor pentru a evita supraînvățarea.
După ce ai ales o metodă, ai nevoie de o modalitate de a rezuma ce a găsit. Aici intervin metricile efectului tratamentului.
Efectul mediu al tratamentului (ATE) măsoară efectul cauzal mediu al tratamentului pe întreaga ta populație. Dacă ATE-ul unei campanii cu reduceri este de 5 $, înseamnă că, în medie, reducerea a crescut cheltuielile cu 5 $ per client.
ATE îți oferă imaginea de ansamblu, dar ascunde variația individuală. O medie de 5 $ ar putea însemna că toți au cheltuit cu 5 $ mai mult, sau ar putea însemna că jumătate dintre clienți au cheltuit cu 10 $ mai mult, în timp ce cealaltă jumătate nu a văzut nicio schimbare.
Efectul mediu condițional al tratamentului (CATE) estimează efectul tratamentului pentru subgrupuri specifice pe baza caracteristicilor lor. Așadar, în loc de un singur număr pentru toți, CATE îți spune că reducerea a crescut cheltuielile cu 8 $ pentru clienții noi, dar doar cu 2 $ pentru cei care revin.
CATE este ceea ce face ML cauzal acționabil. ATE îți spune dacă o intervenție funcționează. CATE îți spune pentru cine funcționează - iar acesta este răspunsul de care ai nevoie pentru a lua decizii bazate pe date.
ML cauzal apare oriunde ai nevoie să treci de la "ce s-a întâmplat?" la "ce ar trebui să facem?" Iată câteva exemple.
Un spital vrea să știe ce tratament funcționează cel mai bine pentru un profil specific de pacient. ML standard poate prezice cine e la risc, dar ML cauzal estimează dacă Tratamentul A sau Tratamentul B va produce un rezultat mai bun pentru acel pacient. Asta permite decizii de tratament personalizate pe baza efectelor estimate, nu a mediilor populaționale.
O echipă de marketing derulează o campanie promoțională și vede un vârf al vânzărilor. Întrebarea este: a cauzat campania vârful sau a fost determinat de cererea sezonieră? ML cauzal izolează impactul real al campaniei luând în calcul confounderi precum momentul, demografia clienților și comportamentul anterior de cumpărare.
Guvernele și instituțiile trebuie să evalueze dacă politicile produc rezultatele dorite. Un program de formare profesională a redus șomajul? Un stimulent fiscal a crescut investițiile? ML cauzal oferă un cadru pentru evaluarea politicilor atunci când testele randomizate nu sunt practice sau nici măcar posibile.
O echipă de produs adaugă o funcționalitate nouă și engagementul crește. ML cauzal ajută la stabilirea dacă funcționalitatea a cauzat creșterea sau dacă a coincis cu alte schimbări - cum ar fi o campanie de marketing sau un competitor care a căzut. Înțelegerea impactului real al unei funcționalități separă deciziile informate de date de o ghicire la întâmplare.
Elementul comun este că deciziile depind de a ști de ce s-a întâmplat ceva, nu doar că s-a întâmplat.
Există trei biblioteci care acoperă majoritatea cazurilor de utilizare ML cauzal în Python. Îți voi arăta ce face fiecare și îți voi prezenta un flux de lucru tipic.
Înainte să intrăm în cod, iată un fragment complet care acoperă toate importurile și crearea setului de date. Poți instala dependențele lipsă cu pip sau uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
Setul de date definește 1000 de clienți într-un magazin online, iar eu încerc să estimez efectul cauzal al unui e-mail cu reducere în dolari. Efectul cauzal real al reducerii este de 5 $, dar, după cum poți vedea din output, o comparație naivă supraestimează efectul real pentru că clienții care au primit reduceri aveau deja mai multe achiziții anterioare:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")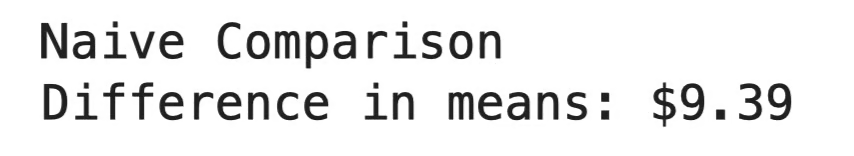
Comparație naivă
DoWhy este un framework creat de Microsoft pentru inferență cauzală cap-coadă. Urmează un proces în patru pași: modelează problema ca un graf cauzal, identifică efectul cauzal, estimează-l și apoi testează dacă estimarea rezistă sub ipoteze diferite.
Ceea ce face DoWhy să iasă în evidență este accentul pe validare. După ce produce o estimare, rulează teste de refutare care îți provoacă rezultatul. Dacă estimarea supraviețuiește acelor teste, poți avea mai multă încredere în ea. Dacă nu, știi că presupunerile tale au nevoie de ajustări.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")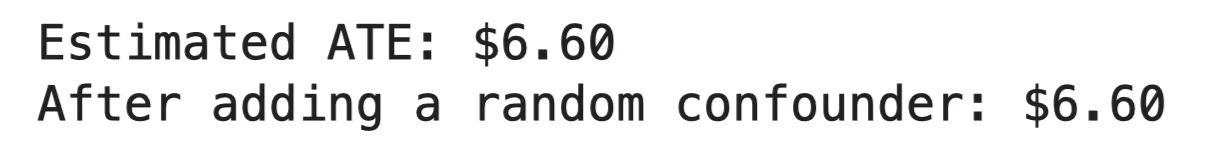
Output DoWhy
În medie, reducerea a crescut suma achiziției cu 6,60 $ per client. Testul de refutare a adăugat o variabilă aleatoare în model, iar estimarea nu s-a schimbat deloc, ceea ce înseamnă că rezultatul nu este determinat de corelații false. Dacă estimarea s-ar fi schimbat mult, ar fi fost un semnal de alarmă că presupunerile cauzale sunt greșite.
EconML, tot de la Microsoft, se concentrează pe estimarea efectelor de tratament eterogene. Sau, pe scurt, cum variază efectul între diferite subgrupuri. Implementează metode precum Double ML și Păduri Cauzale despre care am vorbit mai devreme.
EconML urmează un API familiar stil scikit-learn, cu metode .fit() și .effect().
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")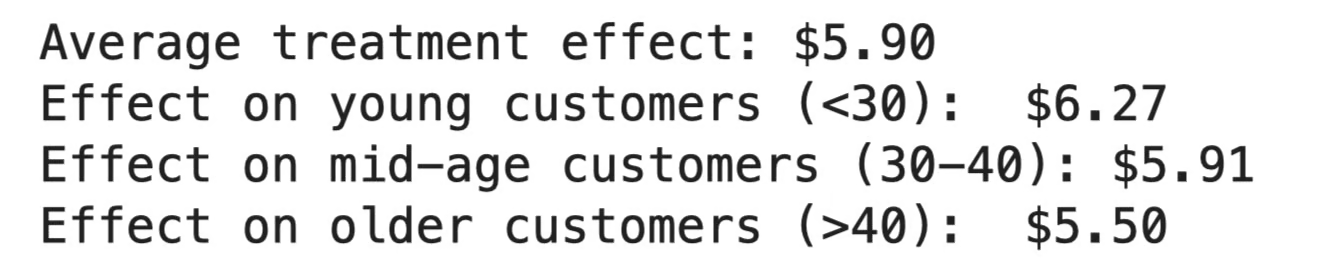
Output EconML
Reducerea a crescut sumele achizițiilor cu 5,90 $ în medie, dar efectul nu a fost uniform. Clienții mai tineri au răspuns cel mai mult (6,27 $), în timp ce clienții mai în vârstă au avut cea mai mică creștere (5,50 $). Dacă bugetul e limitat, asta îți spune unde să direcționezi campania mai întâi.
CausalML, construit de Uber, este conceput pentru uplift modeling - a prezice care indivizi vor răspunde cel mai mult la un tratament. Este deosebit de popular în marketing, unde obiectivul este să vizezi clienții care își vor schimba comportamentul din cauza unei campanii, nu pe cei care ar fi convertit oricum.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())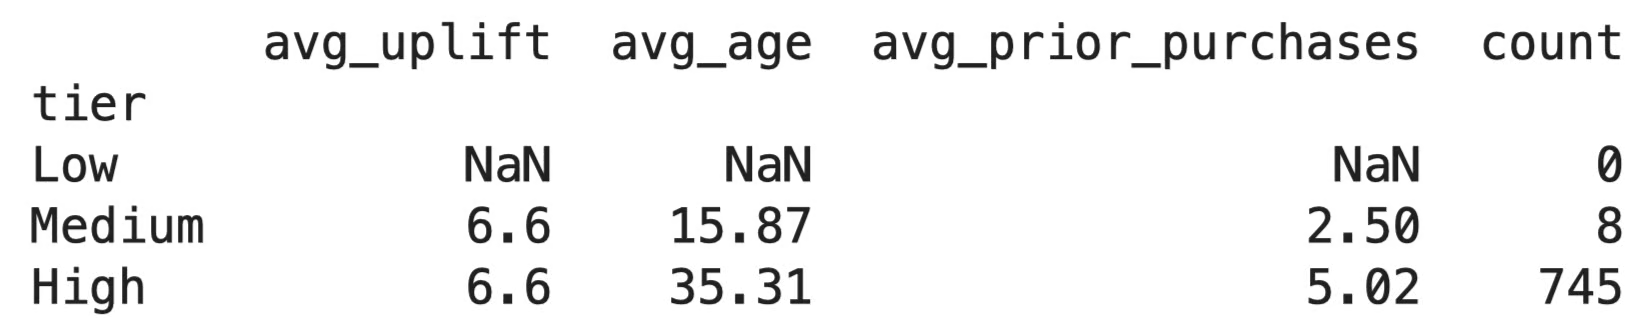
Output CausalML
Scorurile de uplift sunt aproape identice pentru toți clienții, ceea ce înseamnă că reducerea a avut, aproximativ, același efect pentru toți - circa 6,60 $ per persoană. Are sens pentru setul nostru de date sintetic, unde am introdus un efect de tratament constant de 5 $, fără variație pe subgrupuri. În date reale, de obicei vezi o răspândire mai mare, iar acolo straturile de țintire devin utile.
Fiecare bibliotecă are un caz de utilizare ideal. Folosește:
Toate trei funcționează bine împreună. Un tipar comun este să definești graful cauzal în DoWhy, să estimezi efectele cu EconML și să folosești CausalML pentru a interpreta rezultatele.
ML cauzal este uneori ușor de folosit greșit. Iată greșelile care îi derutează cel mai des pe oameni.
Clasicul. Clienții care folosesc mai mult o funcționalitate cheltuiesc și mai mult, așa că concluzionezi că funcționalitatea crește cheltuiala. Dar poate că acei clienți cu cheltuieli mari sunt pur și simplu mai implicați în general. Fără un cadru cauzal, doar ghicești direcția relației.
Orice analiză cauzală începe cu o întrebare: este acesta un tipar sau este o cauză? Dacă sari peste întrebare, niciun volum de modelare nu te va ajuta.
Un confounder afectează atât tratamentul, cât și rezultatul.
Să zicem că măsori efectul unui program de training asupra performanței angajaților. Angajații care se înscriu la training tind să fie mai motivați. Motivația determină atât înscrierea (tratamentul), cât și performanța (rezultatul). Dacă nu o iei în calcul, vei atribui efectul motivației programului de training.
Soluția este mai degrabă structurală decât statistică. Desenează DAG-ul, mapează fiecare variabilă care ar putea influența ambele părți și decide cum să gestionezi fiecare înainte să potrivești un singur model.
Un ATE de 5 $ nu înseamnă că fiecare client a câștigat 5 $. Este o medie, iar mediile ascund multe. Unii clienți pot fi câștigat 15 $, în timp ce alții au pierdut 5 $.
Și inversul e periculos. O estimare CATE pentru un subgrup nu înseamnă că fiecare individ din acel grup va răspunde la fel. Efectele tratamentului sunt estimări cu incertitudine, nu garanții. Verifică întotdeauna intervalele de încredere și nu lua decizii de țintire doar pe baza estimărilor punctuale.
Numărul pe care ți-l dă EconML sau DoWhy e la fel de bun ca presupunerile din spatele lui. Un model nu poate răspunde la întrebări precum:
Acestea cer pe cineva care înțelege problema. O pădure cauzală va produce cu plăcere estimări ale efectelor tratamentului dintr-un model prost specificat - pur și simplu nu îți va spune că sunt greșite.
Cele mai bune analize cauzale combină abilitatea ML de a gestiona date complexe cu un om care știe ce variabile contează și de ce.
ML cauzal schimbă întrebarea din "ce se va întâmpla?" în "ce a cauzat să se întâmple?"
Această schimbare îți schimbă modul de a lua decizii. Te face să treci de la a reacționa la tipare la a înțelege mecanismele din spatele lor. Unii ar spune chiar că este singura cale de a lua decizii cu adevărat bazate pe date.
Dar instrumentele funcționează doar la fel de bine ca presupunerile pe care le oferi. Un graf cauzal greșit sau un efect de tratament interpretat greșit te pot conduce la concluzii care par „științifice” și bazate pe date, dar sunt greșite. Modelul nu va ridica mâna să-ți spună.
Cele mai bune rezultate vin din combinarea capacității ML de a gestiona date complexe cu cineva care înțelege suficient de bine problema încât să pună întrebările cauzale potrivite. Începe cu cunoștințele de domeniu, apoi lasă modelul să facă treaba grea. Atât tot.
Prima parte e ușoară, mai ales cu cursul nostru Învățare supervizată cu scikit-learn. Înscrie-te azi ca să-ți dezvolți abilitățile de machine learning cu o bibliotecă Python esențială.
Învăță cu DataCamp
course
course
course