course
Understanding Machine Learning
2 घंटा
307.3K
क्या आप कभी ऐसी स्थिति में रहे हैं जहाँ आपका मशीन लर्निंग मॉडल यह तो भविष्यवाणी कर देता है कि कौन खरीदेगा, लेकिन यह नहीं बता पाता कि उन्होंने क्यों खरीदा?
पारंपरिक मशीन लर्निंग पैटर्न पहचानती है और नतीजे का अनुमान लगाती है। यह बताएगी कि कोई ग्राहक churn करने वाला है या अगले तिमाही में बिक्री घटेगी। लेकिन अगर आप पूछें कि क्या आपकी ताज़ा मार्केटिंग मुहिम ने वाकई बिक्री बढ़ाई, या किसी उपचार से सच में रोगियों के नतीजे सुधरे—तो इसे समझ नहीं आता। भविष्यवाणी और कारण—ये दो अलग बातें हैं।
कारणात्मक मशीन लर्निंग, मशीन लर्निंग को कारण-निर्वचन (causal inference) तकनीकों के साथ जोड़ती है। तो, "क्या होगा?" पूछने के बजाय यह पूछती है, "अगर हम हस्तक्षेप करें तो क्या होगा?"—और यही सवाल हर व्यावसायिक फ़ैसले या चिकित्सा उपचार के पीछे होता है।
इस लेख में, मैं आपको कारणात्मक ML के मूल सिद्धांतों, कारण-प्रभाव का अनुमान लगाने की विधियों, और उन्हें Python में लागू करने के तरीकों से रूबरू कराऊँगा।
अगर आप मशीन लर्निंग में नए हैं, तो हमारे शुरुआती-अनुकूल Machine Learning Fundamentals in Python ट्रैक में नामांकन करें।
मानक ML मॉडल डेटा से पैटर्न सीखते हैं और उनसे भविष्यवाणी करते हैं। वे "क्या होने वाला है?" का जवाब अच्छे से देते हैं, लेकिन यह नहीं बताते कि वह क्यों हुआ।
कारणात्मक मशीन लर्निंग अलग सवाल पूछती है। यह ML को कारण-निर्वचन तकनीकों के साथ मिलाकर डेटा से कारण-प्रभाव संबंधों का अनुमान लगाती है। यानी नतीजा भविष्यवाणी करने के बजाय, यह अनुमान लगाती है कि अगर आप कोई विशेष कदम उठाएँ तो क्या बदलेगा।
उस कदम को intervention कहा जाता है—यानी प्रभाव देखने के लिए आप जो जानबूझकर बदलाव करते हैं। क्या छूट (discount) ने सच में ज़्यादा ख़रीदारी करवाई, या वे ग्राहक वैसे भी खरीदते? क्या नई दवा से रिकवरी में सुधार हुआ, या मरीज़ अपने-आप ठीक हो गए?
ये ऐसे सवाल हैं जिनका जवाब भविष्यवाणी नहीं दे सकती, लेकिन कारणात्मक ML दे सकती है।
पारंपरिक ML सहसंबंध (correlations) सीखती है। यह पाती है कि जिन्हें छूट वाले ईमेल मिलते हैं, वे ज़्यादा खरीदते हैं, और इस पैटर्न से भविष्य की खरीदारी का अनुमान लगाती है। लेकिन सहसंबंध यह नहीं बताता कि ईमेल ने खरीदारी करवाई। हो सकता है वे ग्राहक पहले से खरीदने वाले थे।
कारणात्मक ML खरीद पर ईमेल के कारण-प्रभाव का अनुमान लगाती है। यह पूछती है कि अगर आपने ईमेल नहीं भेजा होता तो क्या होता। "ये चीज़ें साथ-साथ दिखती हैं" और "इस चीज़ ने वह चीज़ करवाई"—इन दोनों के फर्क से पारंपरिक और कारणात्मक ML अलग होती हैं।
इसे सरल तरीके से ऐसे समझें:
पहला आपको भविष्यवाणी करने में मदद करता है। दूसरा आपको फ़ैसला लेने में। दोनों उपयोगी हैं।
अधिकांश व्यावसायिक और नीतिगत फ़ैसले स्वभाव से कारणात्मक होते हैं। आप "क्या होगा?" नहीं, बल्कि "हमें क्या करना चाहिए?" पूछते हैं।
यहाँ कुछ ठोस उदाहरण हैं:
मानक मशीन लर्निंग तरीके इन सवालों का जवाब नहीं दे सकते क्योंकि वे सहसंबंध को फीचर की तरह मानते हैं। जो चर साथ चलते हैं, उनके पीछे कोई साझा कारण हो सकता है, या संबंध महज़ संयोग हो सकता है। कारणात्मक ML आपको सोचना सिखाती है कि चीज़ें क्यों जुड़ी हैं—और क्या एक को बदलने से सच में दूसरी बदलेगी।
कारण-प्रभाव का अनुमान लगाने से पहले, कुछ बुनियादी बातें समझना ज़रूरी है जिन पर हर कारणात्मक विश्लेषण टिका होता है।
हर कारणात्मक सवाल के दो हिस्से होते हैं: उपचार और परिणाम।
उपचार वह कार्रवाई या हस्तक्षेप है जिसका आप अध्ययन कर रहे हैं—जैसे मरीज़ों को दी गई दवा, या ग्राहकों को दी गई छूट। परिणाम वह है जिसे आप मापते हैं—जैसे रिकवरी समय, खरीद दर, या उत्पादकता।
कारणात्मक ML का लक्ष्य यह अनुमान लगाना है कि उपचार परिणाम को कैसे बदलता है। यह यह नहीं मापती कि दोनों सहसंबद्ध हैं या नहीं, बल्कि क्या एक वास्तव में दूसरे का कारण है।
आप देख सकते हैं कि दवा लेने के बाद क्या हुआ, लेकिन यह नहीं देख सकते कि अगर दवा नहीं ली होती तो क्या होता। उस अनदेखे परिदृश्य को counterfactual कहते हैं।
किसी और संदर्भ में, मान लें किसी ग्राहक को 20% छूट मिली और उसने खरीदारी की। counterfactual पूछता है: क्या वह बिना छूट के भी खरीदता? आप इसे कभी पक्के तौर पर नहीं जान पाएँगे, क्योंकि समय को पलटकर एक ही व्यक्ति पर दोनों संस्करण नहीं चला सकते।
कारणात्मक ML सांख्यिकीय तकनीकों और मान्यताओं से इन counterfactuals का अनुमान लगाती है। आपके कारणात्मक अनुमान की गुणवत्ता इस पर निर्भर करती है कि आप अनदेखे को कितनी अच्छी तरह निकटानुमानित कर पाते हैं।
Confounder वह चर है जो उपचार और परिणाम—दोनों को प्रभावित करता है, और यूँ कारण का झूठा आभास पैदा करता है।
उदाहरण के लिए, आप जाँच रहे हैं कि क्या व्यायाम से हृदय रोग घटता है। जो लोग अधिक व्यायाम करते हैं वे अक्सर बेहतर खान-पान भी रखते हैं। आहार, व्यायाम (उपचार) की संभावना और हृदय रोग (परिणाम)—दोनों को प्रभावित करता है। यदि आप आहार को नज़रअंदाज़ करते हैं, तो आप केवल व्यायाम के असर को बढ़ा-चढ़ाकर आँकेंगे।
Confounders कारणात्मक विश्लेषण के सबसे बड़े खतरे हैं। इन्हें पहचानना और इनके लिए हिसाब रखना ही किसी कारणात्मक अनुमान को विश्वसनीय बनाता है—और इसी पर समय देना चाहिए।
अगर आप सोच रहे हैं कि किन चरों को confounder मानें और किन्हें नहीं—तो इसका जवाब है: एक ग्राफ़ बनाइए।
एक directed acyclic graph (DAG) एक आरेख है जो चरों के बीच कारणात्मक संबंधों का नक्शा बनाता है। हर नोड एक चर दर्शाता है, और हर तीर कारण से प्रभाव की ओर इशारा करता है। "Directed" का मतलब तीरों की दिशा होती है। "Acyclic" का मतलब लूप नहीं होते—कोई चर सीधे या श्रृंखला के ज़रिए स्वयं का कारण नहीं बन सकता।
पहले वाले व्यायाम के उदाहरण को लें। एक सरल DAG में Diet → Exercise और Diet → Heart Disease, साथ ही Exercise → Heart Disease के तीर होंगे। ग्राफ़ साफ़ दिखाता है कि Diet एक confounder है क्योंकि उसके तीर उपचार और परिणाम—दोनों की ओर जाते हैं।
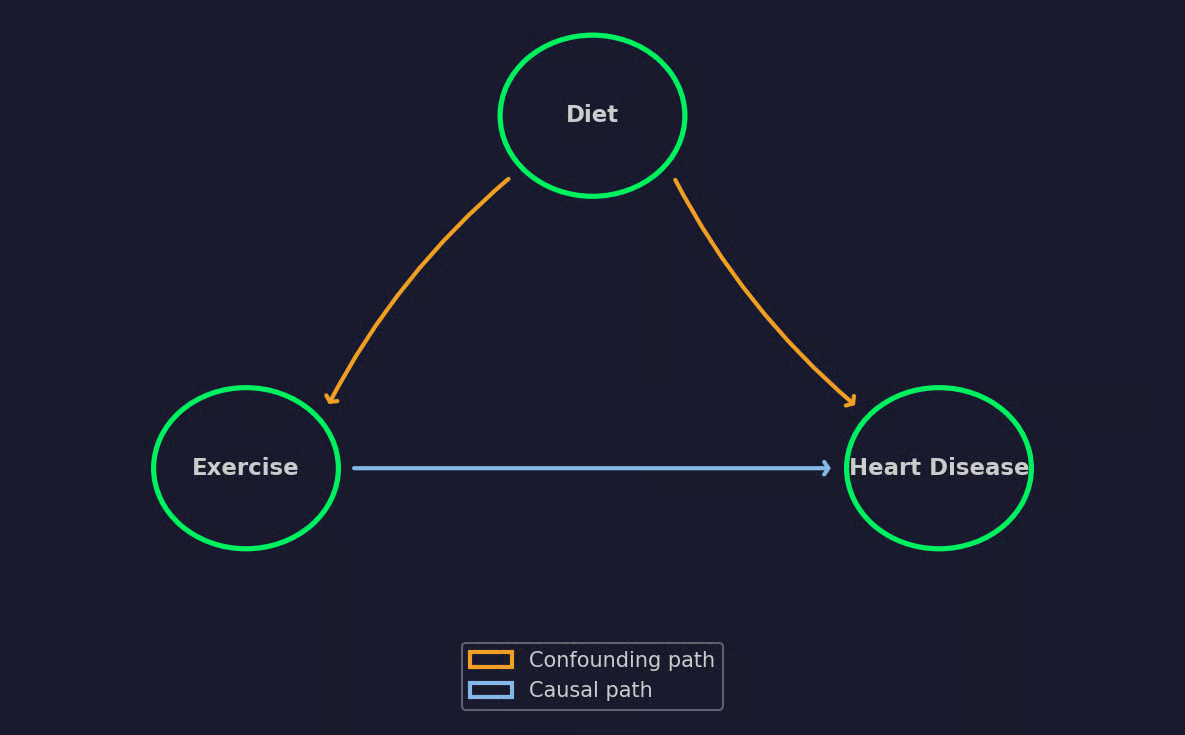
एक सरल DAG उदाहरण
DAG यह भी बताते हैं कि किन चरों को नियंत्रित करना है और किन्हें नहीं छेड़ना। अगर आप गलत चर को नियंत्रित कर लें, तो पक्षपात हटाने के बजाय जोड़ भी सकते हैं। इसे ध्यान में रखते हुए, DAG को अपने पूरे कारणात्मक विश्लेषण का रोडमैप समझें।
सबसे अच्छी बात?
DAG बनाने के लिए आपको गणित नहीं, क्षेत्र-ज्ञान चाहिए। ग्राफ़ आपकी दुनिया-सम्बन्धी मान्यताओं को एन्कोड करता है, और आपके कारणात्मक अनुमानों की गुणवत्ता इस पर निर्भर करती है कि वे मान्यताएँ कितनी सही हैं।
कारणात्मक ML आँकड़ों और इकोनोमेट्रिक्स से बहुत कुछ उधार लेती है, और इन्हें मशीन लर्निंग से स्केल करती है। मैं चार सबसे आम तरीकों से गुज़ारूँगा।
आदर्श दुनिया में, आप उपचार के असर को मापने के लिए यादृच्छिक प्रयोग चलाएँगे। पर व्यवहार में उपचार असाइनमेंट शायद ही रैंडम होता है। जो लोग उपचार पाते हैं, वे अक्सर उनसे अलग होते हैं जो नहीं पाते—और ये फर्क पक्षपात लाते हैं।
प्रोपेन्सिटी स्कोर विधियाँ, देखे गए लक्षणों के आधार पर, किसी व्यक्ति को उपचार मिलने की संभावना का अनुमान लगाती हैं। इसी संभावना को प्रोपेन्सिटी स्कोर कहते हैं।
स्कोर मिल जाने पर, उन्हें उपयोग करने के दो मुख्य तरीके हैं:
दोनों तरीके प्रेक्षणीय डेटा से ऐसा परिदृश्य रचने की कोशिश करते हैं जैसा किसी यादृच्छिक प्रयोग में दिखता।
कभी-कभी जिन confounders को आपको नियंत्रित करना है, वे आपके डेटा में होते ही नहीं। आप उन्हें माप नहीं सकते, तो प्रोपेन्सिटी स्कोर काम नहीं आएँगे। यहीं instrumental variables (IV) काम आते हैं।
एक instrument वह चर है जो उपचार को प्रभावित करता है, लेकिन परिणाम पर उसका सीधा असर नहीं होता। वह केवल उपचार के माध्यम से ही परिणाम को प्रभावित करता है।
क्लासिक उदाहरण है—शिक्षा का कमाई पर प्रभाव। प्रेरणा (motivation) शिक्षा की मात्रा और कमाई—दोनों को प्रभावित करती है, पर प्रेरणा सीधे मापी नहीं जाती। निकटतम कॉलेज तक की दूरी एक instrument बन सकती है, क्योंकि वह कॉलेज जाने की संभावना को प्रभावित करती है, लेकिन सीधे भविष्य की सैलरी को नहीं।
व्यवहार में, अच्छा instrument मिलना कठिन है। जब हो, तो यह तरीका बेहतरीन है; पर कमज़ोर या अमान्य instrument भ्रामक नतीजे देगा।
कारणात्मक फ़ॉरेस्ट्स random forest एल्गोरिद्म का विस्तार हैं—ये भविष्यवाणी करने के बजाय उपचार-प्रभाव का अनुमान लगाते हैं। एक साधारण रैंडम फ़ॉरेस्ट नतीजे की भविष्यवाणी करता है, जबकि कारणात्मक फ़ॉरेस्ट यह आँकता है कि अलग-अलग उपसमूहों में उपचार उस नतीजे को कितना बदलता है।
जब उपचार-प्रभाव व्यक्तियों में भिन्न होता है, यह उपयोगी है। दवा युवाओं पर बेहतर काम कर सकती है, बुजुर्गों पर नहीं। उसी तरह, छूट मूल्य-संवेदी ग्राहकों में खरीद बढ़ा सकती है, वफादार खरीदारों पर असर नहीं। कारणात्मक फ़ॉरेस्ट्स डेटा को उन विशेषताओं पर बाँटते हैं जो उपचार-प्रभाव में सबसे बड़ा अंतर दिखाती हैं।
आउटपुट आपके डेटासेट के हर व्यक्ति के लिए वैयक्तिकृत उपचार-प्रभाव का अनुमान होता है।
Double machine learning (DML) ML मॉडलों को सांख्यिकीय निर्वचन के साथ मिलाकर दोनों का बेहतरीन संगम करता है।
आप एक ML मॉडल से परिणाम की भविष्यवाणी करते हैं और दूसरे से उपचार असाइनमेंट की। फिर शेषांश (residuals)—यानी जो हिस्से दोनों मॉडल नहीं समझा सके—को देखते हैं, और उनके संबंध से कारणात्मक प्रभाव मिलता है।
अगर आप सोच रहे हैं यह अतिरिक्त चरण क्यों—तो जवाब है: ML मॉडल पैटर्न पकड़ने में बेहतरीन हैं, पर कारणात्मक अनुमान में पक्षपात ला सकते हैं। DML इसे cross-fitting से हटाता है—जहाँ आप ओवरफिटिंग से बचने के लिए डेटा के अलग-अलग विभाजनों पर ट्रेन और प्रेडिक्ट करते हैं।
एक तरीका चुन लेने के बाद, आपको उसके निष्कर्षों का सार बताने का उपाय चाहिए। यहीं उपचार-प्रभाव मीट्रिक्स काम आते हैं।
Average Treatment Effect (ATE) आपके पूरे जनसमूह पर उपचार के औसत कारणात्मक प्रभाव को मापता है। अगर किसी डिस्काउंट कैंपेन का ATE $5 है, तो मतलब औसतन छूट से प्रति ग्राहक खर्च $5 बढ़ा।
ATE बड़ी तस्वीर देता है, पर व्यक्तिगत भिन्नता छिप जाती है। $5 का औसत यह भी हो सकता है कि सबने $5 ज़्यादा खर्च किया, या यह कि आधों ने $10 बढ़ाया और बाकी आधों में कोई बदलाव नहीं हुआ।
Conditional Average Treatment Effect (CATE) विशिष्ट विशेषताओं पर आधारित उपसमूहों के लिए उपचार-प्रभाव का अनुमान लगाता है। यानी एक ही संख्या के बजाय, CATE बताएगा कि छूट ने नए ग्राहकों में खर्च $8 बढ़ाया, जबकि लौटकर आने वालों में केवल $2।
CATE कारणात्मक ML को क्रियान्वयन योग्य बनाता है। ATE बताता है कि हस्तक्षेप काम करता है या नहीं। CATE बताता है कि किसके लिए काम करता है—और डेटा-आधारित फ़ैसलों के लिए आपको यही जवाब चाहिए।
जहाँ भी आपको "क्या हुआ?" से "हमें क्या करना चाहिए?" की ओर बढ़ना हो, वहाँ कारणात्मक ML काम आती है। यहाँ कुछ उदाहरण हैं।
अस्पताल जानना चाहता है कि किसी विशेष मरीज़ प्रोफ़ाइल के लिए कौन-सा उपचार बेहतर काम करता है। मानक ML जोखिम का अनुमान लगा सकती है, लेकिन कारणात्मक ML आँकती है कि उस खास मरीज़ के लिए उपचार A या उपचार B में कौन-सा बेहतर नतीजा देगा। इससे जनसमूह के औसत पर नहीं, अनुमानित प्रभावों पर आधारित वैयक्तिकृत उपचार-फ़ैसले संभव होते हैं।
एक मार्केटिंग टीम ने प्रचार मुहिम चलाई और बिक्री में उछाल दिखा। सवाल है—क्या मुहिम ने उछाल कराया, या यह मौसमी मांग से था? कारणात्मक ML टाइमिंग, ग्राहक जनसांख्यिकी और पिछली खरीदारी जैसे confounders का हिसाब रखकर वास्तविक प्रभाव अलग करती है।
सरकारें और संस्थाएँ जानना चाहती हैं कि नीतियाँ इच्छित नतीजे देती हैं या नहीं। क्या नौकरी-प्रशिक्षण कार्यक्रम ने बेरोज़गारी घटाई? क्या कर-प्रोत्साहन से निवेश बढ़ा? जब यादृच्छिक परीक्षण व्यवहार्य नहीं होते, कारणात्मक ML नीतिगत मूल्यांकन का ढाँचा देती है।
प्रोडक्ट टीम ने नया फ़ीचर जोड़ा और एंगेजमेंट बढ़ गया। कारणात्मक ML यह तय करने में मदद करती है कि क्या फ़ीचर ने बढ़ोतरी कराई या यह अन्य बदलावों—जैसे मार्केटिंग पुश या प्रतिस्पर्धी के डाउन होने—के साथ संयोग था। किसी फ़ीचर के वास्तविक प्रभाव को समझना, डेटा-सूचित फ़ैसलों को अनुमान से अलग करता है।
साझा सूत्र यही है: फ़ैसले इस पर निर्भर करते हैं कि कुछ क्यों हुआ—सिर्फ़ इस पर नहीं कि वह हुआ।
Python में तीन लाइब्रेरीज़ हैं जो ज़्यादातर कारणात्मक ML उपयोग-केस कवर करती हैं। मैं बताऊँगा कि हर एक क्या करती है और एक सामान्य कार्यप्रवाह दिखाऊँगा।
कोड में जाने से पहले, यहाँ एक पूरा स्निपेट है जिसमें सभी इम्पोर्ट्स और डेटासेट निर्माण शामिल हैं। आप कोई भी मिसिंग डिपेंडेंसी pip या uv से इंस्टॉल कर सकते हैं।
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
यह डेटासेट एक ई-कॉमर्स स्टोर के 1000 ग्राहकों को परिभाषित करता है, और मैं डॉलर में छूट ईमेल के कारणात्मक प्रभाव का अनुमान लगाने की कोशिश कर रहा हूँ। छूट का वास्तविक कारणात्मक प्रभाव $5 है, लेकिन जैसा कि आउटपुट से दिखता है, एक साधारण तुलना वास्तविक प्रभाव को बढ़ा-चढ़ाकर आँकती है क्योंकि जिन्हें छूट मिली, उनके पहले से अधिक पूर्व-खरीद थे:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")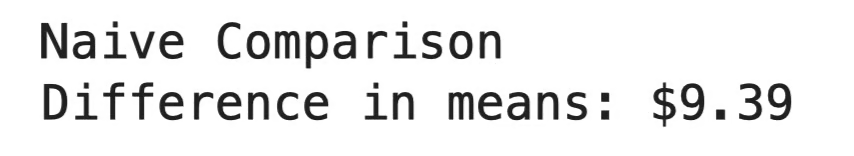
साधारण तुलना
DoWhy Microsoft द्वारा बनाया गया एक एंड-टू-एंड कारण-निर्वचन फ्रेमवर्क है। यह चार-चरणीय प्रक्रिया अपनाता है: समस्या को कारणात्मक ग्राफ़ के रूप में मॉडल करना, कारणात्मक प्रभाव की पहचान करना, उसका अनुमान लगाना, और फिर अलग-अलग मान्यताओं के तहत अनुमान की जाँच करना।
DoWhy की खासियत इसका वैलिडेशन पर ज़ोर है। अनुमान निकालने के बाद यह refutation टेस्ट चलाता है जो आपके नतीजे को चुनौती देते हैं। अगर अनुमान उन परीक्षणों में खरा उतरता है, तो भरोसा बढ़ता है। अगर नहीं, तो आपको पता चल जाता है कि आपकी मान्यताओं में खामी है।
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")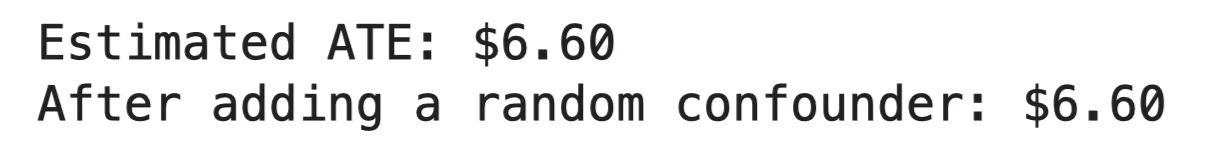
DoWhy आउटपुट
औसतन, छूट ने प्रति ग्राहक खरीद राशि $6.60 बढ़ाई। refutation टेस्ट ने मॉडल में एक रैंडम चर जोड़ा, और अनुमान जरा भी नहीं बदला—मतलब नतीजा झूठे सहसंबंधों से प्रेरित नहीं है। अगर अनुमान बहुत बदलता, तो यह संकेत होता कि कारणात्मक मान्यताएँ ठीक नहीं।
EconML, यह भी Microsoft से, विषम (heterogeneous) उपचार-प्रभावों के अनुमान पर केंद्रित है—साधारण शब्दों में, प्रभाव अलग-अलग उपसमूहों में कैसे बदलता है। इसमें Double ML और Causal Forests जैसे तरीके शामिल हैं जिन्हें मैंने ऊपर कवर किया।
EconML, scikit-learn जैसी API का पालन करता है, जिसमें .fit() और .effect() मेथड होते हैं।
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")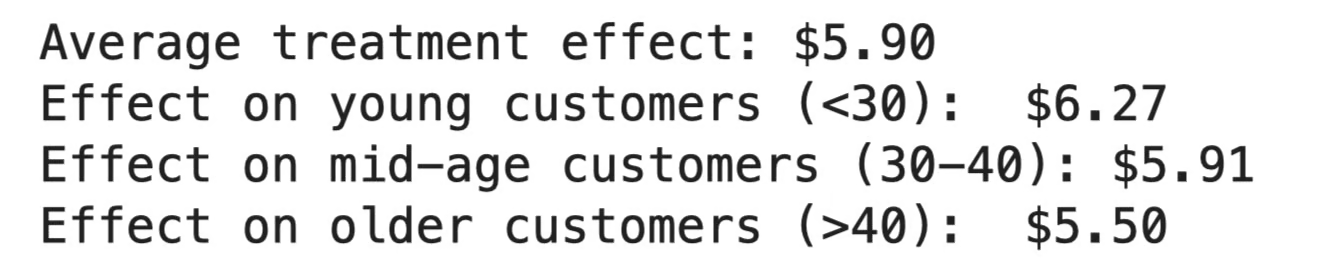
EconML आउटपुट
छूट ने औसतन खरीद राशि $5.90 बढ़ाई, पर प्रभाव समान नहीं था। युवा ग्राहकों में प्रतिक्रिया सबसे अधिक थी ($6.27), जबकि बुजुर्गों में सबसे कम ($5.50)। अगर बजट सीमित है, तो यह बताता है कि अभियान पहले कहाँ केंद्रित करें।
CausalML, Uber द्वारा बनाया गया, uplift modeling के लिए डिज़ाइन किया गया है—यानी यह भविष्यवाणी करना कि कौन-से व्यक्ति उपचार पर सबसे अधिक प्रतिक्रिया देंगे। यह खासकर मार्केटिंग में लोकप्रिय है, जहाँ लक्ष्य उन ग्राहकों को लक्षित करना होता है जो अभियान की वजह से अपना व्यवहार बदलेंगे, न कि वे जो वैसे भी कन्वर्ट हो जाते।
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())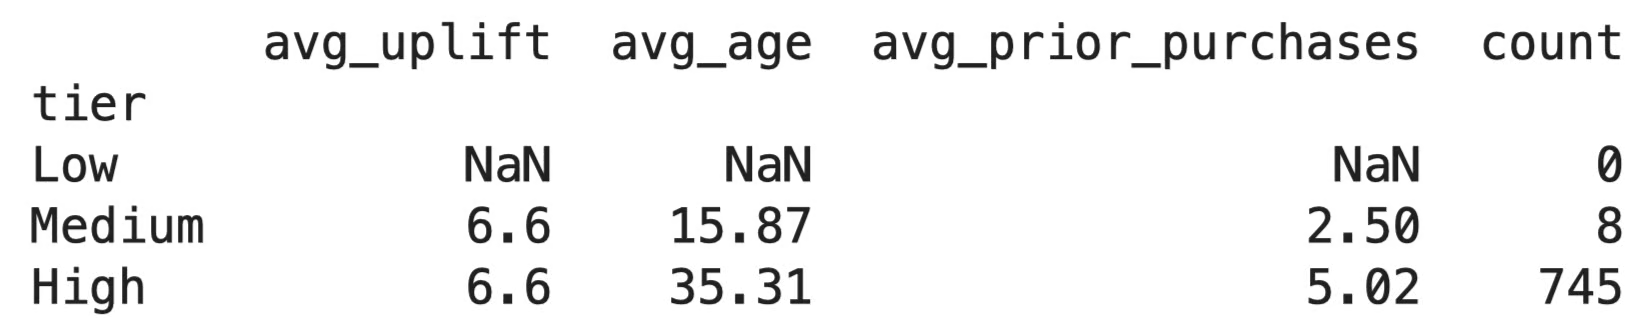
CausalML आउटपुट
uplift स्कोर लगभग सभी ग्राहकों में एक जैसे हैं—मतलब छूट का प्रभाव लगभग सभी पर समान था—लगभग $6.60 प्रति व्यक्ति। यह हमारे सिंथेटिक डेटासेट के अनुरूप है, जहाँ मैंने उपसमूह के हिसाब से बिना परिवर्तन के सपाट $5 का उपचार-प्रभाव रखा है। वास्तविक डेटा में आमतौर पर ज़्यादा फैलाव दिखता है—और यहीं टार्गेटिंग टियर उपयोगी होते हैं।
हर लाइब्रेरी का आदर्श उपयोग-केस है। उपयोग करें:
तीनों साथ भी अच्छे से काम करते हैं। एक सामान्य पैटर्न है—DoWhy में अपना कारणात्मक ग्राफ़ परिभाषित करें, EconML से प्रभावों का अनुमान लगाएँ, और CausalML से नतीजों की व्याख्या करें।
कारणात्मक ML का गलत उपयोग करना आसान है। यहाँ वे गलतियाँ हैं जो सबसे ज्यादा भ्रम पैदा करती हैं।
यह क्लासिक गलती है। जो ग्राहक किसी फ़ीचर का ज़्यादा उपयोग करते हैं, वे ज़्यादा खर्च भी करते हैं—तो आप निष्कर्ष निकाल लेते हैं कि फ़ीचर खर्च बढ़ाता है। लेकिन हो सकता है कि अधिक खर्च करने वाले ग्राहक कुल मिलाकर अधिक संलग्न हों। बिना कारणात्मक ढाँचे के, आप संबंध की दिशा का अनुमान भर लगा रहे हैं।
हर कारणात्मक विश्लेषण एक सवाल से शुरू होता है: क्या यह पैटर्न है, या कारण? अगर आप यह सवाल छोड़ देते हैं, तो कितना भी मॉडलिंग कर लें, मदद नहीं मिलेगी।
Confounder वह है जो उपचार और परिणाम—दोनों को प्रभावित करता है।
मान लें आप किसी प्रशिक्षण कार्यक्रम का कर्मचारी प्रदर्शन पर असर माप रहे हैं। जो कर्मचारी प्रशिक्षण में नाम लिखवाते हैं, वे अक्सर अधिक प्रेरित होते हैं। प्रेरणा नामांकन (उपचार) और प्रदर्शन (परिणाम)—दोनों को बढ़ाती है। अगर आप इसका हिसाब नहीं रखते, तो आप प्रेरणा के प्रभाव को प्रशिक्षण के खाते में लिख देंगे।
समाधान सांख्यिकीय से ज़्यादा संरचनात्मक है। अपना DAG बनाइए, हर उस चर को मैप करिए जो दोनों ओर असर डाल सकता है, और किसी मॉडल को फिट करने से पहले ही तय करिए कि किससे कैसे निपटना है।
$5 का ATE यह नहीं बताता कि हर ग्राहक को $5 का लाभ हुआ। यह औसत है—और औसत बहुत कुछ छुपाते हैं। कुछ को $15 का फ़ायदा हुआ होगा, कुछ को $5 का नुकसान।
उल्टा भी ख़तरनाक है। किसी उपसमूह के लिए CATE का मतलब यह नहीं कि उस समूह के हर व्यक्ति की प्रतिक्रिया एक-सी होगी। उपचार-प्रभाव अनुमान हैं—अनिश्चितता के साथ, गारंटी नहीं। हमेशा कॉन्फिडेंस इंटरवल देखें और केवल पॉइंट-एस्टिमेट पर टार्गेटिंग फ़ैसले न लें।
EconML या DoWhy जो संख्या देते हैं, वे उतनी ही अच्छी हैं जितनी अच्छी उनकी मान्यताएँ। कोई मॉडल इन सवालों का जवाब नहीं दे सकता:
इनके लिए समस्या को समझने वाला व्यक्ति चाहिए। एक कारणात्मक फ़ॉरेस्ट गलत-स्पेसिफ़ाइड मॉडल से भी खुशी-खुशी उपचार-प्रभाव दे देगा—बस यह नहीं बताएगा कि वे गलत हैं।
सबसे अच्छे कारणात्मक विश्लेषण, जटिल डेटा सँभालने में ML की क्षमता और यह जानने वाले इंसान—कि कौन-से चर मायने रखते हैं और क्यों—इन दोनों का मेल होते हैं।
कारणात्मक ML सवाल को "क्या होगा?" से बदलकर "यह क्यों हुआ?" कर देती है।
यह बदलाव आपके फ़ैसले लेने का तरीका बदल देता है। आप पैटर्न्स पर प्रतिक्रिया देने से आगे बढ़कर उनके पीछे की यांत्रिकी समझते हैं। कुछ लोग कहेंगे कि यही असली डेटा-आधारित फ़ैसले लेने का रास्ता है।
लेकिन ये टूल्स उतने ही अच्छे हैं जितनी अच्छी आप उन्हें मान्यताएँ देते हैं। गलत कारणात्मक ग्राफ़ या उपचार-प्रभाव की गलत पढ़ाई आपको ऐसे निष्कर्षों तक पहुँचा सकती है जो "वैज्ञानिक" और डेटा-आधारित लगते हैं, पर गलत होते हैं। मॉडल आपको चेतावनी नहीं देगा।
सबसे अच्छे नतीजे तब मिलते हैं जब ML की जटिल डेटा सँभालने की ताकत, उस व्यक्ति के साथ मिलती है जो समस्या को इतना समझता हो कि सही कारणात्मक सवाल पूछ सके। डोमेन-ज्ञान से शुरुआत करें, फिर मॉडल को भारी काम करने दें। बस इतना ही।
पहला हिस्सा आसान है—खासकर हमारे Supervised Learning with scikit-learn कोर्स के साथ। आज ही नामांकन करें और इस ज़रूरी Python लाइब्रेरी के साथ अपनी मशीन लर्निंग कौशल बढ़ाएँ।
DataCamp के साथ सीखें
course
course
course