Corso
Capire il Machine Learning
2 h
307.3K
Ti è mai capitato che il tuo modello di machine learning sappia prevedere chi comprerà, ma non sappia dirti perché ha comprato?
Il machine learning tradizionale sa individuare schemi e prevedere risultati. Ti dirà che un cliente probabilmente abbandonerà o che le vendite caleranno il prossimo trimestre. Ma se gli chiedi se la tua ultima campagna di marketing ha effettivamente causato più vendite, o se un trattamento ha davvero migliorato gli esiti dei pazienti, non sa cosa fare. Predizione e causalità sono due cose diverse.
Il causal machine learning combina il machine learning con le tecniche di inferenza causale. Quindi, invece di chiedersi "cosa succederà?", si chiede "cosa succede se interveniamo?" - ed è questa la domanda alla base di ogni decisione di business o trattamento medico.
In questo articolo, ti guiderò attraverso i concetti alla base del causal ML, i metodi usati per stimare causa ed effetto e come applicarli in Python.
Se sei alle prime armi con il machine learning, iscriviti al nostro percorso Machine Learning Fundamentals in Python, pensato per principianti.
I modelli di ML standard apprendono schemi dai dati e li usano per fare previsioni. Sono bravi a rispondere a "cosa succederà?" ma non possono dirti cosa l’ha fatto succedere.
Il causal machine learning pone una domanda diversa. Combina ML con tecniche di inferenza causale per stimare relazioni di causa-effetto dai dati. Quindi, invece di prevedere un risultato, stima cosa cambierebbe se facessi una specifica azione.
Quell’azione si chiama intervento e rappresenta un cambiamento deliberato che introduci per vederne l’effetto. Lo sconto ha davvero generato più acquisti, o quei clienti avrebbero comprato comunque? Il nuovo farmaco ha migliorato il recupero, o i pazienti sarebbero migliorati da soli?
Sono domande a cui le previsioni non possono rispondere, ma il causal ML sì.
L’ML tradizionale apprende correlazioni. Trova che i clienti che ricevono email con sconti tendono a comprare di più, e usa questo schema per prevedere acquisti futuri. Ma la correlazione non ti dice se l’email ha causato l’acquisto. Magari quei clienti avevano già intenzione di comprare.
Il causal ML stima l’effetto causale dell’email sugli acquisti. Si chiede cosa sarebbe successo se non l’avessi inviata. La differenza tra "queste cose tendono a comparire insieme" e "questa cosa ha causato quell’altra" è ciò che separa l’ML tradizionale dal causal ML.
Ecco un modo semplice per pensarci:
La prima ti aiuta a prevedere. La seconda ti aiuta a decidere. Entrambe sono utili.
La maggior parte delle decisioni di business e di policy sono per natura causali. Non stai chiedendo "cosa succederà?" - stai chiedendo "cosa dovremmo fare?"
Ecco alcuni esempi concreti:
I metodi di machine learning standard non possono rispondere a nessuna di queste domande perché trattano la correlazione come una caratteristica. Due variabili che si muovono insieme potrebbero condividere una causa comune, oppure la relazione potrebbe essere pura coincidenza. Il causal ML ti obbliga a pensare al perché le cose sono connesse - e se cambiare una cambierà davvero l’altra.
Prima di poter stimare causa ed effetto, devi capire un paio di cose su cui si basa ogni analisi causale.
Ogni domanda causale ha due parti: un trattamento e un esito.
Il trattamento è l’azione o l’intervento che stai studiando. Potrebbe essere un farmaco somministrato ai pazienti, o uno sconto offerto ai clienti. L’esito è ciò che stai misurando, come il tempo di recupero, il tasso di acquisto o la produttività.
L’obiettivo del causal ML è stimare come il trattamento cambia l’esito. Non stima se i due sono correlati, ma se uno causa effettivamente l’altro.
Puoi osservare cosa è successo dopo che un paziente ha preso il farmaco, ma non puoi osservare cosa sarebbe successo se non l’avesse preso. Quello scenario non osservato si chiama controfattuale.
In un altro dominio, diciamo che un cliente ha ricevuto uno sconto del 20% e ha effettuato un acquisto. Il controfattuale chiede: avrebbe comprato senza lo sconto? Non lo saprai mai con certezza perché non puoi riavvolgere il tempo ed eseguire entrambe le versioni sulla stessa persona.
Il causal ML stima questi controfattuali utilizzando tecniche statistiche e assunzioni. La qualità della tua stima causale dipende da quanto bene approssimi ciò che non puoi osservare direttamente.
Un confondente è una variabile che influenza sia il trattamento sia l’esito, creando una falsa impressione di causalità.
Per esempio, supponi di studiare se l’esercizio fisico riduca le malattie cardiache. Le persone che si allenano di più tendono anche a mangiare più sano. La dieta influisce sia sulla probabilità di fare esercizio (trattamento) sia sulle malattie cardiache (esito). Se ignori la dieta, sovrastimerai quanto conti l’esercizio da solo.
I confondenti sono la minaccia più grande per l’analisi causale. Identificarli e tenerne conto è ciò che rende affidabile una stima causale, ed è qualcosa su cui vale la pena investire tempo.
Se ti stai chiedendo come capire quali variabili sono confondenti e quali no, beh, disegni un grafo.
Un directed acyclic graph (DAG) è un diagramma che mappa le relazioni causali tra variabili. Ogni nodo rappresenta una variabile, e ogni freccia punta da una causa al suo effetto. "Directed" significa che le frecce hanno una direzione. "Acyclic" significa che non ci sono cicli - una variabile non può causare se stessa, né direttamente né tramite una catena.
Prendi l’esempio dell’esercizio di prima. Un DAG semplice avrebbe frecce da Dieta - Esercizio e Dieta - Malattie cardiache, più una freccia da Esercizio - Malattie cardiache. Il grafo rende ovvio che la Dieta è un confondente perché ha frecce che puntano sia al trattamento sia all’esito.
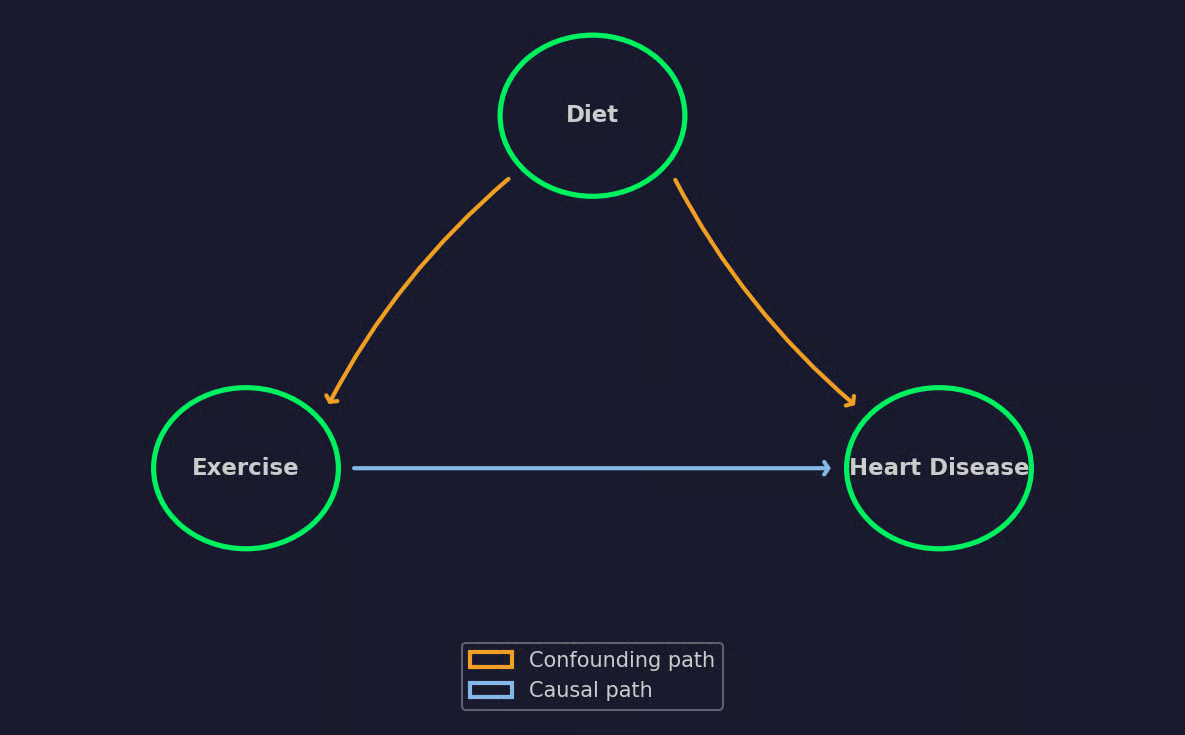
Un semplice esempio di DAG
I DAG ti dicono anche quali variabili controllare e quali lasciare stare. Se controlli la variabile sbagliata, puoi introdurre bias invece di rimuoverlo. Con questo in mente, pensa a un DAG come a una mappa dell’intera analisi causale.
La parte migliore?
Non ti serve la matematica per costruire un DAG. Ti serve solo la conoscenza del dominio. Il grafo codifica le tue assunzioni su come funziona il mondo, e la qualità delle stime causali dipende dal fatto che quelle assunzioni siano corrette.
Il causal ML prende molto dalla statistica e dall’econometria, ma scala queste idee con il machine learning. Ti guiderò attraverso i quattro approcci più comuni.
In un mondo ideale, eseguiresti un esperimento randomizzato per misurare l’effetto di un trattamento. Ma nella pratica, l’assegnazione ai trattamenti è raramente casuale. Le persone che ricevono il trattamento spesso differiscono da quelle che non lo ricevono - e queste differenze creano bias.
I metodi del propensity score affrontano questo problema stimando la probabilità che ciascun individuo riceva il trattamento, in base alle sue caratteristiche osservate. Questa probabilità è il propensity score.
Una volta calcolati i punteggi, ci sono due modi principali per usarli:
Entrambi i metodi provano a simulare come sarebbe stato un esperimento randomizzato, usando dati osservazionali.
A volte i confondenti che devi controllare non sono nei tuoi dati. Non puoi misurarli, quindi i propensity score non aiutano. Qui entrano in gioco le variabili strumentali (IV).
Uno strumento è una variabile che influenza il trattamento ma non ha un effetto diretto sull’esito. Influenza l’esito solo attraverso il trattamento.
Un esempio classico è studiare l’effetto dell’istruzione sui guadagni. La motivazione influisce sia su quanta istruzione si ottiene sia su quanto si guadagna - ma non puoi misurare direttamente la motivazione. La distanza dal college più vicino funziona come strumento perché influenza se qualcuno frequenta il college, ma non influisce direttamente sul salario futuro.
Nella pratica, trovare un buon strumento è difficile. Il metodo è ottimo quando ne hai uno, ma uno strumento debole o non valido produrrà risultati fuorvianti.
I causal forest estendono l’algoritmo di random forest per stimare effetti di trattamento invece di previsioni. Una random forest standard predice un esito, mentre una causal forest stima di quanto il trattamento cambia quell’esito per diversi sottogruppi.
Questo è utile quando l’effetto del trattamento varia tra gli individui. Un farmaco potrebbe funzionare bene per i pazienti più giovani ma non per quelli più anziani. Allo stesso modo, uno sconto potrebbe aumentare gli acquisti per i clienti sensibili al prezzo ma non avere alcun effetto sui clienti fedeli. Le causal forest rilevano queste differenze dividendo i dati in base alle caratteristiche che producono la maggiore variazione degli effetti di trattamento.
L’output è una stima personalizzata dell’effetto di trattamento per ciascun individuo nel dataset.
Il double machine learning (DML) combina modelli di ML con inferenza statistica per avere il meglio di entrambi i mondi.
Usi un modello di ML per prevedere l’esito e un altro per prevedere l’assegnazione al trattamento. Poi guardi i residui (le parti che nessun modello è riuscito a spiegare), e la relazione tra loro ti dà l’effetto causale.
Se ti stai chiedendo perché i passaggi extra, ecco la risposta. I modelli di ML sono ottimi nel catturare schemi, ma introducono bias quando usati per la stima causale. Il DML rimuove quel bias tramite una tecnica chiamata cross-fitting, in cui alleni e predici su split diversi dei dati per evitare overfitting.
Una volta scelto un metodo, ti serve un modo per riassumere ciò che ha trovato. Qui entrano in gioco le metriche di effetto del trattamento.
L’Average Treatment Effect (ATE) misura l’effetto causale medio del trattamento sull’intera popolazione. Se l’ATE di una campagna di sconti è di 5 $, significa che, in media, lo sconto ha aumentato la spesa di 5 $ per cliente.
L’ATE ti dà il quadro generale, ma nasconde la variazione individuale. Una media di 5 $ potrebbe significare che tutti hanno speso 5 $ in più, oppure che metà dei clienti ha speso 10 $ in più mentre l’altra metà non ha visto cambiamenti.
Il Conditional Average Treatment Effect (CATE) stima l’effetto del trattamento per sottogruppi specifici in base alle loro caratteristiche. Quindi, invece di un unico numero per tutti, il CATE ti dice che lo sconto ha aumentato la spesa di 8 $ per i nuovi clienti ma solo di 2 $ per quelli di ritorno.
Il CATE rende il causal ML azionabile. L’ATE ti dice se un intervento funziona. Il CATE ti dice per chi funziona - ed è la risposta di cui hai bisogno per prendere decisioni basate sui dati.
Il causal ML appare ovunque tu debba passare da "cosa è successo?" a "cosa dovremmo fare?" Ecco un paio di esempi.
Un ospedale vuole sapere quale trattamento funziona meglio per uno specifico profilo di paziente. L’ML standard può prevedere chi è a rischio, ma il causal ML stima se il Trattamento A o il Trattamento B produrrà un esito migliore per quel particolare paziente. Questo consente decisioni terapeutiche personalizzate basate su effetti stimati anziché su medie di popolazione.
Un team marketing lancia una campagna promozionale e vede un picco nelle vendite. La domanda è: la campagna ha causato il picco o è stato dovuto alla domanda stagionale? Il causal ML isola il vero impatto della campagna tenendo conto di confondenti come tempistiche, demografia dei clienti e comportamenti d’acquisto precedenti.
Governi e istituzioni devono valutare se le policy producono i risultati desiderati. Un programma di formazione ha ridotto la disoccupazione? Un incentivo fiscale ha aumentato gli investimenti? Il causal ML fornisce un framework per la valutazione delle policy quando i trial randomizzati non sono pratici o possibili.
Un team di prodotto aggiunge una nuova funzionalità e l’engagement aumenta. Il causal ML aiuta a determinare se la funzionalità ha causato l’aumento o se è coincisa con altri cambiamenti - come una spinta di marketing o un competitor down. Capire l’impatto reale di una funzionalità separa le decisioni informate dai dati dal tirare a indovinare.
Il filo conduttore è che le decisioni dipendono dal sapere perché qualcosa è successo, non solo dal fatto che sia successo.
Ci sono tre librerie che coprono la maggior parte dei casi d’uso del causal ML in Python. Ti spiegherò cosa fa ciascuna e ti mostrerò un tipico workflow.
Prima di entrare nel codice, ecco uno snippet completo che copre tutti gli import e la creazione del dataset. Puoi installare le dipendenze mancanti con pip o uv.
import numpy as np
import pandas as pd
from dowhy import CausalModel
from econml.dml import DML
from sklearn.ensemble import RandomForestRegressor, RandomForestClassifier
from sklearn.linear_model import LinearRegression
from causalml.inference.meta import LRSRegressor

np.random.seed(42)

# Generate synthetic data
n = 1000
customer_age = np.random.normal(35, 10, n)
prior_purchases = np.random.poisson(5, n)

# Treatment: whether the customer received a discount email
# Older customers with more purchases were more likely to get one
propensity = 1 / (1 + np.exp(-(0.03 * customer_age + 0.1 * prior_purchases - 2)))
discount = np.random.binomial(1, propensity)

# Outcome: purchase amount in dollars
# True causal effect of the discount is $5
purchase_amount = (
    50
    + 5 * discount
    + 0.5 * customer_age
    + 2 * prior_purchases
    + np.random.normal(0, 10, n)
)

df = pd.DataFrame({
    "customer_age": customer_age,
    "prior_purchases": prior_purchases,
    "discount": discount,
    "purchase_amount": purchase_amount
})

features = df[["customer_age", "prior_purchases"]].values
treatment = df["discount"].values
outcome = df["purchase_amount"].values
Il dataset definisce 1000 clienti in un e-commerce, e sto cercando di stimare l’effetto causale di un’email con sconto in dollari. Il vero effetto causale dello sconto è di 5 $, ma come si vede dall’output, un confronto ingenuo sovrastima il vero effetto perché i clienti che hanno ricevuto sconti avevano già più acquisti precedenti:
naive_ate = (
    df[df["discount"] == 1]["purchase_amount"].mean()
    - df[df["discount"] == 0]["purchase_amount"].mean()
)
print("Naive Comparison")
print(f"Difference in means: ${naive_ate:.2f}")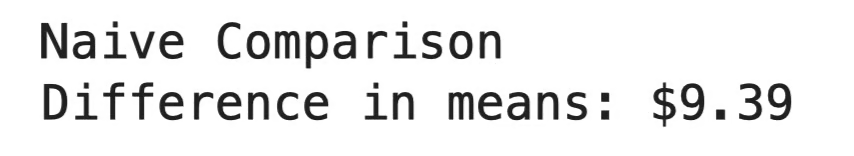
Confronto ingenuo
DoWhy è un framework creato da Microsoft per l’inferenza causale end-to-end. Segue un processo in quattro fasi: modellare il problema come grafo causale, identificare l’effetto causale, stimarlo e poi testare se la stima regge sotto diverse assunzioni.
Ciò che distingue DoWhy è l’attenzione alla validazione. Dopo aver prodotto una stima, esegue test di confutazione che mettono alla prova il risultato. Se la stima supera questi test, puoi fidarti di più. Se non li supera, sai che le tue assunzioni vanno riviste.
model = CausalModel(
    data=df,
    treatment="discount",
    outcome="purchase_amount",
    common_causes=["customer_age", "prior_purchases"]
)

identified_estimand = model.identify_effect()
estimate = model.estimate_effect(
    identified_estimand,
    method_name="backdoor.linear_regression"
)

refutation = model.refute_estimate(
    identified_estimand,
    estimate,
    method_name="random_common_cause"
)

print(f"Estimated ATE: ${estimate.value:.2f}")
print(f"After adding a random confounder: ${refutation.new_effect:.2f}")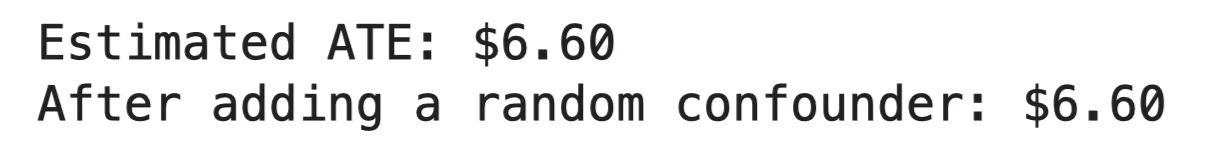
Output di DoWhy
In media, lo sconto ha aumentato l’importo d’acquisto di 6,60 $ per cliente. Il test di confutazione ha aggiunto una variabile casuale al modello e la stima non è cambiata affatto, il che significa che il risultato non è guidato da correlazioni spurie. Se la stima fosse cambiata molto, sarebbe stato un campanello d’allarme che le assunzioni causali erano sbagliate.
EconML, sempre di Microsoft, si concentra sulla stima di effetti di trattamento eterogenei. In parole semplici, come l’effetto varia tra sottogruppi diversi. Implementa metodi come Double ML e Causal Forests che ho trattato prima.
EconML segue una API in stile scikit-learn con metodi .fit() e .effect().
dml = DML(
    model_y=RandomForestRegressor(n_estimators=100, random_state=42),
    model_t=RandomForestClassifier(n_estimators=100, random_state=42),
    model_final=LinearRegression(),
    discrete_treatment=True
)

dml.fit(Y=outcome, T=treatment, X=features, W=None)
individual_effects = dml.effect(X=features)
df["estimated_effect"] = individual_effects

young = df[df["customer_age"] < 30]
middle = df[(df["customer_age"] >= 30) & (df["customer_age"] < 40)]
older = df[df["customer_age"] >= 40]

print(f"Average treatment effect: ${individual_effects.mean():.2f}")
print(f"Effect on young customers (<30):  ${young['estimated_effect'].mean():.2f}")
print(f"Effect on mid-age customers (30-40): ${middle['estimated_effect'].mean():.2f}")
print(f"Effect on older customers (>40):  ${older['estimated_effect'].mean():.2f}\\n")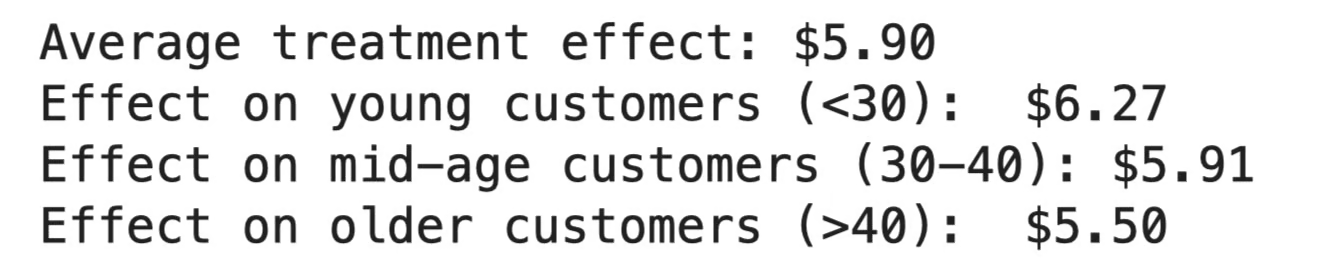
Output di EconML
Lo sconto ha aumentato gli importi d’acquisto di 5,90 $ in media, ma l’effetto non è stato uniforme. I clienti più giovani hanno risposto di più (6,27 $), mentre i più anziani hanno visto l’aumento minore (5,50 $). Se il budget è limitato, questo ti dice dove puntare la campagna per prima.
CausalML, sviluppata da Uber, è pensata per l’uplift modeling - prevedere quali individui risponderanno maggiormente a un trattamento. È particolarmente popolare nel marketing, dove l’obiettivo è raggiungere i clienti che cambieranno comportamento grazie a una campagna, non quelli che avrebbero convertito comunque.
learner = LRSRegressor()
cate_estimates = learner.fit_predict(
    X=features,
    treatment=treatment,
    y=outcome
)

df["uplift"] = cate_estimates.flatten()

# Split into targeting tiers
df["tier"] = pd.cut(df["uplift"], bins=3, labels=["Low", "Medium", "High"])

tier_summary = df.groupby("tier").agg(
    avg_uplift=("uplift", "mean"),
    avg_age=("customer_age", "mean"),
    avg_prior_purchases=("prior_purchases", "mean"),
    count=("uplift", "size")
).round(2)

print(tier_summary.to_string())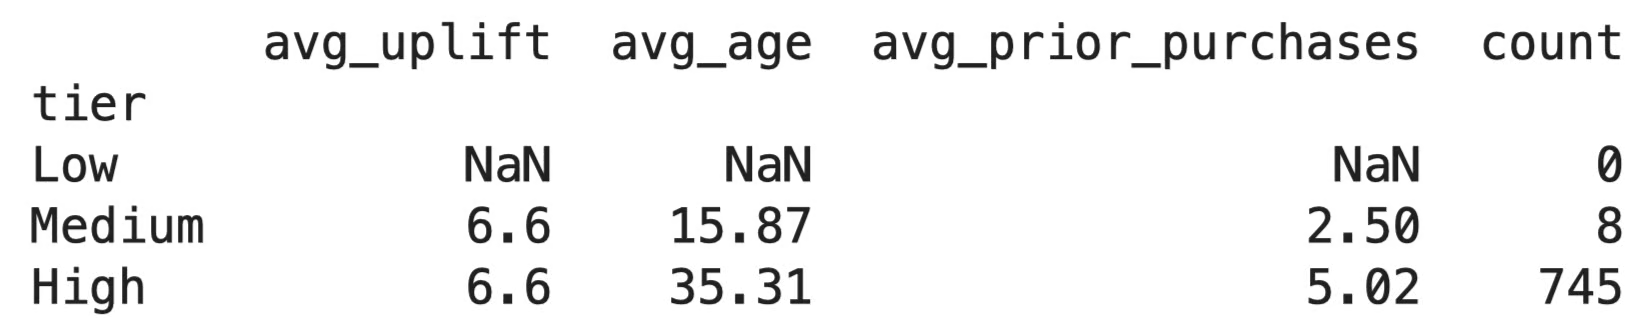
Output di CausalML
I punteggi di uplift sono quasi identici per tutti i clienti, il che significa che lo sconto ha avuto più o meno lo stesso effetto su tutti - circa 6,60 $ a persona. Ha senso per il nostro dataset sintetico, dove ho inserito un effetto di trattamento piatto di 5 $ senza variazione per sottogruppo. Nei dati reali, vedresti tipicamente più dispersione, ed è lì che i livelli di targeting diventano utili.
Ogni libreria ha un caso d’uso ideale. Usa:
Tutte e tre funzionano bene insieme. Uno schema comune è definire il grafo causale in DoWhy, stimare gli effetti con EconML e usare CausalML per interpretare i risultati.
Il causal ML a volte è facile da usare male. Ecco gli errori che creano più confusione.
Questo è un classico. I clienti che usano di più una funzionalità spendono anche di più, quindi concludi che la funzionalità spinge la spesa. Ma magari i clienti ad alta spesa sono semplicemente più coinvolti in generale. Senza un framework causale, stai indovinando la direzione della relazione.
Ogni analisi causale parte da una domanda: è uno schema o è una causa? Se salti questa domanda, nessuna quantità di modellazione ti aiuterà.
Un confondente influenza sia il trattamento che l’esito.
Supponi di misurare l’effetto di un programma di formazione sulla performance dei dipendenti. I dipendenti che si iscrivono alla formazione tendono a essere più motivati. La motivazione guida sia l’iscrizione (trattamento) sia la performance (esito). Se non ne tieni conto, attribuirai l’effetto della motivazione al programma di formazione.
La soluzione è più strutturale che statistica. Disegna il tuo DAG, mappa ogni variabile che potrebbe influenzare entrambi i lati e decidi come gestire ciascuna prima di adattare un singolo modello.
Un ATE di 5 $ non significa che ogni cliente abbia guadagnato 5 $. È una media, e le medie nascondono molto. Alcuni clienti potrebbero aver guadagnato 15 $ mentre altri perso 5 $.
Anche l’inverso è pericoloso. Una stima CATE per un sottogruppo non significa che ogni individuo in quel gruppo risponderà allo stesso modo. Gli effetti del trattamento sono stime con incertezza, non garanzie. Controlla sempre gli intervalli di confidenza e non prendere decisioni di targeting basandoti solo sulle stime puntuali.
Il numero che ti danno EconML o DoWhy è valido solo quanto le assunzioni alla base. Un modello non può rispondere a domande come queste:
Richiedono qualcuno che capisca il problema. Una causal forest produrrà volentieri stime di effetto di trattamento da un modello mal specificato - semplicemente non ti dirà che sono sbagliate.
Le migliori analisi causali combinano la capacità dell’ML di gestire dati complessi con una persona che sa quali variabili contano e perché.
Il causal ML cambia la domanda da "cosa succederà?" a "cosa l’ha fatto succedere?"
Questo spostamento cambia il modo in cui prendi decisioni. Ti fa passare dal reagire agli schemi al comprenderne la meccanica. Alcuni direbbero persino che è l’unico modo per prendere vere decisioni guidate dai dati.
Ma gli strumenti funzionano solo quanto le assunzioni che dai loro. Un grafo causale sbagliato o un effetto di trattamento mal interpretato possono portarti a conclusioni che sembrano “scientifiche” e guidate dai dati ma sono errate. Il modello non alzerà la mano per dirtelo.
I risultati migliori arrivano combinando la capacità dell’ML di gestire dati complessi con qualcuno che capisca il problema abbastanza da porre le giuste domande causali. Parti dalla conoscenza del dominio, poi lascia che il modello faccia il grosso del lavoro. Tutto qui.
La prima parte è facile, soprattutto con il nostro corso Supervised Learning with scikit-learn. Iscriviti oggi per far crescere le tue competenze di machine learning con una libreria Python imprescindibile.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min